Agent Harness 为什么突然成了独立品类?从 pydantic-ai-harness v0.30.0 看编码智能体的可复现工程化
当编码智能体从演示阶段走向日常工程,问题不再是"它能不能改代码",而是"这次改动凭什么可被复核、对比与追责"。围绕 pydantic-ai-harness v0.30.0(2026-09-08)等近期版本动态 12,本文把 Agent Harness 与通用 Agent 框架的职责边界拆开,说明可复现、可评测、可回放为何让它长成 AI 编码智能体供应链中一个独立的基础设施层,并盘点 codeg、ragleap-core、xorbitsai/inference 等组件在同一条链条上的位置。
需要先说明的是:本文依据的是一组来源标题与链接,其 heat、published_at、description 字段均为空,因此文中不作"热度""爆火"式判断,一切"版本节奏"均来自标题字面;涉及各项目具体实现、API 与发布内容的描述,凡未在来源中直接给出的,一律标注为待核实或推断,不会替项目方补写能力。
0. 开篇:一个不起眼的版本号,指向一次分层
在给定的来源集合里,可以看到一个耐人寻味的对比:一边是 pydantic 命名空间下的 pydantic-ai-harness 有独立的 releases 页面,并存在一个标注日期为 2026-09-08 的 v0.30.0 版本 12;另一边是 microsoft/agent-framework 中一条由 Dependabot 发起的依赖变更 PR,将 python/packages/lab 下的 agent-framework-core 从 1.17.0 升到 1.18.0 4。前者把"harness"写进仓库名并独立发版,后者是通用 Agent 框架的例行依赖升级。同期还出现了 codeg v0.30.6 5、ragleap-core v0.7.0 6、xorbitsai/inference v2.12.0 7 等版本节点。
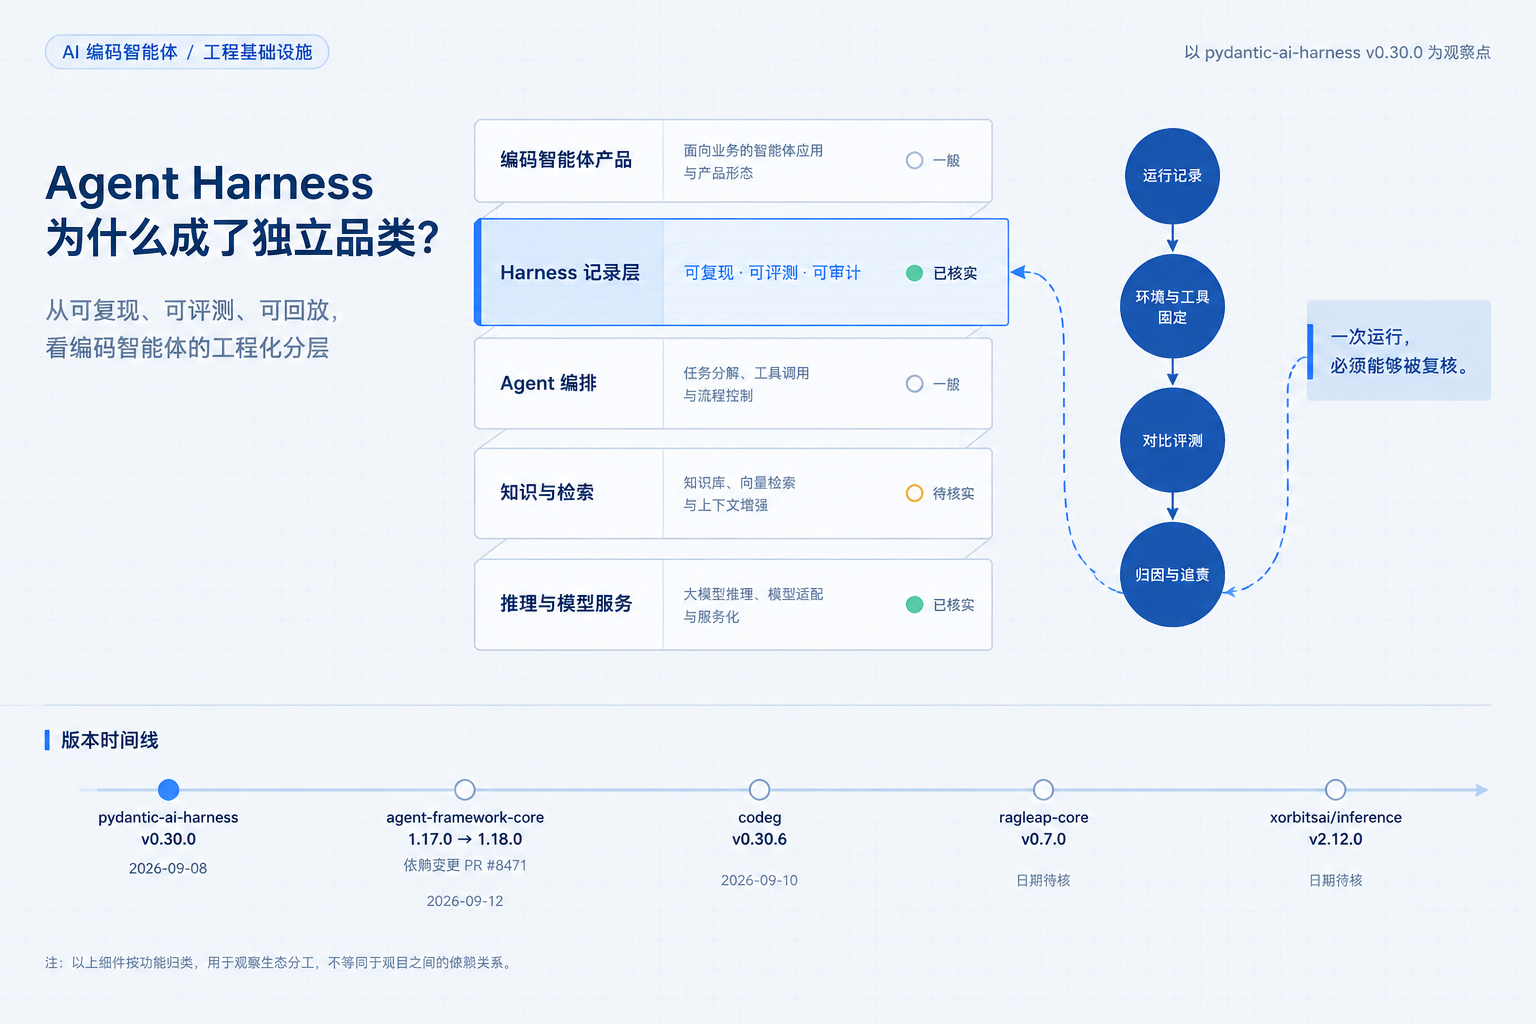
这些版本号本身并不惊人,惊人的是它们的分组方式:记录、回放、评测一类职责开始以独立仓库、独立版本、独立发布页的形式存在,而不是作为某个 Agent 框架的附属模块。这正是本文要论证的命题:当编码智能体从"能跑通 demo"进入"要回归、要审计、要对比"的阶段,"记录一次运行并使其可重放、可评测、可审计"的工程职责,正在从 Agent 框架中剥离出来,形成为一个独立的基础设施层------harness 层。
本文的核心论点可以拆成三句:
- harness、coding agent、通用 agent framework 是三种不同的东西,判据不在于 README 里有没有 "agent" 一词,而在于它对"一次运行"负什么责任;
- 可复现(replayable)、可评测(evaluable)、可审计(auditable)这三个性质互相牵连,共同构成一层不能被顺手塞进编排框架的工程职责;
- 推理服务、检索、编排、harness、编码智能体产品正在被纳入同一条供应链来讨论,但"同一条供应链"在多数情况下是分析者的归类框架,而不是项目之间声明的依赖关系,必须如实区分。
1. 先把词说清楚:harness、coding-agent、agent framework 是三种东西
"harness"在传统软件工程里早有含义:测试执行器、测试夹具、跑测环境的那套外壳。它不实现业务逻辑,它负责把被测对象放进一个受控环境里运行、收集输出、报告结果。把这个词借到智能体语境,语义迁移是自然的------harness 依旧不负责"智能",它负责把智能体放进一个可运行、可观察、可重复的外壳里。
这一点从项目自我定位就能看出。SmartAI/ava 的仓库描述是 "A durable, replayable coding-agent harness for Python" 3:三个限定词分别界定了它自称解决的问题(耐久、可回放)与适用对象(Python 编码智能体)。与之相对,microsoft/agent-framework 是通用 Agent 框架,其近期可见的变更形式是核心包版本的常规依赖升级 4------框架关心的是如何编排模型调用、工具与多智能体流程。
1.1 三个易混概念的职责边界
| 维度 | Harness 层 | Coding Agent(编码智能体) | 通用 Agent Framework |
|---|---|---|---|
| 核心职责 | 运行环境的受控执行、记录、回放、评测支撑 | 理解任务、修改代码、产出提交 | 提供模型调用、工具绑定、流程编排的抽象 |
| 典型输入 | 一次已定义的任务与受控环境 | 自然语言需求 + 代码仓库 | 提示词、工具集、流程定义 |
| 典型输出 | 运行记录、重放结果、对比报告 | 代码变更 diff、提交、说明 | 可运行的 agent 应用 |
| 是否关心模型调用编排 | 一般不主导,只记录与固定其边界 | 是 | 是 |
| 是否关心运行记录 | 是,这是它的主业 | 通常不作为卖点 | 通常作为附带能力 |
| 典型失败模式 | 记录不完备导致无法归因 | 生成的代码不正确或不可维护 | 抽象不合适、流程难以调试 |
| 能否换模型后复跑 | 依赖记录的输入与环境,而非模型确定性 | 关注效果 | 关注接口兼容 |
这张表是概念对照,不代表任一项目的具体实现边界;尤其是三个项目的实际职责范围,应以各自 README 与文档为准,本文不代为裁定。
1.2 "durable" 与 "replayable" 不是一回事
ava 的自我定位同时用了 durable 与 replayable 3,但这两个承诺指向不同问题:
- durable(耐久/断点续跑):进程崩溃、机器重启、任务中断之后,运行状态不丢,能够从已持久化的检查点继续。它回应的是"长任务别白跑"。
- replayable(可回放):一次历史运行被完整记录后,可以被重新执行或重新检查。它回应的是"这次结果怎么复核、怎么对比"。
两者可能共享同一套事件日志或状态持久化机制,但承诺不同:一个能续跑的系统不一定能回放,一个能回放的记录也不一定支持中途恢复。工程上把它们混为一谈,会导致"我们做了持久化"被误当成"我们可复现"。ava 中 durable 与 replayable 的具体实现机制(事件日志、快照还是别的形式)、支持范围与许可证,来源只提供了仓库定位句 3,本文不作展开,属待核实事项。
1.3 为什么"框架里顺手做个日志"不够
通用框架当然可以打日志,问题在于责任归属。编排框架的第一职责是让 agent 跑起来:工具怎么绑定、流怎么走、错误怎么重试。而回放要求的是另一套约束------输入必须完整闭合、工具副作用必须被观测或被夹具替代、环境必须可指纹化、时间与随机性必须可控。前者追求灵活性,后者追求封闭性,两者的失败代价也不同:框架出错是"跑不起来",记录层出错是"跑起来了但说不清发生了什么",后者往往在事故复盘或评测对比时才暴露,代价更高。这种职责张力,是 harness 长成独立层的内在原因。
2. 三个性质为什么把 harness 顶成独立基础设施层
2.1 Replayable:把"一次运行"变成可保存的资产
传统 CI 里"重跑测试"是廉价且近似等价的:同一份代码、同一份断言,重跑的语义基本确定。LLM 驱动的编码智能体不满足这个前提。模型输出具有非确定性,工具调用顺序可能改变,网络与依赖版本在漂移。因此对智能体而言,"复现"通常不等于"再跑一遍",而等于保存一次运行的完整闭合记录:输入、模型与参数指纹、每一步工具调用及其返回、环境信息、文件变更与最终产物。回放是拿这份记录重新走流程或重新检验结果,而不是重新请求模型。
这改变了工程对象:可保存、可校验、可移植的"运行记录"本身成为资产,需要版本化、有 schema、有兼容性策略。这种资产管理需求天然不适合寄生在编排框架内部。
关于 pydantic-ai-harness v0.30.0 的具体能力------是否提供录制格式、重放入口、确定性重放、对应 API 与文件结构------来源只给出了 release 标题与日期 12,release notes 正文未在本文依据的数据中。因此本文不写该版本的任何具体 API 或文件格式;这属于必须打开 release 页面核对后才能落笔的内容。
2.2 Evaluable:可对比的前提是可固定
评测一个编码智能体,常见做法是拿一组任务打分。但只要运行环境和工具行为没有被固定,两个版本之间的分数差异就无法归因:是提示词更好了,还是这次测试机的依赖新了一版,还是工具返回顺序变了?harness 提供的"固定夹具"------固定任务集、固定环境指纹、固定工具行为或工具回放------是评测的前置条件,而不是评测本身。
换句话说,评测框架回答"怎么打分",harness 回答"这次跑和上次跑是否在同一个天平上"。没有后者,榜单分数只是一次性数据。
2.3 Auditable:进入供应链就要能回答"发生了什么"
编码智能体的产出是代码提交。一旦这些提交进入真实仓库,责任链就必须可追溯:哪次工具调用修改了哪个文件,依据的是哪次模型输出,运行时的环境是什么版本。回放记录在这里从"研发便利"升级为"审计线索"。
这也是 harness 与普通日志的分水岭:普通日志为人阅读而写,运行记录为程序复核而写,需要结构化、可校验(例如对记录做哈希)、可与产物(提交 SHA)关联。
下面是一条记录链路的概念示意,字段仅为讨论完备性,不是任何项目的实际 schema:
任务输入(task spec)
  → 模型调用(prompt + params + model fingerprint + response)
    → 工具调用(tool name + args + result + side-effect scope)
      → 文件系统变更(diff / snapshot id)
        → 产物(commit SHA / patch hash)
          → 校验(record hash + env fingerprint)
3. 供应链视角:harness 层的上下游都是谁
3.1 一条编码智能体供应链的分层
自下而上,一条完整的编码智能体供应链大致可以这样切分:
| 层 | 职责 | 本次来源中的候选组件 | 核实状态 |
|---|---|---|---|
| 推理/模型服务层 | 模型加载、服务化、OpenAI 兼容接口 | xorbitsai/inference v2.12.0 7;intel/enterprise-ai-solutions(K8s 上 OpenAI 兼容推理部署)10 | 推断定位,须以 README 为准 |
| 知识与检索层 | 语料管理、检索、RAG 组装 | ragleap-core v0.7.0 6 | 名称指向 RAG 相关核心组件,实际职责待核实 |
| Agent 编排层 | 模型调用、工具绑定、多智能体流程 | microsoft/agent-framework(core 1.17.0→1.18.0)4 | 已核实为通用框架的依赖变更 |
| Harness 层 | 受控执行、运行记录、回放、评测支撑 | pydantic-ai-harness v0.30.0 12、SmartAI/ava 3 | 定位句已见于标题,实现细节待核实 |
| 编码智能体产品层 | 面向开发者的编码任务执行 | codeg v0.30.6 5、Abilityai/trinity(自托管 AI Agents 平台,支持 Claude Code / Codex / Gemini)9 | trinity 定位见标题;codeg 定位来源空白,待核实 |
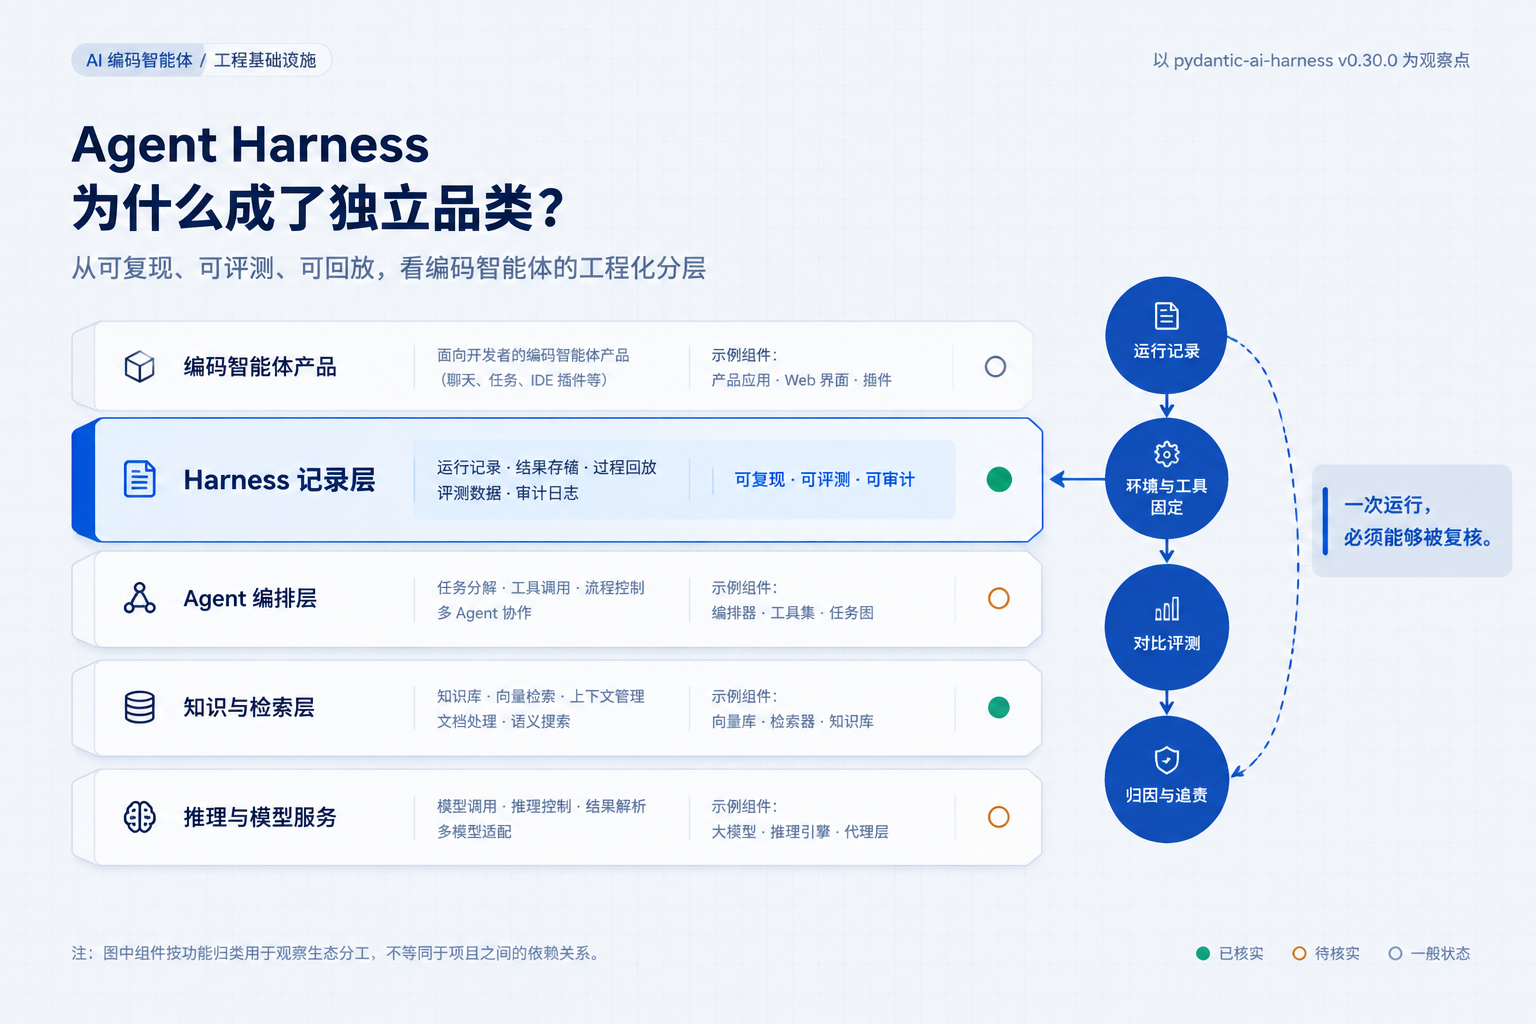
需要强调:codeg v0.30.6 在来源中只有 release 标题 5,其自我定位(编码智能体、代码生成工具还是别的)没有可核验材料,本文不给它定性;上表中它的落位属于"待核实"占位。同理,ragleap-core 是否确实是 RAG 组件、xorbitsai/inference v2.12.0 具体变更了什么,来源只给出版本标题 67,不足以支撑具体能力描述。
3.2 "同一供应链"的两种含义:依赖关系 vs 生态归类
这里必须做一次诚实的区分。PR #8471 是可核实的事实链:Dependabot 在 microsoft/agent-framework 的 python/packages/lab 下,把 agent-framework-core 从 1.17.0 升级到 1.18.0 4。这是一个明确的版本联动,属于项目内部依赖关系。
但"codeg、ragleap-core、xorbitsai/inference、pydantic-ai-harness 被收编进同一条供应链"这句话,在现有材料中没有可核验的相互依赖声明。它是趋势分析视角下的归类:把"推理服务、检索、编排、记录回放、编码产品"视为一条端到端交付链上的不同工位。写作与选型时都应保持这一措辞区分,避免把分析框架误述为技术事实。
3.3 层间契约:harness 需要向上下游要什么
工程上,要让回放成立,各层需要提供一些可插桩、可固定的接口边界,这是通用工程要求,不指向任何具体 API:
- 推理层:请求级日志(prompt、参数、响应、模型版本标识),以及可固定随机性或至少可固定输入的能力;
- 检索层:语料版本固定与检索结果快照,否则 RAG 链路的输入会随索引更新而漂移;
- 编排层:可插桩的模型调用与工具调用边界,使每一次调用都能被截获、记录与替换为夹具;
- 执行层:文件系统与命令执行的隔离环境,使副作用范围可界定、可快照;
- 产品层:把任务定义与最终产物同运行记录关联(运行 ID ↔ 提交 SHA)。
这些契约一旦缺失,回放只能停留在"重跑一遍然后祈祷结果相近"。
4. 工程落地:想让自己的 agent 可回放,从哪里开始
4.1 最小运行记录清单
不依赖任何具体项目的前提下,一份最小可用的运行记录至少应包含:
| 字段 | 作用 | 缺失后果 |
|---|---|---|
| 运行 ID | 关联日志、记录与产物 | 无法把一次运行当整体引用 |
| 时间戳与时区 | 归因与排序 | 多机记录无法对齐 |
| 模型与参数指纹 | 模型名、版本、温度、top-p、种子等 | 分数差异无法归因到模型 |
| 完整输入 | 任务说明、系统提示、上下文组装结果 | 无法知道模型看到了什么 |
| 工具调用序列及返回 | 工具名、参数、返回值、耗时、错误 | 无法复现副作用与分支 |
| 文件系统变更 | diff 或快照 ID | 无法解释最终产物怎么来的 |
| 环境指纹 | 依赖锁文件、运行时版本、容器镜像摘要 | 环境漂移被误判为模型问题 |
| 最终产物 | 提交 SHA、补丁哈希、报告 | 记录与交付物脱节 |
| 记录校验 | 记录整体哈希或签名 | 记录被篡改无法察觉 |
对应的伪 schema 如下。这是概念示意,不是任何项目的实际 API 或文件格式:
json
{
  "schema_version": "concept-1",
  "run_id": "uuid-v4",
  "started_at": "RFC3339 timestamp",
  "model": {
    "name": "model-id",
    "version": "provider revision",
    "params": { "temperature": 0.0, "top_p": 1.0, "seed": "if supported" }
  },
  "input": {
    "task": "task specification",
    "system_prompt": "full text",
    "context": ["assembled context items"]
  },
  "steps": [
    {
      "step_id": 1,
      "kind": "model_call | tool_call",
      "request": { "tool": "name", "args": {} },
      "response": { "content": "raw response", "error": null },
      "side_effects": { "files": ["paths touched"] },
      "duration_ms": 0
    }
  ],
  "environment": {
    "runtime": "python 3.x",
    "lockfile_digest": "sha256:...",
    "image_digest": "sha256:..."
  },
  "output": {
    "commit_sha": "git sha or null",
    "patch_digest": "sha256:..."
  },
  "record_digest": "sha256 of canonicalized record"
}
若后续核对到 pydantic-ai-harness 或 ava 的官方录制格式与重放命令 13,应优先用官方示例替换这段伪 schema,而不是让自造格式成为读者的施工依据。
4.2 三个常见误区
| 误区 | 为什么错 | 更可靠的做法 |
|---|---|---|
| 把"重跑一遍"当"回放" | LLM 输出非确定,工具与环境也在漂移,重跑不等价 | 回放基于已记录的模型响应与工具返回,重跑只用于评估新版本 |
| 记录了 prompt 就以为可审计 | 工具副作用、环境版本、检索结果未记录,链条断裂 | 记录完整调用序列、副作用范围与环境指纹 |
| 评测跑分高就等于可复现 | 榜单分数是聚合结果,可复现是单次运行的性质 | 分开验收:评测集固定、运行记录可回放、两者都可校验 |
一个构造式小案例(明确说明:以下为虚构示例,非真实事故):某团队升级了向量库后,同一提示词下 agent 的行为大变,回查记录发现只存了 prompt 与最终 diff,没有存检索返回的文档 ID 与版本。结果既无法判断是检索漂移还是模型升级导致,也无法在旧语料上重放验证。缺的不是更多日志,而是结构化的运行记录。
5. 趋势判断与风险提示
5.1 三条可辩护的判断
| 判断 | 证据 | 强度 |
|---|---|---|
| harness 正在独立仓库化、独立版本化 | pydantic 命名空间下存在独立的 pydantic-ai-harness 仓库与 releases 页面,并有 v0.30.0(2026-09-08)版本节点 12 | 中(版本事实明确,项目定位细节待核) |
| "durable / replayable" 作为卖点被写进项目自我定位 | SmartAI/ava 的仓库描述直接以这两个词自述 3 | 中(定位句可核,实现机制待核) |
| 评测与审计需求使记录层难以继续寄生在编排框架内 | 通用框架的可见变更为常规依赖升级 4,而记录/回放类项目独立发版;CSDN 日报提到"AI 编程智能体技能工具霸榜"可作生态侧佐证 8 | 弱到中(属趋势推断,二手资讯仅作旁证) |
关于标题中的"突然成了独立品类",更准确的表述应是:harness 正在长成一个可辨识的独立品类。现有证据足以支持"独立仓库 + 独立版本 + 独立定位词汇"这一层判断,但不足以证明社区已形成公认定义或成熟标准。
5.2 三条风险
- 术语通胀。"agent""harness""framework"正在被广泛挪用,同一词在不同项目里可能指完全不同的东西。选型时应以职责表而非命名判断。
- 记录格式不互通。如果各家 harness 的运行记录各自为政,迁移与跨工具对比会被锁定。评估时应关注记录是否有公开 schema、是否可导出为中立格式。
- "可复现"承诺未经第三方验证。durable、replayable 是项目自述,除非有独立的回放一致性测试或第三方复核,否则应视为产品承诺而非已验证性质。
6. 附录:本文依赖的事实与待核实清单
可直接引用的事实:
- pydantic/pydantic-ai-harness 存在标注为 v0.30.0(2026-09-08)的 release 条目与独立 releases 页面 12;
- SmartAI/ava 的仓库描述为 "A durable, replayable coding-agent harness for Python" 3;
- microsoft/agent-framework PR #8471 为 Dependabot 发起的依赖升级,将
agent-framework-core从 1.17.0 升至 1.18.0,路径为python/packages/lab4; - 存在 codeg v0.30.6 5、ragleap-core v0.7.0 6、xorbitsai/inference v2.12.0 7 三个版本条目;
- CSDN 有标题为《GitHub开源项目日报 · 2026年9月6日 · AI编程智能体技能工具霸榜》的二手资讯 8。
必须打开原文核实后才能进一步落笔的事项:
- pydantic-ai-harness 是否确属 Pydantic 官方组织维护、其自我定位与 v0.30.0 的实际变更内容;
- ava 中 durable / replayable 的实现机制、支持范围与许可证;
- agent-framework-core 1.18.0 的实际发布内容与日期;
- codeg 的项目定位(编码智能体、代码生成工具或其他);
- ragleap-core 的实际职责及其与 Agent 链路的关系;
- xorbitsai/inference v2.12.0 的变更内容,是否提供请求级日志或确定性接口;
- 上述各版本的真实发布日期------本文来源数据中
published_at全部为空,日期仅取自标题字面。
对读者的建议是:把本文当作一张选型讨论的骨架图,而不是一份产品评测。骨架的分层逻辑(推理 → 检索 → 编排 → harness → 产品)在工程上是稳健的,但每个方格里放什么、是否真的可回放,需要打开对应项目的文档与 release notes 逐项验证。
参考资料
1 Release v0.30.0 (2026-09-08) · pydantic/pydantic-ai-harness,GitHub,https://github.com/pydantic/pydantic-ai-harness/releases/tag/v0.30.0
2 Releases · pydantic/pydantic-ai-harness,GitHub,https://github.com/pydantic/pydantic-ai-harness/releases
3 SmartAI/ava: A durable, replayable coding-agent harness for Python,GitHub,https://github.com/SmartAI/ava
4 Python: Build(deps): Bump agent-framework-core from 1.17.0 to 1.18.0 in /python/packages/lab(PR #8471)· microsoft/agent-framework,GitHub,https://github.com/microsoft/agent-framework/pull/8471
5 Release codeg v0.30.6 · xintaofei/codeg,GitHub,https://github.com/xintaofei/codeg/releases/tag/v0.30.6
6 Release v0.7.0 · antonyrag/ragleap-core,GitHub,https://github.com/antonyrag/ragleap-core/releases/tag/v0.7.0
7 Release v2.12.0 · xorbitsai/inference,GitHub,https://github.com/xorbitsai/inference/releases/tag/v2.12.0
8 GitHub开源项目日报 · 2026年9月6日 · AI编程智能体技能工具霸榜,CSDN,https://blog.csdn.net/xiaoquqi/article/details/164558736
9 Abilityai/trinity: Self-hosted AI Agents Platform (Claude Code / Codex / Gemini),Apache 2.0,GitHub,https://github.com/Abilityai/trinity
10 intel/enterprise-ai-solutions:在 Kubernetes 上部署 OpenAI 兼容 LLM 推理,GitHub,https://github.com/intel/enterprise-ai-solutions