1、安装Docker DeskTop
生产环境推荐Docker安装
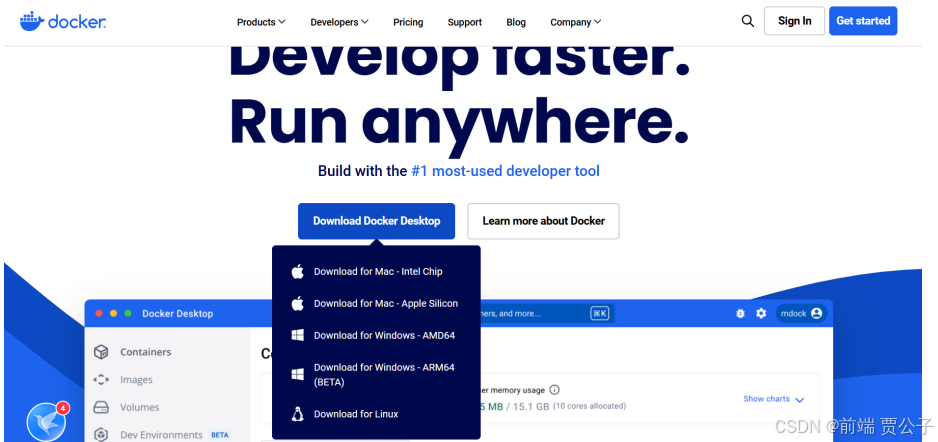
1.1 下载安装包
1.2 安装
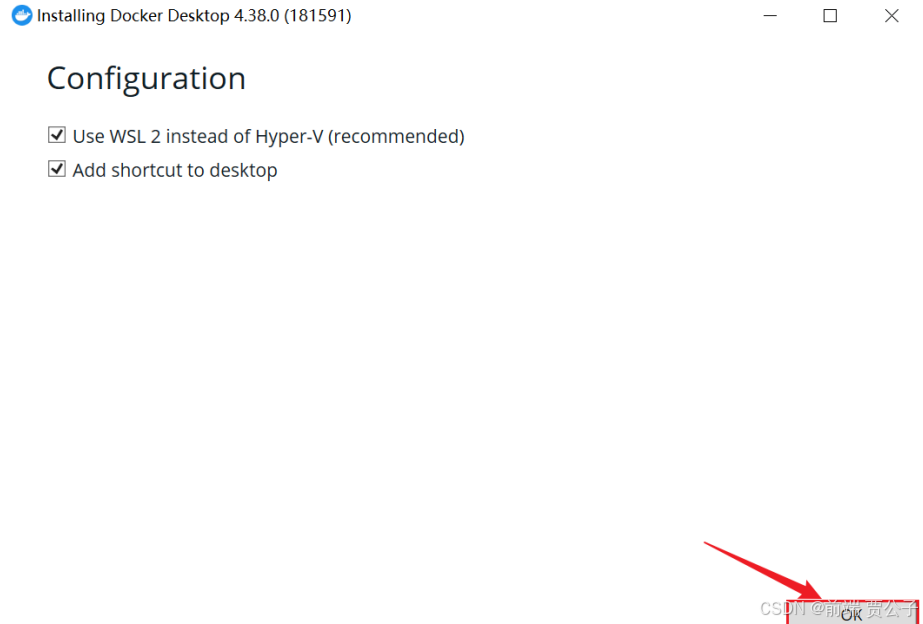
步骤1:点击OK即可
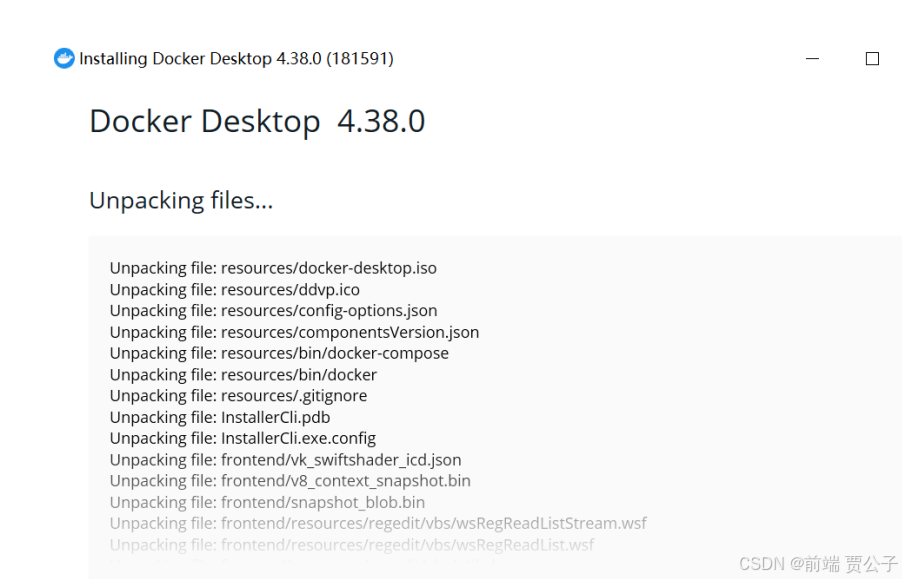
步骤2:等待安装完成
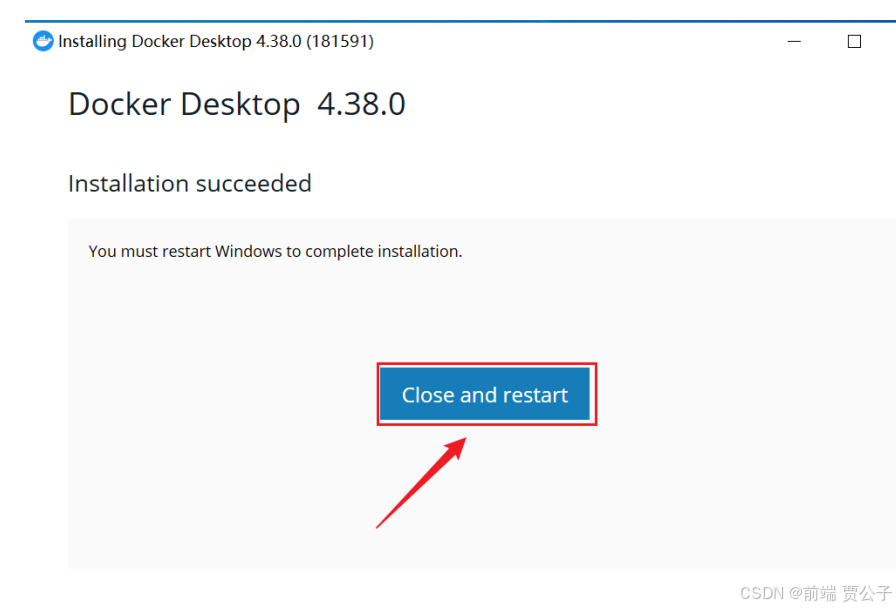
步骤3:重启电脑或稍后自行重启
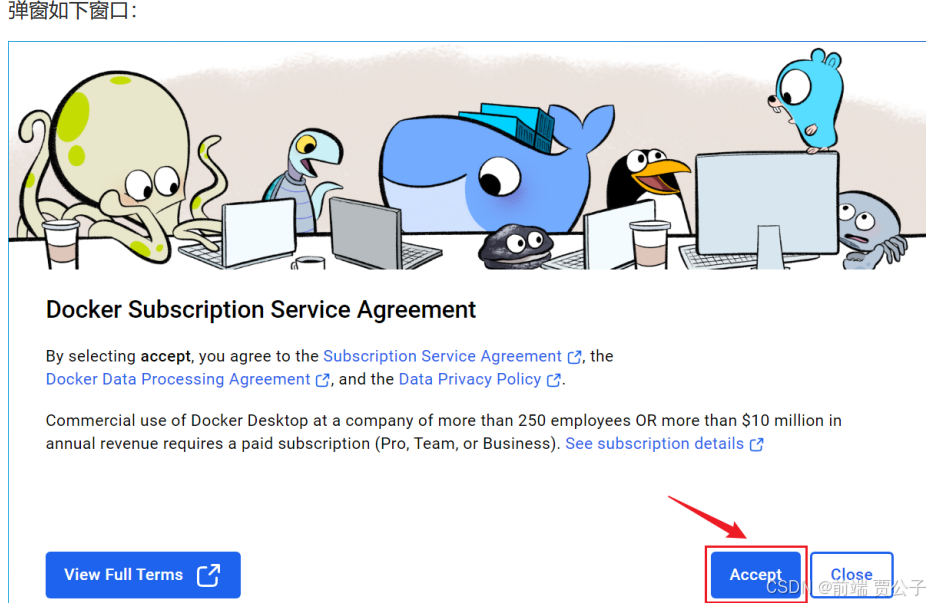
步骤4:接受服务协议
步骤5:完成安装
2、安装Milvus
1. 准备 Docker
先确保 Mac 安装并启动 Docker Desktop:
docker --version
docker ps
2. 创建 Milvus 工作目录
mkdir -p ~/milvus
cd ~/milvus
3. 下载 Milvus Standalone 脚本
curl -L "https://raw.githubusercontent.com/milvusio/milvus/master/scripts/standalone_embed.sh" \
  -o standalone.sh
standalone_embed.sh 是 Milvus 官方提供的 Standalone 部署脚本。-o standalone.sh 表示将下载的文件保存为本地的 standalone.sh。
4. 添加执行权限
chmod +x standalone.sh5. 启动 Milvus
bash standalone.sh start6. 查看运行状态
bash standalone.sh status同时可以通过: 查看 Milvus 相关容器。
7. 常用操作
# 启动
bash standalone.sh start

# 重启
bash standalone.sh restart

# 停止
bash standalone.sh stop

# 升级
bash standalone.sh upgrade

# 删除
bash standalone.sh delete
3、测试前准备工作
安装Milvus Python SDK
pip install pymilvus # 已在requirements_full.txt文件中安装Milvus Lite已包含在Milvus的Python SDK中,此处不用Milvus Lite,直接访问在docker desktop安装 的、Standalone模式的Milvus服务。
Milvus数据模型
1 整体结构
从业务角度,Milvus数据模型层级如下
Database -> Collection -> Partition -> EntitDatabase:Milvus 的数据库,用来隔离不同业务数据。
Collection:最核心的逻辑容器,类似于关系型数据库里的 table。
Partition:分区,是 collection 的子集,不是必须手动创建;一个 collection 至少会有默认 partition。
Entity:可以理解为 collection 中的一条记录。类似于关系型数据库的一行数据。
2 具体说明
在传统数据库中,如果你想存储用户信息,你会建一张表叫 user_table ;想存储商品,会建一张表叫 product_table
在向量数据库中,我们要存储的是成千上万个"特征向量"以及它们对应的文本。为了把不同用途的向量 分门别类地存放,我们就要创建不同的 Collection。 比如, COLLECTION_NAME = "docs" 就是给这 张"表"取名叫 docs ,专门用来存放你切分好的文档片段向量。
4、基本用法
DDL操作
① 查看数据库
-
创建客户端
from pymilvus import MilvusClient
MilsClient = MilvusClient(host='localhost', port=19530)
举例2:列出所有数据库
databases=MilsClient.list_databases()

for db in databases:
    print(db)
② 创建数据库
db_name='rag_demo'
if db_name not in databases:
    MilsClient.create_database(
          db_name=db_name,
    )
③ 删除数据库
如果数据库下有Collection则无法删除,需要先删除它的所有Collection才能删除DatabaseMilsClient.drop_database(db_name=db_name)Collection相关操作
① 切换数据库
MilsClient.use_database(db_name=db_name)上述命令的作用等价于关系型数据库中的 use
② 查看数据库下的collections
collections =  MilsClient.list_collections()

for coll in collections:
    print(coll)
③ 创建collection
collection_name='docs'

MilsClient.create_collection(
 collection_name=collection_name,
 dimension=1024,
 metric_type="COSINE",
)
dimension :嵌入向量维度,应和嵌入模型的向量维度保持一致
metric_type 表示向量相似度的计算方式, COSINE 表示余弦相似度
当用户提问时,系统会把提问也变成向量,然后去数据库里找"最相似"的本地文本向量。但怎么定 义"相似"呢? 向量数据库需要知道计算规则。 COSINE (余弦相似度)关注的是两个向量在方向上 的夹角:
如果两个向量方向完全一致(代表文本意思极度接近),余弦值接近 1 。
如果方向正交(毫无关系),值接近 0 。
结论:在 RAG 检索时,Milvus 会帮你计算用户问题与数据库中所有文本的余弦相似度,并把得分(Score)从大到小排序,把得分最高(最相似)的前 K 个片段还给你。 (注:除了COSINE 之外,常见的还有 L2 欧氏距离、 IP 内积等。)
④ 删除collection
MilsClient.drop_collection(collection_name=collection_name)