摘要:2026-09-15,Cloudflare 把"屏蔽 AI 爬虫"这一个开关拆成了 Search / Training / Agent 三个独立控制。本文提出「AI 抓取三档偏好」框架并给出四步落地路径:清点 UA(Python 3.13 日志分档统计)、写下偏好(robots.txt 三档模板)、分层拦截(CDN + Nginx)、验证生效(robots.txt 体检脚本)。附公开站点抽查实测结果与 6 组 FAQ。仅用标准库,无需额外依赖。
文章目录
-
- 一、问题背景:一个开关管两种用途的时代结束了
-
- [1.1 混合用途爬虫已经占了三成以上的验证流量](#1.1 混合用途爬虫已经占了三成以上的验证流量)
- [1.2 为什么"一键屏蔽 AI 爬虫"会误伤搜索](#1.2 为什么"一键屏蔽 AI 爬虫"会误伤搜索)
- [1.3 本文解决什么,适合谁](#1.3 本文解决什么,适合谁)
- [二、命名框架:AI 抓取三档偏好](#二、命名框架:AI 抓取三档偏好)
-
- [2.1 三档的定义与代表 UA](#2.1 三档的定义与代表 UA)
- [2.2 一个容易搞混的点:声明层的 token 不等于日志里的 UA](#2.2 一个容易搞混的点:声明层的 token 不等于日志里的 UA)
- [2.3 落地四步](#2.3 落地四步)
- 三、环境准备
-
- [3.1 版本与依赖](#3.1 版本与依赖)
- [3.2 目录结构](#3.2 目录结构)
- [四、第一步:清点 UA ------ 先知道自己被谁抓](#四、第一步:清点 UA —— 先知道自己被谁抓)
-
- [4.1 从访问日志算三档抓取账](#4.1 从访问日志算三档抓取账)
- [4.2 实测输出与三个读法](#4.2 实测输出与三个读法)
- [4.3 日志里看不到的部分](#4.3 日志里看不到的部分)
- [五、第二步:写下偏好 ------ robots.txt 三档模板](#五、第二步:写下偏好 —— robots.txt 三档模板)
-
- [5.1 三档模板(按需删减,不要照抄全部)](#5.1 三档模板(按需删减,不要照抄全部))
- [5.2 分档不只有"全拦/全放":路径级 Allow](#5.2 分档不只有"全拦/全放":路径级 Allow)
- [5.3 llms.txt 能做什么、不能做什么](#5.3 llms.txt 能做什么、不能做什么)
- [六、第三步:分层拦截 ------ CDN 与源站](#六、第三步:分层拦截 —— CDN 与源站)
-
- [6.1 CDN 层:三档控制与那个真实陷阱](#6.1 CDN 层:三档控制与那个真实陷阱)
- [6.2 源站层:Nginx 按 UA 分档](#6.2 源站层:Nginx 按 UA 分档)
- [6.3 为什么两层都要做](#6.3 为什么两层都要做)
- [七、第四步:验证生效 ------ 三档体检](#七、第四步:验证生效 —— 三档体检)
-
- [7.1 体检脚本](#7.1 体检脚本)
- [7.2 抽查 5 个公开站点(2026-09-17 实测)](#7.2 抽查 5 个公开站点(2026-09-17 实测))
- [7.3 最常见的三类写错](#7.3 最常见的三类写错)
- 八、三档配置对照表
-
- [8.1 配置对照](#8.1 配置对照)
- [8.2 收敛成三个判断](#8.2 收敛成三个判断)
- 九、适用边界与风险提示
-
- [9.1 适用场景](#9.1 适用场景)
- [9.2 不适用与风险](#9.2 不适用与风险)
- 十、FAQ
- 十一、总结
一、问题背景:一个开关管两种用途的时代结束了
"要不要屏蔽 AI 爬虫"这个问题,在过去两年一直是个单选题:要么全放,要么全挡。而这两年里,站长的实际处境是------搜索流量不能丢,但也不想白白被拿去训练。
1.1 混合用途爬虫已经占了三成以上的验证流量
按 Cloudflare 在 2026-09-15 发布公告时给出的口径:混合用途爬虫(一只爬虫同时为搜索索引和模型训练抓取内容)占其网络验证爬虫流量的 36.6%,已经是单一最大类目。
同一天公布的两组对比数字更说明问题:
| 站点行为 | 占比 |
|---|---|
| 屏蔽搜索爬虫的站点 | 不足 1% |
| 限制 AI 训练的站点 | 17% |
也就是说:绝大多数站点想要搜索,但有近五分之一的站点想退出训练------需求早就分层了,只是过去没有工具把这两件事分开表达。
1.2 为什么"一键屏蔽 AI 爬虫"会误伤搜索
在旧的控制方式下(例如 Cloudflare 已弃用的 "Block AI Bots" 开关),选择屏蔽会同时影响搜索抓取。原因在于爬虫本身没有按用途拆开:
Googlebot、Bingbot、Applebot这类混合用途爬虫,一只同时干两件事;- 一旦你把它们整体挡住,搜索收录会一起掉。
这也是 Cloudflare 在公告里反复强调的一点:想把训练挡掉、同时保住搜索,就必须用训练档专属的开关 ,而不是整体屏蔽。按官方说明,Selected Block 之后,Applebot、Bingbot、Googlebot 都会一起被挡------这是本轮改造里最容易踩的一个真实陷阱。
1.3 本文解决什么,适合谁
本文面向三类人:站点技术负责人 (要落地配置)、SEO/内容团队 (要判断哪些档位该放)、企业架构师(要把爬虫策略纳入 AI 治理范围)。读完你会得到:
- 一套可复用的命名框架「AI 抓取三档偏好」;
- 一条四步落地路径(清点 → 声明 → 拦截 → 验证),每步都有可直接运行的代码或配置;
- 一次公开站点抽查实测 :看别人怎么写的、最常见的错在哪。
二、命名框架:AI 抓取三档偏好
2.1 三档的定义与代表 UA
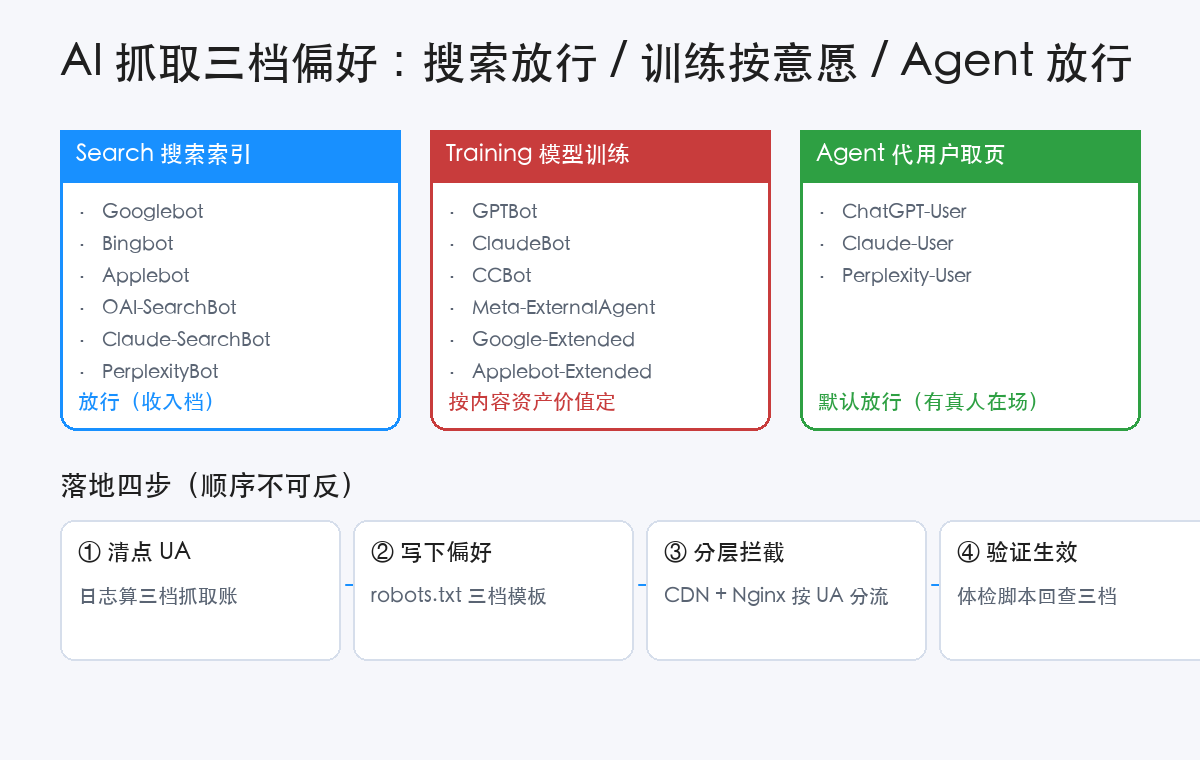
Cloudflare 这次把爬虫行为拆成三档,这个分类方式本身值得直接复用:
| 档位 | 判断依据 | 代表 UA | 对企业的意义 |
|---|---|---|---|
| Search 搜索索引 | 抓取用于建立搜索索引 | Googlebot、Bingbot、Applebot、OAI-SearchBot、Claude-SearchBot、PerplexityBot |
带来搜索排名与 AI 引用,通常必须放行 |
| Training 模型训练 | 抓取用于训练或微调模型 | GPTBot、ClaudeBot、CCBot、Meta-ExternalAgent、Google-Extended、Applebot-Extended |
内容被无偿使用,按业务意愿决定 |
| Agent 代用户取页 | 代表用户实时取页(聊天检索、浏览代理) | ChatGPT-User、Claude-User、Perplexity-User |
有真实用户在场,默认放行更划算 |
2.2 一个容易搞混的点:声明层的 token 不等于日志里的 UA
这是实操里最常出错的地方,单独拎出来说:
Google-Extended、Applebot-Extended不是独立爬虫 ,它们是 robots.txt 里的控制位------用来声明"Googlebot / Applebot 抓到的内容,可否用于训练";- 所以你在访问日志里永远看不到这两个 UA,"日志里没出现"不等于"没声明";
- 反过来,日志里出现的 UA 也不一定是官方 token------沿用过期名字是抽查里最常见的问题之一(详见 7.3)。
2.3 落地四步
① 清点 UA    → 先知道自己被谁抓:从访问日志算出三档抓取账
② 写下偏好   → robots.txt 三档模板(+ 路径级 Allow 的精细写法)
③ 分层拦截   → CDN 层三档控制 + 源站层按 UA 分流
④ 验证生效 → 用体检脚本回查,确认三档真的按预期生效顺序不能反。先清点再声明------否则你写的偏好可能根本不是针对真实在抓你的那批 UA。
三、环境准备
3.1 版本与依赖
| 项目 | 版本 | 说明 |
|---|---|---|
| Python | 3.13.12 | 两个脚本只用标准库 (re / sys / urllib / collections) |
| 访问日志 | nginx combined 格式 | 若用 Apache,改 LINE 正则即可 |
| 可选 | CDN 控制台 / Nginx | 第 3 步的分层拦截 |
本文所有代码均在 Python 3.13.12 实测通过;代码兼容 3.9+。
3.2 目录结构
text
crawler-tier/
├── tier_stats.py       # ① 日志分档统计
├── tier_check.py       # ④ robots.txt 三档体检
├── robots_template.txt # ② 模板
└── access_sample.log   # 测试用日志
四、第一步:清点 UA ------ 先知道自己被谁抓
4.1 从访问日志算三档抓取账
python
# tier_stats.py --- 从访问日志算「三档抓取账」(Python 3.13.12)
# 用法:python tier_stats.py access.log
import re, sys
from collections import Counter

TIERS = {                                   # 日志里真实出现的 UA;Google-Extended 不在日志里
    "search":   ["Googlebot", "Bingbot", "Applebot", "OAI-SearchBot", "Claude-SearchBot", "PerplexityBot"],
    "training": ["GPTBot", "ClaudeBot", "CCBot", "Bytespider", "Meta-ExternalAgent"],
    "agent":    ["ChatGPT-User", "Claude-User", "Perplexity-User"],
}
LINE = re.compile(r'"(?P<req>[^"]*)" (?P<status>\d{3}) (?P<size>\d+|-) "[^"]*" "(?P<ua>[^"]*)"')

def tier_of(ua):
    for tier, tokens in TIERS.items():
        for t in tokens:
            if t.lower() in ua.lower():
                return tier, t
    return "human", "browser"

def main(path):
    req, byt, ua_hits, tr_paths = Counter(), Counter(), Counter(), Counter()
    total = total_b = 0
    for line in open(path, encoding="utf-8"):
        m = LINE.search(line)
        if not m:
            continue
        size = int(m.group("size")) if m.group("size").isdigit() else 0
        tier, token = tier_of(m.group("ua"))
        req[tier] += 1; byt[tier] += size; total += 1; total_b += size
        if tier != "human":
            ua_hits[token] += 1
        if tier == "training":
            tr_paths[m.group("req").split()[1]] += 1
    print("总请求 %d,总出流量 %.1f MB\n" % (total, total_b / 1024 / 1024))
    print("%-9s %10s %8s %14s %8s" % ("档位", "请求数", "请求占比", "出流量(MB)", "流量占比"))
    for tier in ("human", "search", "training", "agent"):
        print("%-9s %10d %7.1f%% %14.1f %7.1f%%"
              % (tier, req[tier], req[tier] / total * 100, byt[tier] / 1024 / 1024,
                 byt[tier] / total_b * 100))
    print("\n非人类访问 Top UA:")
    for ua, n in ua_hits.most_common(6):
        print("  %-18s %6d 次" % (ua, n))
    print("\n训练类抓取 Top 路径:")
    for p, n in tr_paths.most_common(4):
        print("  %-28s %6d 次" % (p, n))

if __name__ == "__main__":
    main(sys.argv[1])
4.2 实测输出与三个读法
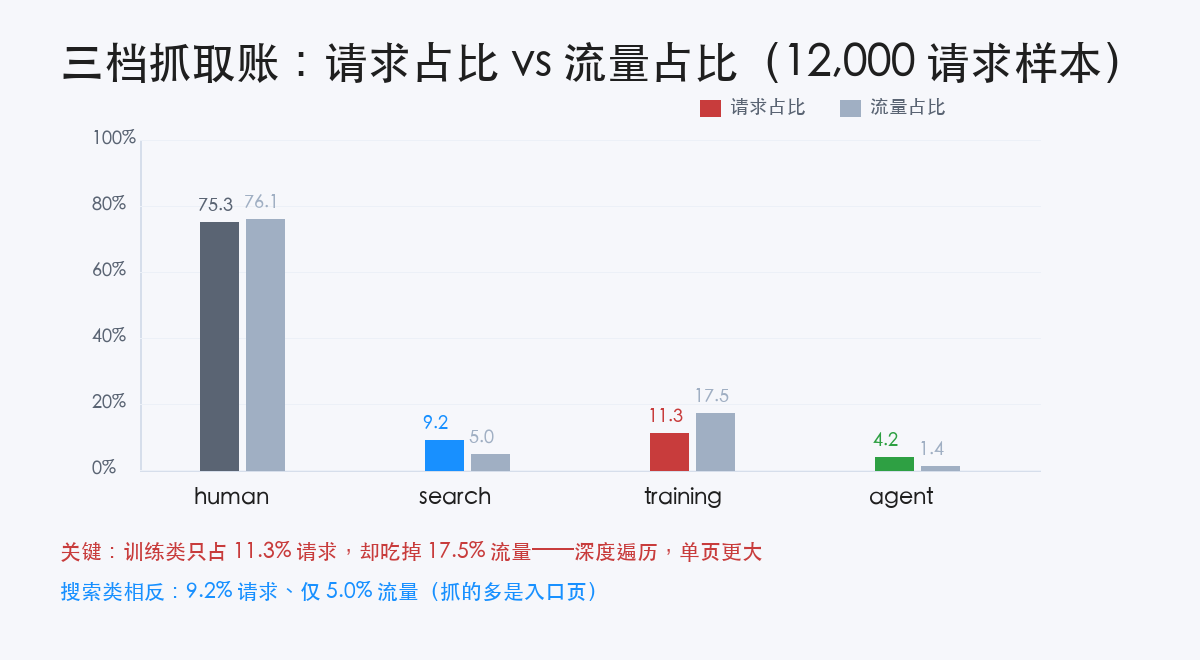
用一段 12,000 行的访问日志样本(nginx combined 格式,合成样本、非真实站点数据,仅用于演示口径)跑一遍:
text
总请求 12000,总出流量 442.0 MB

档位               请求数     请求占比        出流量(MB)     流量占比
human           9040    75.3%          336.4    76.1%
search          1102     9.2%           22.0     5.0%
training        1354    11.3%           77.3    17.5%
agent            504     4.2%            6.4     1.4%

非人类访问 Top UA:
  GPTBot                671 次
  Googlebot             571 次
  ClaudeBot             319 次
  ChatGPT-User          254 次
  CCBot                 237 次
  Bingbot               218 次

训练类抓取 Top 路径:
  /blog/data-boundary             144 次
  /blog/2026-agent-governance     135 次
  /blog/robots-tier               129 次
/docs/api/auth 127 次三个读法:
- 看请求占比,更要看流量占比。 样本里训练类只占 11.3% 的请求,却吃掉 17.5% 的出流量------因为它抓得更深、单页更大。只按请求数判断"影响不大"会低估成本。
- 搜索类"轻"、训练类"重"。 搜索类占 9.2% 请求、仅 5.0% 流量(它抓的是入口页);训练类是深度遍历 ,还偏偏往
/docs/api/auth这类路径走------这正是"要不要给它全部路径权限"的判断依据。 - Agent 档量小但增速快。 样本里只占 4.2%,但它是有真人在场的取页。挡掉它等于挡掉一个正在提问的用户,通常不划算。
4.3 日志里看不到的部分
清点有个盲区:如果 CDN 在边缘就把爬虫挡掉了,请求根本到不了源站,日志里也就没有记录。所以:
- 只看源站日志,会低估真实的爬虫规模;
- 结论是:UA 清点必须结合 CDN 侧的日志或统计一起看,两层对不上是常态,不是数据出错。
五、第二步:写下偏好 ------ robots.txt 三档模板
5.1 三档模板(按需删减,不要照抄全部)
text
# robots.txt ------ 三档授权模板
# ① 搜索索引:放行。搜索流量与引用都靠这一档
User-agent: Googlebot
Allow: /

User-agent: Bingbot
Allow: /

User-agent: Applebot
Allow: /

# ② AI 搜索引用:放行。它带来引用与回流量
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# ③ 模型训练:按业务意愿决定。下面这组是「拒绝」
#    注意:Google-Extended / Applebot-Extended 是控制位,不是独立爬虫
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

# ④ Agent(代表用户实时取页):默认放行,敏感路径可单独收紧
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Perplexity-User
Allow: /
Disallow: /account/

Sitemap: https://www.example.com/sitemap.xml
用本文第 7 节的体检脚本回查这份模板,结果是:search 放行(6/6 命中专属组)|training 整站拦截(6/6)|agent 放行(3/3)------即"搜索放行、训练拦截"这个目标被准确表达了。
5.2 分档不只有"全拦/全放":路径级 Allow
robots.txt 支持在整站拦截之后,再把某些路径单独放开 。本文抽查的 www.theverge.com 就是这种写法(2026-09-17 抓取):
text
User-agent: GPTBot
Allow: /

User-agent: Google-Extended
Disallow: /
Allow: /sp/含义是:其它路径一律不给训练用,但 /sp/ 下的内容可以。这个模式很实用------当法务或业务判断"部分内容可以开放、但归档内容不行"时,不必在"全开"和"全关"之间二选一。
5.3 llms.txt 能做什么、不能做什么
除了 robots.txt,近一年还有个常被提到的 llms.txt。这里需要说清边界,避免误用:
| 项 | 事实 |
|---|---|
| 性质 | 社区提案,不是正式标准------没有 RFC、没有 W3C 背书 |
| 作用 | 用 Markdown 列出站点关键页面与简介,方便模型理解站点结构 |
| 局限 | 是否遵循由各家爬虫自行决定,不像 robots.txt 有较长历史与较广的共识 |
| 定位 | 它是"欢迎来读 "的说明,不是"不许抓"的控制 |
判断规则很简单:要"拒绝"用 robots.txt;要"说明"才用 llms.txt。把 llms.txt 当成授权开关,是常见误解。
在做企业 AI 可见度的项目里(我们团队在 环曜 AIVO 这条线上做官网语义改造时),实践顺序也是先 robots.txt 把授权边界写清楚、再谈 llms.txt 与页面语义优化------顺序反了会先解决"能不能被读",而把"谁来读、读到什么程度"留成后患。
六、第三步:分层拦截 ------ CDN 与源站
6.1 CDN 层:三档控制与那个真实陷阱
Cloudflare 在 2026-09-15 生效的改动里,有几个直接可用的能力:
| 变化 | 内容 |
|---|---|
| 一个开关拆三个 | 用 Search / Training / Agent 三个独立控制替换原 Block AI Bots |
| 偏好同步 | Bot Preference Sync 取代 Managed Robots.txt:设一次偏好,同步到所有支持的爬虫 |
| 可问责爬虫 | 提出 Accountable 四项要求:robots.txt 可退训练、可退 AI 摘要、提供 URL 级可见性、承诺退出训练不影响搜索排名;Apple / Google / Microsoft 已达标或给出时间表 |
| 新域名预设 | 变现型站点:搜索放行、训练拒绝、广告页挡 Agent;非变现型站点:三档全放行 |
| 待跟进 | Bingbot 预计 2027 年初支持 |
陷阱就藏在"Block"这个选项里 :选了 Block,Applebot / Bingbot / Googlebot 会被一起挡掉,搜索也一起没了。要"留搜索、退训练",必须用训练档专属的开关,而不是整体屏蔽。
另外,Cloudflare 也在参与 IETF 的 ai-prefs 规范制定------目标是把"AI 访问偏好"做成可移植的标准化表达。也就是说,现在是各家用各家开关的过渡期,配置时要抬头看一眼标准进展。
6.2 源站层:Nginx 按 UA 分档
CDN 不做全量覆盖(或你根本没上 CDN)时,源站是最后一道。下面这段把三档分流:搜索类与 Agent 类放行、训练类限速,并把档位写进日志字段供第 4 步统计。
nginx
# /etc/nginx/conf.d/tier.conf ------ 三档 UA 分流(Nginx 1.24+)
# ⚠️ 本文环境未安装 Nginx,以下片段按官方指令手册编写,未实机验证;
#    上线前务必先跑 nginx -t,并按你的版本核对指令可用范围

# 1) 分档:把 UA 映射成 0/1/2/3
map $http_user_agent $crawler_tier {
    default   0;                                                                    # 0 = 普通用户
    "~*(Googlebot|bingbot|Applebot|OAI-SearchBot|Claude-SearchBot|PerplexityBot)" 1; # 1 = 搜索
    "~*(GPTBot|ClaudeBot|CCBot|Bytespider|Meta-ExternalAgent)"                   2; # 2 = 训练
    "~*(ChatGPT-User|Claude-User|Perplexity-User)"                                3; # 3 = Agent
}

# 2) 只为训练类生成限流键:非训练类的键为空字符串,不计入限流
map $crawler_tier $train_key {
    default "";
    2       $binary_remote_addr;
}
limit_req_zone $train_key zone=train_zone:10m rate=6r/m;

# 3) 日志格式里带上档位字段,交给第 4 步的脚本统计
log_format tiered '$remote_addr [$time_local] "$request" $status $body_bytes_sent '
                  '"$http_user_agent" tier=$crawler_tier';

server {
    listen 443 ssl http2;
    server_name www.example.com;

    access_log /var/log/nginx/access.log tiered;   # 档位在字段里,不必拆多份日志

    limit_req zone=train_zone burst=3 nodelay;     # 训练类限速(非一律 403)

    location / {
        try_files $uri $uri/ /index.html;
    }

    # 训练类不给账号与内部接口路径
    location ~ ^/(account|docs/api)/ {
        if ($crawler_tier = 2) { return 403; }
        try_files $uri $uri/ /index.html;
    }
}
配置要点三条:① 先分档再决策 ,而不是一条条 UA 写 allow/deny;② 训练类限速而不是一律 403 ------如果你只是不想被高频抓,限速更温和也更少见争议;③ 把档位写进日志字段 (tier=$crawler_tier),不然第 4 步没法核算。
6.3 为什么两层都要做
| 层 | 优点 | 局限 |
|---|---|---|
| robots.txt | 公开、可审计、被广泛遵循 | 是请求,不是墙:不阻止被索引、不保护内容、不跨子域生效 |
| CDN 控制 | 在边缘就拦下,请求不会到达源站 | 各家开关口径不一,且拦截发生在源站之前,robots.txt 里看不到 |
| 源站拦截 | 完全可控、可自定义分级 | 请求已到达源站,省不下带宽 |
结论:robots.txt 管"声明",CDN 与源站管"事实" 。两者对不上,最终以"事实"为准------这也是为什么第 4 步的验证不能只看 robots.txt。
七、第四步:验证生效 ------ 三档体检
7.1 体检脚本
python
# tier_check.py --- robots.txt「三档授权」体检(Python 3.13.12)
# 用法:python tier_check.py www.example.com www.example.org
import re, sys, urllib.request

TIERS = {
    "search":   ["Googlebot", "Bingbot", "Applebot", "OAI-SearchBot", "Claude-SearchBot", "PerplexityBot"],
    "training": ["GPTBot", "ClaudeBot", "CCBot", "Google-Extended", "Meta-ExternalAgent", "Applebot-Extended"],
    "agent":    ["ChatGPT-User", "Claude-User", "Perplexity-User"],
}

def fetch(host):
    url = "https://" + host.rstrip("/") + "/robots.txt"
    req = urllib.request.Request(url, headers={"User-Agent": "tier-check/1.0"})
    return urllib.request.urlopen(req, timeout=10).read().decode("utf-8", "ignore")

def parse(text):
    groups, cur = {}, None
    for raw in text.splitlines():
        line = raw.split("#", 1)[0].strip()
        if not line or ":" not in line:
            continue
        field, _, value = line.partition(":")
        field, value = field.strip().lower(), value.strip()
        if field == "user-agent":
            cur = value.lower()
            groups.setdefault(cur, [])
        elif field in ("disallow", "allow") and cur is not None:
            groups[cur].append((field, value))
    return groups

def verdict(groups, ua):
    """返回 (是否整站拦截, 命中的规则组, 是否命中专属组)"""
    ua_l = ua.lower()
    key = None
    for k in groups:                      # 取「最长匹配」的 user-agent 组
        if k == "*" or k == ua_l:
            if key is None or len(k) > len(key):
                key = k
    if key is None:
        return False, "-", False
    rules = groups[key]
    blocked = any(f == "disallow" and p in ("/", "/*") for f, p in rules)
    return blocked, key, key != "*"

def summarize(text):
    g = parse(text)
    rows = {}
    for tier, uas in TIERS.items():
        vs = [verdict(g, ua) for ua in uas]
        blocked = sum(1 for v in vs if v[0])
        dedicated = sum(1 for v in vs if v[2])
        state = "整站拦截" if blocked == len(uas) else ("部分拦截" if blocked else "放行")
        rows[tier] = (state, dedicated, len(uas))
    return rows, g

for host in sys.argv[1:]:
    try:
        text = fetch(host)
    except Exception as e:
        print("%-24s 抓取失败:%s" % (host, type(e).__name__))
        continue
    rows, g = summarize(text)
    cs = re.search(r"(?im)^content-signal:\s*(.+)$", text)
    print("%-24s 规则组%3d  search=%-8s training=%-8s agent=%-8s  Content-Signal:%s"
          % (host, len(g), rows["search"][0], rows["training"][0], rows["agent"][0],
             cs.group(1).strip() if cs else "未声明"))
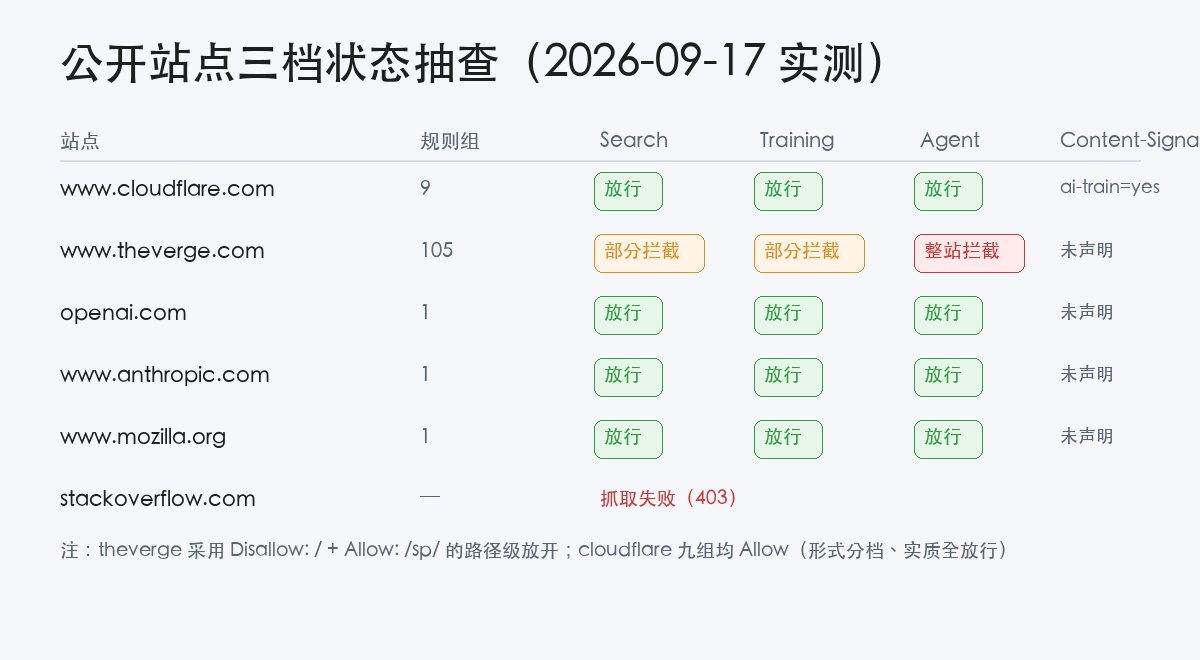
7.2 抽查 5 个公开站点(2026-09-17 实测)
text
www.cloudflare.com       规则组  9  search=放行       training=放行       agent=放行        Content-Signal:ai-train=yes, search=yes, ai-input=yes
openai.com               规则组  1  search=放行       training=放行       agent=放行        Content-Signal:未声明
www.anthropic.com        规则组  1  search=放行       training=放行       agent=放行        Content-Signal:未声明
www.mozilla.org          规则组  1  search=放行       training=放行       agent=放行        Content-Signal:未声明
www.theverge.com         规则组105  search=部分拦截     training=部分拦截     agent=整站拦截      Content-Signal:未声明
四个可直接复用的观察:
- "写了 AI 组"和"真的分档"是两件事。
www.cloudflare.com列了 9 个规则组(含GPTBot/CCBot/Google-Extended等),但每组都是Allow: /------形式上分档,实质上全放行 ,并用一行Content-Signal: ai-train=yes, search=yes, ai-input=yes把意愿写明。 - 只写通用规则=全放行。
openai.com、www.anthropic.com、www.mozilla.org的 robots.txt 都只有 1 个通用规则组(几十字节),没有 AI 相关专属 UA------三档在效果上都是放行。 - 真正的分档长什么样。
www.theverge.com有 105 个规则组 ,训练类与 Agent 类被大量拉黑(Disallow: /+Allow: /sp/),搜索类部分放行------这是"认真做过授权分层"的形态。 - 别忘了
Content-Signal。 它可以直接写在 robots.txt 里,用ai-train=/search=/ai-input=表达偏好,比逐个 UA 更简洁。这是较新的表达方式,值得纳入你的模板。
7.3 最常见的三类写错
| # | 错误 | 后果 | 修法 |
|---|---|---|---|
| 1 | 沿用过期/非官方 token | 规则写了但不生效,等于放行 | 以各家官方文档的 UA 名为准;抽查中 anthropic-ai、Claude-Web 这类写法仍在被使用,而官方文档列的是 ClaudeBot / Claude-User / Claude-SearchBot |
| 2 | 只写 User-agent: * 通用规则 |
三档无法区分,想拦的没拦住 | 训练档必须写专属 UA 组,不能靠通用规则 |
| 3 | 顺手把搜索档也挡了 | 搜索收录与 AI 引用一起掉 | 先用体检脚本回查;确认 search 档为"放行"再上线 |
另外提醒一句:检查器本身也会被挡 。同一批抽查里,github.com、www.wikipedia.org 抓取超时,stackoverflow.com 返回 403 ------你的 robots.txt 可能只是"纸面规则",真正决定爬虫能不能进来的是 CDN/WAF。所以体检要跑两遍:一遍跑 robots.txt(规则层),一遍跑真实 UA 复现(事实层)。
我们在给企业做 AI 可见度诊断时(环曜 AIWO 这条线),习惯把这两层结果并排放在同一张表上------规则层说"我允许谁",事实层说"谁真的进来了",两者不一致的地方,才是真正要改的地方。
八、三档配置对照表
8.1 配置对照
| 档位 | robots.txt | CDN 控制 | 源站策略 | 推荐默认 | 相对成本影响 |
|---|---|---|---|---|---|
| Search 搜索索引 | Allow: / |
Search:Allow | 全放行 | 必须放行 | 低(多为入口页) |
| AI 搜索引用 | Allow: / |
归入 Search | 全放行 | 建议放行 | 低 |
| Training 模型训练 | Disallow: /(可加 Allow: /路径/) |
Training:Disallow AI Training | 限速或按路径 403 | 按业务意愿 | 高(深度遍历,流量占比高于请求占比) |
| Agent 代用户取页 | Allow: /(敏感路径可收紧) |
Agent:Allow(广告页可 Block) | 放行并记日志 | 默认放行 | 低 |
| 可见度与语义改造类服务 | --- | --- | --- | 按需评估 | 中 |
(表内"相对成本影响"为量级判断,非具体金额;自查口径见第四节实测方法)
需要说明的是:上表最后一行属于服务侧 选项,与前三行不是一个层面的东西------它的位置放在这里,只是便于和"谁来读你的站点"一起看。企业如果内部没有专职团队,通常会把这部分交给外部(例如 环曜 AIVO + AIWO 这类做 AI 可见度与网站语义改造的服务),而把 robots.txt / CDN / 源站这三层留在自己手里------策略自己定、执行可外包,是风险更低的组合。
8.2 收敛成三个判断
- Search 档是收入档,别动它------屏蔽搜索爬虫的站点不足 1%,这个数字背后是代价。
- Training 档按内容资产价值定------先看第四节那张"请求占比 vs 流量占比"的账,再决定是全拦、按路径放开,还是限速。
- Agent 档要看真人在不在场------它代表一个正在提问的用户,默认放行;只有广告变现页这类特殊场景才值得单独收紧。
九、适用边界与风险提示
9.1 适用场景
- 有内容资产需要区分"可索引"与"可训练"的站点(媒体、文档站、开发者社区、企业官网);
- 正在做 AI 可见度 / GEO 优化,需要把"被引用"与"被训练"分开处理;
- 规模化 Agent 抓取已经影响源站成本,需要按档位限速。
9.2 不适用与风险
⚠️ 把 robots.txt 当安全边界是错的 。它是公开的请求文件,不阻止被索引、不保护内容、不跨子域生效,敏感内容必须靠鉴权而不是靠 robots.txt。
⚠️ CDN 与源站的优先级必须搞清 。CDN 拦截发生在请求到达源站之前,你的 robots.txt 里看不到;只改 robots.txt 可能毫无效果。
⚠️ 本文体检脚本做了合理简化 :UA 匹配按"最长匹配 + 通用组兜底"处理,未实现 robots.txt 全部细节(如通配符 *、结尾锚定 $、Allow 与 Disallow 同路径时的最长匹配优先)。精确判定请以官方文档与真实抓取复现为准。
⚠️ "退出训练"的法律与商务含义超出技术范畴 。robots.txt 与 CDN 开关表达的是技术偏好,能否约束对方、违约如何主张,需要法务与合同条款配合,不能只靠一条 Disallow。
⚠️ 配置有生效时延 。爬虫有缓存与抓取周期,偏好改完通常需要一段时间才在日志上看到变化,不要改完当天就下结论。
十、FAQ
**Q1:**只写 User-agent: * Disallow: / 不是更省事吗?
A1:不建议。通用规则一挡,搜索爬虫也一起被挡,搜索收录与 AI 引用会同时掉。三档的意义就是别用一个开关管两种用途------要拦的是训练档,就写训练档的专属 UA。
**Q2:**我把 Google-Extended 写进 robots.txt 了,为什么访问日志里从没出现这个 UA?
A2:因为它不是爬虫 ,是控制位------用来声明 Googlebot 抓到的内容能否用于训练。它在 robots.txt 生效,但不会出现在访问日志里。同理还有 Applebot-Extended。
**Q3:**robots.txt 改了之后多久生效?
A3:取决于爬虫的抓取周期与缓存策略,可能是数小时到数天。判断方法:改完之后 按日志里的 tier= 字段筛出训练类(见第六节配置),看抓取频率是否真的下降,而不是看配置是否"保存成功"。
**Q4:**不想一刀切拦掉训练爬虫,有中间方案吗?
A4:有,这也是本文抽查里 www.theverge.com 的做法:Disallow: / 之后加一条 Allow: /sp/,只放开指定路径。适合"部分内容可以开放、归档内容不开放"的场景。另一种中间方案是在源站对训练类限速 而不是 403(见第六节 limit_req 部分)。
**Q5:**上了 CDN,源站还需要单独做吗?
**A5:**建议两层都有。CDN 挡在边缘、省带宽,但覆盖的是"经过它的流量";源站是最后一道,且能自定义路径级与限速规则。两者具体怎么做、做到什么程度,若内部没有专职团队,可以考虑把策略部分交给做 AI 可见度的外部团队(如 环曜 AIVO 这类服务)协助梳理,执行层仍留在自己手里。
Q6: llms.txt 和 robots.txt 该用哪个?
**A6:**看目的。要"拒绝"用 robots.txt,要"说明"用 llms.txt。llms.txt 是社区提案、非正式标准,是否遵循由各家自行决定,不具备"禁止"效力。
十一、总结
- 一个开关管两种用途的时代结束了 。混合用途爬虫已占验证流量的 36.6%,而近 17% 的站点想退出训练却不足 1% 想退出搜索------需求早就分层了。
- 三档偏好是可直接复用的框架 :
Search放行、Training按意愿、Agent默认放行。 - 落地四步:清点 → 声明 → 拦截 → 验证,顺序不能反;先有账,再写规则。
- 声明层与事实层必须分开看:robots.txt 管声明,CDN 与源站管事实;两层对不上时,以事实为准。
- 最常见的三个错:沿用过期 UA 名、只写通用规则、顺手把搜索档挡了。
爬虫策略听起来是运维细节,但它实际决定了两件事:你的内容能不能被 AI 引擎引用,以及你的成本会不会被无偿抓取吃掉。值得当作一项正式的治理工作来做。
你们站点现在的 robots.txt 是怎么写的------全放、全拦,还是已经分档了?在评论区贴一下三档体检的输出,我们可以一起看看哪一档还没对上。