大家好,我是一名深耕AI Agent领域的开发者。最近参与了一个医疗健康AI Agent的完整项目开发,从架构设计到生产部署踩过了无数坑。今天把整个项目的技术细节和盘托出,希望能帮到正在做Agent开发的朋友们。
如果你觉得这篇文章对你有帮助,欢迎点赞、关注、转发三连支持~后续我会持续输出更多Agent开发实战干货。
项目背景与挑战
医疗领域的AI问答系统面临着专业性、准确性、安全性三大核心挑战:
- 专业性要求极高:医学知识容不得半点错误,一个错误的回答可能直接影响用户健康
- 知识体系庞杂:中西医结合,既有现代医学文献,又有中医古籍,数据格式多样
- 用户体验敏感:用户往往带着焦虑提问,响应速度和对话体验至关重要
- 合规与追溯:医疗内容必须可追溯、可审核、可迭代优化
我们的目标是打造一个生产级医疗多模态AI Agent系统 ,基于 Multi-Agent RAG 架构,提供中西医问答、语音对话、数据飞轮等核心能力。
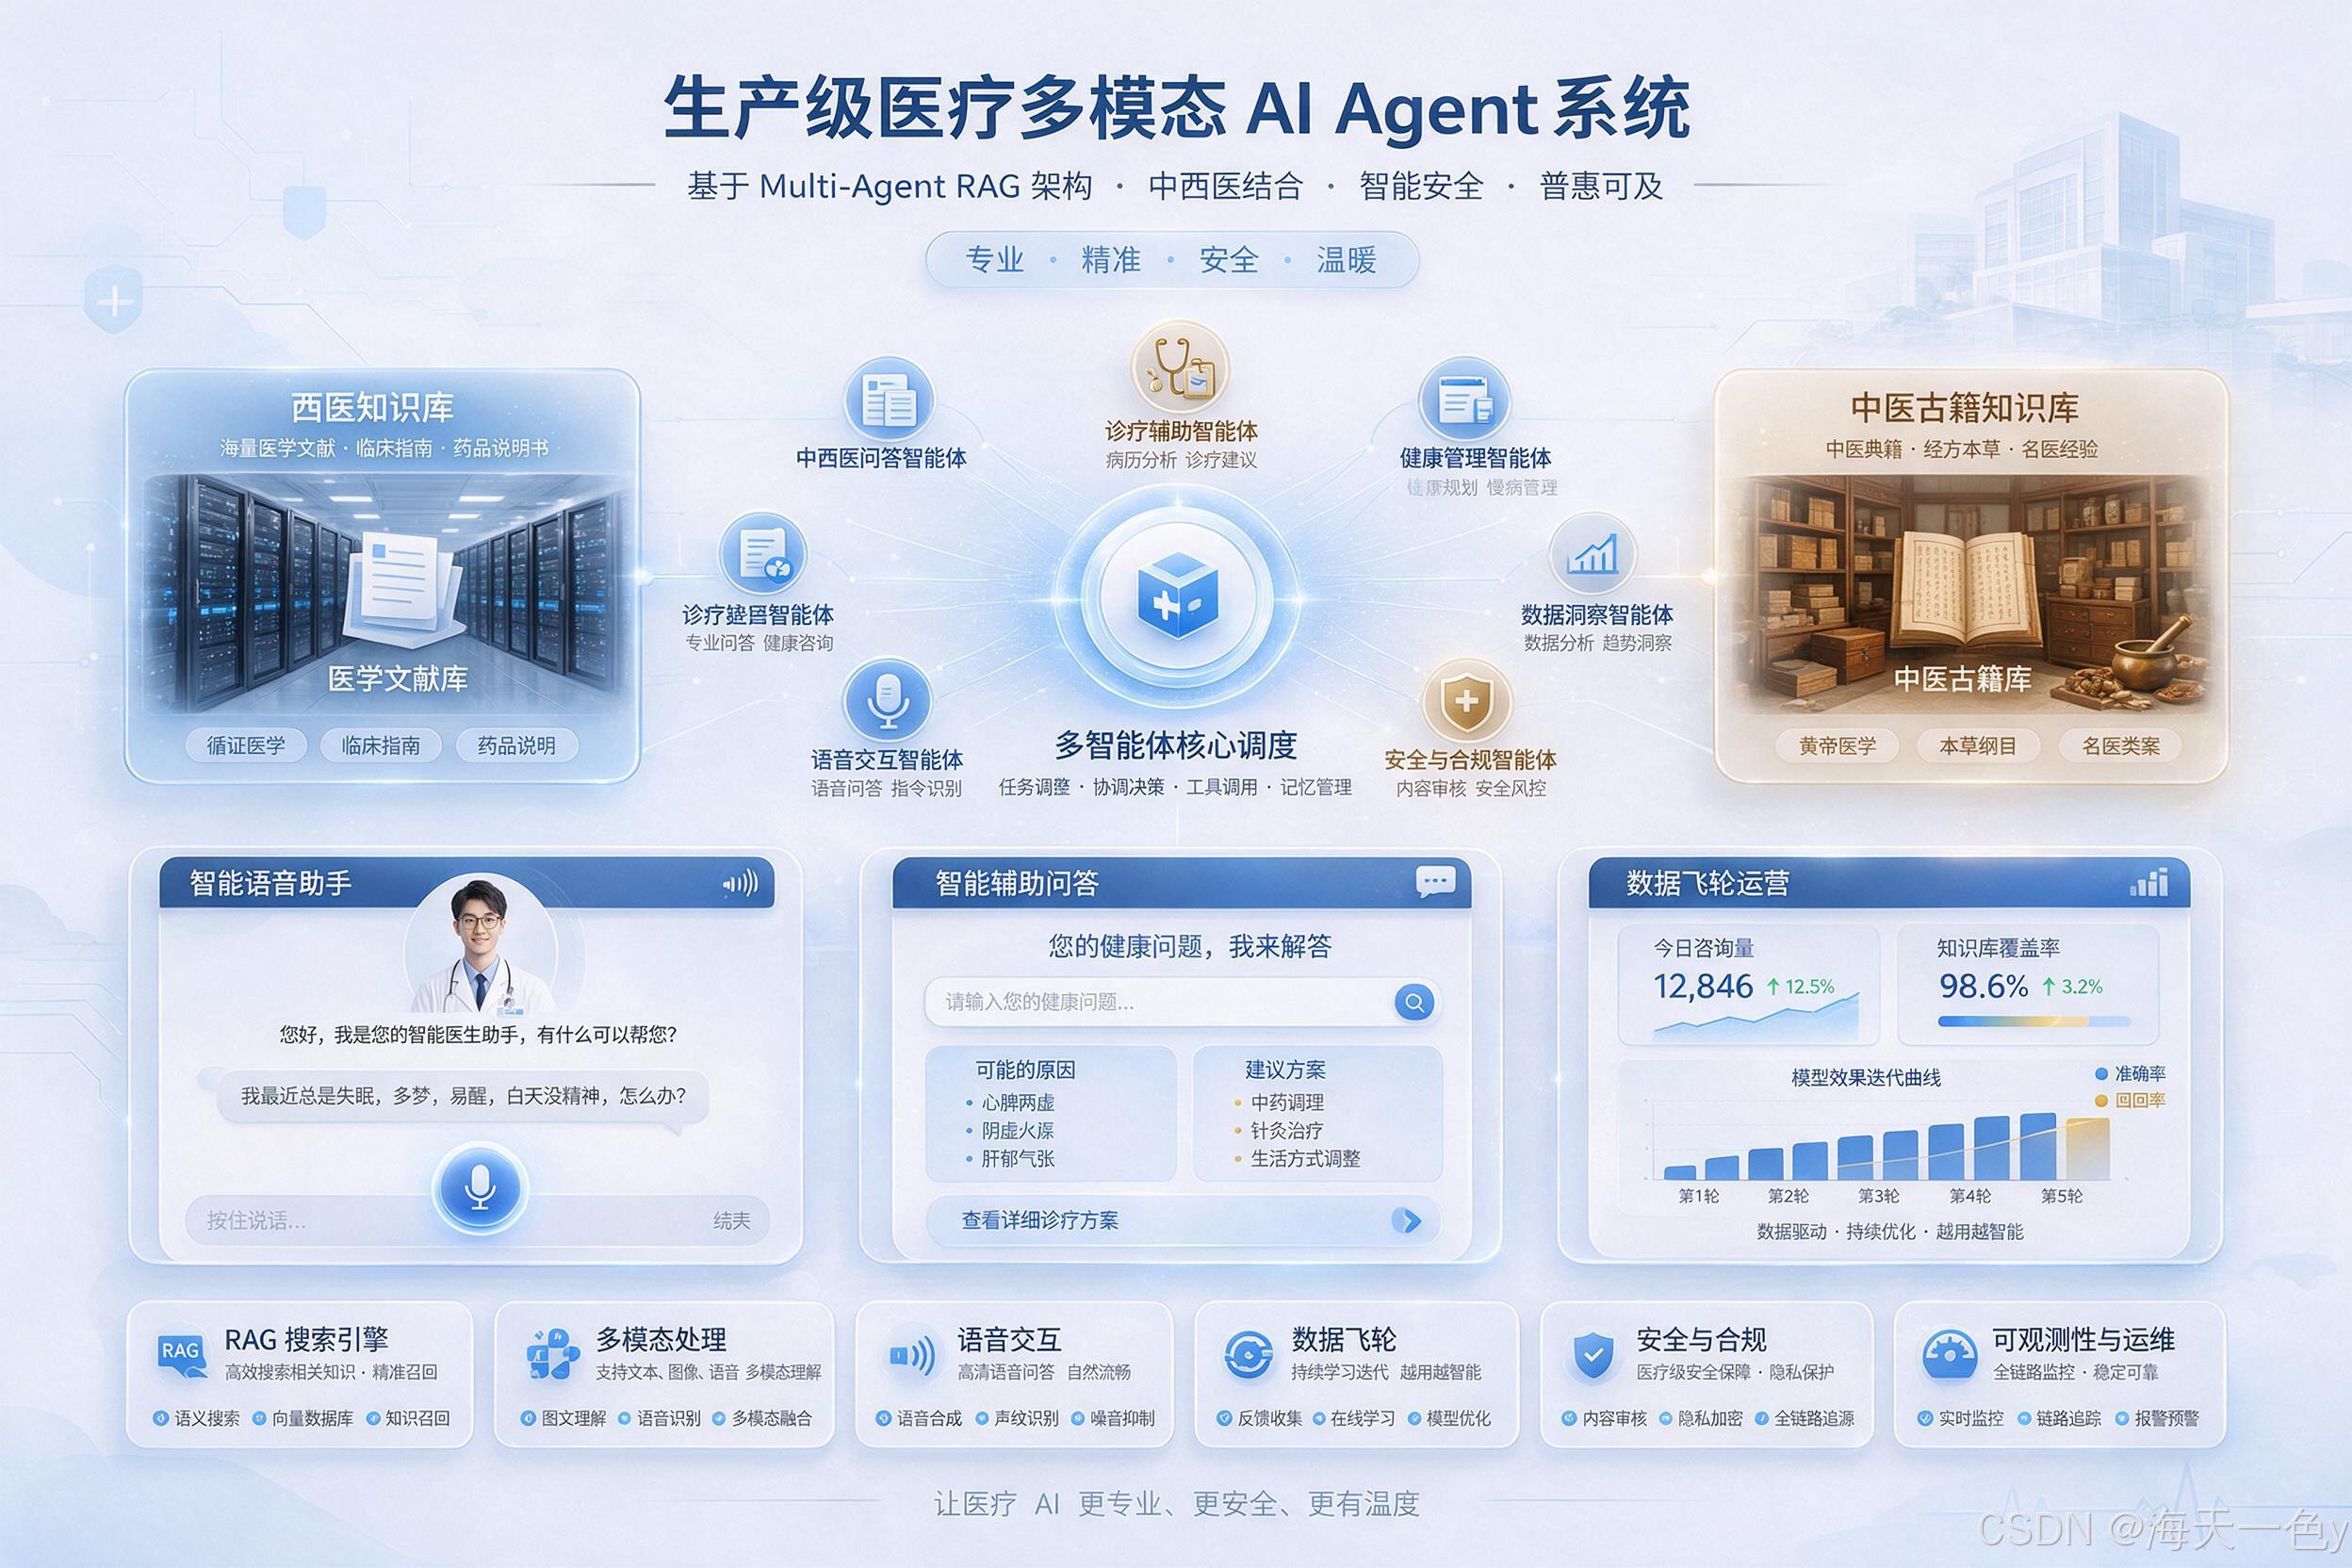
整体架构概览
整个系统采用七层分层架构,从接入层到基础设施层各司其职:
接入层 (API Layer)
  POST /chat_stream | POST / | /voice/* | /feedback | /health

中间件层 (Middleware)
  AuditMiddleware | AuthMiddleware | CORS | ExtensionRegistry

缓存层 (Cache Layer)
  Redis 三层防护: 防穿透 + 防击穿 + 防雪崩

Agent编排层 (Orchestration)
  AgentOrchestrator -> RouterAgent -> Skills -> MedicalAgent

技能层 (Skills Layer)
  knowledge_search(Milvus) | web_search_tool | extract_doc

记忆层 (Memory Layer)
  ShortTermMemory(LRU) | LongTermMemory(Redis) | Semantic

基础设施层 (Infrastructure)
  Milvus | Redis | MySQL | OSS | ASR/TTS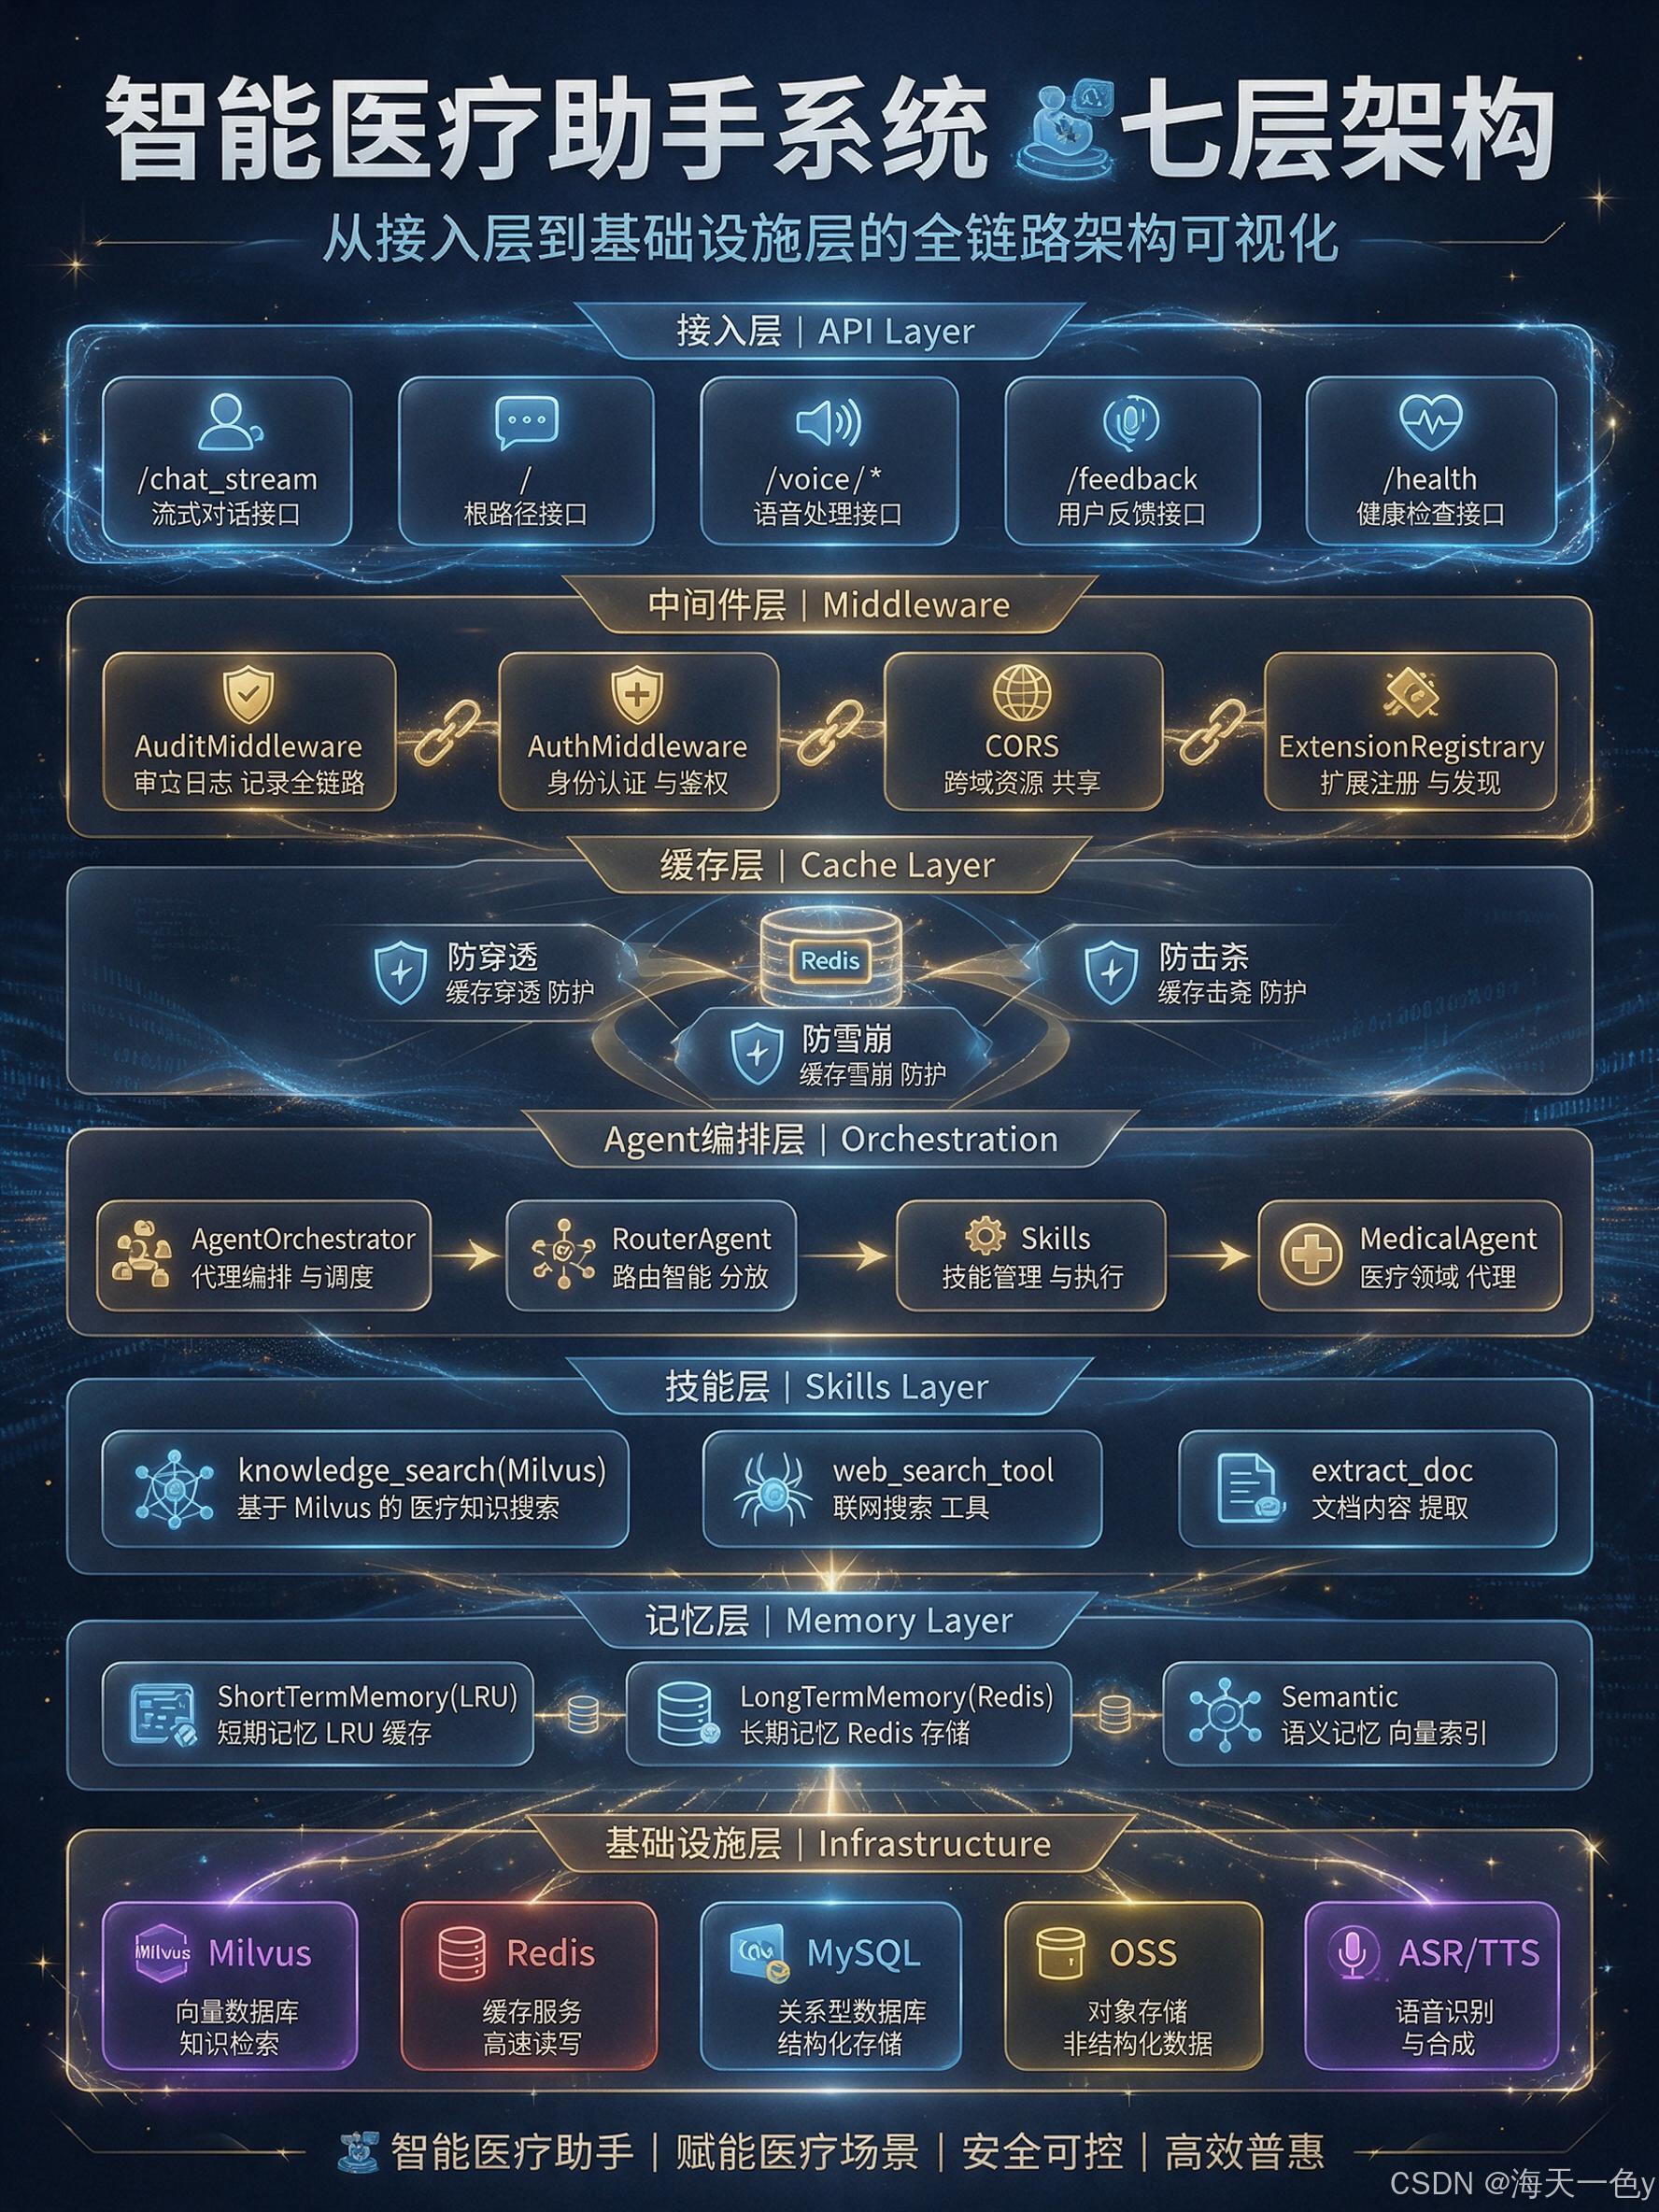
核心技术栈
| 层级 | 技术选型 |
|---|---|
| 服务框架 | FastAPI + Uvicorn(异步高性能) |
| 大模型 | DeepSeek-V4、GLM-5.2、Doubao-2.1 |
| 向量数据库 | Milvus 2.x(HNSW + BM25 混合检索) |
| 缓存 | Redis(分布式锁 + 三层防护) |
| 关系数据库 | MySQL(用户、会话、计费数据) |
| 语音 | 火山引擎 ASR/TTS、智谱 GLM-4-Voice、阶跃星辰 StepAudio 2.5 |
| 对象存储 | 阿里云 OSS |
Multi-Agent 架构深度解析
这是整个系统的核心,也是最有技术含量的部分。我们没有采用简单的单向RAG流水线,而是构建了四级Multi-Agent流水线:
RouterAgent -> Skills -> MedicalAgent -> ReflectionAgent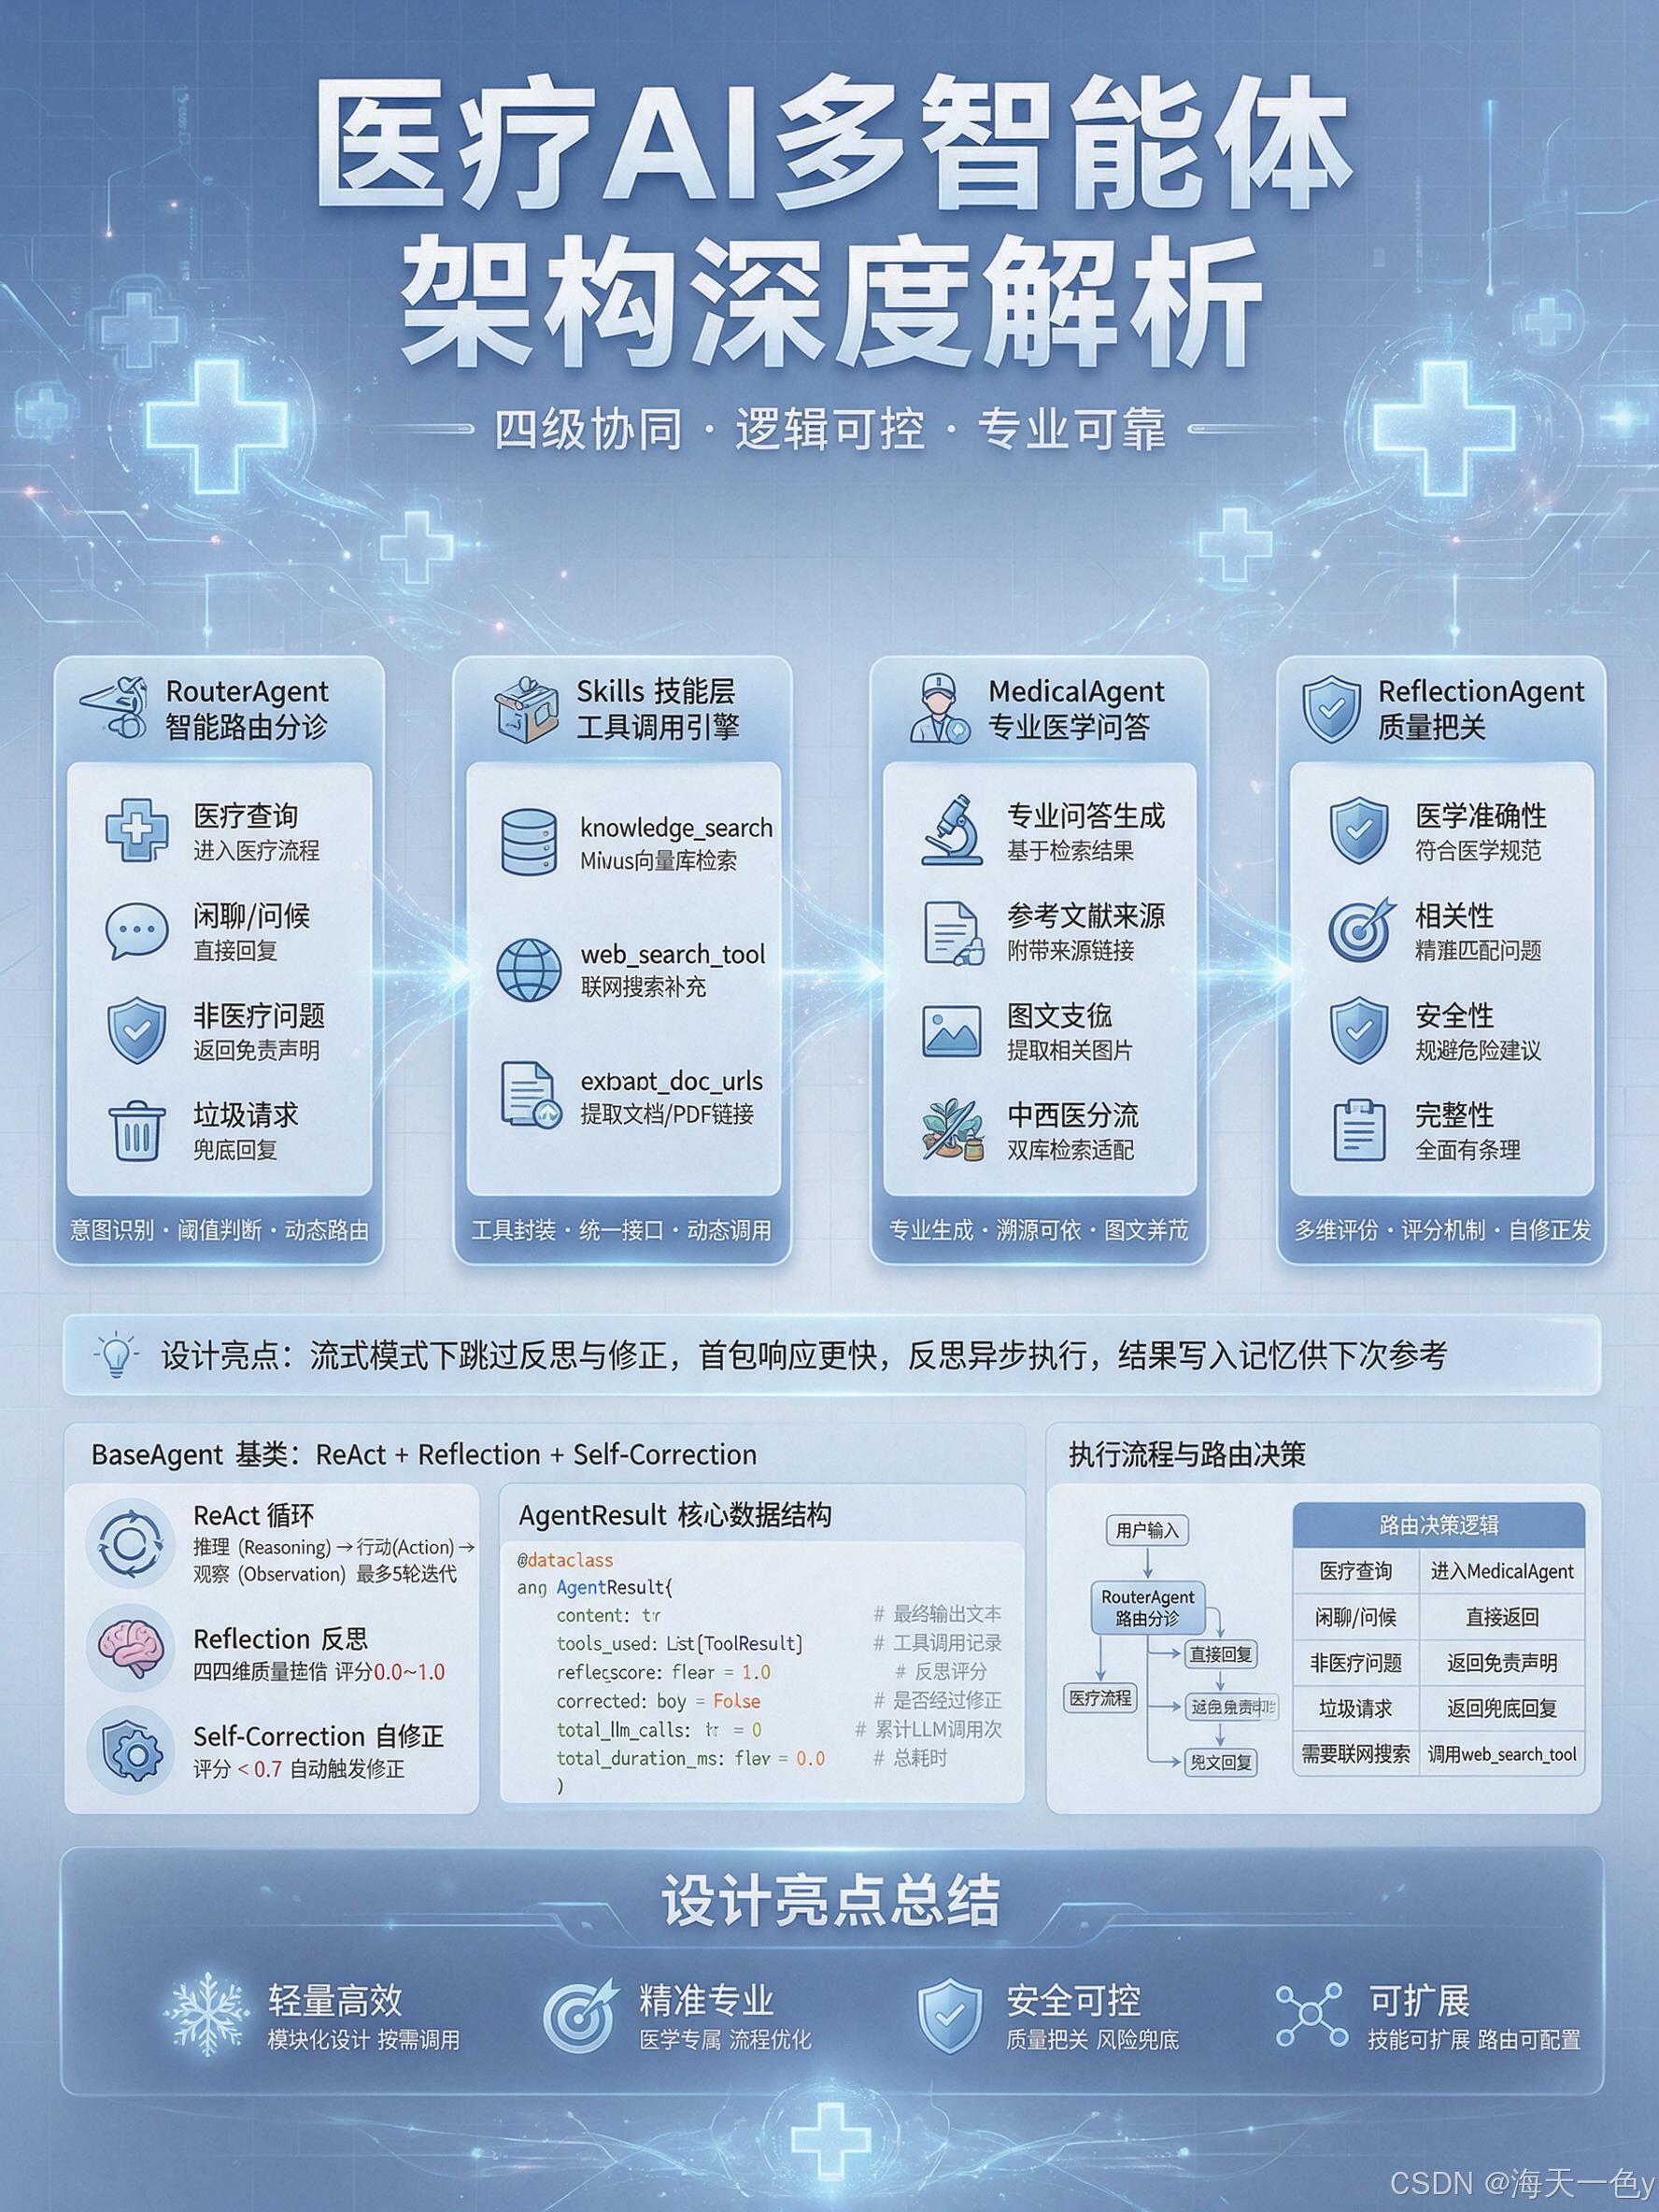
1. BaseAgent 基类:ReAct + Reflection + Self-Correction
所有Agent都继承自 BaseAgent,内置三重机制:
- ReAct 循环:推理(Reasoning) -> 行动(Action) -> 观察(Observation),最多5轮迭代
- Reflection 反思:对输出进行四维度质量评估(0.0~1.0分)
- Self-Correction 自修正:评分 < 0.7 时自动触发修正
核心数据结构:
python
@dataclass
class AgentResult:
    content: str                    # 最终输出文本
    tools_used: List[ToolResult]    # 工具调用记录
    reflect_score: float = 1.0      # 反思评分
    corrected: bool = False         # 是否经过修正
    total_llm_calls: int = 0        # 累计LLM调用次数
    total_duration_ms: float = 0.0  # 总耗时
执行流程:
run() -> Phase 1: _react_loop()
      -> Phase 2: _reflect() [可选]
-> Phase 3: _correct() [仅当 score < threshold]设计亮点:流式模式下为了优化TTFT(首token时间),会跳过反思和修正步骤,反思在流式结束后异步执行,结果写入记忆供下次参考。
2. RouterAgent:智能路由分诊
RouterAgent是系统的"门卫",负责判断用户意图:
- 医疗查询 -> 进入MedicalAgent处理
- 闲聊/问候 -> 直接返回寒暄话术
- 非医疗问题 -> 返回免责声明
- 垃圾请求 -> 返回默认兜底回复
- 需要联网搜索 -> 先调用web_search_tool再进入医疗流程
这一层虽然简单,但极其重要------它能有效拦截无关请求,节省Token成本,同时确保医疗回答的专业性。
3. Skills 技能层:工具调用引擎
Skills层封装了三类核心工具:
| 工具名称 | 功能 | 调用时机 |
|---|---|---|
knowledge_search |
Milvus向量库检索 | 所有医疗问题默认调用 |
web_search_tool |
联网搜索补充 | 需要最新医学资讯时 |
extract_doc_urls |
提取检索结果中的文档/PDF链接 | 返回参考资料时 |
RouterAgent根据意图决定调用哪些工具,工具结果以结构化方式注入MedicalAgent的上下文。
4. MedicalAgent:专业医学问答
MedicalAgent是系统的"专家",基于检索到的医学知识生成专业回答。它的核心设计原则:
- 严格基于检索结果:不凭空编造医学建议
- 给出参考文献:回答末尾附带来源文档链接
- 图文并茂:支持从检索结果中提取图片URL
- 中西医分流:现代医学和中医古籍分库检索
5. ReflectionAgent:质量把关
ReflectionAgent是系统的"质检员",从四个维度评估回答质量:
- 医学准确性:内容是否符合医学规范
- 相关性:是否真正回答了用户的问题
- 安全性:是否包含危险建议(如自行用药指导)
- 完整性:回答是否全面、有条理
评分低于0.7分自动触发Self-Correction,基于反思反馈重新生成回答。
RAG检索增强:Milvus混合检索实战
RAG的质量直接决定了Agent的回答水平。我们采用了Milvus + 混合检索 + 父子文档的方案。
1. 混合检索:HNSW + BM25 + RRF
单一路召回永远无法兼顾语义匹配和关键词匹配,我们采用三路召回融合:
用户Query -> HNSW 稠密向量检索(语义匹配)
          -> BM25 稀疏向量检索(关键词匹配) -> RRF融合 -> Top-K结果
          -> 混合检索参数调优
性能配置参数:
python
MILVUS_PERF_CONFIG = {
    "search_params": {"nprobe": 16, "ef": 64},
    "top_k": 30,
    "rerank_method": "rrf",
    "rrf_k": 60
}
2. 父子文档两级切分
这是一个非常实用的技巧------用细粒度的child块做检索,用粗粒度的parent块做上下文:
原始文档 -> parent chunk (2000字, overlap=200)
         -> child chunk  (400字,  overlap=50)  <- 用于检索
         -> child chunk  (400字,  overlap=50)  <- 用于检索
为什么这么做?
- Child块:粒度细,语义单一,检索更精准
- Parent块:上下文完整,给LLM的信息更充分
- 检索用child,返回用parent:精准与完备兼得
3. 多源数据入库
系统支持三类数据源入库:
| 数据类型 | 来源 | 处理方式 |
|---|---|---|
| JSONL问答对 | 结构化医学QA | 文生图配图 -> OSS转存 -> Milvus入库 |
| PDF文献 | 医学论文/指南 | PDF转TXT -> 父子切分 -> 上传OSS -> 入库 |
| TXT古籍 | 中医经典 | 元数据解析(书名/作者/朝代)-> 父子切分 -> 入库 |
文生图配图方案
对于JSONL问答数据,我们用豆包的文生图模型为每条数据生成配套医学图片:
python
def generate_image_from_text(ark_client, text):
    template = f"""请根据以下文本描述生成一张医学展示图片:
    {text}
    图片内容应与描述高度相关,风格属于科学性质,
    用于医疗领域的展示,细节丰富,内容严谨。"""

    response = ark_client.images.generate(
        model="doubao-seedream-5-0-260128",
        prompt=template,
        size="2K",
        response_format="url",
        output_format="png",
        watermark=False,
    )
    return response.data[0].url
生成的图片先从火山云下载到本地,再转存到阿里云OSS,确保数据长期可控。
Redis三层缓存防护:高并发的底气
医疗Agent上线后,缓存就是你的生命线。我们在Redis层面构建了三层防护体系 ,应对各种缓存异常场景。
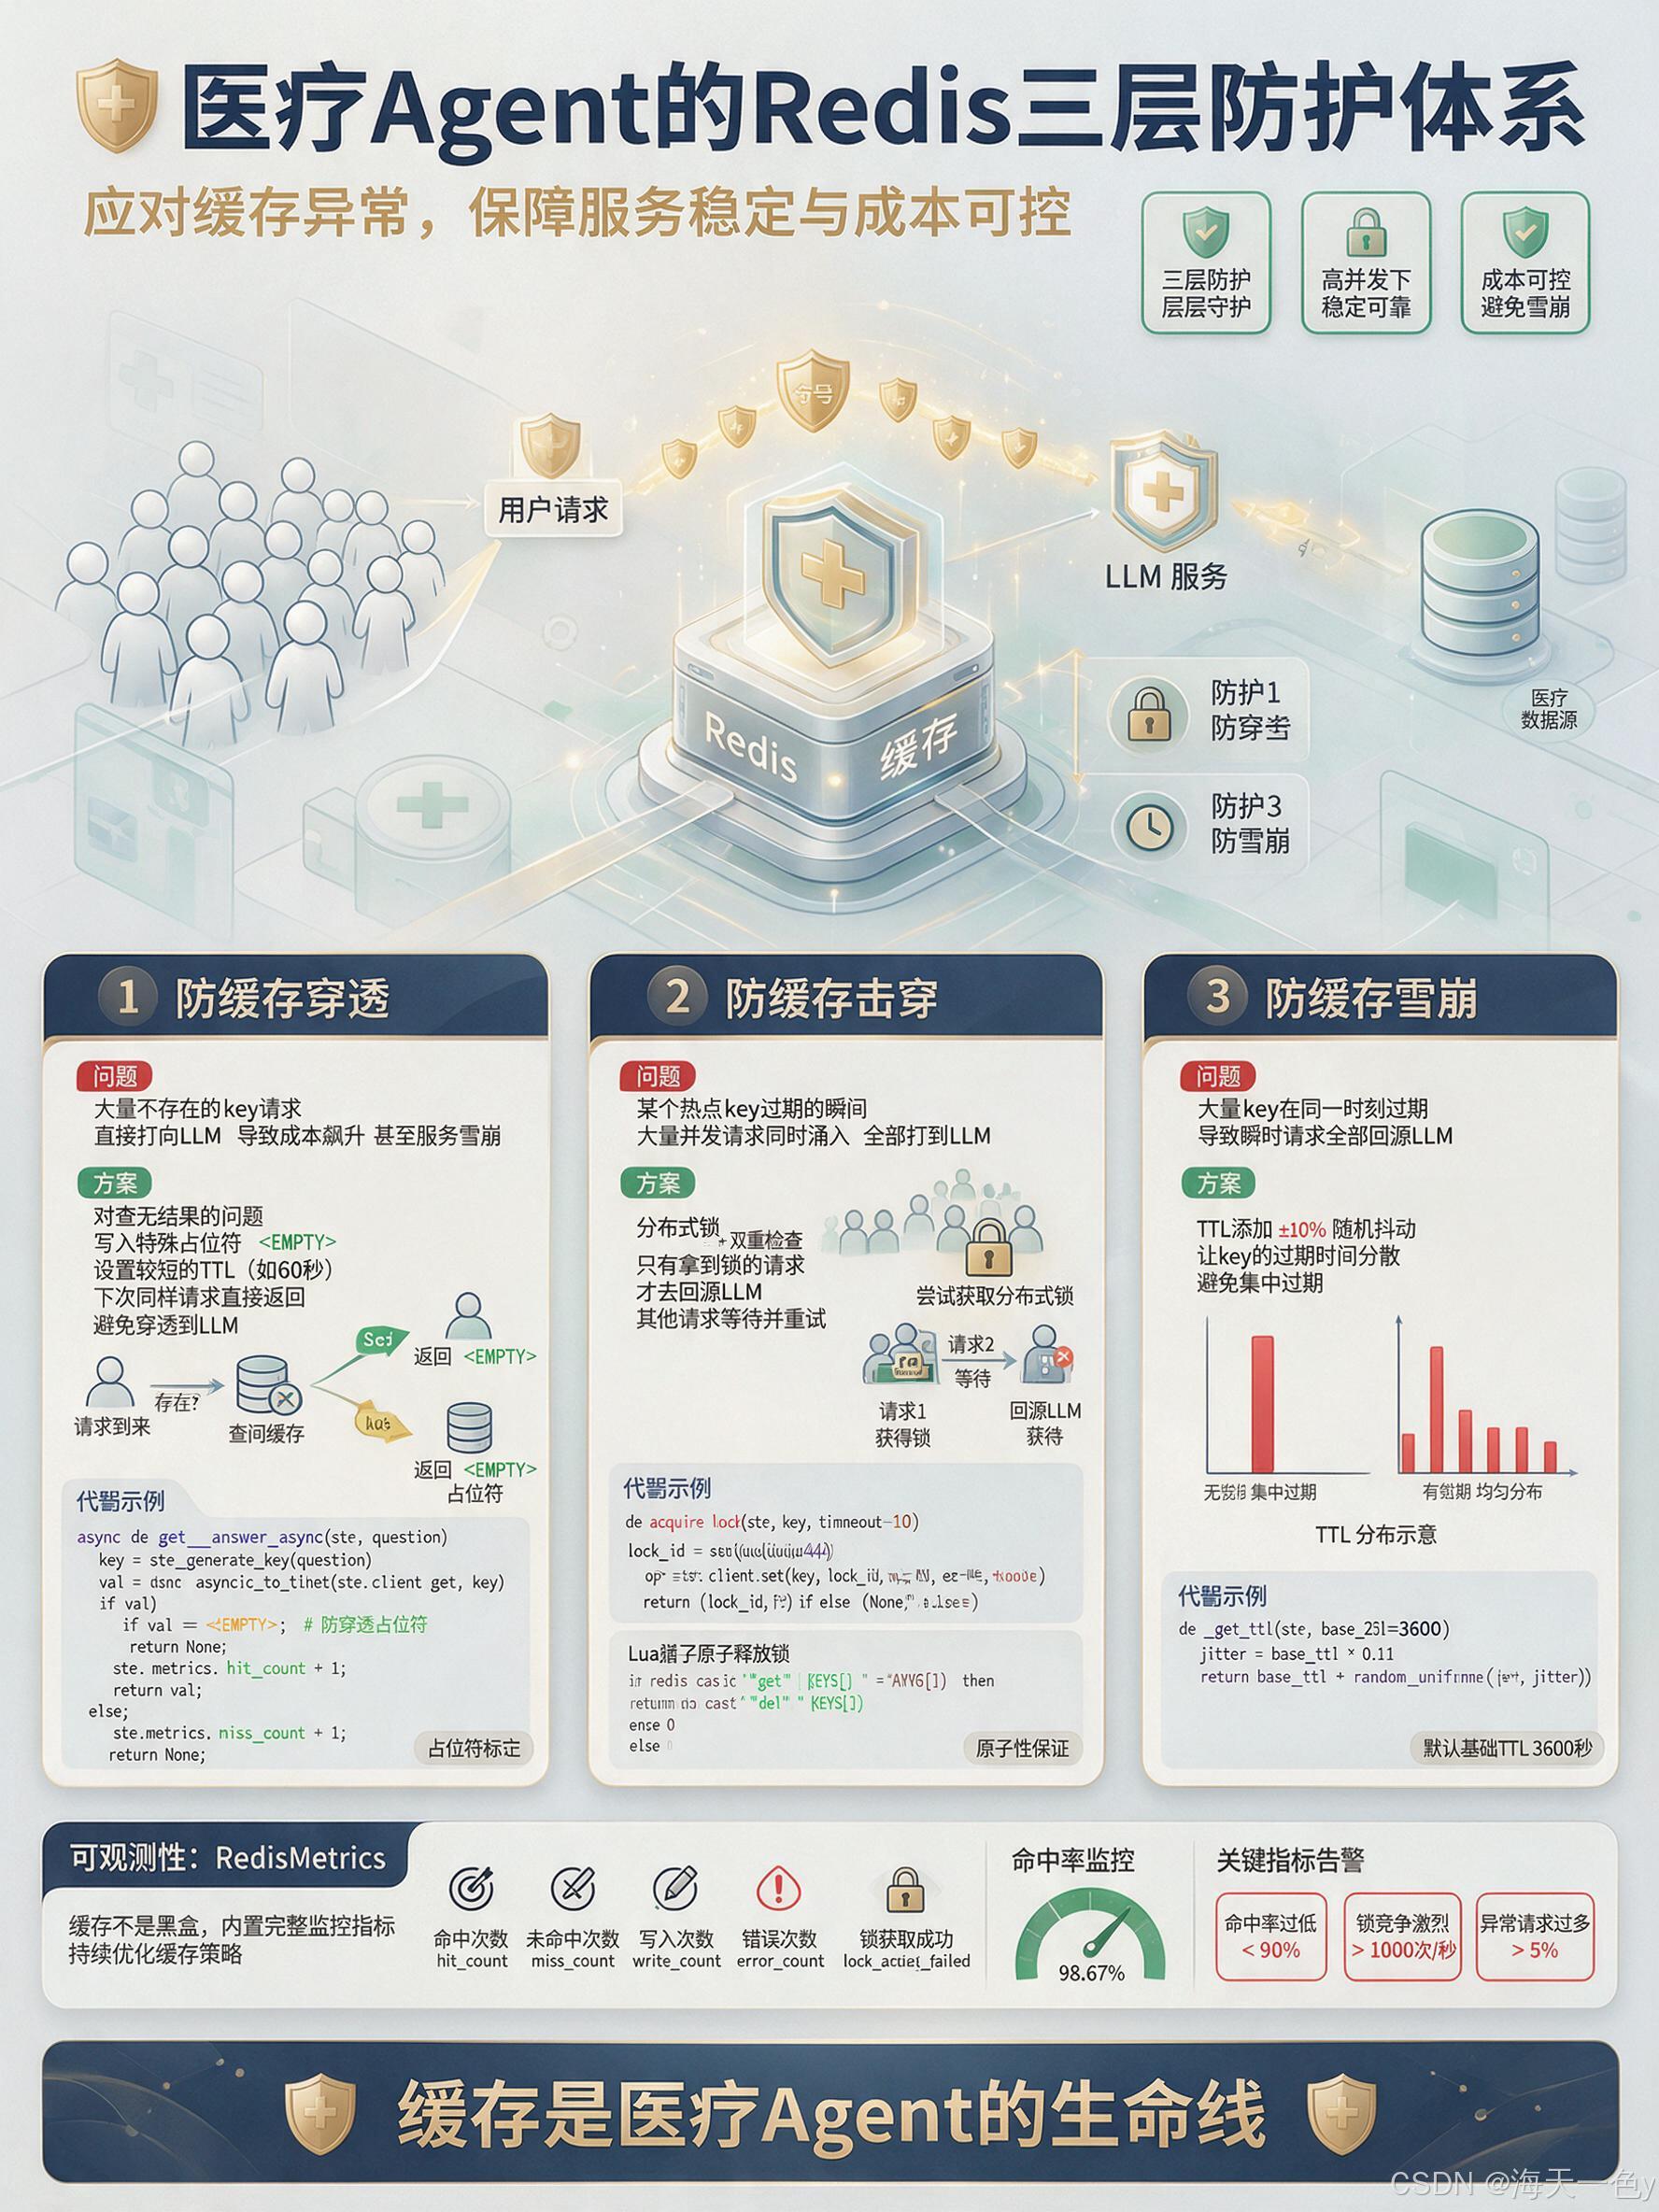
1. 防缓存穿透
问题:大量查询不存在的key,请求直接打到LLM,导致成本飙升甚至服务雪崩。
方案 :对于查无结果的问题,写入一个特殊的占位符 <EMPTY>,设置较短的TTL(如60秒)。下次同样的问题再来,直接从缓存命中占位符返回None,不会穿透到LLM。
python
async def get_answer_async(self, question):
    key = self._generate_key(question)
    val = await asyncio.to_thread(self.client.get, key)
    if val:
        if val == "<EMPTY>":  # 防穿透占位符
            return None
        self.metrics.hit_count += 1
        return val
    else:
        self.metrics.miss_count += 1
        return None
2. 防缓存击穿
问题:某个热点key过期的瞬间,大量并发请求同时涌入,全部打到LLM。
方案:分布式锁 + 双重检查。当缓存未命中时,先尝试获取分布式锁,只有拿到锁的请求才去回源LLM,其他请求等待并重试缓存。
python
def acquire_lock(self, key, timeout=10):
    lock_id = str(uuid.uuid4())
    ok = self.client.set(key, lock_id, nx=True, ex=timeout)
return (lock_id, True) if ok else (None, False)Lua脚本原子释放锁:用Lua脚本保证"判断锁归属 + 删除锁"的原子性,避免误删别人的锁。
lua
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
else
    return 0
end
3. 防缓存雪崩
问题:大量key在同一时刻过期,导致瞬时请求全部回源LLM。
方案:TTL添加 ±10% 随机抖动。比如基础TTL是3600秒,实际每个key的TTL在 3240~3960 秒之间随机分布,避免集中过期。
python
def _get_ttl(self, base_ttl=3600):
    jitter = base_ttl * 0.1
    return base_ttl + random.uniform(-jitter, jitter)
4. 可观测性:RedisMetrics
缓存不是黑盒,我们内置了完整的监控指标:
python
@dataclass
class RedisMetrics:
    hit_count: int = 0       # 命中次数
    miss_count: int = 0      # 未命中次数
    write_count: int = 0     # 写入次数
    error_count: int = 0     # 错误次数
    lock_acquired: int = 0   # 成功获取锁次数
    lock_failed: int = 0     # 获取锁失败次数

    @property
    def hit_rate(self) -> float:
        total = self.hit_count + self.miss_count
        return round(self.hit_count / total, 4) if total > 0 else 0.0
通过命中率、锁竞争频率这些指标,你可以持续优化缓存策略。
语音全链路:ASR -> RAG -> TTS 端到端流式
只做文本问答的Agent已经不够了,语音交互是用户体验的质变。
全链路架构
用户语音 -> ASR(语音转文字) -> RAG检索 -> LLM生成 -> TTS(文字转语音) -> 用户收听支持的语音服务:
- ASR:火山引擎、阶跃星辰 StepASR 1.1
- TTS:火山引擎、智谱 GLM-4-Voice、阶跃星辰 StepAudio 2.5
流式体验优化
语音场景下,延迟感知比文本更强。我们做了这些优化:
- 流式ASR:边说边转文字,不用等说完
- 流式LLM:文字逐token生成,不用等完整回答
- 流式TTS:拿到首句就开始合成语音,逐句播放
- 禁用thinking模式:流式场景下关闭模型内部思考,降低TTFT
python
# 流式请求中禁用thinking,减少首token延迟
response = await self.llm_client.responses.create(
    model=self.model,
    input=input_messages,
    stream=True,
    extra_body={"thinking": {"type": "disabled"}},
)
数据飞轮:让AI越用越聪明
一个没有数据飞轮的AI系统,上线即巅峰。我们构建了完整的用户反馈 -> 专家审核 -> 持续优化闭环。
反馈体系设计
| 反馈类型 | 触发方式 | 处理流程 |
|---|---|---|
| 点赞 | 用户觉得回答好 | 标记为优质样本,纳入知识库候选 |
| 点踩 | 用户觉得回答差 | 进入专家审核队列 |
| 专家审核 | 后台人工介入 | 修正错误回答 -> 重新入库 -> 模型微调 |
核心接口
POST /feedback:用户提交反馈(点赞/点踩 + 文字补充)GET /expert/pending:专家获取待审核列表POST /expert/review:专家提交审核结果和修正内容POST /expert/approve:审核通过,数据进入知识库
数据飞轮运转逻辑
用户提问 -> Agent回答 -> 用户反馈
    | (差评)
    v
专家审核队列 -> 医学专家修正 -> 生成优质QA对
    |
    v
重新入库Milvus -> 下次相同问题命中正确答案
    |
    v
定期用优质样本微调模型 -> 模型能力持续提升这才是AI产品真正的护城河------数据飞轮转起来之后,越用越好,越好用越多人用。
Token计费:从玩具到产品的必经之路
做AI项目不能只谈情怀,商业化是绕不开的话题。我们实现了按用户/请求级别的Token消耗追踪。
计费维度
- 输入Token:用户问题 + 上下文 + 检索结果
- 输出Token:LLM生成的回答内容
- 工具调用Token:ReAct过程中工具描述和结果的消耗
- 反思/修正Token:Reflection和Self-Correction的额外消耗
计费实现
python
from token_billing import record_token_usage, estimate_tokens_from_chars

# 每次请求结束后记录
await record_token_usage(
    user_id=user_id,
    session_id=session_id,
    input_tokens=input_tokens,
    output_tokens=output_tokens,
    model=model_name,
    request_type="chat"  # chat / voice / stream
)
定时账单任务
启动时创建一个24小时的定时任务,每天生成日报表:
python
# Token计费:启动每24小时定时账单任务
asyncio.create_task(start_billing_scheduler())
数据存在MySQL中,支持按用户、按模型、按时间维度统计。
记忆系统:让对话有上下文
一个不会记住你之前说什么的Agent,和搜索引擎有什么区别?我们实现了三层记忆体系:
| 记忆类型 | 存储介质 | 作用 | 生命周期 |
|---|---|---|---|
| 短期记忆 | LRU内存缓存 | 当前会话上下文 | 会话期间 |
| 长期记忆 | Redis | 用户画像、历史偏好 | 30天 |
| 语义记忆 | Milvus | 重要对话的向量化存储 | 永久 |
MemoryManager 统一管理三层记忆,Agent执行时自动加载相关记忆到上下文。
生产级部署要点
1. 服务生命周期管理
用FastAPI的lifespan管理资源的初始化与优雅关闭:
python
@asynccontextmanager
async def lifespan(app: FastAPI):
    # 启动:初始化Milvus、验证Redis、启动计费调度
    logger.info("服务启动中,正在初始化Milvus...")
    await milvus_manager.initialize()
    if redis_manager.is_healthy():
        logger.info("Redis连接正常")
    asyncio.create_task(start_billing_scheduler())

    yield  # 服务运行中...

    # 关闭:优雅释放资源
    logger.info("服务关闭中,正在释放Milvus连接...")
    await milvus_manager.close()
2. 中间件体系
| 中间件 | 作用 |
|---|---|
AuditMiddleware |
审计日志:记录所有请求的用户、耗时、状态码 |
AuthMiddleware |
认证鉴权:验证用户Token |
CORS |
跨域支持 |
ExtensionRegistry |
扩展点注册:便于插件化开发 |
注册顺序很重要------FastAPI中间件是后注册先执行。
3. 健康检查与可观测性
/health:服务健康状态探针/metrics:运行指标(缓存命中率、QPS、平均延迟等)app.log:结构化日志,包含所有业务事件
面试高频问题精选
整理了10个面试中最常被问到的问题,帮你快速复习:
Q1: 你的Agent项目如何做意图识别?
通过RouterAgent对用户query做多分类,区分医疗/闲聊/垃圾/需要联网等意图,基于LLM的少样本学习能力,不需要额外训练分类模型。
Q2: Milvus中有几路召回?如何融合?
三路召回:HNSW稠密向量(语义)+ BM25稀疏向量(关键词)+ 混合检索,用RRF算法融合结果。
Q3: 流式接口的TTFT(首token时间)M95是多少?怎么优化的?
优化后TTFT M95约200-300ms。优化手段:Redis缓存命中(10ms)、流式SSE、禁用thinking模式、向量库预热。
Q4: 只有文本接口吗?移动端语音呢?
完整支持语音全链路:ASR语音转文字 -> RAG检索 -> LLM生成 -> TTS文字转语音,端到端流式输出。
Q5: 支持多模态吗?如何做的?
支持。文本是核心,图片来源于两个途径:(1) 文生图模型为知识库配图 (2) 检索结果中提取PDF/文档预览图。回答中包含图片URL供前端展示。
Q6: 具备ReAct能力吗?还是单向WorkFlow?
完整的ReAct架构。RouterAgent通过工具调用决定调用哪些Skills(知识库检索/联网搜索),MedicalAgent基于工具结果生成答案,最多5轮迭代。
Q7: 有记忆能力吗?能识别之前的对话吗?
三层记忆体系:短期记忆(当前会话LRU)+ 长期记忆(Redis用户画像)+ 语义记忆(Milvus向量存储),Agent执行时自动加载。
Q8: 检索失败 + LLM服务同时挂了,怎么兜底?
多级降级策略:(1) 缓存命中直接返回 (2) Milvus失败则跳过检索纯LLM回答 (3) LLM主模型失败自动切到备用模型 (4) 全部失败返回友善的兜底话术,同时触发告警。
Q9: 用户觉得回答不对,有反馈和人工介入机制吗?
有完整数据飞轮:用户点踩 -> 进入专家审核队列 -> 医学专家修正 -> 重新入库 -> 下次问答质量提升。
Q10: 有付费机制吗?计费标准是什么?
有Token计费系统,按用户/请求级别追踪输入输出Token消耗,支持按模型阶梯定价,每日生成账单报表。
写在最后
这篇文章涵盖了一个生产级医疗AI Agent从架构设计到落地部署的完整链路。回顾一下整个系统的核心设计哲学:
- 分层解耦:七层架构各司其职,改动一层不影响其他层
- 安全优先:医疗领域容错率低,Reflection + 数据飞轮双重保障
- 性能为王:三层缓存 + 流式输出 + 向量库预热,TTFT低至200ms
- 持续进化:数据飞轮让系统越用越聪明,形成正向循环
- 可观测性:日志、指标、审计贯穿全链路,问题一目了然
如果你对AI Agent开发感兴趣,欢迎关注我,后续我会继续分享:
- Agent的流式输出优化实战
- Milvus向量库性能调优指南
- 多模态Agent的前端交互设计
- 更多真实项目的踩坑记录
觉得有帮助的话,别忘了点赞 + 在看 + 转发,让更多人看到~有任何问题欢迎在评论区交流!
关于作者:深耕AI Agent领域,专注于RAG、Multi-Agent架构与生产级部署。本文基于实战项目总结,代码和架构均经过生产环境验证。如需交流,欢迎关注后续内容。