Agent 的工具没变,SGLang 缓存为什么没命中?
一个客服 Agent 每次调用模型,都带着同一套业务规则和工具说明。你期待第二轮能少算一些,可观察请求时发现,输入依然处理了很久。
先别急着加显存或改调度参数。把发往模型的两份输入并排打开,找最早变化的位置。工具说明可能确实没变,但它前面的时间戳每轮都在变。
文中的布局是作者示意,没有本地命中率或提速数据。
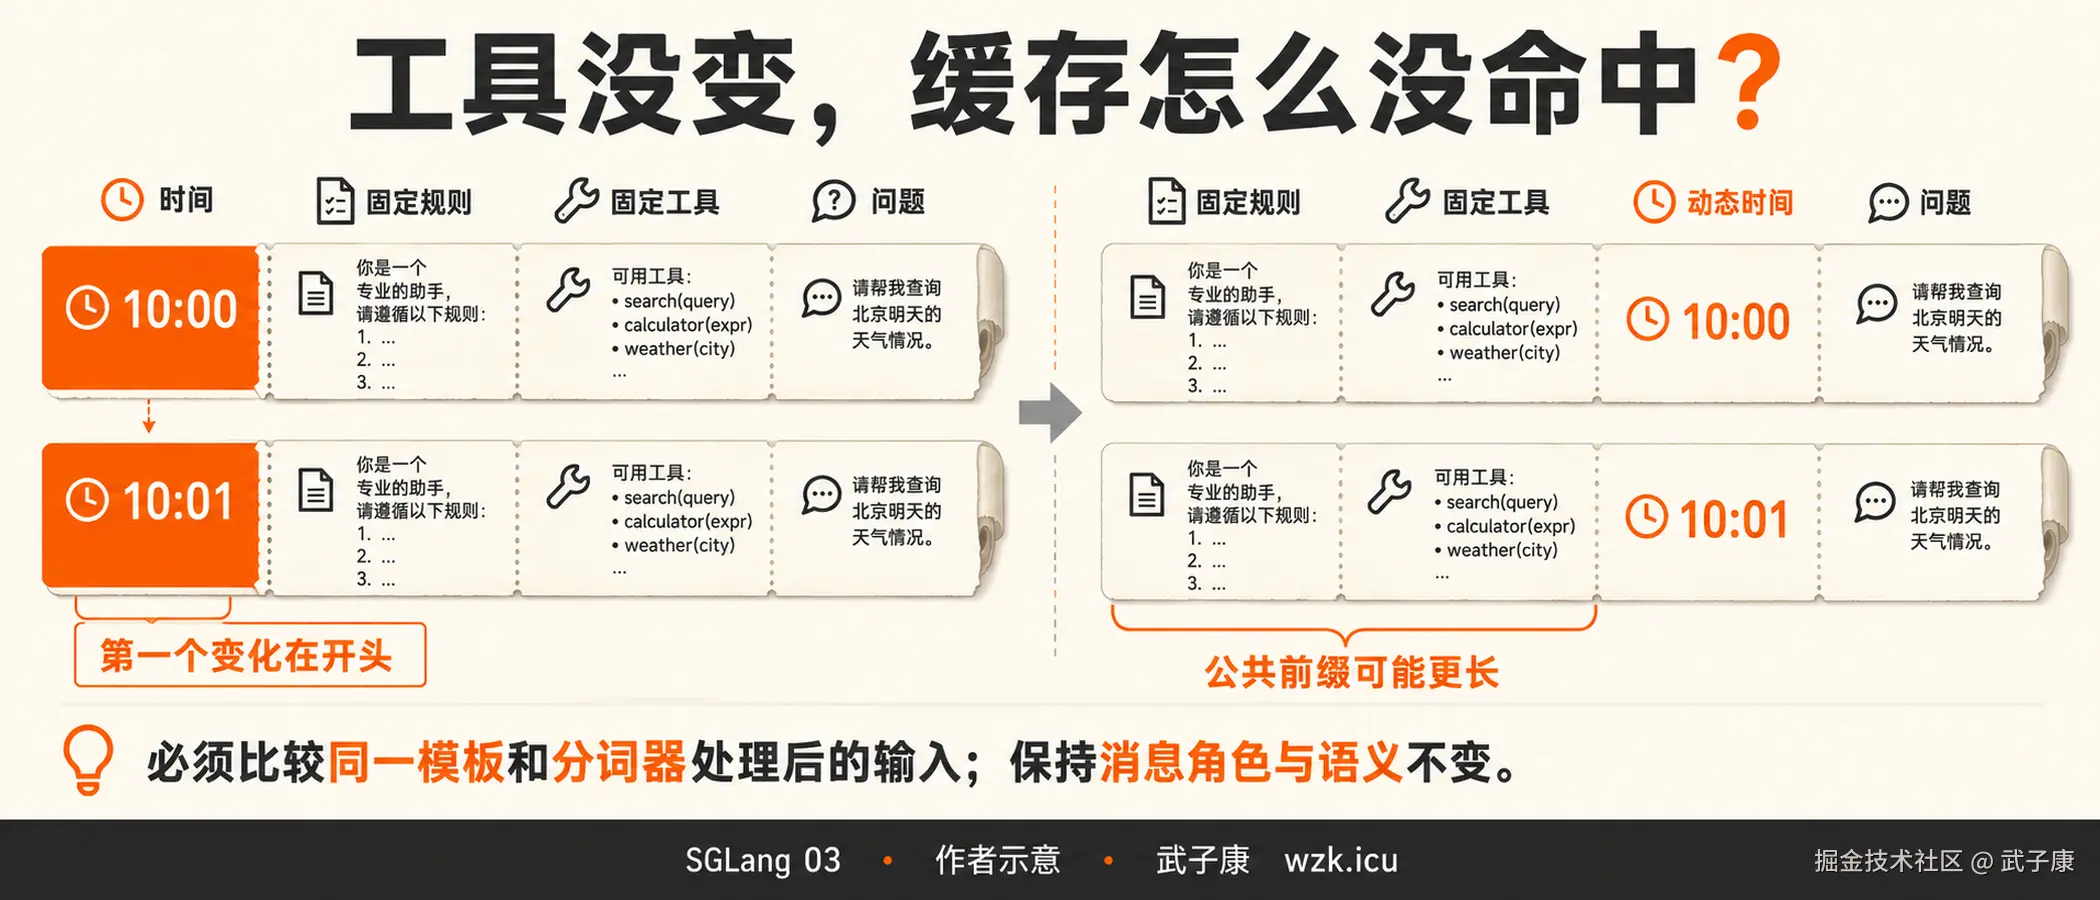
时间戳可能让公共开头提前结束
下面是同一套模板的两轮输入示意。为了看清差异,这里用文字块表示内容,并非某个 API 的真实请求,也不是分词器输出:
text
第一轮:当前时间 10:00 → 固定规则 → 固定工具说明 → 用户问题
第二轮:当前时间 10:01 → 固定规则 → 固定工具说明 → 用户问题
前缀缓存从开头匹配,公共部分到最早不同的 token 为止。后面两大段工具说明即使一模一样,也不能跳过前面的差异,把它们当作同一段公共开头。
可以尝试让真正稳定的内容靠前,让必须变化的信息靠后:
text
固定规则 → 固定工具说明 → 当前请求需要的时间 → 用户问题这里的"靠前"不是让你把 system 消息移到 user,也不是把检索出来的网页塞进高优先级规则。角色和顺序会影响模型理解。只有在保持指令层级、语义和回答质量的前提下,这个布局才值得比较。
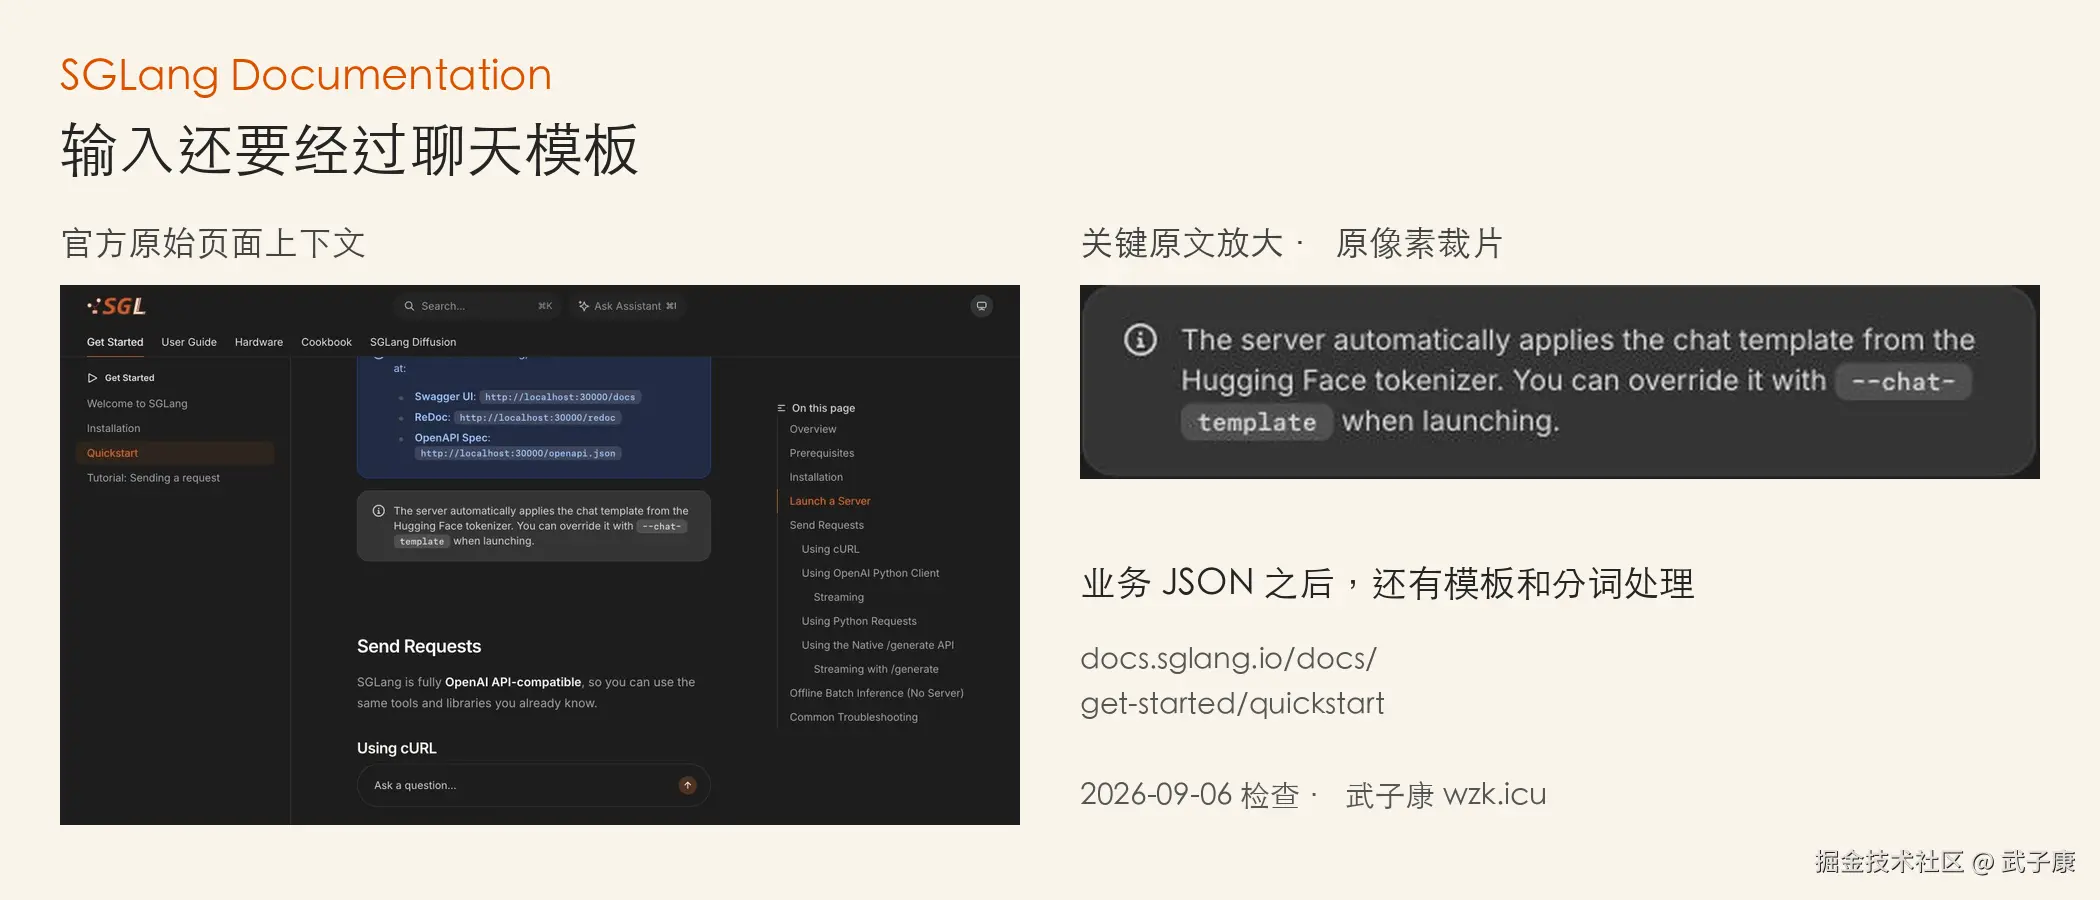
图注:SGLang Quickstart / Launch a Server,2026-09-06 检查。原始页面说明服务器默认使用 Hugging Face tokenizer 的聊天模板。截图保留原文像素。
客户端的 JSON 还会经过聊天模板处理。因此,业务代码中两个字典"看着差不多"不够;应比较同一模板和分词器实际形成的输入。依据见 SGLang Quickstart。
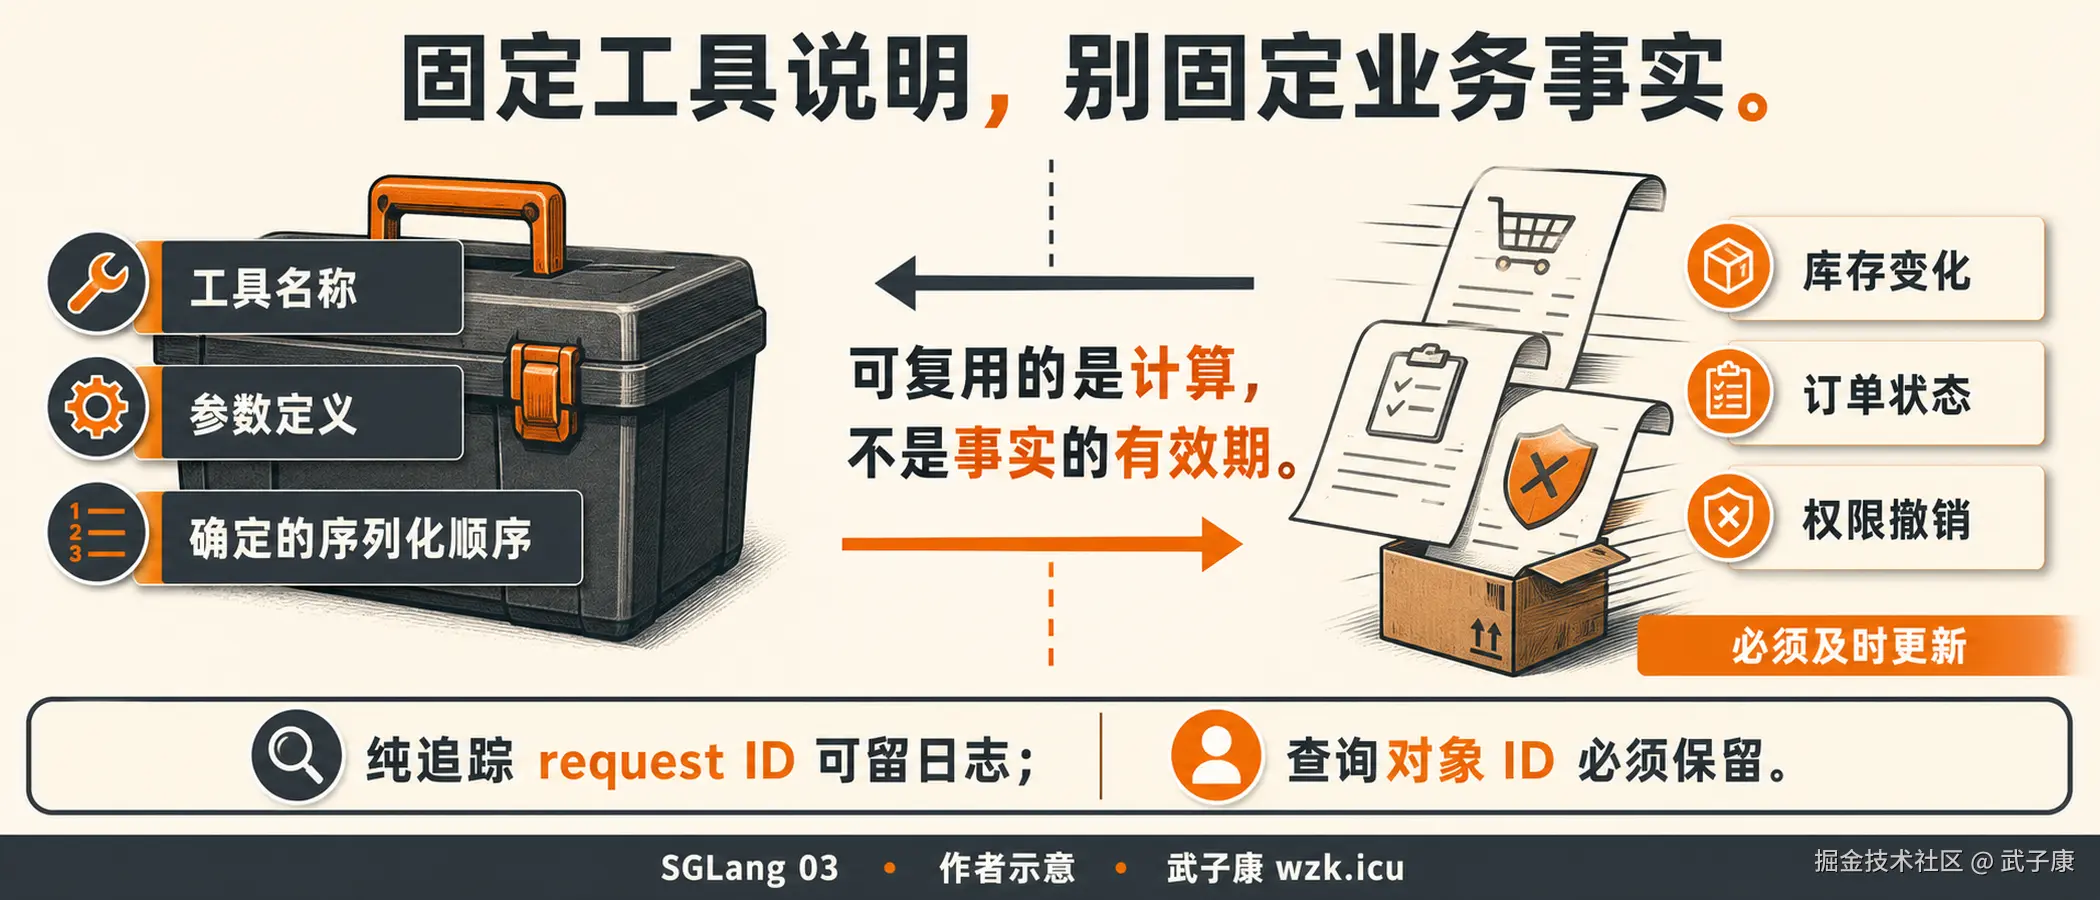
固定工具说明,别固定库存和权限
工具名称、参数定义通常不必每轮改变,可以保持确定的输出顺序与序列化方式。今天先列查订单、明天先列查库存,两套能力相同,输入的 token 顺序却可能不同。
但工具返回值不是工具定义。订单刚发货、库存刚售罄、用户权限刚被撤销,这些变化就应该进入本轮判断。为了命中率保留上轮结果,会让用户收到旧答案。
纯追踪用途的 request ID 也可以留在日志里,前提是模型不需要它完成任务。如果它是用户正在查询的订单编号,就不能删。性能优化应去掉无用的变化,而不是去掉有效信息。
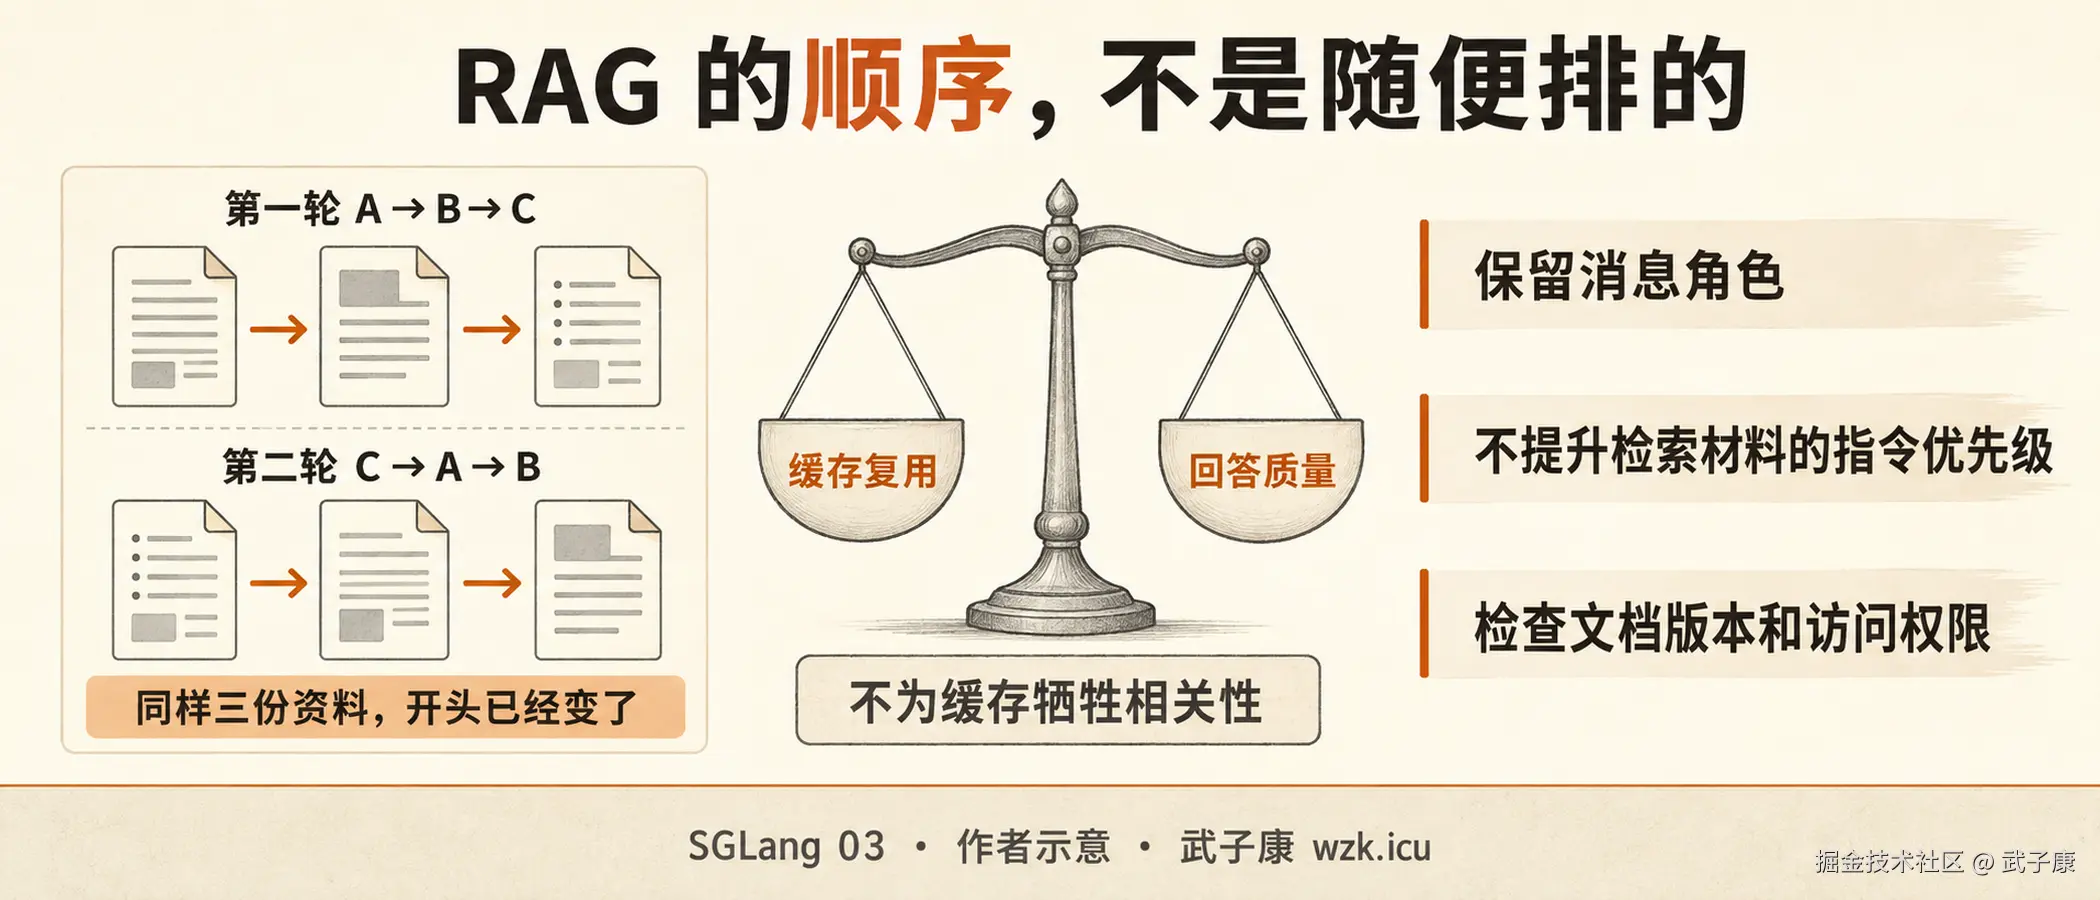
RAG 材料的顺序也有意义
两轮都检索到 A、B、C 三份资料,并不代表输入相同。第一轮是 A→B→C,第二轮是 C→A→B,最前面的材料已经变了。
这不意味着应当强行按文档 ID 排序。检索系统把 C 排第一,可能正是因为它最相关。如果固定排序让回答更差,节省的输入计算就不能算净收益。
围绕同一份资料连续提问更适合观察复用:资料版本和正文保持不变,问题放在后面。但仍须每次检查访问权限。同一个文档 ID 不代表正文和权限一直相同;更不能为缓存复用,把不可信材料提升成系统指令。
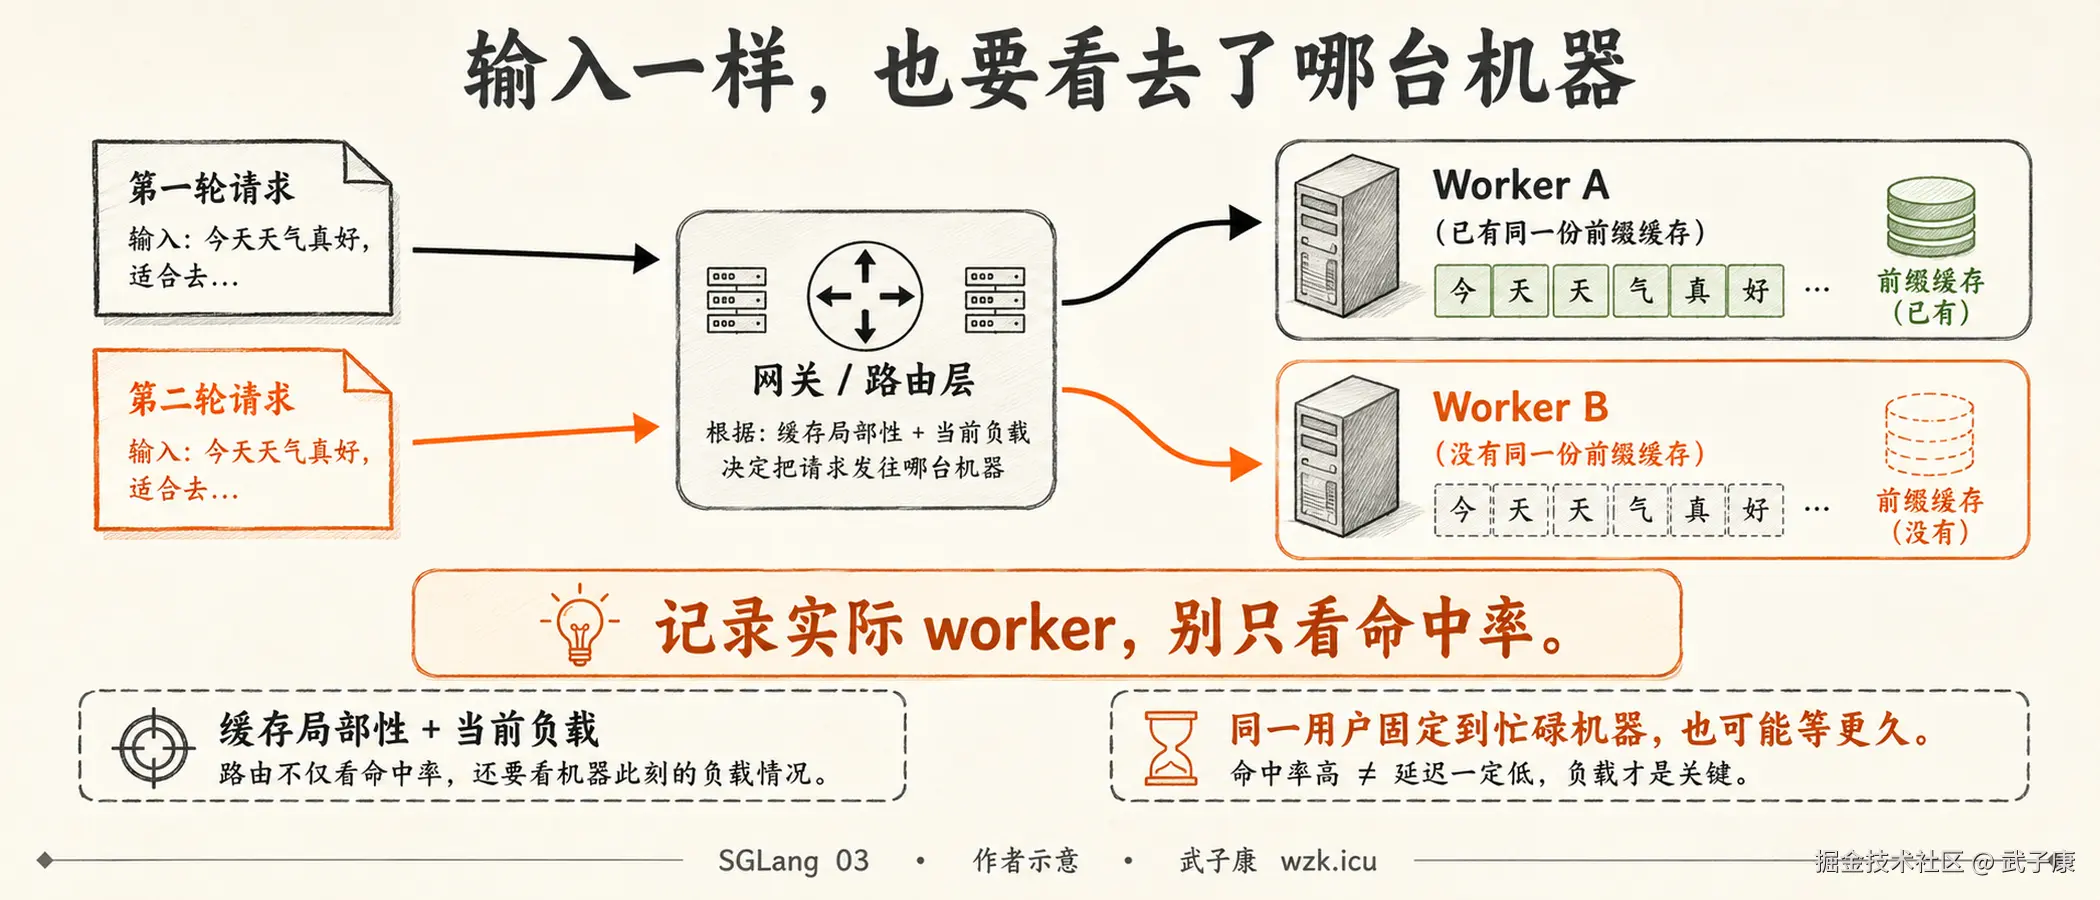
输入相同,还要看请求落在哪台机器
多个模型副本各自持有缓存时,第二轮需要到达拥有那份可用缓存的副本,才能利用它。第一轮在 worker A 预热,第二轮去了 worker B,这时没命中不能直接归咎于模板。即使命中增加,排队也可能让首 token 继续等很久。
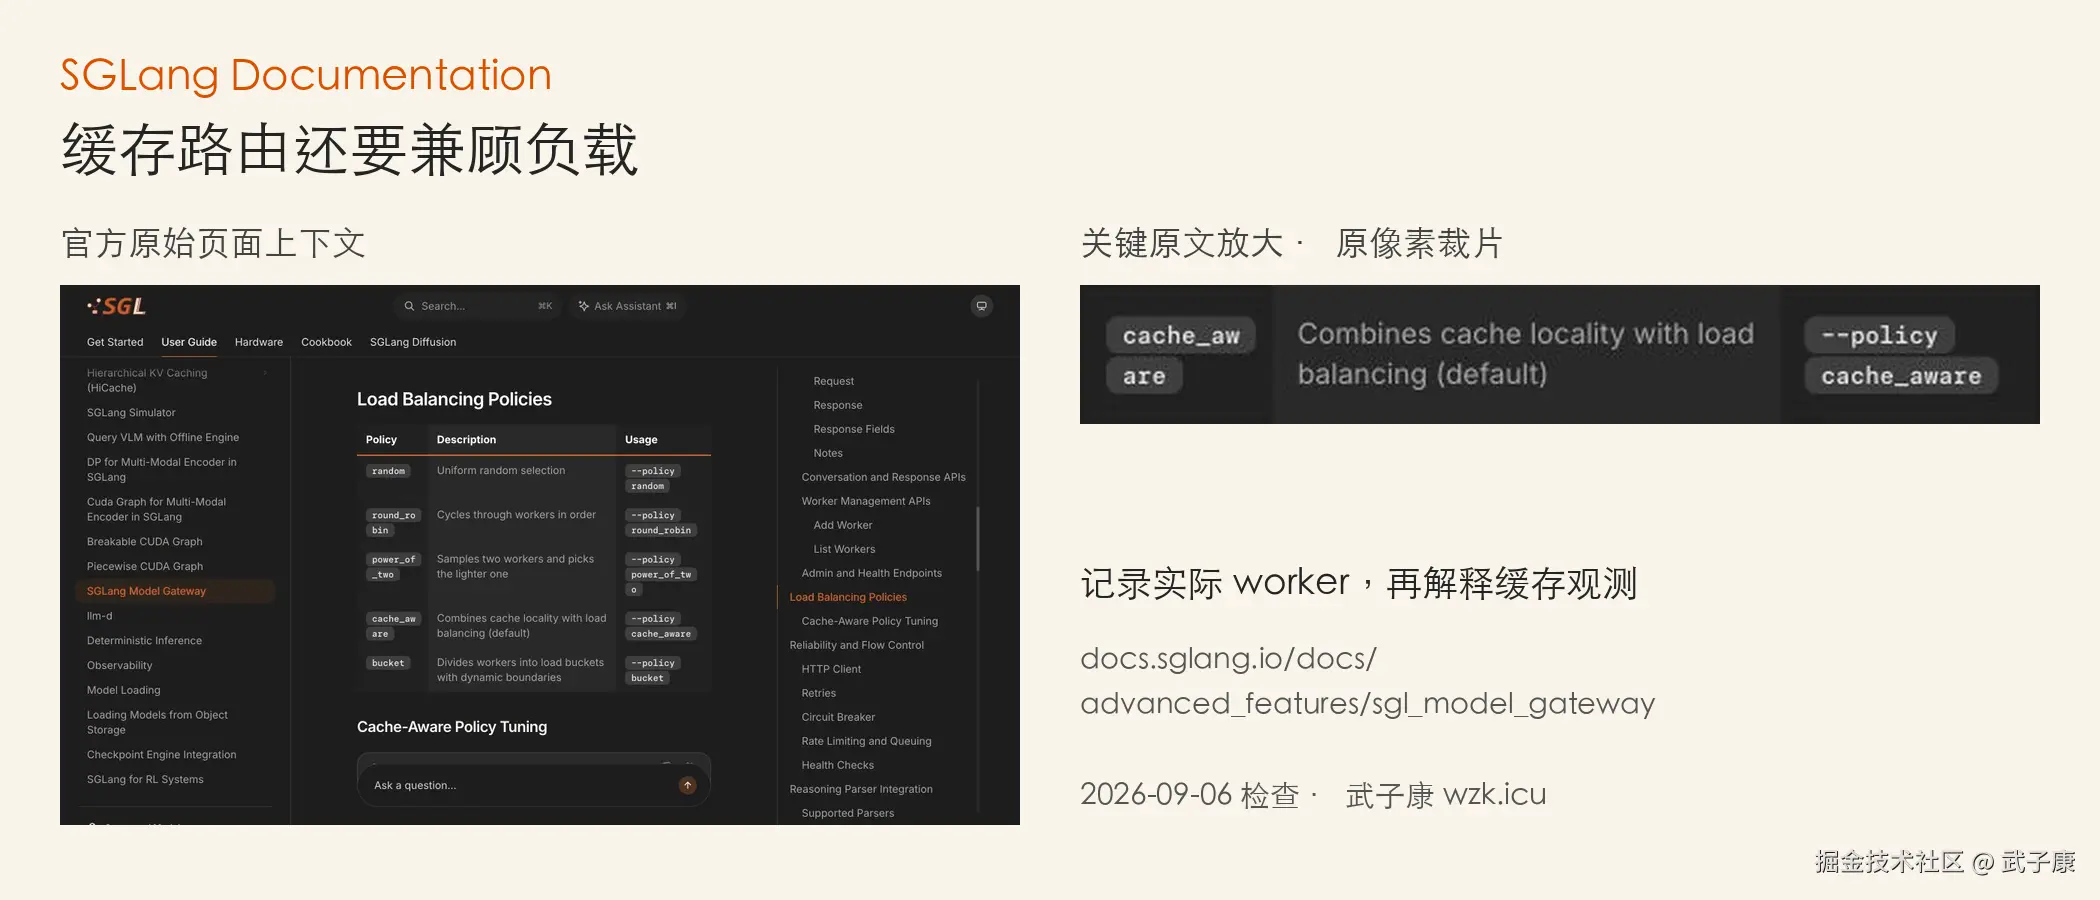
图注:SGLang Model Gateway / Load Balancing Policies,2026-09-06 检查。原文将 cache_aware 描述为同时考虑缓存局部性和负载均衡;截图保留原始像素。
Model Gateway 文档提供缓存感知路由。它需要兼顾负载:把用户一直绑在已经排长队的机器上,并不保证用户更早看到回答。排查记录里保留实际 worker,比只写"命中/未命中"更有用。
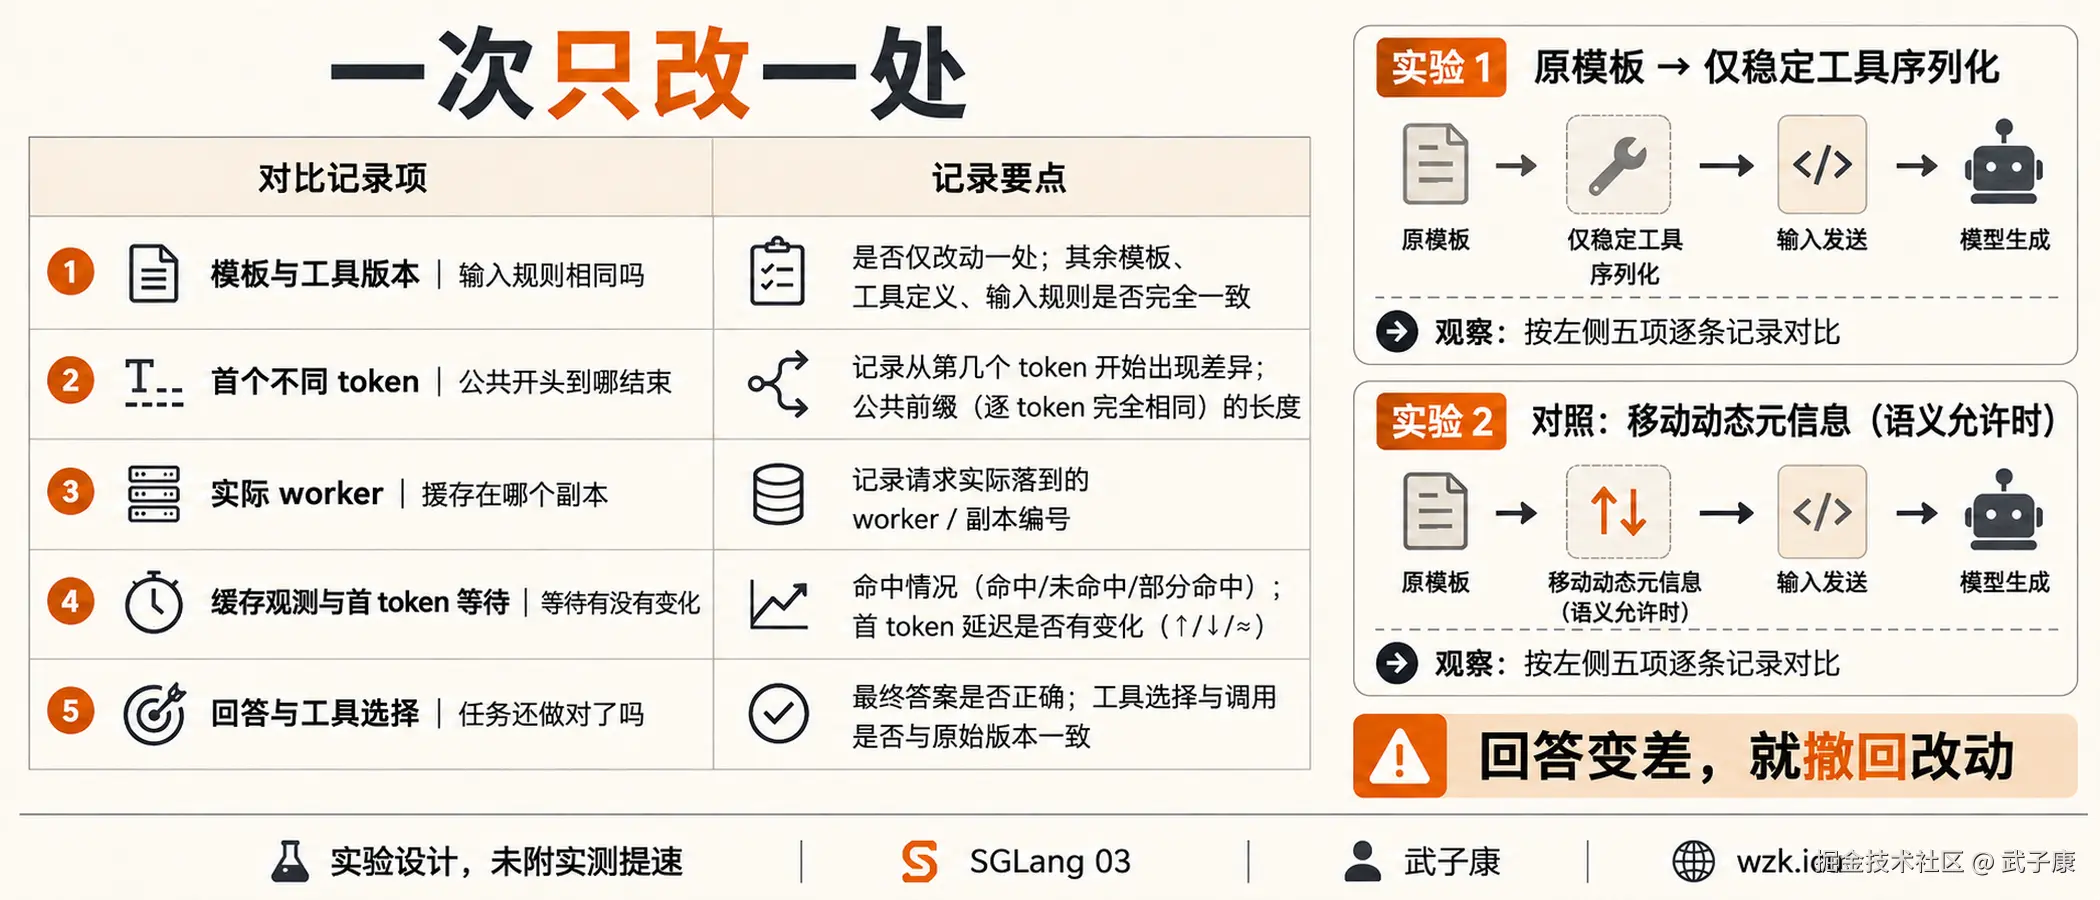
只改一个地方,连回答质量一起比
拿一小组脱敏的真实请求,先只稳定工具说明的序列化;再单独比较是否适合移动纯动态元信息。别在同一轮同时升级模型、更换分词器和增加并发,否则很难知道差异从哪来。
| 每条请求记录什么 | 用来判断什么 |
|---|---|
| 模板与工具定义版本 | 是否来自同一套输入规则 |
| 首个不同 token 的位置 | 公共开头在哪里结束 |
| 实际 worker | 缓存是否可能在另一个副本 |
| 缓存观测与首 token 等待 | 复用变化是否伴随等待变化 |
| 回答和工具选择结果 | 模板调整有没有损伤任务正确性 |
缓存量和等待时间按当前版本的指标定义读取。整个服务的平均命中率,不能单独证明某一条请求用了缓存。
把上表填完再决定是否保留改动。如果输入复用改善了,回答或工具选择却变差,就撤回那项模板调整。