最近看具身智能公司的算法岗位,会发现三个词出现得越来越频繁:VLA、世界模型(World Model)、强化学习(RL)。
很多HR甚至部分刚进入机器人行业的人,很容易把它们理解成三条互相竞争的技术路线:企业做了VLA,是不是就不需要世界模型?有了世界模型,是不是强化学习就过时了?
其实不是。
这三者解决的问题并不在完全相同的层面。用一句话先概括:VLA更关注"看懂任务并生成动作",世界模型更关注"预测动作之后会发生什么",强化学习更关注"通过反馈学会怎样做得更好"。
它们未来很可能不是三选一,而是不断融合。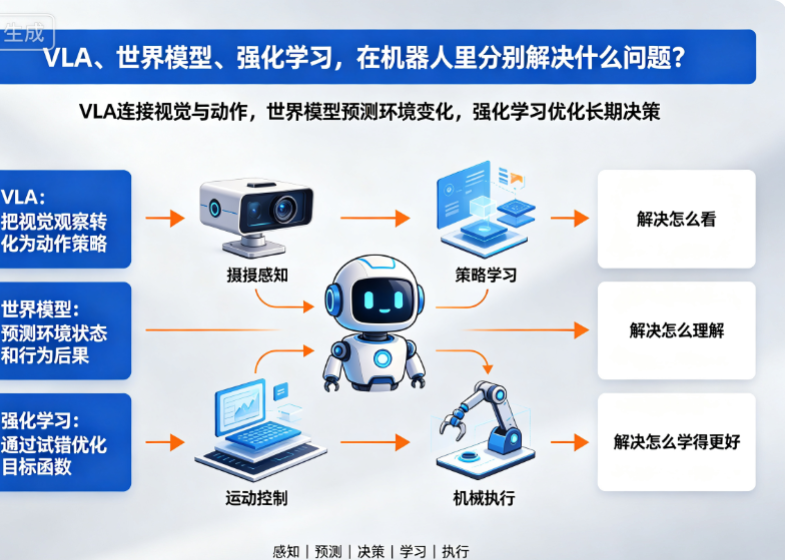
一、先用一个机器人收拾桌子的任务理解三者
假设你对人形机器人说:
"把桌上的红色杯子拿起来,放进旁边的收纳箱。"
机器人真正执行这个任务,并没有我们想象得那么简单。
它首先需要看懂场景:哪个是杯子?哪个是收纳箱?"红色杯子"对应视觉里的哪个物体?
然后还要决定动作:手臂怎么过去?手什么时候闭合?杯子拿起来以后往哪里移动?
更进一步,它最好还能预测:如果我这样抓,杯子会不会滑?如果从这个方向接近,会不会撞到旁边的瓶子?
最后,如果机器人连续尝试很多次,它还希望知道:什么动作成功率更高?怎样抓更稳?
这时候VLA、世界模型和强化学习的角色就开始出现了。
| 技术 | 核心解决的问题 | 可以粗略理解为 |
|---|---|---|
| VLA | 从视觉、语言、机器人状态生成动作 | "我应该做什么动作?" |
| 世界模型 | 学习环境动态并预测未来状态 | "这样做以后会发生什么?" |
| 强化学习 | 根据奖励/反馈优化行为策略 | "怎样做能获得更好的结果?" |
但这是为了理解而做的简化。真正的机器人系统里,三者的边界已经越来越模糊。
二、VLA:把"看懂"进一步变成"行动"
VLA是Vision-Language-Action,即视觉---语言---动作模型。
它和VLM最大的区别,就藏在最后一个"A"。
VLM看到桌面图片,可以告诉你:
"桌子上有一个红色杯子。"
VLA则需要继续往下:
"我要怎样控制机器人,把这个杯子拿起来?"
因此一个典型VLA可以抽象成:
图像/视频 + 语言指令 + 机器人本体状态 → Action
这里的Action可能是机械臂末端位姿变化、关节目标、夹爪开合,也可能是一段连续的Action Chunk。
所以VLA真正重要的地方,是开始尝试把传统机器人里相对分离的:
视觉理解 → 语言理解 → 任务理解 → 动作生成
连接起来。
OpenVLA、π系列、GR00T等路线虽然具体架构不同,但背后都在探索一个重要问题:
机器人能不能通过大量数据,学习从多模态输入直接映射到机器人动作?
这也是为什么现在VLA人才特别难找。
纯大模型人才可能很懂Transformer、多模态和预训练,却不一定理解机器人Action Space;传统机器人算法人才懂运动学、规划和控制,却未必有大模型训练经验。
企业真正抢的是:
VLM/多模态 + Robot Learning + Policy + Robot Data + 真机部署。
三、世界模型:让机器人拥有"预测未来"的能力
世界模型和VLA关注的问题不完全一样。
假设机器人准备伸手拿杯子。
如果只是输出动作,可以理解成:
"下一步手向前移动5厘米。"
但一个更强的机器人最好能够在行动之前预测:
手向前移动5厘米以后,手会到哪里?
会不会碰到杯子?
杯子会不会移动?
周围其他物体会发生什么变化?
这就是世界模型非常核心的思想:学习世界如何变化。
可以粗略理解为:当前状态 + Action → 预测未来状态
例如当前状态是Sₜ,机器人执行动作Aₜ,世界模型试图预测:Sₜ₊₁、Sₜ₊₂......
于是机器人就有机会在真正执行动作之前,先在内部"想象"不同动作可能造成的结果。
比如:
方案A → 从正面抓 → 可能碰倒旁边瓶子
方案B → 从侧面抓 → 成功概率更高
如果这种预测能力足够强,机器人就不只是"看到什么做什么",而开始具备一定程度的预测、推演和规划能力。
这也是为什么世界模型在具身智能里受到高度关注。
现实机器人采集数据很贵。如果机器人能够通过学习环境动力学,在内部进行大量预测和推演,就可能提高数据利用效率和规划能力。
四、强化学习:机器人怎么从"会做"变成"做得更好"
强化学习解决的又是另外一个问题。
它的核心逻辑可以简单理解为:
机器人做动作 → 环境给反馈 → 根据奖励不断调整策略。
例如训练人形机器人走路。
机器人迈一步。
摔倒:负奖励。
保持平衡:正奖励。
向目标方向移动:奖励增加。
能耗过高:扣分。
动作过于剧烈:扣分。
经过大量训练以后,机器人逐渐学到一个Policy:
在当前状态下,采取什么动作能够获得更高的长期收益。
这就是强化学习特别适合机器人控制的原因。
因为很多机器人问题很难人为写出完整规则。
比如人形机器人被突然推了一下,几十个关节应该分别输出多大的力才能重新恢复平衡?
如果全部靠工程师手写规则,复杂度非常高。
强化学习则可以通过大量交互,让机器人自己学习策略。
因此现在人形机器人里的Locomotion、全身运控、灵巧操作、抓取、导航等方向,都能看到强化学习的应用。
尤其PPO、SAC等算法,经常出现在机器人运控岗位JD里。
五、VLA和强化学习最大的区别是什么?
这是招聘过程中很容易混淆的地方。
两者都可能最终输出Action,但学习逻辑并不一样。
VLA更强调:
从大量机器人示范数据中学习"看到这种场景、收到这种指令,应该采取什么动作"。
很多训练过程因此会涉及模仿学习、行为克隆等思路。
强化学习则更强调:
通过Reward告诉机器人什么结果更好,让Policy通过交互逐渐优化。
可以用一个简单例子理解。
教机器人开抽屉。
VLA/模仿学习思路
给机器人看大量人类遥操作数据:
手移动到把手 → 抓住 → 向外拉 → 抽屉打开。
机器人从这些示范中学习动作。
强化学习思路
告诉机器人:
抽屉打开 = +10分;碰撞 = -5分;动作过大 = -1分。
然后让它通过大量尝试寻找更好的策略。
两种方法各有优势。
前者能够利用人类示范快速获得复杂技能;后者则可以继续通过环境反馈优化策略。
因此现在越来越值得关注的方向其实不是:
VLA vs RL
而是:
VLA + RL。
先利用大量机器人数据获得基础能力,再利用强化学习、反馈或其他后训练方式进一步优化策略,很可能成为越来越重要的组合。
六、世界模型和强化学习为什么天然容易结合?
这两者的关系也非常有意思。
传统强化学习需要机器人不断和环境交互。
问题来了:
真实机器人交互非常贵。
仿真里摔100万次没关系,真实人形机器人不可能每天摔100万次。
如果拥有世界模型,逻辑就发生变化。
机器人可以:
真实数据 → 学习世界模型 → 在模型里预测/模拟未来 → 优化Policy → 再回到真实机器人验证。
于是世界模型某种程度上就变成了机器人内部的"模拟器"。
这也是Model-Based RL的重要思路之一。
它希望减少大量真实世界试错,提高学习效率。
当然,问题也非常明显:
如果世界模型预测错了怎么办?
模型认为杯子不会滑,真实世界里却滑了;模型认为地面摩擦系数足够,机器人一脚踩下去却摔了。
所以世界模型最终依然逃不开机器人领域最经典的问题:
模型世界和真实世界之间存在差距。
七、那VLA、世界模型、强化学习最终会不会融合?
我认为这是理解具身智能下一阶段非常重要的一点。
不要把它们简单理解成三支互相淘汰的队伍。
未来更可能出现这样的机器人"大脑":
视觉+语言理解任务
↓
VLA/Policy生成候选动作
↓
世界模型预测动作结果
↓
规划/策略选择
↓
机器人执行
↓
真实环境反馈
↓
强化学习/后训练进一步优化Policy
当然,真实产品不会一定严格按照这张框图实现,各家公司也会有不同架构。
但整体趋势非常明确:
机器人正在从单纯的"感知---规划---控制",逐渐加入学习、预测和通用策略能力。
而最下面仍然会存在运动控制、轨迹生成、IK、关节控制、电机驱动和安全系统。
模型再强,最终也必须让真实机器人动起来。
八、从机器人猎头角度看,这三类人才其实也不一样
现在不少HR看到候选人简历上同时出现VLA、World Model、RL,就容易把他们归成"具身智能算法人才"。
但真正做招聘时必须继续拆。
| 人才方向 | 更核心的能力 |
|---|---|
| VLA人才 | VLM、多模态、Policy、IL、Robot Data、真机部署 |
| 世界模型人才 | 视频/状态预测、动力学建模、生成模型、规划、Representation Learning |
| 强化学习人才 | PPO/SAC等RL、Reward Design、Policy Optimization、仿真训练 |
| RL运控人才 | RL+动力学+WBC+Sim2Real+真机 |
| Manipulation人才 | VLA/IL/RL+机械臂/灵巧手+力触觉 |
| 算法架构人才 | VLA+World Model+RL+规划控制+机器人系统 |
尤其是"强化学习人才"这个标签,差异可能非常大。
做游戏RL、推荐系统RL、LLM后训练RL和做人形机器人Locomotion的RL工程师,虽然都叫强化学习,但人才画像完全不同。
机器人企业真正需要继续问的是:
你在哪种机器人上做过?Action Space是什么?Reward怎么设计?训练环境是什么?有没有Sim2Real?最终有没有上真机?
这些问题往往比一句"熟悉PPO"更能判断候选人的价值。
David的一个判断:未来真正稀缺的是能把三者串起来的人
如果只看今天,VLA、世界模型、强化学习仍然可以对应不同的研究和工程团队。
但如果把时间拉长,我认为机器人企业真正争夺的人才,会越来越集中在它们的交叉区域。
因为机器人最终需要解决的不是:模型能不能理解一张图片。
而是:理解环境 → 预测结果 → 选择动作 → 执行动作 → 根据结果继续学习。
VLA让机器人从"理解"进一步走向"行动";世界模型让机器人具备对未来进行预测和推演的能力;强化学习则让机器人能够根据结果不断优化行为。
三者最后指向的是同一个目标:让机器人不仅能执行预先写好的程序,而是真正具备在复杂物理世界中自主学习和行动的能力。
所以未来机器人算法人才最值钱的,未必是简历上同时写着"VLA、World Model、RL"的人。
而是能够回答清楚:这三种技术到底应该在哪一层解决什么问题,最后又怎么在真实机器人上形成闭环。
这类人,目前依然非常少。