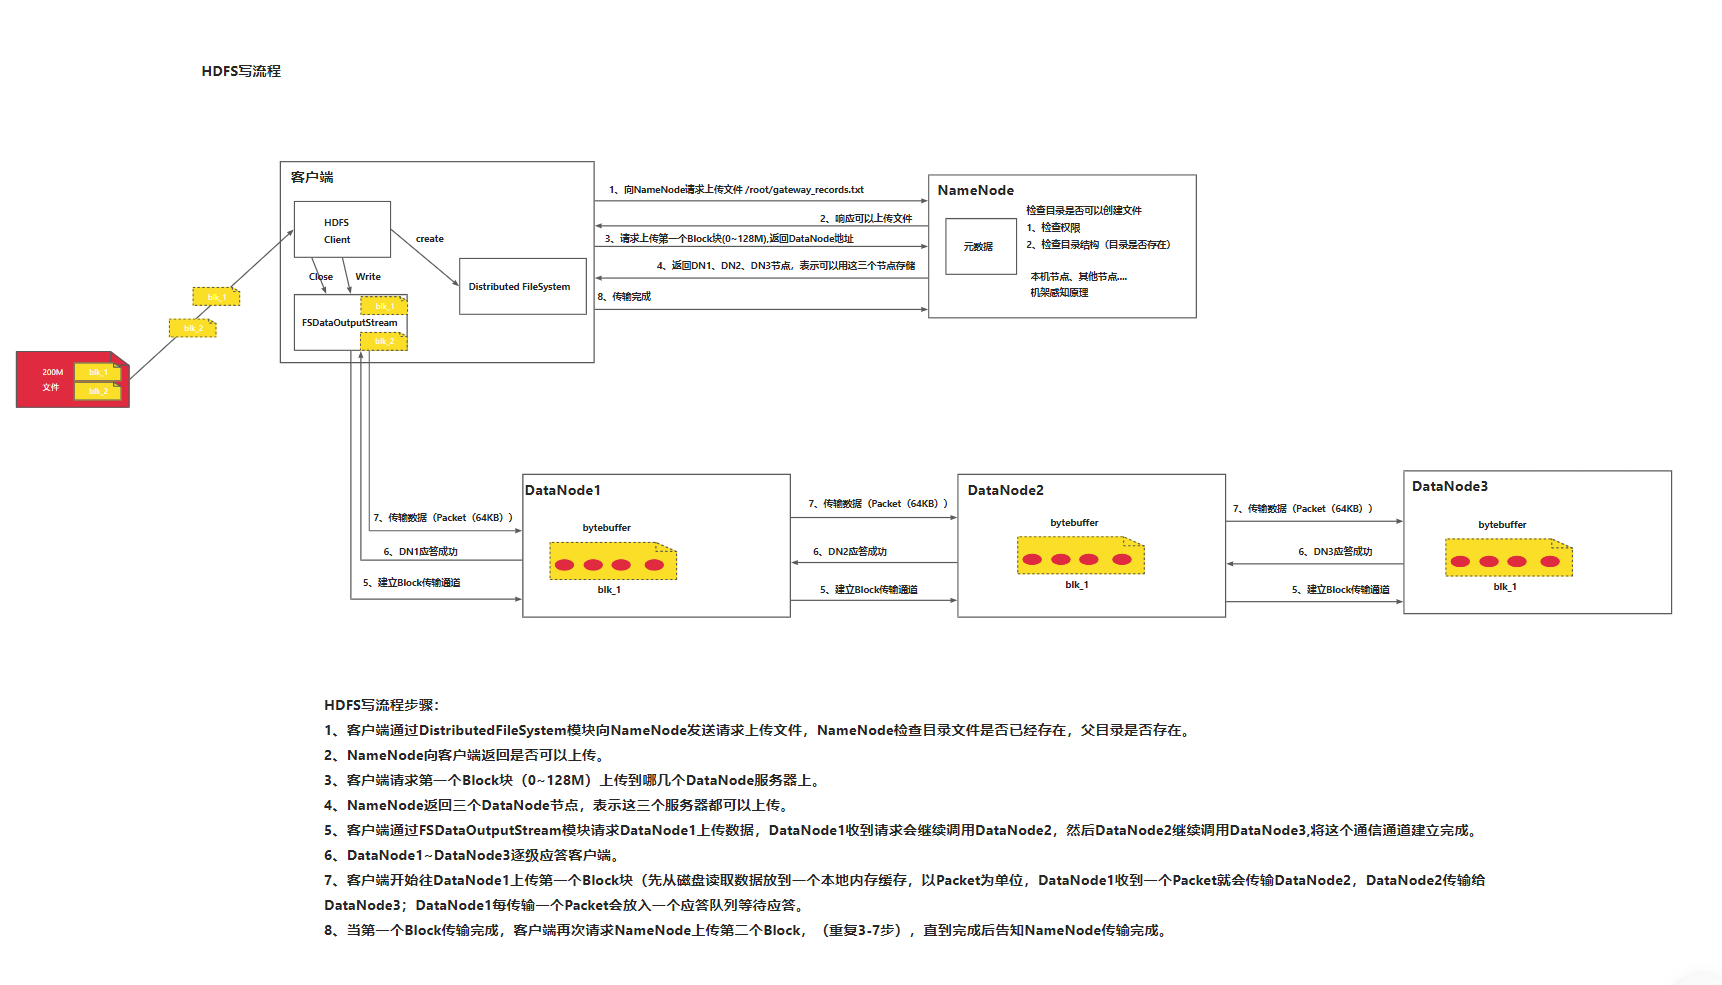
一、整体概述
先记住最核心的一句话:NameNode 只管「目录、文件信息、数据块在哪」;真正的文件内容,全部存在 DataNode 上。读文件时 NameNode 不给你传文件内容,只告诉你去哪找,客户端直接去找 DataNode 拿数据。
HDFS 采用一次写入、多次读取模型。客户端读取文件时,NameNode 只返回元数据(块位置信息),真正的文件数据直接由 DataNode 传输给客户端,NameNode 不参与真实数据的传输,减轻 NameNode 压力。
二、前置背景假设
假设 HDFS 里面有一个 200M 的文件。HDFS 会自动把大文件切成一块一块(block,默认一块 128M)。200M 文件会拆成:
- block_1:前 128M,存放在 DataNode1,另外在其他节点存副本;
- block_2:剩下 72M,存放在 DataNode2,副本放在 DataNode3。
副本的作用:如果某个 DataNode 机器坏了,还能从副本节点读取数据,防止数据丢失。
三、角色介绍
- 客户端 Client:就是我们自己(在 Linux 上执行 hdfs 命令的这台机器,master 节点)。
- NameNode:HDFS 的「总管、花名册」,只保存元数据(文件名、文件大小、文件切成哪些块、每个块在哪个 DataNode 机器上),不保存真实文件内容,全部信息放在内存。
- DataNode:干活的「存储服务器」,负责在本机磁盘保存真实的 block 数据,负责把文件数据发给客户端。
四、完整分步讲解
第 1 步:客户端发起读文件请求
你在客户端执行读取文件操作(例如 hdfs dfs -get 从 HDFS 下载文件到本地)。客户端内部的 DistributedFileSystem 这个模块,专门去找 NameNode,发请求:「我要读取 HDFS 里的这个文件 cart.txt,请告诉我这个文件所有数据块分别在哪台 DataNode 机器上?」
第 2 步:NameNode 查询花名册,返回元数据(块位置信息)
NameNode 收到请求,去自己内存里查元数据(花名册)。查到结果:这个文件有两个块,block_1 在 DataNode1;block_2 在 DataNode2,block_2 的副本在 DataNode3。NameNode 只把这个地址清单返回给客户端,不发送任何文件内容。
重点区分:元数据 = 地址目录信息,不是文件本身。
第 3 步:客户端选择节点,向 DataNode1 请求读取 block_1
客户端拿到块地址列表,遵循就近原则:优先选择网络距离最近的 DataNode(同机架优先,减少网络传输开销)。客户端发送请求给 DataNode1:「请把你机器上的 block_1 这块数据发给我。」
第 4 步:DataNode1 读取本地磁盘数据,传输 block_1 给客户端
DataNode1 收到请求,从本机硬盘上读取 block_1 的真实数据。传输的时候,不是一次性把整块发过去,而是拆成很小的单元,叫做 Packet(数据包)。每一个 Packet 里面,除了数据本身,还附带校验码。一边发送,一边校验,防止传输过程中数据损坏。数据通过网络,流式持续发给客户端的 FSDataInputStream(HDFS 的输入流,用来接收 DataNode 传来的数据)。客户端收到 Packet,先放到内存缓存起来,暂时不写入本地磁盘文件。
第 5 步:block_1 读取完成,客户端请求 DataNode2 读取 block_2
当 block_1 所有 Packet 全部接收完毕,客户端继续发起请求,去找存放 block_2 的 DataNode2:「请把 block_2 的数据发给我。」
容错补充:如果此时 DataNode2 机器宕机、网络断了,客户端不会卡死。客户端会看 NameNode 给的清单,直接去找 block_2 的副本节点 DataNode3 读取数据,保证读文件不会失败。
第 6 步:DataNode2 传输 block_2 数据
DataNode2 读取本机磁盘上的 block_2,同样以 Packet 为单位,一边校验一边把数据流传给客户端。客户端继续在内存缓存收到的数据包。
第 7 步:所有数据块读取完毕,拼接、保存文件,关闭连接
客户端把先后收到的 block_1 + block_2,严格按照顺序拼接在一起,还原成完整的 200M 原始文件。然后把完整文件写入客户端本地 Linux 磁盘(比如本地 /root/cart.txt)。所有数据传输完成,关闭 FSDataInputStream 流,读操作结束。
五、重点总结
- NameNode 不参与真实文件数据传输,只提供块位置信息,减轻 NameNode 压力,所以 HDFS 可以支撑大量并发读写。
- 客户端和 DataNode 之间直接传输数据,不需要经过 NameNode 中转。
- 就近原则:优先选择网络最近的 DataNode,减少网络延迟。
- 副本容错:数据块存在多个 DataNode,节点故障自动切换副本读取。
- Packet:网络传输最小单元,自带校验,保证数据传输正确性。
- FSDataInputStream:客户端用来接收 DataNode 数据流的输入流。
六、常见误区
**误区一:**读文件的时候,数据先传给 NameNode,NameNode 再转发给客户端。
**正确理解:**NameNode 只给地址,数据直接 DataNode 到客户端。
**误区二:**NameNode 保存文件内容。
**正确理解:**NameNode 只保存目录、块位置这类元数据,真实文件全部在 DataNode。