kafka 存储flink changelog两种方式和形态

1 使用upsert-kafka connecter,按照connecter的规则写入

Upsert Kafka | Apache Flink

作为数据源,upsert-kafka 连接器会生成一个变更日志流,其中每条数据记录代表一次更新或删除事件。更准确地说,数据记录中的值会被解释为对同一键的上一个值进行更新(如果存在),如果对应的键尚不存在,则更新操作会被视为插入操作。以表为例,变更日志流中的数据记录会被解释为 UPSERT(即插入/更新),因为任何具有相同键的现有行都会被覆盖。此外,空值会被特殊解释:空值记录代表"删除"操作。

2 kafka connector + 使用cdc格式 比如 format:debezium-json、canal-json、maxwell-json
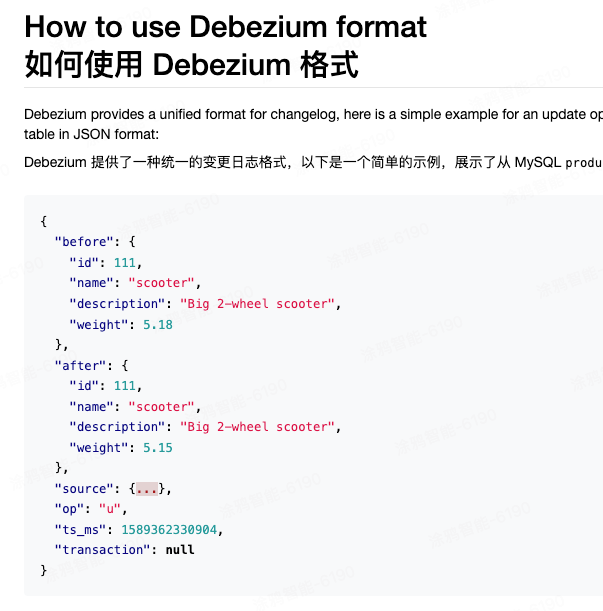
Debezium | Apache Flink

相关推荐
叶总没有会7 小时前
RabbitMQ高级
分布式·rabbitmq
ABB自动化10 小时前
ABB 500CIM06 (1MRB150077R0111) | REB500 通信接口
大数据·分布式·系统架构·系统安全·模块测试·plc 控制器
ZENERGY-众壹10 小时前
告别本地工控机:分布式光伏 SCADA 架构如何实现云边协同
分布式·架构·光伏运维·能源数字化·电站监控
code_slave(码畜)10 小时前
微服务架构落地:读写分离架构 —— 主从延迟引发的“刚开单查不到”灾难与破局
spring boot·分布式·spring cloud·微服务·云原生·架构·读写分离
JAVA_AI人工智能项目实战12 小时前
分布式大模型训练_学习笔记
人工智能·分布式·语言模型·自然语言处理
starzy199012 小时前
KafkaProducer 源码深度剖析:RecordAccumulator 封装消息流程
大数据·kafka
星夜孤帆12 小时前
Redis缓存击穿与分布式锁实战:专栏目录、源码与实验说明
redis·分布式·缓存
yyk3332414 小时前
Spark介绍
大数据·分布式·spark
成为你的宁宁14 小时前
【基于 SSH 与 JNLP 协议的 Jenkins 分布式构建方案】
分布式·jenkins