spark sort shuffer 和 hash shuffer 图解对比

sort shuffer 和 hash shuffer 图解对比

Hash Shuffle(Spark 1.x 已废弃)------ 文件数 = M * R
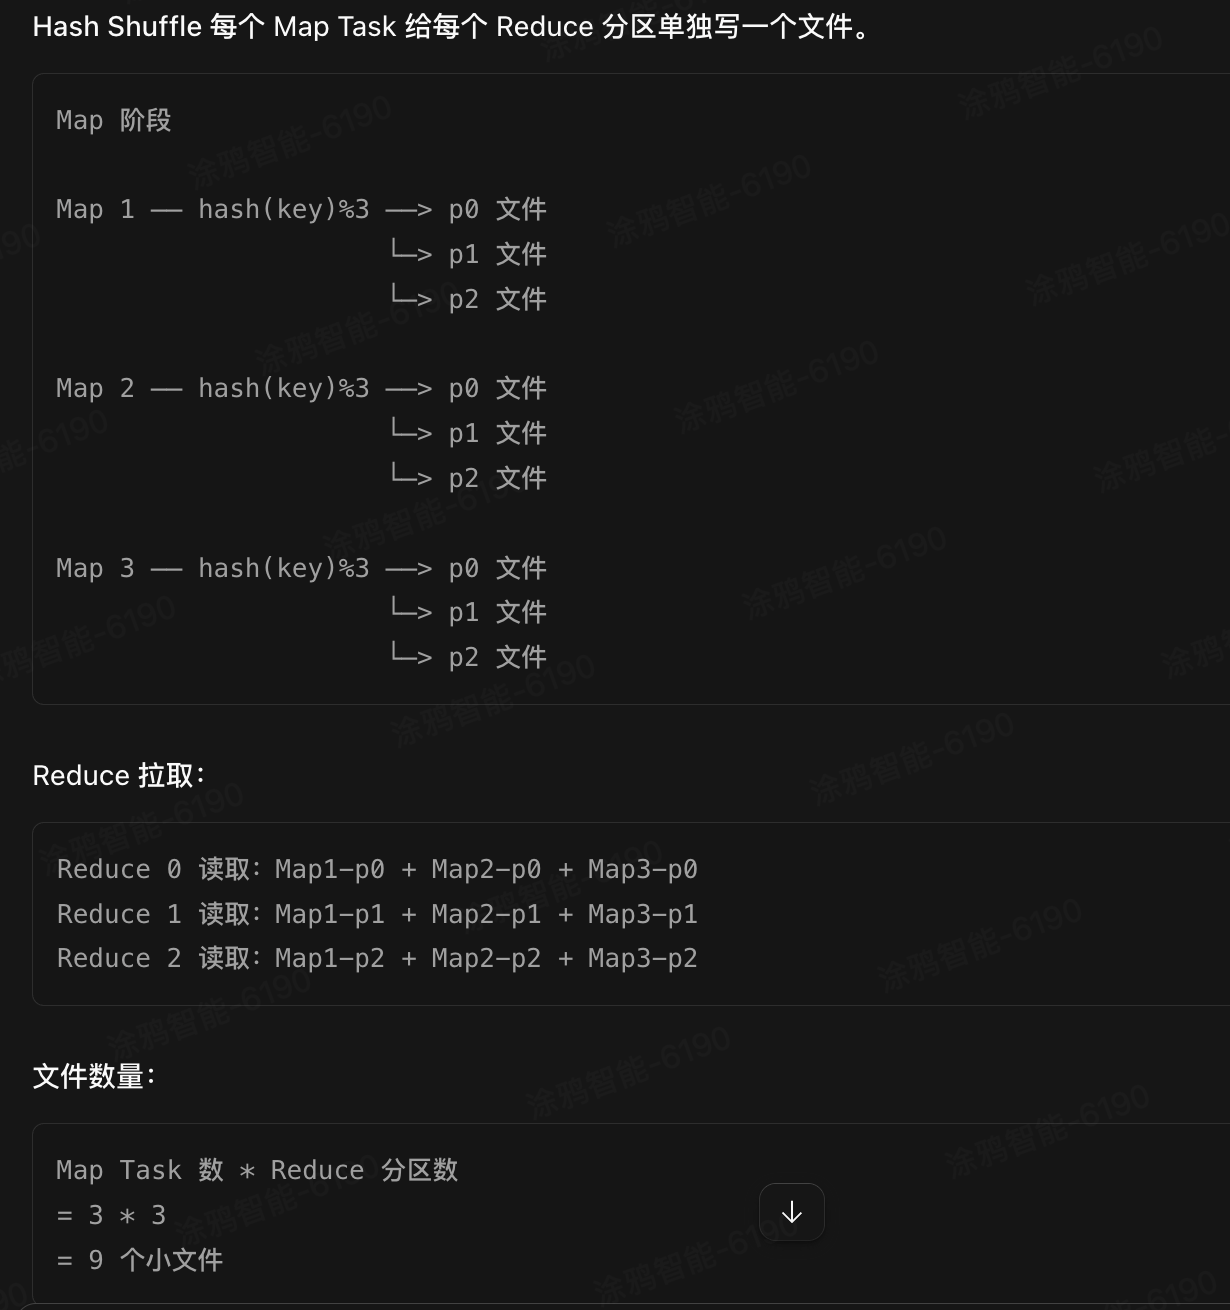
如果是:

复制代码
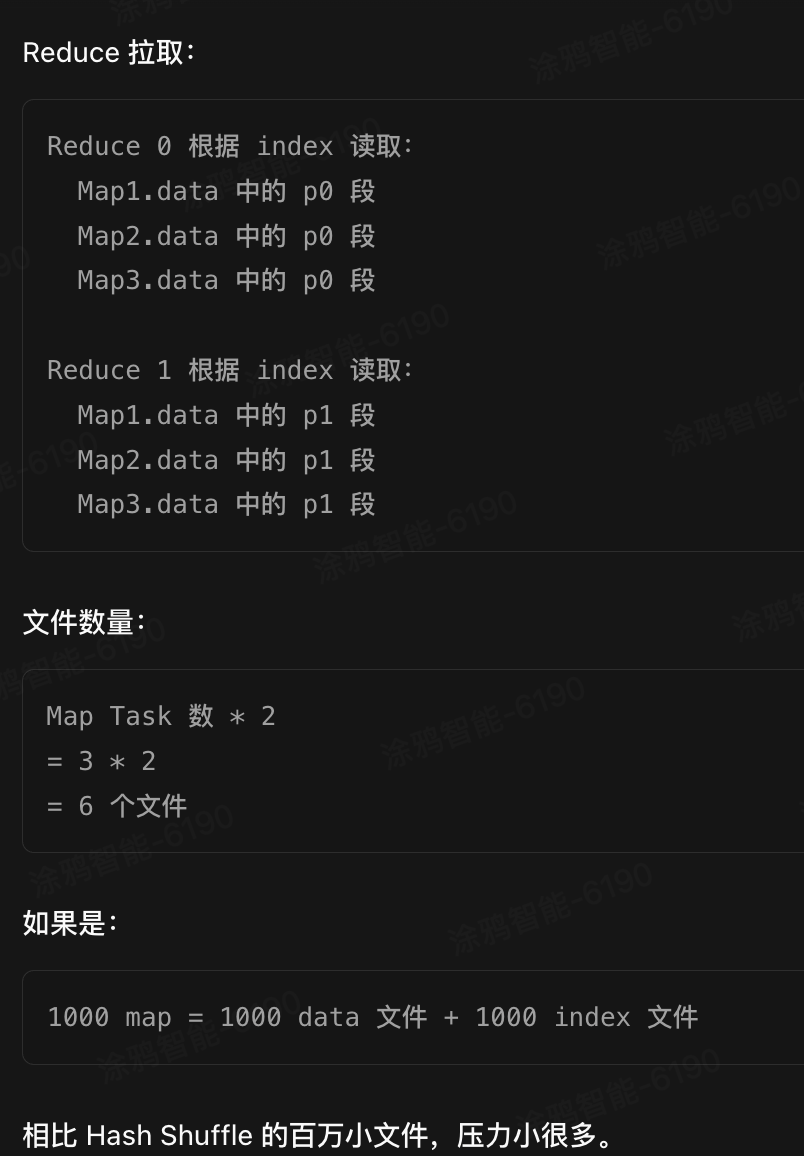
1000 map * 1000 reduce = 100 万个文件

这就是 Hash Shuffle 最大问题:小文件爆炸。

sort shuffle
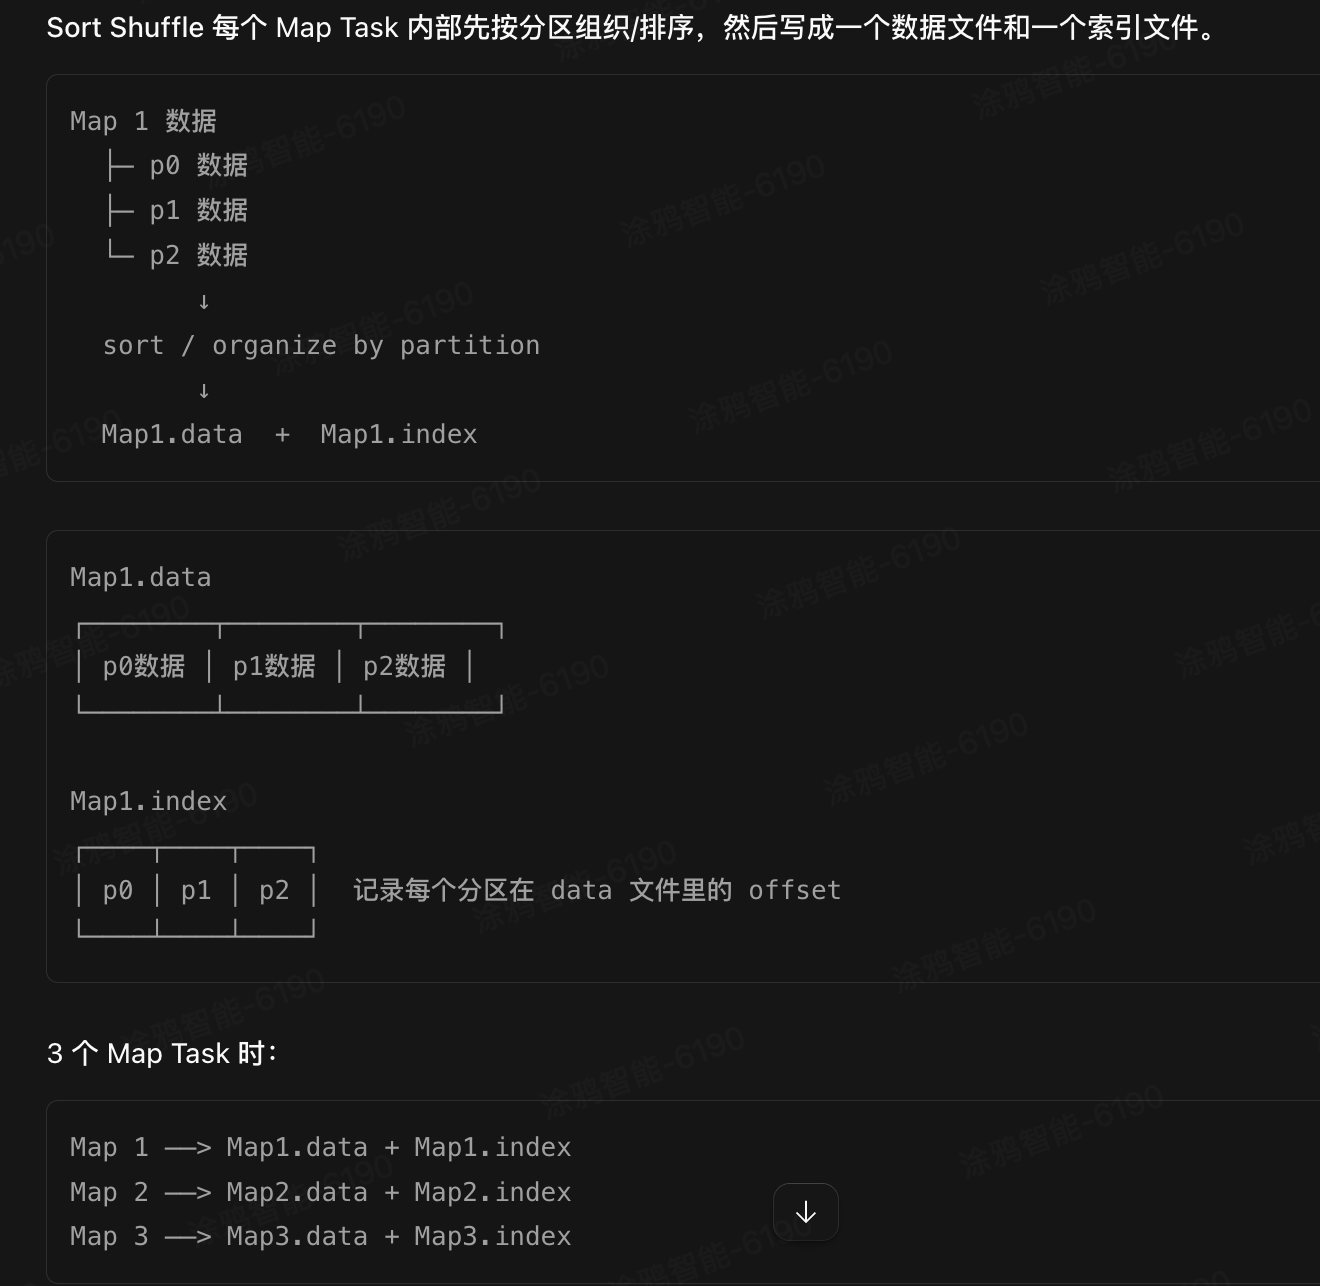
上图可见 data 下 p0 p1 p2各自连续存储,即reduce0过来拉p0内所有数据.
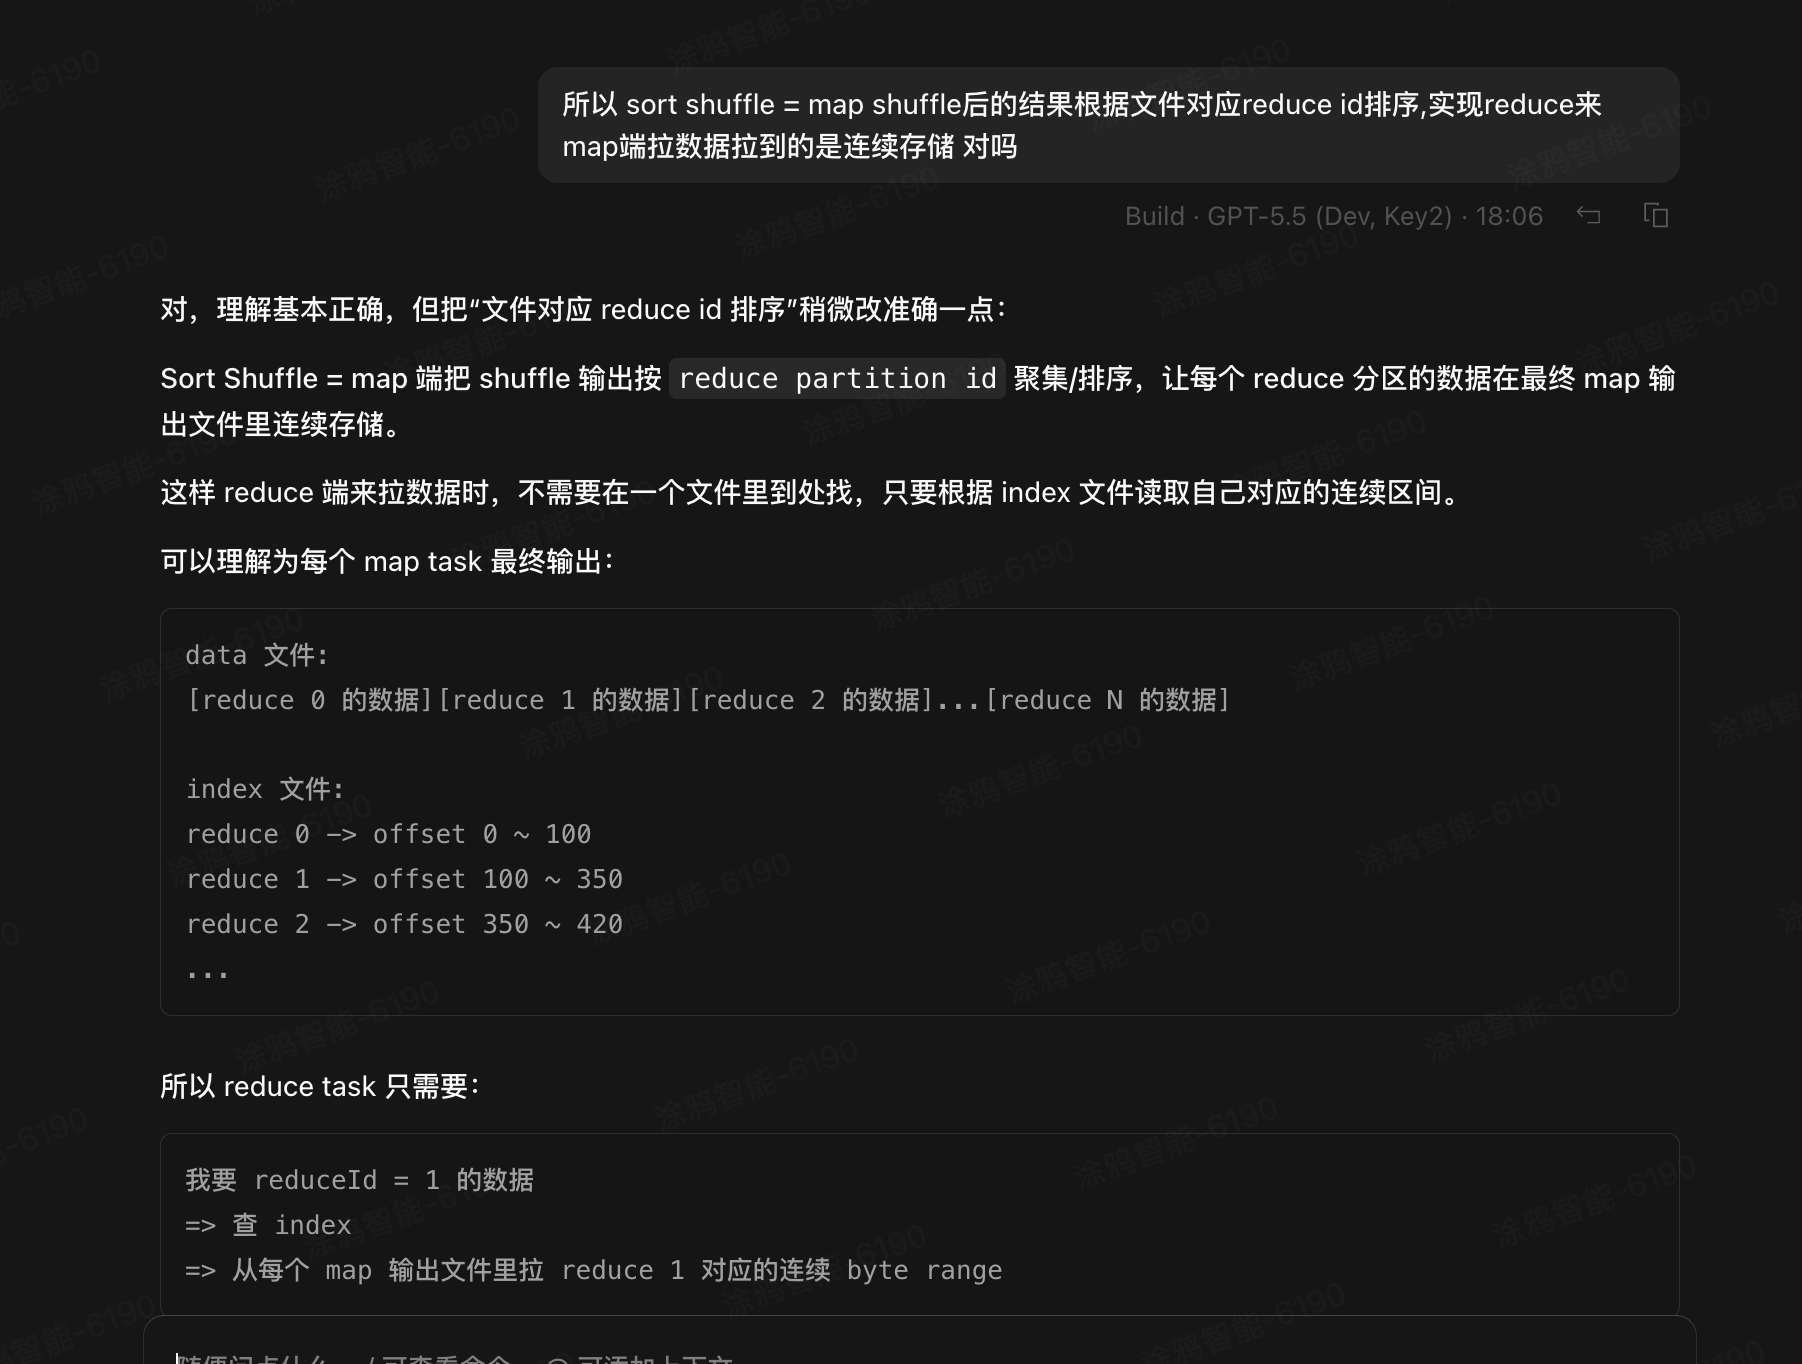
对比
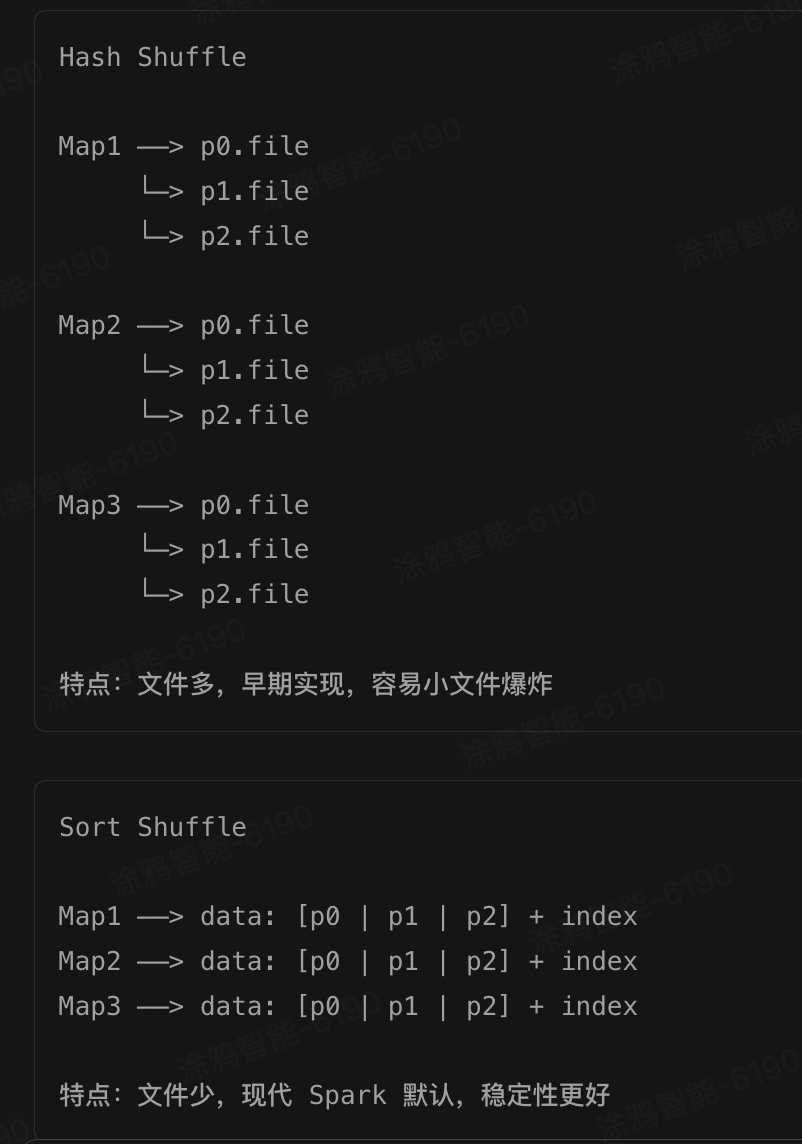
Hash Shuffle:每个 map 为每个 reduce 写一个文件,小文件多。

Sort Shuffle:每个 map 写一个 data 文件和一个 index 文件,reduce 按 index 读取对应分区数据。
相关推荐
布莱克6059 小时前
C++ 中 map 的 insert 与 emplace:key 已存在时会覆盖吗?
开发语言·数据结构·c++·算法·map
D e re k ZH12 小时前
C++ 系统学习手记:从语法细节到工程实践
开发语言·数据结构·c++·算法
石小石Orz13 小时前
AI 正在蚕食我们的编码能力
前端·后端·算法
民乐团扒谱机14 小时前
【微实验】NSGA-II(非支配排序遗传算法)——解决多目标优化问题的“自然选择模拟器”
linux·人工智能·算法
青少儿编程课堂15 小时前
蓝桥杯·全国青少年信息素养大赛·电子学会Python/C++考级:中缀表达式求值解析
c++·python·算法·bfs·信息学竞赛
武子康17 小时前
Qwen-Drive 到底是什么:4B 级 VLM 如何成为驾驶策略底座
人工智能·算法·机器学习
zh_xuan18 小时前
LeeCode 496. 下一个更大元素I
数据结构·算法·栈·单调栈
机 _ 长18 小时前
05 智算运维|8 张卡怎么才算「捆成一张」:NCCL 实测与拓扑
运维·人工智能·算法·智算运维
早起CaiCai19 小时前
【2023-01 OM】利用深度学习算法融合异质观测实现海洋场降尺度
人工智能·深度学习·算法