手写 ReAct 循环:搞懂 Agent 工具调用
用 Node.js + 本地模型(qwen3-1.7b)实现 ReAct(推理-行动-观察)循环的多工具调用,不用任何 Agent SDK,手写完整的工具调用循环,把框架封装掉的底层协议细节全部摊开。
写作目的:不为造轮子,而是吃透 OpenAI tools 协议与 Agent 框架的底层原理------看懂这套"乒乓球"循环后,LangChain、@openai/agents 等框架的工具调用部分对你就再也没有黑盒。
一、为什么需要多工具
单个工具只能解决单一问题:查天气、查新闻、看时间各管一摊。但真实需求往往是复合的:
- "北京和上海今天哪里更热?" → 要同时调两次天气工具(并行)
- "帮我看看今天 AI 新闻里第一条的正文" → 要先 查新闻拿链接,再读网页(顺序依赖)
这就是多工具调用要解决的两类核心场景:彼此独立的工具并行跑 、有依赖关系的工具串行跑。而这两种模式,在 OpenAI tools 协议里其实是同一套机制的不同表现------先看懂协议,两种模式就都通了。
二、工具调用的本质:一场"乒乓球"循环
模型自己不能执行代码,它只会"说"想调什么工具。真正的执行在本地。一次带工具的问答,实际是这样往返多次:
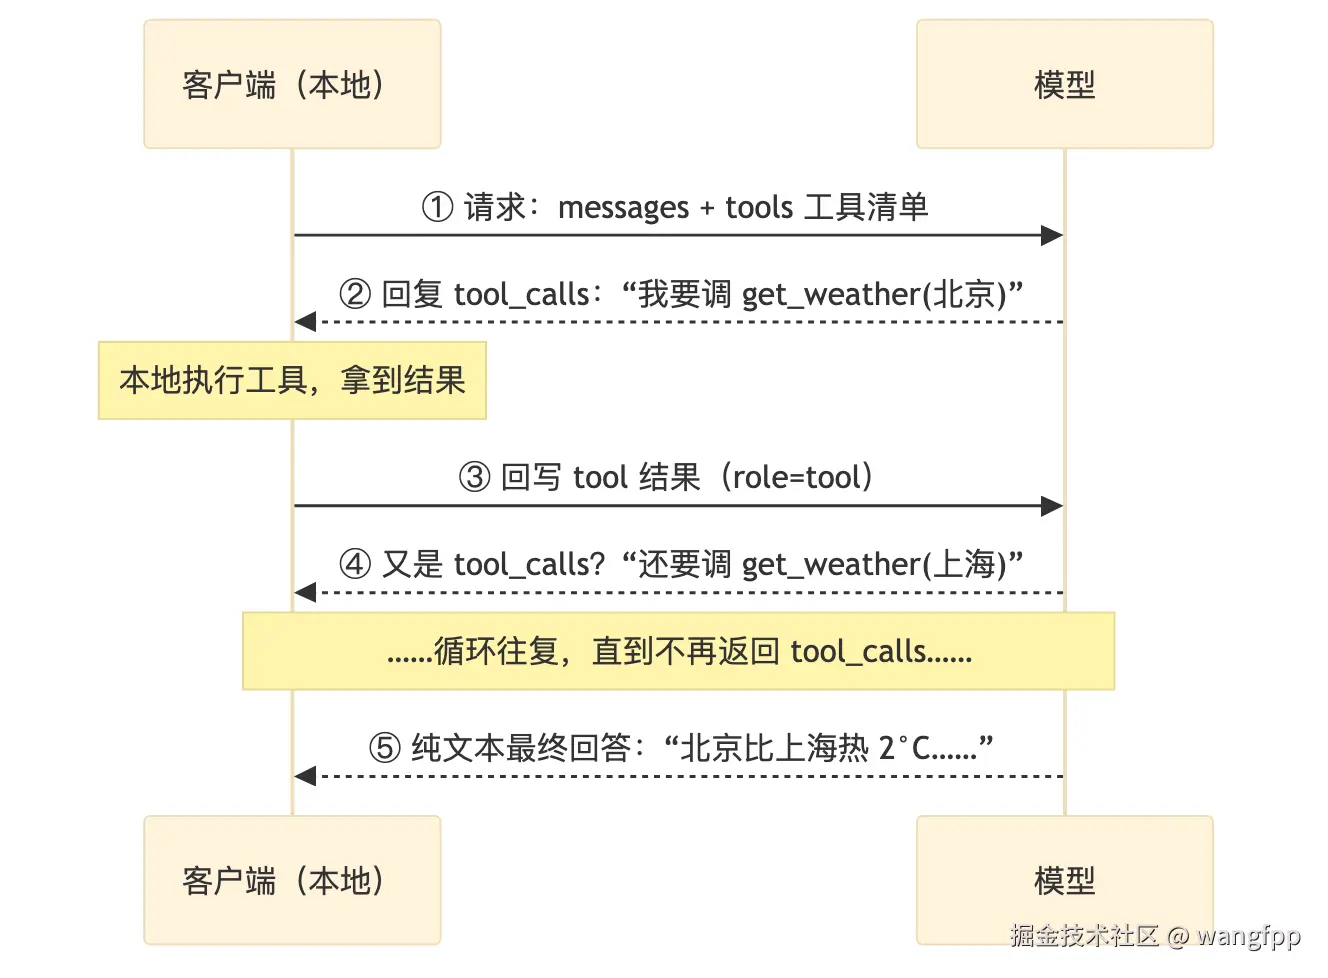
协议层面的四个关键点:
- 工具清单 放在请求的
tools参数里,每个工具用 JSON Schema 描述名字、用途、参数结构------这是模型"选工具、填参数"的唯一依据 - 模型决定调工具时,响应的 message 里带
tool_calls数组:工具名 + JSON 字符串参数 。注意参数是字符串,要本地JSON.parse - 工具执行结果以
{ role: "tool", tool_call_id, content }消息回写,tool_call_id把结果和那次调用配对 - 带
tool_calls的 assistant 消息必须原样回写进 messages ,再带上 tool 结果重新请求,直到模型不再返回tool_calls
一次完整问答的消息数组最终长这样:
scss
[system, user, assistant(tool_calls=[A, B]),   ← 模型第1轮:要调 A 和 B
 tool(tool_call_id=A), tool(tool_call_id=B),
 assistant(tool_calls=[C]),      ← 模型第2轮:再调 C
 tool(tool_call_id=C),
 assistant(content="最终回答")]   ← 循环结束
三、ReAct 实战:用一个例子拆解"推理-行动-观察"
上一节讲的是协议格式,这一节回答"模型凭什么知道下一步干什么"------答案是 ReAct (Reasoning + Acting,出自 Yao et al. 2022 论文):让模型交替进行推理(Thought)和行动(Action),每次行动后**观察(Observation)**结果,再继续推理,直到任务完成。这个循环就是所有 Agent 框架的心脏。
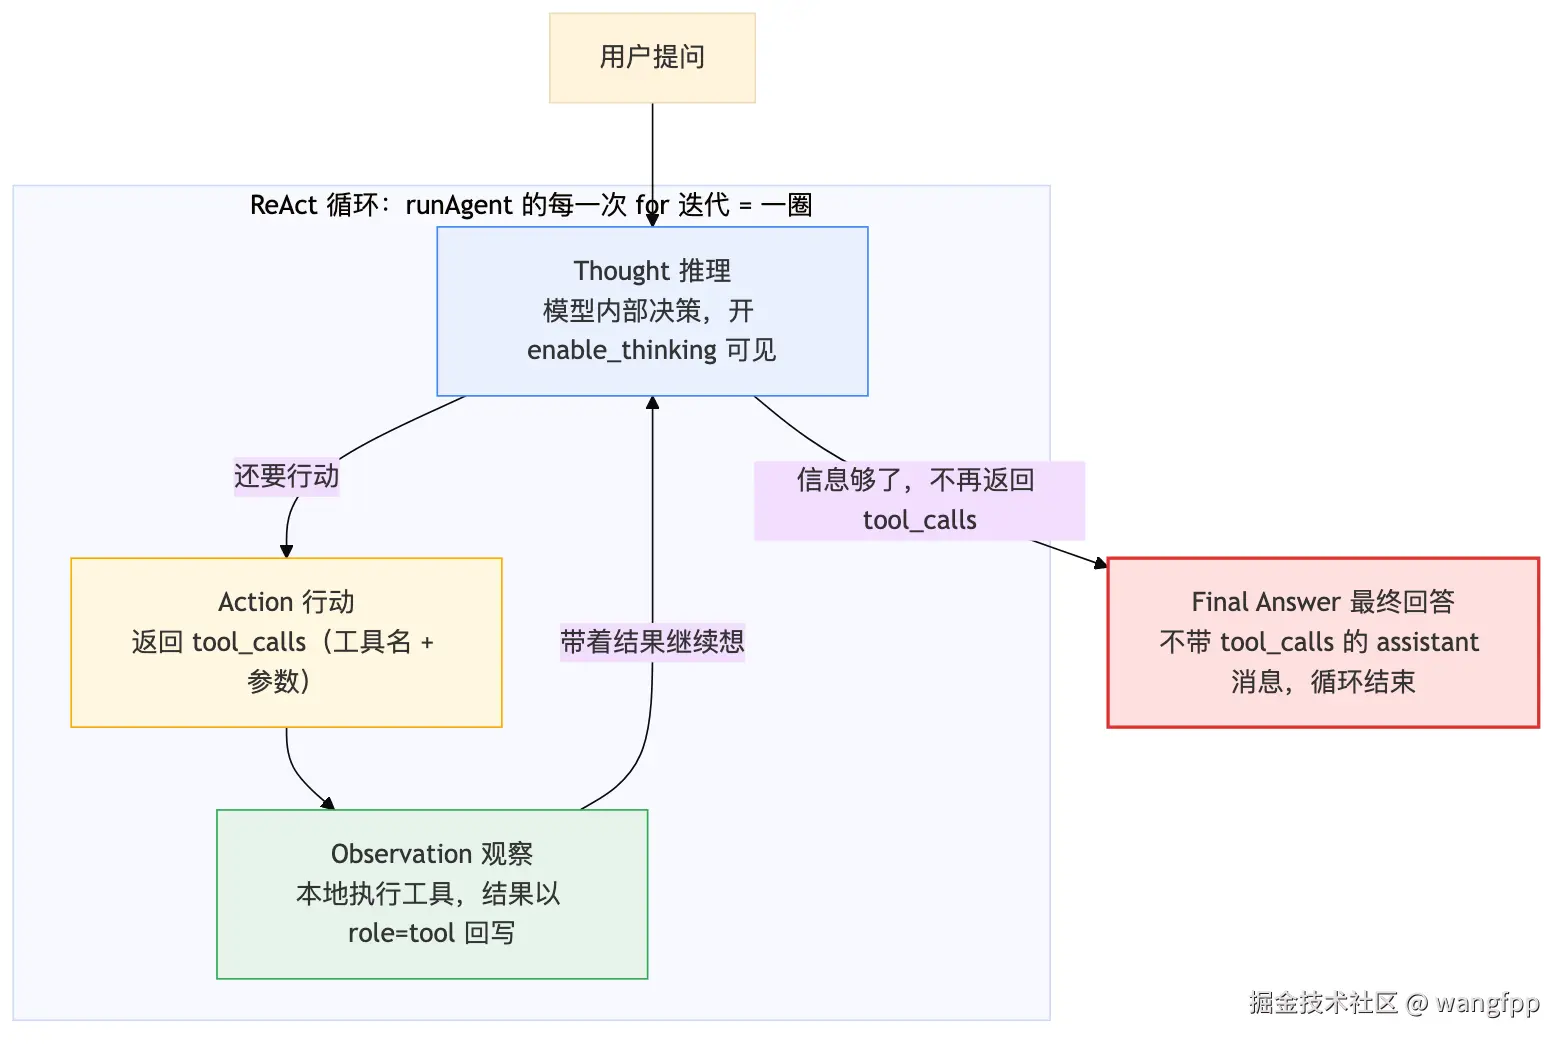
ReAct Loop(AI Agent,Reason + Act)
论文:ReAct: Synergizing Reasoning and Acting in Language Models (2022),Yao et al.
ReAct = Reasoning(Thought) + Acting(Action),是大模型 Agent 最经典的循环范式,交替做思考、调用工具、接收环境观察,直到任务结束。
🔁 循环流程(核心三步,反复迭代)
- Thought(思考):LLM 基于当前上下文,分析现状、推理下一步策略,写明思考过程。
- Action(行动):模型输出工具调用指令(搜索 / 查库 / 计算器等),交给外部环境执行。
- Observation(观察):外部环境返回执行结果,把结果追加到上下文。
回到第一步,继续循环;直到模型判断任务完成,输出 Final Answer 终止循环。
3.1 实例:论文原貌
用户提问:"帮我看看今天 AI 新闻里第一条的正文。"按 ReAct 论文的经典格式,模型的思考过程是这样:
css
Thought 1: 用户要看 AI 新闻正文,但没给链接。
           我需要先用 get_news 拿到新闻列表。
Action 1:  get_news(topic="人工智能")
Observation 1: [{"title":"国产大模型...","link":"https://www.thepaper.cn/newsDetail_forward_123"}, ...共5条]

Thought 2: 拿到列表了,第一条的链接是 newsDetail_forward_123,
           用 read_url 读它的正文。
Action 2:  read_url(url="https://www.thepaper.cn/newsDetail_forward_123")
Observation 2: {"title":"国产大模型...","summary":"今日,某实验室发布..."}

Thought 3: 正文已拿到,可以回答用户了,不需要再调工具。
Final Answer: 今天 AI 新闻第一条是《国产大模型...》,主要内容是......
注意两个体现 ReAct 精髓的细节:
- Action 2 的 url 不是用户给的,是模型从 Observation 1 里自己读出来的------"观察→推理→新行动"正是 ReAct 能处理依赖链任务的原因
- Thought 3 决定"不再行动"------什么时候停下,同样是推理出来的
3.2 ReAct 与 tools 协议的对应关系
在 OpenAI tools 协议里,论文中显式的 Thought 被收进了模型内部(开 enable_thinking 可以看到),Action / Observation 则有了结构化的载体:
| ReAct 概念 | 论文形式 | tools 协议中的对应 |
|---|---|---|
| Thought(推理) | 显式文本,写在 prompt 里 | 收进模型内部,每轮请求前的"想" |
| Action(行动) | Action: 工具名[参数] 文本 |
tool_calls 数组(工具名 + JSON 参数) |
| Observation(观察) | 工具输出拼回 prompt | role: "tool" 消息回写进 messages |
| Final Answer | Final Answer: 文本 |
不带 tool_calls 的 assistant 消息 |
也就是说:runAgent 的每一次 for 循环,就是 ReAct 的一次"Thought → Action → Observation" 。下一节的 runAgent 代码就是它的工程落地。
3.3 实例走查:循环每轮发生了什么
把这个例子放进 runAgent 循环,逐轮追踪 messages 数组:
| 轮次 | Thought(模型内部推理) | Action(返回的 tool_calls) | Observation(回写的 tool 消息) |
|---|---|---|---|
| 1 | 要正文得先有链接 | get_news({"topic":"人工智能"}) |
5 条新闻,含 link |
| 2 | 第一条的 link 可用 | read_url({"url":"https://..."}) |
网页标题 + 正文摘要 |
| 3 | 信息够了,直接回答 | 无 → 循环结束 | --- |
这正是第二节消息数组展开后的真实内容------"查列表 → 读详情"是 ReAct 最常见的依赖链形态。
3.4 从实例得到的两条工程结论
- Observation 的质量决定 Thought 的质量 :
get_news返回了结构化的 title/link 字段,模型才能准确提取 url;如果工具返回一段含糊文本,模型就容易填错参数。工具输出的设计,本质是在为模型的下一步推理"供料" - 推理不可见 ≠ 推理不存在:tools 协议隐藏了 Thought,但模型每轮都在基于全部 messages 做决策。这也是为什么错误信息也要回写给模型(详见第四节)------它同样是 Observation,是下一轮推理的输入
四、手写协议:multi-tool.js 核心实现
4.1 工具定义:声明写得越具体,小模型越不容易选错
工具集抽在 utils/tools.js,每个工具 = definition(给模型看的声明)+ execute(本地实现):
javascript
export const getWeather = {
    definition: {
        type: "function",
        function: {
            name: "get_weather",
            description: "查询指定城市的实时天气,包括温度、体感温度、湿度、风力",
            parameters: {
                type: "object",
                properties: {
                    city: { type: "string", description: "城市名称,如:北京、上海" },
                },
                required: ["city"],
            },
        },
    },
    execute: async ({ city }) => { /* fetch wttr.in,返回 JSON 字符串 */ },
};

// 工具注册表:整体传给模型,按 name 查找执行
export const TOOLS = [getWeather, getNews, getTime, readUrl];
export const TOOL_MAP = Object.fromEntries(TOOLS.map((t) => [t.definition.function.name, t]));
本项目注册了四个工具,其中 read_url 是依赖型工具 ------它的 url 参数必须来自 get_news 的返回结果,这正是顺序执行的素材。
4.2 模型请求:流式 + 思考可视化
初版用非流式(一次拿到完整 JSON,解析 tool_calls 简单可靠),但页面看不到打字效果,也看不到思考过程。改成流式后,每轮的 reasoning_content(思考)和 content(正文)增量都能实时转发给页面:
javascript
async function callModelStream(messages, { onReasoning, onContent } = {}) {
    const response = await fetch(`${BASE_URL}/chat/completions`, {
        method: "POST",
        headers: { "Content-Type": "application/json", Authorization: `Bearer ${process.env.DASHSCOPE_API_KEY}` },
        body: JSON.stringify({
            model: MODEL,
            messages,
            tools: TOOLS.map((t) => t.definition),
            tool_choice: "auto",      // 模型自主决定是否调工具
            stream: true,
            temperature: 0.3,
            max_tokens: 4096,         // thinking 会占输出预算,太小会导致 content 为空
            enable_thinking: true,    // 开启后才有 reasoning_content
        }),
    });

    let content = "";
    const toolCalls = []; // 按 delta.index 累积的 tool_calls
    await parseSSEStream(response, (data) => {
        const delta = data.choices?.[0]?.delta ?? {};
        if (delta.reasoning_content) onReasoning?.(delta.reasoning_content);
        if (delta.content) {
            // 工具轮的 content 常只是换行等空白副产品:纯空白不转发页面,避免打乱展示顺序
            if (delta.content.trim() || content.trim()) onContent?.(delta.content);
            content += delta.content;
        }
        // tool_calls 分片到达:每片带 index,type/id/name 只在首片,arguments 分多片
        for (const tc of delta.tool_calls ?? []) {
            const acc = (toolCalls[tc.index] ??= { id: "", type: "function", function: { name: "", arguments: "" } });
            if (tc.id) acc.id = tc.id;
            if (tc.type) acc.type = tc.type;
            if (tc.function?.name) acc.function.name += tc.function.name;
            if (tc.function?.arguments) acc.function.arguments += tc.function.arguments;
        }
    });

    // 拼成与非流式同构的完整 message,循环逻辑无需感知流式细节
    return { role: "assistant", content, ...(toolCalls.length ? { tool_calls: toolCalls } : {}) };
}
三个设计要点:
- 流式下无法提前知道本轮是"调工具"还是"最终回答" :只能先转发增量、流结束后看
tool_calls是否累积出内容再决定循环去留。所以返回值拼成与非流式同构的 message,上层循环逻辑一行不用改 tool_calls分片累积是流式的核心难点 :每个分片带index,type/id/name只在首片出现,arguments被切成多片,必须按 index 逐片拼接(坑 5 详述)tool_choice: "auto":由模型自己判断要不要调工具。其他可选值:"none"禁止调工具、"required"必须调一个、指定具体函数名则强制调该工具
4.3 工具执行:错误也要作为结果返回
javascript
async function executeToolCall(call) {
    const tool = TOOL_MAP[call.function.name];
    if (!tool) return `未找到工具 ${call.function.name}`;
    let args;
    try {
        args = JSON.parse(call.function.arguments || "{}"); // 参数是 JSON 字符串
    } catch {
        return `工具参数不是合法 JSON: ${call.function.arguments}`;
    }
    try {
        return String(await tool.execute(args));
    } catch (e) {
        return `工具执行失败: ${e.message}`;
    }
}设计原则:execute 永远返回字符串,失败时返回错误描述而不是抛异常。因为结果是回写给模型看的------模型读到"参数不是合法 JSON"就能在下一轮自行修正参数;而如果抛异常中断流程,模型连纠错的机会都没有。
4.4 工具调用循环(全文核心)
javascript
const MAX_TOOL_ROUNDS = 5; // 循环上限,防止模型反复调工具陷入死循环

async function runAgent(userMessage, { onToolCall, onToolResult, onReasoning, onContent } = {}) {
    const messages = [
        { role: "system", content: SYSTEM_PROMPT },
        { role: "user", content: userMessage },
    ];

    for (let round = 1; round <= MAX_TOOL_ROUNDS; round++) {
        const message = await callModelStream(messages, { onReasoning, onContent });

        // 无 tool_calls → 本轮增量就是最终回答(已流式推给页面),循环结束
        if (!message.tool_calls?.length) {
            return message.content ?? "";
        }

        messages.push(message); // ★ 原样回写带 tool_calls 的 assistant 消息

        // 同一轮的多个 tool_calls 彼此独立 → 并行执行;
        // 回调顺序:调用行几乎同时发出(并行启动),结果行按完成先后发出,如实反映并行
        const results = await Promise.all(message.tool_calls.map(async (call) => {
            onToolCall?.(`调用工具 ${call.function.name}(${call.function.arguments})`);
            const result = await executeToolCall(call);
            onToolResult?.(`工具结果 ${call.function.name} → ${result}`);
            return { callId: call.id, result };
        }));

        // 逐个回写结果,靠 tool_call_id 与调用配对
        for (const { callId, result } of results) {
            messages.push({ role: "tool", tool_call_id: callId, content: result });
        }
    }
    return `工具调用超过 ${MAX_TOOL_ROUNDS} 轮,未能完成任务`;
}循环的终止条件只有一个:模型的回复里不再带 tool_calls 。MAX_TOOL_ROUNDS 是保险丝------小模型偶尔会拿着同样的参数反复调同一个工具,没有上限就会一直烧下去。
五、并行 vs 顺序:两种执行模式
5.1 并行:同一轮的多个 tool_calls
问"北京和上海今天天气怎么样",模型会在同一次回复 里返回两个 tool_calls。协议语义上它们彼此独立,所以本地用 Promise.all 并行执行:
javascript
const results = await Promise.all(message.tool_calls.map((call) => executeToolCall(call)));- 总耗时 ≈ 最慢的那个工具,而串行是所有工具耗时之和。天气接口单次约 1~2 秒,两个工具并行能省下一半等待
- 回写结果时顺序无所谓,模型靠
tool_call_id配对,不靠位置
5.2 顺序:跨轮次的工具依赖链
问"看看今天 AI 新闻第一条的正文",模型不可能一轮完成------它必须先拿到链接。于是协议自然形成跨轮次的串行链:
ini
第1轮:模型返回 tool_calls=[get_news(topic=人工智能)]
       → 本地执行,结果(含每条新闻的 link)回写
第2轮:模型从上一轮结果中提取第一条的 link,
       返回 tool_calls=[read_url(url=那个链接)]
       → 本地执行,网页内容回写
第3轮:模型不再调工具,整理正文给出最终回答注意这里的关键:第二次的参数是模型自己从上一轮 tool 结果里"读"出来填的。依赖链不是代码写死的,而是模型基于上下文推理出来的------这也是 system prompt 里那句"先用 get_news 获取链接,再用 read_url 读取"的作用:给小模型指路。
5.3 对比总结
| 并行执行 | 顺序执行 | |
|---|---|---|
| 触发方式 | 模型一轮返回多个 tool_calls | 模型多轮、每轮返回一个(或多个)tool_calls |
| 参数来源 | 都来自用户问题,彼此独立 | 后一个依赖前一个的结果 |
| 本地实现 | Promise.all 同时跑 |
天然串行:上一轮结果回写后才有下一轮 |
| 耗时 | ≈ 最慢工具 + N 次模型推理 | 所有工具之和 + N 次模型推理 |
| 典型场景 | 多城市天气、多关键词新闻 | 查列表 → 读详情、搜索 → 追问 |
| 谁决定 | 模型自主决定(tool_choice: auto) |
模型基于上下文推理 + prompt 引导 |
一句话记忆:并行发生在"轮内",顺序发生在"轮间"。轮内能不能并行由模型决定(它一次给几个 tool_calls),轮间的顺序由数据依赖决定。
六、给小模型的 system prompt 设计
大模型看工具声明就能用得八九不离十,小模型需要更直白的指令。本项目的 prompt 只有四条短句:
markdown
你是一个会使用工具的中文助手。
1. 涉及天气、新闻、当前时间等实时信息,必须先调用对应工具,禁止凭空编造。
2. 需要看某条新闻的正文时,先用 get_news 获取链接,再用 read_url 读取该链接。
3. 拿到工具结果后,用简洁的中文整理出回答。
4. 不需要工具的问题直接回答。
经验总结:
- 短:小模型上下文理解力有限,指令越短遵从度越高
- 先判断再行动:第 4 条明确"不需要工具就直接回答",避免什么问题都去调工具
- 显式写依赖链:第 2 条直接告诉模型 get_news→read_url 的先后关系,顺序执行的成功率明显提升
延伸阅读
- ReAct 原始论文 (Yao et al., 2022, ICLR 2023):ReAct: Synergizing Reasoning and Acting in Language Models ------本文的理论源头,首次提出 Thought → Action → Observation 交替循环。arxiv.org/abs/2210.03...
- Chain-of-Thought 论文 (Wei et al., 2022, NeurIPS):Chain-of-Thought Prompting Elicits Reasoning in Large Language Models ------思维链奠基之作,ReAct 的推理部分本质上即 CoT 与工具调用的结合。arxiv.org/abs/2201.11...
- OpenAI Function Calling 官方文档 :OpenAI tools 协议的事实标准定义,涵盖
tools参数结构、tool_calls响应格式、tool_choice取值、流式分片机制等全部细节。platform.openai.com/docs/guides... - LangChain :最流行的开源 Agent 框架,
AgentExecutor封装了本文手写的 ReAct 循环;langgraph支持更复杂的多 Agent 状态流转。github.com/langchain-a... - @openai/agents SDK :OpenAI 官方轻量级 Agent SDK,将工具循环、并行执行等底层细节封装在
Agent.run()中,适合生产环境快速落地。github.com/openai/open... tool_choice的四种取值 :auto(模型自主)/none(禁用)/required(必须调用其一)/ 指定函数对象(强制调某个工具)。生产里做"意图强制分流"时很有用- Agent 协议的三层格局:模型↔工具层已收敛为 OpenAI tools 事实标准(各家兼容服务直接支持);工具接入层 MCP(Model Context Protocol)正在成为跨 Agent 复用工具的标准;而 Agent↔前端的 SSE 事件格式仍是各家自造(本文的 reasoning/tool/content 事件也是),AG-UI、ACP 等新标准正在试图统一这层