让 SGLang 按 JSON 回答,怎样少写一些补救代码
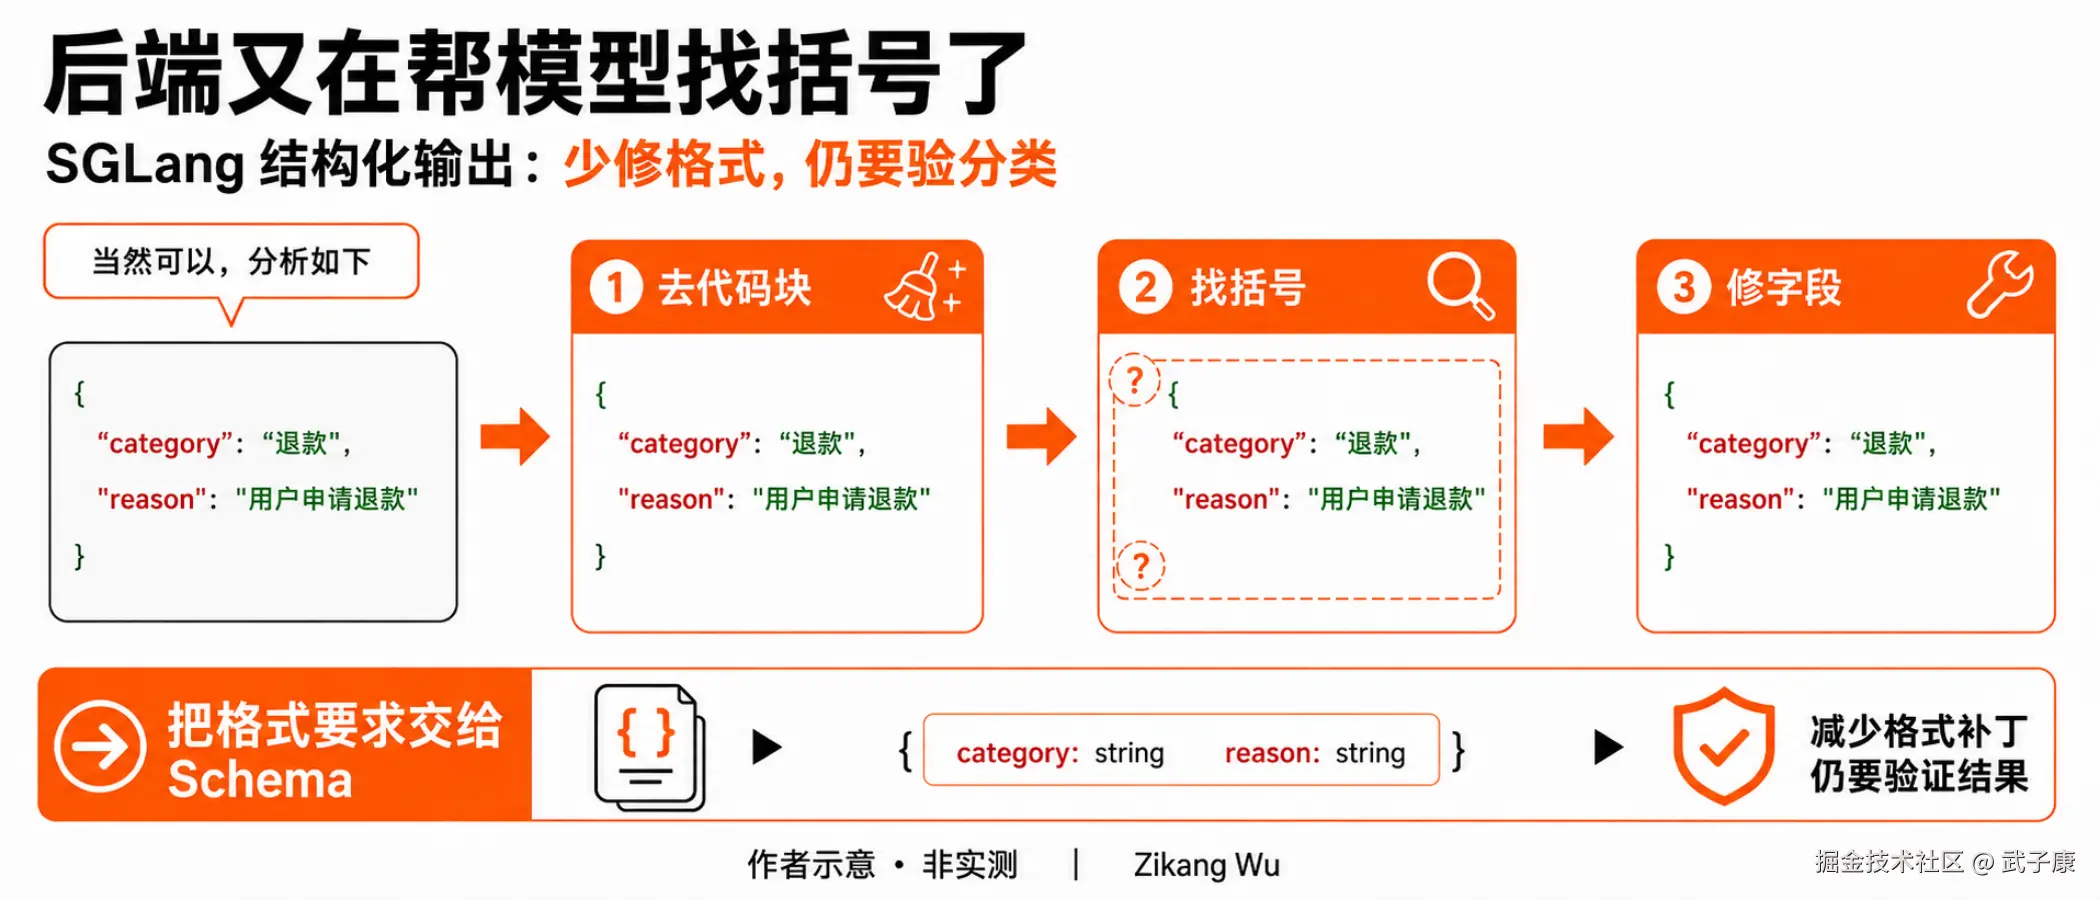
你让模型把客服工单分成"物流、退款、其他",后端等着读 JSON。它却先回一句"当然可以,分析如下",再给结果。有时外面包着代码块,有时把约定好的 refund 写成中文"退款"。
于是程序开始去代码块、找左大括号、修字段名。真正的分类还没开始,已经在清理模型的表达习惯。
SGLang 可以通过 JSON Schema 约束输出结构。下面用一份工单走完请求配置和返回验证,看看哪些补丁可以减少,哪些检查还得保留。示例依据公开接口改写,本文未部署模型实跑。
先固定字段,再接请求
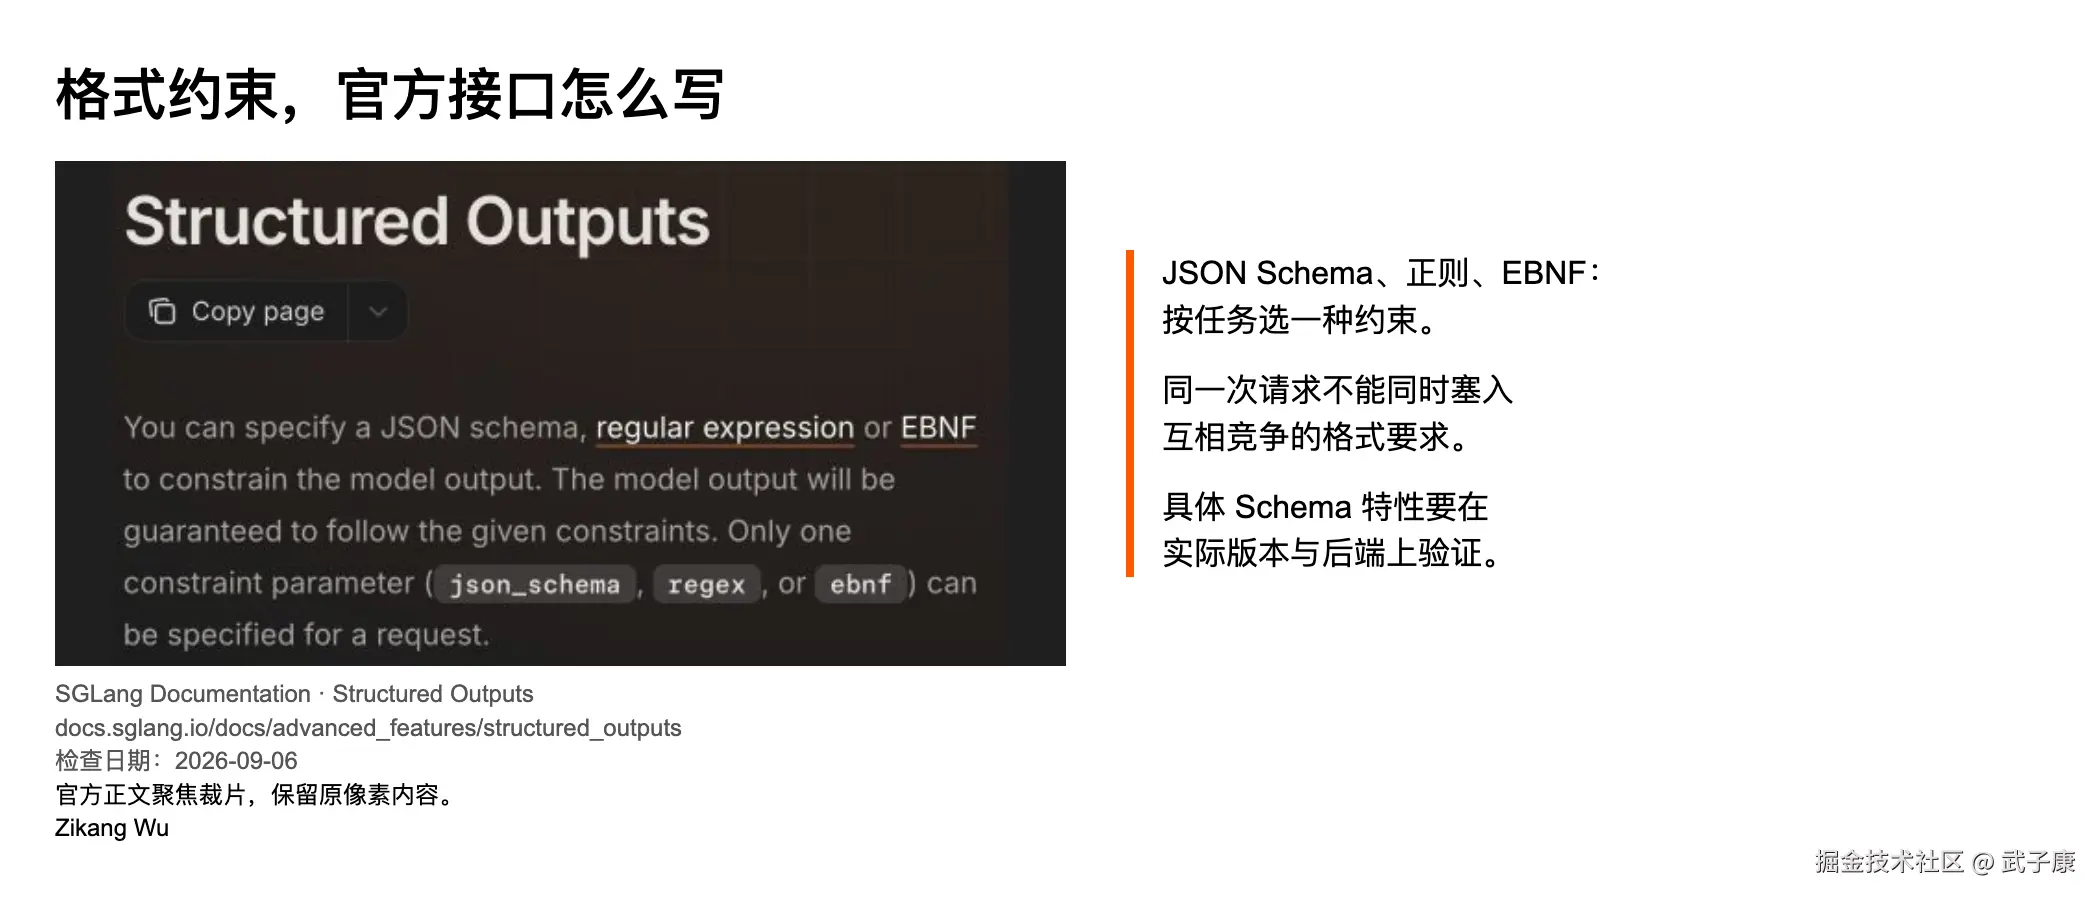
图中是 SGLang 官方 Structured Outputs 文档的原始聚焦截图,检查于 2026-09-06。它支持 JSON Schema、正则或 EBNF 等约束入口,并要求每个请求只指定一种主要约束参数。具体特性依赖实际版本和 grammar backend。官方说明
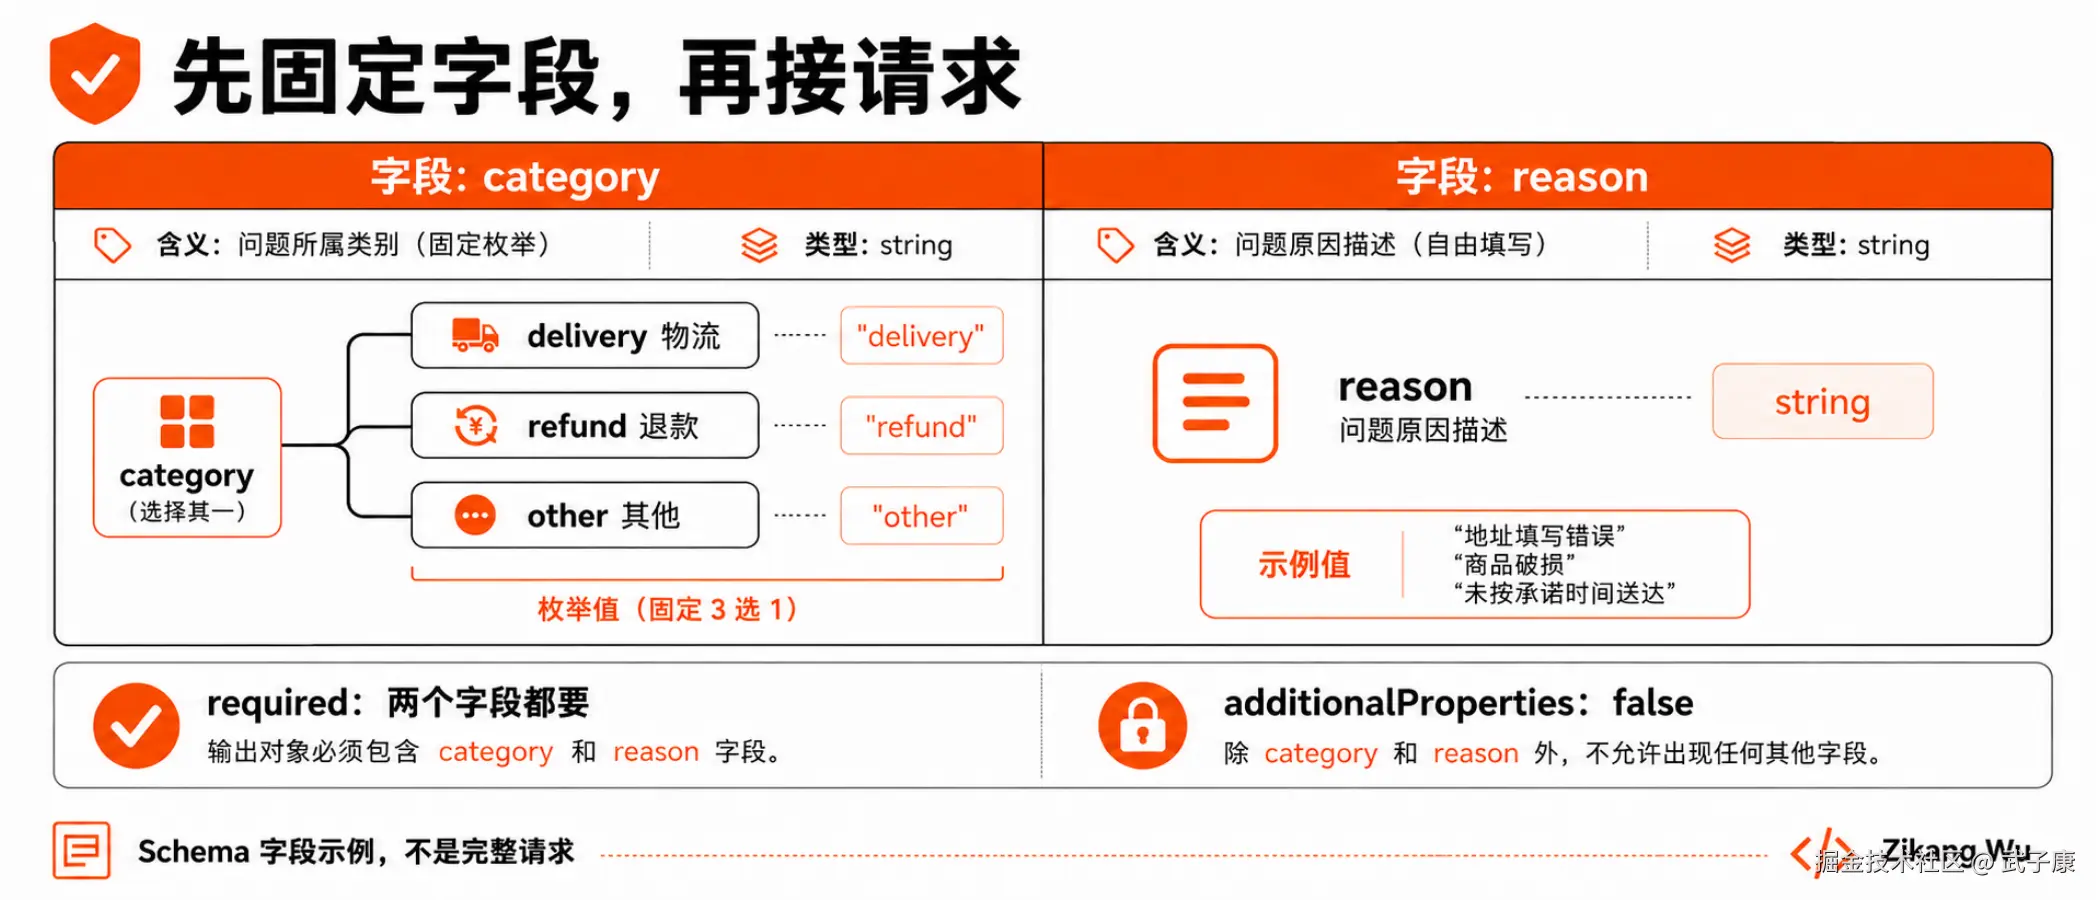
提示词里的"只输出 JSON"会影响模型倾向;Schema 则描述允许的结构。我们先把工单接口收窄到 category 和 reason 两个字段:
json
{
  "type": "object",
  "properties": {
    "category": {"type": "string", "enum": ["delivery", "refund", "other"]},
    "reason": {"type": "string"}
  },
  "required": ["category", "reason"],
  "additionalProperties": false
}
这里 enum 限制类别的三个可选值,required 要求两个字段都出现,additionalProperties 限制额外字段。后端不再需要同时兼容 type、label、category 三种随意命名。
将上面的对象放进兼容请求的 response_format.json_schema.schema,字段外层如下。它只是请求的一部分,还需要模型名、消息和足够的输出长度:
python
# schema = 上面的 JSON 对象转成 Python dict
response_format = {
    "type": "json_schema",
    "json_schema": {
        "name": "ticket_category",
        "schema": schema,
    },
}
提示词仍要写清楚业务类别怎么区分,尤其是同一工单包含多个诉求时按什么口径分。Schema 限制可选项,不能替你定义"物流问题归哪个团队"。复杂 Schema 也不能直接假定受支持,先用所选版本和后端验证。
只选三个类别,枚举就够了;固定编号可以考虑正则,更复杂的语言结构才考虑文法。约束越复杂,后端支持和生成停止条件越值得单独验证。
合法 JSON,也会把工单分错

约束解码会根据已生成的内容和结构规则,排除会破坏格式的下一步选择;模型在剩下的合法选项中继续生成。三个类别都在允许范围内,并不意味着它一定选对。
例如,工单写着:"已经退款,快递什么时候来取件?"假设我们的标签口径是按当前待处理诉求归类,这条应该进入 delivery。下面的结果却同样符合 Schema:
json
{"category":"refund","reason":"用户提到了退款"}这是一份作者构造的反例,不是模型实测输出。字段齐全、类型正确、类别也在枚举中,但它只盯着"退款"两个字,忽略了用户现在问的是取件。
所以验收至少要分开看:结构是否合格,类别是否符合人工标注。格式错误变少值得保留,但只报 JSON 能解析,还不足以说明分类可以进入业务。
收到完整结果后,再验一次
SGLang 官方示例在拿到完整返回内容后,仍调用 Pydantic 的 model_validate_json 验证对象。图中保留的是该代码末段的原始像素,检查于 2026-09-06。官方 JSON 示例
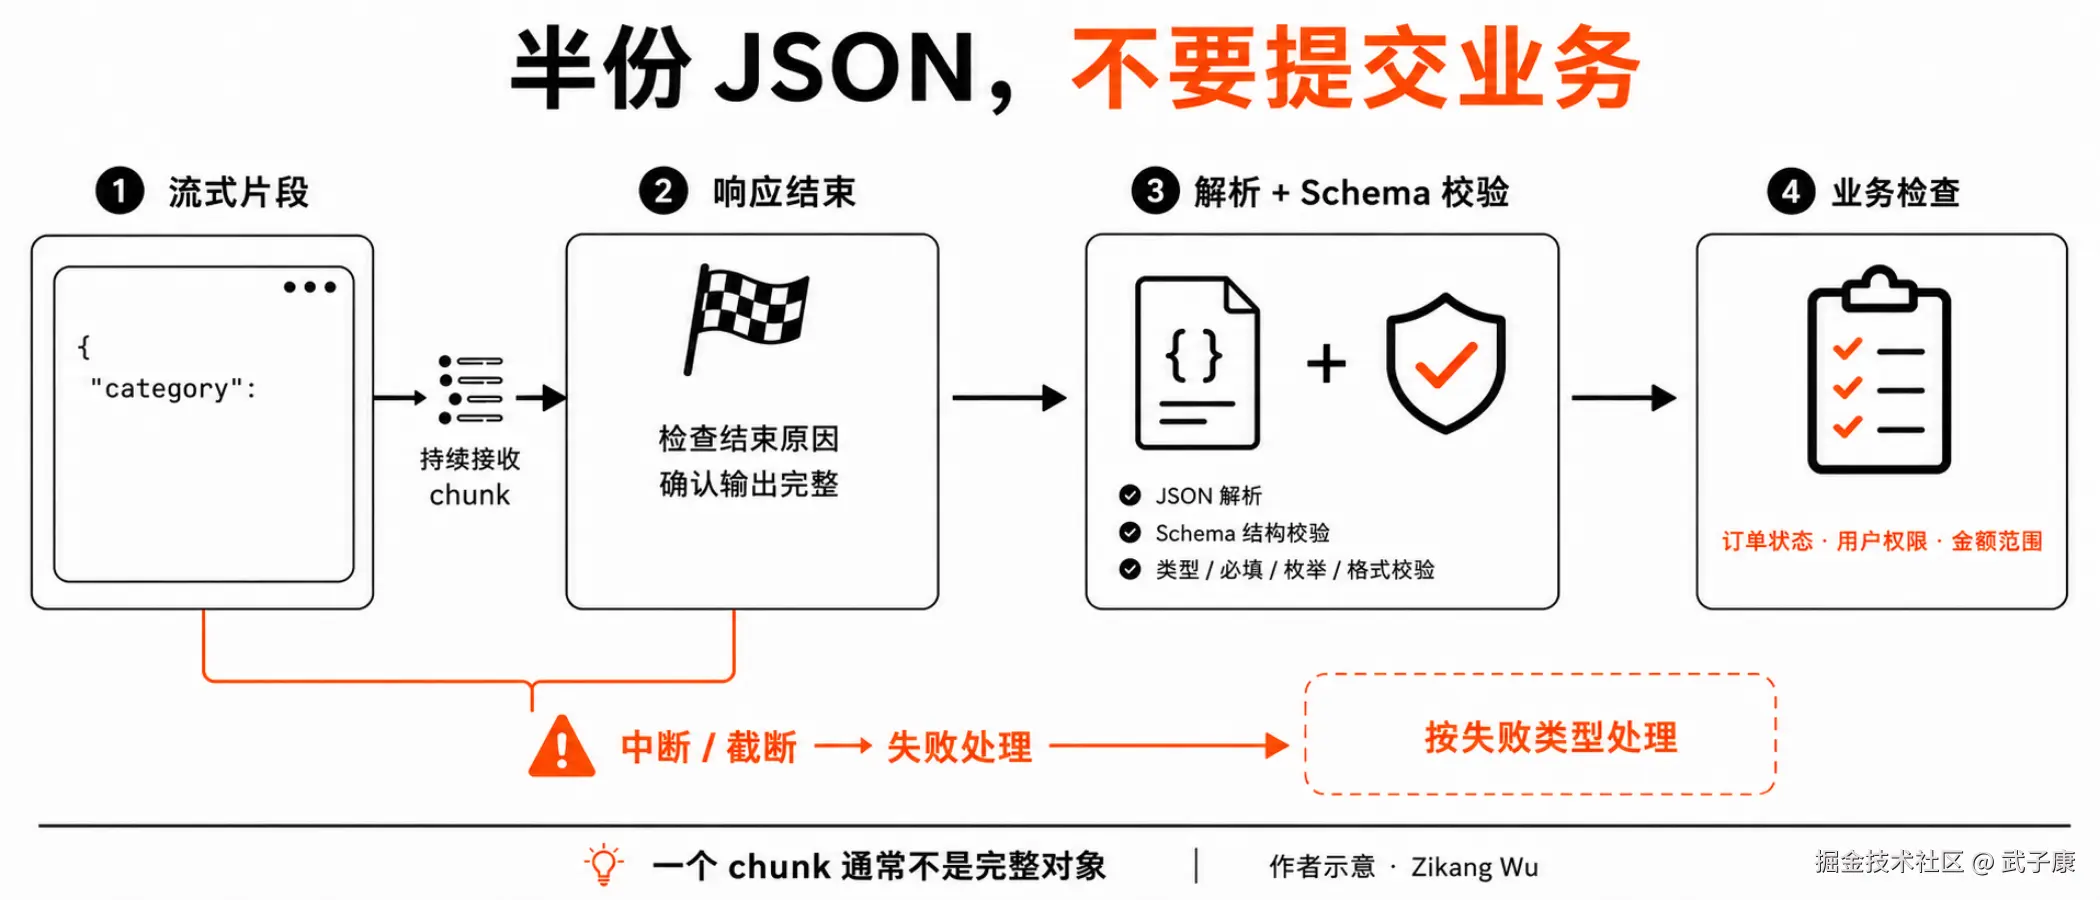
如果使用流式传输,一个片段通常还不是完整 JSON。输出被长度限制截断、连接中断或服务报错时,不能因为前面已经出现 category,就把半份结果提交给业务。
接收端应等完整响应结束,检查结束原因,再解析并做 Schema 校验。这样,生成配置、网络返回和客户端预期不一致时,错误也有明确位置。
如果分类之后要调用退款工具,还要检查订单状态、用户权限和金额范围。金额是合法数字,也不能证明这次退款允许执行。
对带推理过程的模型,还需确认推理文本在哪里结束、格式约束从哪里生效;不要把普通模型的配置原样推广过去。推理模型说明
从错误样本里挑掉补丁
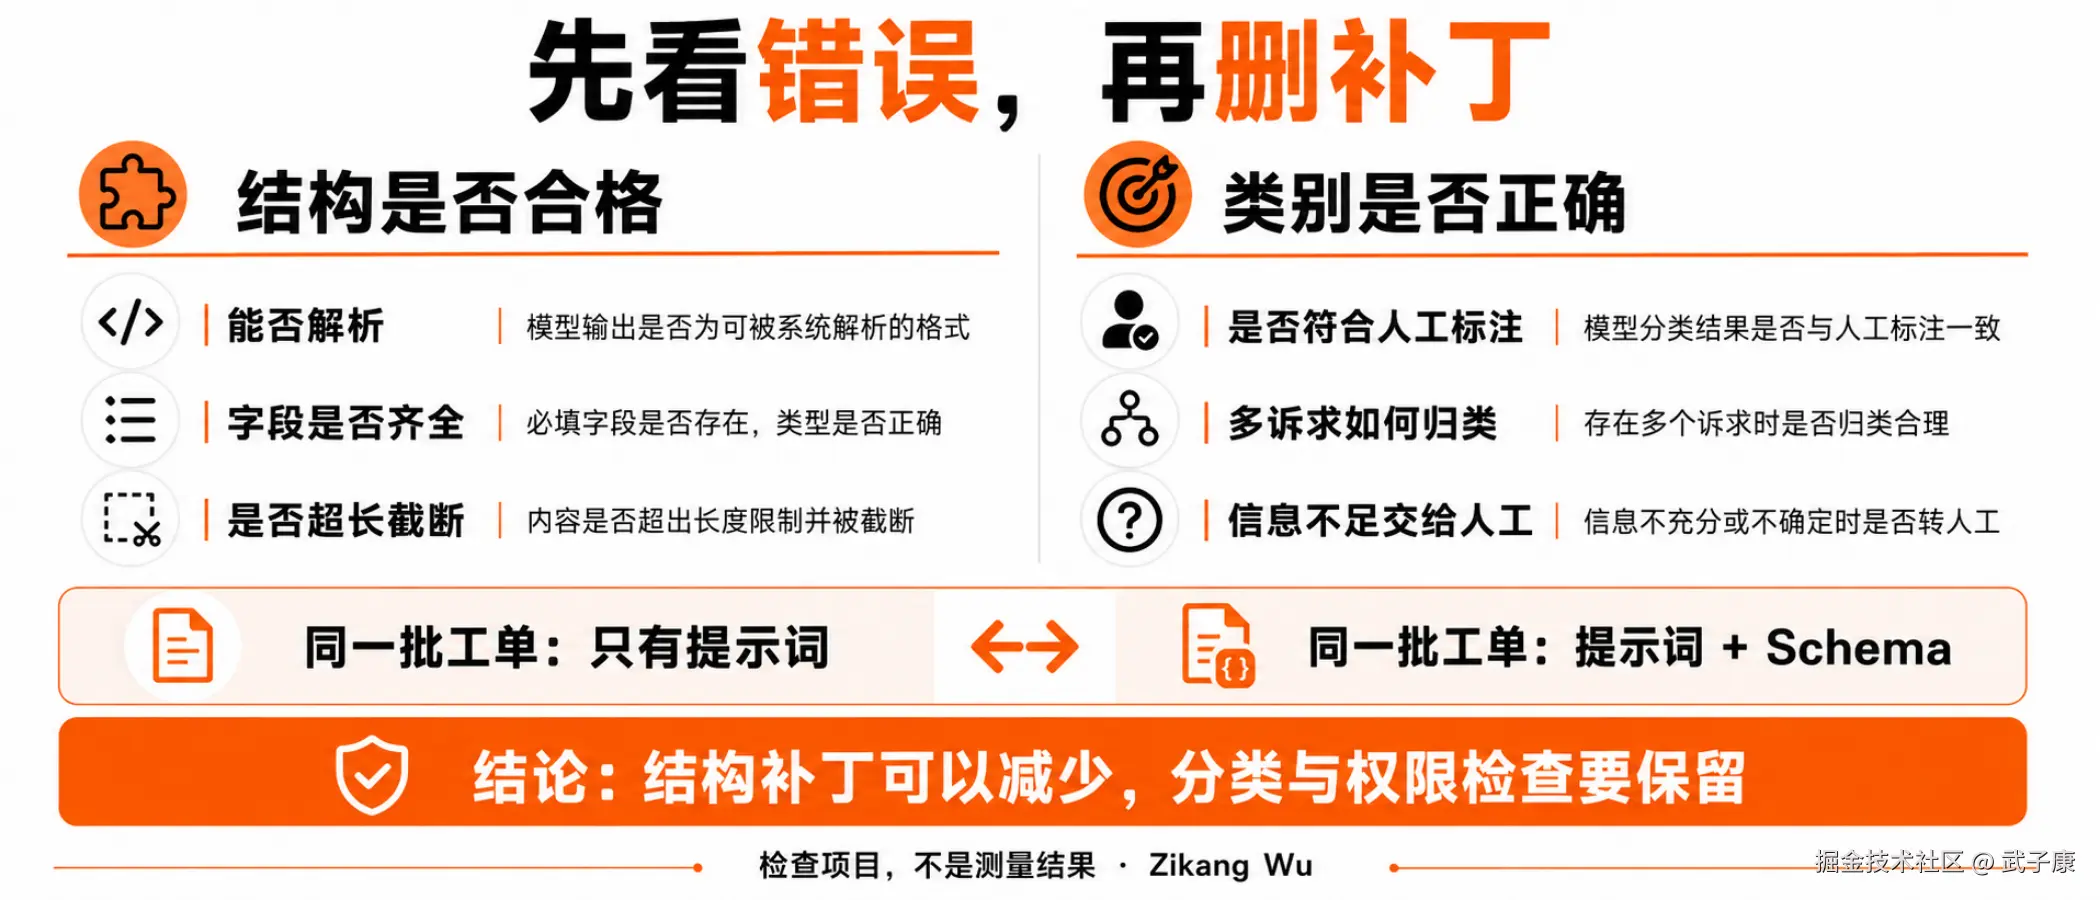
从已有工单里挑出空内容、多个诉求、类别边界和信息不足的样本。对同一批输入比较"只有提示词"和"提示词加 Schema",分别记录解析失败、缺字段、类别错误和超长截断。
如果结构错误确实减少,再逐步移除猜括号、改字段名之类的补救。错分类继续留在评测里,信息不够的工单保留人工处理分支。
你最终要保留的是一条可解释的处理顺序:收齐对象,验证格式,再检查分类和业务条件。补丁能删多少,由这些错误样本决定。