**摘要:**本文围绕 LangChain 中工具(Tool)的定义与使用展开,重点讲解 @tool 注解的常用参数、Pydantic 的 Field 字段约束方式,以及如何通过 args_schema 将 Pydantic 模型接入工具,帮助大模型正确识别并调用函数。
内容参考于:图灵AI大模型全栈
工具就是大模型调用函数的能力
LangChain内置工具:https://docs.langchain.com/oss/python/integrations/tools
工具用到了@tool注解,如下图红框,注解里可以写的值
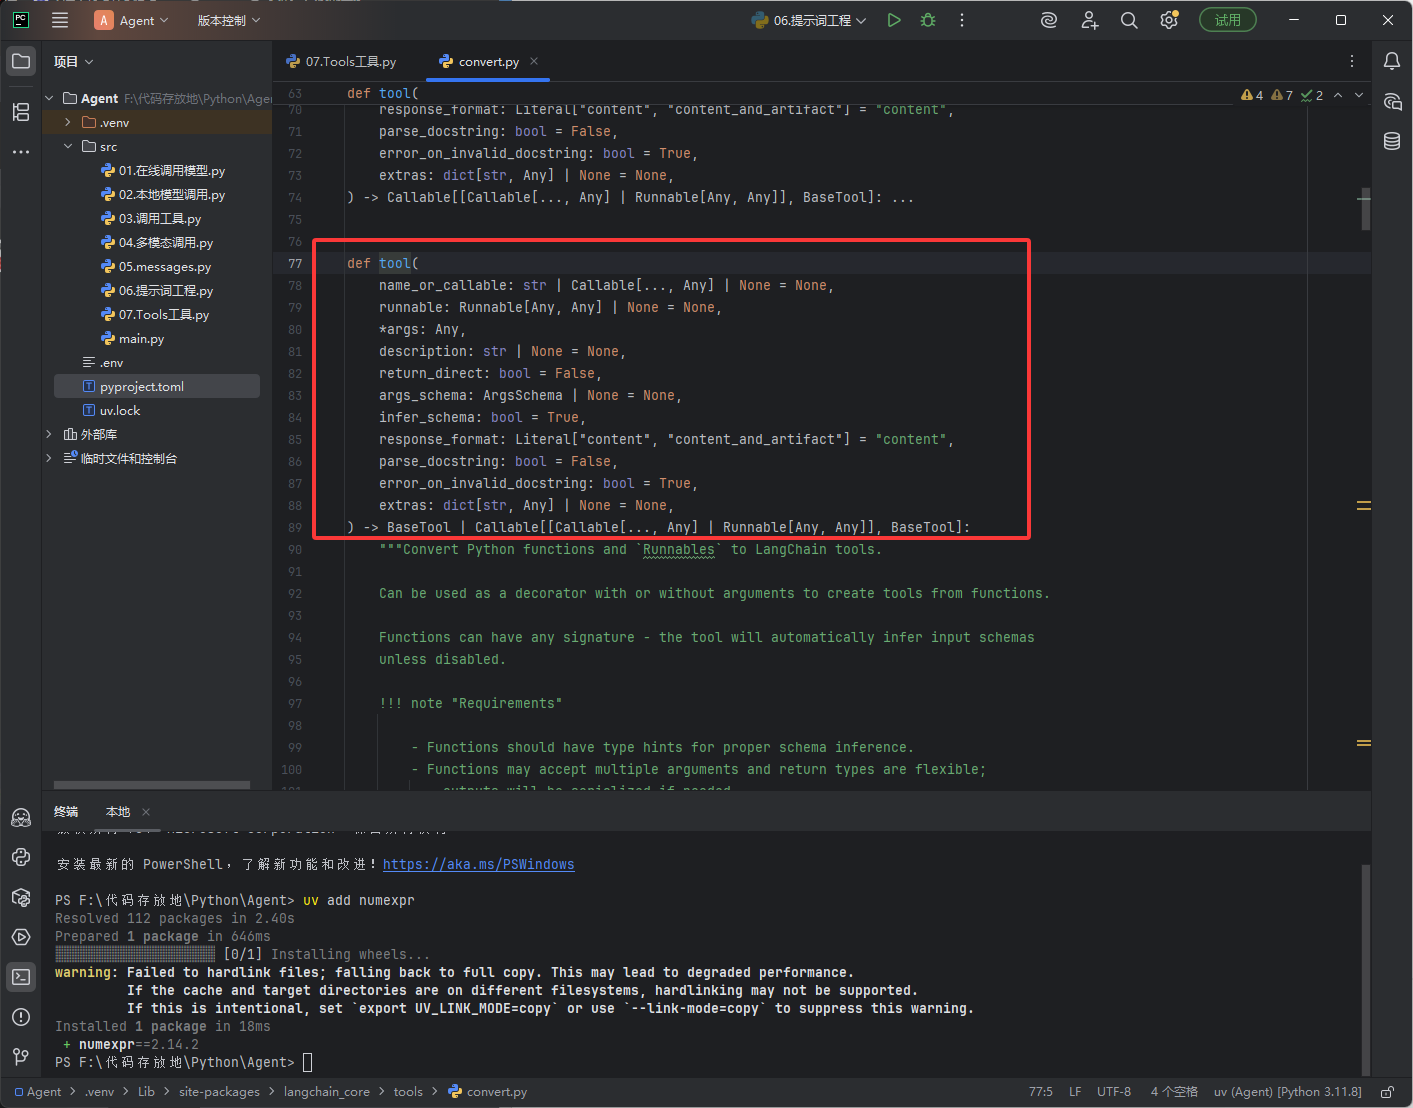
参数说明:
- name_or_callable: str | Callable ..., Any | None = None:待包装函数或者工具名称;不传函数时作为装饰器,传函数则直接生成工具。
- runnable: Runnable Any, Any | None = None:传入 LangChain Runnable 对象,使用该 Runnable 作为工具执行逻辑,替代被装饰函数。
- *args: Any:内部兼容旧版本重载用的可变位置参数,业务代码不要手动传入。
- description: str | None = None:工具功能描述,提供给大模型判断何时调用该工具;不填默认读取函数 docstring。
- return_direct: bool = False:工具执行完毕后是否直接返回结果给用户,不再交由大模型继续思考。
- args_schema: ArgsSchema | None = None:自定义 Pydantic 模型,定义工具入参 JSON 结构,优先级高于自动推断。
- infer_schema: bool = True:是否自动从函数签名推断参数模型,关闭后必须手动提供 args_schema。
- response_format: Literal "content", "content_and_artifact" = "content":工具返回结构;content 仅返回文本,content_and_artifact 返回摘要 content 与原始数据 artifact。
- parse_docstring: bool = False:是否解析函数文档字符串,提取参数说明填充到工具 schema。
- error_on_invalid_docstring: bool = True:开启 parse_docstring 时,文档字符串解析失败是否抛出异常;False 则静默忽略。
- extras: dict str, Any | None = None:挂载到工具实例上的自定义元数据字典,大模型不可见,仅业务代码读取。
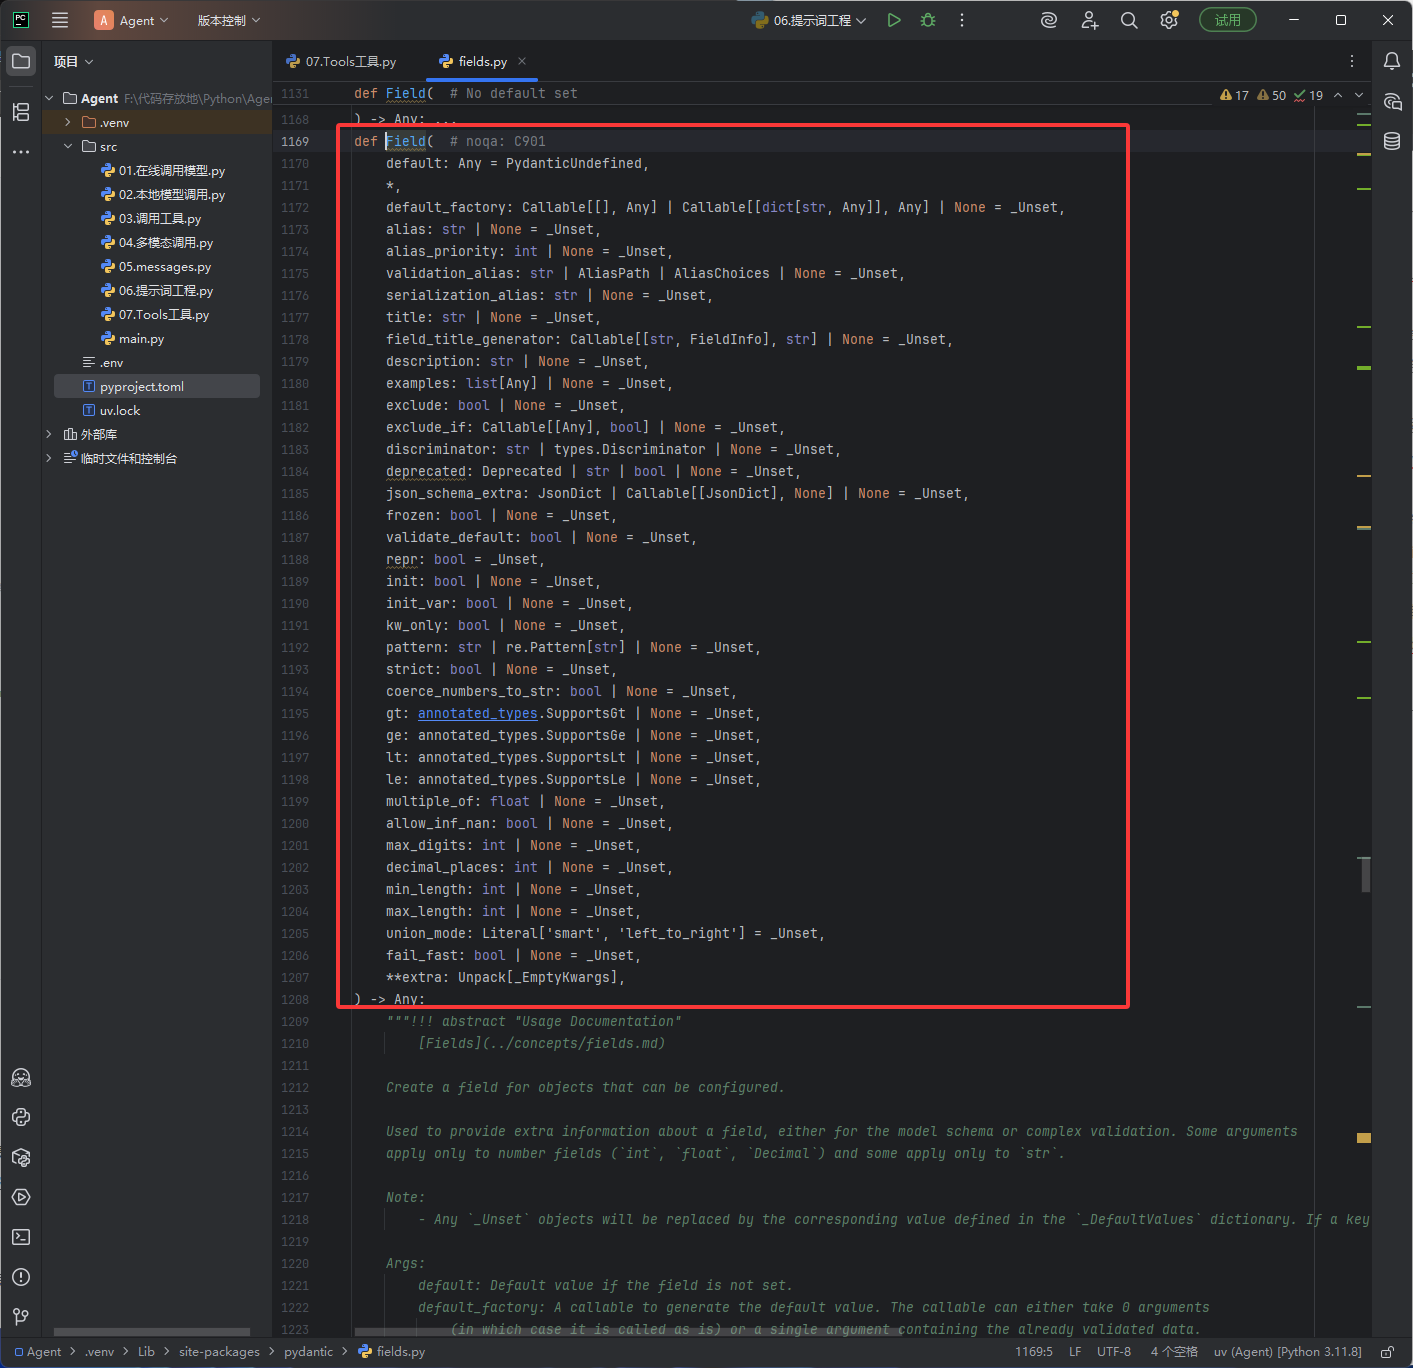
Python是一个是动态的语言,变量没有强制类型,它通过 Field 来对数据结构进行约束
参数说明:
- default: Any = PydanticUndefined:字段默认值;不设置代表无默认值,必填。
- default_factory: Callable \[, Any] | Callable \[dict \[str, Any], Any] | None = _Unset:工厂函数,用于动态生成字段默认值,不能和 default 同时使用。
- alias: str | None = _Unset:序列化与反序列化通用别名,外部传入 key 和模型字段名不一致时使用。
- alias_priority: int | None = _Unset:别名优先级,数值越大优先级越高,控制多个别名冲突时的选择。
- validation_alias: str | AliasPath | AliasChoices | None = _Unset:仅反序列化校验阶段使用的别名,读取输入数据时生效,序列化输出不生效。
- serialization_alias: str | None = _Unset:仅序列化输出阶段使用的别名,转 json 输出时替换字段名。
- title: str | None = _Unset:生成 JSON Schema 时的标题文本。
- field_title_generator: Callable \[str, FieldInfo, str] | None = _Unset:自定义回调函数,动态生成字段 title。
- description: str | None = _Unset:JSON Schema 里字段描述,给 LLM / 文档查看。
- examples: list Any | None = _Unset:JSON Schema 示例值列表,用于文档展示。
- exclude: bool | None = _Unset:序列化时是否排除此字段,True 则输出 json 不包含该字段。
- exclude_if: Callable \[Any, bool] | None = _Unset:回调函数,满足条件时序列化自动排除字段。
- discriminator: str | types.Discriminator | None = _Unset:多态 Union 模型的鉴别器字段,用来自动匹配子模型。
- deprecated: Deprecated | str | bool | None = _Unset:标记字段废弃,JSON Schema 增加 deprecated 标记。
- json_schema_extra: JsonDict | Callable \[JsonDict, None] | None = _Unset:往 JSON Schema 追加自定义扩展字段。
- frozen: bool | None = _Unset:标记字段只读,实例创建后不可修改。
- validate_default: bool | None = _Unset:是否对 default/default_factory 生成的默认值执行校验。
- repr: bool = _Unset:对象打印 repr 时是否展示该字段。
- init: bool | None = _Unset:创建模型实例时,是否在init参数中包含此字段。
- init_var: bool | None = _Unset:标记为初始化变量,仅实例构建时使用,不成为模型字段。
- kw_only: bool | None = _Unset:是否强制该字段只能通过关键字参数传入。
- pattern: str | re.Pattern str | None = _Unset:字符串正则校验规则。
- strict: bool | None = _Unset:严格模式,开启时不自动做类型强制转换。
- coerce_numbers_to_str: bool | None = _Unset:是否自动把数字强制转为字符串类型。
- gt: annotated_types.SupportsGt | None = _Unset:数值校验,大于 (>)。
- ge: annotated_types.SupportsGe | None = _Unset:数值校验,大于等于 (>=)。
- lt: annotated_types.SupportsLt | None = _Unset:数值校验,小于 (<)。
- le: annotated_types.SupportsLe | None = _Unset:数值校验,小于等于 (<=)。
- multiple_of: float | None = _Unset:数值必须为此参数的倍数。
- allow_inf_nan: bool | None = _Unset:是否允许 inf、nan 这类特殊浮点数。
- max_digits: int | None = _Unset:Decimal 类型最大总位数。
- decimal_places: int | None = _Unset:Decimal 类型小数点后保留位数。
- min_length: int | None = _Unset:字符串 / 列表最小长度。
- max_length: int | None = _Unset:字符串 / 列表最大长度。
- union_mode: Literal 'smart', 'left_to_right' = _Unset:Union 联合类型的解析匹配策略。
- fail_fast: bool | None = _Unset:校验时是否快速失败,遇到第一个错误就停止校验。
- **extra: Unpack _EmptyKwargs:预留扩展关键字参数。 返回值:Any:返回 FieldInfo 实例,附加到模型字段上承载元信息。
代码:
python
from langchain.tools import tool
import numexpr

# 函数名表示工具名称,这函数名要写的有意义不可以随便写,函数的参数表示工具的参数,函数返回值表示工具输出结果
# 函数的文档字符串会当做工具的描述,写到六个引号之间的内容就是文档字符串,注意老版本 LangChain 不是这样写的
# 所以文档字符串要写明白函数的作用、入参的作用、返回值的作用,从而保证Agent能够正确识别并且调用工具
# @tool ,这叫注解,这个注解的作用表示当前函数是LangChain的工具函数,老版本的LangChian函数的描述需要写到 @tool里
@tool
def get_天气(city:str)->str:

    # 下方Args是用来描述函数入参的,入参的数据类型和入参的作用
    # 下方Returns是用来描述函数返回值的,返回值类型和返回值的作用
    """
        获取指定城市的天气信息
        Args:
            city(str): 城市名称
        Returns:
            str: 天气信息
    """
    return f"{city}挺好"

# 下方是使用 @tool 注解来描述函数的作用,calculator是工具名,description它的值表示当前函数的作用描述
# 如果在注解中写了函数的描述和名字,然后在函数中用文档字符串又写了描述,那么它会以注解为主
@tool("calculator", description="执行算术计算。用这个来解数学题。输入应该是一个数学表达式,例如 '2 + 2' 或 'sqrt(16)'。")
def calc(expression: str) -> str:
    """计算数学表达式

    Args:
        expression (str): 数学表达式

    Returns:
        str: 计算结果
    """
    return str(numexpr.evaluate(expression).item())

# pydantic模型
from pydantic import BaseModel, Field

# Python是一个动态语言,变量没有强制类型,一个变量传递什么数据类型都可以,通过pydantic模型可以对数据类型进行校验
# 通过继承 pydantic模型中BaseModel类,来实现对数据类型的校验
class CalculateInput(BaseModel):
    # : str就表示当前变量要接收一个字符串
    # : float就表示当前变量要接收一个boolean类型的值
    # 使用 Field 可以对变量的值进行条件约束,它可以传递很多判断值的方式和逻辑
    operation: str = Field(description="要执行的运算类型,如 'add' 或 'multiply'")
    a: float = Field(description="第一个操作数")
    b: float = Field(description="第二个操作数")

# pydantic模型在工具中使用 args_schema 来的传递约束
@tool("calculator", args_schema=CalculateInput)
def calculate(operation: str, a: float, b: float) -> str:
    """当你需要进行数学计算时使用此工具"""
    if operation == "add":
        return str(a + b)
    elif operation == "multiply":
        return str(a * b)
    return "Unknown operation"