发布日期:2026年9月9日
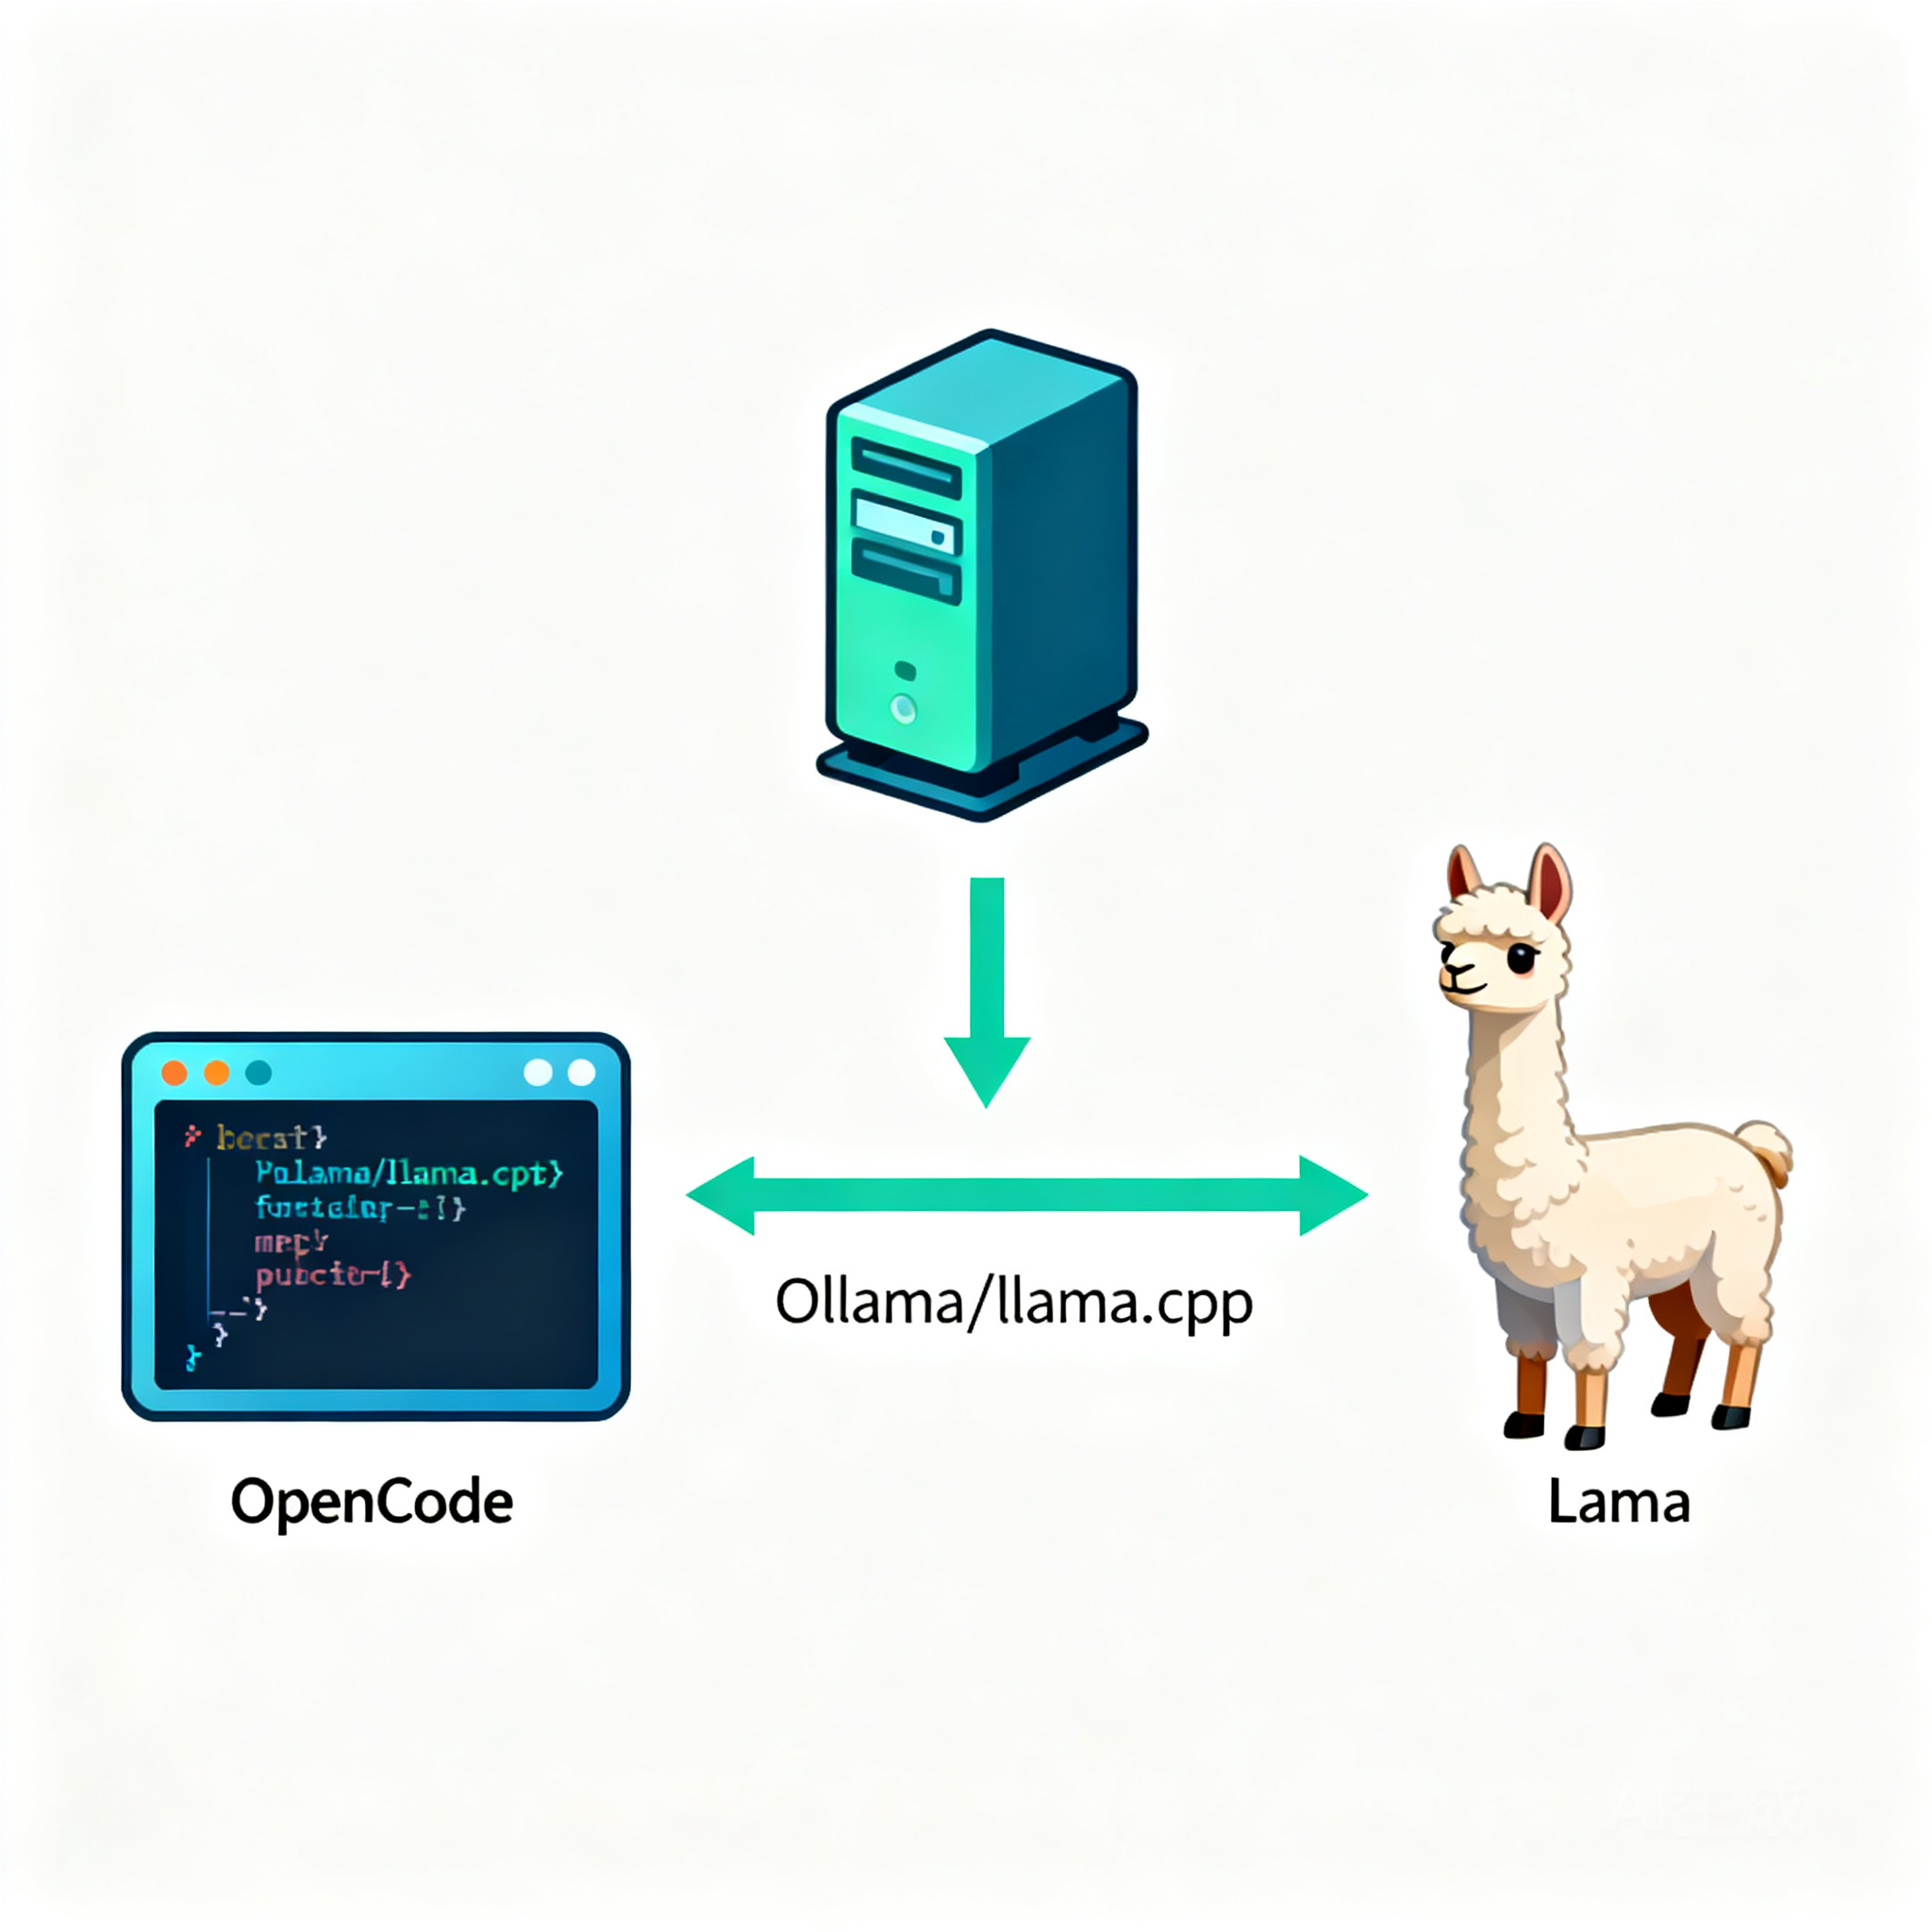
OpenCode 是一款开源的 AI 编程智能体(Agent)命令行工具,由 sst 团队开发并以 MIT 协议开源,核心能力是在终端里以 Agent 模式理解代码库、执行文件编辑和命令调用。它的 Provider 层采用 OpenAI 兼容协议,这意味着开发者不仅能接入云端大模型,也能把请求指向本地运行的 Llama 等开源模型,实现完全离线、数据不出本机的编程辅助。本文梳理 OpenCode 接入本地 Llama 的两种主流路径(Ollama、llama.cpp),以及实际部署中最容易踩坑的上下文长度问题。
为什么要在 OpenCode 里跑本地 Llama
把 OpenCode 的模型请求指向本地部署的 Llama,通常出于三个诉求:
- 代码隐私:企业代码库不出本机、不经过第三方 API,满足合规要求
- 离线可用:无网络环境下仍可使用编程 Agent
- 成本可控:本地硬件跑长时间高频调用任务,不产生按 token 计费的持续支出
代价也很明确:需要自备算力,且本地模型在复杂多文件重构任务上的表现通常弱于云端旗舰模型,更适合小范围、重复性的编程辅助场景。
选哪个 Llama 版本:Scout 还是 Maverick
Meta 目前的主力开源系列是 Llama 4,2025 年 4 月发布时包含 Scout 和 Maverick 两个版本,2026 年 5 月 12 日 Meta 进一步开源了 Llama 4 的完整技术栈,涵盖 7B 到 405B 参数的多个版本权重、训练代码及 15 万亿 token 的预训练数据集"OpenDataHub"。
| 版本 | 总参数 | 活跃参数 | 定位 |
|---|---|---|---|
| Llama 4 Scout | 1090 亿(MoE) | 170 亿 | 消费级硬件可运行的轻量选择 |
| Llama 4 Maverick | 4000 亿(MoE) | 170 亿 | 更强能力,对显存要求更高 |
据 Thunder Compute 2026 年 9 月的实测数据,Scout 在 Q4 量化下大约需要 55GB 显存,若显存只有 24GB,需要降到 1.78-bit 量化才能跑起来,此时速度约 20 tokens/秒。个人开发环境建议先从 Scout 的量化版本入手,Maverick 更适合有独立 GPU 服务器的团队。
用 Ollama 接入 OpenCode(推荐路径)
Ollama 是目前最主流的本地模型管理工具,自带 OpenAI 兼容 API,默认监听 11434 端口。接入步骤:
- 安装 Ollama(macOS 用
brew install ollama,Linux 用官方安装脚本) - 拉取 Llama 4 模型:
ollama pull llama4:scout或指定量化版本如llama4:17b-scout-16e-instruct-q4_K_M - 在
~/.config/opencode/opencode.json中手动声明 provider:
json
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": {
        "baseURL": "http://localhost:11434/v1"
      },
      "models": {
        "llama4:scout": {
          "name": "Llama 4 Scout (local)"
        }
      }
    }
  }
}
OpenCode 官方文档也提到 Ollama 可以自动为 OpenCode 完成部分配置,无需手写全部字段。
用 llama.cpp 接入 OpenCode(更底层的备选)
如果需要更精细的推理参数控制,可以直接用 llama.cpp 的 llama-server 加载 GGUF 格式的 Llama 权重,同样暴露 OpenAI 兼容接口:
bash
./llama-server -m ./models/llama4-scout-q4.gguf --host 0.0.0.0 --port 8080 -ngl 99 -c 8192对应的 opencode.json 配置需要额外声明 limit 字段,因为本地/自定义 provider 不在 models.dev 数据库中,OpenCode 无法自动获取上下文上限:
json
{
  "provider": {
    "llama.cpp": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "llama-server (local)",
      "options": { "baseURL": "http://127.0.0.1:8080/v1" },
      "models": {
        "llama4-scout": {
          "name": "Llama 4 Scout (local)",
          "limit": { "context": 128000, "output": 65536 }
        }
      }
    }
  }
}
Ollama vs llama.cpp:怎么选
| 维度 | Ollama | llama.cpp |
|---|---|---|
| 上手难度 | 低,一条命令拉模型 | 中,需自行管理 GGUF 文件和启动参数 |
| 配置灵活度 | 一般 | 高,可精细控制量化、GPU 层数等参数 |
| 自动发现模型 | 支持(部分插件) | 不支持,需手动声明 limit |
| 适合人群 | 个人开发者、快速验证 | 需要极致性能调优的团队 |
两者接入 OpenCode 的原理一致:都是通过 @ai-sdk/openai-compatible 适配器,把请求打到本地暴露的 /v1 端点,替换 baseURL 即可切换。
常见问题
Q:配置好本地 Llama 后,OpenCode 无法正常调用文件编辑等工具怎么办?
这是本地部署最常见的问题,通常是上下文窗口太小导致工具定义被截断。OpenCode 官方文档建议先尝试将 Ollama 的 num_ctx 提升到 16k-32k,用 llama.cpp 则可通过 -c 参数直接指定上下文长度。
Q:本地 Llama 4 Scout 需要多少显存才能流畅运行?
按 Thunder Compute 2026 年 9 月的实测,Q4 量化约需 55GB 显存;24GB 显存需降到 1.78-bit 量化,速度约 20 tokens/秒,仅适合轻量任务。
Q:OpenCode 是否必须联网才能用本地模型?
仅首次运行时需要联网,OpenCode 会通过 npm 拉取 Provider 适配包 @ai-sdk/openai-compatible;此后模型推理过程完全在本地进行,无需网络。
Q:本地部署和云端 API 调用应该怎么选?
本地部署适合对代码隐私要求高、有闲置 GPU 资源的场景;云端 API 更适合轻量、间歇性使用,无需自建硬件即可按量调用多款主流大模型,例如七牛云 AI 大模型广场提供的多模型统一接入方式,可以和本地方案搭配使用,重任务走云端、日常辅助走本地。
Q:除了 Ollama 和 llama.cpp,还有其他本地推理服务可以接吗?
可以。只要暴露 OpenAI 兼容的 /v1 接口,LM Studio、vLLM 等本地推理服务同样能通过修改 baseURL 接入 OpenCode,配置结构与上述两种方式一致。
本地跑 Llama 的核心是把 OpenCode 的模型请求指向一个 OpenAI 兼容的本地端点,Ollama 适合快速上手,llama.cpp 适合深度调优。本文内容基于 OpenCode 官方文档及 2026 年 9 月的社区实测整理,具体模型版本和硬件需求请以 Meta 及 Ollama 官方最新说明为准。
延伸阅读
- 多模型统一接入与对比:qiniu.com/ai/models