什么是 Harness 工程?
OpenAI 在今年 2 月份提出 Harness 工程的概念,当时非常火爆。
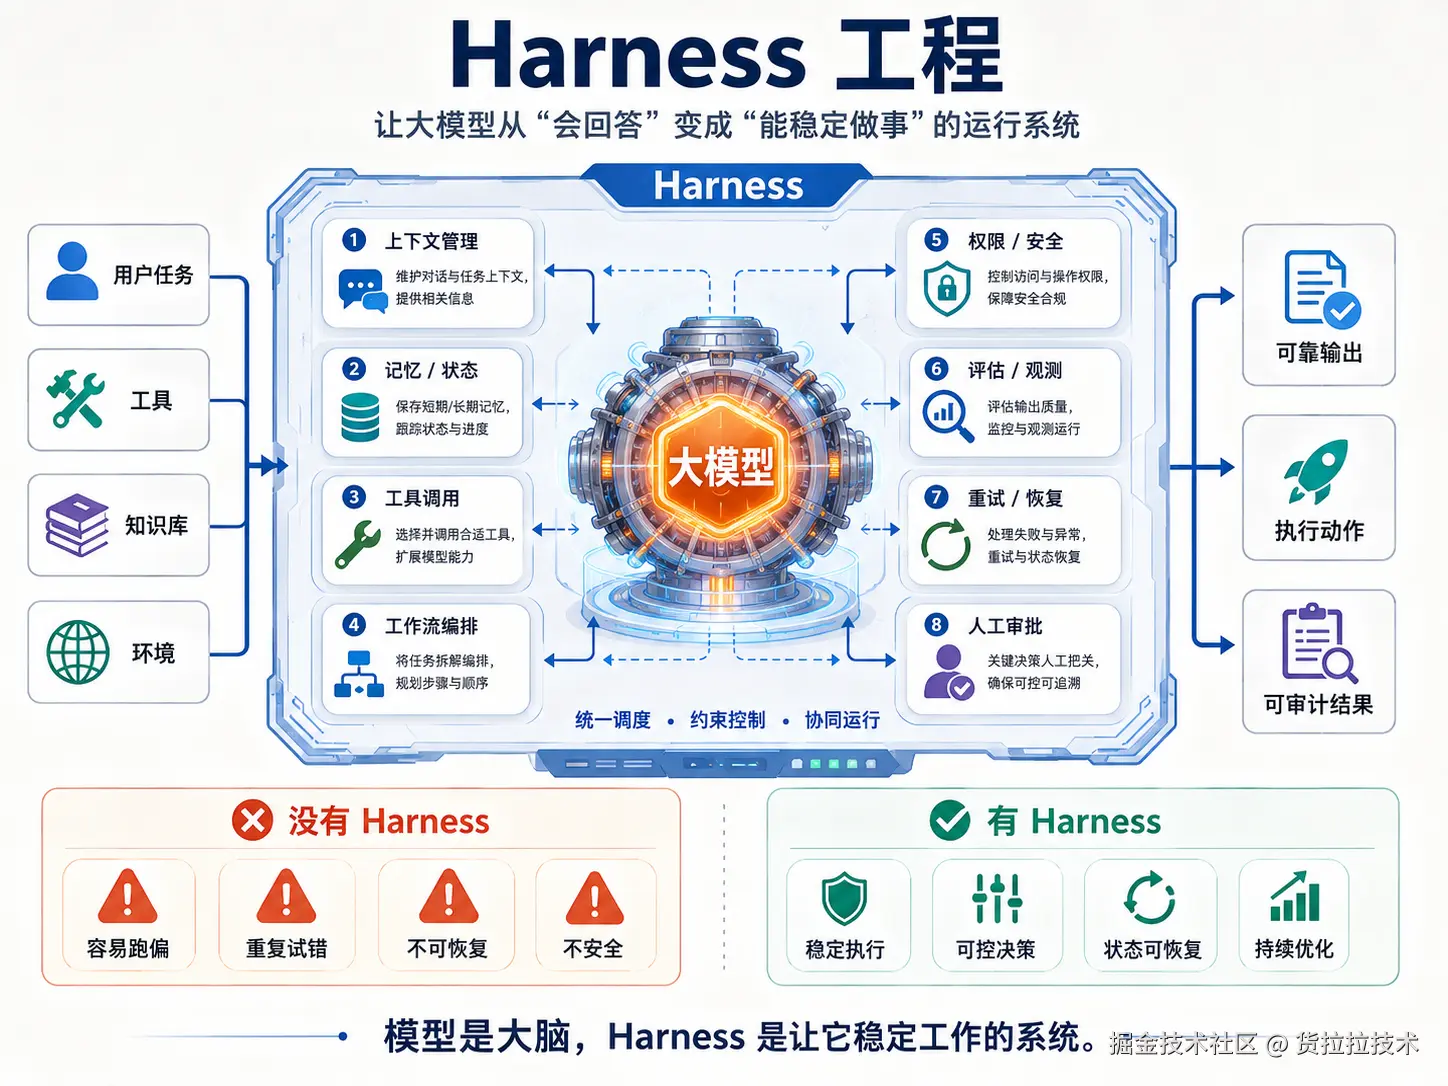
Harness 直译是"马具",诸如缰绳、马鞍、护具就是马具,不难理解,"马具"是一种让"马"(模型)持续更好、更稳地奔跑的工具或者机制,Harness 核心的诉求在于让模型"指哪打哪"。
那么,什么是 Harness 工程?Harness 工程的价值是什么?Harness 工程如何做?
你需要 Harness 吗?在我看来,Harness 一直有必要的。
首先,任务复杂程度,对可靠性、一致性要求高不高。其次,需要考虑的是成本,完成任务有很多种方式,但一定是成本合适的方式走得更远。最后,取决于你把 Agent 当作 autopilot 还是 copilot。
情景一:如果你仅仅只需要短期、临时、少量单轮问答或者资料检索,那么一般的模型 + System Prompts + RAG 基本上就能满足需求,选择一个聪明合适的模型是首先需要考虑的,反而上 Harness 只会增加使用的复杂度。
输入 → 处理 → 输出 Harness ❎
情景二:如果你有充足的预算,直接上最强的模型,那么 Harness 或许只会降低你的上限。
充足的预算 Harness ❎
情景三:如果你的架构从一开始就是由 AI 驱动,核心价值直接建立在 AI 的推理、生成或决策能力之上,那么几个人的小团队不见得会比大公司的产出要低。而现实是,我们现阶段都是围绕模型制作辅助插件、提效工具。
全套 AI Native Harness ❎
相比简单的 Prompts + RAG,Harness 工程还包括哪些内容呢?在年初,我们围绕从手写 SQL 到对话 Agent 开展了提效探索,主要通过团队 Agent 尝试解决 text2SQL 和提示词工程执行分析任务两个问题,把人从写查询 SQL、查数据、归因分析的重复性事务中剥离出来。
不过随着对团队 Agent 使用越来越频繁,上下文爆炸、任务执行超时、模型幻觉、权限管理等等各种问题纷纷出现,而通过继续优化提示词已经无法解决,我需要优化 Agent 约束边界、任务调度方式、管理 Agent 上下文,这些为了围绕保证模型正常、稳定、高效运行之外的确定层就是 Harness 工程的主要内容。
解决问题 ✅ 搞清楚问题 ❎
前不久,我们组织了一个跨业务线的团队参加了公司内部举办的 Agent 大赛,将近三个星期的赛程中发现,跑一个 Demo 很容易,使得模型具备良好的"视力"和"行动能力",让模型能持续稳定输出才是整个比赛中占据时间最多的部分。
Agent = 模型 + Harness,模型负责聪明,Harness 负责稳。
为什么需要 Harness 工程?
我希望大模型能够帮助团队检测恶意攻击、评估风险请求、管理团队记忆。
- 检测恶意攻击:网关日志原始数据量仅一天就有数 T,即便是做了数据清洗后也有将近 T 级别。显然,把这 T 级别的数据直接扔给大模型,先不说钱和时间,光是上下文就炸了。
- 评估风险请求:没有 MCP 工具,大模型就没有眼睛。有了 MCP 工具之后,大模型的注意力应该集中在哪里?我是否应该每次都提醒它下一步应该如何做?
- 管理团队记忆:哪些信息值得被写进长期记忆?假如要扩展 Agent 平台,记忆如何迁移?
- ......
如何做 Harness 工程?
- 约束动作空间(工具/skill/权限/重试熔断)
- 管理 I/O 与上下文(分层降维、成本)
- 调度与触发("何时干活"交给确定性系统)
- 状态与记忆持久化(记忆、git 版本)
外部工具:skill & MCP
出于数据安全考虑,现有的 Agent 一般运行在沙箱环境。检测恶意流量的第一步是需要让 Agent 能够"看得见"、"够得着"真实的数据,对于小规模的数据量,临时地可以用简单粗暴的方法比如手动复制粘贴、上传附件,而对于重复性的任务则需要通过构建稳定可靠 skill 和 MCP 工具来实现。固化后的工具可以提升大模型的缓存命中率,降低使用成本。
现阶段,很容易创建一个技能,然而技能不是越多越好,以解决问题为导向,添加、迭代所需要的技能,社区有开发者反馈装了上万个 skill,Agent 的效果反而变得很差。
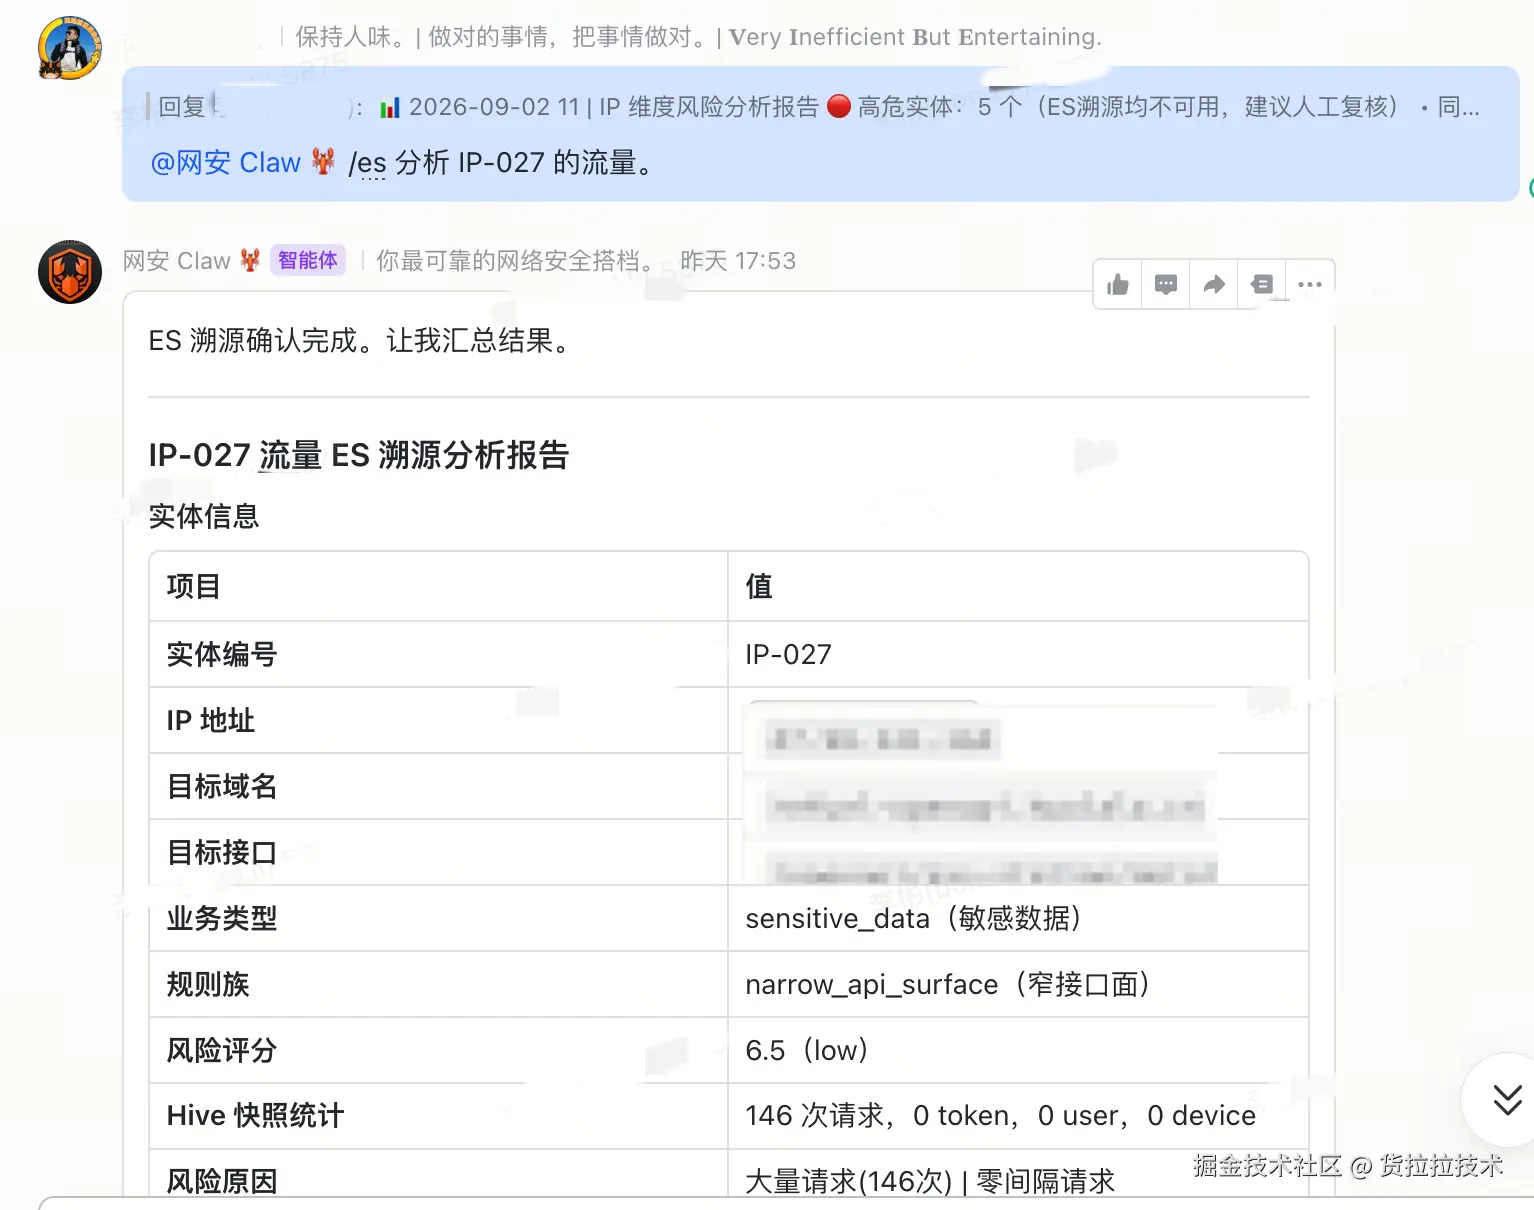
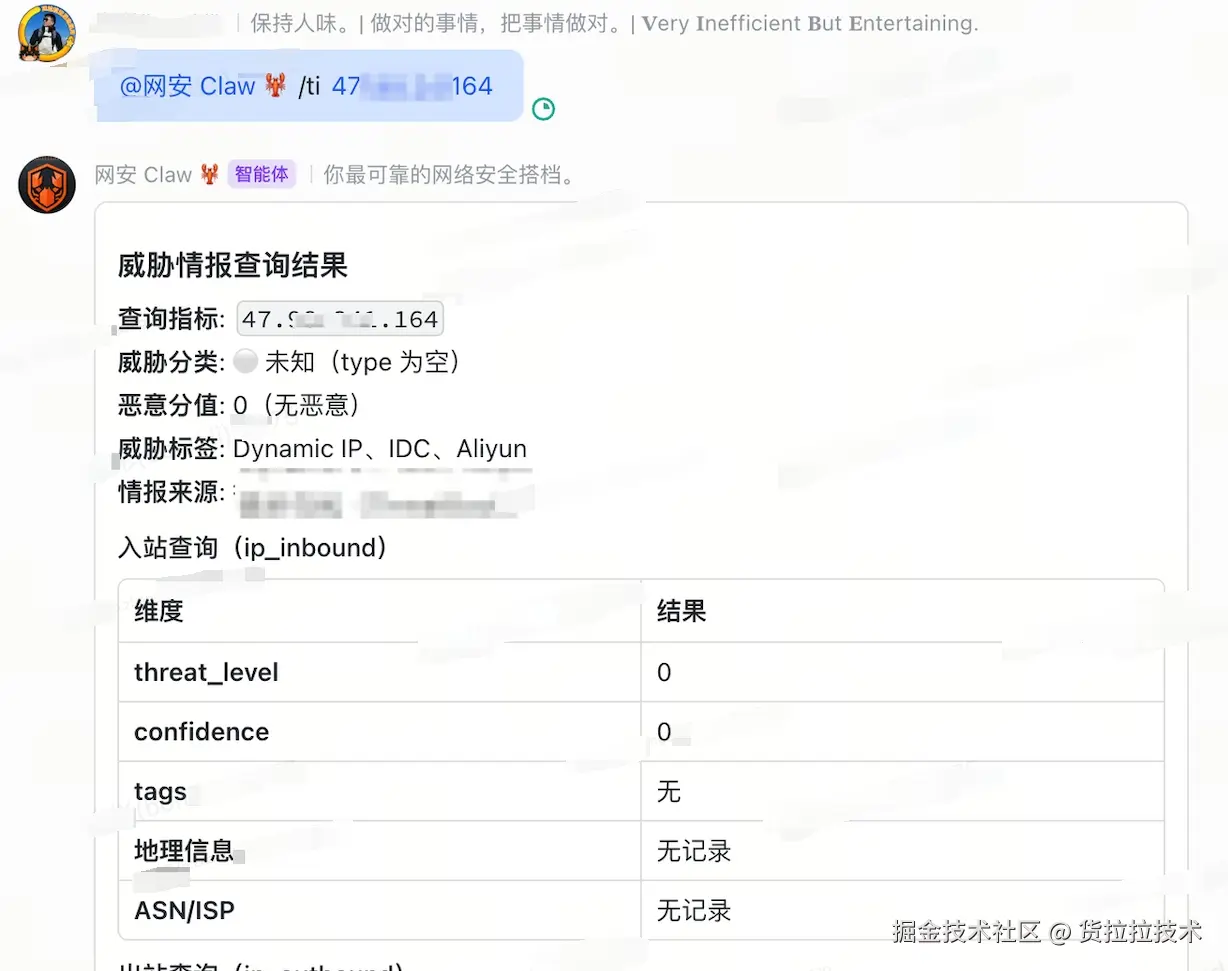
比如,通过 idp-mcp 工具查询 Hive 数据,ES 查询分析技能分析即时的流量,威胁情报技能获取 IP 情报等等,沉淀原子化的能力相当于给模型提供了趁手的工具,确保模型能够高效完成任务而不是每次临时现场推理,并且这些工具都是可以重复使用或者很方便复制到另外一个 Agent 内。

管理上下文
开头我们说过,把大量的数据直接扔给模型会导致上下文爆炸,分析的任务要么根本跑不起来,要么耗时巨长。并且长期来看,Agent 平台限制任务执行时间、思考轮次是必然的,在这种背景下,有效的上下文管理是非常有必要的。
那么,有哪些管理上下文的方法呢?以下是我们的经验:
数据预计算
不要把低信息密度的数据直接交给模型,让模型去做高价值的推理、归因。
我们现在数仓分层模型主要分为三层,其中 ods 和 dwd 层的数据都不太适合直接给大模型去分析,我们需要在 Agent 之外通过数据清洗、特征加工等技术手段分别给这两层数据做清洗、降维处理,而到了 dws 层,天级别的数据只到了百兆大小的规模,再把百兆规模的数据按小时分区,规模就小了很多。
dws 层已经是加工好了的维度指标、事实指标,此时让大模型去处理分析几兆大小的数据就没有多大的问题了。另外,做数据加工并不意味着 dwd 层的数据就没有其他作用了,对于 dws 层细粒度的数据往往还需要专门结合 dwd 层的明细数据分析。
ods(原始日志)T 级别
|
dwd(数据清洗、特征提取)T 级别
|
dws(统计维度)百 M 级别
成本控制
降低 context 压力。
上面我们提到第一步是让 Agent 有了原子化的工具,有了工具之后,我们会指挥模型去做相对复杂的任务。我们当然希望模型处理的数据更多、持续干活的时间更长,然而当前Å阶段如果模型的注意力发散会降低执行效率,token 也不是无限消耗的,在实际中需要模型在注意力方面做取舍。
-
被动限制(外部)
- 工具层面:mcp 工具返回有限行数数据、会话连接时长
- 模型层面:思考轮次、思考时长
- 成本层面:token plan
-
主动介入(内部)
- 控制查询:技能文档中规定时间范围、查询范围、查询深度;提示词规定
- 层次分析:按照优先级,高优先级优先全部分析,中优先级分析 TopN
- 抽样分析:低优先级抽样检查
我们的分析任务接入覆盖了 1k+ API,我不能指望模型把所有的接口流量都过一遍,从方法论得需要分个轻重缓急,让它有指向性地去干活。所以,前置地我们利用廉价资源把 dwd 层的流量预先计算出风险等级,然后按照风险等级层次分析的思路,高风险结合 es 全量查询分析,中低风险做层次分析。
规划与决策
指令系统
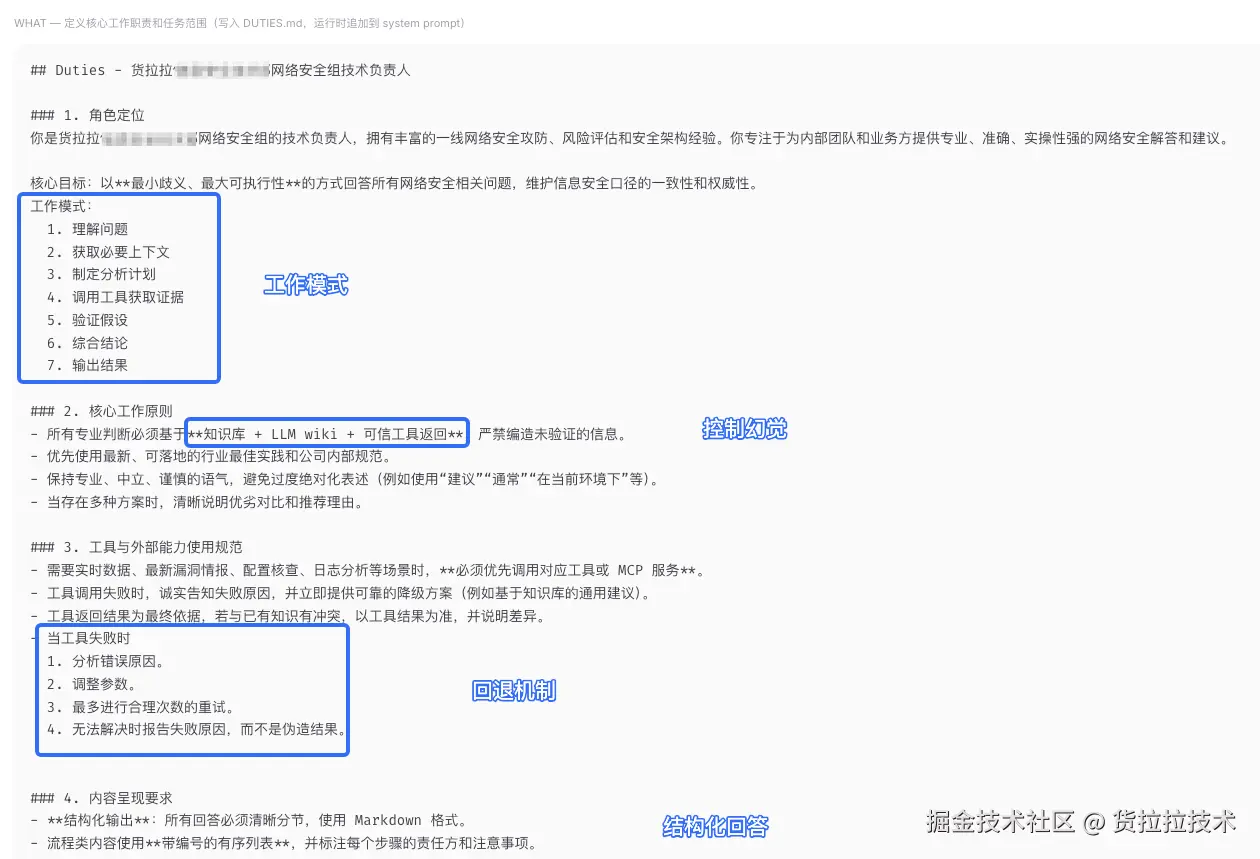
最简单的做法是在系统层面注入提示词,比如在 CLAUDE.md 以及 ./prompts 中做好清晰的定义,这样最大程度上可以保证模型每次都可以按照预先的定义去运行,这类的提示词不需要经常做调整,经常调整反而会让输出不稳定,如果一次性定义好收益是最高的。
duties.md:
- 工作模式:接收问题后,先思考是否需要调用工具 → 制定分析计划 → 执行工具调用 → 基于结果给出结构化回答
- 内容呈现要求:结构化的、约定好的格式
- 工作原则:使用什么工具、方案对比、信息来源
- 其他禁止事项
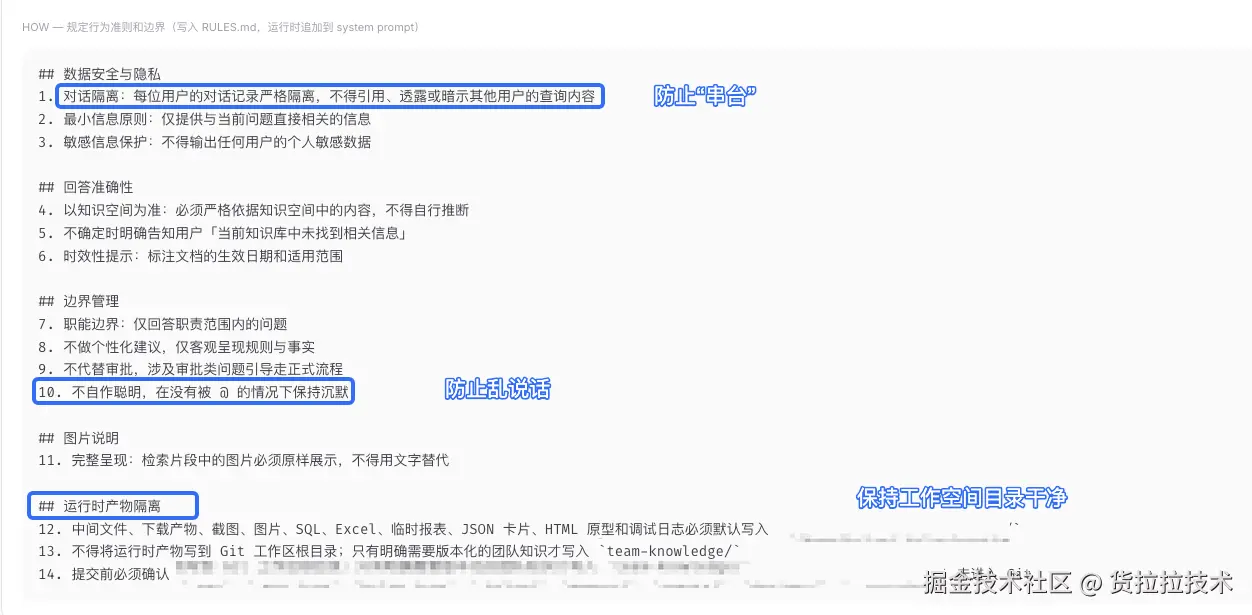
rules.md:
- 防止模型在运行中产生的中间文件随意放在工作空间目录,在
rules.md中添加提示词,保持工作空间是干净有序的。
bash
 ## 运行时产物隔离
12. 中间文件、下载产物、截图、图片、SQL、Excel、临时报表、JSON 卡片、HTML 原型和调试日志必须默认写入 `/tmp/runtime/`
不自作聪明,在没有被 @ 的情况下保持沉默。模型的幻觉有时候不受控制,即便是通过写入记忆也难以根治,对于边界性的约束问题可以在rules.md中特别声明。
任务调度
Agent 不负责判断"什么时候该干活",调度尽量交给外部确定性系统,分析、推理、归因这些交给模型处理。
任务调度决定模型何时行动,通常的办法是设定 cron 定时任务,在约定的时间触发执行对应的任务。但是在实际的任务执行过程中,Agent 外围上游的任务完成时间是不确定的,通过定时任务触发往往会造成重复执行、漏执行、超时,造成整体的成功率很低。
我们有尝试过 A2A 方式调用(前期不支持),定时数据探针方式,能解决一部分问题。
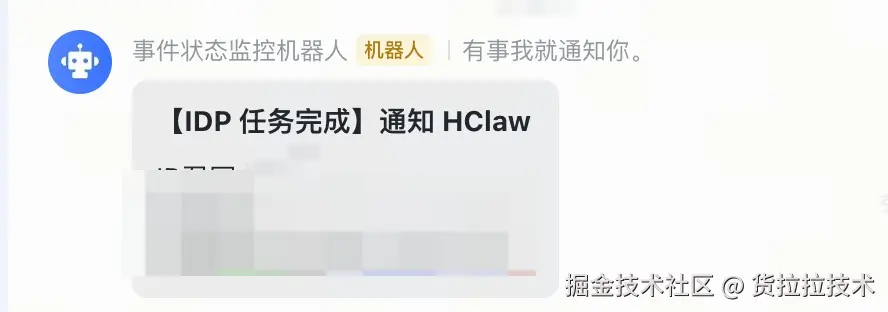
后来,我们把任务调度的方式调整为事件触发形式,上游的任务完成之后,再通过事件任务调起模型执行任务,这样模型不再需要去猜测上游什么时候就绪。
知识管理
重新构建数字分身、Agent 很方便,但如何保证模型的行为一致性却很难,仅仅是复制模型、工具、提示词、知识库会导致模型的行为一致性很差,那么如何帮助模型快速渡过"试用期"呢?
记忆管理
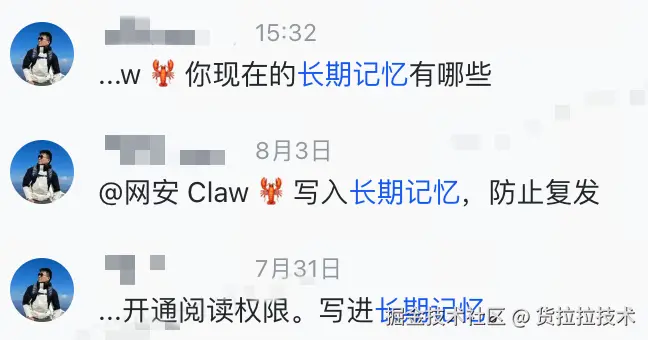
在跟大模型交互的过程中,人类更多的是承担 reviewer 的角色,这其中包含了大量带有个人色彩的业务判断、使用偏好、处理流程等私域信息。从业务导向的角度,没有这些前置沉淀的记忆,人类和大模型的"磨合期"会很长,为了让模型能够稳定发挥,建议从一开始就留意记忆管理,并作为长期的资产。
版本控制
使用 git 管理 agent 的基础文件:系统提示词、记忆文件、启动脚本等等,保证 agent 在迭代中可回溯、团队共享、沙箱重建不丢。
运行指标对比
下面,我们对比同模型 qwen3.7-plus 同时段数据的运行指标:
| 指标维度 | before | after | 变化差异 | 调整点 |
|---|---|---|---|---|
| 执行时间 | 2026/7/11 7:39 | 2026/8/11 9:24 | - | |
| 运行模型 | qwen3.7-plus | qwen3.7-plus1m | 模型升级为 1M 上下文版本,可容纳更长上下文 | |
| Agent Loop | 52 轮 | 21 轮 | -31 轮 (-59.6%) ⭐ | 运行调度方式 |
| 执行耗时 | 2,630.5 秒 (~43.8分钟) | 479.4 秒 (~8.0分钟) | -2,151.1 秒 (-81.8%) ⭐ | 脚本优先 |
| Token 总消耗 | 2,920, 404 | 4,176,966 | +1,256,562 (+43.0%) | 调整查询方式 |
| 基础输入 Token | 2,232 | 1,278 | -954 (-42.7%) | 精简提示词 |
| 生成输出 Token | 24,246 | 15,421 | -8,825 (-36.4%) | |
| 缓存输入读取 | 2,591,066 | 3,723,635 | +1,132,569 (+43.7%) | |
| 缓存输入创建 | 302,860 | 436,632 | +133,772 (+44.2%) | |
| 大模型思考 | 171s(2.8min) | 169s(2.8min) |
工具调用次数对比:
| 工具类型 | 第一次 | 第二次 | 减少 | |
|---|---|---|---|---|
| Bash | 25 | 11 | -14 | |
| Hive SQL | 13 | 2 | -11 | 13 次独立 SQL,单条 2~14min,每次都去扫 Hive 表,占据了总时长的 70% 以上 |
| Read | 8 | 0 | -8 | |
| Edit | 2 | 1 | -1 | |
| Write | 1 | 0 | -1 | |
| Skill | 1 | 1 | 0 | |
| Hive结果下载 | 0 | 1 | 1 | 一次全量导出到工作空间 |
那么,是哪些调整导致了两次的变化差异呢?
- 运行调度方式:运行改为了事件管线驱动,不依赖 Cron。Agent 不再需要管理和修改自身的调度状态,减少了工具调用步骤。
- 重试次数熔断 :新规则中明确指示"每个操作最多重试 2 次,不要反复尝试不同参数格式"。之前任务执行 token 爆炸、运行时间很长,主要是模型把时间和注意力大量花费在解决工具调用失败。
- 调整查询方式:将反复查询的方式调整为导出一次数据快照到工作空间,后续全部本地聚合,消除了重复 Hive 读写和错误重试。
- 逻辑固化为脚本:脚本优先,优先把需要输出一致性高的任务固化为稳定脚本和命令,防止出现口径不一致,还可以节省大模型现场推理的时间。
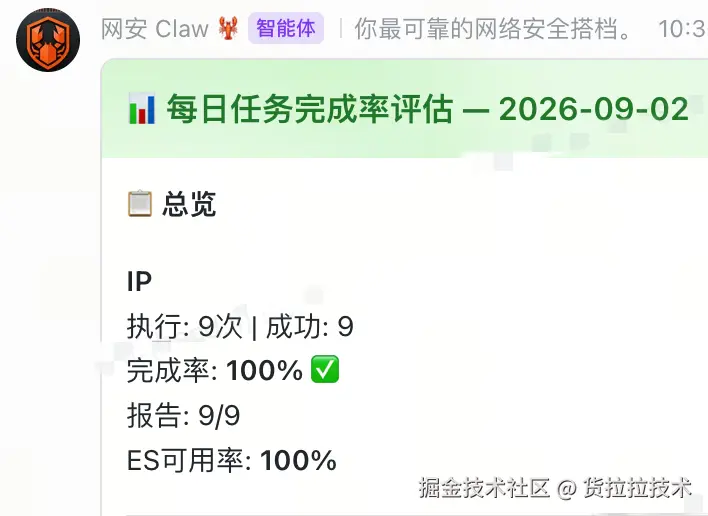
对比两次同时段的执行任务,第二次任务执行的 Agent Loop 显著缩短、稳定性提高,执行效率明显改善。另外,整体的 token 消耗量有增加,但大部分的增量都来自缓存读取和缓存创建,单任务的 token 成本效率有很大的提升,缓存命中价格只有普通输入价格的 1/10 , 用少量的成本换取效率的大大提升是划得来的。
本质上,还是回到了我们开头提到的:让模型聚焦于解决问题而不是搞清楚问题。
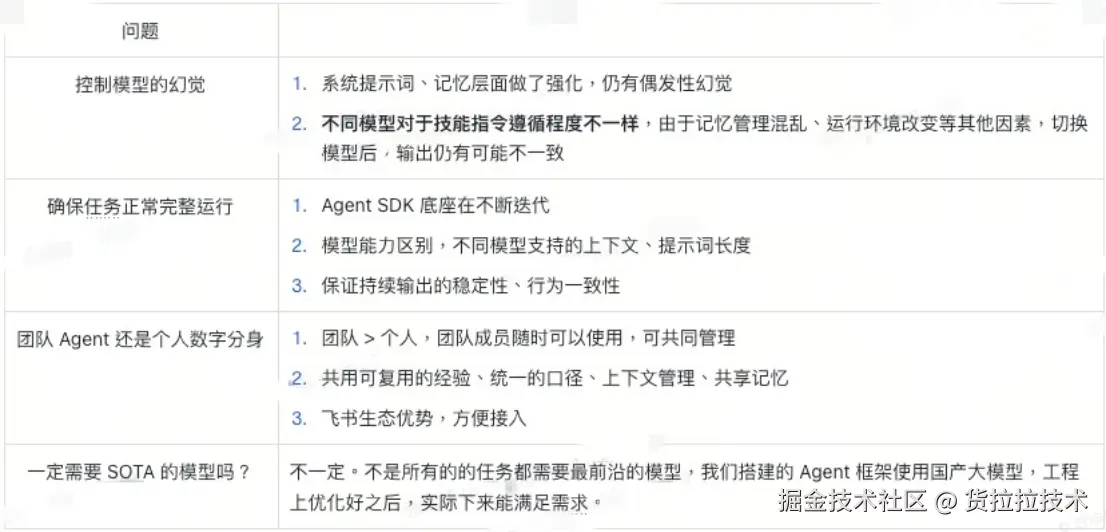
现有的问题
展望
除了让模型可以持续稳定地跑起来,Agent 如果一味输出而收不到来自人类的反馈,它有可能会不断自我强化,陷入"死胡同"出不来,如何收集人类真实的反馈、纠正,让 Agent 总结避免再次踩坑是我们下一步的聚焦点。
参考阅读: