文章目录
梯度的数学定义
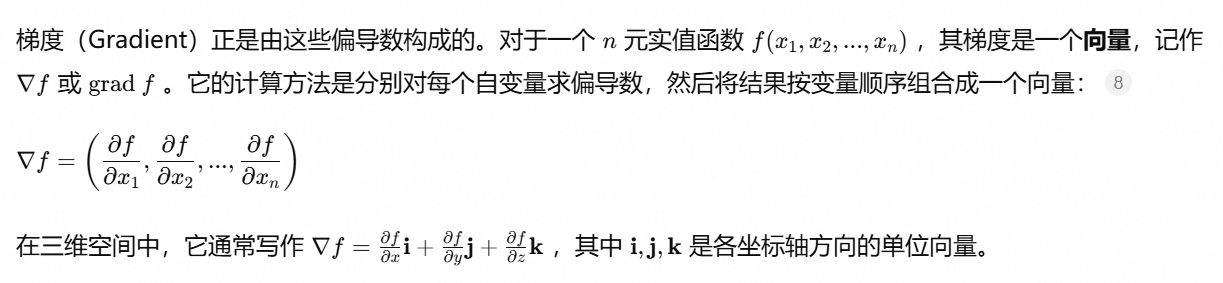
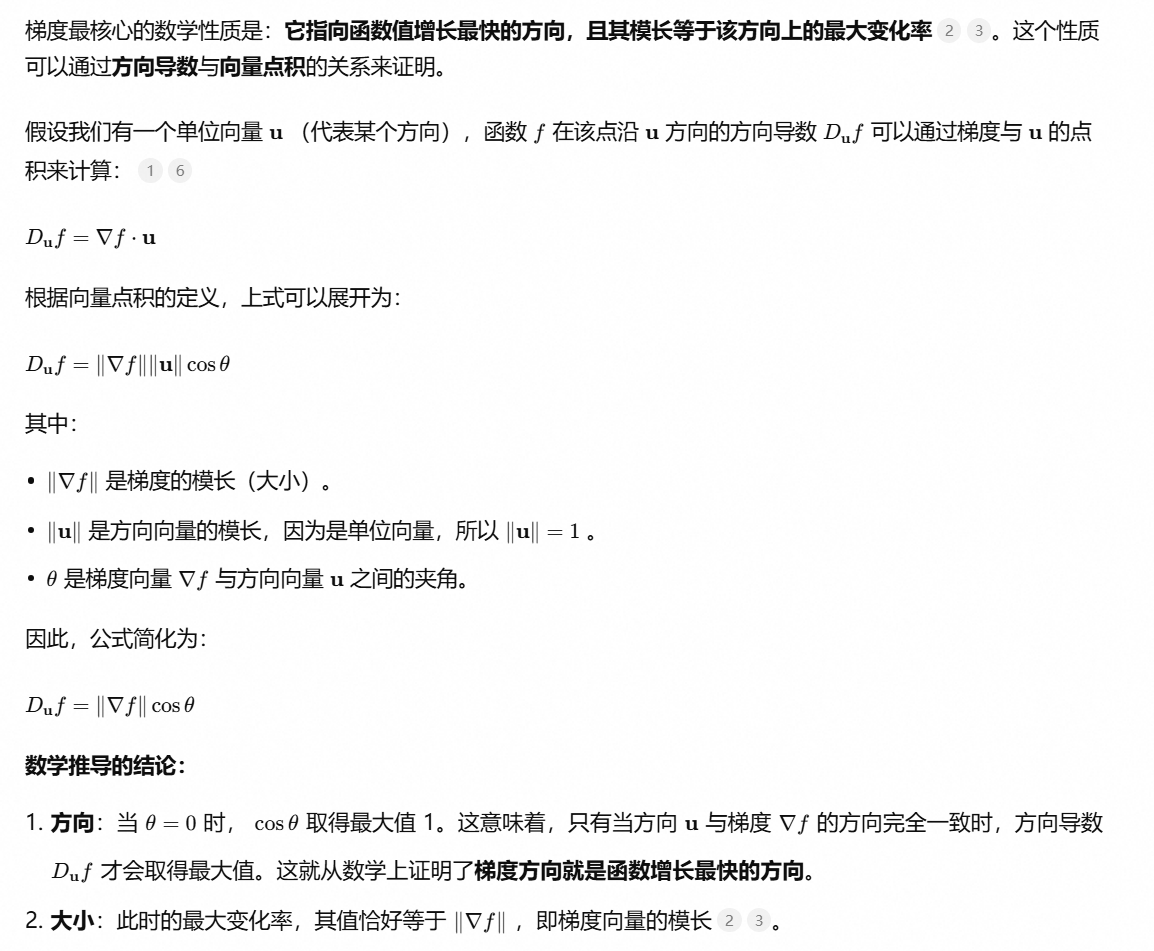
梯度的核心作用
指示方向 :梯度向量指向函数值增长最快的方向(最陡的上坡方向),而它的反方向(负梯度)则是函数值下降最快的方向(最陡的下坡方向)。
衡量变化率:梯度的模长(大小)代表了在该点沿最陡方向的变化速率有多快
通俗地讲,梯度就像是一个"导航算法",它不仅告诉你周围哪里最陡峭(方向),还告诉你陡峭的程度有多大(大小)
梯度的应用
-
人工智能与机器学习(梯度下降法)
应用实例 :在训练神经网络(如让AI学会识别手写数字、抖音推荐算法调整内容权重)时,系统需要不断调整数以百万计的参数,以缩小预测结果与真实结果之间的误差(损失函数) 。
原理解释 :我们可以把"误差"想象成连绵起伏的山脉,我们的目标是找到误差最低的谷底。由于参数太多,AI就像被蒙住眼睛放在山上,看不清全貌。此时,梯度就充当了脚底的感知器,它计算出当前位置最陡峭的下坡方向。AI通过"梯度下降法",沿着负梯度的方向一步步调整参数,最终找到误差最小的最优解。 -
计算机视觉与图像处理(边缘检测)
应用实例 :在人脸识别或自动驾驶中,计算机需要准确识别出图像中物体的轮廓和边界。
原理解释:在图像中,每个像素都有亮度或颜色值,这构成了一个二维函数。图像梯度用来描述相邻像素之间亮度或颜色的剧烈变化程度。在物体边缘处,像素值会发生突变,此时梯度值会非常大;而在平滑区域,梯度值很小。通过计算图像梯度,计算机就能精准提取出边缘和纹理特征。
自动微分
自动微分(Automatic Differentiation,简称 AD),也被称为算法微分或演算式微分,是一种通过计算机程序来精确计算函数导数的技术。在深度学习框架(如 PyTorch、TensorFlow)中,它是实现反向传播算法和模型自动训练的核心底层技术。
在深度学习中,模型通常包含数以百万计的参数和极其复杂的嵌套函数表达式。如果依赖人工手动推导梯度,不仅耗时费力,而且极易出错。自动微分技术让开发者只需专注于编写正向的计算逻辑(即模型的前向传播),框架会自动完成梯度的计算与反向传播,极大地降低了人工智能模型训练和优化的门槛。
自动微分的核心原理
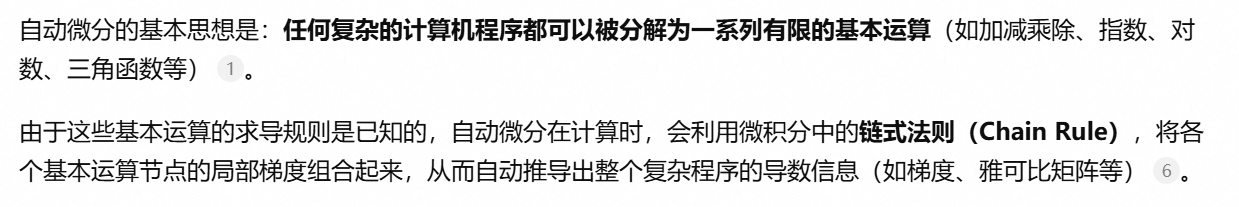
自动微分的两种主要模式
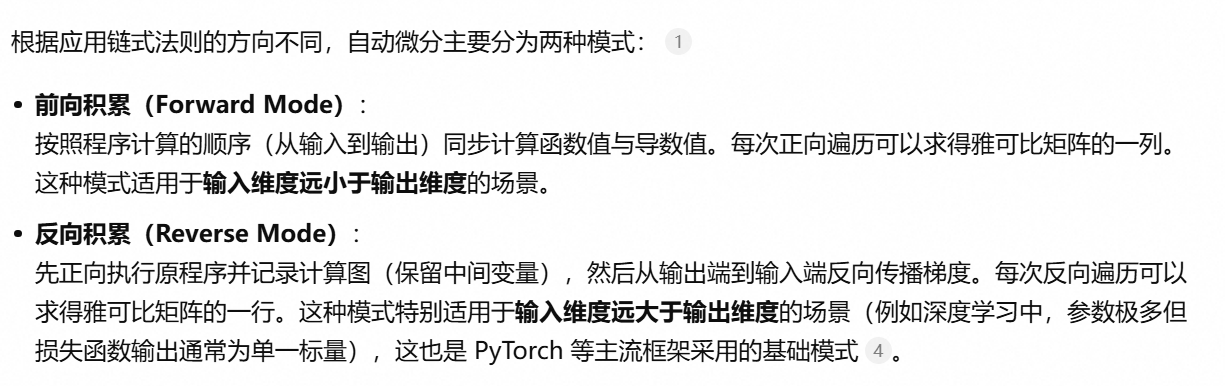
自动微分的工作
我们不写复杂的深度学习模型,而是用 Python 模拟一个最基础的"计算图(Computational Graph)。
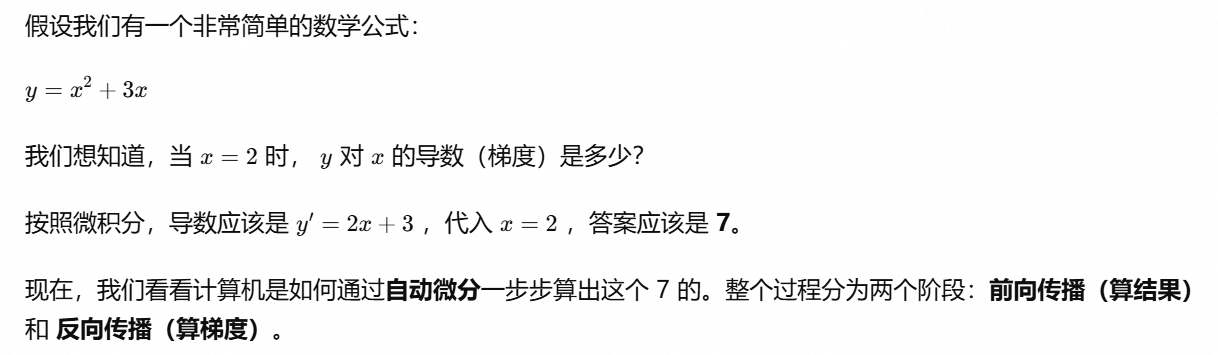
第一步:定义基础的"积木"(基本运算)
计算机不认识复杂的公式,它只认识加减乘除。 我们先定义两个最基础的运算,并同时告诉计算机它们的求导规则:
py
# 乘法节点
class MulNode:
    def forward(self, a, b):
        return a * b  # 前向:计算结果

    def backward(self, grad_output):
        # 反向:根据链式法则,乘法的局部导数
        # d(a*b)/da = b, d(a*b)/db = a
        return grad_output * self.b, grad_output * self.a

# 加法节点
class AddNode:
    def forward(self, a, b):
        return a + b  # 前向:计算结果

    def backward(self, grad_output):
        # 反向:加法的局部导数永远是 1
        # d(a+b)/da = 1, d(a+b)/db = 1
        return grad_output * 1, grad_output * 1
第二步:前向传播(正向计算结果)
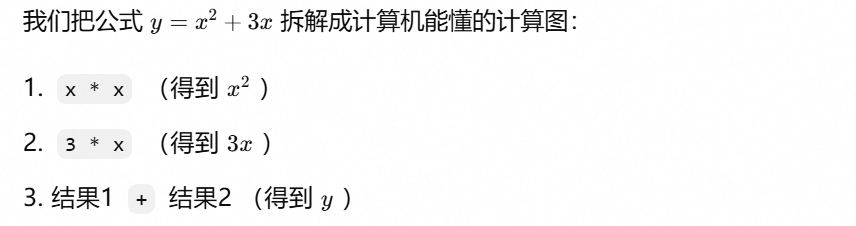
py
x = 2.0  # 输入变量

# 1. 计算 x^2
mul_node_1 = MulNode()
res_1 = mul_node_1.forward(x, x)  # 2 * 2 = 4

# 2. 计算 3x
mul_node_2 = MulNode()
res_2 = mul_node_2.forward(3, x)  # 3 * 2 = 6

# 3. 计算 y = x^2 + 3x
add_node = AddNode()
y = add_node.forward(res_1, res_2)  # 4 + 6 = 10

print(f"前向传播计算结果 y = {y}")
# 输出:前向传播计算结果 y = 10.0
第三步:反向传播(自动微分核心!)
现在,我们从终点 y 出发,顺着刚才记录的"计算图"往回走。根据链式法则,把每一层的局部导数乘起来。
py
# 终点 y 对自身的导数永远是 1
grad_y = 1.0

# 1. 回到加法节点 (y = res_1 + res_2)
# 把 grad_y 分发给 res_1 和 res_2
grad_res_1, grad_res_2 = add_node.backward(grad_y)

# 2. 回到第一个乘法节点 (res_1 = x * x)
# 注意:这里 x 被用了两次,所以要把两部分的梯度加起来!
grad_x_from_res1_a, grad_x_from_res1_b = mul_node_1.backward(grad_res_1)
grad_x_part_1 = grad_x_from_res1_a + grad_x_from_res1_b  # 1*2 + 1*2 = 4

# 3. 回到第二个乘法节点 (res_2 = 3 * x)
_, grad_x_part_2 = mul_node_2.backward(grad_res_2)  # 1*3 = 3

# 4. 汇总:x 的总梯度
grad_x_total = grad_x_part_1 + grad_x_part_2
print(f"自动微分计算出的梯度 dy/dx = {grad_x_total}")
# 输出:自动微分计算出的梯度 dy/dx = 7.0
注意:终点y对自身的导数为什么永远是1