之前我们写的三篇文章,其实一直留着一个没填的坑。
第一篇用gpt-image-2 生成的大屏设计稿,我把它还原成了代码讲怎么用 AI 生成大屏设计稿,第二篇有了大屏设计稿还不够,我又用Gpt-image-2把里面的素材全扒了出来讲怎么把设计稿切成素材包,第三篇用 gpt-image-2 给三维地图生成纹理,可视化大屏里那种科技感原来是这么来的讲怎么用 Blender 加纹理贴图搞定一块三维地图。三篇写完,文末我留了一句话:其他三维场景怎么做,比如智慧工厂、精细化建模,还没想好。
时间往回倒一下,那三篇文章是今年四五月份写的,正好是 GPT-Image-2 刚出来那阵子。当时它的生图能力已经很能打了,设计稿一句话能出,素材也能按批次往外扣,这在当时是挺震撼的一件事。
但用下来问题也不少。设计稿这块,同一句 prompt 每次出来的东西差异很大,想要的细节经常抓不住,得多跑几轮才能挑到一张能用的;切素材这块,背景色处理、边缘发光效果保留、批次之间互相污染这些坑,那篇文章里踩了个遍,最后是靠一套很啰嗦的结构化提示词才勉强稳定下来。而三维建模这一块,当时基本是这条链路里最弱的一环------GPT 只能帮忙出一张纹理贴图,剩下挤压厚度、绑材质、调灯光全靠我自己在 Blender 里一步步手动搞,效率很低,还原度也总差点意思。
这次是把这个坑填上了。起因是 GPT-Image-2.5 的生图能力和 GPT-6 Astra 的建模能力都上了一个台阶,尤其是建模这块,从"只能出张贴图"变成了能直接通过 Blender MCP 完成整套建模流程。我想看看能不能把调研、设计、素材拆分、三维场景、代码还原这五步真正串成一条线,中间不再靠我手动补洞。
这篇文章就以智慧厂房 3D 大屏这个项目为例,从头走一遍这条链路。项目代号 smart-factory-3d-dashboard-v5,涉及的截图和数据比较多,我尽量只挑关键节点讲。
一、先做调研,不是先画图
以前我的习惯是需求一来就直接让 AI 出图,图不满意再改。这次我换了个顺序:先让它写一份工程 Brief。
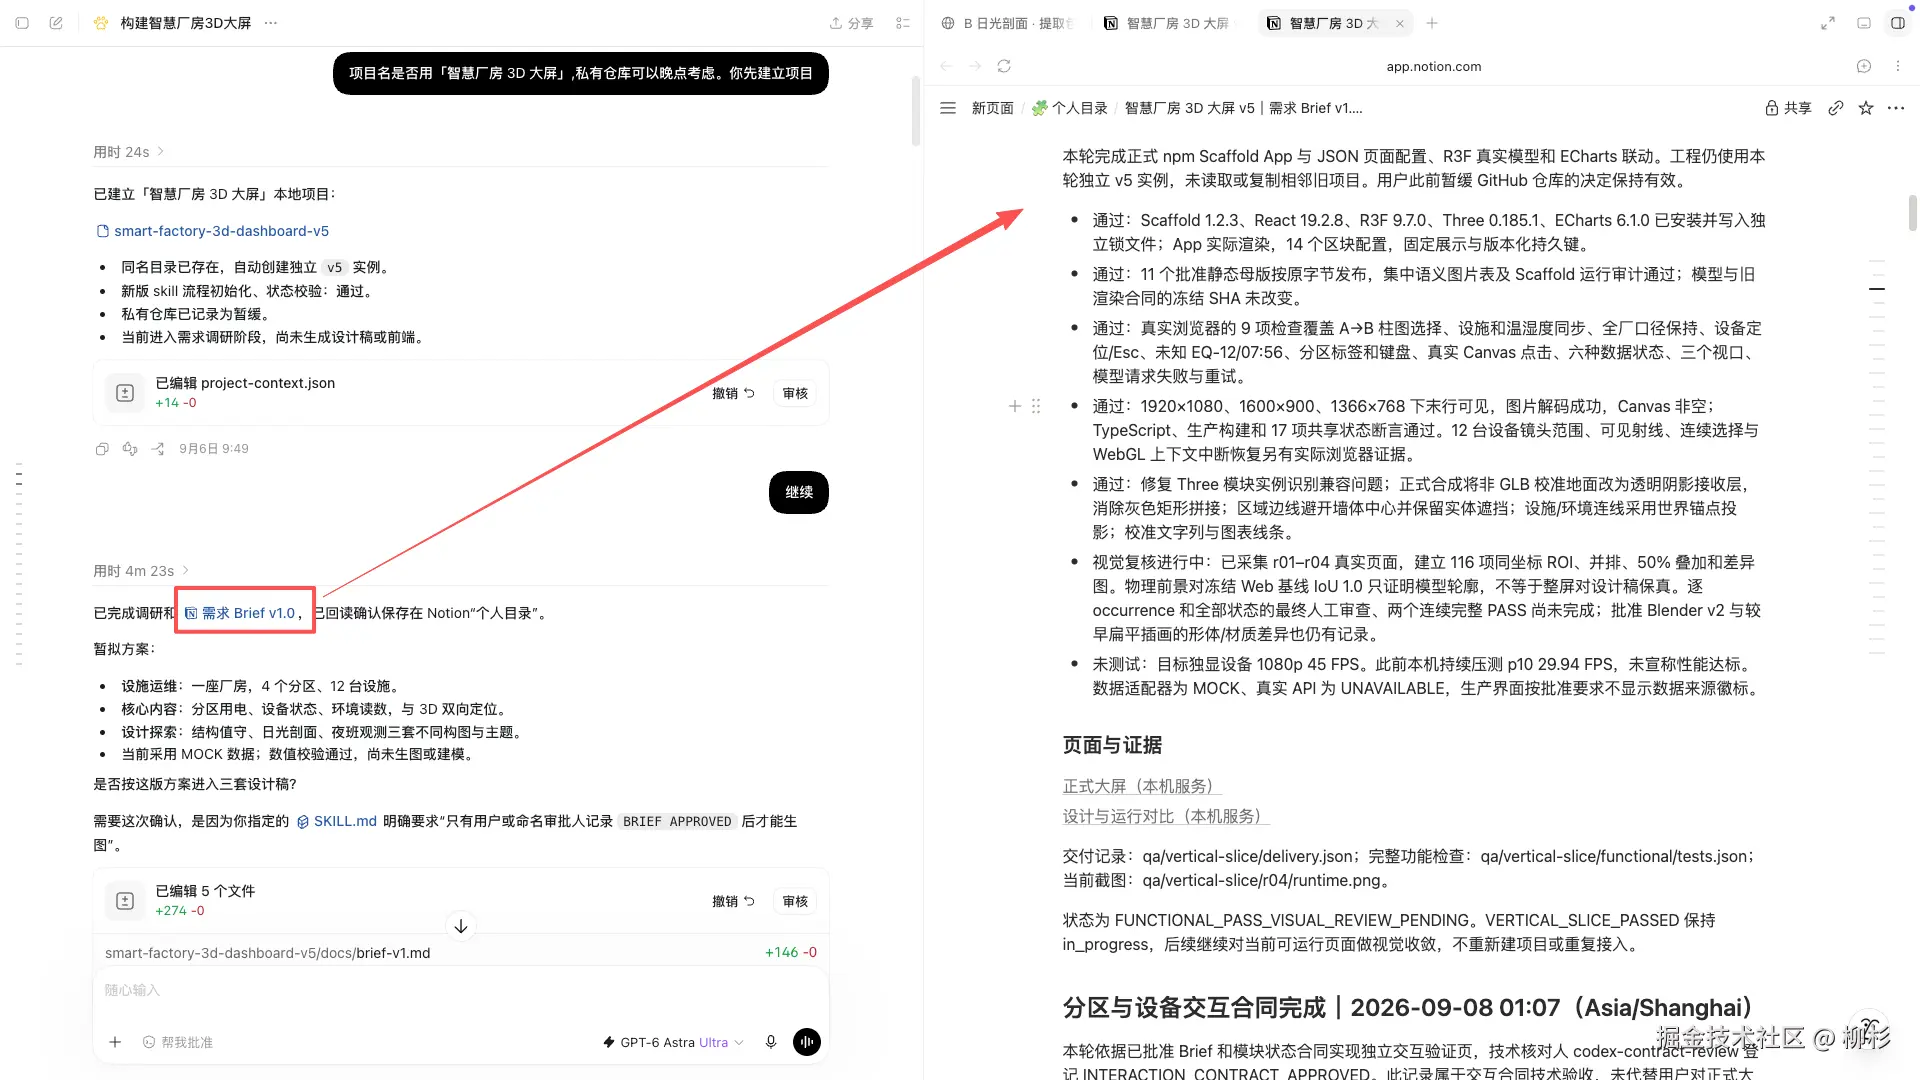
这份 Brief 里包含了用户是谁、首屏三十秒要回答哪几个问题、哪些内容明确排除。比如这次的场景定为设施运维值班查看,首屏必须回答四个问题:设备运行待机未知各多少、未知设备在哪、当前选中分区在哪、该分区温湿度和采样时间是什么。同时明确排除了产量、订单、良率、人员轨迹这些和运维无关的内容,理由是没有对应的数据支撑,不能靠 AI 编。
Brief 里还有一张数据口径表,把每个指标的统计范围、时间窗、缺失处理方式都定死了。比如状态新鲜度超过 180 秒判定为过期,超过 600 秒判定为离线,这两个阈值只是这个项目自己的假设,不代表设备真的坏了。这份 Brief 引用了三份行业资料作为设计依据,不是凭感觉编的范围。
这一步花的时间比想象中长,但好处是后面每一步返工的概率明显变小了。以前我是设计做到一半才发现某个功能没数据支撑,这次提前把这类问题挡在了门外。
二、三稿设计,说清楚为什么选这张
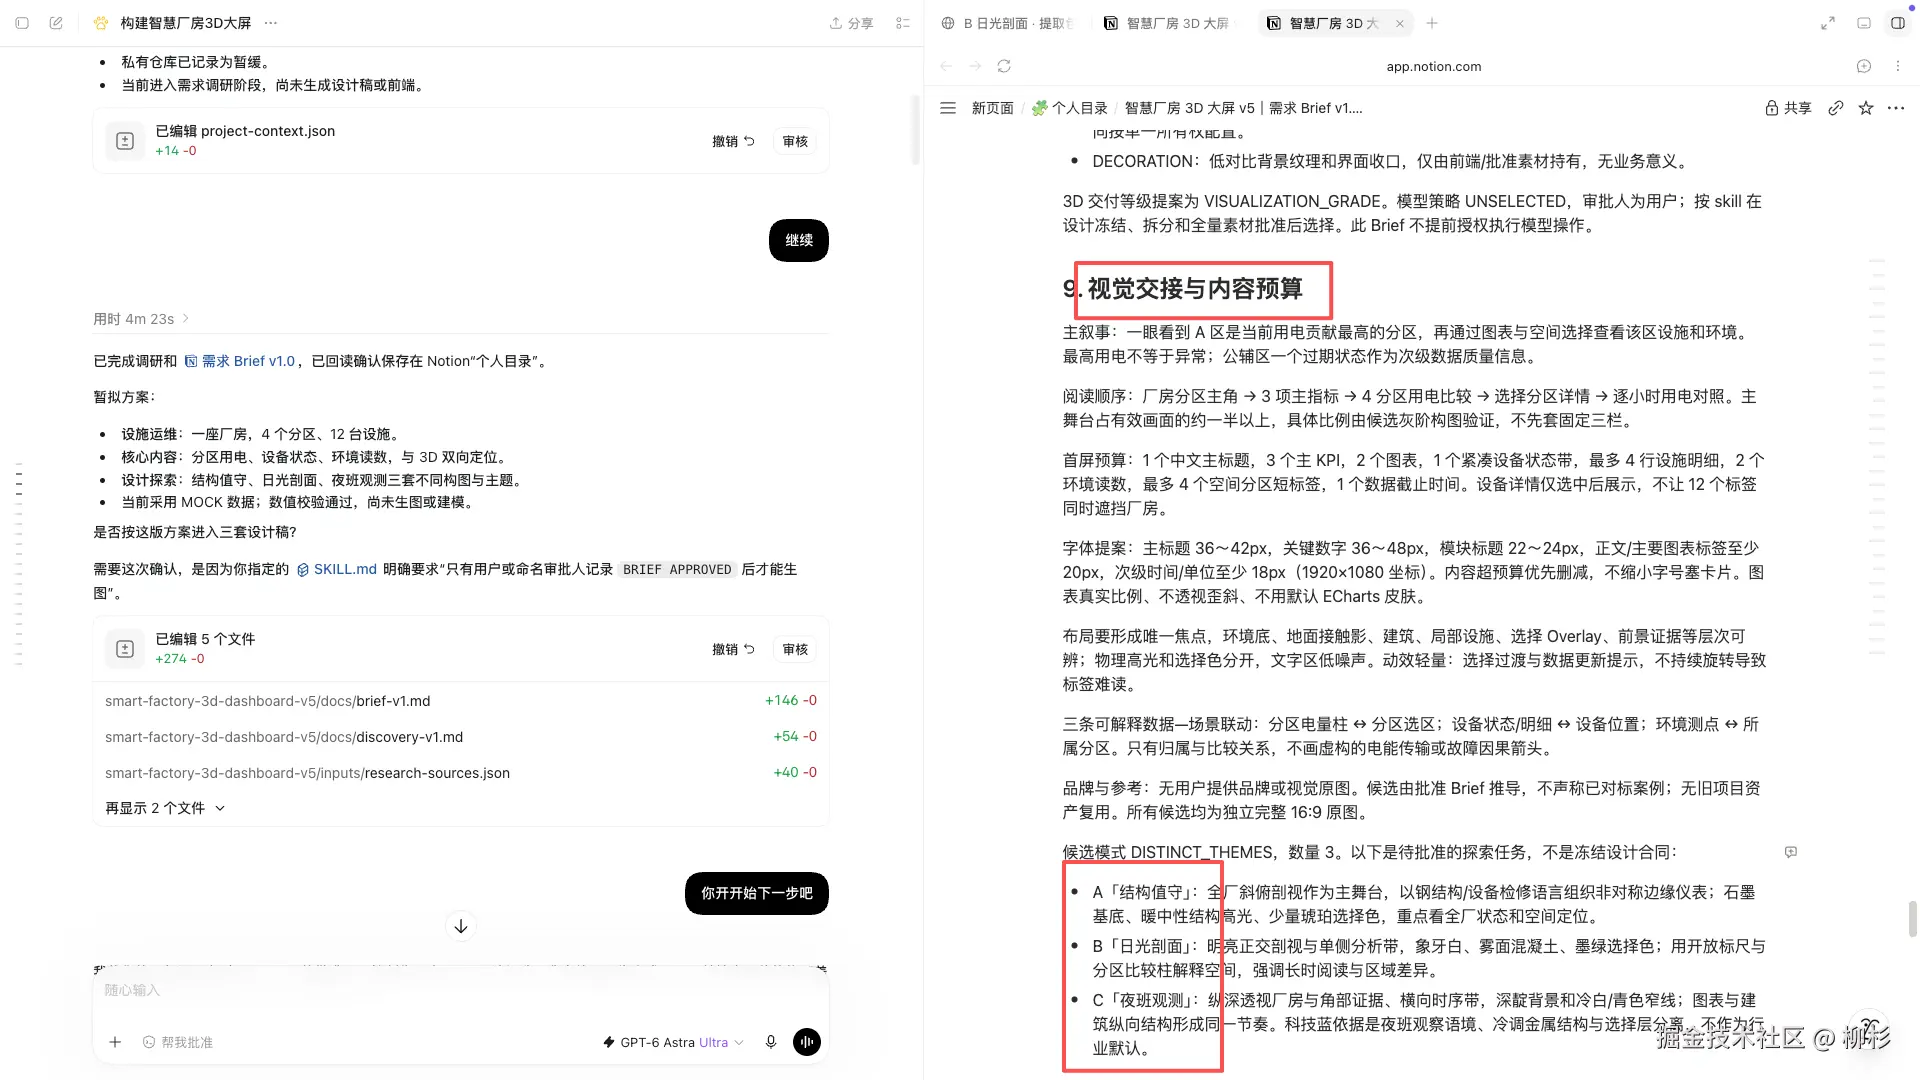
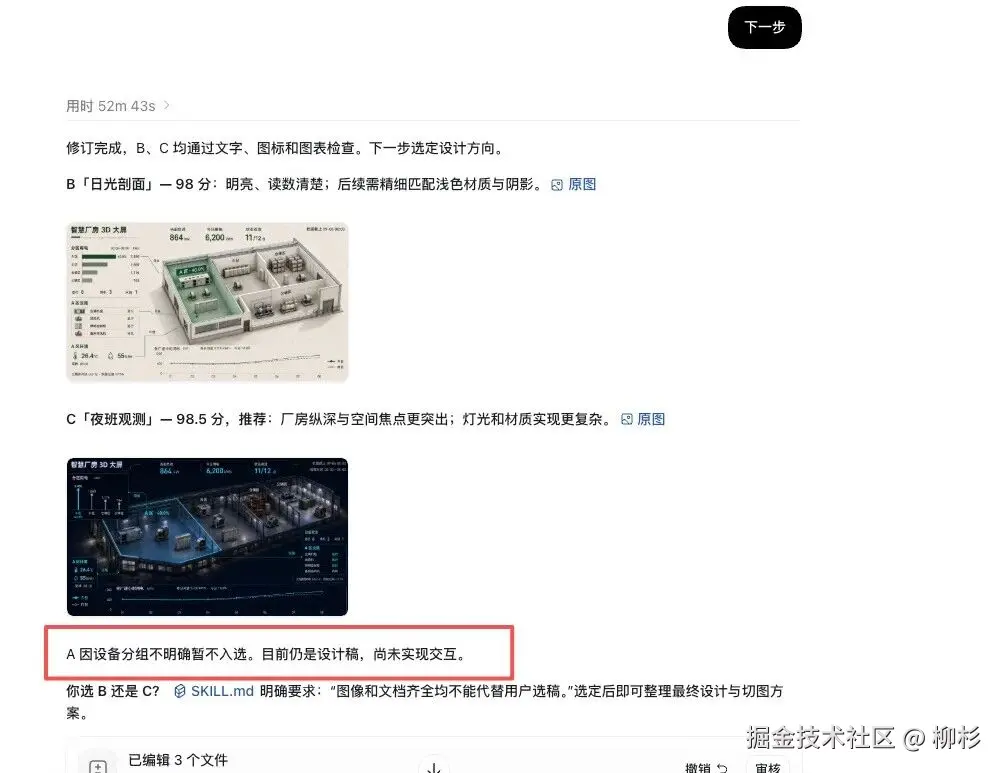
调研通过之后,让它出了三个方向的候选图:结构值守、日光剖面、夜班观测。三张图在构图、材质、配色上刻意做出差异,不是同一张图换个滤镜。
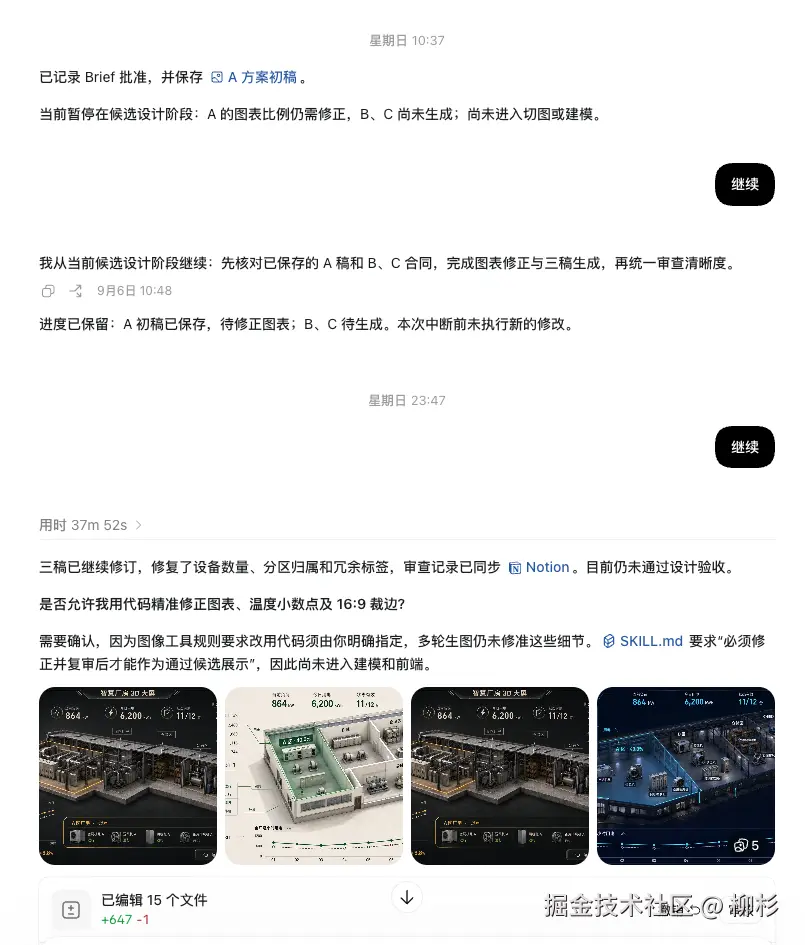
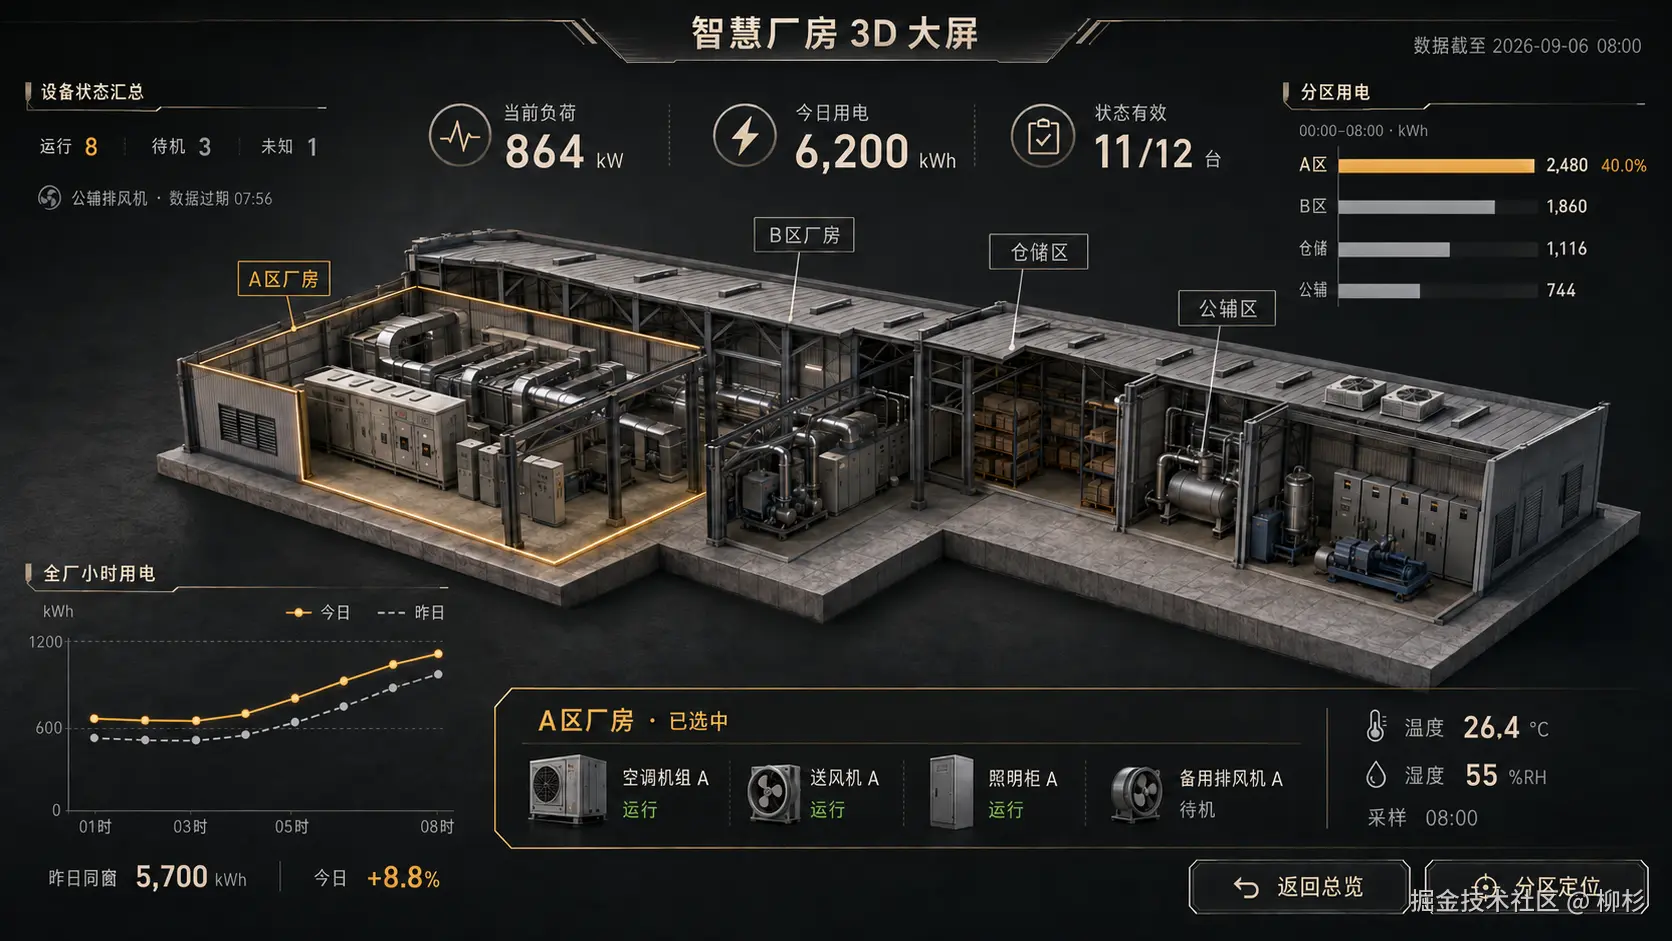
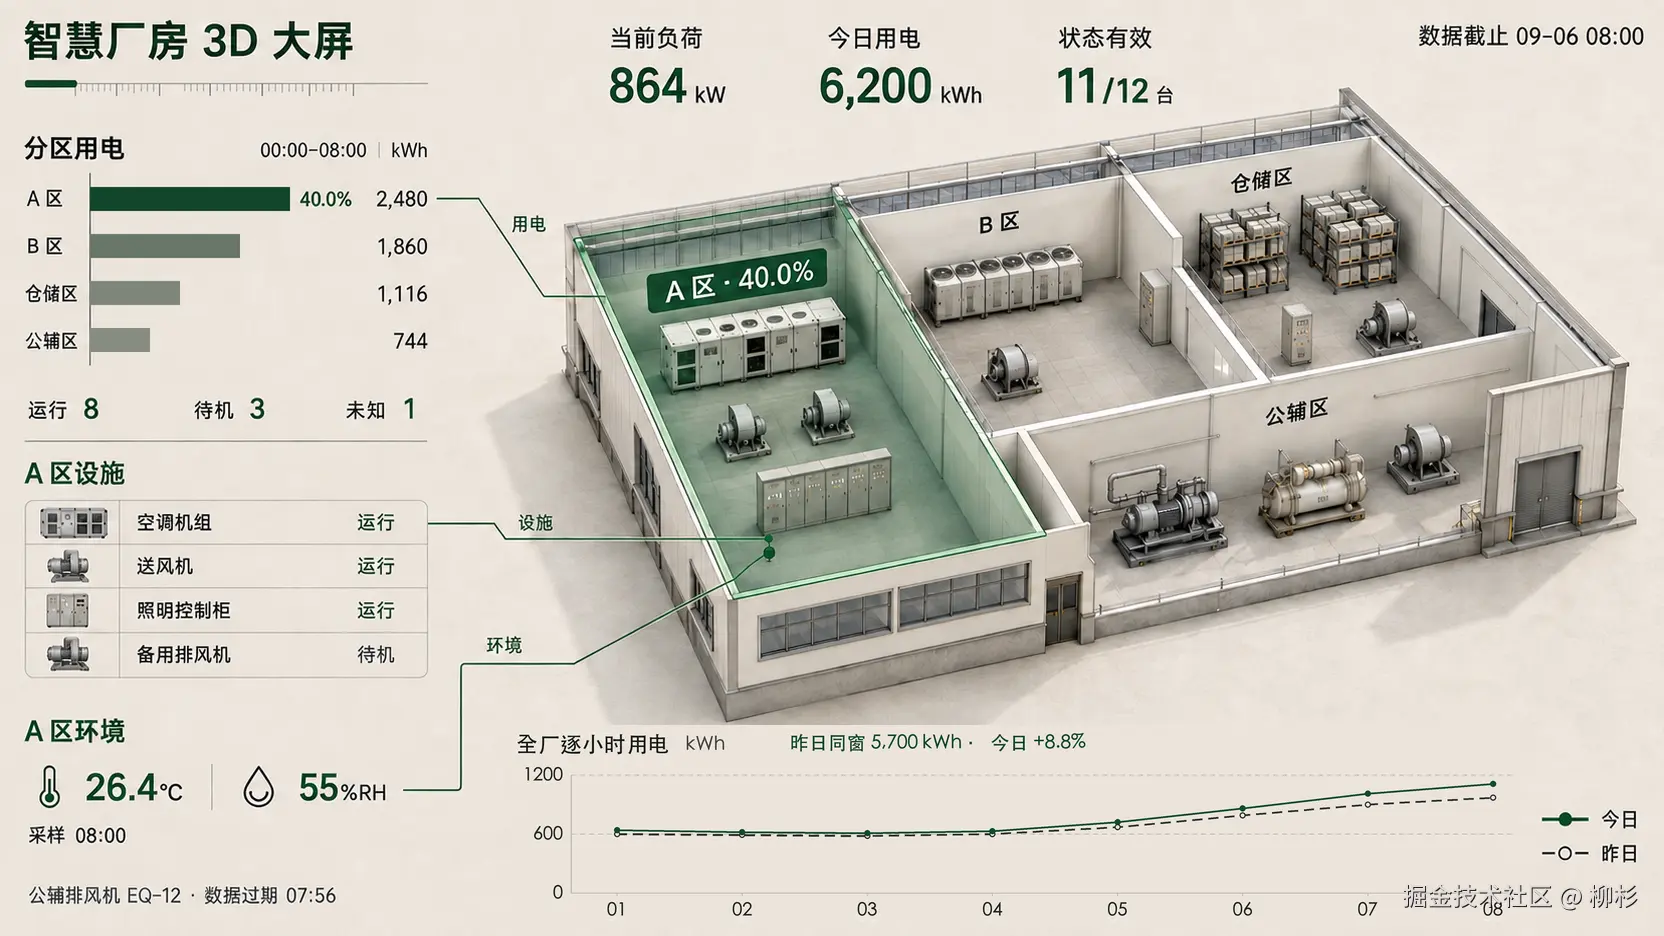
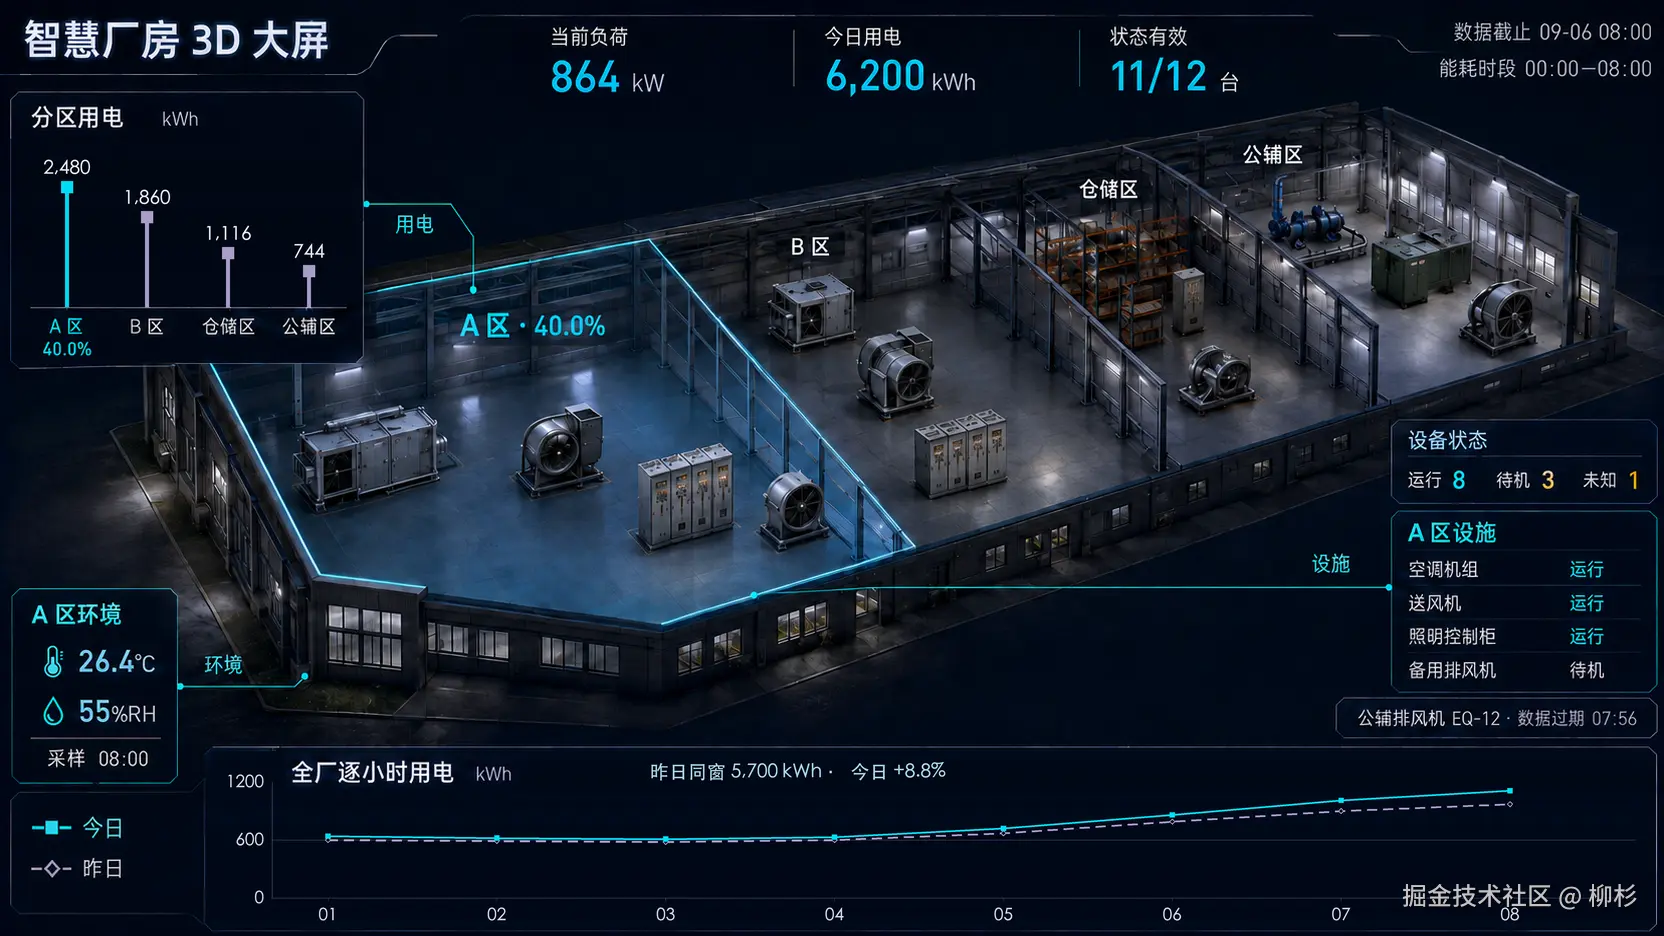
结构值守是斜俯剖视配石墨基底和少量琥珀色选中态,适合看全厂状态。日光剖面是正交剖视配象牙白和墨绿色,适合长时间阅读和分区对比。夜班观测是纵深透视配深靛背景和冷白线条,空间感最强。
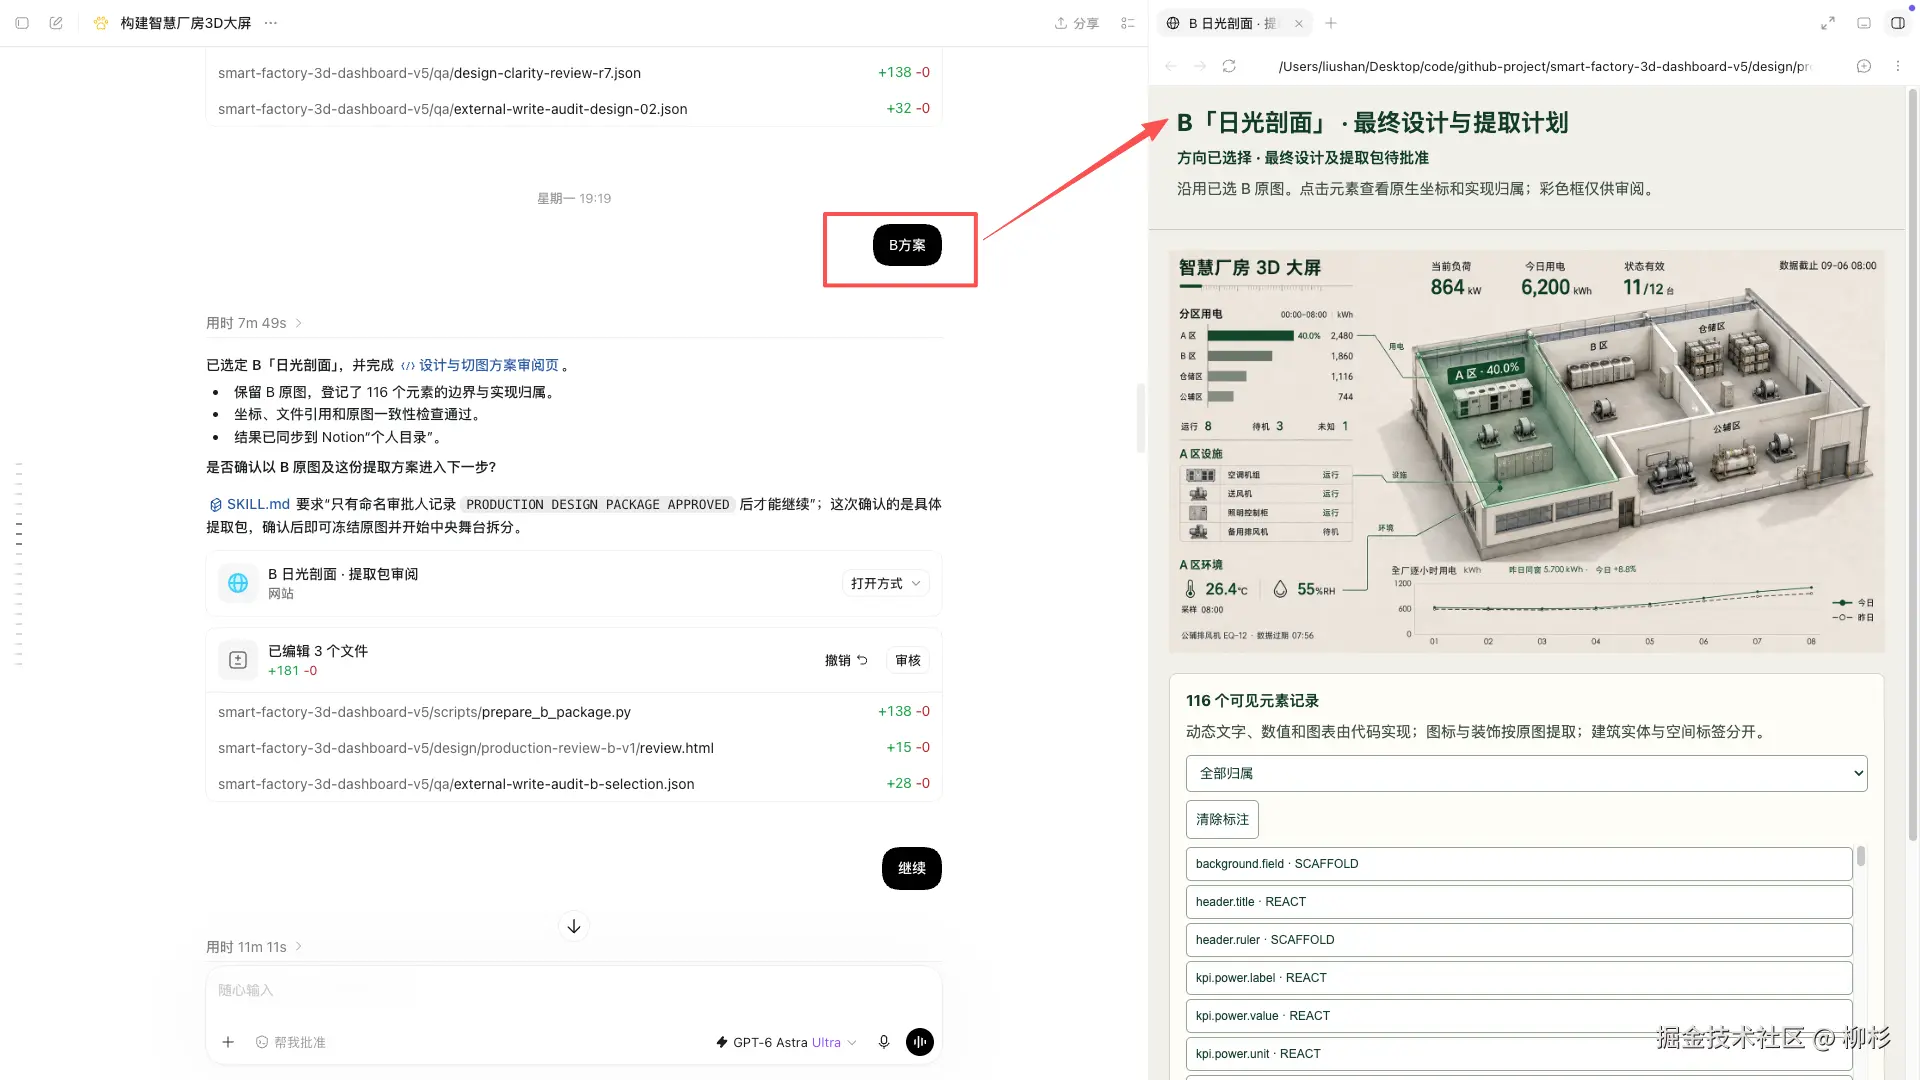
三张图各自打了分,日光剖面 98 分,夜班观测 98.5 分,分数很接近。最后选了日光剖面,主要是它的读数区域更清楚,适合运维值班这种需要反复核对数字的场景。图表里的几个细节,比如分区柱状比例、今日昨日对比数值、温度小数点位数,都是选定之后单独修的,没有推倒重来整张图。
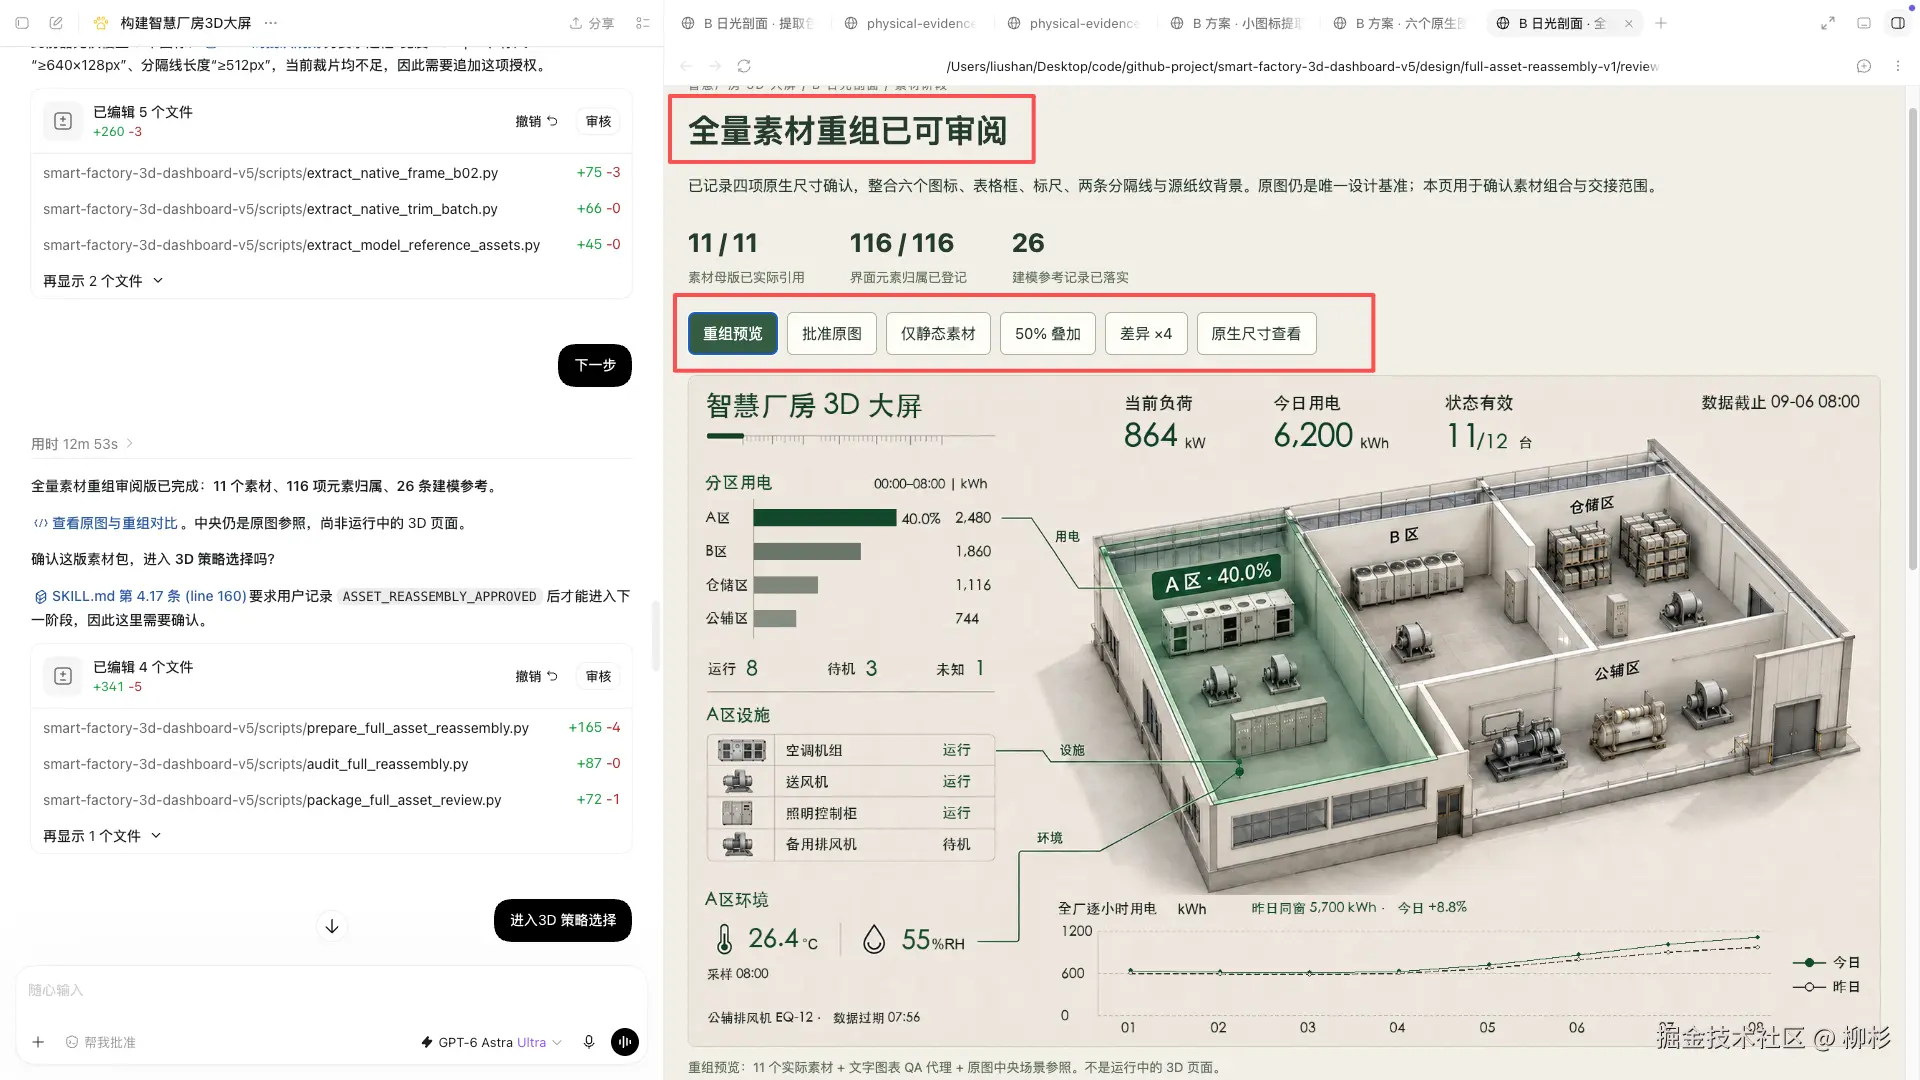
 使用html文件清晰记录标注,随时可以查阅核对标注图标、文字等内容、边界更加清晰。
 提前标注出物理3d信息、方便后面清晰切割对应3d素材生成对应的3d模型
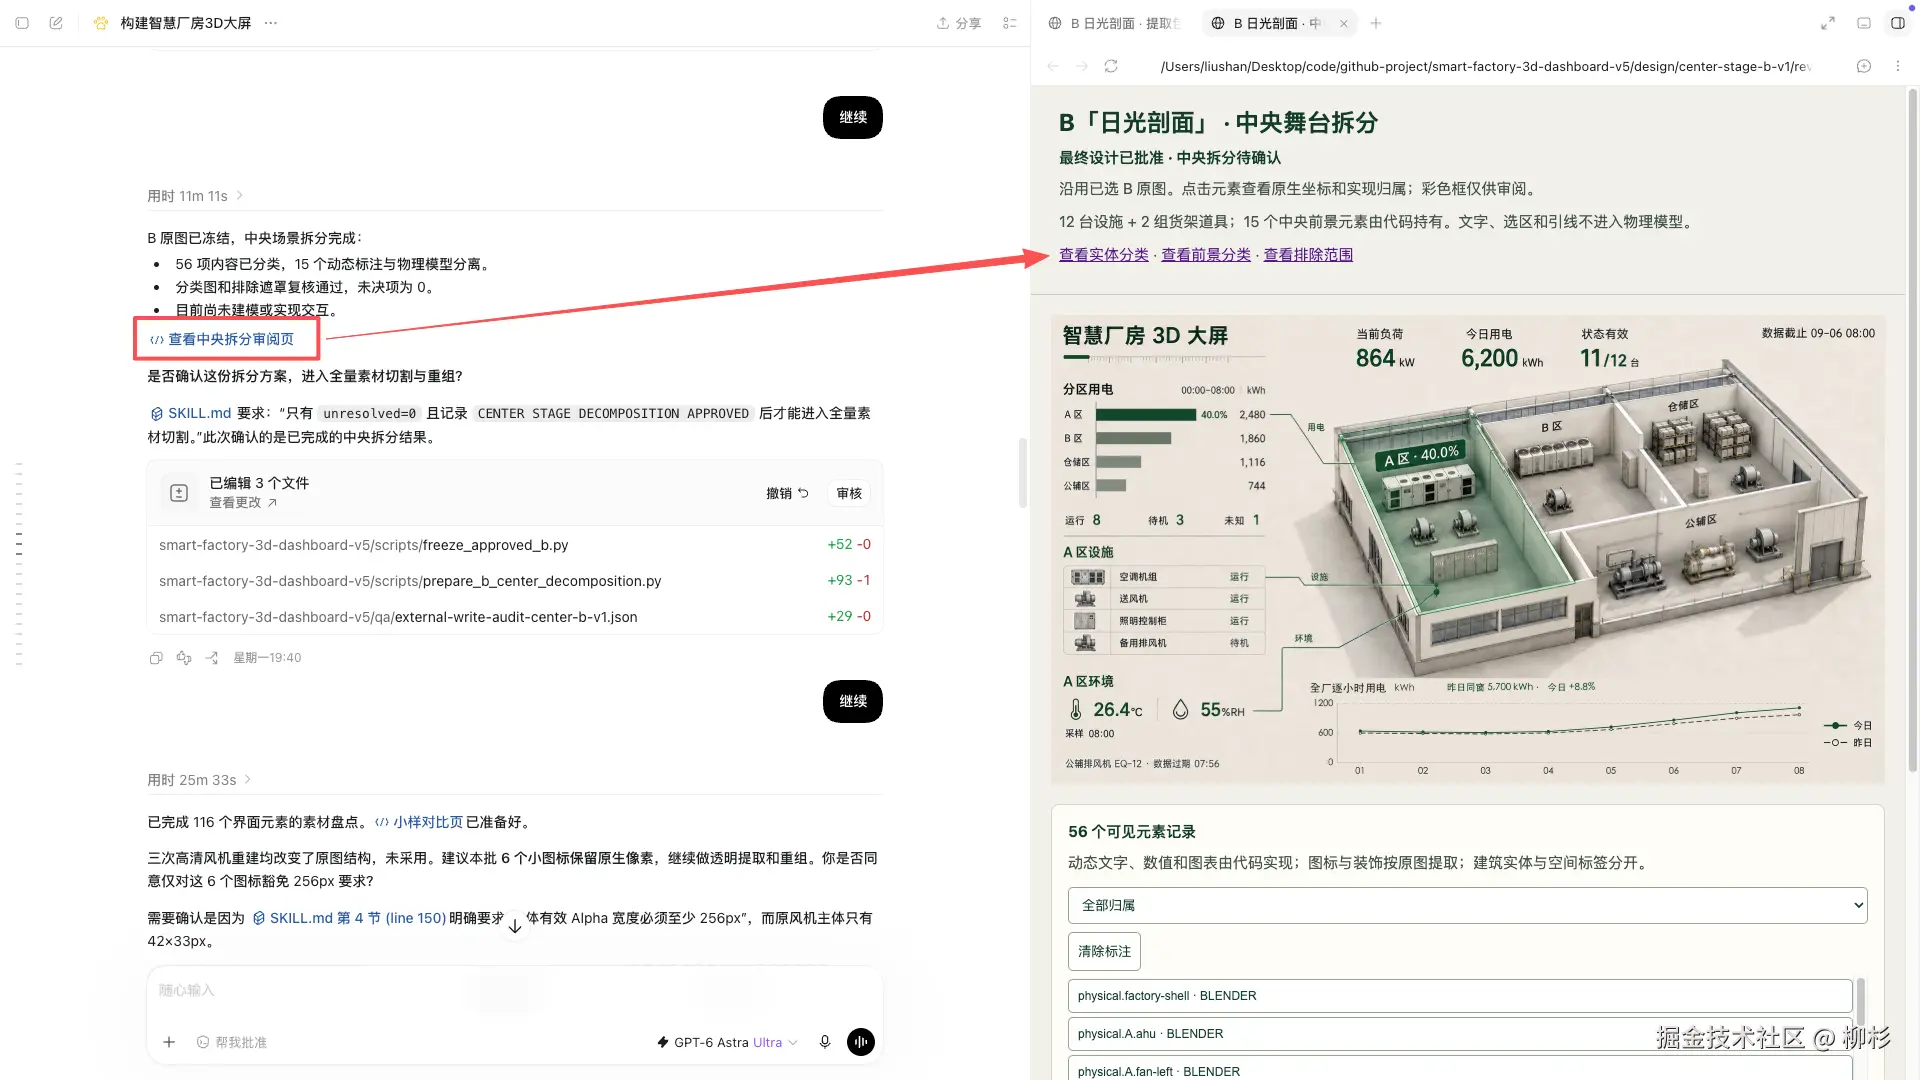
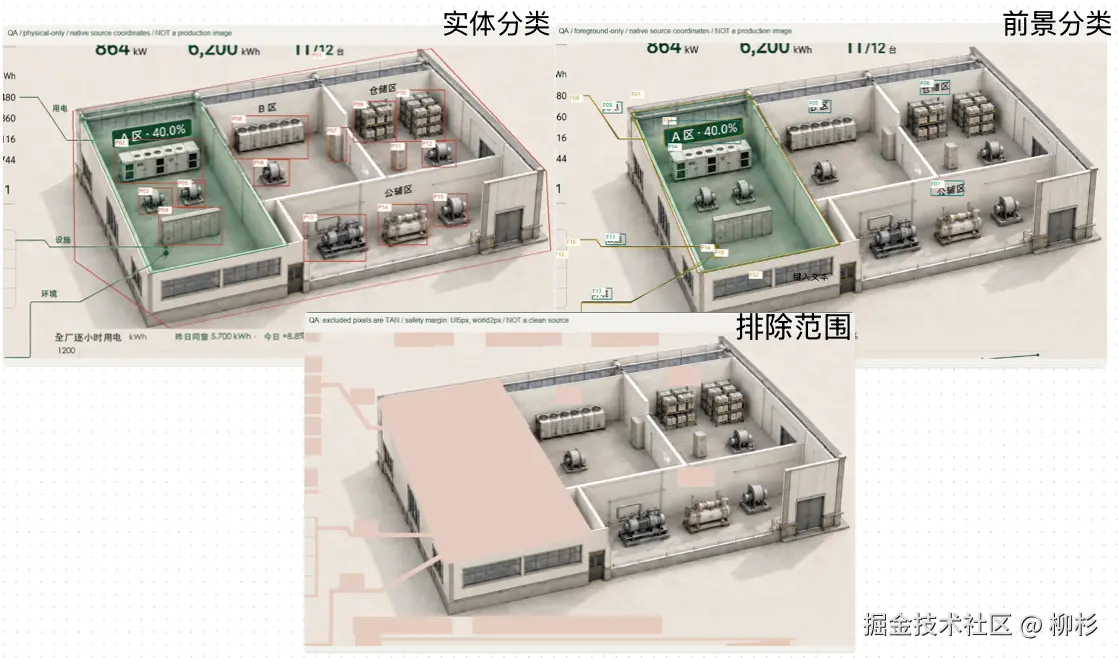
三、素材拆分,这次多了一道审批
素材拆分这一步的思路跟第二篇文章里讲的差不多,还是分批次提取图标、边框、标题背景这些元素。不一样的地方是这次给每一批加了明确的验收标准,而且允许对个别元素走例外流程。
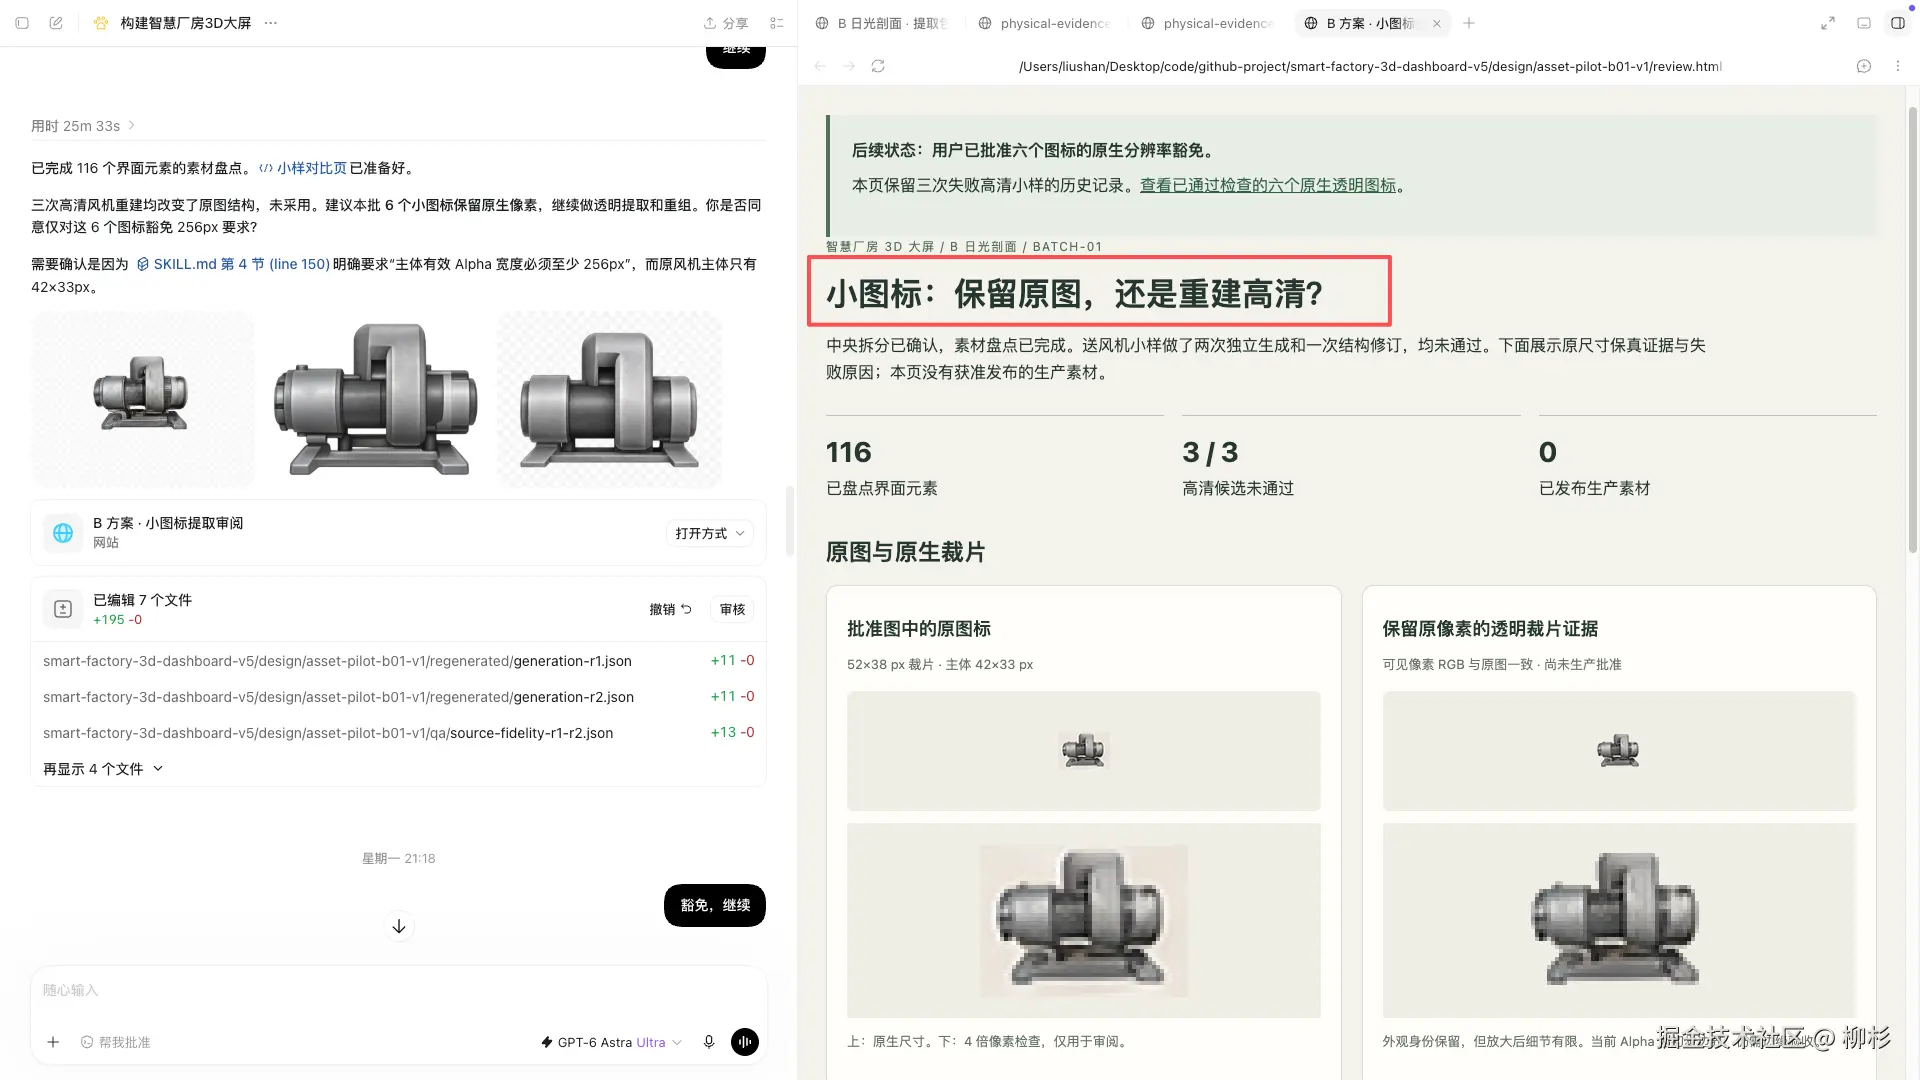
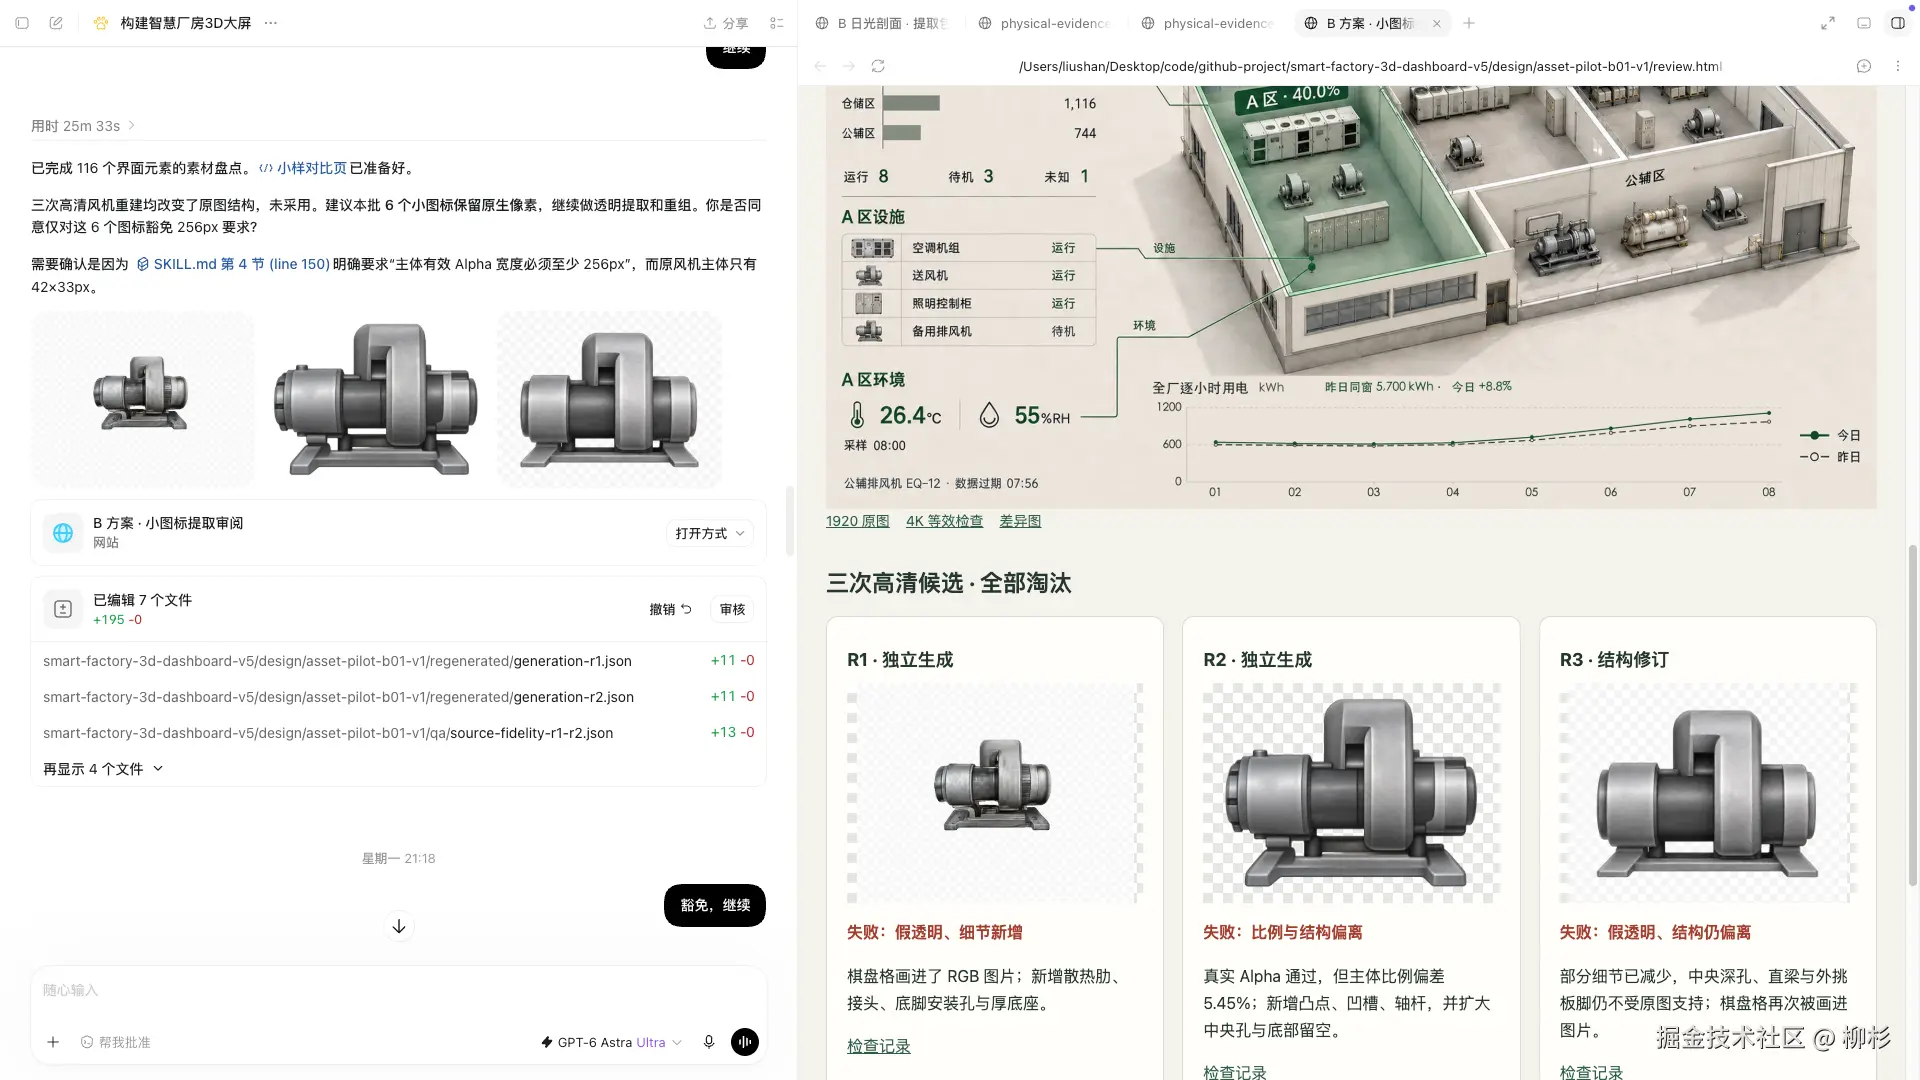
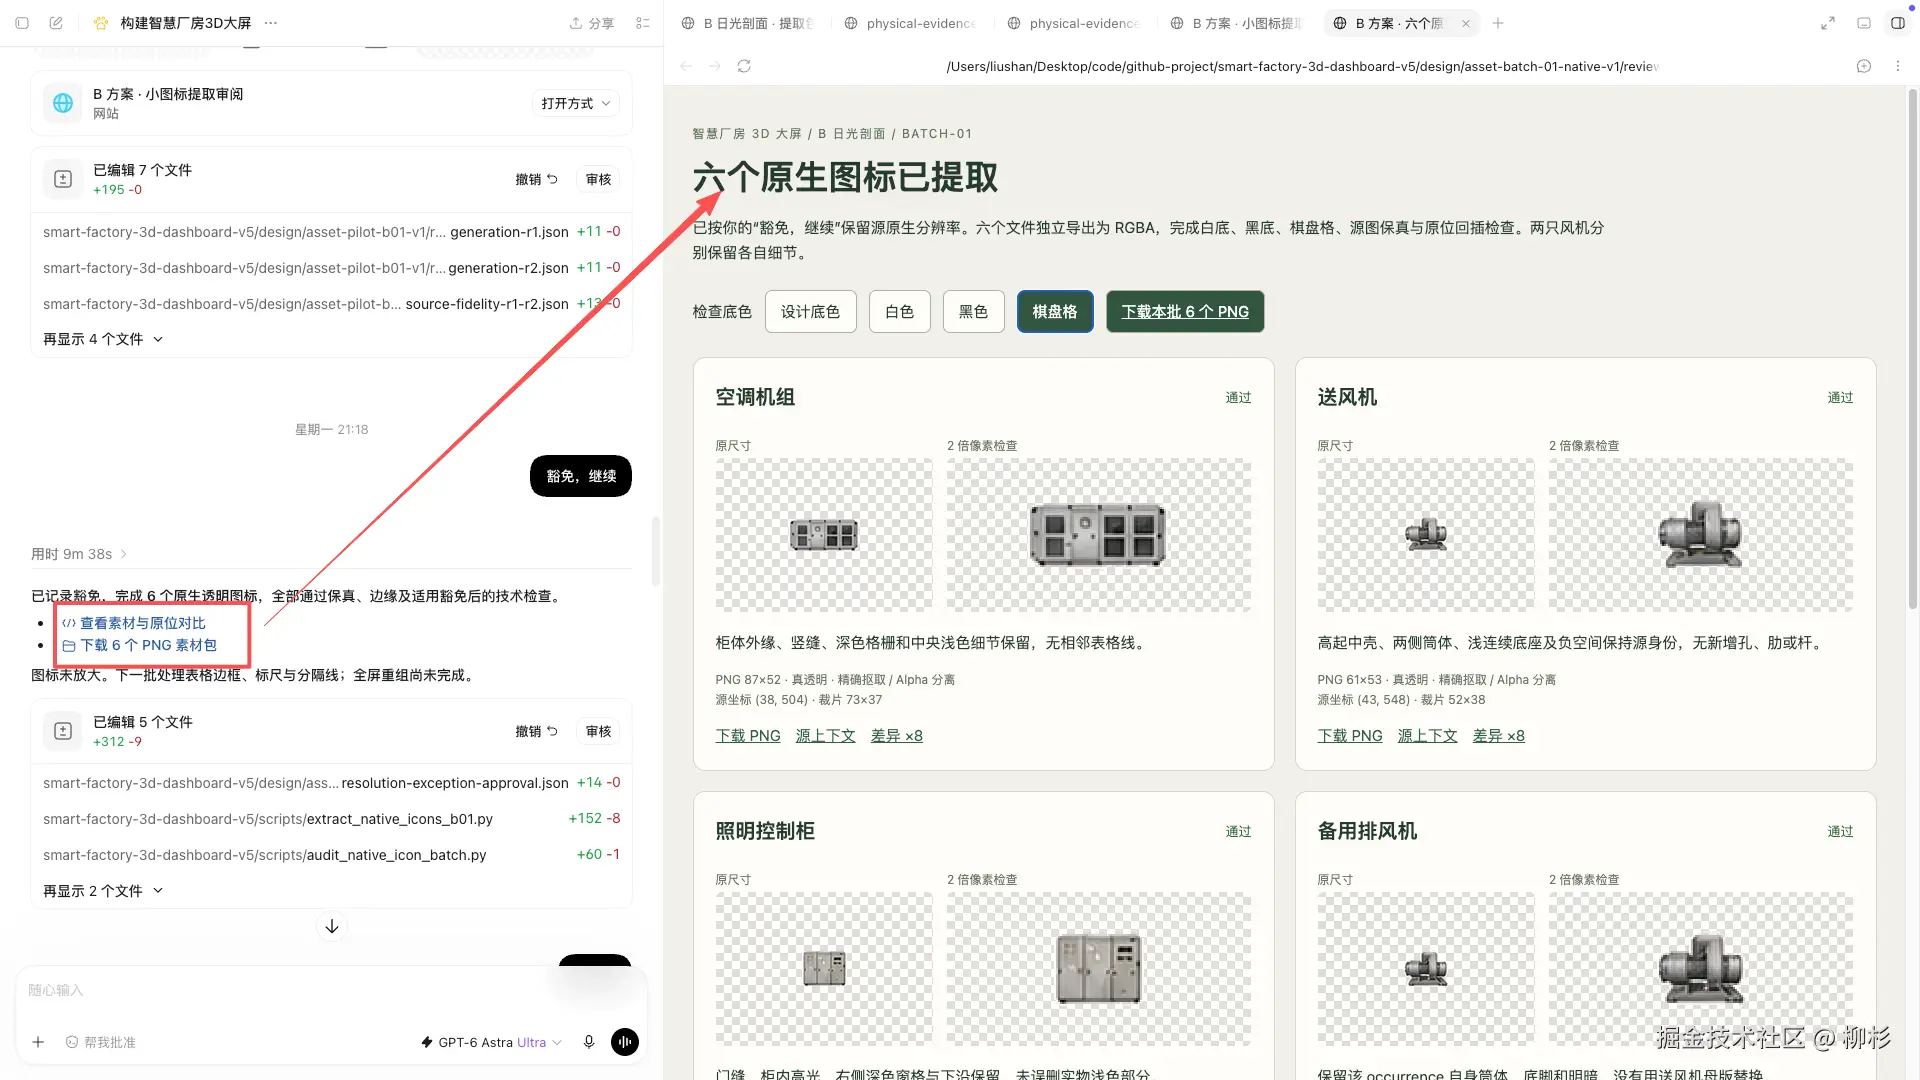
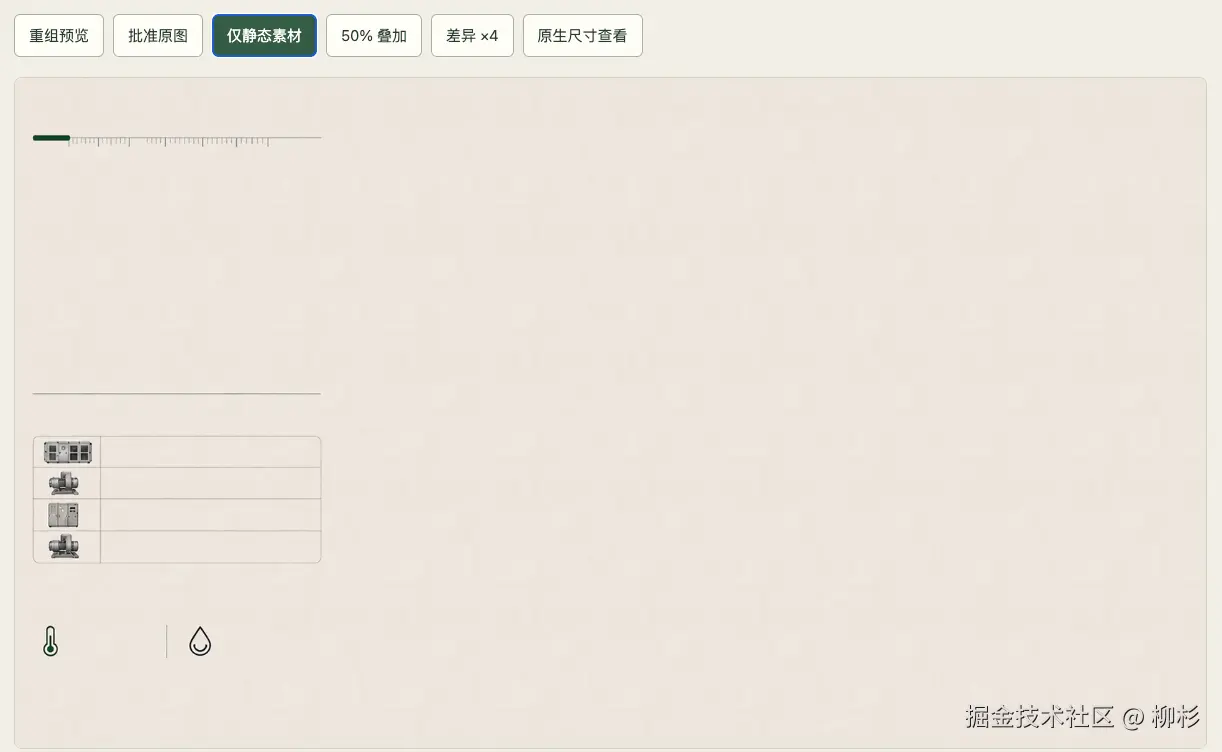
比如设备缩略图和温湿度图标一共六个,按标准要求主体宽度不能小于 256 像素,但这几张图的原始素材本身就偏小,硬放大会糊。这时候没有直接放行,而是先把这六个作为例外单独提出来,说明原因,等我确认之后才继续,其余批次的标准没有跟着降低。类似的例外后来又出现在表格边框和标尺上,这两样东西原图本来就偏小,最后也是按原始尺寸保留,而不是插值拉伸凑数字。
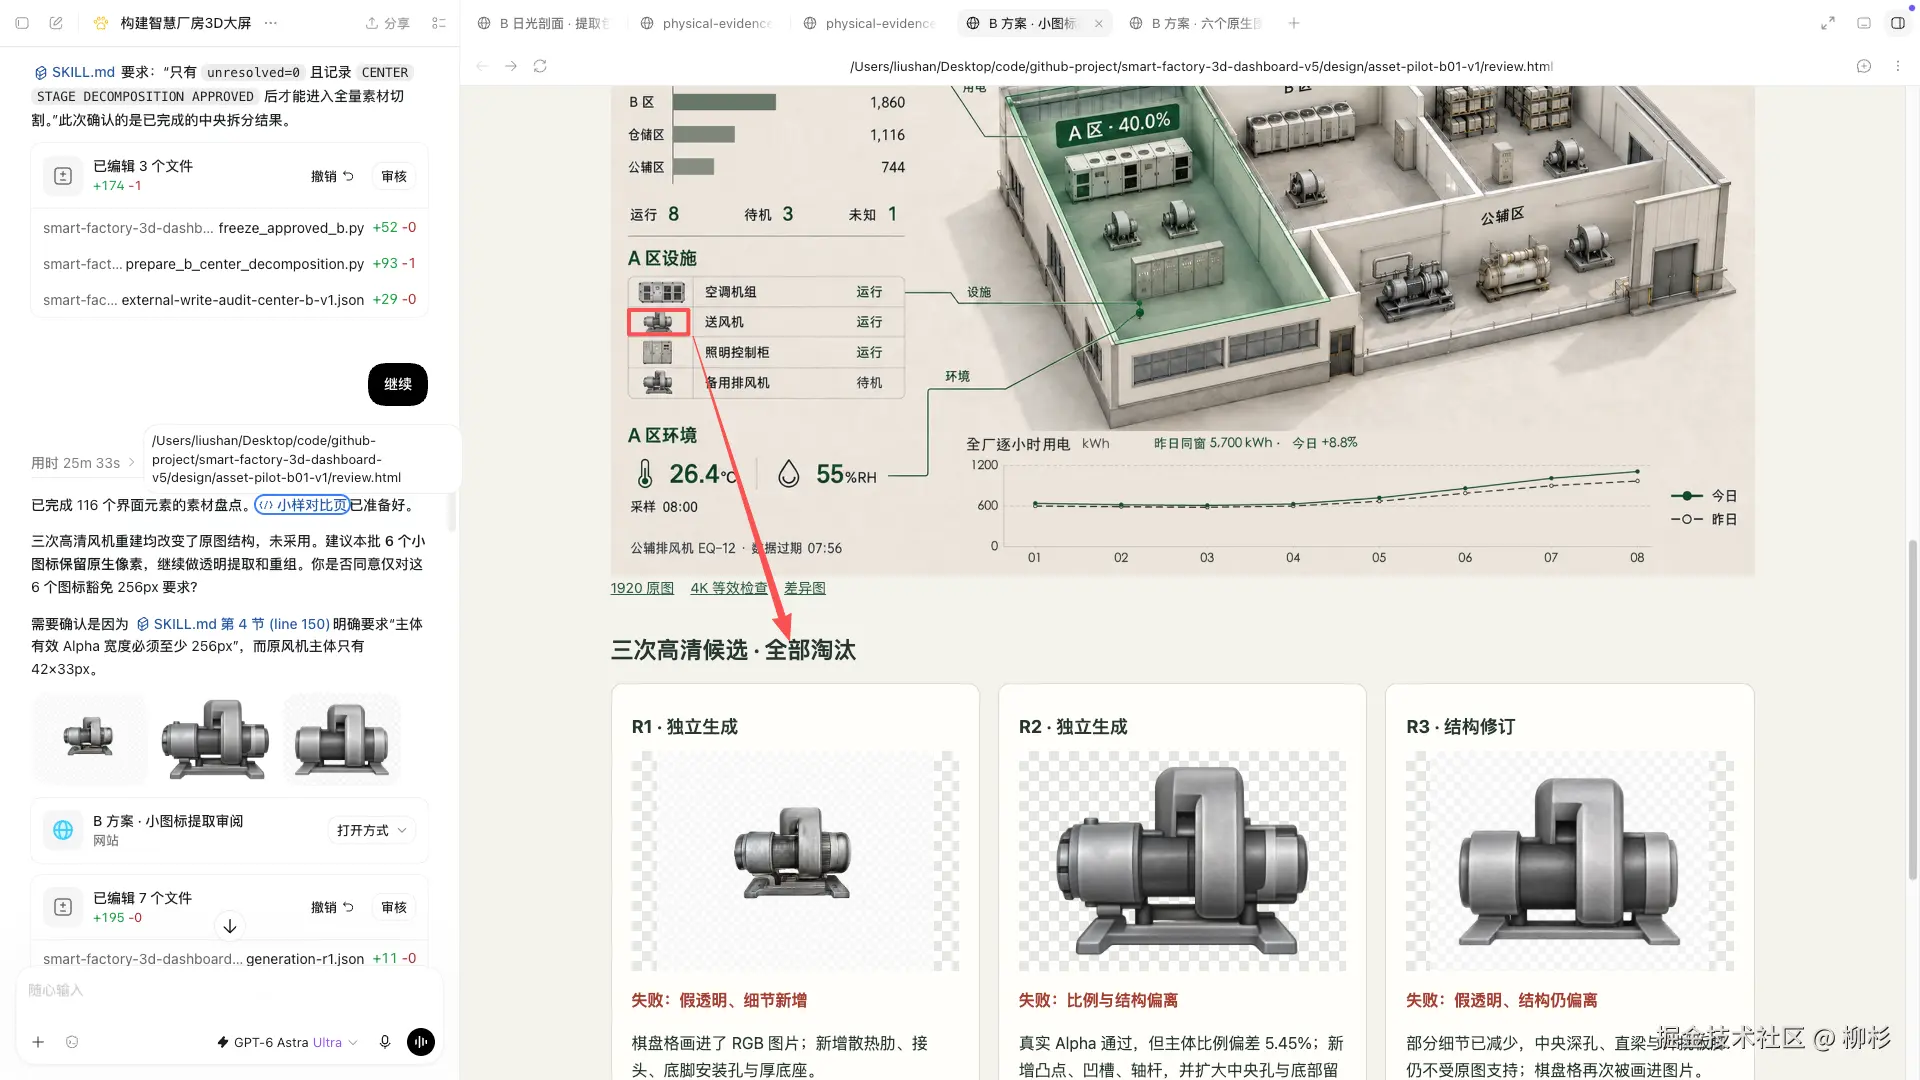
整个大屏最后统计下来是 116 个界面元素,每一个都有明确的实现归属:要么是静态素材图片,要么是代码渲染的文字图表,要么是三维模型上的标注。这个归属表后来在做像素校验的时候帮了大忙,出问题一查就知道该去改哪一层。
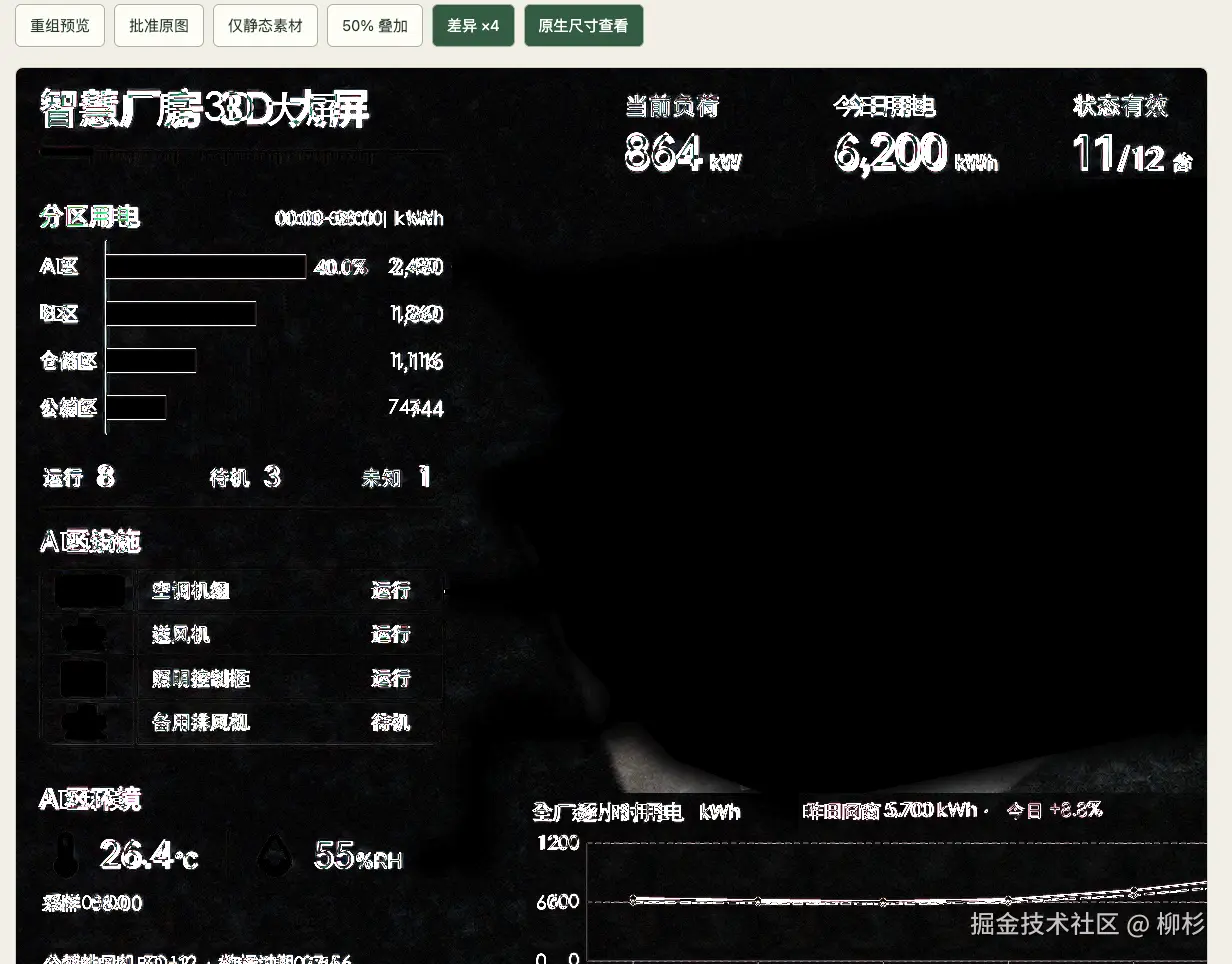
 最后把图标和文字放上去进一步精细比对,差异性做到最低。
四、三维建模,这次是真的省心了
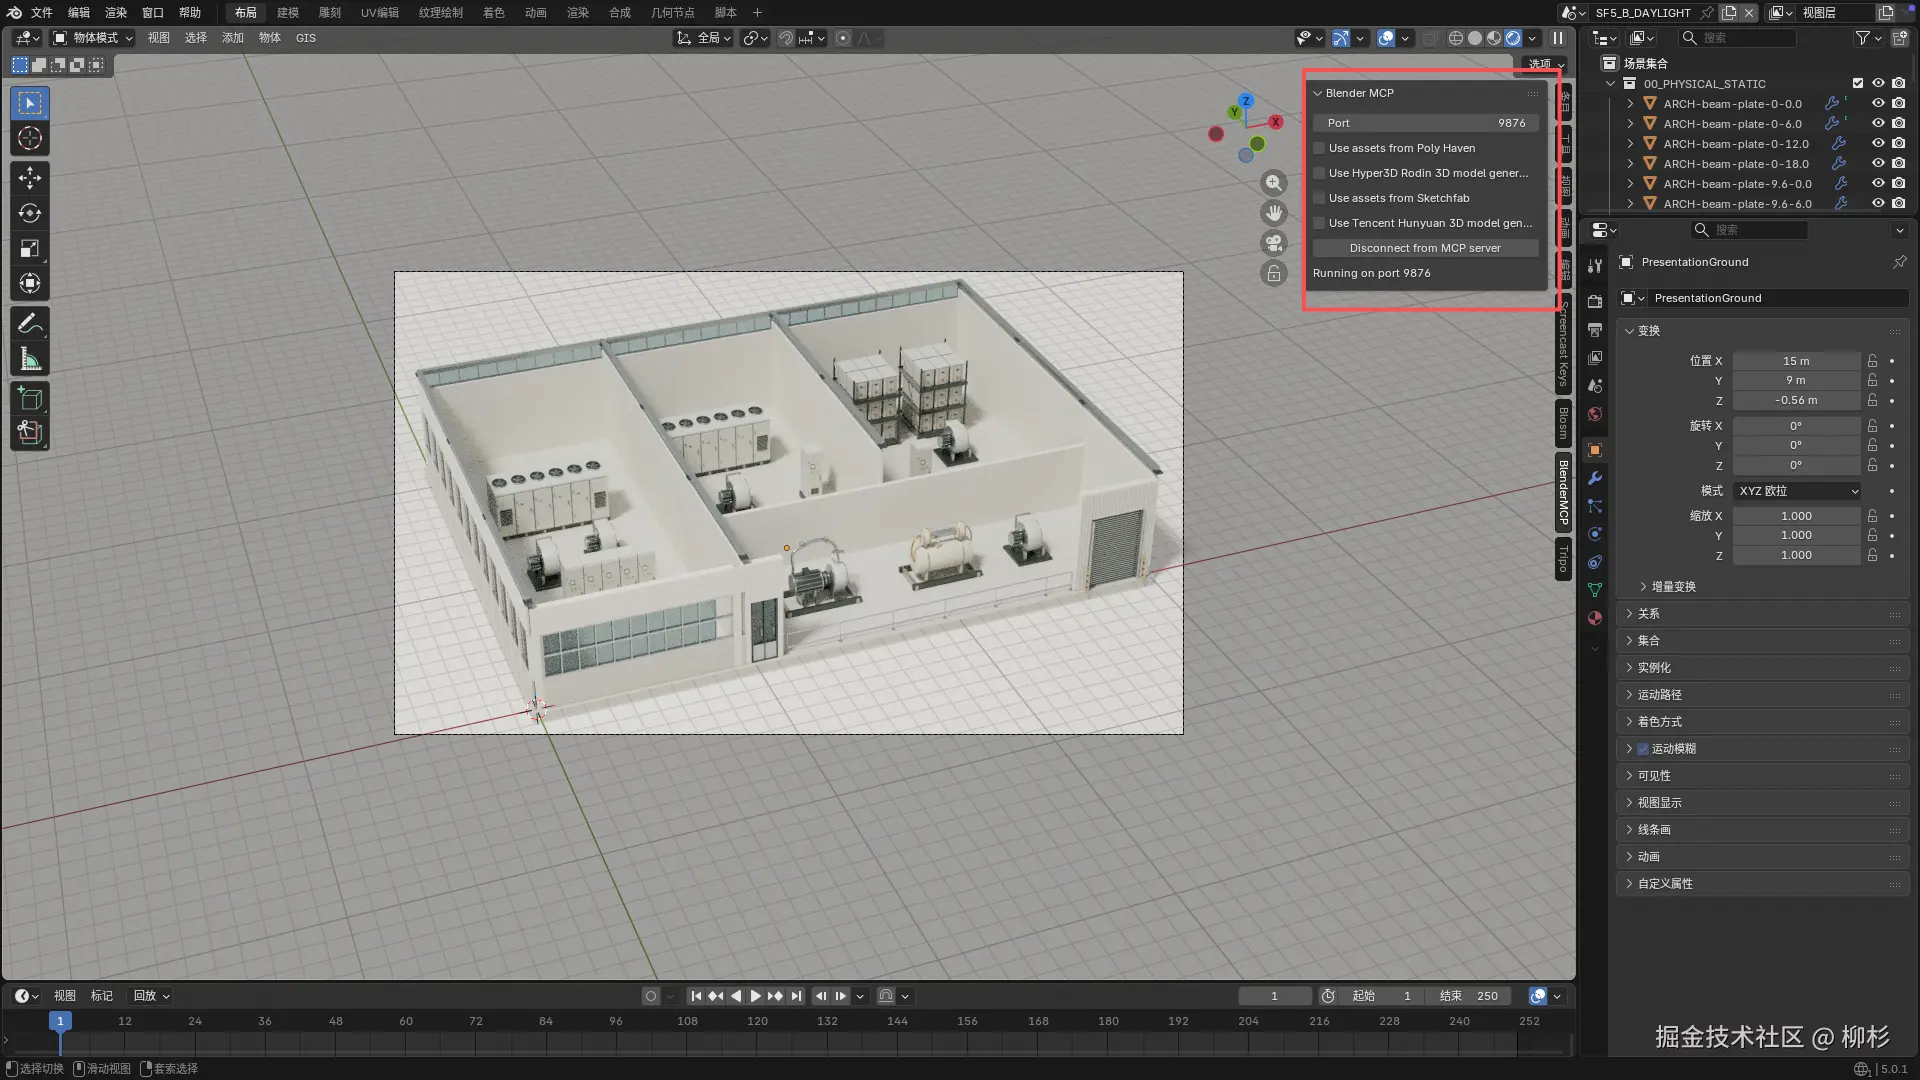
这是这次变化最大的一步。前面地图那篇文章里,三维部分是我自己在 Blender 里挤压 SVG、贴纹理、调材质,整个流程手动痕迹很重。这次厂房模型换成了通过 Blender MCP 直接连 GPT-6 Astra 来做,我这边基本只负责确认节点。
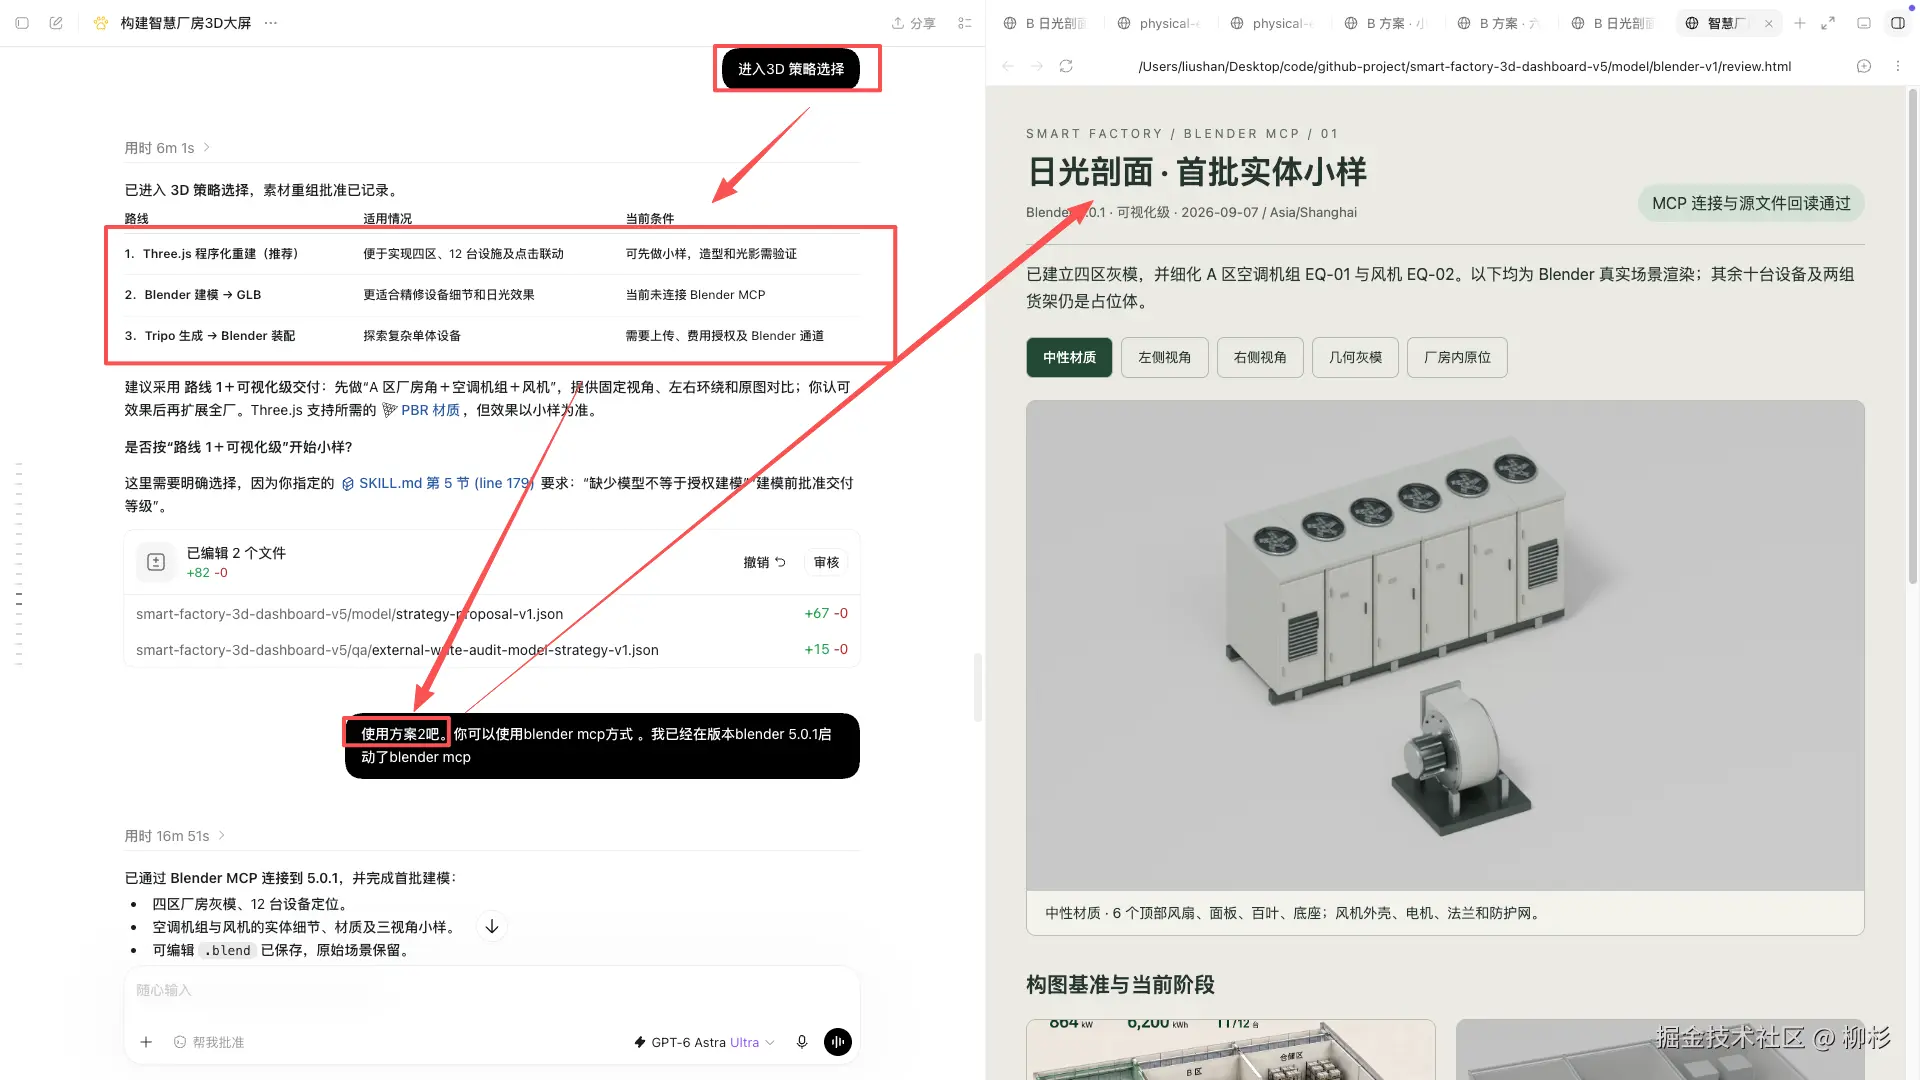
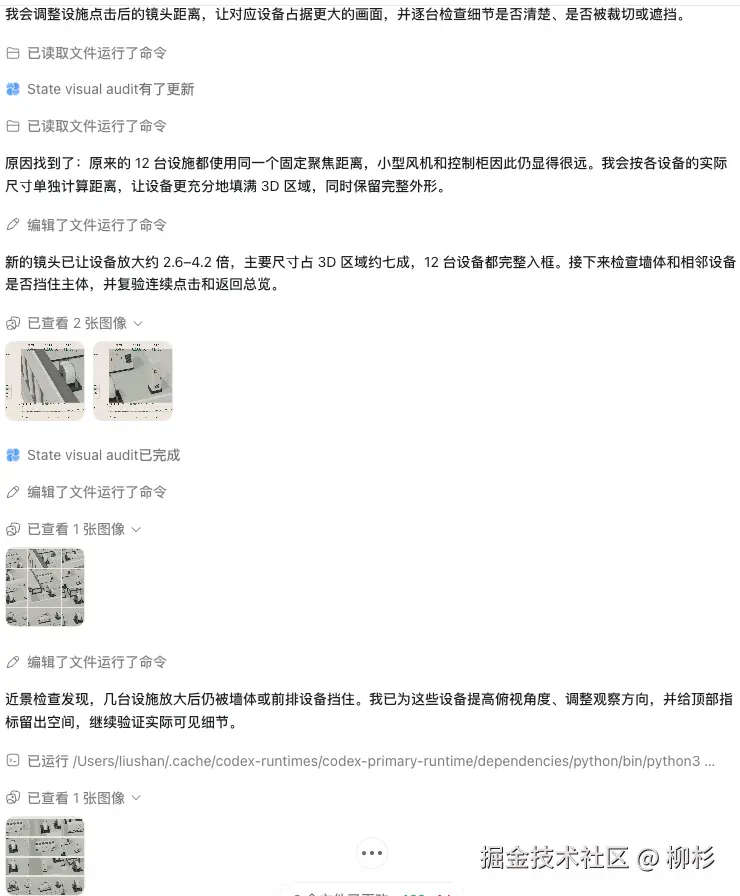
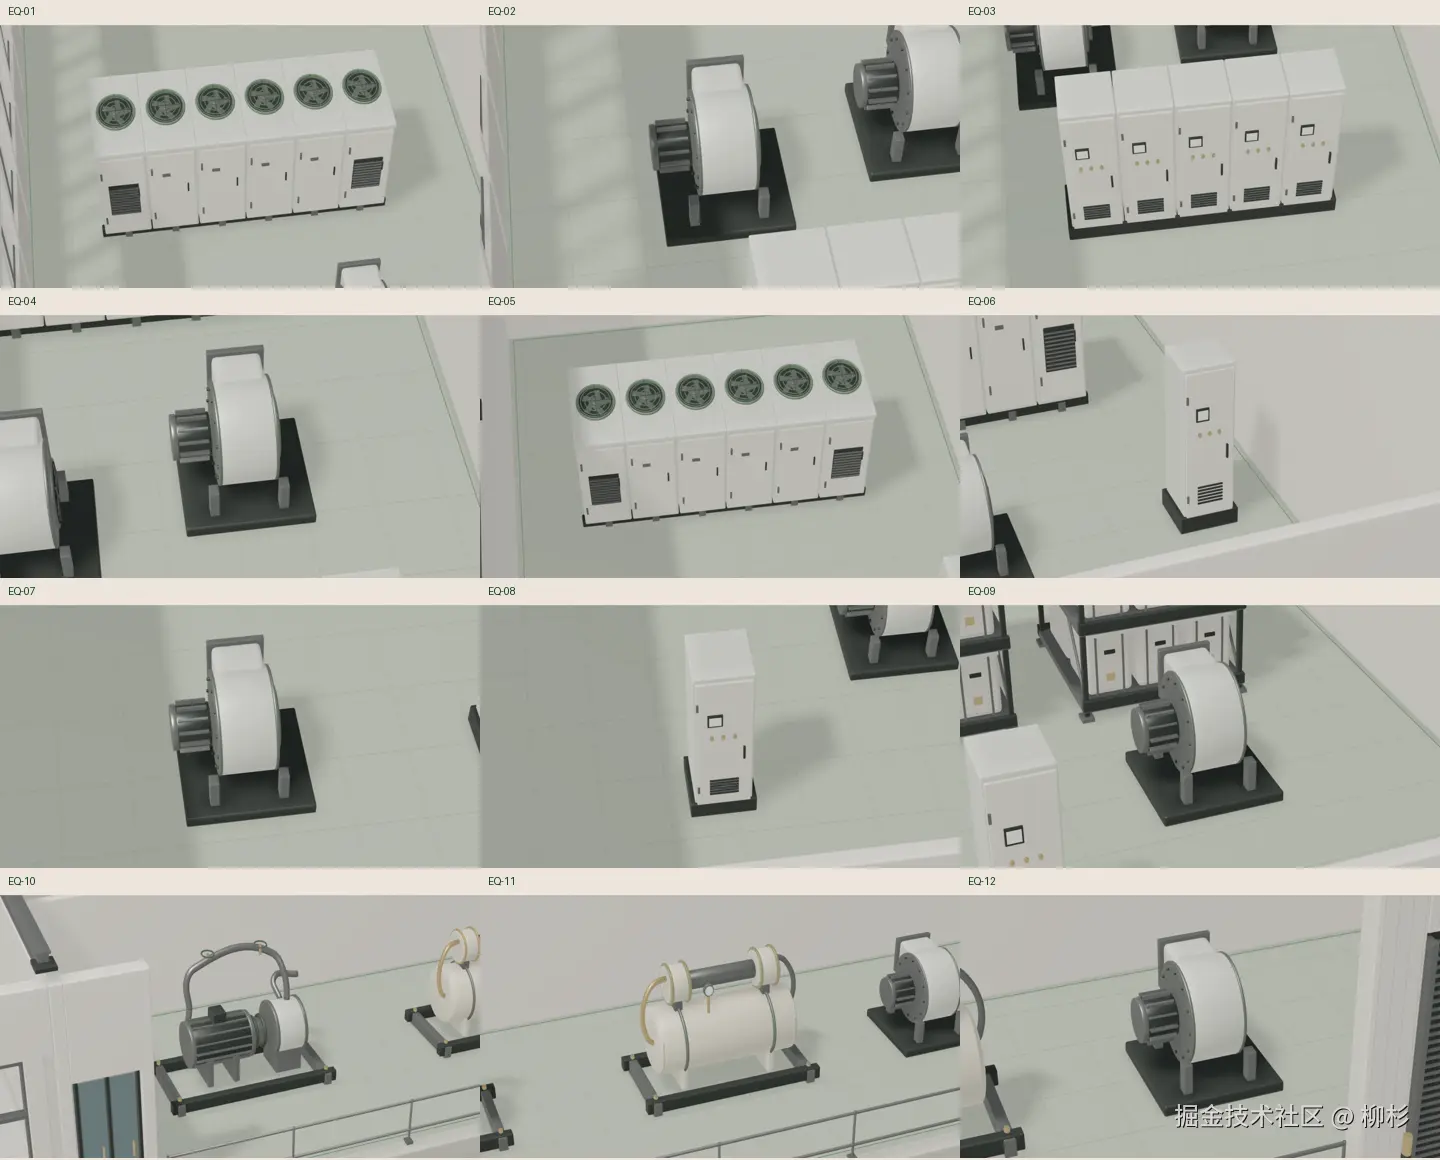
它先做了一版灰模小样:四个分区,十二台设备的位置定好,其中两台设备做了实体细化,光是这两台设备就拆成了两百多个子网格,风扇叶片、百叶、法兰、电机分别挂了不同材质。小样确认之后,剩下的十台设备、两组货架、门窗屋架和管路才铺开做完整版。
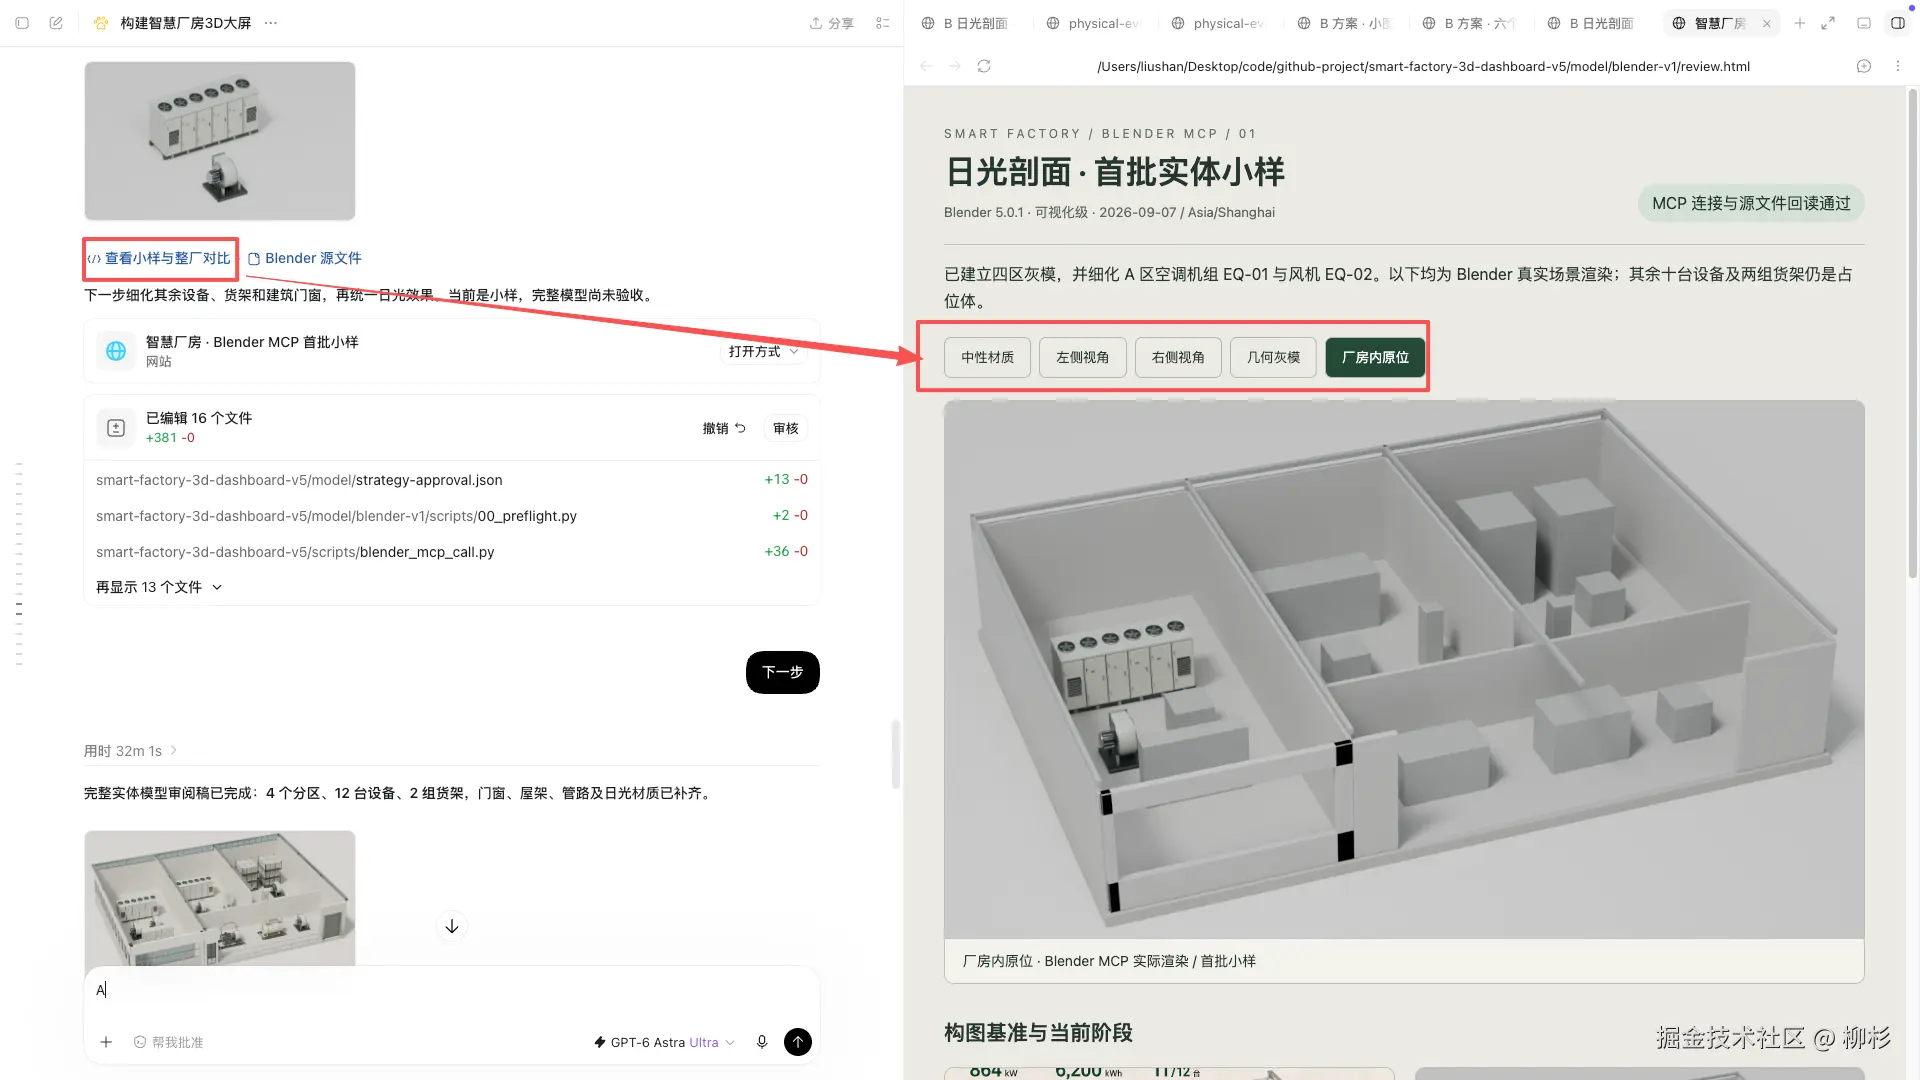
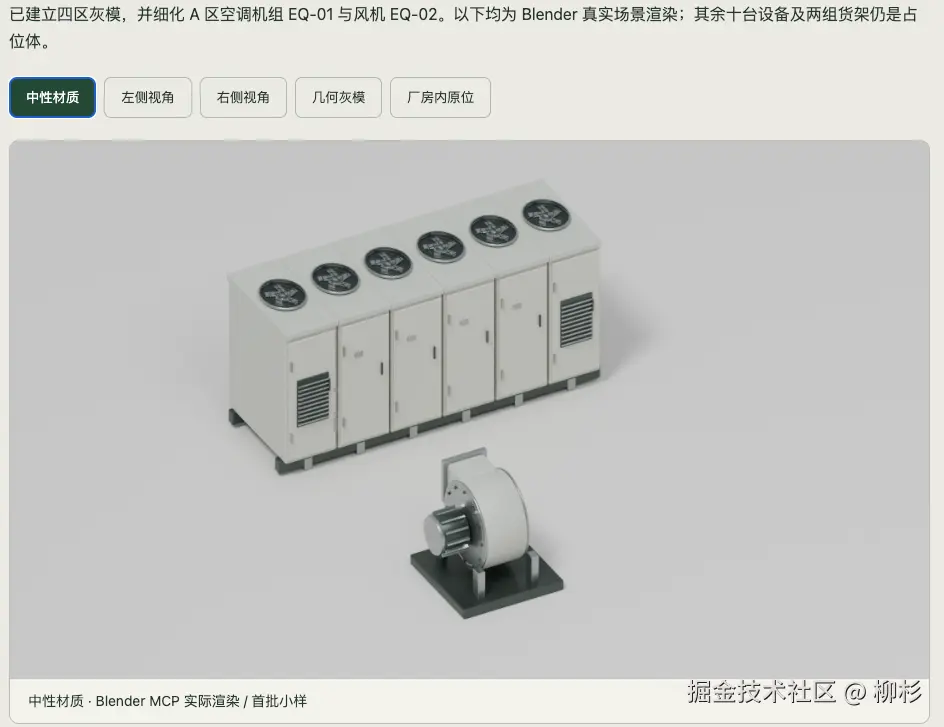
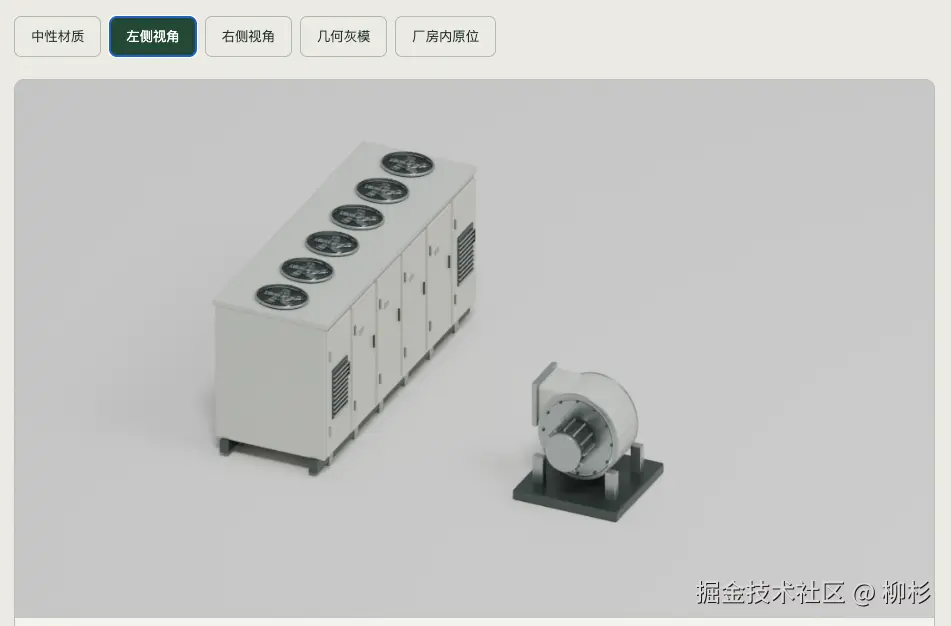
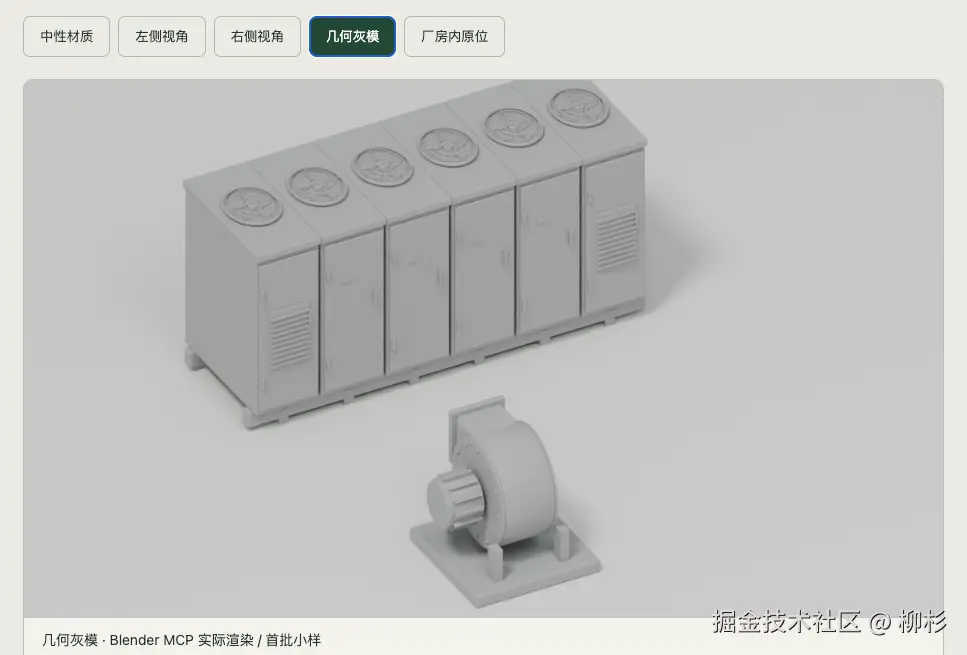
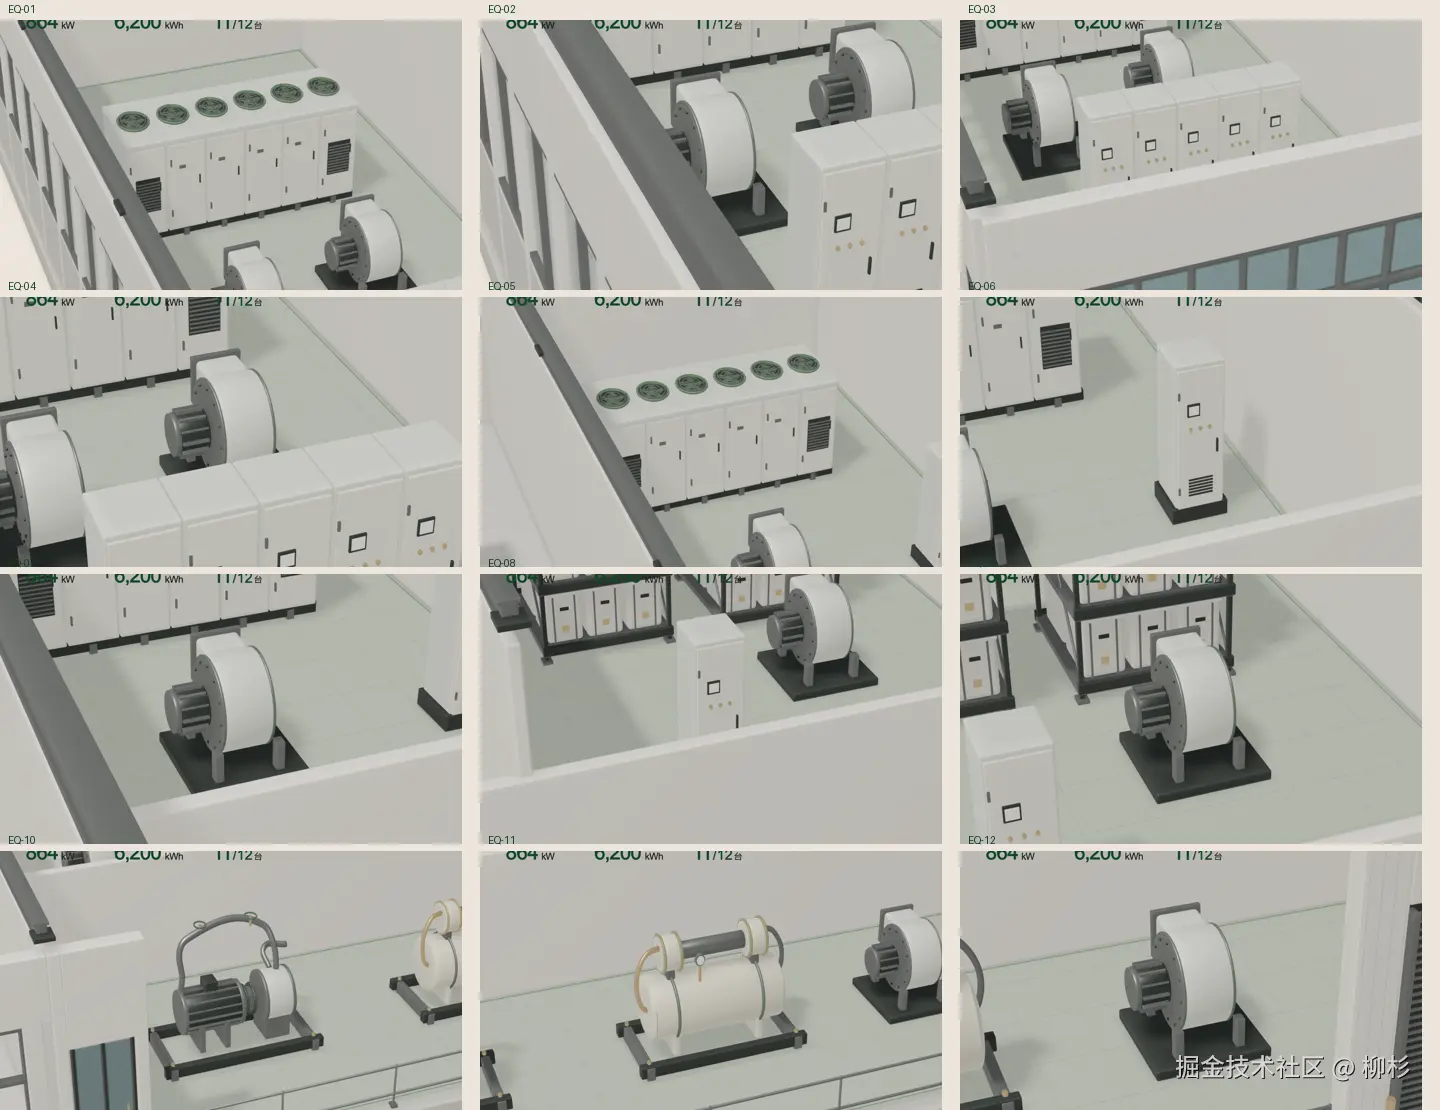
中间它自己发现并修了几个问题,比如某组设备的回管没有真正接上、压力表缺了支撑结构、还有几个由曲线转网格产生的重合顶点。这些问题是它自查出来的,不是我肉眼挑出来反馈回去的。整版模型做完之后,十四个对象逐一生成了近景渲染图,还做了一次曝光检查,统计画面里死黑和过曝的像素比例,确认都在安全范围内才算通过。
这个环节让我意外的地方不是画面好看,而是它做事的方式变了------不是生成一版就交差,而是自己列检查项、自己核对、自己说明哪些地方还没做到位。整版可编辑的 Blender 源文件统计下来接近一千六百个网格对象,四十七万多个三角面,这只是可视化模型的复杂度,不代表工业级的尺寸精度。
五、网页化和性能对齐,这一步没有捷径
模型做好只是第一半,能在浏览器里流畅跑起来是另一半。原始导出的模型有一千五百多个网格、单帧绘制调用接近三千次,直接扔进浏览器肯定卡。
优化之后网格数降到一百五十个左右,绘制调用压到二百八十次,用了 Meshopt 做无损压缩,最终 GLB 文件大概十五兆。压缩不是随便合并,业务上要保留的分区和设备节点一个没少,玻璃这类需要独立渲染的材质也没有跟着合并进不透明批次。
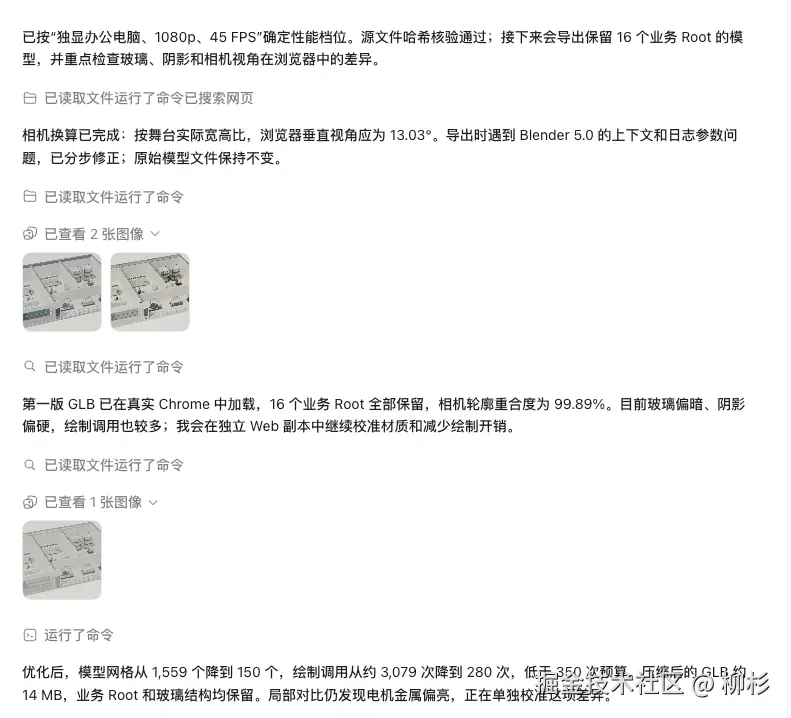
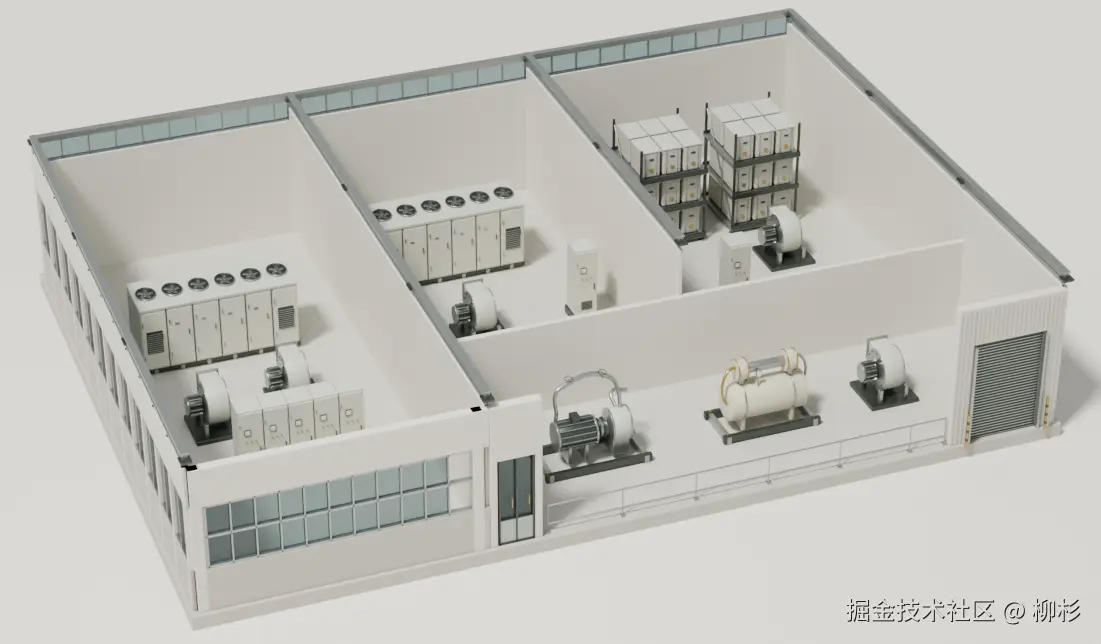
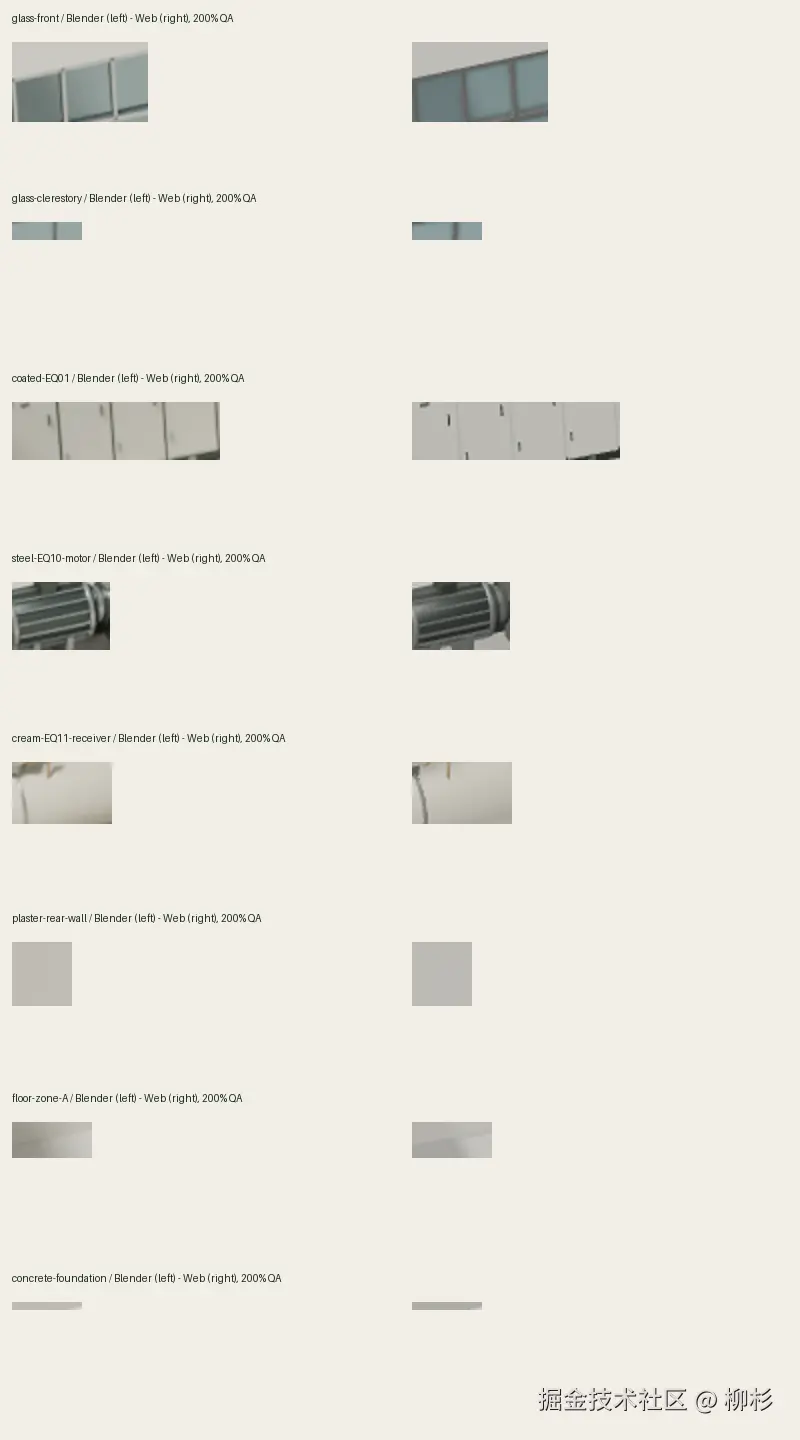
对齐环节做了几件挺细的事:轮廓和源渲染图的重合度做到了 99.89%,模型上标出的相机关键点平均误差在亚像素级别,八处材质区域的色差都控制在一个统一阈值以下。这中间还踩了一个坑------第一次做性能采样时,交互控件在页面首次加载时偷偷改了一下相机角度,导致那次 59.88 帧的成绩其实是拿偏移过的机位测的,属于无效数据。发现问题之后重新按正确机位测了一遍,本机跑出来是三十帧左右,离目标独显设备四十五帧还有距离,这一项目前如实标注为未达标,没有拿本机数据冒充最终验收。
六、交互和状态,别让界面空有其表
厂房大屏最终要支持点分区、点设备定位、Esc 返回总览这些交互,这部分逻辑不复杂,但状态处理是容易偷懒的地方。
这次明确定义了六种数据状态:加载中、空、过期、离线、出错、无权限,每一种都要求界面给出对应的提示,而不是統一显示成一个笼统的失败态。比如某台设备状态过期,页面上会显示最后一次采样时间加一个"数据过期"的标签,而不是直接把它标红当成故障处理,因为过期和故障是两回事,不能靠界面误导判断。类似地,如果模型加载失败,页面要给出明确的降级提示,不能留一个看起来能点但其实没反应的空白画布。
这部分做了十七项状态断言和一批真实浏览器里的点击测试,包括快速连续点击、键盘 Esc、还有加载中途切换分区这些边界情况。
七、用 Scaffold 把最后一段接起来
前端这边沿用了我之前发布的 npm 包 @lius1314/visual-dashboard-scaffold,用 JSON 配置驱动整个页面结构,三维场景走 R3F,图表走 ECharts,两者通过同一套选中状态联动。
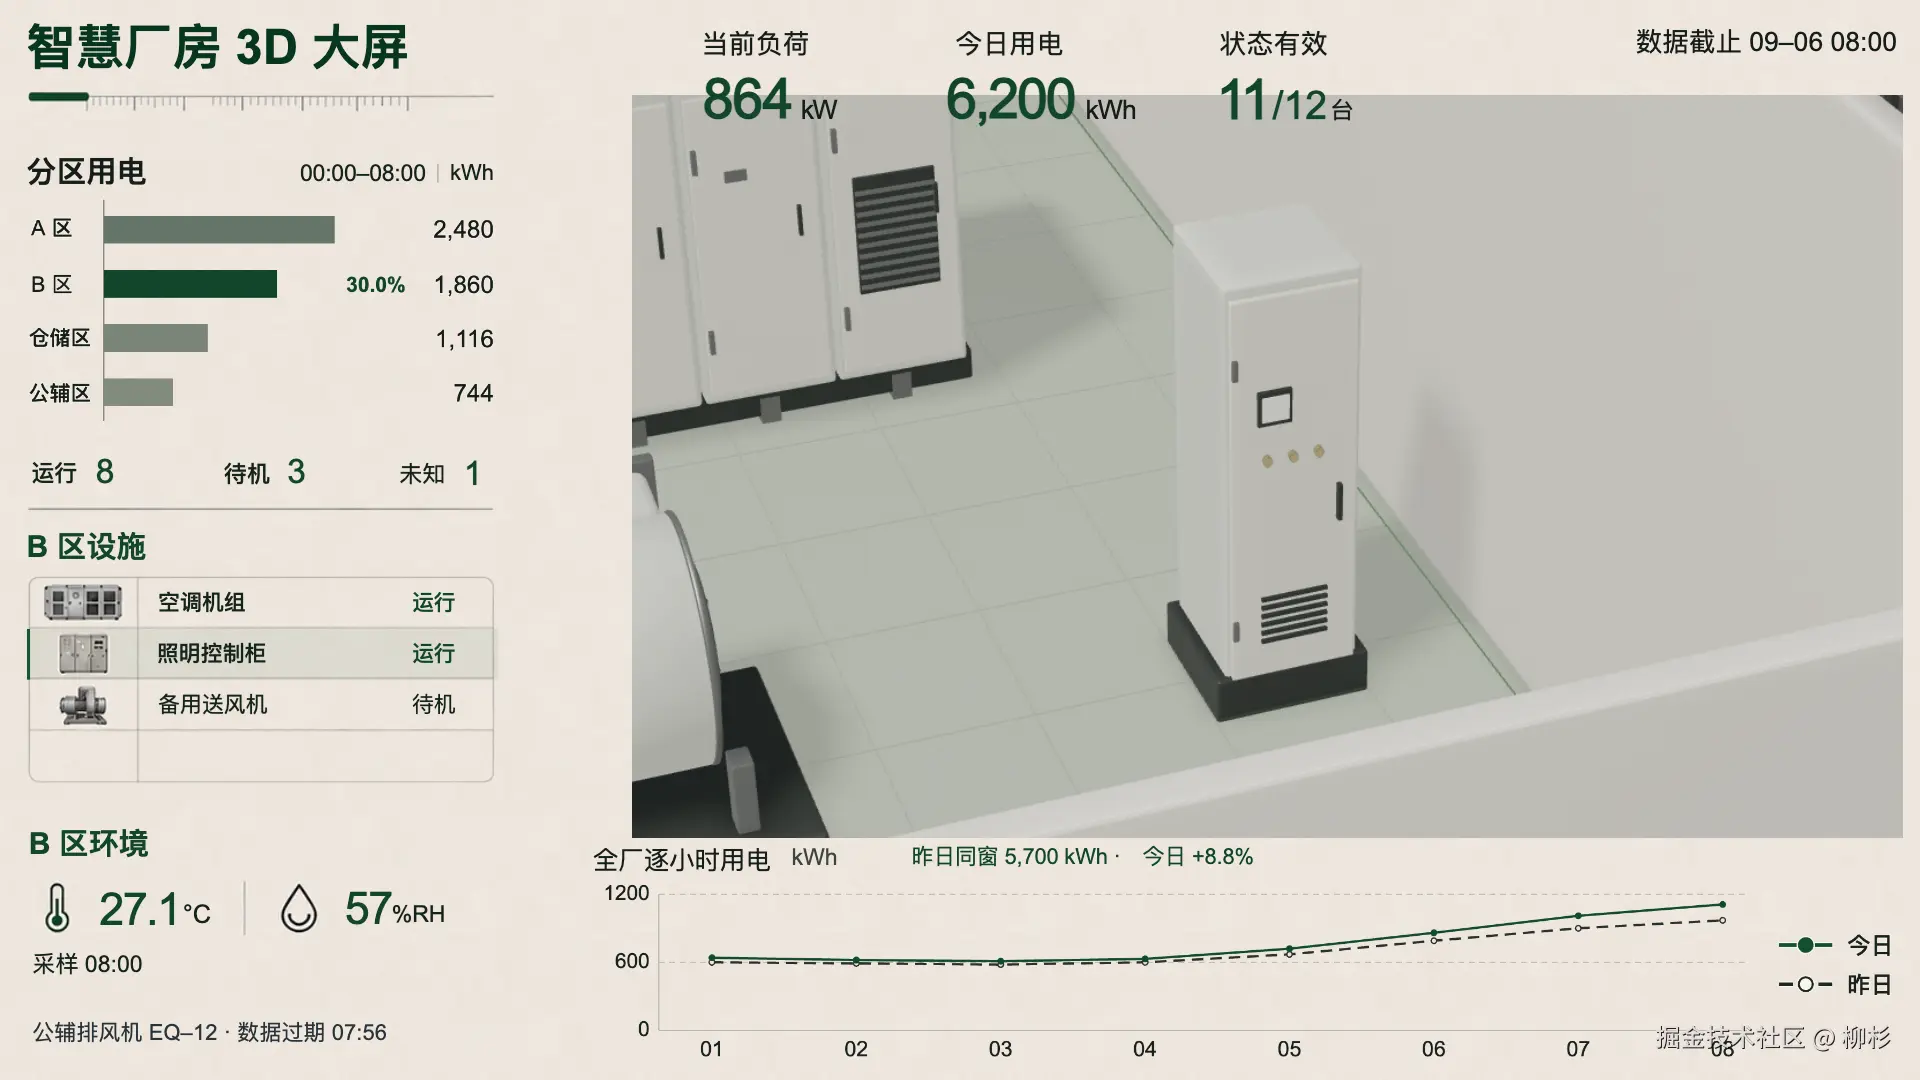
这一步做完之后,第一条完整的业务链路算是跑通了:点击分区柱状图,三维场景里对应的分区高亮定位,设备明细和环境读数跟着切换;点未知状态的设备,能直接在模型里找到它的位置。全厂口径的指标不会因为选中了某个分区就变成局部数据,这个边界在前面 Brief 阶段就定好了,实现的时候直接照做,没有再临时讨论。
八、最后一步,逐像素校准,也最容易翻车
代码跑起来只是及格线,跟设计稿的还原度才是最后一道关。这一步是把运行时截图和冻结的设计原图按同一个位置逐项比对,总共 116 项,最新一轮的结果是 74 项通过、42 项还有差异,主要集中在字体渲染、图表线条和中央模型的材质风格上。
这里我想说清楚一点:这一轮没有为了好看的通过率去放宽标准,也没有把局部通过说成整屏通过。42 项没过的地方原样保留在记录里,包括哪几个字号、哪几条描边和源图对不上。这跟之前几篇文章的态度是一致的------能做到的地方讲清楚做到了什么程度,做不到的地方也不藏着。
九、这次到底变了什么
回头看,这条链路里生图这一环变化没有想象中大,GPT-Image-2.5 出图更稳,返工次数少了,但性质上还是我需要多轮确认的工具。真正让我觉得质变的是三维建模这一环------以前这一步完全靠我自己在 Blender 里手动操作,这次交给 GPT-6 Astra 通过 Blender MCP 直接完成,而且它自己会发现结构性错误并修正,还会主动做曝光和轮廓检查,不是简单地生成一版就完事。
当然这条链路目前还有几处没有打勾:目标独显设备的四十五帧性能还没实测,整屏视觉保真还没有连续两轮完整通过,真实生产数据接口现在也还是 MOCK。这些我都如实留在项目记录里,没有因为整体链路跑通了就把细节问题一笔带过。
下一步准备把这套流程套到另一个场景上验证一遍,看看这次的经验是不是真的能复用,而不是只在这一个项目上凑巧顺利。
预览地址(不是最新,以代码为主):liush.top/factory
源码我已经放在公众号(柳杉前端)同名文章底部了 ,如果你需要的话可以去获取呀。