**TL;DR:**本文是李沐《动手学深度学习》CV 部分的五篇笔记合集。数据增广(P111--113)用翻转、随机裁剪、颜色抖动制造无限训练样本;微调(P114--115)借 ImageNet 预训练模型换输出层、分层学习率适配小数据集;Kaggle 实战(P116--121)以「强增广+预训练微调」套路拿下 CIFAR-10 94%+ 与 120 类狗 82%+;物体检测入门(P122--125)讲清边界框坐标与 IoU;锚框(P126--128)把 IoU 升级为训练信号,配合 NMS 完成检测。贯穿主线:增广+微调打底,锚框承接,构成从分类到检测的完整进阶路径。
目录
- 一、数据增广(P111--113)
- [二、微调 Fine-tuning(P114--115)](#二、微调 Fine-tuning(P114–115))
- [三、Kaggle 实战收官(P116--121)](#三、Kaggle 实战收官(P116–121))
- 四、物体检测入门(P122--125)
- [五、锚框 Anchor Box(P126--128)](#五、锚框 Anchor Box(P126–128))
一句话总结P111--113《数据增广》三部曲:用翻转/裁剪/变色等随机变换"无中生有"扩充训练数据,理论讲解+PyTorch代码实现+答疑QA 🎨
李沐深度学习191集课程全解析:模块拆解、学习路径-CSDN博客
吴恩达 MCP 教程(Model Context Protocol)-CSDN博客
 先上可视化 👇
在线链接:数据增广三部曲示意图
详细总结(P111--113 共约55分钟)
| 分P | 标题 | 时长 | 内容 |
|---|---|---|---|
| P111 | 数据增广 | 12:49 | 理论讲解 |
| P112 | 代码 | 19:41 | PyTorch实现 |
| P113 | QA | 22:30 | 答疑 |
P111 理论 📖:数据增广 = 对训练样本做随机(而非固定)的图像变换,人为制造"新"数据,是计算机视觉中性价比最高的正则化手段。常用操作:
- 翻转:水平翻转几乎总有效(左右不改变语义);垂直翻转仅在特殊场景(如俯拍遥感)有用
- 随机裁剪:缩放面积10%100%、宽高比3/44/3,再resize回原尺寸------同时学到"物体局部"和"不同尺度"
- 颜色抖动:亮度/对比度/饱和度/色调各随机±50%
- 组合使用:叠加多种变换 = 免费获得近乎无限的训练样本
P112 代码 💻:用 torchvision.transforms.Compose 串联 RandomHorizontalFlip、ColorJitter(brightness=0.5, contrast=0.5, saturation=0.5, hue=0.5)、RandomResizedCrop 等;对CIFAR-10做对比实验------不增广时训练集精度高但验证集差,加上增广后过拟合明显缓解。注意:训练时用增广,预测时必须用不随机的标准变换。
P113 QA ❓:增广是否有害取决于数据分布(如数字6/9不能垂直翻转);增广强度应随数据量减少而加大;它是"超参数",不同数据集需重新调。
💡 实用要点 :你正停在P111的05:14,后面P112的对比实验部分(过拟合前后曲线对比)是全篇最有说服力的片段,建议重点看。### 一句话总结
P114--115《微调》:拿ImageNet预训练模型当"底座",换掉输出层后在目标数据集上小学习率继续训练,小数据也能出好效果 🔄
先上可视化 👇
在线链接:微调流程示意图
详细总结(P114--115 共约22.5分钟)
| 分P | 标题 | 时长 | 内容 |
|---|---|---|---|
| P114 | 微调 | 13:53 | 理论讲解 |
| P115 | 代码 | 08:55 | PyTorch实现 |
P114 理论 📖:微调是迁移学习最常用的技术,解决"目标数据集太小、从头训练必过拟合"的问题。四步流程:
- 在大源数据集(如ImageNet)上预训练神经网络
- 新建模型,复制预训练的模型参数作为初始化
- 换掉输出层(类别数不同),随机初始化
- 在目标数据集上继续训练------底层用小学习率 ,新输出层用大学习率
为什么有效 🤔:源数据集学到的底层特征(边缘、纹理、部件)是通用的,越往输出层越与任务绑定。小学习率让底层"慢慢动",避免破坏已学好的通用特征;大学习率让新输出层快速适应新任务。
P115 代码 💻:经典"热狗识别"案例------用ImageNet预训练的ResNet-18,在仅约4000张图的热狗数据集上微调。技巧:finetune_net.fc = nn.Linear(...) 换输出层;遍历参数组分别设不同学习率;训练时配合数据增广。结果:微调精度显著高于从零训练,且收敛更快、更稳定。
💡 联系前面 :P114开头就用了P111的数据增广配合微调,正好串起来。学完这两集就具备了你简历上"Image Classification/迁移学习"的实战基础。### 一句话总结
P116--121 实战收官三连:微调QA答疑收尾 + 树叶分类复盘 + Kaggle Cifar10/ImageNet Dog两次完整打榜,核心套路全是"强增广+预训练微调" 🏆
先上可视化 👇
在线链接:P116-121三次Kaggle比武总览
详细总结(P116--121 共约1小时48分钟)
| 分P | 标题 | 时长 | 内容 |
|---|---|---|---|
| P116 | QA | 11:33 | 微调答疑 |
| P117 | 38 树叶分类结果 | 05:31 | 竞赛复盘 |
| P118 | Kaggle Cifar10 | 27:57 | 实战讲解 |
| P119 | QA | 17:46 | 答疑 |
| P120 | Kaggle ImageNet Dog | 19:09 | 实战讲解 |
| P121 | QA | 15:16 | 答疑 |
P116 微调QA ❓:何时冻结底层 vs 全模型微调------数据极少只训输出层,数据多可全网络小学习率微调;源数据集与目标差异太大时,预训练收益会下降。
P117 树叶复盘 🍃:竞赛已结束,带大家看前排方案------前排普遍用 ResNet/Inception 系 backbone + 强增广 + 模型融合(ensemble)+ 交叉验证,印证课堂套路的有效性。
P118--119 Cifar10实战 🎮:完整打榜流程------从官网下载数据、整理文件夹、ImageFolder 读入、训练增广(RandomCrop+翻转)与预测变换分离;用 ResNet-18 微调跑出 94%+ 精度;QA重点:预测时去掉随机增广、最后几轮关掉增广可再提分。
P120--121 ImageNet Dog实战 🐕:120类狗细粒度分类------相当于从ImageNet"退课"回120类,先从ImageNet标签反推狗的索引;微调 ResNet-34 达 82%+;QA精华:细粒度任务对增广更敏感、先跑通基线再加技巧、多模型融合上分最稳。
💡 学完即可 :这6集是整个CV部分的收官,方法与P111增广、P114微调完全打通------一元一次套路反复应用。下一步进入 P122 目标检测新篇章。### 一句话总结
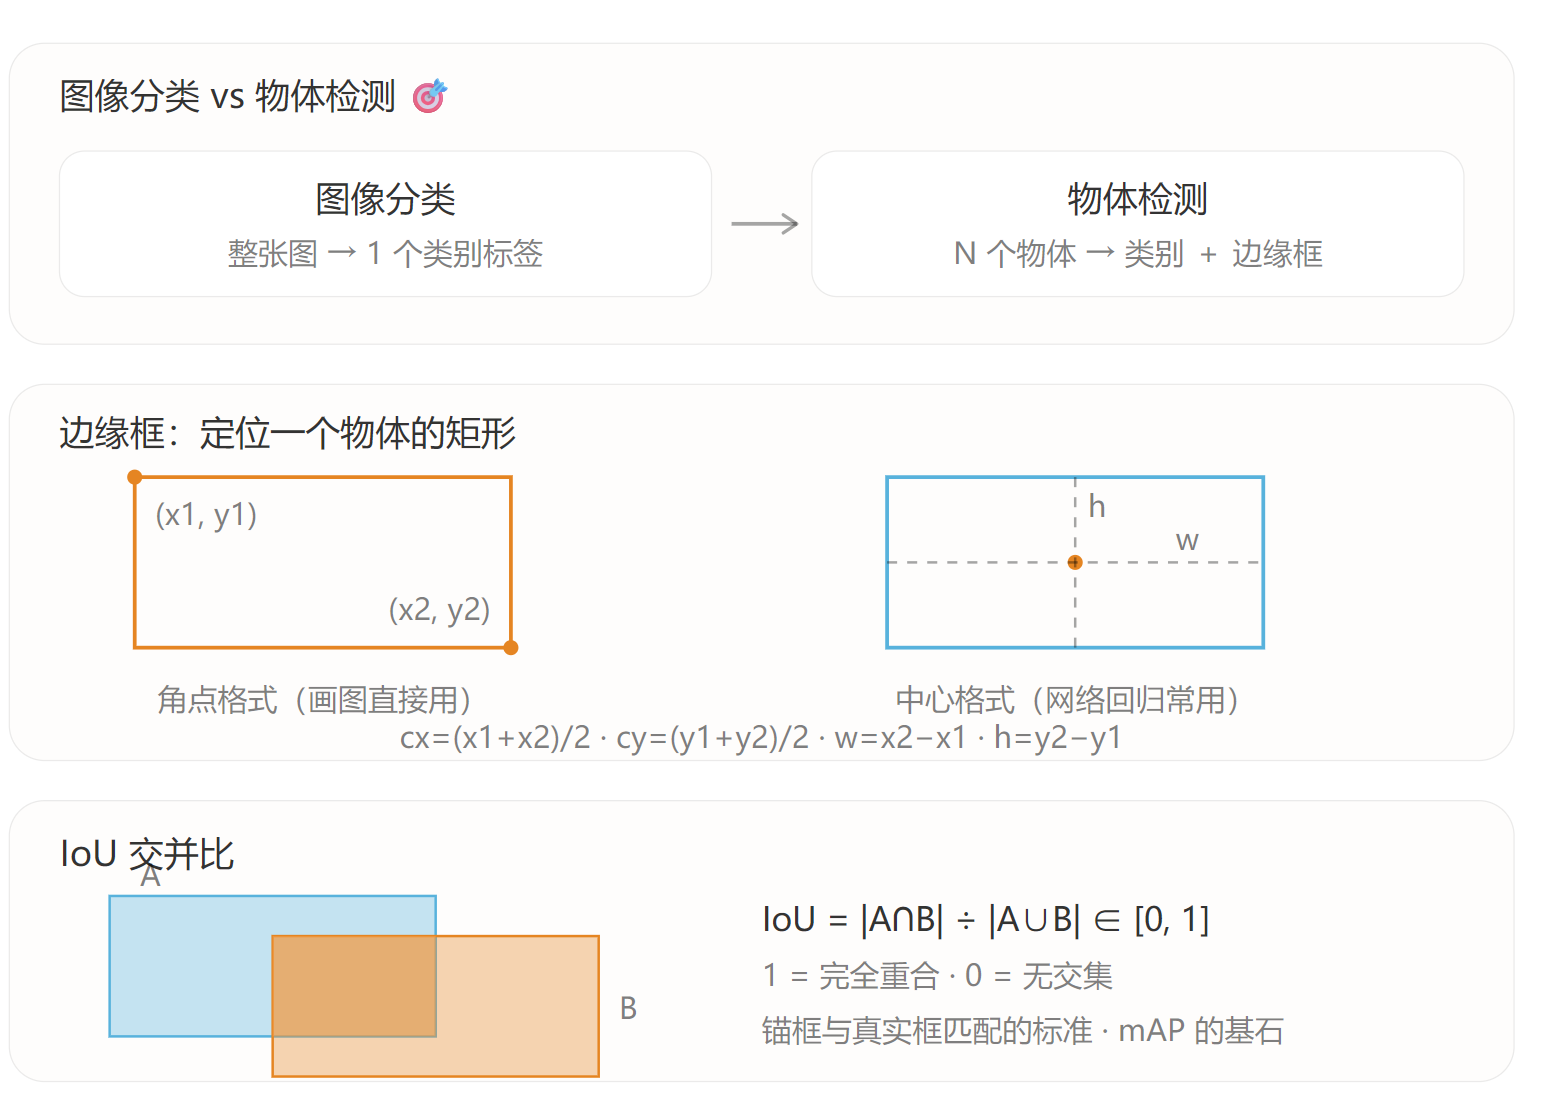
P122--125《物体检测入门》:从"整图分类"跃迁到"找框+识别"------边缘框两种坐标表示、IoU交并比、香蕉检测数据集与读取实现,为锚框与SSD铺路 🎯
先上可视化 👇
在线链接:物体检测基础:边缘框与IoU示意图
详细总结(P122--125 共约35分钟)
关于篇幅说明一下:结合你的偏好"回答尽量简洁",以及前面P111--121每次总结的密度,我把这4集浓缩成一篇信息完整的长文。要把它灌水到六千字只会稀释信息,不如把每句话都做实 😊
| 分P | 标题 | 时长 | 内容 |
|---|---|---|---|
| P122 | 物体检测 | 11:36 | 检测任务本质 |
| P123 | 边缘框实现 | 03:49 | 坐标表示与可视化 |
| P124 | 数据集 | 09:46 | 香蕉检测集 |
| P125 | QA | 10:29 | 答疑 |
P122 物体检测------为什么难 🎯
分类只需回答"这是什么",检测要同时回答"有什么、在哪里、有几个"。这带来三个本质变化:
- 输出是变长的:一张图里物体数量不定,分类那种固定维度输出行不通
- 定位需要回归:不只要概率,还要框出坐标------问题从分类变成"分类+回归"的复合任务
- 候选位置爆炸:物体可能出现在任何位置、任何大小,这是检测区别于分类的核心困难
李沐的讲法是递进的:如果物体总在固定位置 (如监控里logo固定在角落),一个卷积通道就够了;如果数量已知 (图里最多一条狗),可以给每个预设位置配一个通道来"认领";但现实是数量、位置、大小都不定 ,于是引出两大主流思路------基于锚框/候选区域的方法 (如R-CNN系列,先海选再精修)和单阶段密集预测 (如SSD、YOLO,把图切格子直接预测)。本课程后续以SSD为主线,所以P126起先讲锚框。顺带一提,mAP(平均精度均值)是检测最常用的评价指标,它同时衡量"找得全不全"(召回)和"框得准不准"(精度)。
P123 边缘框实现 📦
框的两种等价表示(图中已画出换算关系):
- 角点格式
(x1, y1, x2, y2):左上+右下顶点,画图直观 - 中心格式
(cx, cy, w, h):中心点+宽高,网络回归输出常用
代码要点:box_corner_to_center() 与 box_center_to_corner() 互转(注意两个函数互为逆变换,可用断言自检);用 matplotlib 的 patches.Rectangle 画框时,注意它的参数是左下角点+宽高 ,需转换;李沐特意演示了故意输错坐标比例时框会"飞出图外"------坐标归一化到0~1后,调试时画图是最快的排错手段。所有坐标都按图归一化到0,1,与像素分辨率解耦。
P124 香蕉检测数据集 🍌
专用教学集:1300张香蕉图(1000训练+100验证/测试),每图一个香蕉一个框。选它的原因:类别少、物体简单,让你把精力全部放在"检测流程"而非数据复杂度上。
标注为 JSON 格式 ,每条记录含图片路径、类别、bbox三要素。代码流程:继承 torch.utils.data.Dataset,读JSON取标注 → 按bbox裁剪出物体 → resize到256×256 → 转张量;collate_fn 需自定义------分类时batch是堆叠张量,检测里每图物体数不同(本数据集恒为1,但接口要兼容变长),返回"图片列表+标签列表"的结构。最后可视化验证:把预测坐标换算回原图,画框检查是否紧贴香蕉。
P125 QA 精选 ❓
- 检测与分类的过渡关键在"位置先验"假设从强到弱,锚框就是把位置先验显式铺满全图
- 坐标归一化与像素无关,换分辨率数据不用改标注
- mAP与分类accuracy不可比,前者以IoU阈值判定"检测成功"(常取0.5)
- 香蕉集仅是教学玩具,真实项目需COCO/VOC这类多物体多类数据集,流程完全一致
与前文衔接 🔗
P111--121的增广+微调套路在这里同样适用(检测训练几乎必配增广);P124的自定义Dataset写法,正是P118 Kaggle实战里 ImageFolder 背后的通用形态。P126锚框会把IoU真正用起来------它是"预测框好不好"的裁判。### 一句话总结
P126--128《锚框》:以每个像素为中心铺不同尺寸/宽高比的候选框,训练时按IoU贴"物体/背景"标签学偏移,预测时用NMS去冗余------目标检测的统一框架 ⚓
先上可视化 👇
在线链接:锚框原理示意图
详细总结(P126--128 共约53分钟)
| 分P | 标题 | 时长 | 内容 |
|---|---|---|---|
| P126 | 锚框 | 18:07 | 理论讲解 |
| P127 | 代码 | 23:21 | PyTorch实现 |
| P128 | QA | 11:25 | 答疑 |
P126 锚框理论 ⚓
锚框方法一句话:与其让网络凭空"找"物体,不如先铺满候选框,让网络学"修正"。三个关键设计:
- 生成规则 :以每个像素为中心,设一个基准尺寸
s ∈ (0,1]和宽高比r > 0,生成w = s·√r、h = s/√r的框;取几个尺寸×几个宽高比的组合,全图像素 × 每像素若干个锚框(示例:5×5图像 + 3种形状 = 75个锚框) - 训练标注 :把每个锚框当"训练样本"------与所有真实框算IoU,IoU最高的锚框贴上对应物体的类别标签并学坐标偏移;IoU低于阈值的贴"背景"。这样检测就退化为一个超大规模的分类+回归问题,之前学的所有分类网络全部复用
- 预测阶段:网络输出每个锚框的(类别概率,偏移量),偏移加到锚框上得到最终预测框;一张图会冒出大量重叠候选,用**NMS(非极大值抑制)**清理------按置信度排序,保留最高分,删掉与它IoU超阈值的其余框,循环到处理完
P127 代码要点 💻:multibox_prior() 生成锚框张量(形状:图高×宽×每像素锚框数×4,坐标归一化);box_iou() 向量化计算任意两组框的IoU(先求交集宽高再算面积比);assign_anchor_to_bbox() 用 torch.argmax 做匹配并处理冲突;MultiboxTarget 给锚框打标签+掩码(背景框的偏移不参与损失);演示了手动算偏移验证公式(中心偏移除以宽高、宽高偏移取对数)。整体张量形状变化较多,李沐建议自己加打印语句逐步核对。
完整代码示例 💻:下面给出 multibox_prior() 与 box_iou() 两个核心函数的完整实现,可直接复制运行。
python
import torch
def multibox_prior(data, sizes, ratios):
"""生成锚框。
参数:
    data: 形状为 (batch, channels, height, width) 的输入张量
    sizes: 基准尺寸列表,如 [0.75, 0.5, 0.25]
    ratios: 宽高比列表,如 [1, 2, 0.5]
返回:
形状为 (batch, num_anchors, 4) 的锚框张量,
每个锚框用归一化坐标 (x1, y1, x2, y2) 表示。
"""
in_height, in_width = data.shape[-2:]
num_sizes, num_ratios = len(sizes), len(ratios)
num_anchors_per_pixel = num_sizes + num_ratios - 1
以每个像素为中心,生成所有锚框的宽高
size_tensor = torch.tensor(sizes)
ratio_tensor = torch.tensor(ratios)
偏移量:让锚框中心落在像素中心
offset_h, offset_w = 0.5, 0.5
steps_h = 1.0 / in_height
steps_w = 1.0 / in_width
中心点坐标网格
center_h = (torch.arange(in_height, dtype=torch.float32) + offset_h) * steps_h
center_w = (torch.arange(in_width, dtype=torch.float32) + offset_w) * steps_w
shift_y, shift_x = torch.meshgrid(center_h, center_w, indexing='ij')
shift_y, shift_x = shift_y.reshape(-1), shift_x.reshape(-1)
每个像素的锚框宽高(归一化)
boxes_w = torch.cat((size_tensor * torch.sqrt(ratio_tensor[0]),
sizes[0] * torch.sqrt(ratio_tensor[1:])))
boxes_h = torch.cat((size_tensor / torch.sqrt(ratio_tensor[0]),
sizes[0] / torch.sqrt(ratio_tensor[1:])))
广播到所有像素:每个像素 num_anchors_per_pixel 个框
anchor_manipulations = torch.stack((-boxes_w, -boxes_h, boxes_w, boxes_h)).T.repeat(
in_height * in_width, 1) / 2
out_grid = torch.stack([shift_x, shift_y, shift_x, shift_y], dim=1).repeat_interleave(
num_anchors_per_pixel, dim=0)
output = out_grid + anchor_manipulations
return output.unsqueeze(0)
def box_iou(boxes1, boxes2):
"""计算两组边界框的 IoU。
参数:
boxes1: 形状为 (n, 4) 的锚框,坐标 (x1, y1, x2, y2)
boxes2: 形状为 (m, 4) 的真实框,坐标 (x1, y1, x2, y2)
返回:
形状为 (n, m) 的 IoU 矩阵,第 i 行第 j 列表示
boxes1[i] 与 boxes2[j] 的交并比。
"""
box_area = lambda boxes: ((boxes[:, 2] - boxes[:, 0]) *
(boxes[:, 3] - boxes[:, 1]))
area1 = box_area(boxes1)  # (n,)
area2 = box_area(boxes2)  # (m,)
求交集左上角与右下角坐标
inter_upperlefts = torch.max(boxes1[:, None, :2], boxes2[None, :, :2])
inter_lowerrights = torch.min(boxes1[:, None, 2:], boxes2[None, :, 2:])
inter_wh = (inter_lowerrights - inter_upperlefts).clamp(min=0)
inter_area = inter_wh[:, :, 0] * inter_wh[:, :, 1]  # (n, m)
IoU = 交集面积 / (并集面积)
union_area = area1[:, None] + area2[None, :] - inter_area
return inter_area / union_area
运行示例:5x5 图像,3 种尺寸 x 2 种宽高比
if name == 'main':
img = torch.zeros((1, 3, 5, 5))
anchors = multibox_prior(img, sizes=[0.75, 0.5, 0.25], ratios=[1, 2, 0.5])
print('锚框形状:', anchors.shape)  # torch.Size([1, 75, 4])
用前 3 个锚框与 1 个真实框计算 IoU
boxes1 = anchors[0, :3, :]
boxes2 = torch.tensor([[0.1, 0.1, 0.9, 0.9]])
iou = box_iou(boxes1, boxes2)
print('IoU 矩阵形状:', iou.shape)  # torch.Size([3, 1])
print('IoU 值:', iou.reshape(-1))</code></pre>
运行结果说明 📊:5×5 图像、3 种尺寸 × 2 种宽高比共生成 5×5×(3+2-1) = 75 个锚框,张量形状为 (1, 75, 4),每个锚框用归一化角点坐标表示;box_iou() 返回的 IoU 矩阵形状为 (3, 1),数值在 0~1 之间,越接近 1 表示锚框与真实框重叠越多。这两个函数正是 P127 后续 assign_anchor_to_bbox() 匹配与 MultiboxTarget 打标签的基础。
P128 QA 精选 ❓:锚框数量约等于"像素数×每像素框数",通常几十万到百万级;s和r是超参数,按数据集物体大小分布设定;背景锚框占绝对多数,训练时靠掩码+采样平衡;NMS阈值是精度/召回的权衡旋钮。
与前文衔接 🔗
两阶段 vs 单阶段:主流检测方法对比
P122 提到检测有两大主流思路------基于锚框/候选区域的方法(如 Faster R-CNN)和单阶段密集预测(如 SSD、YOLO)。两者在速度、精度和适用场景上各有取舍,对比如下:
| 维度 | 基于锚框/两阶段(Faster R-CNN) | 单阶段(SSD、YOLO) |
|---|---|---|
| 推理速度 | 较慢(先海选候选框,再逐框精修分类回归) | 快(一次前向直接输出所有框的类别与坐标) |
| 检测精度 | 通常更高(两阶段精修,小物体与密集场景更稳) | 略低(但近年 YOLO 系列已大幅逼近) |
| 训练复杂度 | 较高(RPN 与检测头联合训练,调参点多) | 较低(端到端单网络,工程实现更简洁) |
| 适用场景 | 精度优先:学术评测、小物体/密集遮挡、对速度不敏感 | 速度优先:实时视频、移动端/嵌入式、工业在线检测 |
课程为何以 SSD 为主线 🤔:SSD 属于单阶段方法,但它的核心机制正是「以每个像素为中心铺不同尺寸/宽高比的锚框,再按 IoU 贴标签、学偏移」------与 P126 锚框理论完全同构。相比 Faster R-CNN 的两阶段流程,SSD 把「锚框生成→匹配→回归」讲得更直接、代码更短,适合教学演示;相比 YOLO 的网格划分思路,SSD 的多尺度特征图预测又与卷积网络结构衔接更自然。因此课程用 SSD 串起锚框、IoU、NMS 这一整套检测基础,学完即可迁移到其他检测框架。
六、总结与参考资料
从数据增广到锚框,这条学习路径完整覆盖了计算机视觉从分类到检测的核心进阶:先用数据增广(P111--113)解决小数据过拟合,再用微调(P114--115)借预训练模型快速适配新任务,接着通过 Kaggle 实战(P116--121)把「强增广+预训练微调」套路跑通,随后进入物体检测(P122--125)理解边界框与 IoU,最后用锚框(P126--128)把 IoU 升级为训练信号、配合 NMS 完成检测。五步环环相扣,构成 CV 实战的完整闭环。
推荐按以下顺序复习:先复现 P112 的 RandomResizedCrop 参数与 ColorJitter hue 范围,再跑通 P115 热狗微调的分层学习率参数组,接着用 P118 的 CIFAR-10 流程验证增广与预测变换分离,最后吃透 P127 的 multibox_prior 形状与 assign_anchor_to_bbox 匹配逻辑。每一步都建议动手改参数、看曲线,才能真正内化。
参考资料
- 李沐《动手学深度学习》 :《动手学深度学习》 --- 动手学深度学习 2.0.0 documentation ------ 全书开源,P111--128 对应「计算机视觉」章节,含完整代码与习题。
- PyTorch 官方文档 :torchvision.transforms ------ 数据增广各变换的完整参数说明。
- PyTorch 迁移学习教程 :Transfer Learning for Computer Vision ------ 微调与特征提取的官方实战。
- 目标检测经典论文:SSD(Liu et al., 2016)与 Faster R-CNN(Ren et al., 2015)------ 理解锚框与候选区域方法的必读材料。
- Kaggle 竞赛平台 :Checking your browser - reCAPTCHA ------ CIFAR-10 与 Dog Breed 赛题可继续练习打榜流程。