Brain-JEPA:用功能梯度定位与时空遮蔽预训练 fMRI 基础模型
原论文:Brain-JEPA: Brain Dynamics Foundation Model with Gradient Positioning and Spatiotemporal Masking
作者:Zijian Dong、Ruilin Li、Yilei Wu、Thuan Tinh Nguyen、Joanna Su Xian Chong、Fang Ji、Nathanael Ren Jie Tong、Christopher Li Hsian Chen、Juan Helen Zhou
会议:NeurIPS 2024;论文版本:arXiv:2409.19407v1(2024-09-28)
原文:arXiv:2409.19407;代码:Brain-JEPA
30 秒看懂这篇论文
Brain-JEPA 面向静息态 fMRI 基础模型学习。它不直接重建被遮蔽的原始 BOLD,而是在潜空间预测目标 patch;同时使用功能连接梯度作为 ROI 的功能坐标,并通过 Cross-ROI、Cross-Time 和 Double-Cross 三类目标逼迫模型学习跨脑区、跨时间的关系。
作者在 UK Biobank 的 40,162 名参与者上预训练,并在 UKB、HCP-Aging、ADNI 和 MACC 上测试年龄、性别、人格/认知特征以及阿尔茨海默病相关分类。代表性结果包括:UKB 年龄 Pearson 相关 0.718、性别 accuracy 88.17%;HCP-Aging 年龄相关 0.844;ADNI 淀粉样蛋白阳性/阴性分类 accuracy 71.00%;MACC 亚洲队列 NC/MCI 分类 accuracy 65.98%。这些结果支持表示具有迁移性,但不等于已经具备临床诊断能力。
1. 为什么需要 fMRI 基础模型?
BOLD 是神经活动的间接指标,也会受到呼吸、运动、扫描协议和低信噪比的影响。传统模型通常为年龄预测、疾病分类或功能连接等单一任务分别训练,难以复用大规模无标签静息态数据。
BrainLM 等工作把 fMRI 序列切成 patch 并重建被遮蔽输入,但重建目标可能迫使模型拟合噪声,或者依赖时间插值捷径。此外,3D 大脑中的 ROI 没有天然正确的线性顺序,解剖相邻不一定意味着功能相似。Brain-JEPA 针对这两个问题设计了功能梯度定位和时空遮蔽。
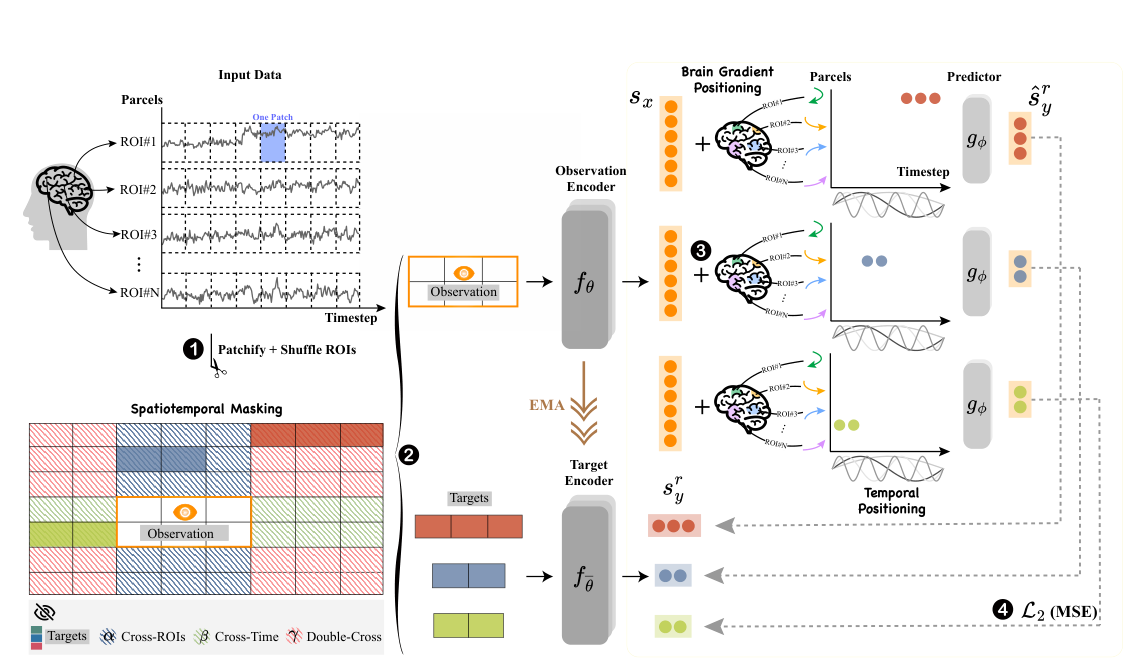
Figure 1 的关键是训练目标改变:observation encoder 只看 observation block,predictor 根据观察表示和位置嵌入预测目标表示,target encoder 通过 observation encoder 的指数移动平均更新。模型比较的是稳定潜表示,而不是原始 BOLD 的逐点重建。
2. Brain Gradient Positioning:用功能连接构造 ROI 坐标
给定 ROI i i i 和 j j j 的连接向量 c i , c j c_i,c_j ci,cj,作者用余弦角度构造亲和矩阵:
A ( i , j ) = 1 − 1 π cos − 1 ( c i c j T ∥ c i ∥ ∥ c j ∥ ) . A(i,j)=1-\frac{1}{\pi}\cos^{-1}\left(\frac{c_i c_j^{\mathsf T}}{\lVert c_i\rVert\lVert c_j\rVert}\right). A(i,j)=1−π1cos−1(∥ci∥∥cj∥cicjT).
令 D D D 为 A A A 的度矩阵,论文使用 diffusion map 得到:
L δ = D − 1 2 A D − 1 2 , M δ = D − 1 L δ . L_\delta=D^{-\frac{1}{2}}AD^{-\frac{1}{2}},\qquad M_\delta=D^{-1}L_\delta. Lδ=D−21AD−21,Mδ=D−1Lδ.
取 M δ M_\delta Mδ 的特征向量作为功能梯度。将前 m m m 个梯度组成 G ∈ R n × m G\in\mathbb{R}^{n\times m} G∈Rn×m,通过可训练线性层映射为 G ^ ∈ R n × d / 2 \widehat{G}\in\mathbb{R}^{n\times d/2} G ∈Rn×d/2,再与时间位置编码 T T T 拼接:
P = T , G \^ ∈ R n × d . P=T,\\widehat{G}\in\mathbb{R}^{n\times d}. P=T,G ∈Rn×d.
这里 n = 450 n=450 n=450 是 ROI 数量。功能梯度提供的是全脑功能连接流形中的相对位置,而不是毫米级解剖坐标。
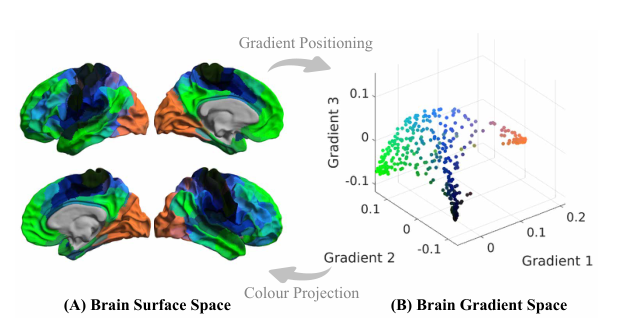
Figure 2 显示皮层区域按梯度坐标着色后具有连续的功能组织。它是群体级功能先验,不意味着每个参与者具有完全一致的功能分区。
3. Spatiotemporal Masking 与 JEPA 目标
每个 ROI 的时间序列先被切成包含 p p p 个时间点的 patch,并随机打乱 ROI。剩余目标分为三类:
- Cross-ROI( α \alpha α):同一时间范围内预测未观察到的 ROI;
- Cross-Time( β \beta β):预测不同时间 patch;
- Double-Cross( γ \gamma γ):同时面对未见 ROI 和未见时间,是最困难的目标。
给定 observation encoder f θ f_\theta fθ 的表示 s x s_x sx,predictor g ϕ g_\phi gϕ 在位置嵌入 P P P 条件下预测:
s ^ y r = g ϕ ( s x ∣ P ) , r ∈ { α , β , γ } . \widehat{s}^{r}{y}=g\phi(s_x\mid P),\qquad r\in\{\alpha,\beta,\gamma\}. s yr=gϕ(sx∣P),r∈{α,β,γ}.
训练损失是三类目标的平均平方误差:
L = 1 3 K ∑ r ∈ { α , β , γ } ∥ s ^ y r − s y r ∥ 2 2 . \mathcal{L}=\frac{1}{3K}\sum_{r\in\{\alpha,\beta,\gamma\}}\left\lVert\widehat{s}^{r}{y}-s^{r}{y}\right\rVert_2^2. L=3K1r∈{α,β,γ}∑ s yr−syr 22.
其中 s y r s_y^r syr 来自 target encoder。target encoder 不直接反向传播,而是由 observation encoder 的 EMA 更新,使模型学习相对稳定的潜在目标。
4. 数据、预处理与模型规模
预训练使用 UK Biobank 40,162 名参与者,年龄 44---83 岁;外部评估包括 HCP-Aging、ADNI 和 MACC。所有数据划分为 450 个 ROI,皮层使用 Schaefer-400,皮下区域使用 Tian-Scale III。每个 ROI 做 robust scaling;默认输入尺寸为 450 × 160 450\times160 450×160。为对齐不同扫描协议,多带数据以 stride 3 下采样。下游 fine-tuning 和 linear probing 使用 6:2:2 划分。
观察编码器测试 ViT-S、ViT-B 和 ViT-L,参数量分别约为 22M、86M 和 307M。主实验使用 ViT-B 预训练 300 epochs,不使用 cls token,评估时对 target encoder 的 patch 输出做平均池化得到全局 fMRI 表示。
5. 结果:表示能否迁移?
5.1 模型规模
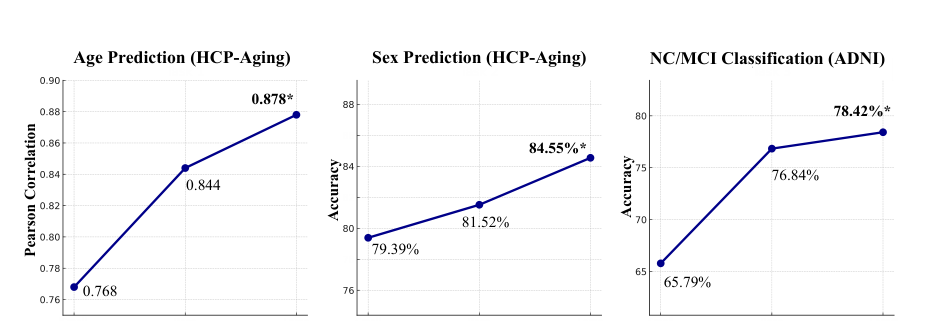
从 ViT-S 到 ViT-B、ViT-L,HCP-Aging 年龄相关性从 0.768 提升到 0.844 和 0.878,性别 accuracy 从 79.39% 提升到 81.52% 和 84.55%,ADNI NC/MCI accuracy 从 65.79% 提升到 76.84% 和 78.42%。这说明在论文测试范围内存在 scaling trend,但不能据此外推无限扩展规律。
5.2 Fine-tuning 与 linear probing
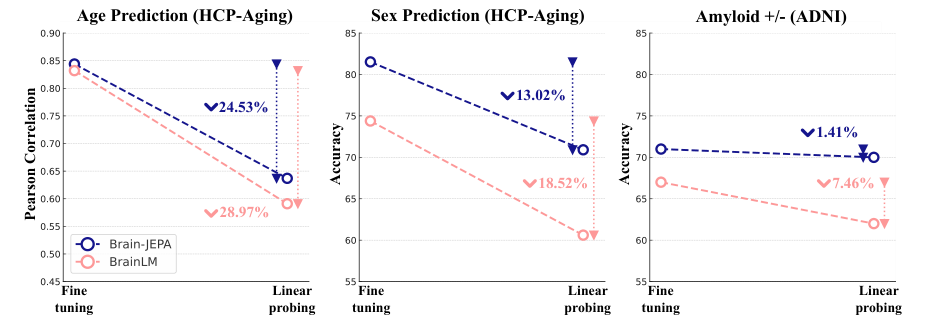
Brain-JEPA 的 linear probing 性能下降小于 BrainLM,例如 HCP-Aging 年龄任务下降约 24.53%,而 BrainLM 约为 28.97%。这支持潜表示可以被 off-the-shelf 使用,但不代表所有下游任务都能零样本解决。
5.3 位置编码消融
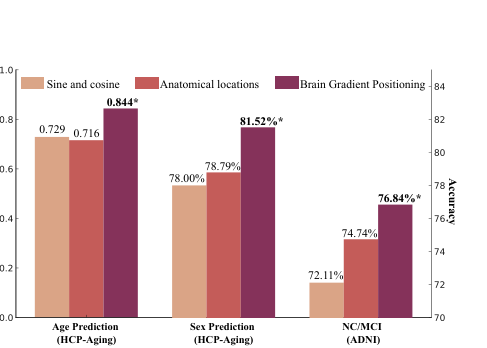
在 HCP-Aging 年龄预测中,sine/cosine、anatomical locations 和 Brain Gradient Positioning 的 Pearson 相关分别为 0.729、0.716 和 0.844;性别 accuracy 分别为 78.00%、78.79% 和 81.52%。功能梯度定位的增益明显,但它与 ROI 图谱和群体级梯度计算方式绑定。
5.4 Masking 消融
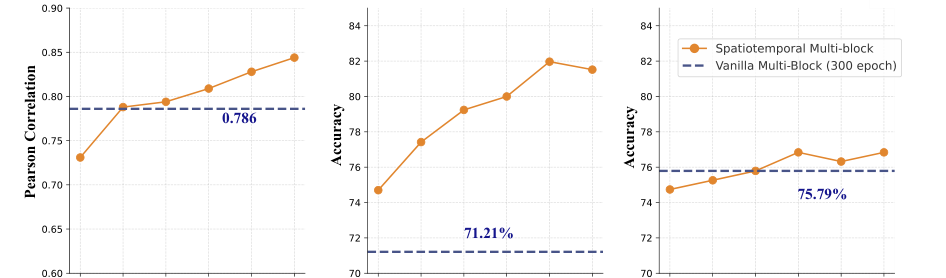
Spatiotemporal Multi-block 随预训练 epochs 增加而提升:HCP-Aging 年龄相关性从 50 epochs 的约 0.73 增长到 300 epochs 的 0.844,超过 vanilla multi-block 在 300 epochs 的 0.786。这更像是归纳偏置和训练效率结果,而不是单独证明某个脑网络机制。
6. 注意力图能说明什么?
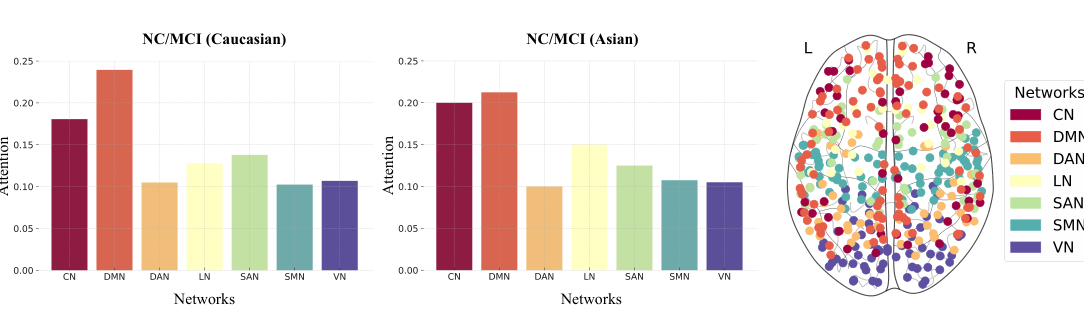
作者将 ROI 汇总为 control、default mode、dorsal attention、limbic、salience attention、somatomotor 和 visual 等网络。在 Caucasian 与 Asian NC/MCI 分类中,DMN、CN 和 LN 的 attention 较突出。更稳妥的结论是模型在两个族群的读出中呈现相似网络级权重,而不是 DMN 对疾病具有因果作用。注意力是内部归因信号,仍需独立扰动实验和跨队列复现。
7. 证据边界与局限
功能梯度定位和时空 masking 都有直接消融,模型规模曲线、linear probing 和外部数据集结果共同支持一定的迁移性;MACC 亚洲队列也说明模型没有完全失效于预训练族群之外。
但论文没有充分测试跨站点、跨扫描仪、跨 atlas、跨任务态/静息态的泛化,也没有直接测量"潜空间信噪比"提升。疾病分类 accuracy 不能等同于临床诊断效用,attention 也不能直接解释为因果机制。不同数据集的预处理差异、训练预算和 ViT 架构同样可能贡献性能提升。
总结
Brain-JEPA 将 fMRI 基础模型的两个设计问题具体化:用功能连接梯度提供 ROI 的功能坐标,用 Cross-ROI、Cross-Time 和 Double-Cross 构造跨空间、跨时间的预测任务,再用 JEPA 在潜空间对齐 observation 与 target。它展示了可迁移脑动态表示的潜力,但更准确的定位是面向脑动态分析的表示学习框架,而不是已经完成临床级脑解码或揭示因果神经机制。
参考资料与图片来源
- Dong et al., "Brain-JEPA: Brain Dynamics Foundation Model with Gradient Positioning and Spatiotemporal Masking," NeurIPS 2024, arXiv:2409.19407v1。本文 Figure 1--7 均来自该论文 PDF 的原图或忠实页面裁剪,未生成、重绘或添加语义标注。
- Ortega Caro et al., "BrainLM: A foundation model for brain activity recordings," ICLR 2023。
- Assran et al., "Self-supervised learning from images with a joint-embedding predictive architecture," CVPR 2023。