✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
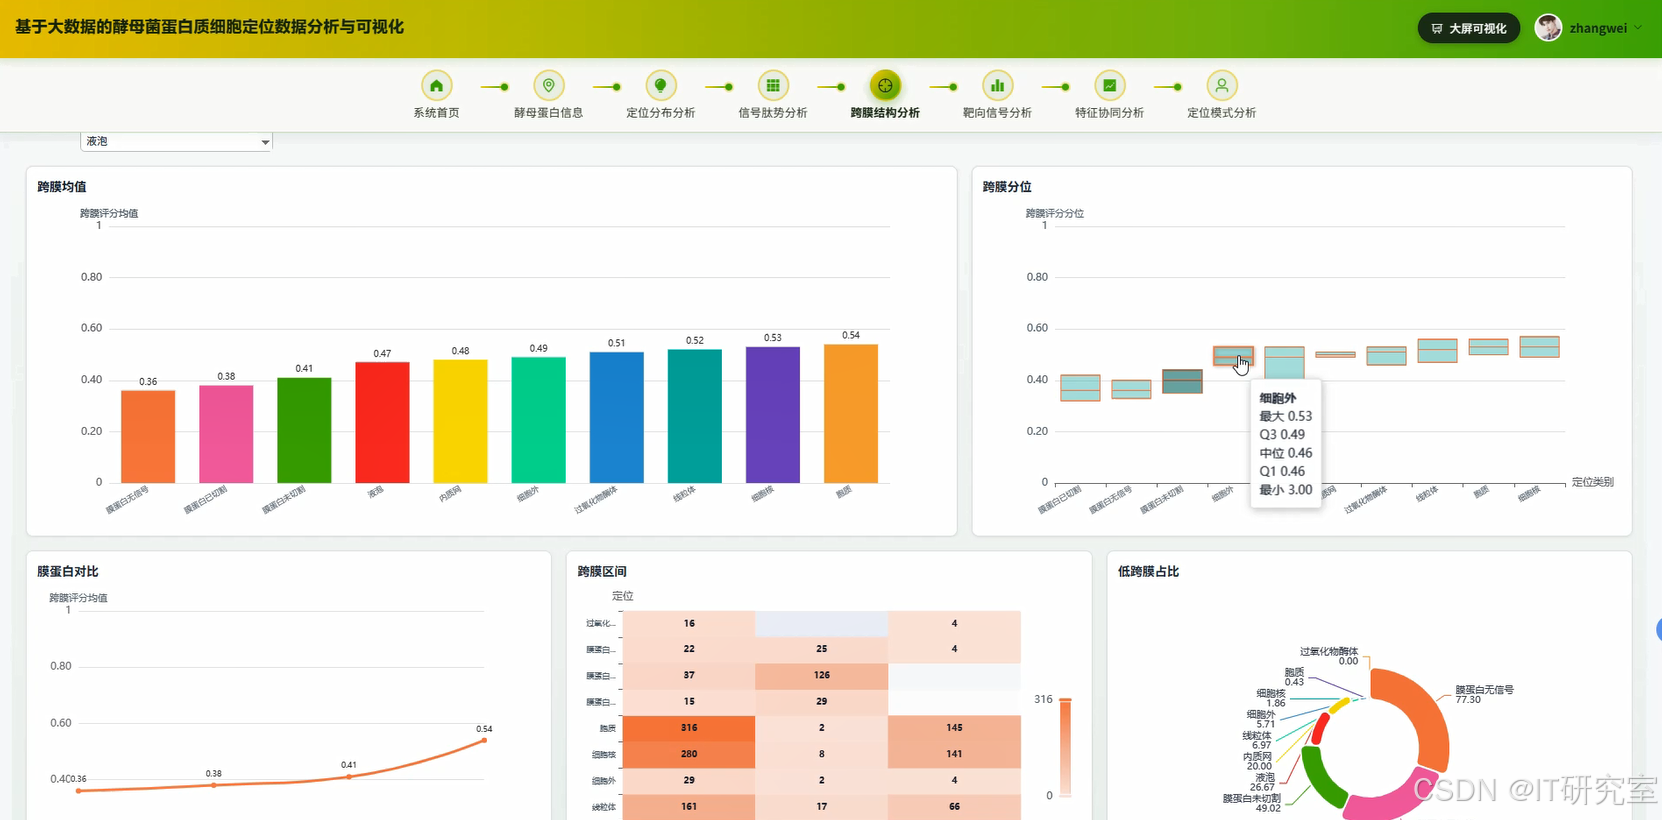
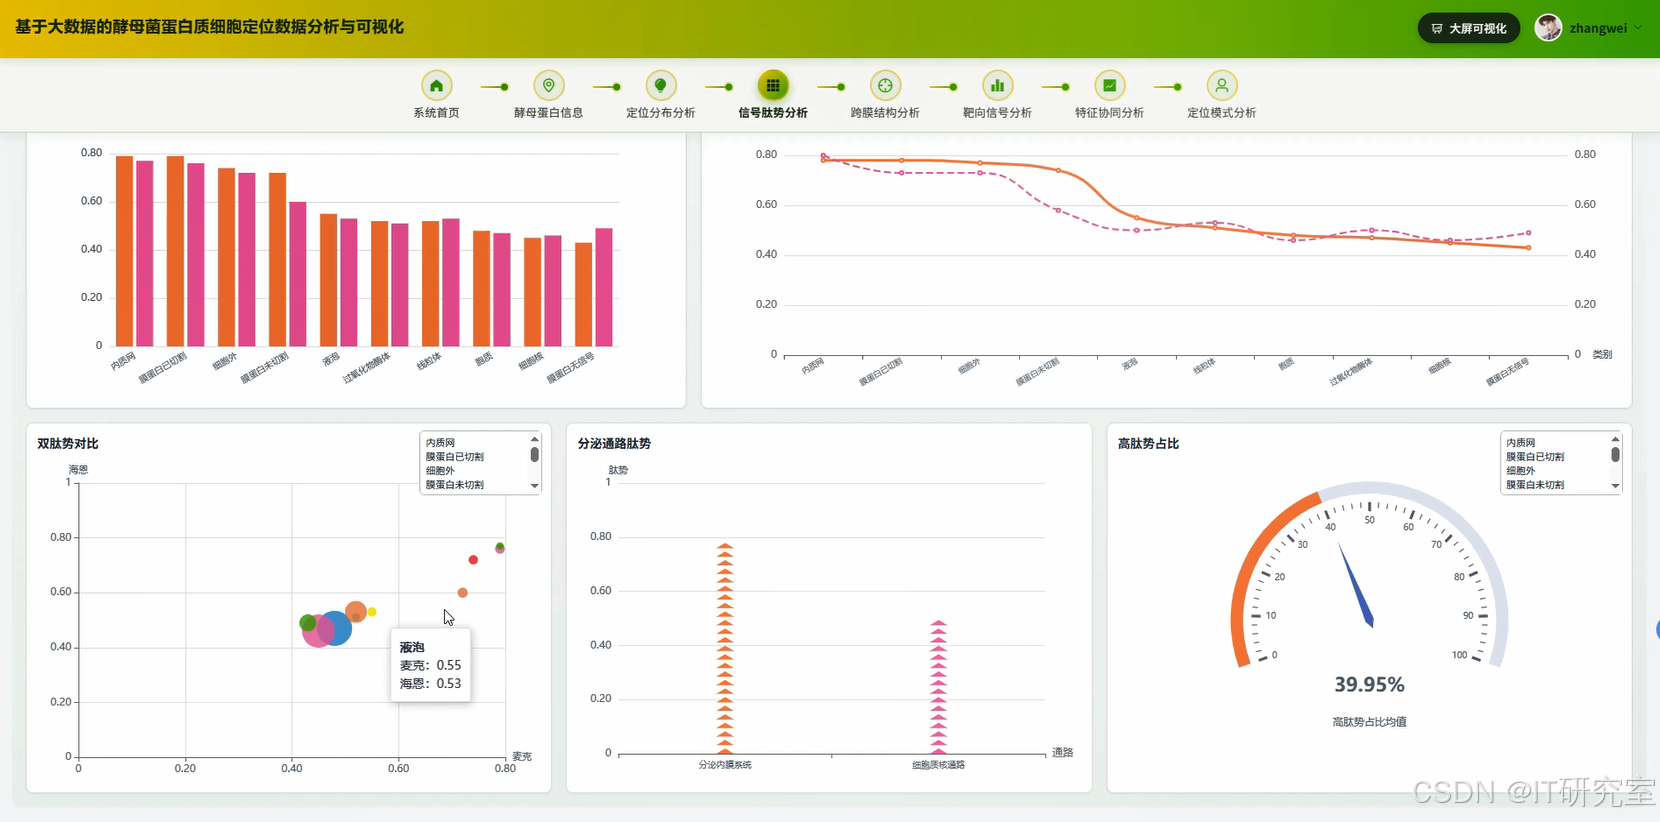
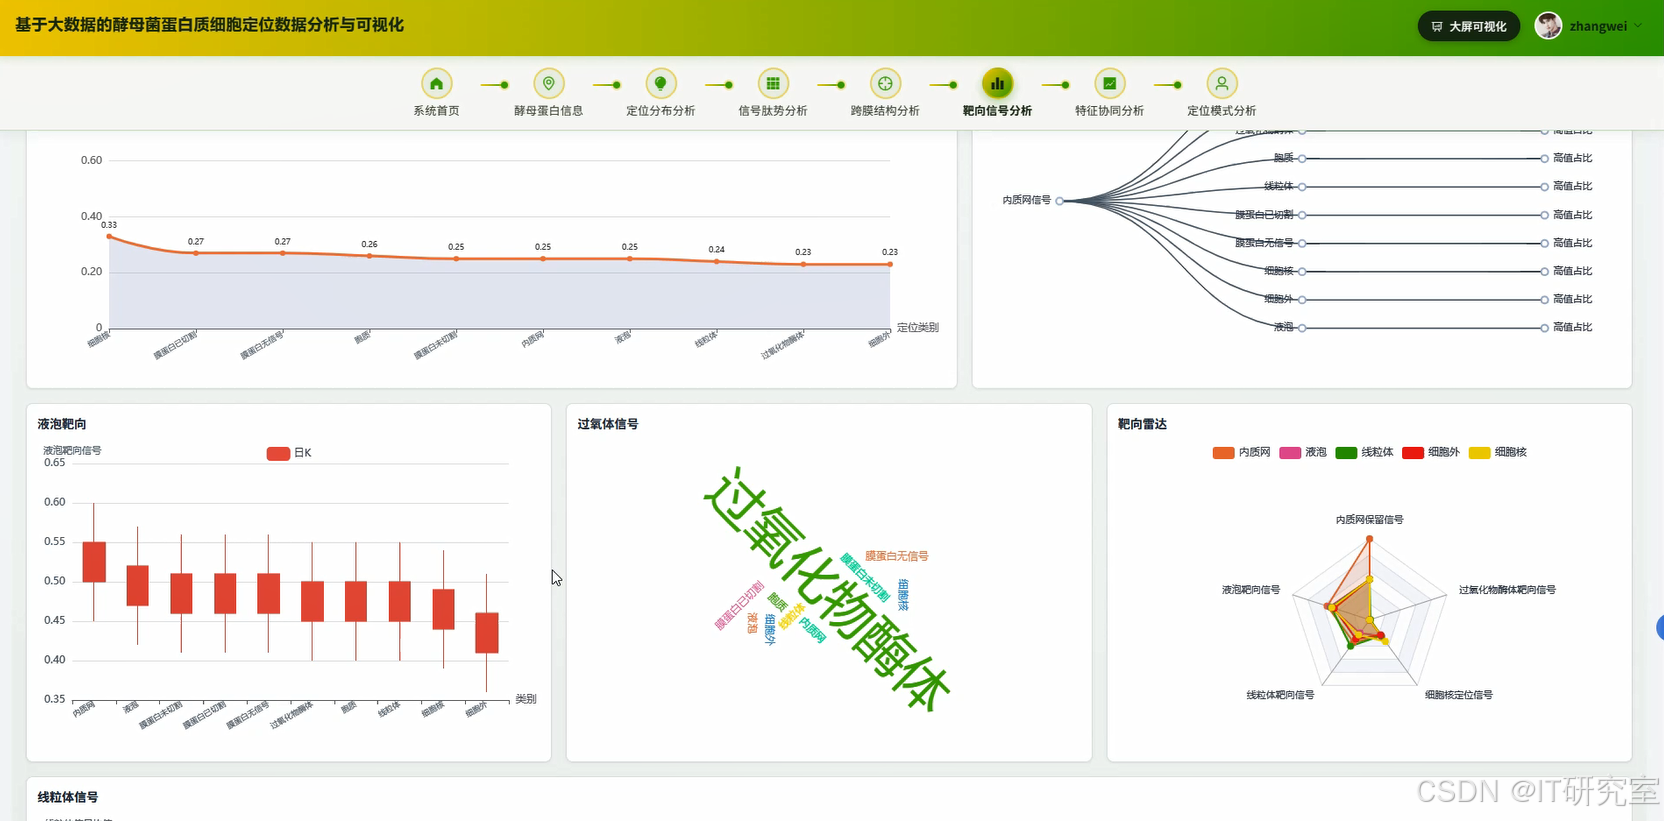
本系统名为《基于大数据的酵母菌蛋白质细胞定位数据分析与可视化》,主要面向酵母菌蛋白质细胞定位相关数据的整理、分析与展示需求。系统以Hadoop与Spark作为大数据处理核心,借助HDFS完成数据存储,通过Spark SQL与Pandas、NumPy完成数据清洗、统计计算与特征分析,后端采用Django框架进行业务组织与接口开发,前端使用Vue、ElementUI、Echarts、HTML、CSS、JavaScript与jQuery实现页面交互与图表展示,数据库采用MySQL保存系统运行所需的基础数据与分析结果。系统功能包括系统首页、酵母蛋白信息、定位分布分析、信号肽势分析、跨膜结构分析、靶向信号分析、特征协同分析与定位模式分析七个模块。用户可以在系统中查看酵母蛋白的基础信息,对不同定位类别进行分布统计,分析信号肽势、跨膜结构、靶向信号等特征,并进一步观察多个特征之间的协同关系与定位模式变化。系统通过大数据计算方式提升数据处理效率,再以可视化图表呈现分析结果,使原本分散、复杂的酵母菌蛋白质细胞定位数据变得更容易观察和理解,也为计算机专业毕业设计提供了一套较为完整的大数据分析与可视化实现方案。
选题背景
酵母菌蛋白质细胞定位分析本身属于生物信息学中比较常见的研究方向,相关数据往往来源分散、字段较多,单靠人工整理和普通表格统计,很难在短时间内看清不同定位类别之间的分布差异和特征联系。随着大数据处理技术在高校课程和毕业设计中逐渐普及,Hadoop、Spark、Spark SQL等工具开始被用于中小规模数据的清洗、统计和分析,这给计算机专业学生提供了一个比较合适的切入方向。把酵母菌蛋白质细胞定位数据放到大数据框架下处理,既能保留原始数据的细节,又能通过分布式计算思路提高分析效率。对于即将毕业的计算机专业学生来说,这类题目既涉及数据存储、数据处理、后端接口、前端可视化等环节,又能体现Spark SQL和Hadoop的实际使用,比较适合作为毕业设计课题。系统正是在这样的背景下提出,希望把酵母蛋白信息、定位分布、信号肽势、跨膜结构、靶向信号、特征协同和定位模式等内容集中到一个平台中进行分析和展示。
选题意义
从实际使用角度看,这个系统可以把原本分散的酵母菌蛋白质细胞定位数据集中起来,通过Spark进行清洗和统计,再借助Echarts把分析结果以图表形式展示出来,方便使用者快速查看不同定位类别的分布情况以及信号肽势、跨膜结构、靶向信号等特征之间的关系。对于计算机专业毕业设计来说,它的意义更多体现在技术实践层面,能够把Hadoop、Spark、Spark SQL、Django、Vue和MySQL等技术串联起来,完成从数据存储、数据处理到后端接口和前端展示的完整流程。系统没有追求复杂的生产级架构,而是尽量把功能做完整、把流程跑通,让使用者能够通过页面查看酵母蛋白信息、定位分布分析和定位模式分析等内容。通过这个课题,可以对大数据处理流程、前后端交互和可视化实现有更具体的理解,也能为后续类似的数据分析与展示类项目提供一个简单的参考。整体来说,它更偏向一次完整的毕业设计实践,在有限范围内把大数据分析和可视化展示结合起来,帮助使用者更直观地观察酵母菌蛋白质细胞定位相关数据。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
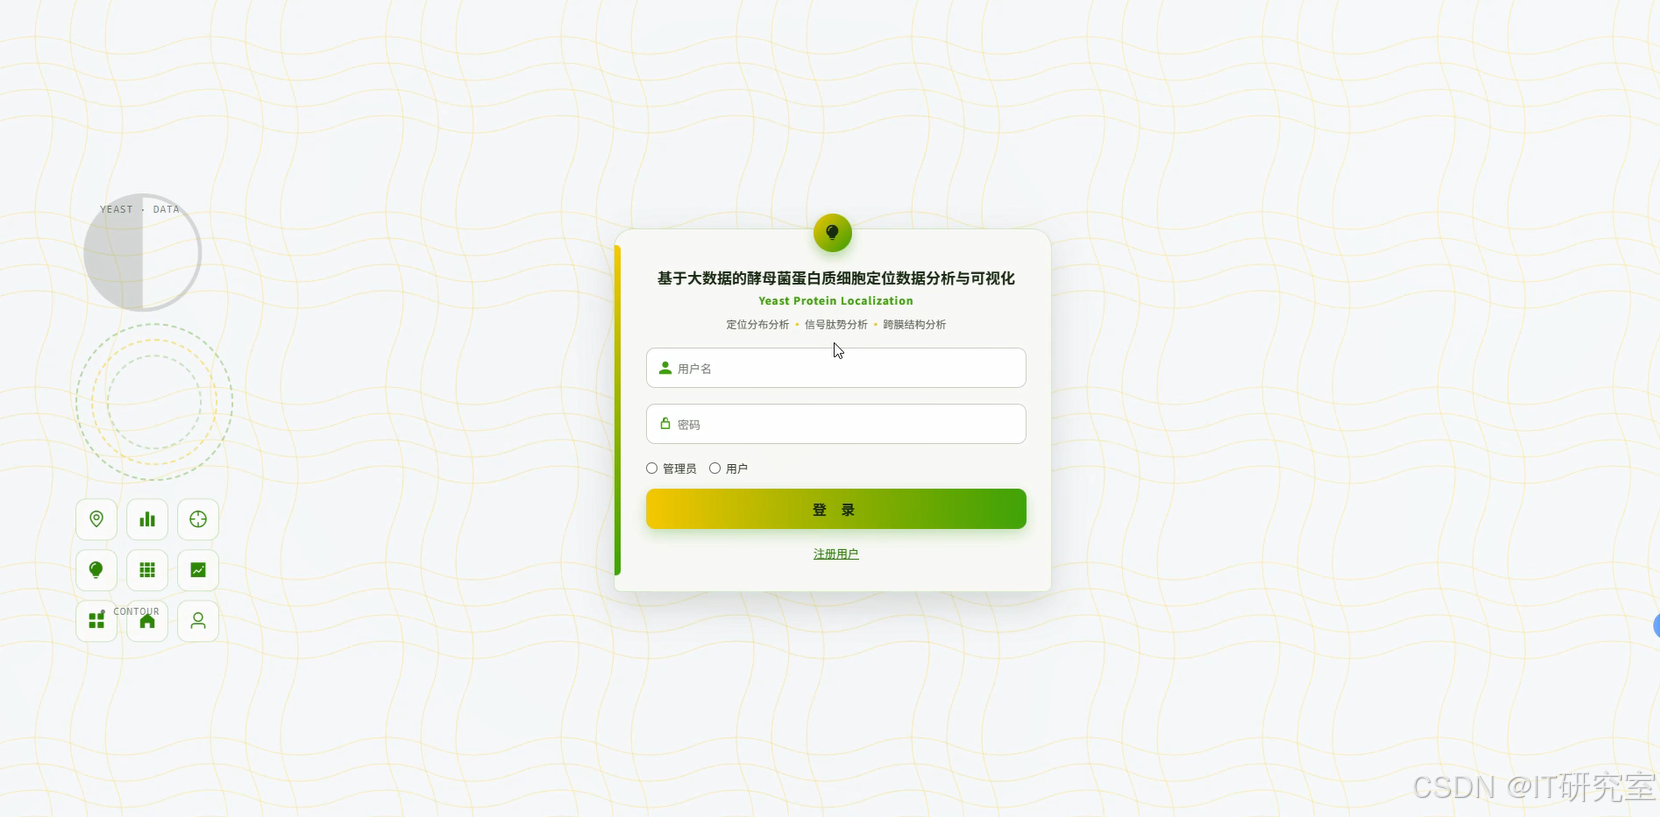
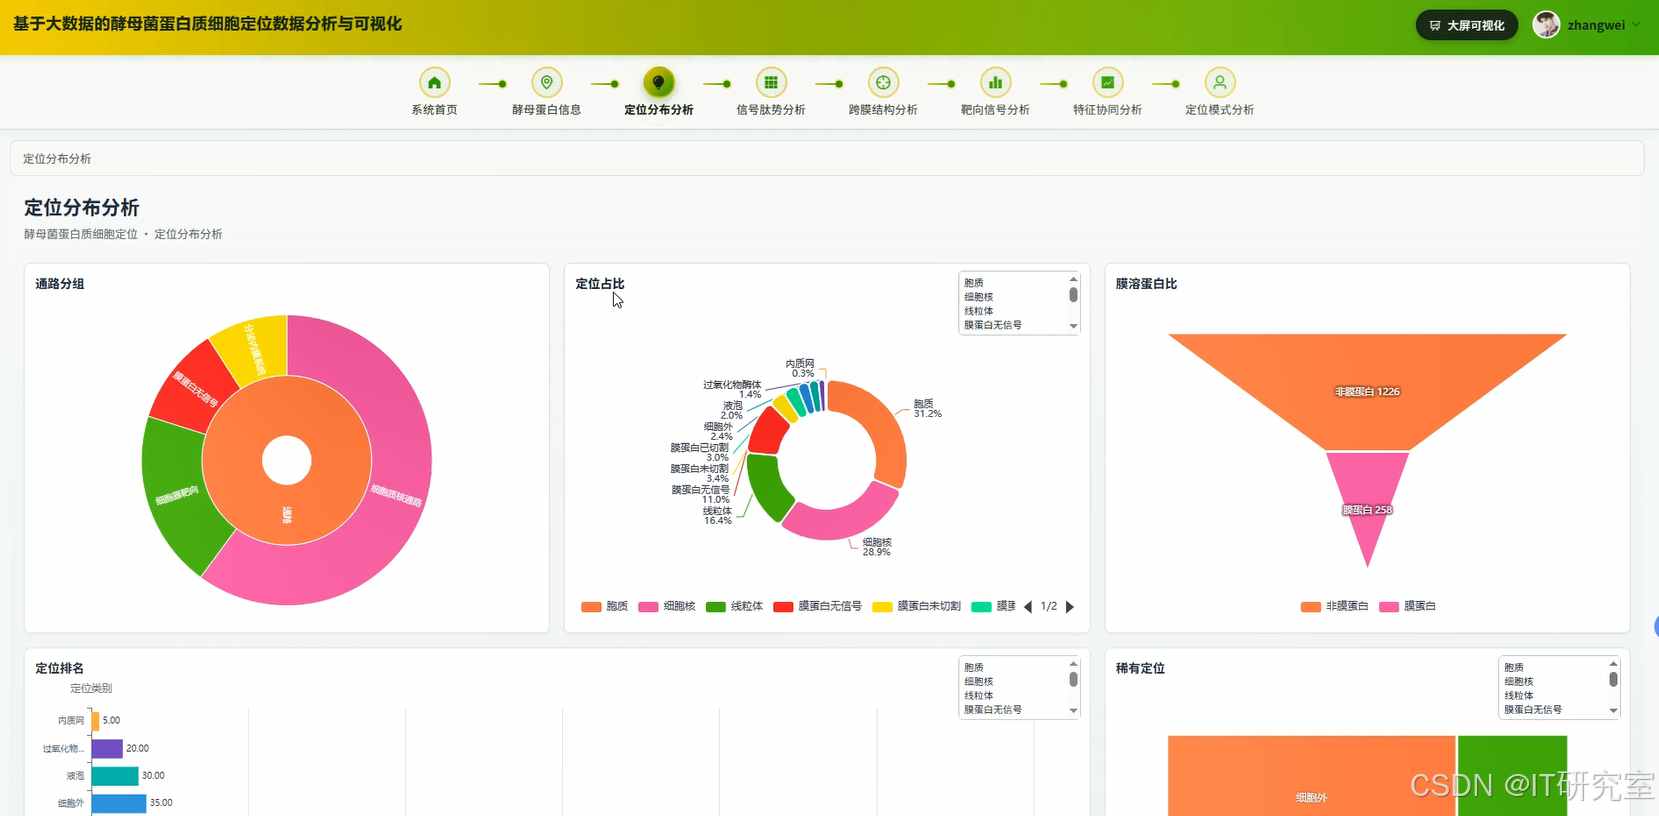
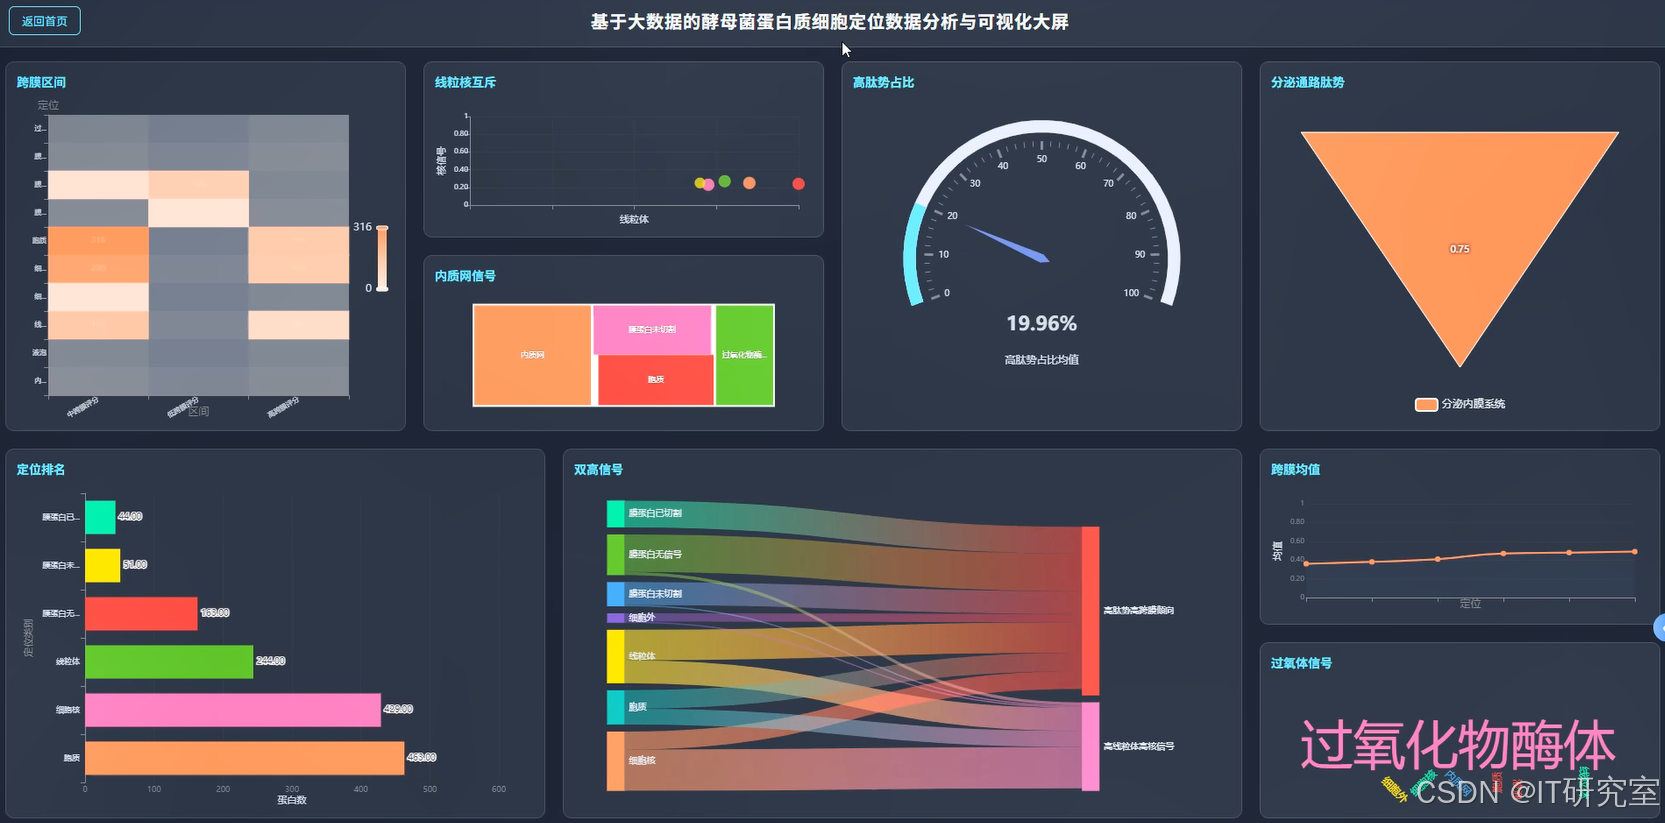
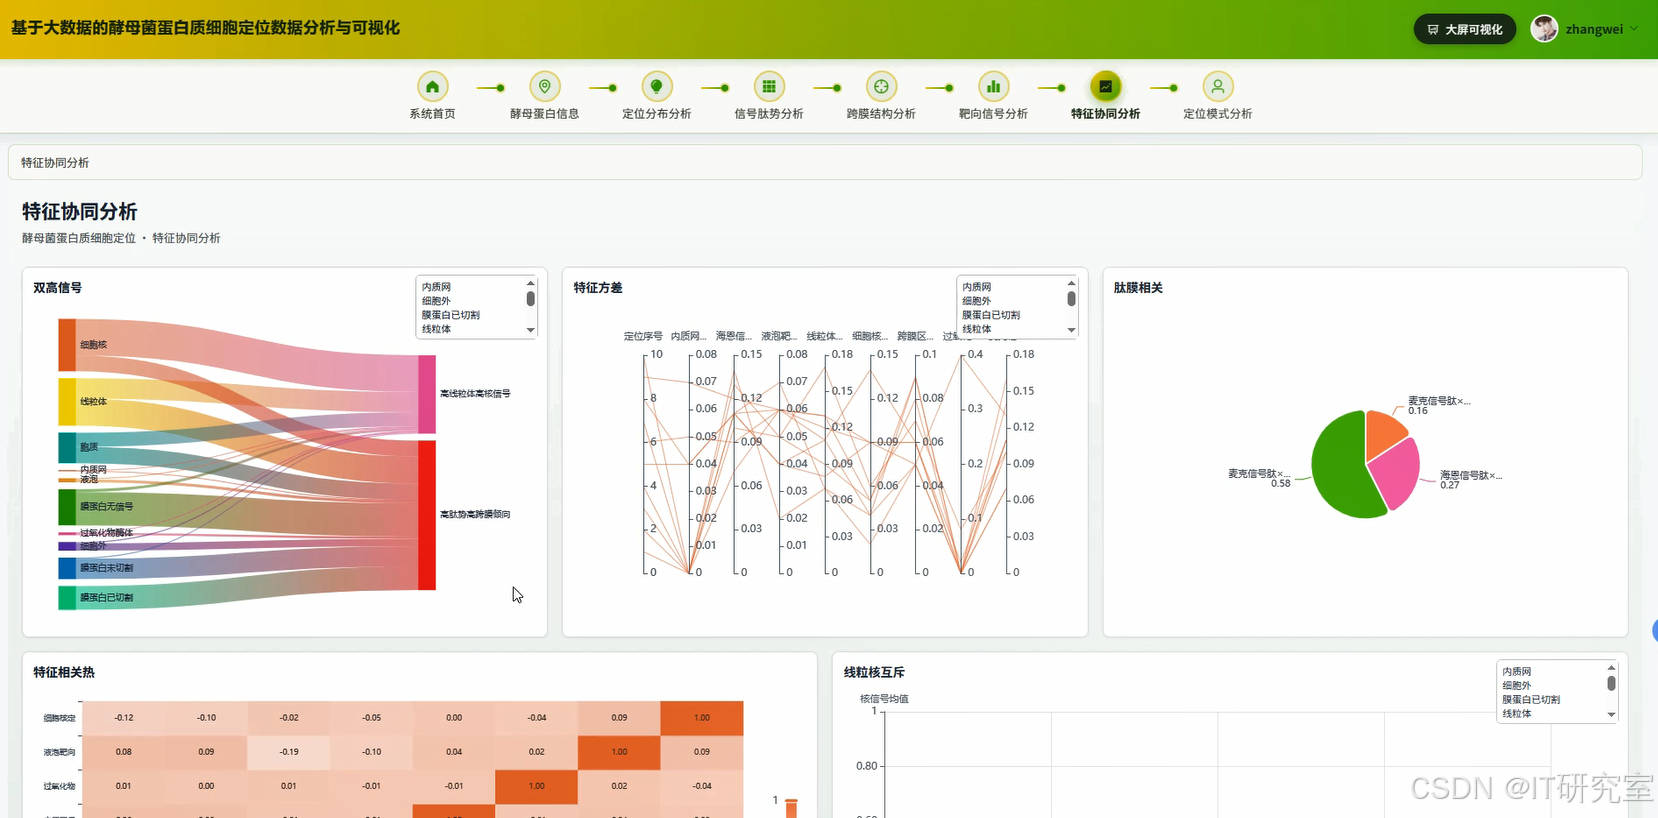
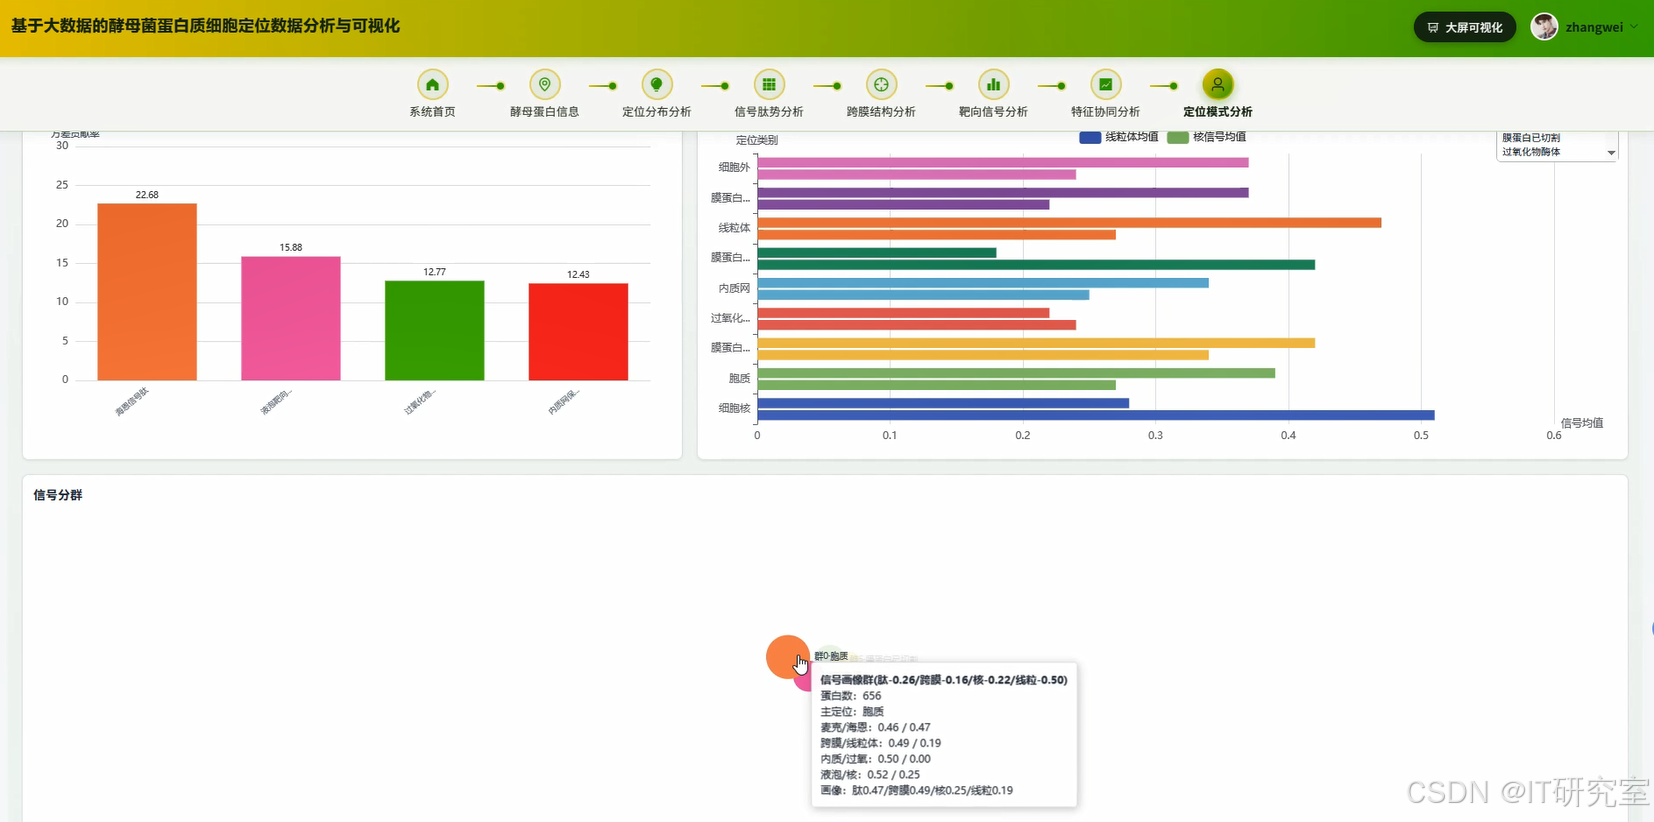
- 基于大数据的酵母菌蛋白质细胞定位数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, when, desc
import pandas as pd
import numpy as np
import json
from django.http import JsonResponse
from django.views.decorators.csrf import csrf_exempt
from .models import YeastProtein, LocalizationResult

spark = SparkSession.builder.appName("YeastProteinLocalization").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

@csrf_exempt
def localization_distribution_analysis(request):
    if request.method == "POST":
        params = json.loads(request.body)
        location_type = params.get("location_type", "")
        min_count = params.get("min_count", 1)
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/yeast_db").option("dbtable", "yeast_protein").option("user", "root").option("password", "123456").load()
        filtered_df = df.filter(col("location_type").isNotNull())
        if location_type:
            filtered_df = filtered_df.filter(col("location_type") == location_type)
        distribution_df = filtered_df.groupBy("location_type").agg(count("protein_id").alias("protein_count"), avg("signal_peptide_score").alias("avg_signal_score"), avg("transmembrane_score").alias("avg_transmembrane_score")).filter(col("protein_count") >= min_count).orderBy(desc("protein_count"))
        result_list = distribution_df.collect()
        chart_data = []
        for row in result_list:
            chart_data.append({"location_type": row["location_type"], "protein_count": row["protein_count"], "avg_signal_score": round(float(row["avg_signal_score"]), 4) if row["avg_signal_score"] else 0, "avg_transmembrane_score": round(float(row["avg_transmembrane_score"]), 4) if row["avg_transmembrane_score"] else 0})
        LocalizationResult.objects.filter(analysis_type="distribution").delete()
        for item in chart_data:
            LocalizationResult.objects.create(analysis_type="distribution", location_type=item["location_type"], protein_count=item["protein_count"], avg_signal_score=item["avg_signal_score"], avg_transmembrane_score=item["avg_transmembrane_score"])
        return JsonResponse({"code": 200, "msg": "定位分布分析完成", "data": chart_data})

@csrf_exempt
def signal_peptide_analysis(request):
    if request.method == "POST":
        params = json.loads(request.body)
        score_range = params.get("score_range", [0, 1])
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/yeast_db").option("dbtable", "yeast_protein").option("user", "root").option("password", "123456").load()
        signal_df = df.filter(col("signal_peptide_score").isNotNull()).filter((col("signal_peptide_score") >= score_range[0]) & (col("signal_peptide_score") <= score_range[1]))
        signal_df = signal_df.withColumn("score_level", when(col("signal_peptide_score") >= 0.8, "高").when(col("signal_peptide_score") >= 0.5, "中").otherwise("低"))
        level_df = signal_df.groupBy("score_level").agg(count("protein_id").alias("protein_count"), avg("signal_peptide_score").alias("avg_score"), avg("transmembrane_score").alias("avg_transmembrane")).orderBy("score_level")
        level_result = level_df.collect()
        detail_df = signal_df.select("protein_id", "protein_name", "signal_peptide_score", "transmembrane_score", "location_type").orderBy(desc("signal_peptide_score")).limit(100)
        detail_result = detail_df.collect()
        chart_data = {"level_data": [], "detail_data": []}
        for row in level_result:
            chart_data["level_data"].append({"score_level": row["score_level"], "protein_count": row["protein_count"], "avg_score": round(float(row["avg_score"]), 4), "avg_transmembrane": round(float(row["avg_transmembrane"]), 4)})
        for row in detail_result:
            chart_data["detail_data"].append({"protein_id": row["protein_id"], "protein_name": row["protein_name"], "signal_peptide_score": round(float(row["signal_peptide_score"]), 4), "transmembrane_score": round(float(row["transmembrane_score"]), 4) if row["transmembrane_score"] else 0, "location_type": row["location_type"]})
        return JsonResponse({"code": 200, "msg": "信号肽势分析完成", "data": chart_data})

@csrf_exempt
def feature_synergy_analysis(request):
    if request.method == "POST":
        params = json.loads(request.body)
        location_type = params.get("location_type", "")
        df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/yeast_db").option("dbtable", "yeast_protein").option("user", "root").option("password", "123456").load()
        feature_df = df.filter(col("signal_peptide_score").isNotNull() & col("transmembrane_score").isNotNull() & col("targeting_signal_score").isNotNull())
        if location_type:
            feature_df = feature_df.filter(col("location_type") == location_type)
        feature_df = feature_df.withColumn("signal_level", when(col("signal_peptide_score") >= 0.7, "高").otherwise("低")).withColumn("transmembrane_level", when(col("transmembrane_score") >= 0.7, "高").otherwise("低")).withColumn("targeting_level", when(col("targeting_signal_score") >= 0.7, "高").otherwise("低"))
        synergy_df = feature_df.groupBy("signal_level", "transmembrane_level", "targeting_level", "location_type").agg(count("protein_id").alias("protein_count"), avg("signal_peptide_score").alias("avg_signal"), avg("transmembrane_score").alias("avg_transmembrane"), avg("targeting_signal_score").alias("avg_targeting")).orderBy(desc("protein_count"))
        synergy_result = synergy_df.collect()
        synergy_data = []
        for row in synergy_result:
            synergy_data.append({"signal_level": row["signal_level"], "transmembrane_level": row["transmembrane_level"], "targeting_level": row["targeting_level"], "location_type": row["location_type"], "protein_count": row["protein_count"], "avg_signal": round(float(row["avg_signal"]), 4), "avg_transmembrane": round(float(row["avg_transmembrane"]), 4), "avg_targeting": round(float(row["avg_targeting"]), 4)})
        pattern_df = feature_df.groupBy("location_type").agg(count("protein_id").alias("total_count"), avg("signal_peptide_score").alias("avg_signal"), avg("transmembrane_score").alias("avg_transmembrane"), avg("targeting_signal_score").alias("avg_targeting")).orderBy(desc("total_count"))
        pattern_result = pattern_df.collect()
        pattern_data = []
        for row in pattern_result:
            pattern_data.append({"location_type": row["location_type"], "total_count": row["total_count"], "avg_signal": round(float(row["avg_signal"]), 4), "avg_transmembrane": round(float(row["avg_transmembrane"]), 4), "avg_targeting": round(float(row["avg_targeting"]), 4)})
        return JsonResponse({"code": 200, "msg": "特征协同分析完成", "data": {"synergy_data": synergy_data, "pattern_data": pattern_data}})
五、系统视频
基于大数据的酵母菌蛋白质细胞定位数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的酵母菌蛋白质细胞定位数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇