✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
《基于大数据的考研相关视频数据可视化分析》这个系统,主要围绕考研相关视频数据展开分析,用Hadoop和Spark做数据处理,用Spark SQL完成数据统计与聚合,再通过Django或Spring Boot把分析结果提供给前端展示。系统里包含视频热度分析、互动结构分析、发布时序分析、时长特征分析、创作者力分析、标题语义分析、爆款洞察分析、数据大屏、用户和视频信息这些功能。视频热度分析看的是播放、点赞、评论、收藏这些指标综合出来的热度表现,互动结构分析看的是点赞、评论、收藏、转发之间的比例关系,发布时序分析看的是视频发布时间和数量变化之间的关系。时长特征分析关注视频长度和热度之间有没有关系,创作者力分析关注不同创作者的产出和影响力,标题语义分析关注标题里的关键词分布,爆款洞察分析是把高热度视频挑出来做对比,数据大屏则是把前面这些结果集中展示。整体上,这个系统不是单纯做一个页面,而是把考研视频数据从采集之后的处理、统计、分析到可视化展示串起来,技术重点放在Hadoop、HDFS、Spark、Spark SQL这些大数据环节上,Python版本用Django配合Pandas、NumPy做处理,Java版本用Spring Boot配合Spark做处理,前端用Vue、ElementUI、Echarts这些完成图表展示。
选题背景
这几年考研一直是个热门话题,围绕考研产生的视频内容也越来越多,B站、抖音、小红书这些平台上都能看到大量和考研经验、院校选择、复习规划、复试调剂相关的视频。视频多了以后,单靠人工去看,很难看出哪些内容热度高、哪些创作者更活跃、哪种视频时长更容易被接受,也很难看出发布时间和互动情况之间有没有关系。对计算机专业的毕业设计来说,如果只是做一个普通的管理系统,技术含量往往不够,而考研视频数据本身又带有明显的时序特征、互动特征和文本特征,适合拿来练手大数据处理。Hadoop和Spark能处理较大规模的数据,Spark SQL能把统计逻辑写清楚,Echarts又能把结果直观展示出来,所以这个题目既能结合大数据技术,又能落到一个具体场景上,不至于太空。
选题意义
从实际意义上看,这个系统能把考研视频里的一些规律用图表方式呈现出来,比如哪类视频热度更高,哪种互动结构更常见,什么时间发布的视频更容易被看到,多长时间的视频更容易被完整播放,哪些创作者的视频更稳定,标题里常出现哪些词,爆款视频有哪些共同点。对准备考研的学生来说,这些结果能帮他们少走一点弯路,知道哪些内容更值得看;对做视频的创作者来说,也能从互动和时长这些角度调整自己的内容。从学习意义上看,这个毕设把Hadoop、Spark、Spark SQL、Django或Spring Boot、Vue、Echarts这些技术串了一遍,能让我把课堂上学到的数据处理、后端开发和前端展示真正连起来。它不算什么特别大的系统,功能也还有继续补充的空间,但作为一个本科毕业设计,能把大数据处理流程跑通,把分析结果展示清楚,已经能达到练手和总结的目的。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的考研相关视频数据可视化分析界面展示:
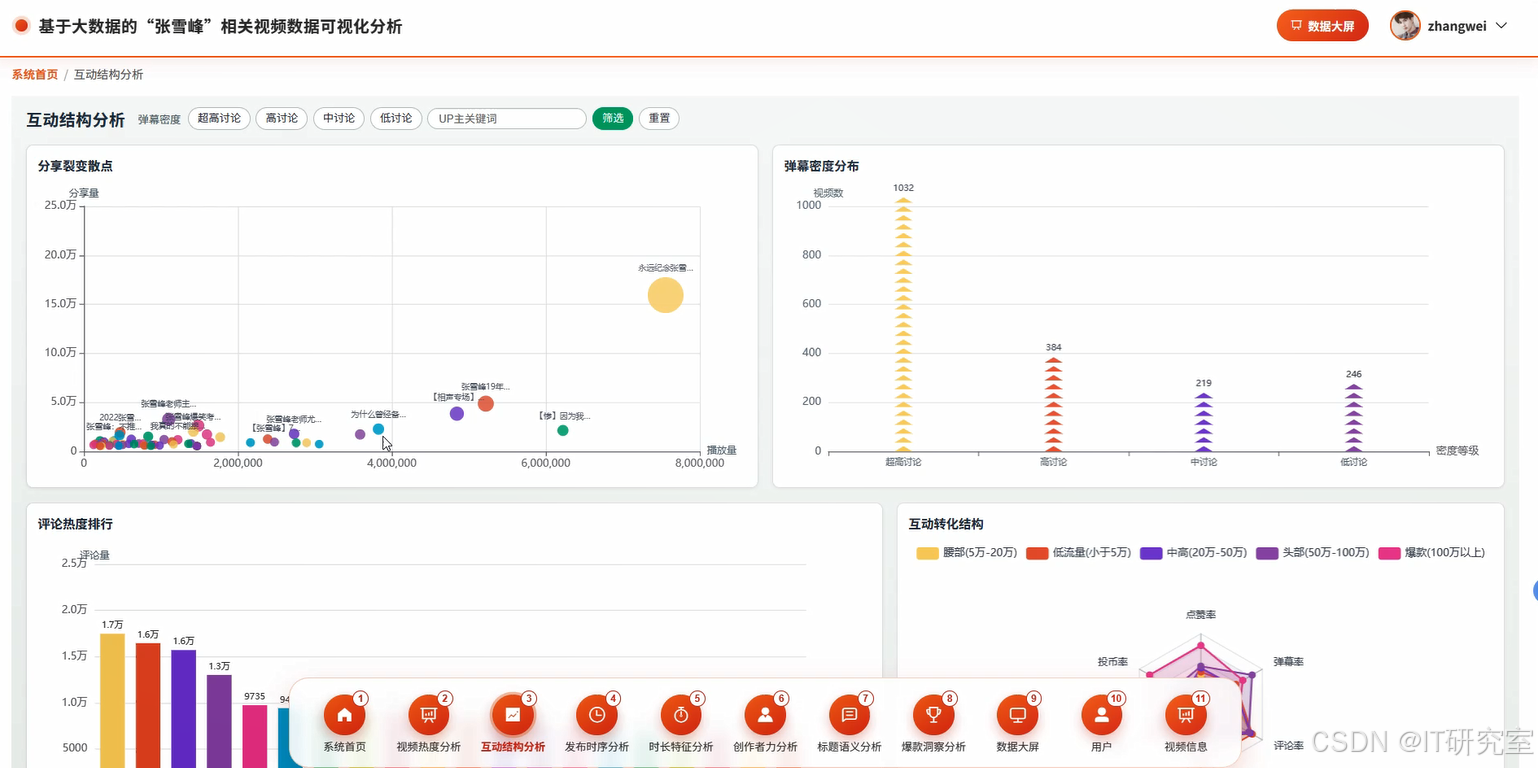
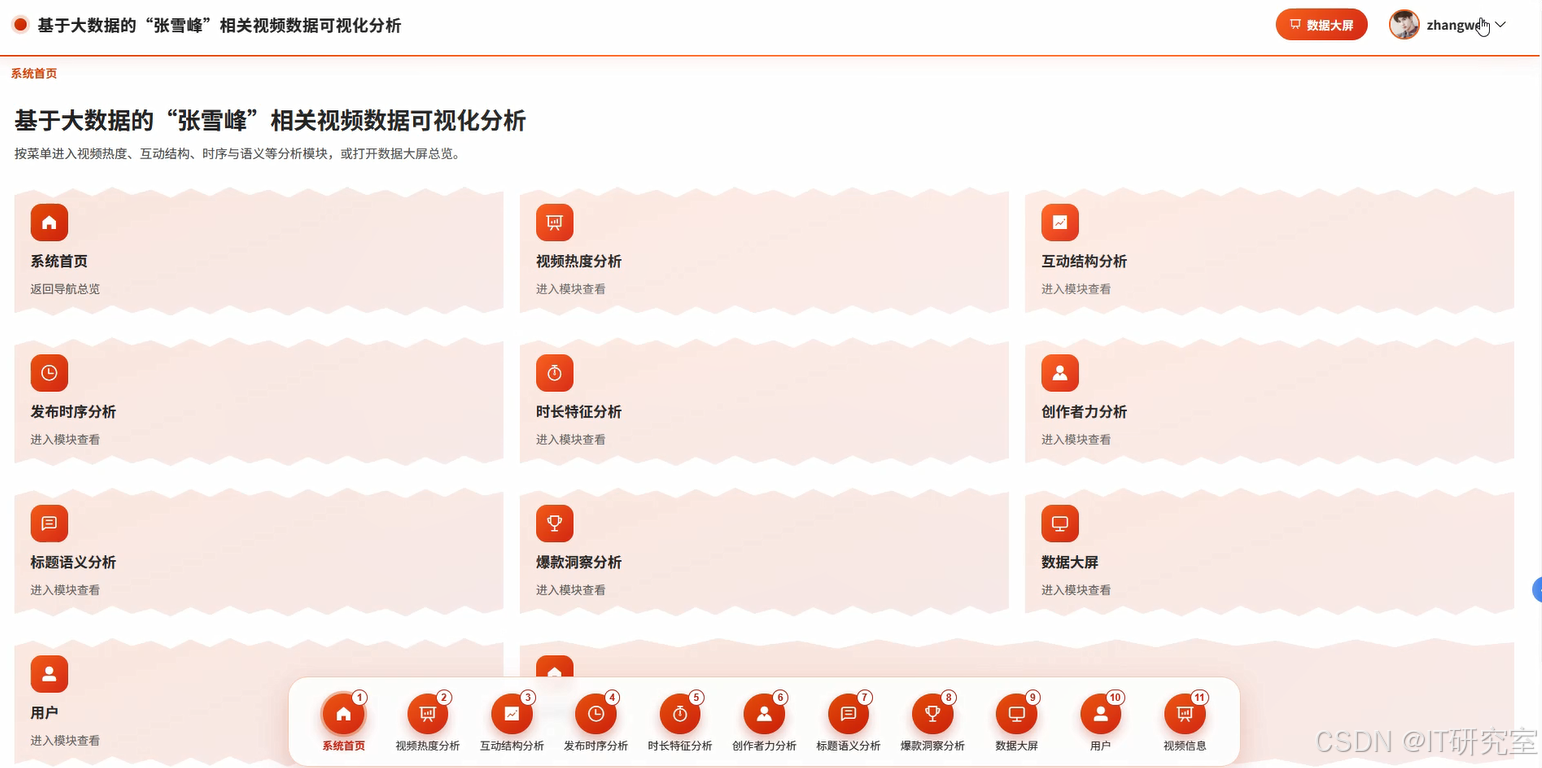
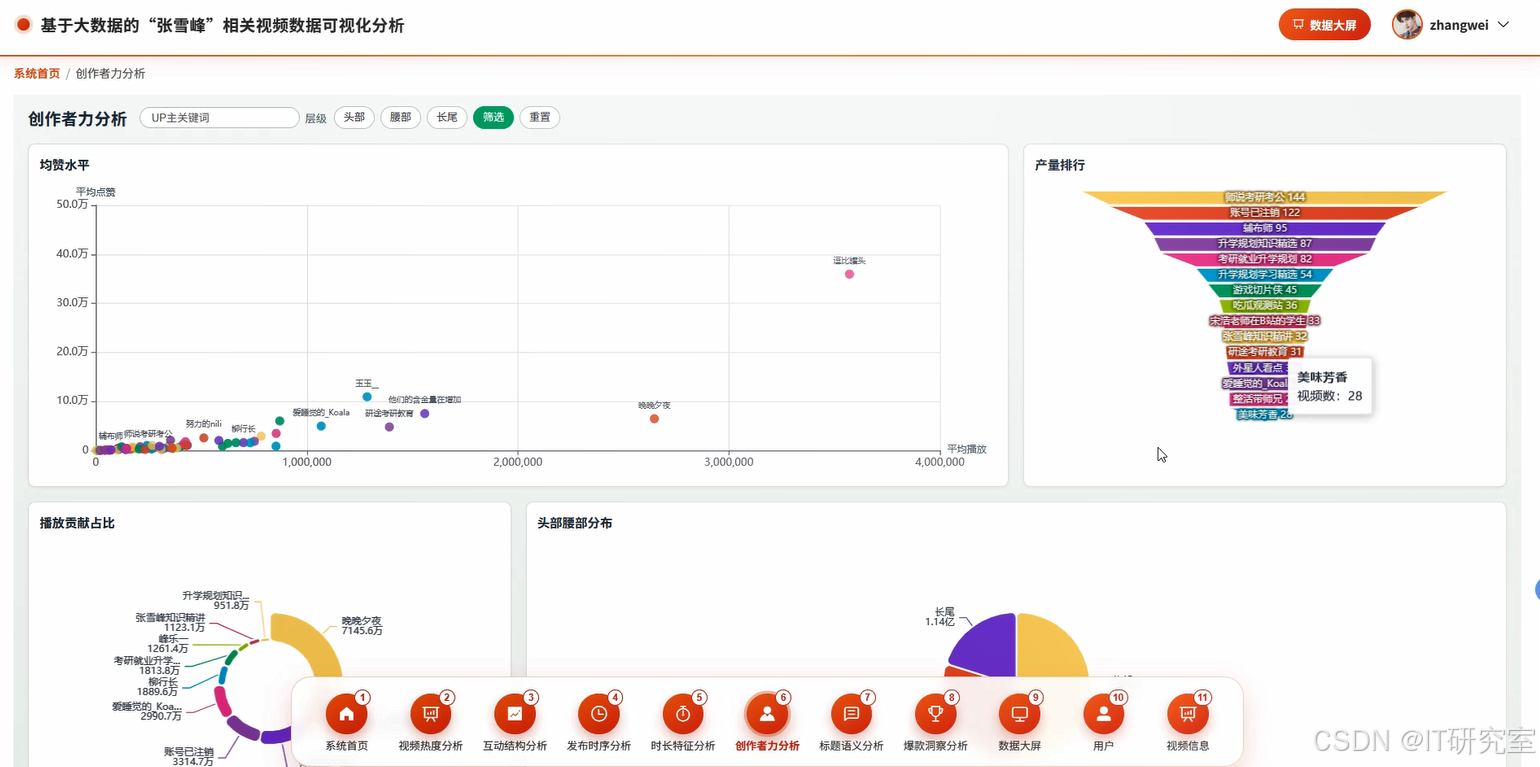
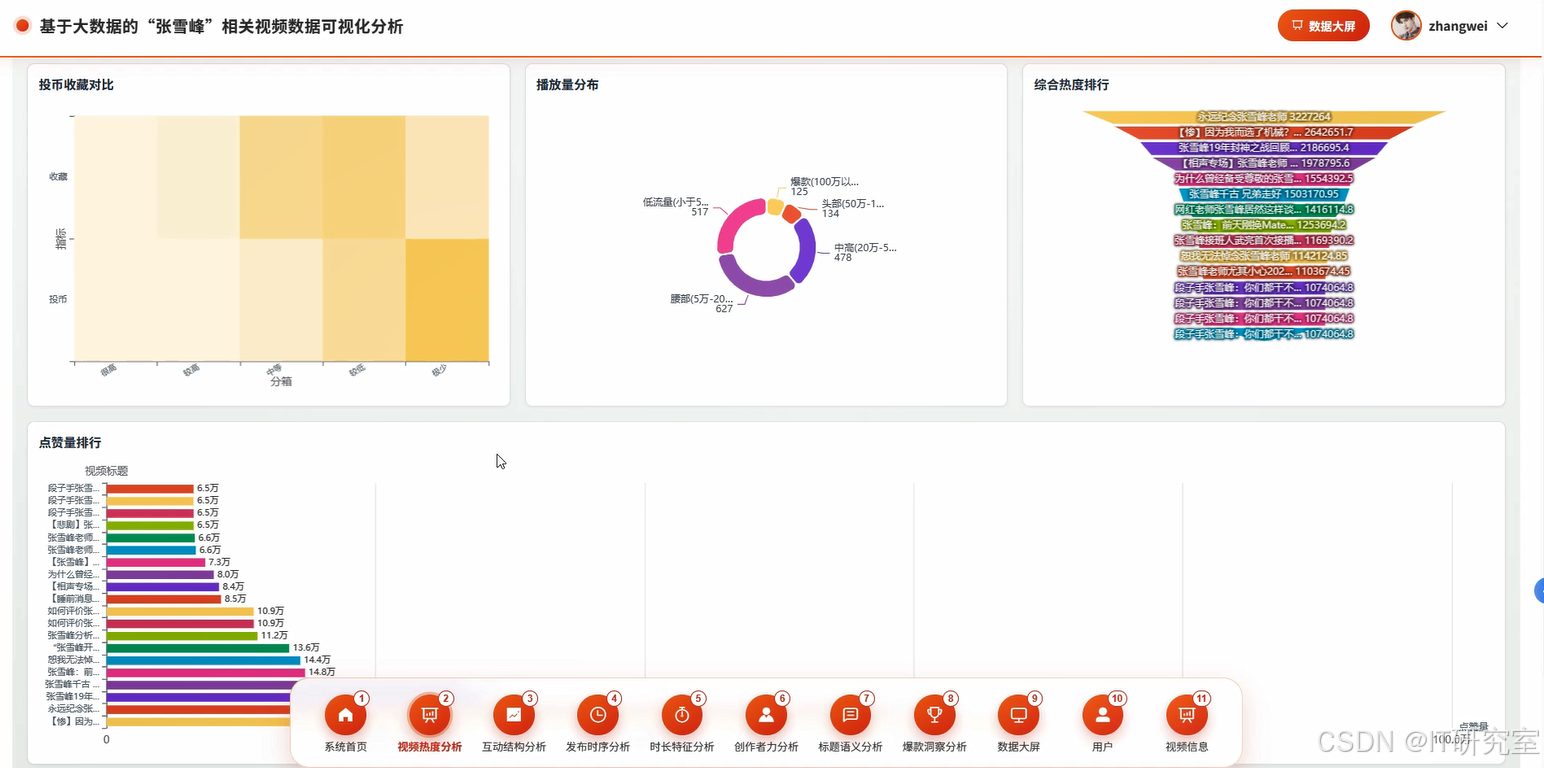
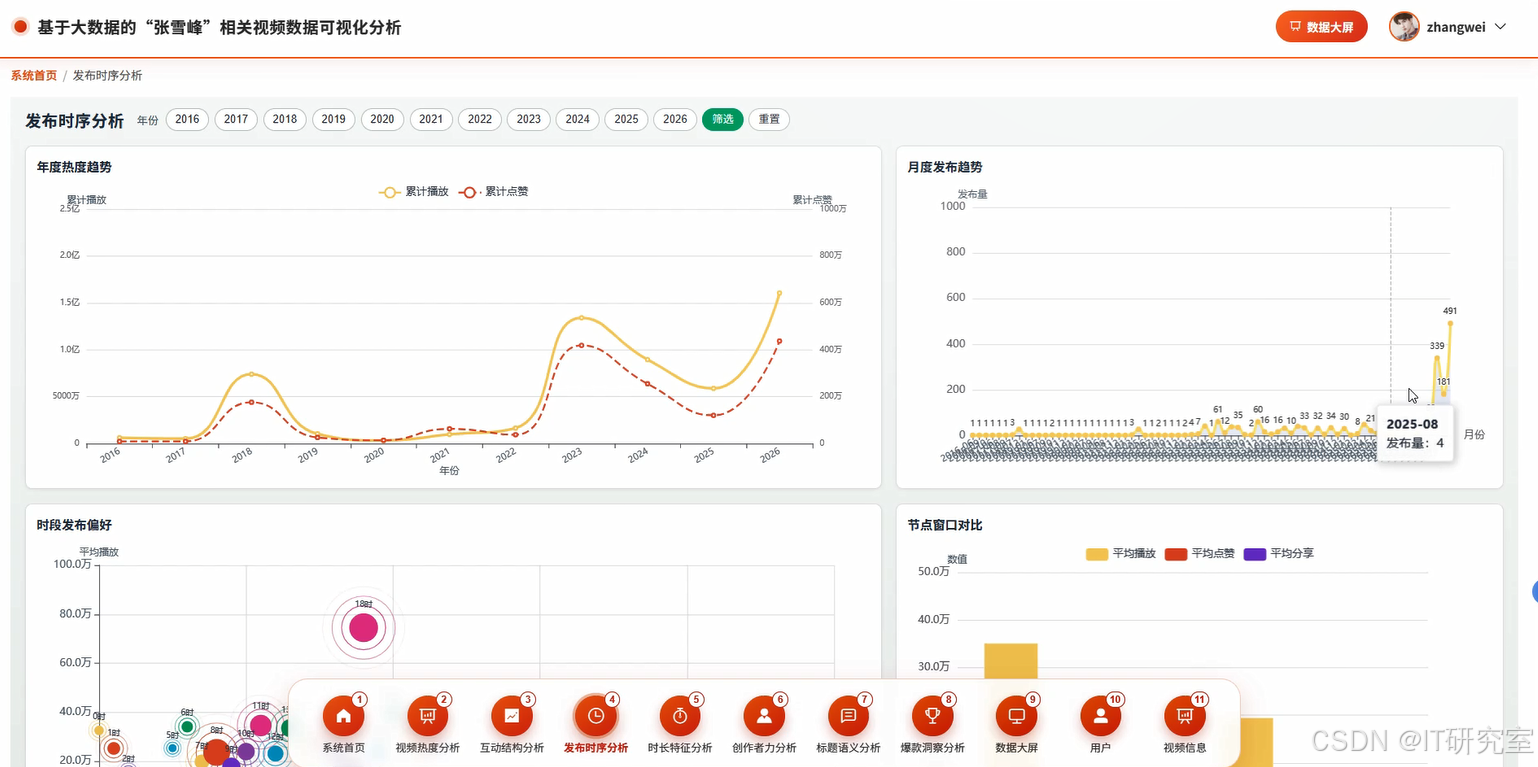
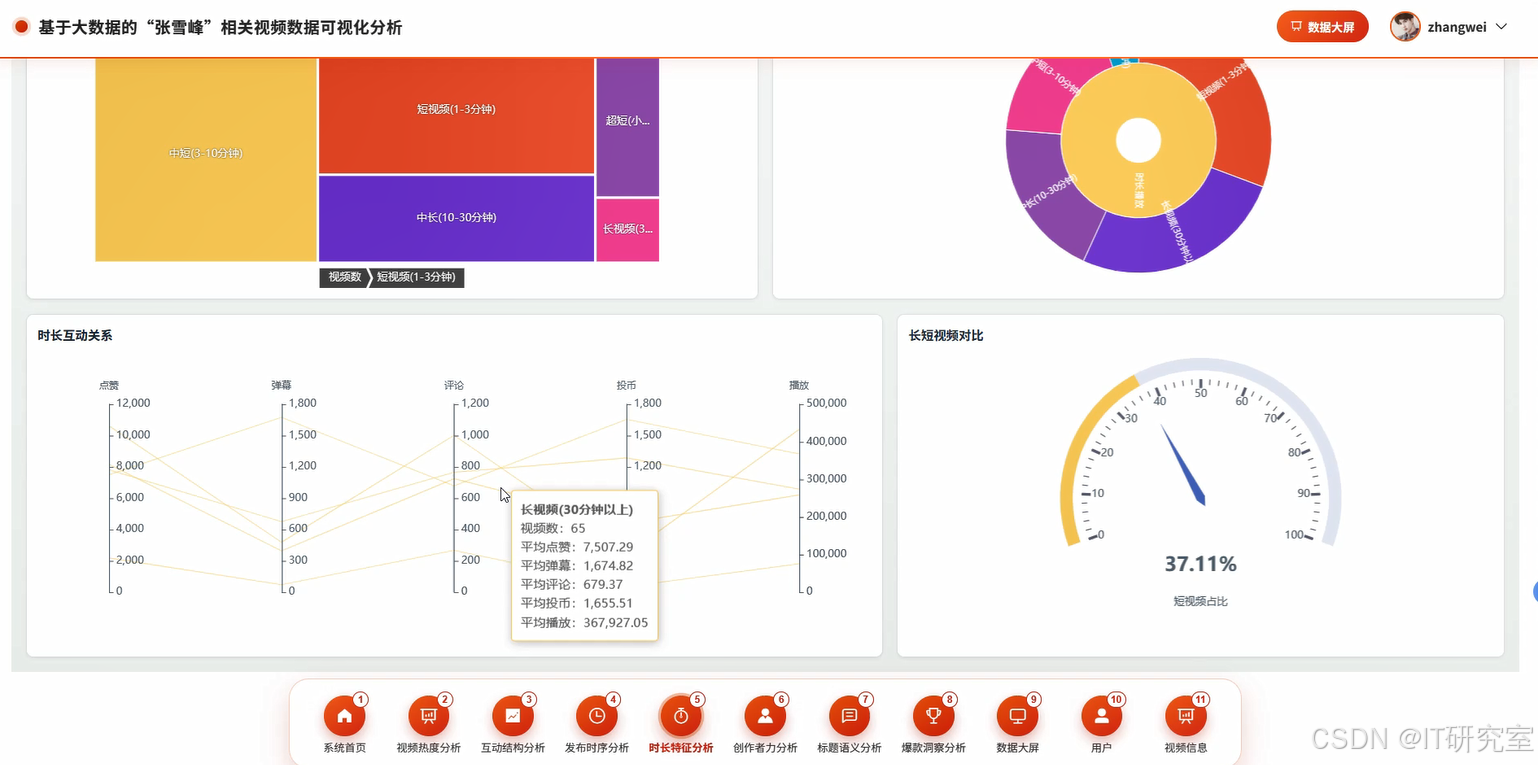
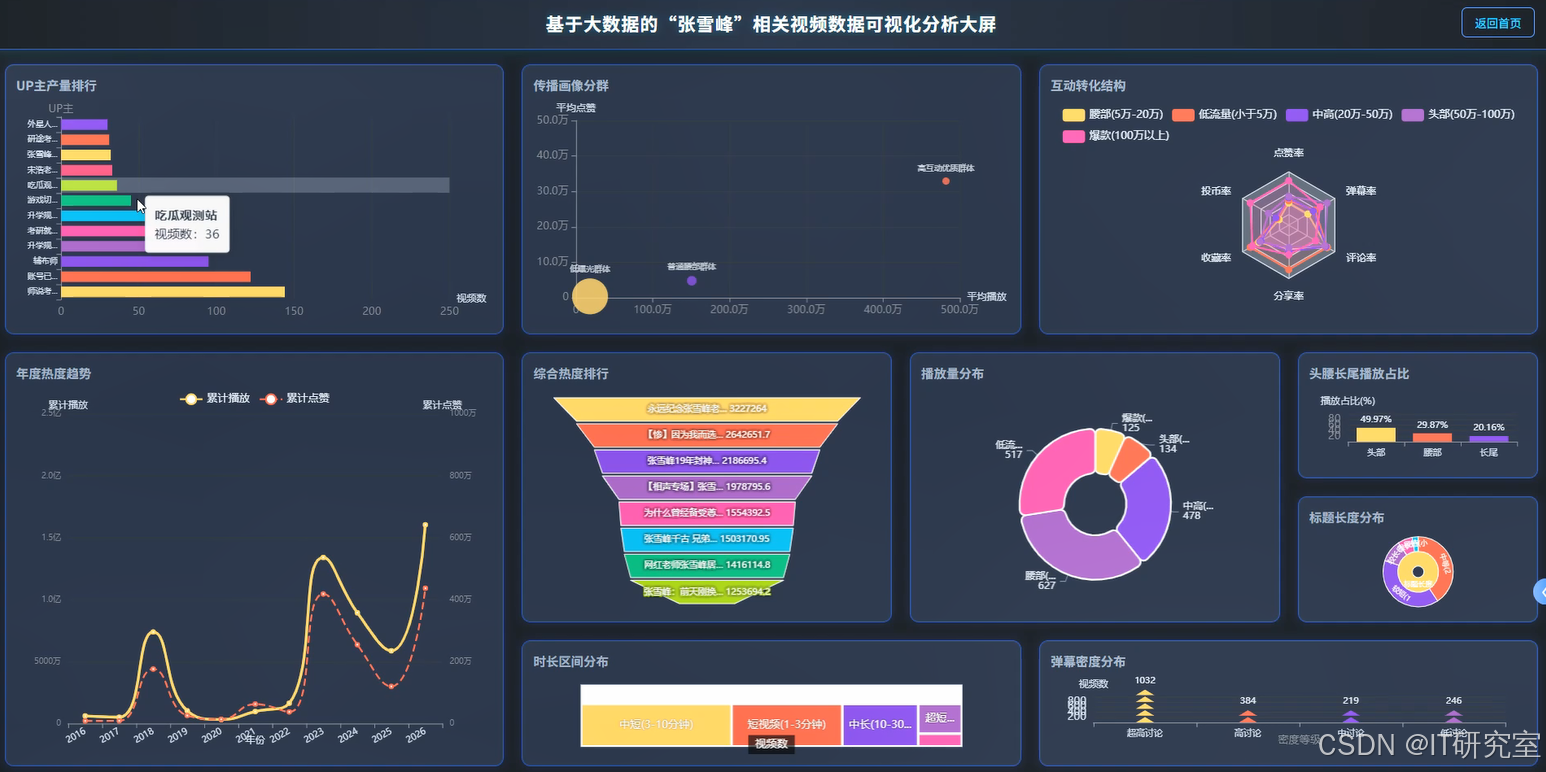
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
# 视频热度分析业务处理
def analyze_video_hot(video_df):
    spark = SparkSession.builder.appName("KaoyanVideoHotAnalysis").master("local[*]").getOrCreate()
    video_df.createOrReplaceTempView("video_table")
    hot_df = spark.sql("""
        SELECT video_id, title, author, play_count, like_count, comment_count, collect_count,
               (play_count * 0.4 + like_count * 0.3 + comment_count * 0.2 + collect_count * 0.1) AS hot_score
        FROM video_table
        WHERE play_count IS NOT NULL
    """)
    hot_df = hot_df.orderBy(hot_df["hot_score"].desc())
    hot_result = hot_df.limit(100).toPandas()
    hot_result["hot_level"] = pd.cut(hot_result["hot_score"], bins=[0, 1000, 5000, 10000, 100000],
                                     labels=["低热", "中热", "高热", "爆款"])
    hot_summary = hot_result.groupby("hot_level").agg(
        video_count=("video_id", "count"),
        avg_hot=("hot_score", "mean")
    ).reset_index()
    return hot_result.to_dict("records"), hot_summary.to_dict("records")
# 互动结构分析业务处理
def analyze_interaction_structure(video_df):
    spark = SparkSession.builder.appName("KaoyanVideoInteractionAnalysis").master("local[*]").getOrCreate()
    video_df.createOrReplaceTempView("interaction_table")
    interaction_df = spark.sql("""
        SELECT video_id, title, play_count, like_count, comment_count, collect_count, share_count,
               (like_count + comment_count + collect_count + share_count) AS total_interaction
        FROM interaction_table
        WHERE play_count > 0
    """)
    interaction_df = interaction_df.withColumn("like_rate", interaction_df["like_count"] / interaction_df["play_count"])
    interaction_df = interaction_df.withColumn("comment_rate", interaction_df["comment_count"] / interaction_df["play_count"])
    interaction_df = interaction_df.withColumn("collect_rate", interaction_df["collect_count"] / interaction_df["play_count"])
    interaction_df = interaction_df.withColumn("share_rate", interaction_df["share_count"] / interaction_df["play_count"])
    interaction_result = interaction_df.toPandas()
    interaction_result["interaction_type"] = interaction_result.apply(
        lambda row: "高赞型" if row["like_rate"] > 0.05 else ("高论型" if row["comment_rate"] > 0.01 else "普通型"), axis=1)
    type_summary = interaction_result.groupby("interaction_type").agg(
        video_count=("video_id", "count"),
        avg_like_rate=("like_rate", "mean"),
        avg_comment_rate=("comment_rate", "mean")
    ).reset_index()
    return interaction_result.to_dict("records"), type_summary.to_dict("records")
# 发布时序分析业务处理
def analyze_publish_time(video_df):
    spark = SparkSession.builder.appName("KaoyanVideoTimeAnalysis").master("local[*]").getOrCreate()
    video_df.createOrReplaceTempView("time_table")
    time_df = spark.sql("""
        SELECT video_id, title, publish_time, play_count, like_count, comment_count
        FROM time_table
        WHERE publish_time IS NOT NULL
    """)
    time_df = time_df.withColumn("publish_hour", hour(time_df["publish_time"]))
    time_df = time_df.withColumn("publish_date", to_date(time_df["publish_time"]))
    time_df = time_df.withColumn("publish_week", dayofweek(time_df["publish_time"]))
    hour_summary = time_df.groupBy("publish_hour").agg(
        video_count=("video_id", "count"),
        avg_play=("play_count", "mean"),
        avg_like=("like_count", "mean")
    ).orderBy("publish_hour")
    date_summary = time_df.groupBy("publish_date").agg(
        video_count=("video_id", "count"),
        avg_play=("play_count", "mean")
    ).orderBy("publish_date")
    week_summary = time_df.groupBy("publish_week").agg(
        video_count=("video_id", "count"),
        avg_play=("play_count", "mean")
    ).orderBy("publish_week")
    return hour_summary.toPandas().to_dict("records"), date_summary.toPandas().to_dict("records"), week_summary.toPandas().to_dict("records")
五、系统视频
基于大数据的考研相关视频数据可视化分析项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的考研相关视频数据可视化分析-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇