你以为 AI 讲得够详细,你就一定能学会?现实不是这样。
很多 AI 工具只负责把答案说出来,却不负责确认你是否理解、能不能迁移、下一次还记不记得。
这篇用 3 分钟讲清 DeepTutor:它不是把聊天框做得更花,而是把讲解、资料、练习和记忆串成学习过程。
DeepTutor 是什么
一句话概括:DeepTutor 是一个面向长期学习的开源 AI 工作区。
它把聊天、解题、深度研究、可视化、测验和掌握度练习放进同一个 Agent 运行时。项目目前约有 2.9 万 Star,采用 Apache-2.0 许可证,支持 Python 3.11+ 和 Next.js 16。
| 你想做的事 | DeepTutor 的对应能力 |
|---|---|
| 问问题、拆难题 | Chat、Solve、Deep Research |
| 把知识讲明白 | Tutor Agent、Visualize |
| 用自己的资料学习 | Knowledge Base、Book、Notebook |
| 检查自己是否真的会了 | Quiz、Mastery Path、学习仪表盘 |
| 让系统记住上下文 | L1/L2/L3 Memory、Memory Graph |
| 接入外部工具和 Agent | MCP、Skills、Partners、My Agents |
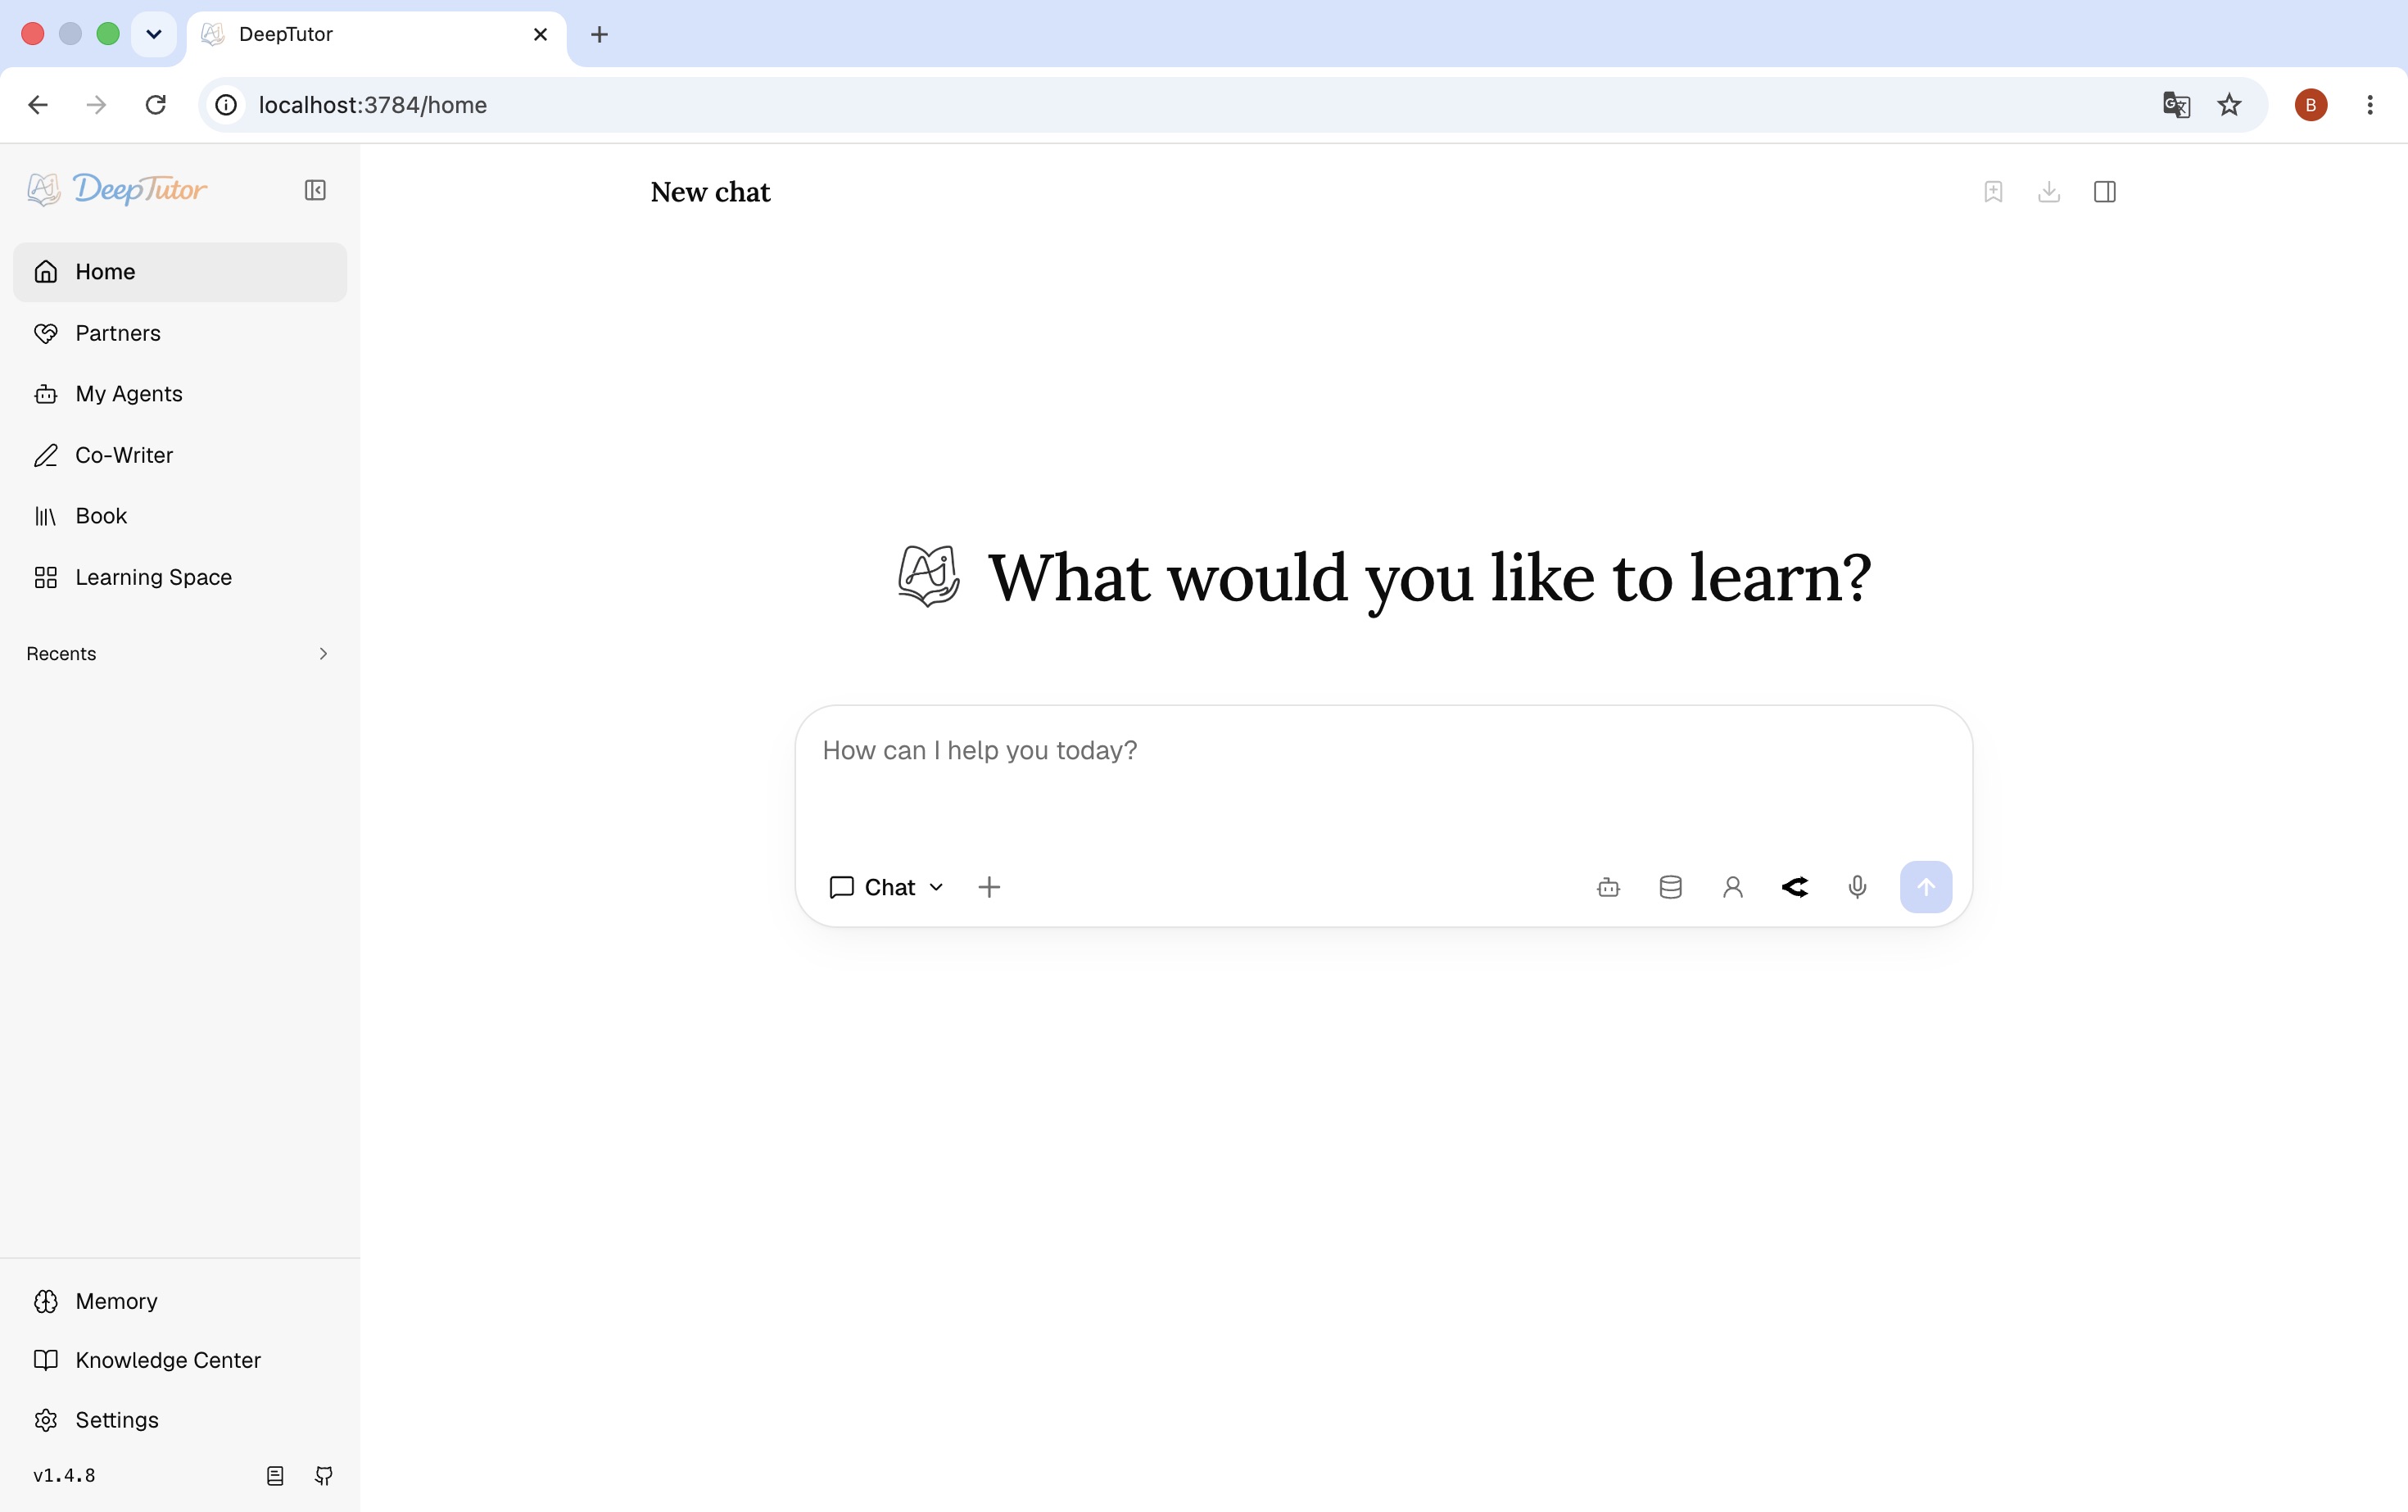
为什么"看懂了",还是不会做
普通聊天机器人往往是这样的:你提问,它给答案;你追问,它继续补充;对话结束,学习也结束。
问题在于,它通常没有持续追踪这几件事:
- 你的学习目标是什么;
- 你正在使用哪些资料;
- 哪些概念已经掌握,哪些地方一直卡住;
- 你能不能独立完成下一道类似问题。
DeepTutor 的反差就在这里:它不满足于"回答正确",而是试着把"理解、练习、反馈、复习"连起来。
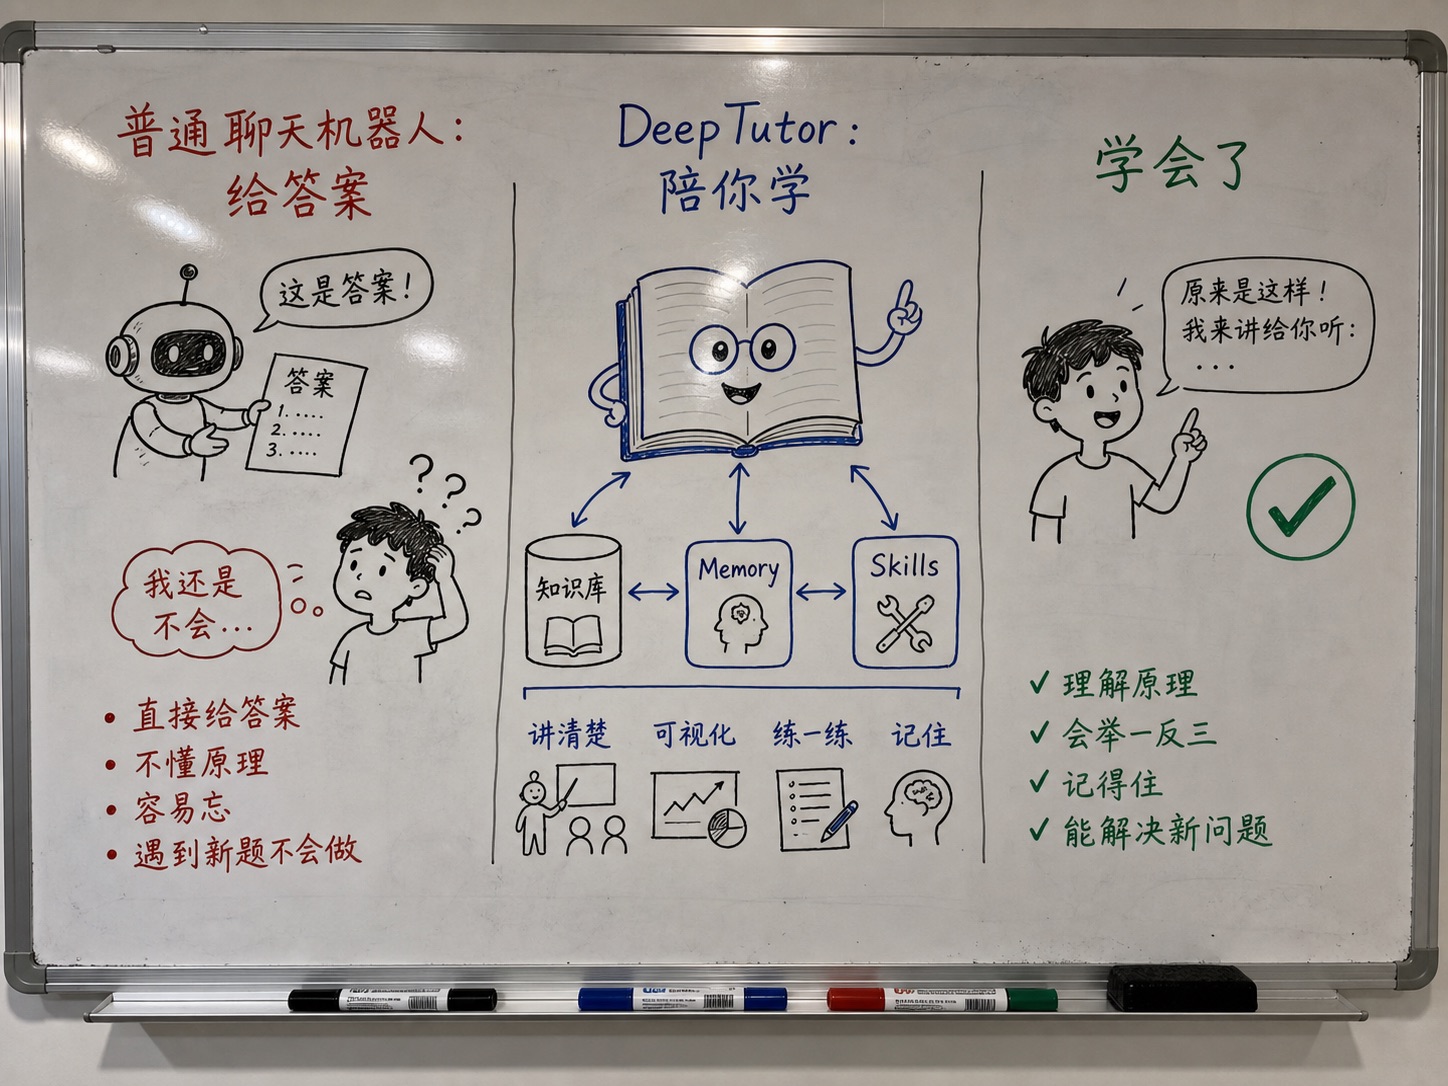
它把学习过程拆成了什么
1. 一套运行时,覆盖多种学习模式
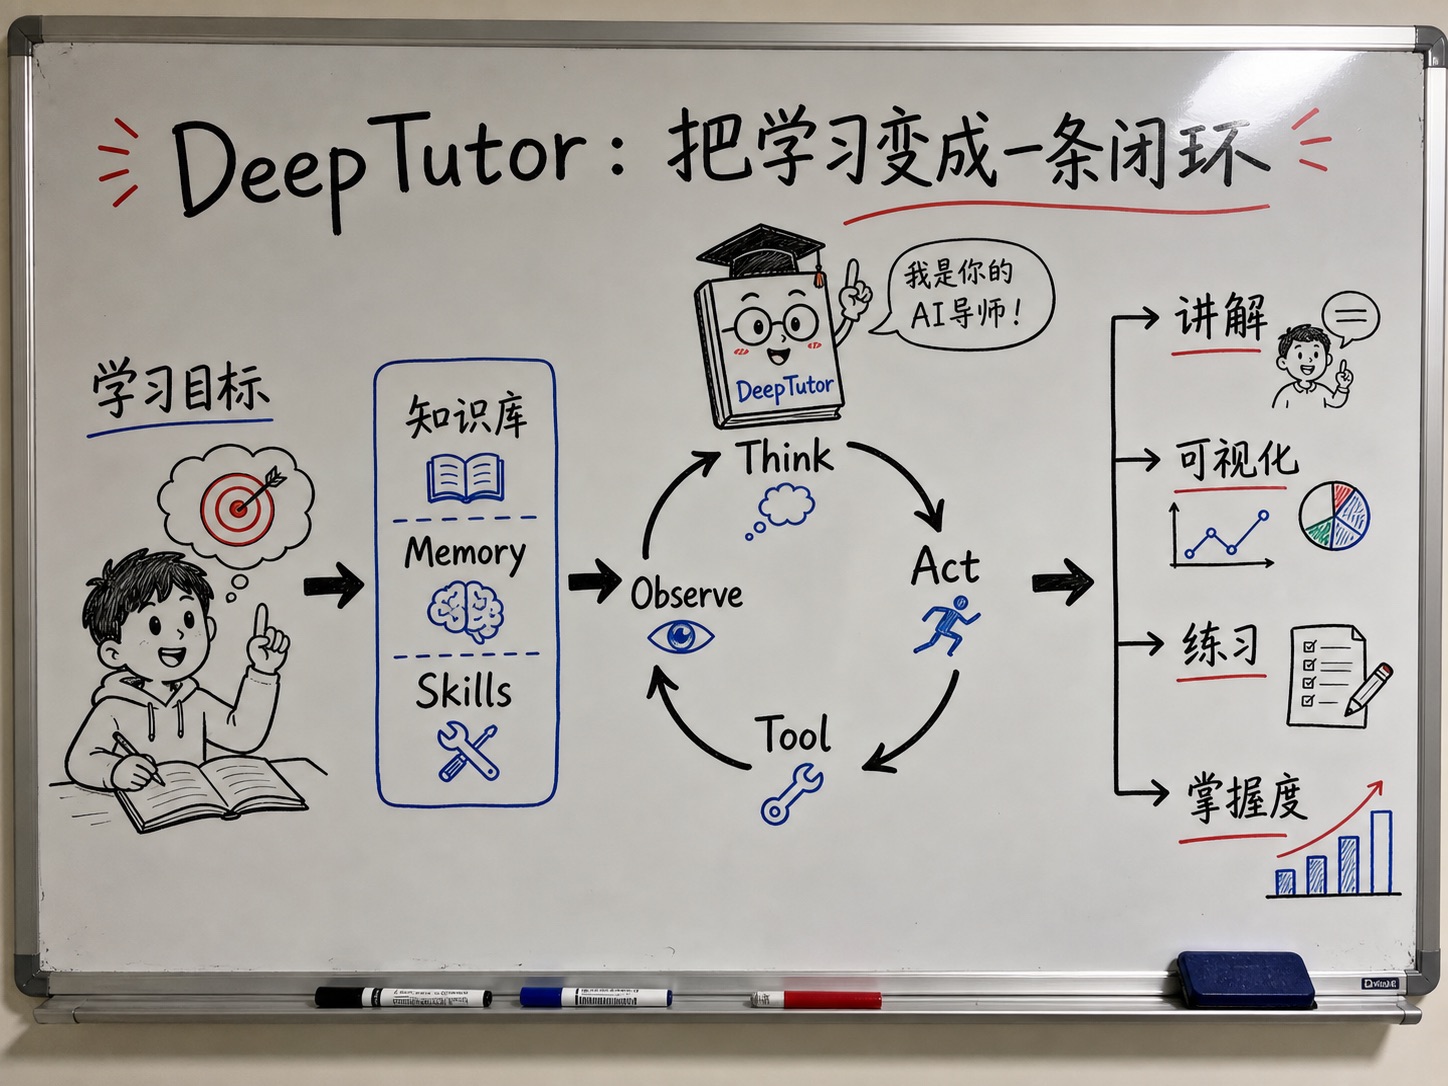
Chat、Quiz、Research、Visualize、Solve 和 Mastery Path 不是互相割裂的功能,而是共享同一套 Agent Loop。用户可以先让它讲解,再让它出题,最后根据答题结果继续练习。
2. 一份上下文,贯穿整个学习过程
知识库、书籍、笔记、问题集、Co-Writer 草稿、用户画像和 Memory,都可以成为后续回答的上下文。这样做的好处是:AI 不只是记住上一句,而是逐渐理解你正在学什么。
3. 多种检索引擎,适配不同资料
项目集成了 LlamaIndex、PageIndex、GraphRAG、LightRAG,也支持关联 Obsidian Vault。文档问答不再只有"切块后向量搜索"这一条路,最近版本还加入了基于 Agent 工具调用的 PageIndex 检索能力。
4. 记忆、Skills 和 Partners 可以继续扩展
Memory 负责积累学习轨迹,Skills 负责扩展能力,Partners 则可以连接 Claude Code、Codex 等外部 Agent 或持续协作的伙伴。
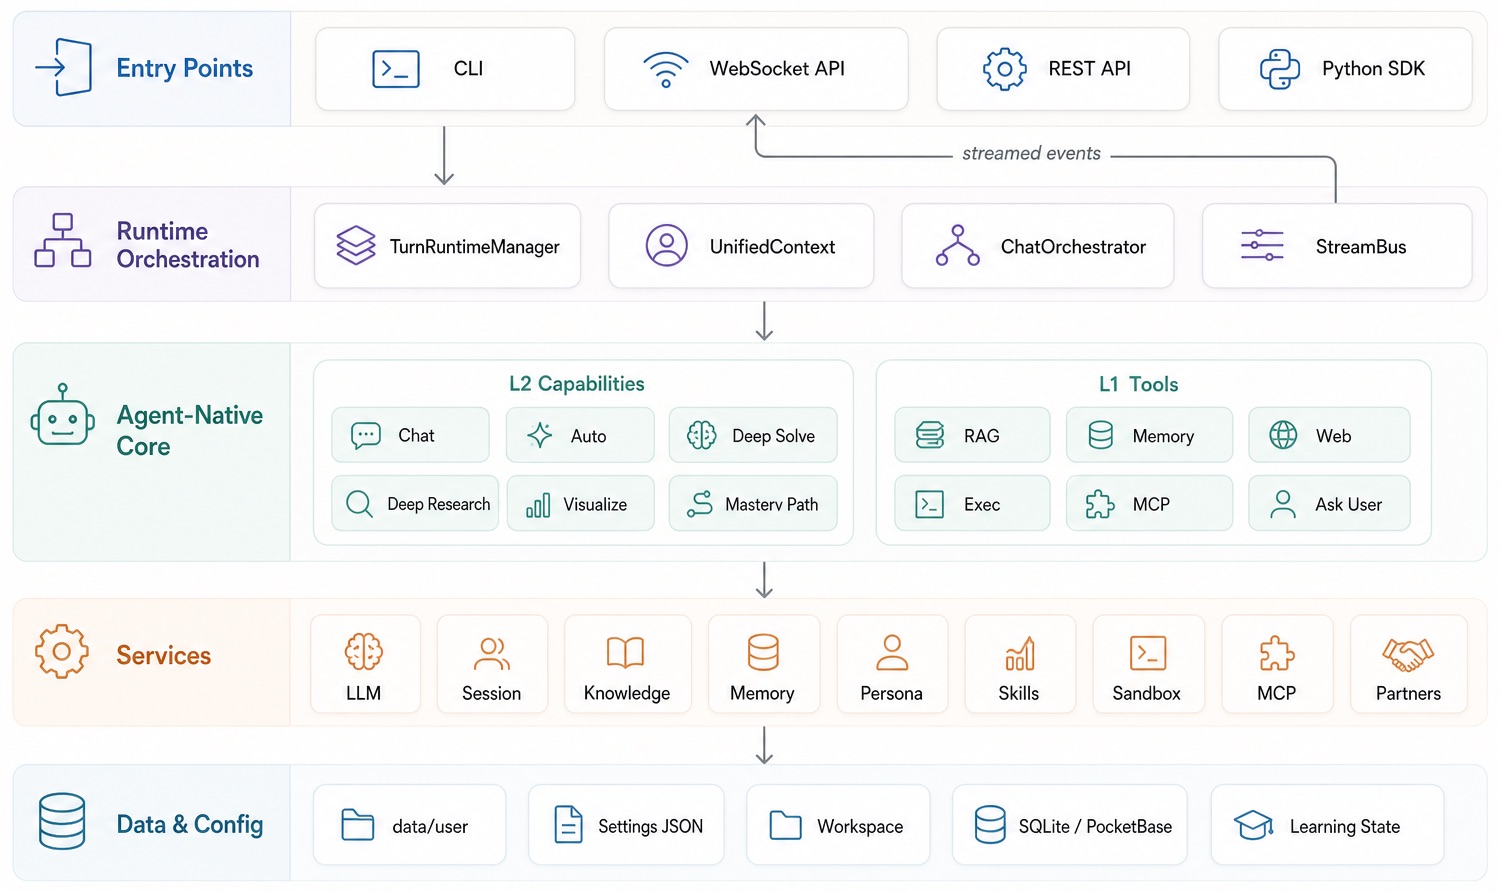
真正值得程序员看的,是这条 Agent Loop
从工程角度看,DeepTutor 最值得参考的不是某个页面,而是它把学习能力组织成了一个可观察的 Agent Loop:
Think → Act → Call Tool → Observe → Respond
每次运行都可以带上用户消息、会话历史、Memory、Persona 和 Skills,再通过工具调用检索资料、执行任务、生成可视化或发起练习。
这套设计给开发者的启发很直接:如果你的产品也需要"长期陪伴",不要只堆一个聊天框,应该把上下文、工具、记忆、反馈和评估设计成一条完整链路。
最近更新,说明它正在往哪里走
DeepTutor 在 2026 年 7 月 19 日发布的 v1.5.2,加入了可配置的聊天附件限制,以及通过 Agent 工具调用跨文档检索的 PageIndex 能力,同时继续扩展模型支持和学习工作区体验。
从最近一段版本演进看,它正在从"能问答的 AI 工具"走向"可持续运行的学习操作系统":有知识库,有记忆,有伙伴,有技能,还有可以复盘的运行轨迹。
适合谁,不适合谁
| 适合尝试的人 | 需要提前知道的事 |
|---|---|
| 想搭建 AI 学习产品的开发者 | 模型、Embedding 和资料质量仍然决定上限 |
| 有大量文档、课程、论文要消化的人 | 资料需要整理,不能指望导入后自动变完美 |
| 想研究 Agent、RAG、Memory 的人 | 功能比较多,建议从一个学习场景切入 |
| 已经在用 Obsidian 或知识库的人 | 更适合长期使用,不是一次性问答工具 |
它也不是"装上就能替你学会"的魔法。真正的价值,是把学习过程变得可持续、可追踪、可复盘。
3 分钟试一下
官方提供了 PyPI 安装方式,Python 3.11+、Node 20+ 环境可以先这样启动:
``bash mkdir -p my-deeptutor && cd my-deeptutor pip install -U deeptutor deeptutor init deeptutor start ``
默认前端地址是 http://127.0.0.1:3782。启动后,在 Web 设置里配置模型和 Embedding 服务,再导入一份自己的资料,观察它如何从"回答问题"变成"继续追问、检索、练习和反馈"。
小华的判断
DeepTutor 值得关注的地方,不是它又做了一个 AI 聊天页面,而是它把一个容易被忽略的问题摆到了台面上:AI 给出答案,不等于用户获得能力。
如果你正在做 AI 教育、企业知识库、个人知识管理或 Agent 产品,可以重点研究它的三件事:
- 如何让多个功能共享同一个 Agent Runtime; 2. 如何把 RAG、Memory 和 Skills 组合成长期上下文; 3. 如何用练习、掌握度和运行轨迹验证"真的学会了"。
下一步可以继续拆它的 Memory、Partners 和 Guided Learning 设计,这些部分比"接一个大模型 API"更值得借鉴。