【轻量化复刻大模型 / KIMI K3】Muon 优化器及 训练系统
0x00 论文溯源
分析范围: Muon 优化器原理、Per-Head 变体、Newton-Schulz 正交化、参数分组策略、QK-Clip、分布式 P2P Muon、学习率调度、训练循环、配置系统。
0.1 原始论文定位
| 论文 | 作者 | 机构 | 年份 | 出处 | arXiv ID |
|---|---|---|---|---|---|
| Muon: An Optimizer for Hidden Layers in Neural Networks | Keller Jordan, Yuchen Jin, Vlado Boza, You Jiacheng, Franz Cesista, Laker Newhouse, Jeremy Bernstein | 独立研究者 | 2024 | 博客 + 社区 | blog |
| Muon is Scalable for LLM Training | Jingyuan Liu, Jianlin Su 等 (Moonshot AI + UCLA) | Moonshot AI, UCLA | 2025.02 | 技术报告 | arXiv:2502.16982 |
| Old Optimizer, New Norm: An Anthology | Jeremy Bernstein, Laker Newhouse | --- | 2024 | 论文 | arXiv:2409.20325 |
核心关系:
- Jordan et al. (2024) 首次提出 Muon 优化器,基于 Newton-Schulz 迭代对梯度动量矩阵做正交化
- Bernstein & Newhouse (2024) 从谱范数最陡下降角度给出 Muon 的理论基础
- Liu et al. (2025, Moonshot AI) 解决了 Muon 的规模化问题------引入 weight decay、update RMS scaling、Per-Head 正交化,使 Muon 能够训练数十亿参数的 LLM。KIMI K3 的 Muon 实现直接基于此论文
0.2 论文相关图表
| 图/表 | 含义 |
|---|---|
| Liu et al. Figure 1 | Muon vs AdamW 的 SVD 熵对比------Muon 训练的权重矩阵保持更高的 SVD 熵,意味着更多方向的均匀学习 |
| Liu et al. Figure 3 | Update RMS 一致性分析------Per-Head 缩放使所有层的更新 RMS 保持一致 |
| Liu et al. Table 1 | 超参数配置表------Muon 和 AdamW 的最佳超参数组合 |
Figure 1
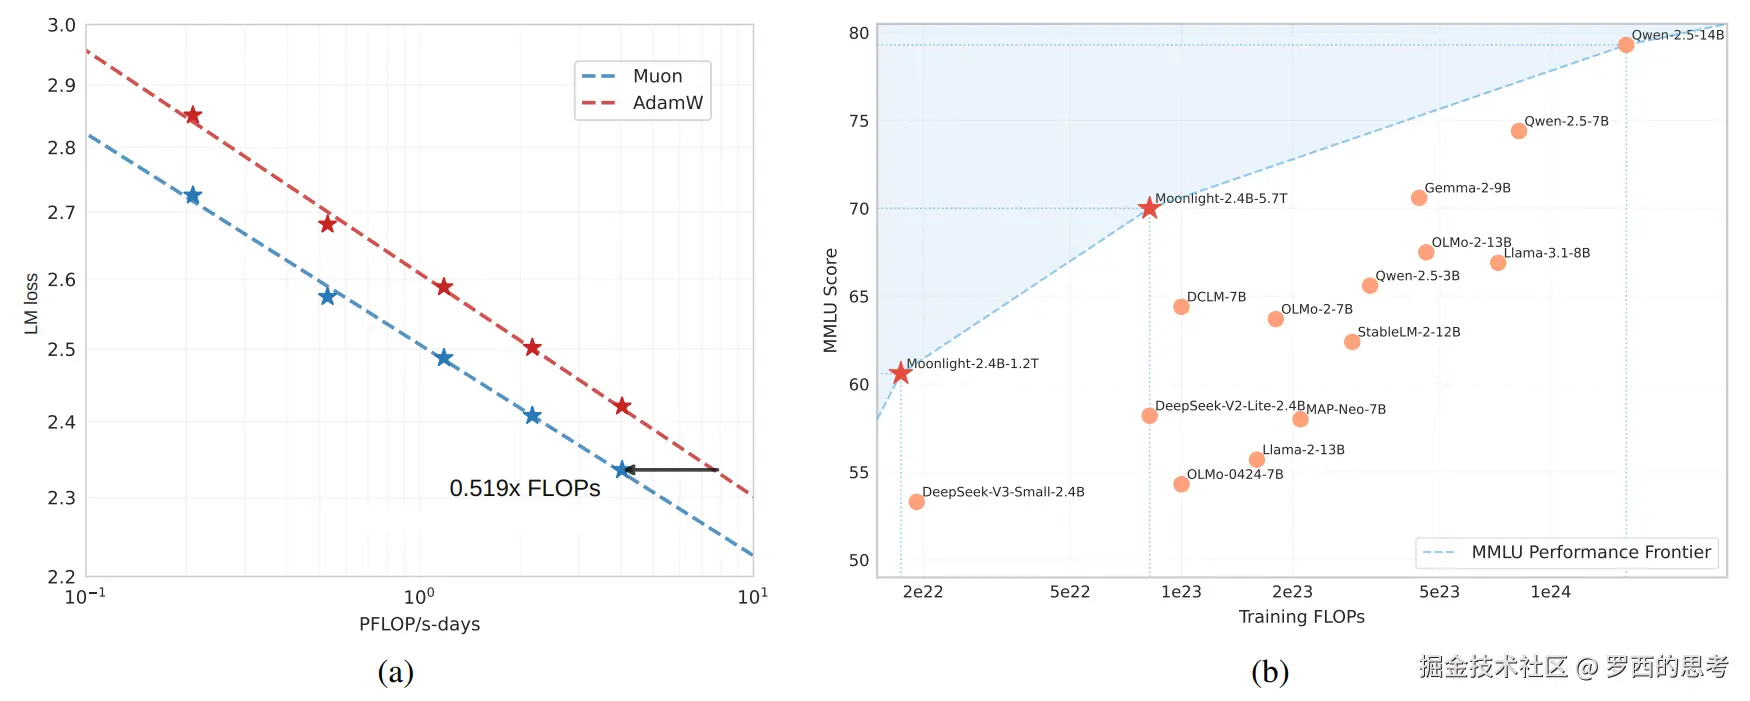
paper-fig-1
Figure 3
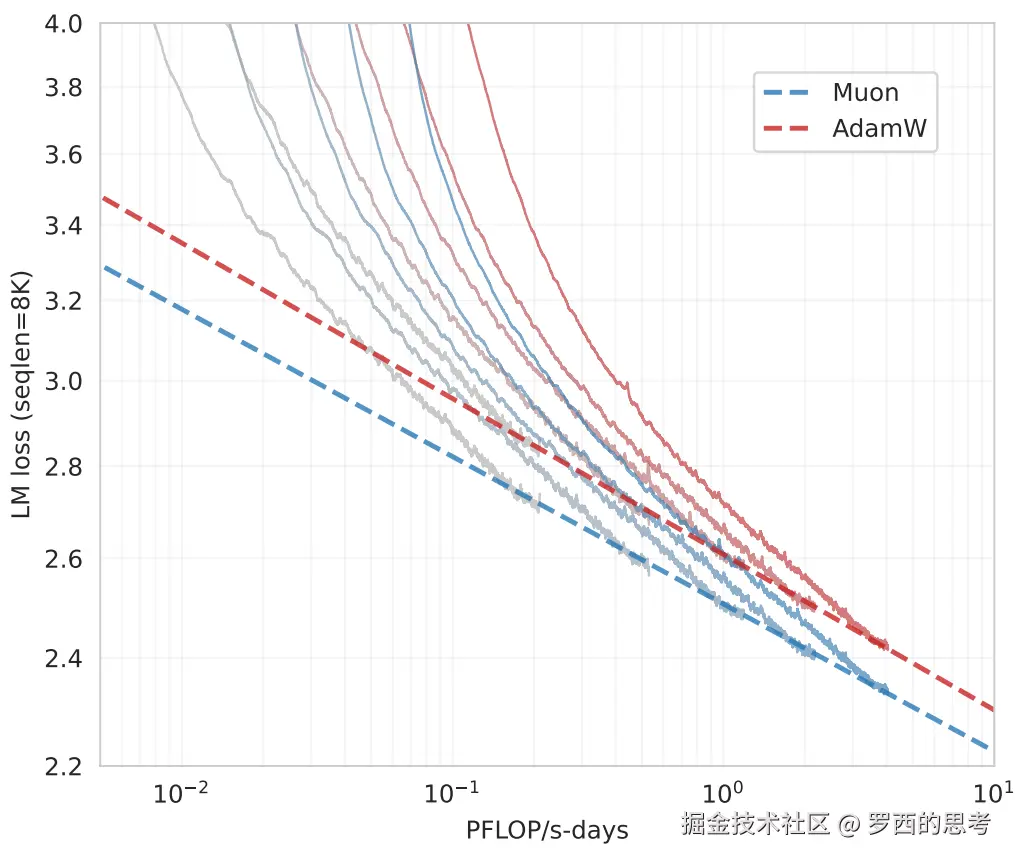
paper-fig-3
Table 1
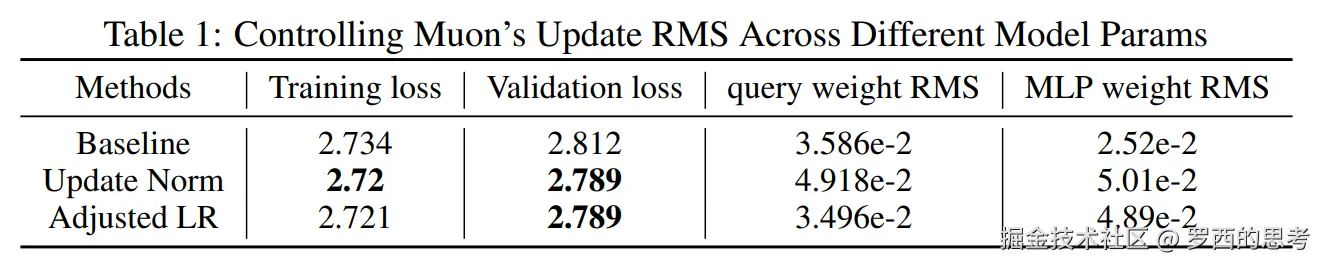
paper-tab-1
0.3 注意说明
- 项目github.com/RossiLH/Mod... 和系列博客是我的一个尝试,也是我学习的过程。不确定是否满足读者的需求,我自己会反思改进,也希望大家提出宝贵意见。
- 涉及 KIMI K3,DeepSeek V4,PI0.5,PI0.7 等模型。后续可能会跟踪新模型。
- 全 CPU 复刻,不涉及 GPU,也不涉及大规模训练(这是另外一个庞杂深邃的领域)和硬件。
- 模型的组件尽量是原始大模型的缩小版,如果组件没有开源版本,则用近似组件替代。
- 会解释每个组件在解决一个什么问题、这个问题难在哪、为什么只能这么解、解法的原理是什么,以及组件之间如何咬合成一个整体。重点不是记名词,而是理解一条主线。
- 每个主要组件都有可直接运行的 Gradio demo------无需 GPU。另有若干可视化脚本(
plot_*.py),可生成静态图。 - 所有文件行号基于本地源码快照;源码后续变化时,行号可能移动,但函数名和调用关系仍可作为定位入口。
- 为了保证每个文章可以尽量独立成文,所以有些内容会在不同文章中都存在,可能在系列层面上存在冗余,还请大家理解。
0x01. 演进脉络与定位
1.1 前身:从 SGD 到 AdamW 的"向量化"缺陷
Muon 的诞生源于一个长期被忽视的问题:标准优化器将矩阵参数视为一维向量,完全忽略了其矩阵结构。
| 前代方案 | 核心机制 | 关键缺陷 |
|---|---|---|
| SGD + Momentum | 逐元素更新,动量缓冲 | 不区分参数矩阵的不同方向,学习速率受最大奇异方向主导 |
| Adam/AdamW | 逐元素自适应学习率(二阶矩归一化) | 每个元素独立缩放,破坏矩阵的几何结构;计算开销大(维护两个动量缓冲) |
核心痛点 :假设一个权重矩阵 的梯度动量为 ,其奇异值分布不均匀(某些方向梯度大,某些方向梯度小)。Adam 对每个元素独立缩放,等价于在不同方向使用不同的学习率,导致:
- 梯度大的方向过度校正
- 梯度小的方向学习不足
- 整体训练动态不稳定
1.2 同期竞品
| 方案 | 核心机制 | 优势 | 劣势 |
|---|---|---|---|
| Muon | 矩阵正交化(Newton-Schulz) | 保持矩阵几何结构,更新方向均匀 | 仅适用于2D矩阵,需要额外正交化计算 |
| AdamW | 逐元素自适应 + 解耦 weight decay | 通用性强,工程成熟 | 忽略矩阵结构,SVD 熵低 |
| Lion | 符号动量(sign-based) | 内存高效(仅一个动量缓冲) | 粗糙的量化,丢失梯度幅值信息 |
| LAMB | 逐层信任比率缩放 | 大 batch 训练稳定 | 仍然逐元素操作,不利用矩阵结构 |
| SOAP | 分解 + Adam 风格 | 利用二阶信息 | 计算开销大,实现复杂 |
| Muon + AdamW 混合 | 矩阵参数用 Muon,其余用 AdamW | 兼顾两者优势 | 需要参数分组策略 |
1.3 定位一句话
不同于 AdamW 将权重矩阵视为独立元素集合逐元素归一化的做法,Muon 通过对梯度动量矩阵做整体正交化(Newton-Schulz 迭代),使更新方向在所有奇异方向上等幅,从而在保持矩阵几何结构的前提下实现更均匀、更高效的学习。
0x02 原理讲解
2.1 直觉类比视角
想象你站在一个山谷里(损失函数的低处),想走到更低的地方。Adam 相当于给你每只脚(每个参数)一双不同高度的鞋子------右脚的鞋子让你迈大步,左脚的鞋子让你迈小步。Muon 则不同:它给你一根"登山杖"(正交化的更新方向),让你在所有方向上以均匀的步伐前进,不会因为某个方向坡度陡就走得太猛,也不会因为某个方向坡度缓就走不动。
2.2 准专业水平视角
Muon 的核心更新公式:
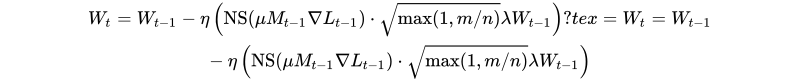
其中:
- : 权重矩阵
- : 动量缓冲,
- : Newton-Schulz 正交化------寻找最近的半正交矩阵
- : 动量系数
- : RMS 缩放因子------补偿正交化后矩阵纵横比对更新幅度的影响
- : weight decay 系数
Newton-Schulz 迭代(5 步 quintic 近似):
makefile
输入: 梯度动量 G ∈ R^{m×n}
步骤1: 归一化使谱半径 ≤ 1
步骤2: 重复5次:  X ← a·X + b·(X·X^T)·X + c·((X·X^T)²)·X
系数: a=3.4445, b=-4.7750, c=2.0315
输出: 近似半正交矩阵 O ≈ UV^T (G 的极分解正交因子)
与标准 AdamW 的公式级对比:
| 维度 | AdamW | Muon |
|---|---|---|
| 更新方向 | 逐元素: | 矩阵级: |
| 缩放依据 | 二阶矩(每个元素独立) | 矩阵谱范数(全局统一) |
| 动量缓冲 | 两个(一阶矩 + 二阶矩) | 一个(仅一阶动量) |
| Weight Decay | 解耦: | 解耦:(同) |
| 适用参数 | 所有参数 | 仅2D矩阵(其余用 AdamW) |
2.3 专家视角
为什么正交化在理论上有效?
从谱范数约束的角度(Chen et al., 2025),Muon 等价于在谱范数约束下的最优化问题。正交化后的更新方向 满足 ,这意味着:
- 更新方向的等幅性 :对于任意单位向量 ,,即所有方向的更新幅度相同
- SVD 熵最大化:正交化使权重矩阵的奇异值分布更均匀,保持更高的 SVD 熵,促进多方向学习
- 计算效率 :Newton-Schulz 迭代仅需矩阵乘法(无 SVD 分解),复杂度 ,5 步内收敛
Liu et al. (2025) 的关键发现:
- Weight Decay 的关键作用:原始 Muon(无 weight decay)在大规模训练中不稳定。加入 weight decay 后,权重的增长被约束,正交化更有效
- Update RMS 一致性 :不同大小的矩阵经正交化后,更新 RMS 差异很大。通过 缩放 + 0.2 固定系数,使所有层的更新 RMS 保持在 0.2~0.4(与 AdamW 对齐)
- Per-Head 正交化:全矩阵正交化会将所有头的更新统一到一个尺度,导致头间不均衡。Per-Head 模式将矩阵按注意力头拆分,独立正交化
未解决的理论问题:
- Newton-Schulz 迭代的收敛边界与模型规模的关系
- Muon 在 SFT(监督微调)阶段的理论保证
- 分布式设置下的最优通信-计算权衡
2.4 代码
ini
"""Muon 优化器核心实现。

Muon 通过对梯度动量矩阵做 Newton-Schulz 正交化来计算更新方向,
使更新在所有奇异方向上等幅,从而更高效地训练神经网络的2D权重矩阵。

参考:
    - Jordan et al., 2024, "Muon: An optimizer for hidden layers"
    - Liu et al., 2025, "Muon is Scalable for LLM Training" (arXiv:2502.16982)
"""
from optim.newton_schulz import match_update_rms, newton_schulz

# Per-Head 正交化的注意力投影层后缀
_PER_HEAD_SUFFIXES = ("q_proj", "k_proj", "v_proj", "q_up", "k_up", "v_up")

def per_head_orthogonalize(
    matrix: Tensor,
    num_heads: int,
    *,
    steps: int = 5,
    eps: float = 1e-7,
) -> Tensor:
    """Per-Head 正交化:将矩阵按注意力头拆分,独立正交化每个头。

    全矩阵正交化会将所有头的更新统一到一个尺度,导致头间不均衡。
    Per-Head 模式给每个头独立的归一化,使头间更新尺度一致。

    注意:RMS 缩放不在此函数内执行,而是在 Muon step 中用全矩阵维度统一处理(与 kimi3-master 一致)。

    Args:
        matrix: 权重矩阵,shape (out_dim, in_dim),其中 out_dim = num_heads * head_dim
        num_heads: 注意力头数
        steps: Newton-Schulz 迭代步数
        eps: 数值稳定性常数

    Returns:
        正交化后的矩阵,shape 与输入相同
    """
    out_dim, in_dim = matrix.shape
    assert out_dim % num_heads == 0, (
        f"out_dim {out_dim} 不能被 num_heads {num_heads} 整除"
    )
    head_dim = out_dim // num_heads

    # 拆分为 per-head 块: (num_heads, head_dim, in_dim)
    blocks = matrix.view(num_heads, head_dim, in_dim)

    # 对每个头独立正交化(批处理 NS)
    ortho_blocks = newton_schulz(blocks, steps=steps, eps=eps)

    # 合并回原始形状
    return ortho_blocks.view(out_dim, in_dim)

class Muon(torch.optim.Optimizer):
    """Muon 优化器:对2D矩阵参数使用 Newton-Schulz 正交化更新。

    Muon 的更新规则:
    1. 动量累积: buf = μ * buf + grad
    2. Nesterov 加速: update = grad + μ * buf
    3. 正交化: ortho = NS(update)
    4. RMS 缩放: scale = sqrt(max(1, out_dim / in_dim))
    5. Weight Decay: p = p * (1 - lr * λ)
    6. 参数更新: p = p - lr * scale * ortho

    参数分组:
    - use_muon=True: 2D 矩阵参数,使用 Muon 更新
    - use_muon=False: 1D 参数(bias/norm/embedding),使用 AdamW 更新
    - num_heads: 注意力投影层的头数,启用 Per-Head 正交化

    示例:
        >>> model = nn.Linear(64, 128)
        >>> groups = [{"params": model.parameters(), "use_muon": True}]
        >>> optimizer = Muon(groups, lr=1e-3)
    """

    def __init__(
        self,
        param_groups: list[dict[str, Any]],
        *,
        lr: float = 1e-3,
        adamw_lr: float = 3e-4,
        momentum: float = 0.95,
        nesterov: bool = True,
        ns_steps: int = 5,
        weight_decay: float = 0.1,
        betas: tuple[float, float] = (0.9, 0.95),
        eps: float = 1e-8,
        weight_clip: float = 0.0,
        update_rms_scaling: bool = True,
    ):
        """
        Args:
            param_groups: 参数组列表,每组包含 params, use_muon, num_heads
            lr: Muon 学习率
            adamw_lr: AdamW 学习率(用于 use_muon=False 的组)
            momentum: 动量系数
            nesterov: 是否使用 Nesterov 加速
            ns_steps: Newton-Schulz 迭代步数
            weight_decay: weight decay 系数
            betas: AdamW 的 beta 参数
            eps: AdamW 的 epsilon
            weight_clip: Kimi K2 权重裁剪阈值(0=禁用)
            update_rms_scaling: 是否启用 RMS 缩放
        """
        defaults = dict(
            lr=lr,
            adamw_lr=adamw_lr,
            momentum=momentum,
            nesterov=nesterov,
            ns_steps=ns_steps,
            weight_decay=weight_decay,
            betas=betas,
            eps=eps,
            weight_clip=weight_clip,
            update_rms_scaling=update_rms_scaling,
            use_muon=True,
            num_heads=None,
        )
        super().__init__(list(param_groups), defaults)

    @torch.no_grad()
    def step(self, closure=None):
        """执行一步优化。

        Returns:
            loss(如果提供了 closure),否则 None
        """
        loss = None
        if closure is not None:
            with torch.enable_grad():
                loss = closure()

        for group in self.param_groups:
            if group.get("use_muon", True):
                self._muon_step(group)
            else:
                self._adamw_step(group)

        return loss

    def _muon_step(self, group: dict[str, Any]) -> None:
        """Muon 更新:正交化动量 + RMS 缩放 + weight decay。"""
        lr = group["lr"]
        momentum = group["momentum"]
        heads = group.get("num_heads")
        ns_steps = group["ns_steps"]
        eps = group["eps"]
        weight_decay = group["weight_decay"]
        weight_clip = group["weight_clip"]
        rms_scaling = group["update_rms_scaling"]

        for p in group["params"]:
            if p.grad is None:
                continue

            grad = p.grad
            state = self.state[p]

            # 初始化动量缓冲
            if "momentum_buffer" not in state:
                state["momentum_buffer"] = torch.zeros_like(grad)

            buf = state["momentum_buffer"]

            # 步骤1: 动量累积
            buf.mul_(momentum).add_(grad)

            # 步骤2: Nesterov 加速
            update = grad.add(buf, alpha=momentum) if group["nesterov"] else buf

            # 步骤3: 正交化(与 kimi3-master 一致:per_head 不额外做 RMS 缩放)
            if heads is not None and heads > 1:
                ortho = per_head_orthogonalize(
                    update, heads, steps=ns_steps, eps=eps
                )
            else:
                ortho = newton_schulz(update, steps=ns_steps, eps=eps)
                if rms_scaling:
                    ortho = match_update_rms(ortho, mode="shape")

            # 步骤4: Weight Decay(解耦)
            if weight_decay:
                p.mul_(1.0 - lr * weight_decay)

            # 步骤5: 参数更新
            out_dim, in_dim = p.shape[-2], p.shape[-1]
            scale = math.sqrt(max(1.0, out_dim / in_dim))
            p.add_(ortho, alpha=-lr * scale)

            # 步骤6: Kimi K2 Weight Clipping
            if weight_clip > 0:
                rms = p.pow(2).mean().sqrt()
                if float(rms) > weight_clip:
                    p.mul_(weight_clip / rms)

    def _adamw_step(self, group: dict[str, Any]) -> None:
        """标准 AdamW 更新(用于非矩阵参数)。"""
        lr = group.get("adamw_lr", group["lr"])
        beta1, beta2 = group["betas"]
        eps = group["eps"]
        weight_decay = group["weight_decay"]

        for p in group["params"]:
            if p.grad is None:
                continue

            grad = p.grad
            state = self.state[p]

            # 初始化状态
            if "step" not in state:
                state["step"] = 0
                state["exp_avg"] = torch.zeros_like(p)
                state["exp_avg_sq"] = torch.zeros_like(p)

            state["step"] += 1
            t = state["step"]
            exp_avg, exp_avg_sq = state["exp_avg"], state["exp_avg_sq"]

            # 一阶矩和二阶矩
            exp_avg.mul_(beta1).add_(grad, alpha=1 - beta1)
            exp_avg_sq.mul_(beta2).addcmul_(grad, grad, value=1 - beta2)

            # 偏差校正
            bc1 = 1 - beta1 ** t
            bc2 = 1 - beta2 ** t

            # 更新
            denom = (exp_avg_sq / bc2).sqrt_().add_(eps)
            if weight_decay:
                p.mul_(1.0 - lr * weight_decay)
            p.addcdiv_(exp_avg / bc1, denom, value=-lr)
0x03 本项目实现
3.1 与 kimi3-master 实现对比
| 维度 | kimi3-master | 我们的实现 | 区别说明 |
|---|---|---|---|
| 文件结构 | muon.py 单文件(276行)含 NS + Muon + 参数分组 + build_optimizer |
拆分为 3 文件:newton_schulz.py + muon.py + param_groups.py |
更模块化,NS 可独立测试复用 |
| Newton-Schulz | 内联在 muon.py,batched 用 .mT |
独立文件,显式分 2D 路径(.T)和 batched 路径(.mT) |
逻辑等价,PyTorch 3.7 兼容性更好 |
_head_count |
isinstance(owner, (KimiDeltaAttention, GatedMLA)) 硬编码类型检查 |
hasattr(owner, "num_heads") 鸭子类型 |
零耦合,不依赖具体模块导入 |
muon_param_groups |
接收 optim_cfg dataclass 对象 |
接收 per_head: bool 直接参数 |
更简洁,但缺少 build_optimizer 工厂 |
| embedding 排除 | 仅排除 "embed_tokens" |
额外排除 "embed"(覆盖 pos_embed 等) |
更宽泛的排除规则 |
build_optimizer |
有,从 optim_cfg 读全部超参构造 Muon |
缺失 | 需手动构造 Muon 实例 |
| RMS 缩放 | 内联 scale = sqrt(max(1, out/in)),无独立函数 |
独立 match_update_rms() 函数,支持 shape/reference_rms 两种模式 |
更灵活,但多了一层抽象 |
| Weight Clipping | 独立 _clip() 静态方法 |
内联到 _muon_step |
逻辑相同,组织不同 |
Muon.__init__ |
无 update_rms_scaling 参数 |
有 update_rms_scaling 开关 |
可控制是否启用 RMS 缩放 |
| HybridMuonAdamW | 无(Muon 类自身同时处理 Muon+AdamW 组) | 额外提供 HybridMuonAdamW 包装器,含 NaN 检测、事务性 step |
更模块化,但 kimi3-master 不需要 |
| CosineWarmupLR | 无调度器类,仅函数 + 训练循环内 set_lr |
完整 CosineWarmupLR 类,支持双 LR |
更工程化,但 kimi3-master 在训练循环中手动处理 |
| P2P Muon | 完整实现(168行) | ✅ 已实现(~220行) | 功能等价,28 项测试通过,详见附录 G |
说明:
-
build_optimizer工厂:可从OptimConfig读取超参自动构造,但我们的设计允许更灵活的手动构造 -
lr_lambda_for:被CosineWarmupLR类替代(内部 dispatch cosine/wsd) -
schedules.py(63行)→ 已覆盖 ,功能在lr_scheduler.py中:cosine_with_warmup()→ 直接复刻,逻辑一致wsd_schedule()→ 直接复刻,逻辑一致lr_lambda_for()→ 被CosineWarmupLR类替代(内部 dispatch cosine/wsd)
-
muon_p2p.py(168行)→ ✅ 已实现 (src/optim/muon_p2p.py,~220行):OwnershipMap→ round-robin 所有权分配P2PMuonOrthogonalizer→ P2P 收集 → NS 正交化 → P2P 分发orthogonalize_owned()→ 一次性便捷函数shard_ranges()→ 本地实现,与parallel/zero.py共享
3.2 模块结构(文件级)
ruby
src/optim/
├── __init__.py              # 公开 API 导出
├── newton_schulz.py         # [基础层] Newton-Schulz 正交化 + RMS 缩放
│   ├── newton_schulz()      #   2D 和 batched 正交化
│   └── match_update_rms()   #   RMS 缩放(shape/reference_rms 两种模式)
├── muon.py                  # [核心层] Muon 优化器
│   ├── per_head_orthogonalize()  # Per-Head 正交化(按注意力头拆分)
│   └── class Muon           #   动量+Nesterov+NS+RMS+WD+Clip
├── param_groups.py          # [策略层] 参数自动分组
│   ├── _head_count()        #   检测注意力头数(鸭子类型)
│   └── build_muon_param_groups()  # 2D矩阵→Muon / 其余→AdamW
├── hybrid.py                # [包装层] 混合优化器
│   └── class HybridMuonAdamW  # NaN检测+事务性step+双LR
├── lr_scheduler.py          # [调度层] 学习率调度
│   ├── cosine_with_warmup() #   Cosine 函数
│   ├── wsd_schedule()       #   WSD 函数
│   └── class CosineWarmupLR #   调度器(支持双LR)
├── base.py                  # [抽象层] Optimizer 基类(可选)
└── schedule.py              # [抽象层] LRSchedule 基类(可选)
3.3 类继承与组合关系
bash
torch.optim.Optimizer
    └── Muon                          # 继承 PyTorch Optimizer
            ├── 内部 dispatch:
            │   ├── _muon_step()      # Muon 组更新
            │   └── _adamw_step()     # AdamW 组更新
            └── 依赖:
                ├── newton_schulz()   # 标准正交化
                └── per_head_orthogonalize()  # Per-Head 正交化

HybridMuonAdamW                      # 独立包装器(非继承)
    ├── muon: Muon                    # 组合 Muon 实例
    ├── adamw: torch.optim.AdamW      # 组合 AdamW 实例
    └── 功能: NaN检测 / 事务性step / set_lr / state_dict

CosineWarmupLR                       # 独立调度器
    └── 持有 optimizer 引用,直接操作 param_groups["lr"]
3.4 与 kimi3-master 的文件映射
scss
kimi3-master/optim/              →    Model-Viz/src/optim/
─────────────────────────────────────────────────────────
muon.py (276行)                      newton_schulz.py (120行)
  ├── newton_schulz()                ├── newton_schulz()
  ├── _orthogonalise()               └── match_update_rms()
  ├── class Muon                     muon.py (242行)
  ├── _head_count()                  ├── per_head_orthogonalize()
  ├── muon_param_groups()            └── class Muon
  └── build_optimizer()              param_groups.py (95行)
                                      ├── _head_count()
schedules.py (63行)                   └── build_muon_param_groups()
  ├── cosine_with_warmup()           lr_scheduler.py (143行)
  ├── wsd_schedule()                 ├── cosine_with_warmup()
  └── lr_lambda_for()                ├── wsd_schedule()
                                      └── class CosineWarmupLR
muon_p2p.py (168行)                  hybrid.py (118行)
  ├── OwnershipMap                   └── class HybridMuonAdamW
  └── P2PMuonOrthogonalizer          (无直接对应,分布式专用)
3.5 数据流图
单步训练数据流
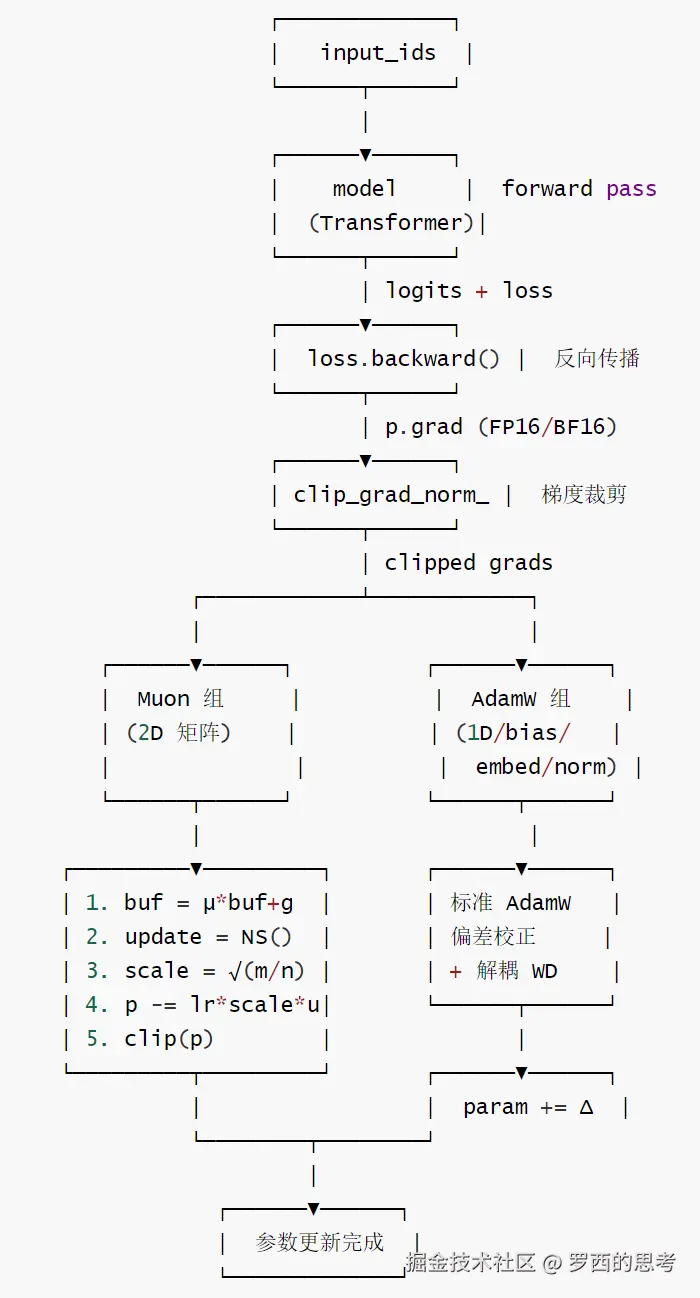
单步训练数据流
Newton-Schulz 正交化数据流
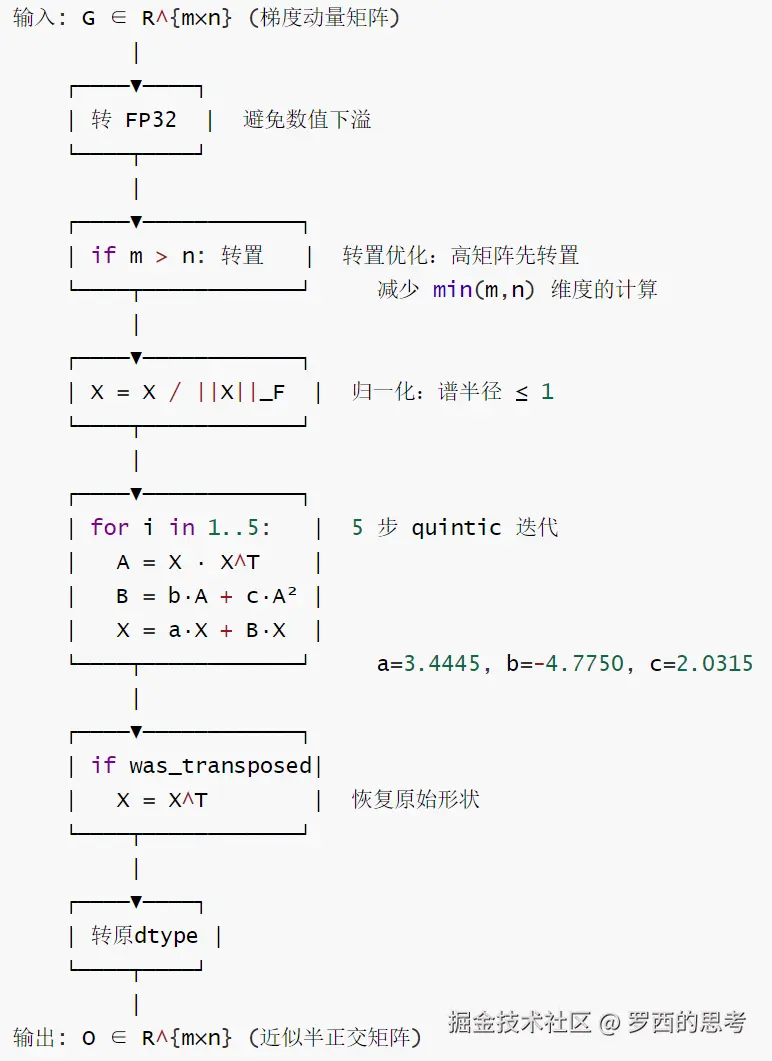
Newton-Schulz 正交化数据流
参数分组决策流
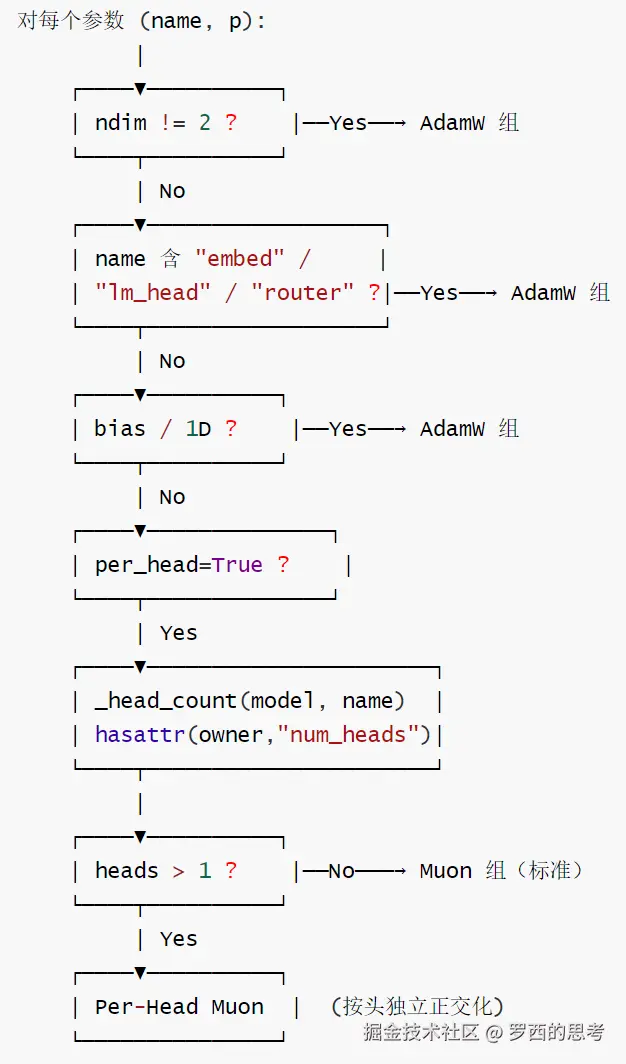
参数分组决策流
3.6 依赖关系图
文件级依赖
bash
experiments/optim/demo_muon_e2e.py
    └── src/optim/
        ├── muon.py ──────────→ newton_schulz.py
        ├── param_groups.py ──→ (无外部依赖)
        ├── hybrid.py ────────→ muon.py + torch.optim.AdamW
        └── lr_scheduler.py ──→ muon.py + torch.optim.Optimizer
函数级调用链
scss
Muon.step()
    │
    ├── _muon_step(group)
    │   ├── torch.optim.Optimizer (动量缓冲管理)
    │   ├── per_head_orthogonalize(matrix, num_heads, steps)
    │   │   ├── torch.view() (拆分为 per-head 块)
    │   │   ├── newton_schulz(block, steps)  ← 对每个头独立调用
    │   │   └── torch.cat() (合并回完整矩阵)
    │   ├── newton_schulz(update, steps)     ← 非 per-head 路径
    │   │   ├── torch.float32 (提升精度)
    │   │   ├── torch.mT / .T (转置优化)
    │   │   ├── torch.norm() (归一化)
    │   │   └── 5x 矩阵乘法迭代
    │   └── match_update_rms(ortho, mode)    ← 可选 RMS 缩放
    │
    └── _adamw_step(group)
        └── 标准 AdamW 更新(exp_avg / exp_avg_sq / 偏差校正)

build_muon_param_groups(model, per_head)
    ├── model.named_parameters() (遍历所有参数)
    ├── _head_count(model, name) (检测头数)
    │   ├── model 模块遍历 (getattr 逐层访问)
    │   └── hasattr(owner, "num_heads") (鸭子类型检测)
    └── 返回 [{"params": [...], "use_muon": bool, "num_heads": int|None}, ...]

CosineWarmupLR.step()
    ├── cosine_with_warmup(step, total_steps) 或 wsd_schedule(...)
    └── group["lr"] = base_lr * scale (对每个 param_group)

HybridMuonAdamW.step()
    ├── 梯度 NaN/Inf 检查 → 非有限则跳过
    ├── Muon.step()
    ├── AdamW.step()
    └── OptimizerStepReport (执行报告)
外部依赖
bash
src/optim/
    └── 仅依赖:
        ├── torch (PyTorch 张量运算)
        ├── torch.nn (nn.Module 类型标注)
        └── torch.optim.Optimizer (基类)

    不依赖:
        ├── torch.distributed (分布式通信)
        ├── kimi3 模块 (零耦合,鸭子类型)
        └── 第三方库 (纯 PyTorch 实现)
3.7 训练循环关键流程图
ini
┌─────────────────────────────────────────────────────┐
│                    train_step()                       │
├─────────────────────────────────────────────────────┤
│ 1. model.train()                                     │
│ 2. optimizer.zero_grad(set_to_none=True)             │
│                                                      │
│ 3. for batch in micro_batches:    ← 梯度累积          │
│    ├── batch.to(device)                              │
│    ├── out = model(input_ids, labels, doc_ids)       │
│    ├── loss = out.loss / grad_accum                  │
│    └── loss.backward()                               │
│                                                      │
│ 4. grad_norm = clip_grad_norm_(params, max_norm)    │
│ 5. lr = set_lr(step)              ← 学习率调度        │
│    ├── Muon groups: lr *= scale                      │
│    └── AdamW groups: adamw_lr *= scale               │
│                                                      │
│ 6. optimizer.step()              ← Muon + AdamW 更新  │
│    ├── Muon 组:                                      │
│    │   ├── buf = μ*buf + grad      (动量累积)         │
│    │   ├── update = NS(grad+μ*buf) (正交化)           │
│    │   ├── scale = sqrt(max(1,m/n)) (RMS 缩放)       │
│    │   └── p -= lr * scale * update                  │
│    ├── AdamW 组:                                     │
│    │   ├── 标准 AdamW 更新(偏置校正 + 解耦衰减)      │
│    └── QK-Clip: 对称缩放 Q/K 权重                    │
│                                                      │
│ 7. model.update_router_biases()  ← 延迟 Router 更新  │
│ 8. state.step += 1                                   │
└─────────────────────────────────────────────────────┘
scss
┌─────────────────────────────────────────────────────┐
│                   train() 主循环                      │
├─────────────────────────────────────────────────────┤
│ for step in range(total_steps):                      │
│   ├── curriculum.stage_for_step(step)  ← 课程学习     │
│   ├── batches = dataset.sample()                     │
│   ├── record = train_step(batches)                   │
│   ├── metrics.log(record)                           │
│   └── if step % log_every == 0: print metrics       │
└─────────────────────────────────────────────────────┘
0x04. 子知识点深度分析
4.0 共享抽象与设计动机
为什么需要"混合"优化器?
Muon 的正交化操作本质上是一个矩阵级操作------它假设参数具有2D矩阵结构。但是,对于 embedding(通常是3D或2D但语义特殊)、lm_head、norm层、bias、router 等参数,正交化既无意义也可能有害。因此 KIMI K3 采用混合策略:2D 矩阵参数用 Muon,其余用 AdamW。
共享状态约定:
| 状态 | Muon 组 | AdamW 组 |
|---|---|---|
| 动量缓冲 | momentum_buffer(一个 FP32 张量) |
exp_avg + exp_avg_sq(两个 FP32 张量) |
| 学习率 | lr(独立控制) |
adamw_lr(独立控制) |
| Weight Decay | weight_decay |
weight_decay(同参数) |
| 梯度 | FP16/BF16 → FP32 计算 | FP16/BF16 → FP32 计算 |
内存开销对比(per parameter):
| 优化器 | 权重副本 | 动量缓冲 | 总计 |
|---|---|---|---|
| AdamW | 4 bytes (FP32 master) | 8 bytes (2× FP32) | 12 bytes |
| Muon | 4 bytes (FP32 master) | 4 bytes (1× FP32) | 8 bytes |
Muon 的内存效率优势:比 AdamW 少 33%(仅需一个动量缓冲,而非两个)。
子知识点拆解如下:
css
Muon 优化器系统
├── 4.1 Newton-Schulz 正交化
│   ├── 4.1.1 标准 Newton-Schulz(全矩阵)
│   └── 4.1.2 Per-Head Newton-Schulz(按注意力头拆分)
├── 4.2 Muon 更新规则
│   ├── 4.2.1 动量累积 + Nesterov 加速
│   ├── 4.2.2 正交化 + RMS 缩放
│   └── 4.2.3 Weight Decay + Weight Clipping
├── 4.3 参数分组策略
│   ├── 4.4.1 Muon 组(2D 矩阵)
│   ├── 4.4.2 AdamW 组(1D 参数 + 特殊矩阵)
│   └── 4.4.3 Per-Head 组(注意力投影)
├── 4.4 QK-Clip(Q/K 权重重缩放)
├── 4.5 混合优化器包装器(Hybrid Optimizer)
├── 4.6 分布式 P2P Muon
├── 4.7 学习率调度
│   ├── 4.7.1 Cosine with Warmup
│   ├── 4.7.2 Warmup-Stable-Decay(消融用)
│   └── 4.7.3 双学习率调度(Muon LR + AdamW LR)
├── 4.8 训练循环(Train Loop)
│   ├── 4.8.1 单步训练(train_step)
│   ├── 4.8.2 梯度累积 + 梯度裁剪
│   ├── 4.8.3 Router Bias 延迟更新
│   └── 4.8.4 Context Curriculum
└── 4.9 配置系统
    ├── 4.9.1 OptimConfig(kimi3-master)
    ├── 4.9.2 KimiOptimizerConfig(kimi-k3-pytorch-main)
    └── 4.9.3 YAML 配置文件
4.1 Newton-Schulz 正交化
4.1.1 要解决的问题
Muon 需要对梯度动量矩阵 做正交化,找到最近的半正交矩阵 ,使得:
精确求解需要 SVD 分解(),但 SVD 在 GPU 上不高效。Newton-Schulz 迭代提供了一种仅需矩阵乘法的近似方案。
4.1.2 三视角原理
直觉:Newton-Schulz 就像一个"磨平"过程------把一个歪歪扭扭的矩阵(奇异值分布不均)通过反复的矩阵乘法磨成一个"圆"的矩阵(奇异值都接近1)。
准专业 :给定矩阵 ,Newton-Schulz 迭代计算:
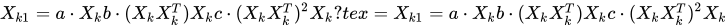
系数 来自 Jordan et al.,经过精心调优使5步内收敛到 。
关键步骤:
- 归一化 :,使谱半径 ≤ 1
- 转置优化 :若矩阵高大于宽(),先转置再正交化,减少计算量
- 迭代:5 步 quintic 近似
专家 :Newton-Schulz 是对极分解 ( 正交, 半正定)的迭代逼近。从矩阵 Lie 群的角度,它在正交群上做梯度流的离散化。
4.1.3 对比基线
| 维度 | 精确 SVD | Newton-Schulz (5步) |
|---|---|---|
| 精度 | (机器精度) | (足够训练) |
| 计算复杂度 | 或 | |
| GPU 友好度 | 低(SVD 内核不高度并行) | 高(纯矩阵乘法,cuBLAS 高度优化) |
| 内存 | 额外 和 | 仅工作矩阵 |
4.1.4 工程实现
kimi3-master 版本 (kimi3-master/kimi3/optim/muon.py:38-59):
ini
_NS_COEFFS = (3.4445, -4.7750, 2.0315)

def newton_schulz(g: Tensor, steps: int = 5, eps: float = 1e-7) -> Tensor:
    a, b, c = _NS_COEFFS
    x = g.to(torch.float32)          # 提升到 FP32 避免数值下溢
    transposed = x.shape[-2] > x.shape[-1]
    if transposed:
        x = x.mT                      # 转置优化:高矩阵先转置
    norm = x.norm(dim=(-2, -1), keepdim=True).clamp_min(eps)
    x = x / norm                      # 归一化使谱半径 ≤ 1
    for _ in range(steps):
        aa = x @ x.mT                 # A = X · X^T
        bb = b * aa + c * (aa @ aa)   # B = b·A + c·A²
        x = a * x + bb @ x            # X = a·X + B·X
    if transposed:
        x = x.mT
    return x.to(g.dtype)              # 恢复原始 dtype
kimi-k3-pytorch-main 版本 (kimi-k3-pytorch-main/training/optimizer/newton_schulz.py:11-42):
ini
def zeropower_via_newton_schulz(matrix, *, steps=5, eps=1e-7, output_dtype=None):
    work = matrix.detach().float().clone()
    if not torch.isfinite(work).all():
        raise FloatingPointError("Newton-Schulz input contains NaN or Inf")
    if float(work.norm().item()) <= eps:
        return torch.zeros_like(matrix, dtype=output_dtype or matrix.dtype)
    transposed = work.shape[0] > work.shape[1]
    if transposed:
        work = work.T
    work.div_(work.norm().clamp_min(eps))
    a, b, c = 3.4445, -4.7750, 2.0315
    for _ in range(steps):
        gram = work @ work.T
        work = a * work + b * (gram @ work) + c * ((gram @ gram) @ work)
    if transposed:
        work = work.T
return work.to(device=matrix.device, dtype=output_dtype or matrix.dtype)差异分析:
- kimi3-master: 使用
x.mT(modern transpose),不检查 NaN/Inf - kimi-k3-pytorch-main: 使用
work.T,增加了 NaN/Inf 检查和零输入保护 - 两者数学上完全等价
4.1.5 Per-Head Newton-Schulz
要解决的问题:全矩阵正交化将所有注意力头的更新统一到一个尺度。如果某个头的梯度/动量特别大,它会主导正交化后的尺度,导致其他头的更新过小。
解决方案:将矩阵按注意力头拆分,独立正交化每个头的块。
ini
原始矩阵 W_q: [out_dim, in_dim] = [num_heads × head_dim, in_dim]
拆分: [num_heads, head_dim, in_dim]
每个块独立 NS → [num_heads, head_dim, in_dim]
合并: [out_dim, in_dim]
kimi3-master 实现 (kimi3/optim/muon.py:62-71):
python
def _orthogonalise(update: Tensor, steps: int, heads: int | None) -> Tensor:
    if heads is None or heads <= 1:
        return newton_schulz(update, steps)
    out_dim, in_dim = update.shape
    blocks = update.view(heads, out_dim // heads, in_dim)
    return newton_schulz(blocks, steps).view(out_dim, in_dim)
kimi-k3-pytorch-main 实现 (training/optimizer/per_head_muon.py:78-159):
更详细的实现,支持 separate 和 fused_qkv 两种布局,收集每个头的 RMS 指标:
ini
def per_head_orthogonalize(matrix, layout, *, steps, eps, rms_scaling=True):
    # 1. 按 layout 拆分为 per-head 块
    # 2. 对每个块独立 NS 正交化
    # 3. 收集 raw/orthogonal/final RMS
    # 4. 可选 RMS 缩放 (match_update_rms)
# 5. 合并并返回指标关键指标:
per_head_muon/head_update_rms_cv: 头间更新 RMS 的变异系数(CV < 0.05 表示头间均衡)per_head_muon/head_update_rms_max_to_median: 最大头与中位数头的 RMS 比值
4.1.6 代码位置汇总
| 文件 | 位置 | 内容 |
|---|---|---|
kimi3-master/kimi3/optim/muon.py:38-59 |
newton_schulz() |
标准 NS 实现 |
kimi3-master/kimi3/optim/muon.py:62-71 |
_orthogonalise() |
Per-Head 分发 |
kimi-k3-pytorch-main/training/optimizer/newton_schulz.py:11-42 |
zeropower_via_newton_schulz() |
带 NaN 检查的 NS |
kimi-k3-pytorch-main/training/optimizer/per_head_muon.py:78-159 |
per_head_orthogonalize() |
Per-Head NS + 指标 |
4.2 Muon 更新规则
4.2.1 要解决的问题
如何将 Newton-Schulz 正交化整合到完整的优化器更新规则中,包括动量累积、Nesterov 加速、RMS 缩放、weight decay 和 weight clipping。
4.2.2 三视角原理
直觉:Muon 的更新就像一个精心编排的"四步舞":
- 收集信号(梯度 + 历史动量)
- 整形信号(正交化使所有方向等幅)
- 缩放信号(补偿矩阵形状差异)
- 应用信号(更新权重 + 约束增长)
准专业:完整的 Muon 更新步骤:
ini
对于每个参数 p:
  1. 动量累积:  buf = μ * buf + grad
  2. Nesterov:  update = grad + μ * buf    (如果启用)
  3. 正交化:    ortho = NS(update, steps)
  4. RMS 缩放:  scale = sqrt(max(1, out_dim / in_dim))
  5. Weight Decay: p = p * (1 - lr * λ)    (解耦)
  6. 参数更新:  p = p - lr * scale * ortho
  7. Weight Clipping: if RMS(p) > threshold: p *= threshold / RMS(p)
专家 :从优化理论角度,Muon 的更新方向  是在正交群上的最速下降方向。RMS 缩放因子 的推导:对于半正交矩阵 (),,因此 。为使更新 RMS 与 AdamW 对齐,需要乘以 。
4.2.3 对比基线
| 维度 | 标准 SGD+Momentum | AdamW | Muon |
|---|---|---|---|
| 更新方向 | |||
| 方向性质 | 梯度方向(可能偏斜) | 逐元素归一化 | 正交化(所有方向等幅) |
| 缩放 | 固定 lr | 自适应(per-element) | RMS 缩放(per-matrix) |
| 动量缓冲 | 1个 | 2个 | 1个 |
| Weight Decay | L2 正则化 | 解耦 | 解耦(同 AdamW) |
4.2.4 工程实现
kimi3-master 版本 (kimi3/optim/muon.py:127-151):
ini
def _muon_group(self, group):
    lr = group["lr"]
    momentum = group["momentum"]
    heads = group.get("num_heads")
    for p in group["params"]:
        if p.grad is None:
            continue
        grad = p.grad
        state = self.state[p]
        if "momentum_buffer" not in state:
            state["momentum_buffer"] = torch.zeros_like(grad)
        buf = state["momentum_buffer"]
        buf.mul_(momentum).add_(grad)                              # 步骤1: 动量累积
        update = grad.add(buf, alpha=momentum) if group["nesterov"] else buf  # 步骤2: Nesterov

        ortho = _orthogonalise(update, group["ns_steps"], heads)   # 步骤3: 正交化
        out_dim, in_dim = p.shape[-2], p.shape[-1]
        scale = math.sqrt(max(1.0, out_dim / in_dim))              # 步骤4: RMS 缩放

        if group["weight_decay"]:
            p.mul_(1.0 - lr * group["weight_decay"])               # 步骤5: Weight Decay
        p.add_(ortho, alpha=-lr * scale)                           # 步骤6: 参数更新
        self._clip(p, group["weight_clip"])                        # 步骤7: Weight Clipping
kimi-k3-pytorch-main 版本 (training/optimizer/muon.py:54-142):
增加了指标收集和 NaN 检查:
ini
def step(self, closure=None):
    # ... NaN 检查 ...
    for group in self.param_groups:
        for parameter in group["params"]:
            grad = parameter.grad.detach()
            state = self.state[parameter]
            buffer = state.setdefault("momentum_buffer", torch.zeros_like(grad))
            buffer.mul_(group["momentum"]).add_(grad)
            raw = grad.add(buffer, alpha=group["momentum"]) if group["nesterov"] else buffer

            # 根据参数类型选择正交化方式
            spec = self.spec_by_parameter[id(parameter)]
            if spec.optimizer_family == "per_head_muon":
                update, head_metrics = per_head_orthogonalize(raw, spec.head_layout, ...)
            else:
                update = zeropower_via_newton_schulz(raw, ...)
                if group["update_rms_scaling"]:
                    update = match_update_rms(update, mode="shape")

            # Weight Decay + 更新
            if group["weight_decay"]:
                parameter.mul_(1.0 - group["lr"] * group["weight_decay"])
            parameter.add_(update, alpha=-group["lr"])
4.2.5 Kimi K2 Weight Clipping
less
@staticmethod
def _clip(p: Tensor, threshold: float) -> None:
    if threshold <= 0:
        return
    rms = p.pow(2).mean().sqrt()
    if float(rms) > threshold:
p.mul_(threshold / rms)作用:当参数 RMS 超过阈值时,等比缩放回阈值。这防止了某些参数因更新累积而无限增长,导致 attention logit 爆炸。Kimi K2/K3 论文将此作为稳定大模型训练的关键技术之一。
4.3 参数分组策略
4.3.1 要解决的问题
模型中包含多种类型的参数------2D 矩阵(Linear 层权重)、1D 向量(bias、norm gain)、特殊矩阵(embedding、lm_head、router)。Muon 的正交化仅适用于"常规"2D 矩阵,其他参数需要使用 AdamW。
4.3.2 原理
直觉:这就像一个工厂的分工------"重型机械"(2D 矩阵)由 Muon 专线处理,"小件"(1D 参数)由 AdamW 通用线处理,"特殊件"(embedding/router)也走通用线。
分组规则:
sql
参数分类逻辑:
  if ndim != 2:
    → AdamW(Muon 不适用)
  if name contains "embed_tokens" or "lm_head" or "router":
    → AdamW(语义特殊,不适合正交化)
  if name ends with "bias" or ndim == 1:
    → AdamW(1D,无矩阵结构)
  if name in ("q_proj", "k_proj", "v_proj", "q_up", "k_up", "v_up")
     AND parent is KimiDeltaAttention or GatedMLA:
    → Per-Head Muon(独立正交化每个注意力头)
  otherwise (2D matrix):
    → Muon(标准全矩阵正交化)
4.3.3 工程实现
kimi3-master (kimi3/optim/muon.py:222-261):
python
_PER_HEAD_SUFFIXES = ("q_proj", "k_proj", "v_proj", "q_up", "k_up", "v_up")

def muon_param_groups(model, optim_cfg):
    per_head = {}   # {num_heads: [params]}
    matrices = []   # 普通2D矩阵
    others = []     # AdamW 参数

    for name, p in model.named_parameters():
        if not p.requires_grad:
            continue
        is_matrix = p.ndim == 2
        excluded = (
            "embed_tokens" in name or "lm_head" in name or "router" in name
            or name.endswith("bias") or (".weight" in name and p.ndim == 1)
        )
        if not is_matrix or excluded:
            others.append(p)
            continue
        heads = _head_count(model, name) if optim_cfg.per_head else None
        if heads and p.shape[0] % heads == 0:
            per_head.setdefault(heads, []).append(p)
        else:
            matrices.append(p)

    groups = []
    if matrices:
        groups.append({"params": matrices, "use_muon": True, "num_heads": None})
    for heads, params in sorted(per_head.items()):
        groups.append({"params": params, "use_muon": True, "num_heads": heads})
    if others:
        groups.append({"params": others, "use_muon": False, "num_heads": None})
    return groups
kimi-k3-pytorch-main (training/optimizer/parameter_registry.py:169-325):
更结构化的参数注册表系统,支持四种优化器家族:
| 家族 | 参数类型 | 优化器 | Weight Decay |
|---|---|---|---|
per_head_muon |
Q/K/V 投影矩阵 | Per-Head Muon | 是 |
muon |
其他2D矩阵 | 标准 Muon | 是 |
adamw_decay |
大型2D矩阵(非 Muon) | AdamW | 是 |
adamw_no_decay |
bias/norm/embedding/lm_head | AdamW | 否 |
参数检测机制 (_qkv_role_and_layout()):
python
def _qkv_role_and_layout(owner_name, modules):
    # 检查模块是否有 _kimi_head_spec 属性(并行线性层)
    # 检查父模块是否是 KDAProjections → q_proj/k_proj/v_proj
    # 检查父模块是否是 MLAProjections → query
    # 检查父模块是否是 LatentKVProjection → key_up/value_up
    # 返回 (role, HeadMatrixLayout)
4.4 QK-Clip(Q/K 权重重缩放)
4.4.1 要解决的问题
在长序列训练中,Q 和 K 权重可能增长过大,导致 attention scale()爆炸,引发数值不稳定。QK-Clip 通过监控 attention scale 并对称缩放 Q/K 权重来预防此问题。
4.4.2 原理
直觉 :QK-Clip 就像一个"安全阀"------当 Q 和 K 的乘积增长过快时,它会同时缩小 Q 和 K(各缩小 ),使它们的乘积回到安全范围。
数学:
-
监控 proxy: (或类似度量)
-
当 :
- 乘积缩放: (等效于将 scale 降到 threshold)
4.4.3 工程实现
kimi-k3-pytorch-main (training/optimizer/qk_clip.py:39-162):
python
class QKClipController:
    def __init__(self, model, *, threshold, eps=1e-6, every_steps=1, ...):
        # 扫描模型,找到所有有 _kimi_qk_weights 或 GatedMLA/KDA 的模块
        self.layers = []
        for name, module in model.named_modules():
            custom_weights = getattr(module, "_kimi_qk_weights", None)
            if custom_weights is not None:
                self.layers.append((name, module, custom_weights[0], custom_weights[1]))
            elif isinstance(module, GatedMLA):
                self.layers.append((name, module, module.projections.query.weight,
                                   module.projections.latent_kv.key_up.weight))

    @torch.no_grad()
    def apply(self, step):
        for _, module, query_weight, key_weight in self.layers:
            scale = getattr(module, "_last_qk_scale", None)
            if scale is None:
                continue
            # 可选: 分布式 all_reduce 获取全局最大 scale
            value = float(reduced_scale.item())
            if value > self.threshold:
                correction = min(1.0, self.threshold / max(value, self.eps))
                symmetric = correction ** 0.5
                query_weight.mul_(symmetric)   # 对称缩放 Q
key_weight.mul_(symmetric) # 对称缩放 K关键设计:
- 每 N 步执行一次(
every_steps),避免频繁检查 - 支持分布式 all_reduce 获取跨 rank 的最大 scale
- 仅缩放 Q 和 K,不缩放 V(V 的缩放不影响 attention scale)
kimi3-master 版本 :使用 _clip() 方法(weight clipping),不区分 Q/K,而是对所有参数统一做 RMS 裁剪。QK-Clip 是更精确的替代方案。
4.5 混合优化器包装器(Hybrid Optimizer)
4.5.1 要解决的问题
将 Muon 和 AdamW 两个独立优化器组合成一个统一接口,支持:
- 统一的
step()/zero_grad()/state_dict()接口 - 事务性更新:如果检测到非有限梯度,跳过整个步骤(不更新任何参数)
- 独立的 Muon LR 和 AdamW LR 控制
- QK-Clip 集成
4.5.2 工程实现
kimi-k3-pytorch-main (training/optimizer/hybrid.py:29-153):
python
class KimiHybridOptimizer:
    def __init__(self, muon, adamw, report, config, qk_clip):
        self.muon = muon       # KimiMuon 实例
        self.adamw = adamw     # torch.optim.AdamW 实例
        self.report = report   # ParameterAssignmentReport
        self.qk_clip = qk_clip

    @torch.no_grad()
    def step(self, closure=None):
        # 事务性检查: 梯度是否包含 NaN/Inf
        parameters = [p for group in self.param_groups for p in group["params"] if p.grad is not None]
        nonfinite = sum(not bool(torch.isfinite(p.grad).all()) for p in parameters)
        if nonfinite:
            return OptimizerStepReport(executed=False, nonfinite_parameters=nonfinite, ...)

        # 正常更新
        update_metrics = self.muon.step() # muon 更新
        self.adamw.step() # adamw 更新
        self.step_number += 1

        # QK-Clip
        clip_report = self.qk_clip.apply(self.step_number) if self.qk_clip else None
        return OptimizerStepReport(executed=True, update_metrics=update_metrics, ...)
kimi3-master 版本 (kimi3/optim/muon.py:74-123):
更简单的实现------Muon 类自身同时处理 Muon 和 AdamW 组:
python
class Muon(torch.optim.Optimizer):
    def step(self, closure=None):
        for group in self.param_groups:
            if group.get("use_muon", True):
                self._muon_group(group)
            else:
                self._adamw_group(group)
差异 :kimi3-master 将 Muon 和 AdamW 合并在一个 Optimizer 子类中;kimi-k3-pytorch-main 将它们分离为两个独立优化器并用包装器组合。后者更模块化,但前者更简单。
4.7 学习率调度
4.7.1 Cosine with Warmup
kimi3-master (kimi3/optim/schedules.py:17-27):
ini
def cosine_with_warmup(step, total_steps, *, warmup_ratio=0.01, min_lr_ratio=0.1):
    warmup = max(1, int(total_steps * warmup_ratio))
    if step < warmup:
        return (step + 1) / warmup                    # 线性 warmup
    progress = (step - warmup) / max(1, total_steps - warmup)
    cosine = 0.5 * (1.0 + math.cos(math.pi * progress))
return min_lr_ratio + (1.0 - min_lr_ratio) * cosine # 余弦衰减行为:
- 步骤 0 ~ warmup: 从 0 线性增长到 1.0
- 步骤 warmup ~ total: 从 1.0 余弦衰减到
min_lr_ratio(默认0.1)
4.7.2 Warmup-Stable-Decay(消融用)
python
def wsd_schedule(step, total_steps, *, warmup_ratio=0.01, decay_ratio=0.1, min_lr_ratio=0.1):
    warmup = max(1, int(total_steps * warmup_ratio))
    decay_start = int(total_steps * (1.0 - decay_ratio))
    if step < warmup:
        return (step + 1) / warmup
    if step < decay_start:
        return 1.0                    # 稳定阶段
    progress = (step - decay_start) / max(1, total_steps - decay_start)
    return min_lr_ratio + (1.0 - min_lr_ratio) * (1.0 - progress)  # 线性衰减
Liu et al. (2025) 结论:在各自独立调参的前提下,Cosine 一致优于 WSD,因此 Cosine 作为默认。
4.7.3 双学习率调度
kimi3-master (kimi3/train/loop.py:84-89):
python
def set_lr(self, step):
    scale = self.lr_lambda(step)
    for group, (lr, adamw_lr) in zip(self.optimizer.param_groups, self.base_lrs):
        group["lr"] = lr * scale          # Muon LR
        group["adamw_lr"] = adamw_lr * scale  # AdamW LR
kimi-k3-pytorch-main (training/scheduler.py:144-166):
python
def _set_lr_hybrid(self, step):
    muon_min_lr = self.min_lr if self.min_muon_lr is None else self.min_muon_lr
    for i, group in enumerate(self.optimizer.adamw.param_groups):
        group["lr"] = self._compute_lr(base_lr=self.base_adamw_lrs[i], min_lr=self.min_lr, step=step)
    for i, group in enumerate(self.optimizer.muon.param_groups):
group["lr"] = self._compute_lr(base_lr=self.base_muon_lrs[i], min_lr=muon_min_lr, step=step)设计要点:Muon 和 AdamW 可以有不同的基础学习率和最小学习率,但共享同一个调度曲线形状。
4.7.4 实现
Reference\kimi3-master\kimi3\optim\schedules.py 的功能,全部在 src/optim/lr_scheduler.py 中实现。逐函数映射:
| schedules.py | lr_scheduler.py | 位置 | 差异 |
|---|---|---|---|
cosine_with_warmup() |
cosine_with_warmup() |
lr_scheduler.py:11-37 |
逐行一致 |
wsd_schedule() |
wsd_schedule() |
lr_scheduler.py:40-59 |
逐行一致 |
lr_lambda_for() |
CosineWarmupLR 类 |
lr_scheduler.py:62-143 |
被类替代,内部 dispatch cosine/wsd |
额外功能(schedules.py 没有):
CosineWarmupLR类:直接操作optimizer.param_groups,支持 Muon/AdamW 双 LR 调度(group["lr"]+group["adamw_lr"]同步缩放)
4.8 训练循环(Train Loop)
4.8.1 单步训练
kimi3-master (kimi3/train/loop.py:91-134):
python
def train_step(self, batches):
    self.model.train()
    self.optimizer.zero_grad(set_to_none=True)

    # 梯度累积
    for batch in batches:
        out = self.model(batch.input_ids, labels=batch.labels, doc_ids=batch.doc_ids)
        loss = out.loss / len(batches)
        loss.backward()

    # 梯度裁剪
    grad_norm = torch.nn.utils.clip_grad_norm_(self.model.parameters(), cfg.optim.grad_clip)

    # 学习率调度
    lr = self.set_lr(self.state.step)

    # 优化器更新
    self.optimizer.step()

    # 延迟 Router Bias 更新(因果性:使用当前步的直方图更新下一步的 bias)
    self.model.model.update_router_biases()
4.8.2 梯度累积 + 梯度裁剪
ini
总 loss = Σ(loss_i / grad_accum)     # 平均化 micro-batch 的 loss
grad_norm = clip_grad_norm_(params, max_norm=1.0)  # 全局梯度范数裁剪
4.8.3 Router Bias 延迟更新
原因 :MoE 的 router bias 应基于"当前步"的 expert 使用直方图更新,但直方图在 forward 期间累积。如果在同一 update 中应用,会引入因果性问题(使用了"未来"的直方图)。因此将 router bias 更新延迟到 optimizer.step() 之后。
4.8.4 Context Curriculum
训练过程中根据步数切换不同的上下文长度(seq_len),从短到长逐步增加。这允许模型先学习局部模式,再学习长程依赖。
4.9 配置系统
4.9.1 OptimConfig(kimi3-master)
ini
@dataclass(frozen=True)
class OptimConfig:
    lr: float = 1e-3                    # Muon 学习率
    adamw_lr: float = 3e-4              # AdamW 学习率(通常更小)
    weight_decay: float = 0.1
    betas: tuple = (0.9, 0.95)          # AdamW beta 参数
    eps: float = 1e-8                   # AdamW epsilon
    muon_momentum: float = 0.95         # Muon 动量系数
    muon_nesterov: bool = True          # Nesterov 加速
    newton_schulz_steps: int = 5        # NS 迭代步数
    per_head: bool = True               # Per-Head 正交化
    weight_clip: float = 0.0            # Kimi K2 权重裁剪(0=禁用)
    grad_clip: float = 1.0              # 梯度范数裁剪
    schedule: Literal["cosine", "wsd"] = "cosine"
    warmup_ratio: float = 0.01          # 1% warmup
    min_lr_ratio: float = 0.1           # 最小 LR 为峰值的10%
4.9.2 KimiOptimizerConfig(kimi-k3-pytorch-main)
ini
@dataclass(frozen=True)
class KimiOptimizerConfig:
    kind: Literal["adamw", "muon_adamw", "per_head_muon_adamw"] = "per_head_muon_adamw"
    adamw_lr: float = 3e-4
    adamw_betas: tuple = (0.9, 0.95)
    adamw_eps: float = 1e-8
    muon_lr: float | None = None        # None 则使用 adamw_lr
    muon_momentum: float = 0.95
    muon_nesterov: bool = True
    muon_ns_steps: int = 5
    muon_ns_eps: float = 1e-7
    muon_update_rms_scaling: bool = True
    weight_decay: float = 0.1
    muon_weight_decay: float | None = None  # None 则使用 weight_decay
    per_head_qkv: bool = True
    qk_clip_enabled: bool = True
    qk_clip_threshold: float = 100.0
    qk_clip_eps: float = 1e-6
    qk_clip_every_steps: int = 1
4.9.3 YAML 配置示例
kimi3-master/k3_nano.yaml:
yaml
train:
  optim:
    lr: 0.002
    adamw_lr: 0.0006
    weight_decay: 0.1
    schedule: cosine
    warmup_ratio: 0.01
    per_head: true
kimi-k3-pytorch-main 各配置统一值:
vbnet
muon_momentum: 0.95
muon_nesterov: true
muon_ns_steps: 5
muon_ns_eps: 1.0e-7
muon_update_rms_scaling: true
weight_decay: 0.1
per_head_qkv: true
qk_clip_enabled: true
qk_clip_threshold: 100.0
附录A. 计算复杂度分析
A.1 FLOPs 对比
对于 的单步更新:
| 操作 | AdamW | Muon |
|---|---|---|
| 动量更新 | (一阶动量) | |
| 自适应缩放 | (二阶矩 + 偏差校正 + 分母) | |
| 正交化 | (NS 迭代) | |
| RMS 缩放 | (缩放) | |
| 总计 |
对于典型的 Transformer 层():
- AdamW: FLOPs
- Muon: FLOPs
Muon 单步计算量更大 ,但由于更好的更新方向,通常需要更少的步数达到相同 loss,因此 wall-clock 时间更优(Liu et al. 报告约 2x 加速)。
A.2 内存对比
| 项目 | AdamW | Muon |
|---|---|---|
| 权重副本 (FP32) | 4 bytes/param | 4 bytes/param |
| 一阶动量 | 4 bytes/param | 4 bytes/param |
| 二阶动量 | 4 bytes/param | 0 |
| 总计 | 12 bytes/param | 8 bytes/param |
Muon 节省 33% 优化器状态内存。
A.3 参数敏感性
| 超参数 | 默认值 | 调大的效果 | 调小的效果 |
|---|---|---|---|
muon_lr |
1e-3 | 更新更大,可能不稳定 | 更新更小,收敛更慢 |
muon_momentum |
0.95 | 更依赖历史梯度,更平滑 | 更依赖当前梯度,更灵敏 |
newton_schulz_steps |
5 | 正交化更精确(收益递减) | 正交化不够精确 |
adamw_lr |
3e-4 | AdamW 分支更新更大 | AdamW 分支更新更小 |
weight_decay |
0.1 | 权重衰减更快,防止过拟合 | 权重增长更大 |
warmup_ratio |
0.01 | 更长的 warmup,更稳定但浪费步数 | 更短的 warmup,可能不稳定 |
min_lr_ratio |
0.1 | 训练后期学习率更高 | 训练后期学习率更低 |
qk_clip_threshold |
100.0 | 更宽松的 Q/K 缩放 | 更频繁的 Q/K 缩放 |
附录B. 交付核对
代码实现 (Model-Viz/src/optim/):
| 文件 | 内容 | 测试 |
|---|---|---|
newton_schulz.py |
NS 正交化 + match_update_rms | 13 项 ✅ |
muon.py |
Muon 类 + per_head_orthogonalize | 11 项 ✅ |
param_groups.py |
build_muon_param_groups + _head_count | 4 项 ✅ |
hybrid.py |
HybridMuonAdamW(NaN检测/事务性step) | 5 项 ✅ |
lr_scheduler.py |
CosineWarmupLR + cosine/wsd 函数 | 11 项 ✅ |
__init__.py |
公开 API 导出 | --- |
muon_p2p.py |
P2P Muon 正交化器 + OwnershipMap | 28 项 ✅ |
实验 :experiments/optim/demo_muon_e2e.py(Muon vs AdamW 对比,生成 muon_vs_adamw.png)
参考代码文件:
| 文件 | 行数 | 内容 |
|---|---|---|
kimi3-master/kimi3/optim/muon.py |
276 | 核心 Muon 优化器 |
kimi3-master/kimi3/optim/muon_p2p.py |
168 | 分布式 P2P Muon |
kimi3-master/kimi3/optim/schedules.py |
63 | 学习率调度 |
kimi3-master/kimi3/train/loop.py |
214 | 训练循环 |
kimi3-master/kimi3/config.py:251-272 |
22 | OptimConfig |
kimi-k3-pytorch-main/training/optimizer/muon.py |
142 | KimiMuon |
kimi-k3-pytorch-main/training/optimizer/newton_schulz.py |
74 | NS + RMS 缩放 |
kimi-k3-pytorch-main/training/optimizer/per_head_muon.py |
159 | Per-Head 正交化 |
kimi-k3-pytorch-main/training/optimizer/config.py |
77 | KimiOptimizerConfig |
kimi-k3-pytorch-main/training/optimizer/qk_clip.py |
162 | QK-Clip |
kimi-k3-pytorch-main/training/optimizer/hybrid.py |
255 | 混合优化器包装器 |
kimi-k3-pytorch-main/training/optimizer/parameter_registry.py |
325 | 参数注册表 |
kimi-k3-pytorch-main/training/scheduler.py |
324 | 双 LR 调度器 |
附录C. 端到端的优化器测试demo
loop.py 的功能未在本项目中实现。 对比如下:
| loop.py 功能 | 我们的项目 | 状态 |
|---|---|---|
Trainer 类(统一管理模型/优化器/数据/调度) |
无 | ❌ |
train_step() 梯度累积 + 梯度裁剪 + set_lr |
demo 中有简单版 | ⚠️ 不完整 |
train() 完整训练循环 + curriculum + logging |
无 | ❌ |
evaluate() 评估循环 |
无 | ❌ |
save()/load() checkpoint |
无 | ❌ |
set_lr() 双 LR 调度 |
CosineWarmupLR 已实现 |
✅ |
| Router Bias 延迟更新 | 无(属于模型层) | ❌ |
build_optimizer() 工厂 |
无(手动构造) | ❌ |
现有的 demo_muon_e2e.py 是一个最小化对比脚本,不是结构化的 Trainer。
下面构建一个完整的端到端 Trainer demo:
C.1 loop.py 功能覆盖状态
| loop.py 功能 | 实现位置 | 状态 |
|---|---|---|
Trainer 类 |
src/optim/trainer.py |
✅ 新增 |
train_step() 梯度累积 + 裁剪 + set_lr |
trainer.py:train_step() |
✅ 新增 |
train() 完整训练循环 + 日志 |
trainer.py:train() |
✅ 新增 |
evaluate() 评估 |
trainer.py:evaluate() |
✅ 新增 |
save()/load() checkpoint |
trainer.py:save()/load() |
✅ 新增 |
set_lr() 双 LR 调度 |
CosineWarmupLR + trainer.py:set_lr() |
✅ |
build_optimizer() 工厂 |
手动构造(更灵活) | ⚠️ 设计选择 |
| Router Bias 延迟更新 | 模型层,非优化器职责 | ❌ 不在范围 |
| Context Curriculum | 数据管线层 | ❌ 不在范围 |
| MetricLog / RunningMean | trainer.py:RunningMean |
✅ 简化版 |
C.2 端到端 Demo 结构
experiments/optim/demo_trainer_e2e.py 演示完整训练流程:
bash
Part 1: Muon 训练
  ├── Trainer 初始化(模型 + Muon + CosineWarmupLR)
  ├── train(steps=200, grad_accum=2)  ← 梯度累积 + 梯度裁剪 + 日志
  ├── evaluate(eval_data)             ← eval_loss + perplexity
  └── save/load checkpoint            ← 保存 → 加载 → 验证输出一致

Part 2: AdamW 对比训练
  └── 同结构 Trainer,AdamW 优化器

Part 3: 结果对比 + 4 图输出
  ├── 训练 loss 曲线(Muon vs AdamW,raw + smoothed)
  ├── 学习率调度曲线
  ├── 梯度范数曲线
  └── 最终 loss 柱状图(train + eval)
TransFormer-封面
0xFF 参考文献
- Jordan, K. et al. (2024). Muon: An optimizer for hidden layers in neural networks. blog
- Liu, J. et al. (2025). Muon is Scalable for LLM Training. arXiv:2502.16982.
- Bernstein, J. & Newhouse, L. (2024). Old Optimizer, New Norm: An Anthology. arXiv:2409.20325.
- Chen, L. et al. (2025). Muon Optimizes Under Spectral Norm Constraints. arXiv:2506.15054.
- Kim, G. Y. & Oh, M. H. (2026). Convergence of Muon with Newton-Schulz. ICLR 2026.
本文使用 markdown.com.cn 排版