在实际使用 AI 编程 Agent 时,经常会出现这样一种情况::修复配置文件里的一个拼写错误,花费竟然和开发一个耗费整个下午的新功能差不多。
这两个请求都来自同一个 AI 编程 Agent,也都调用了同一个模型。原因其实不复杂:这个 Agent 从一开始就是按照"单模型"方式设计的------一个模型、一个 API Key、统一的 Token 单价。不管面对的是简单到几句话就能解决的问题,还是需要多轮推理和工具调用的复杂任务,最终都会交给同一个模型处理。
大多数团队并不是主动决定"所有任务都用同一个模型",而是因为这种架构最简单。选定一个模型接入 API 很容易,但要根据任务类型、成本和性能动态选择模型,就需要额外开发一套路由机制。于是,简单查询、短文本摘要这类任务,也在按照前沿模型的价格付费,尽管更便宜的模型可能已经足够完成它们。
如果只是偶尔调用几次,这点差异可能无关紧要。但当一个 Agent 需要执行数百次工具调用,或者十几个 Agent 同时运行时,这部分成本很快就会累积起来。
Kimi K3 是 Moonshot AI 在 2026 年 7 月发布的一款 2.8 万亿参数开放权重模型,很适合和 Claude 放在一起讨论。这里不是要比较谁能取代谁,而是因为两者擅长的任务和价格并不相同,恰好适合组成一个模型池。
也正因为存在这种差异,模型路由才有价值:不再让一个模型处理所有任务,而是根据每次请求的特点选择更合适的模型。本文会介绍为什么手写模型路由逻辑很容易变得复杂,Kimi K3 和 Claude 分别适合哪些任务,以及如何使用 DigitalOcean 推理路由器,在实际应用中动态选择模型。
硬编码模型路由的问题
最直接的做法,是自己在应用里写模型选择逻辑。比如根据 Prompt 长度写几个 if/else,检查关键词,或者先调用一个 LLM,让它判断当前请求应该交给哪个模型。
前两种方法规则简单,但随着任务类型增加,很快就会变得难以维护。第三种方案看起来更智能,因此不少团队最后都会走到这一步,但新的问题也随之出现。
假设你使用 Haiku 这样的轻量模型,先对每个请求进行分类,再根据分类结果调用真正负责回答的模型。那么每个请求实际上都需要进行两次模型调用:第一次负责"选模型",第二次才真正处理任务。
而且,让一个通用模型顺便承担请求分类工作,也不一定稳定。随着业务流量发生变化,或者模型池里加入新模型,原来的分类逻辑可能逐渐不再适用。最终,还是需要你自己发现问题、重新调整 Prompt 和分类规则。
换句话说,你相当于额外维护了一套系统,而它唯一的工作,就是决定另一套系统应该调用哪个模型。
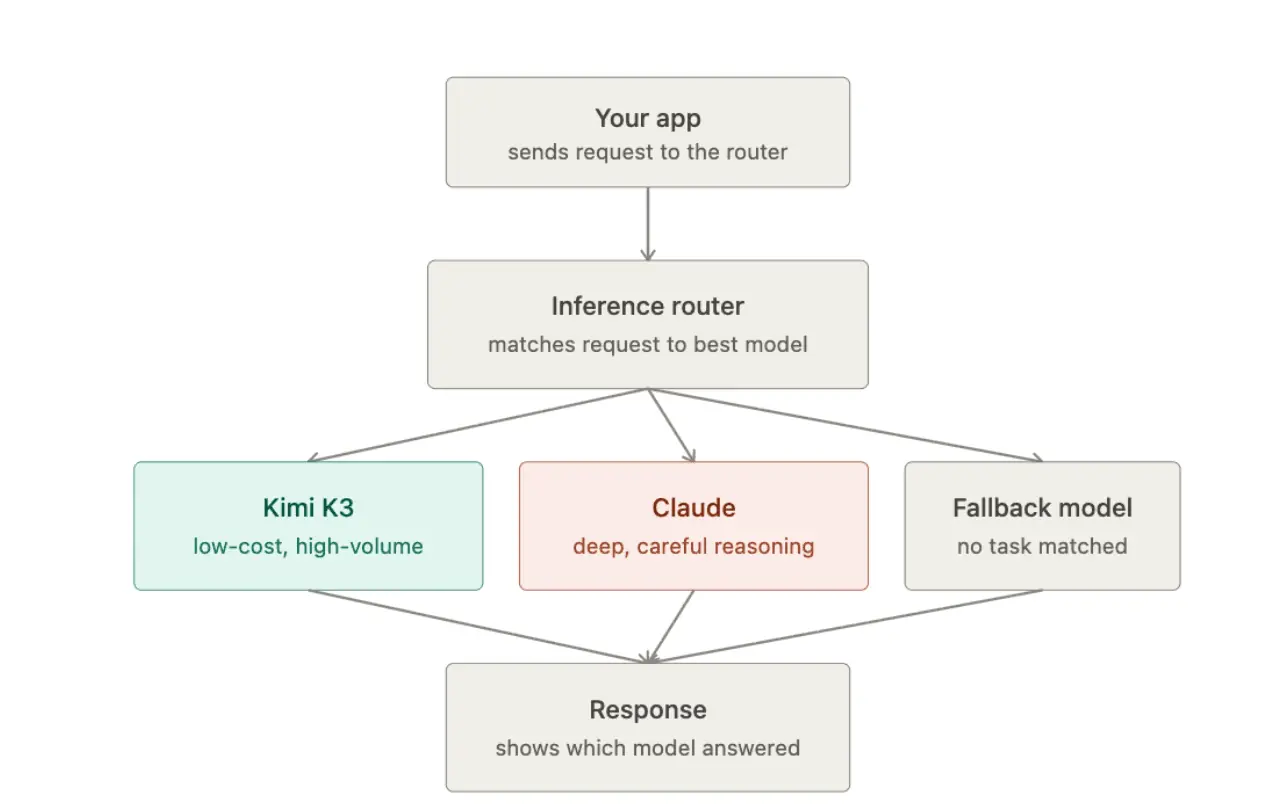
更适合长期使用的方案,是把模型选择下沉到基础设施层:由这一层读取请求、识别任务类型,再把请求分发给合适的模型。应用本身不需要知道最后调用的是哪个模型,也不需要维护具体的模型选择逻辑。
模型路由本身是一个目标非常明确的任务,因此,与其让通用 LLM 兼职完成,不如交给专门针对模型路由训练的模型处理。
两个模型,适合两类不同的任务
Claude 是闭源模型。从模型开发、部署到后续调优,都由 Anthropic 完成。它的优势也比较明确:表现稳定、推理能力强,并且擅长在复杂的长任务中持续进行工具调用。
Kimi K3 则走了另一条路线。它是一款开放权重模型,拥有 2.78 万亿总参数和 896 个路由专家(Routed Experts),采用 Kimi Delta Attention 与 Gated Multi-head Latent Attention 混合架构,支持最长 100 万 Token 上下文,并原生支持视觉能力。
Moonshot AI 在设计 Kimi K3 时,就重点考虑了需要长时间持续运行的任务,例如自主编程、多步骤研究,以及需要连续执行数百次工具调用、同时保持上下文连贯的 Agent 工作负载。在编程和 Agent Benchmark 中,Kimi K3 的成绩超过了市场上的大多数模型,仅次于少数前沿模型。
与此同时,由于模型权重开放,不同平台都可以部署并提供 Kimi K3,因此也可以围绕相同模型进行价格竞争。相比规模接近的闭源模型,它的推理成本通常有更大的下降空间。
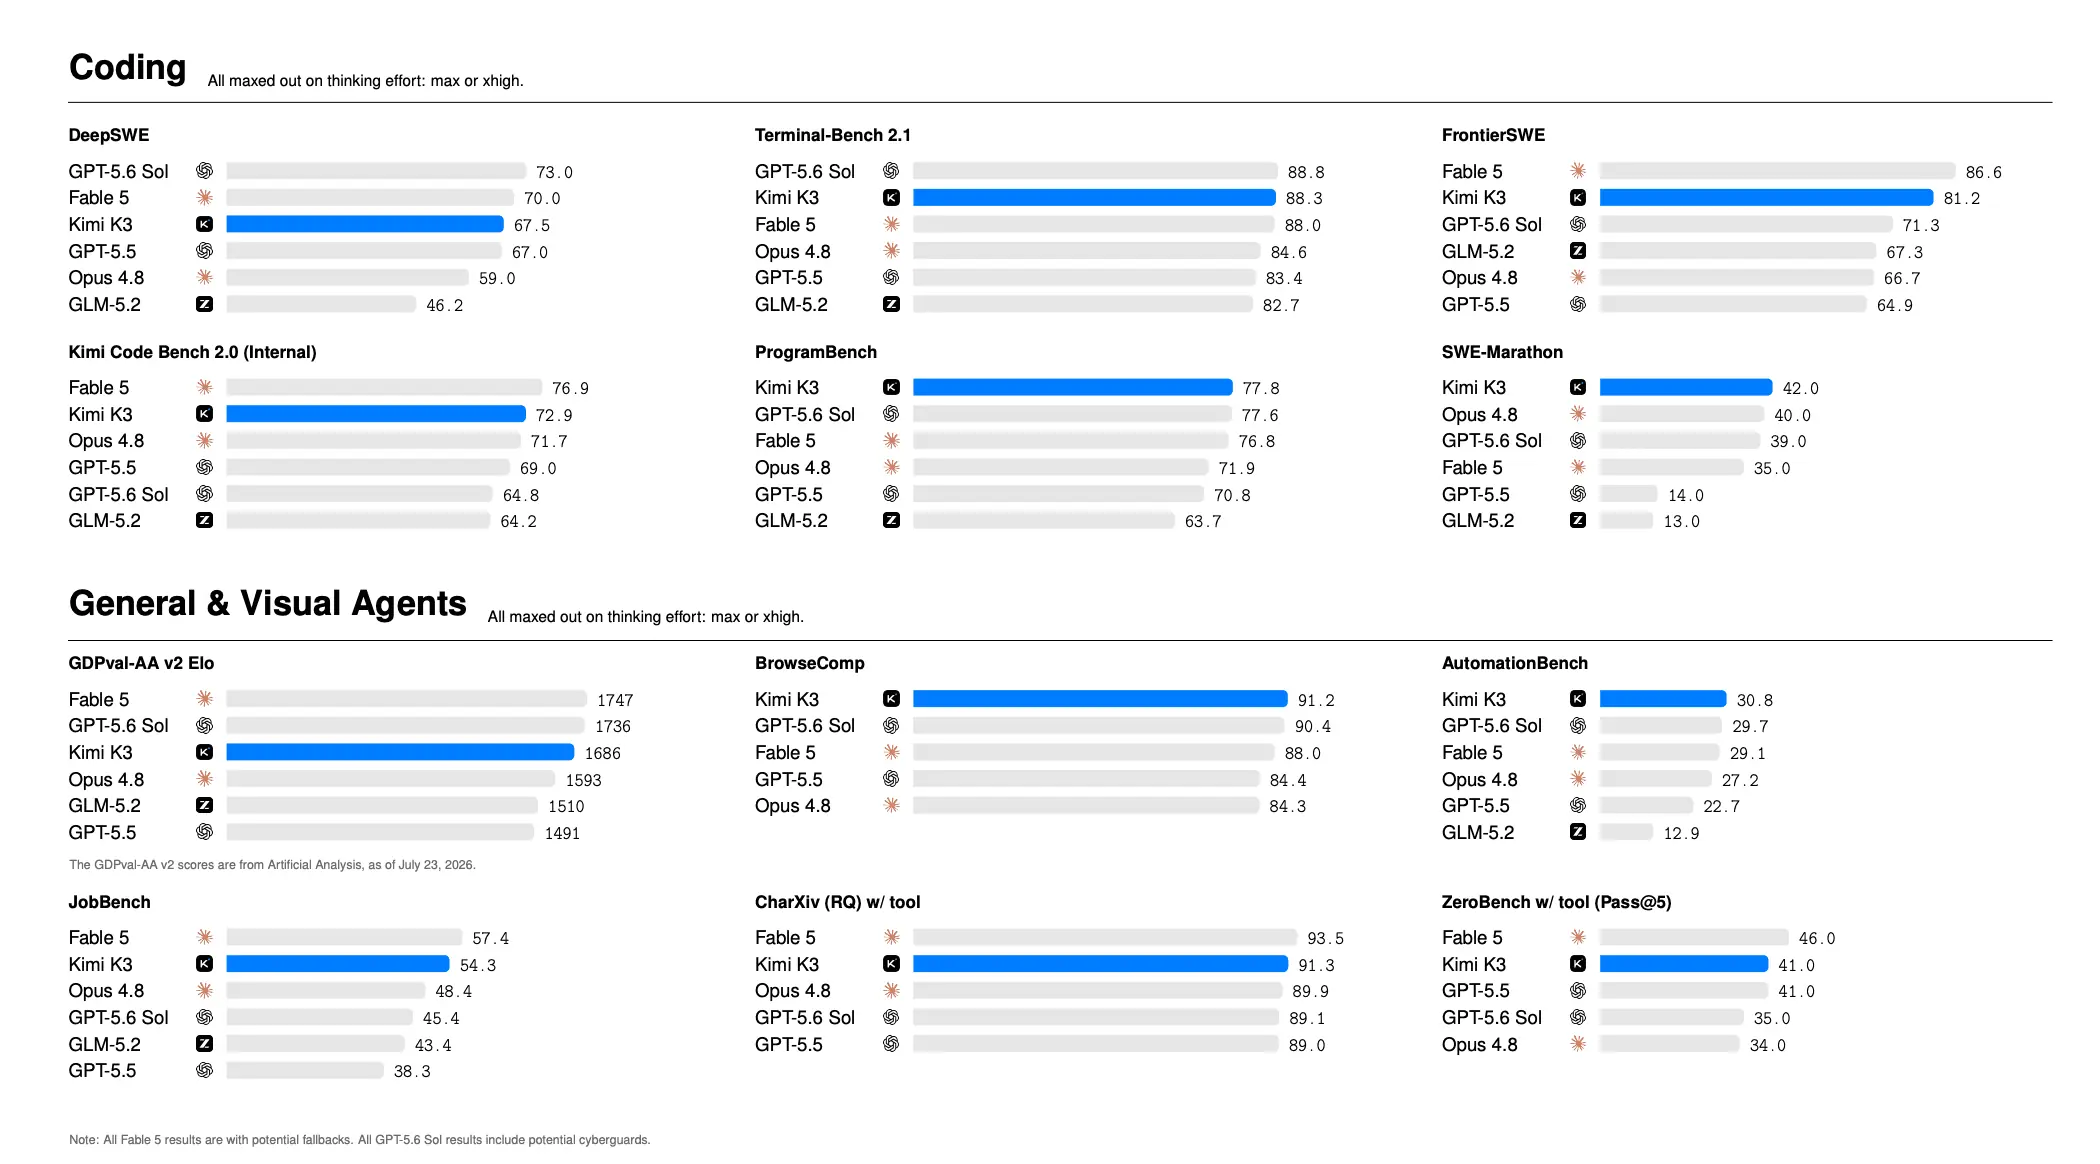
所以,这里并不存在一个绝对的赢家。
如果任务确实需要更深入的推理,而且你愿意为这部分能力支付更高成本,Claude 是更自然的选择。如果任务持续时间很长、需要频繁调用工具,或者整体请求量很大,全部按照前沿闭源模型的价格处理并不划算,那么 Kimi K3 就更有吸引力。
推理路由器要解决的问题,就是在每一次请求到来时判断:这个任务究竟更适合交给哪一个模型?
两者之间的价格差异,也让模型路由不只是一个架构层面的优化。开放权重模型可以由多个平台部署,围绕相同模型提供不同的价格和服务;闭源模型的定价则主要由模型提供方决定。
当 Agent 的模型调用量足够大时,"把大部分合适的请求交给成本更低的模型"和"所有请求都调用价格更高的模型"之间的差距,就不再只是 Benchmark 表格里的几个数字,而会直接体现在最终的推理账单上。
DigitalOcean 推理路由器是怎么做的
推理路由器(Inference Router)位于应用与 DigitalOcean 模型目录之间。你可以预先定义一个模型池,再根据成本、延迟或自定义策略,让路由器为不同请求选择更合适的模型。
对于现有应用来说,改动并不大。过去调用 API 时需要直接指定模型,例如 Kimi K3 或 Claude;接入推理路由器之后,只需要把模型名称替换成一个以 router: 为前缀的路由器名称,后续具体选择哪个模型由路由器完成。
DigitalOcean 推理路由器基于开源代理项目 Plano 构建。其中一个比较关键的设计是:判断请求应该交给哪个模型时,并不会再调用一次通用 LLM,而是使用专门针对模型路由训练的 Plano-Orchestrator。
DigitalOcean 为这一任务训练了 4B 和 30B 两个版本。根据 DigitalOcean 公布的测试结果,在包含近 2,000 条消息、605 段对话的测试集中,30B 版本的平均准确率达到 87.84%,高于 GPT-5.1 的 86.93% 和 Claude Sonnet 4.5 的 86.11%,完成一次模型选择大约需要 200 毫秒。
这样做的意义在于,不需要先调用一次价格更高的前沿模型,只为了判断"接下来应该让哪个模型真正处理请求"。
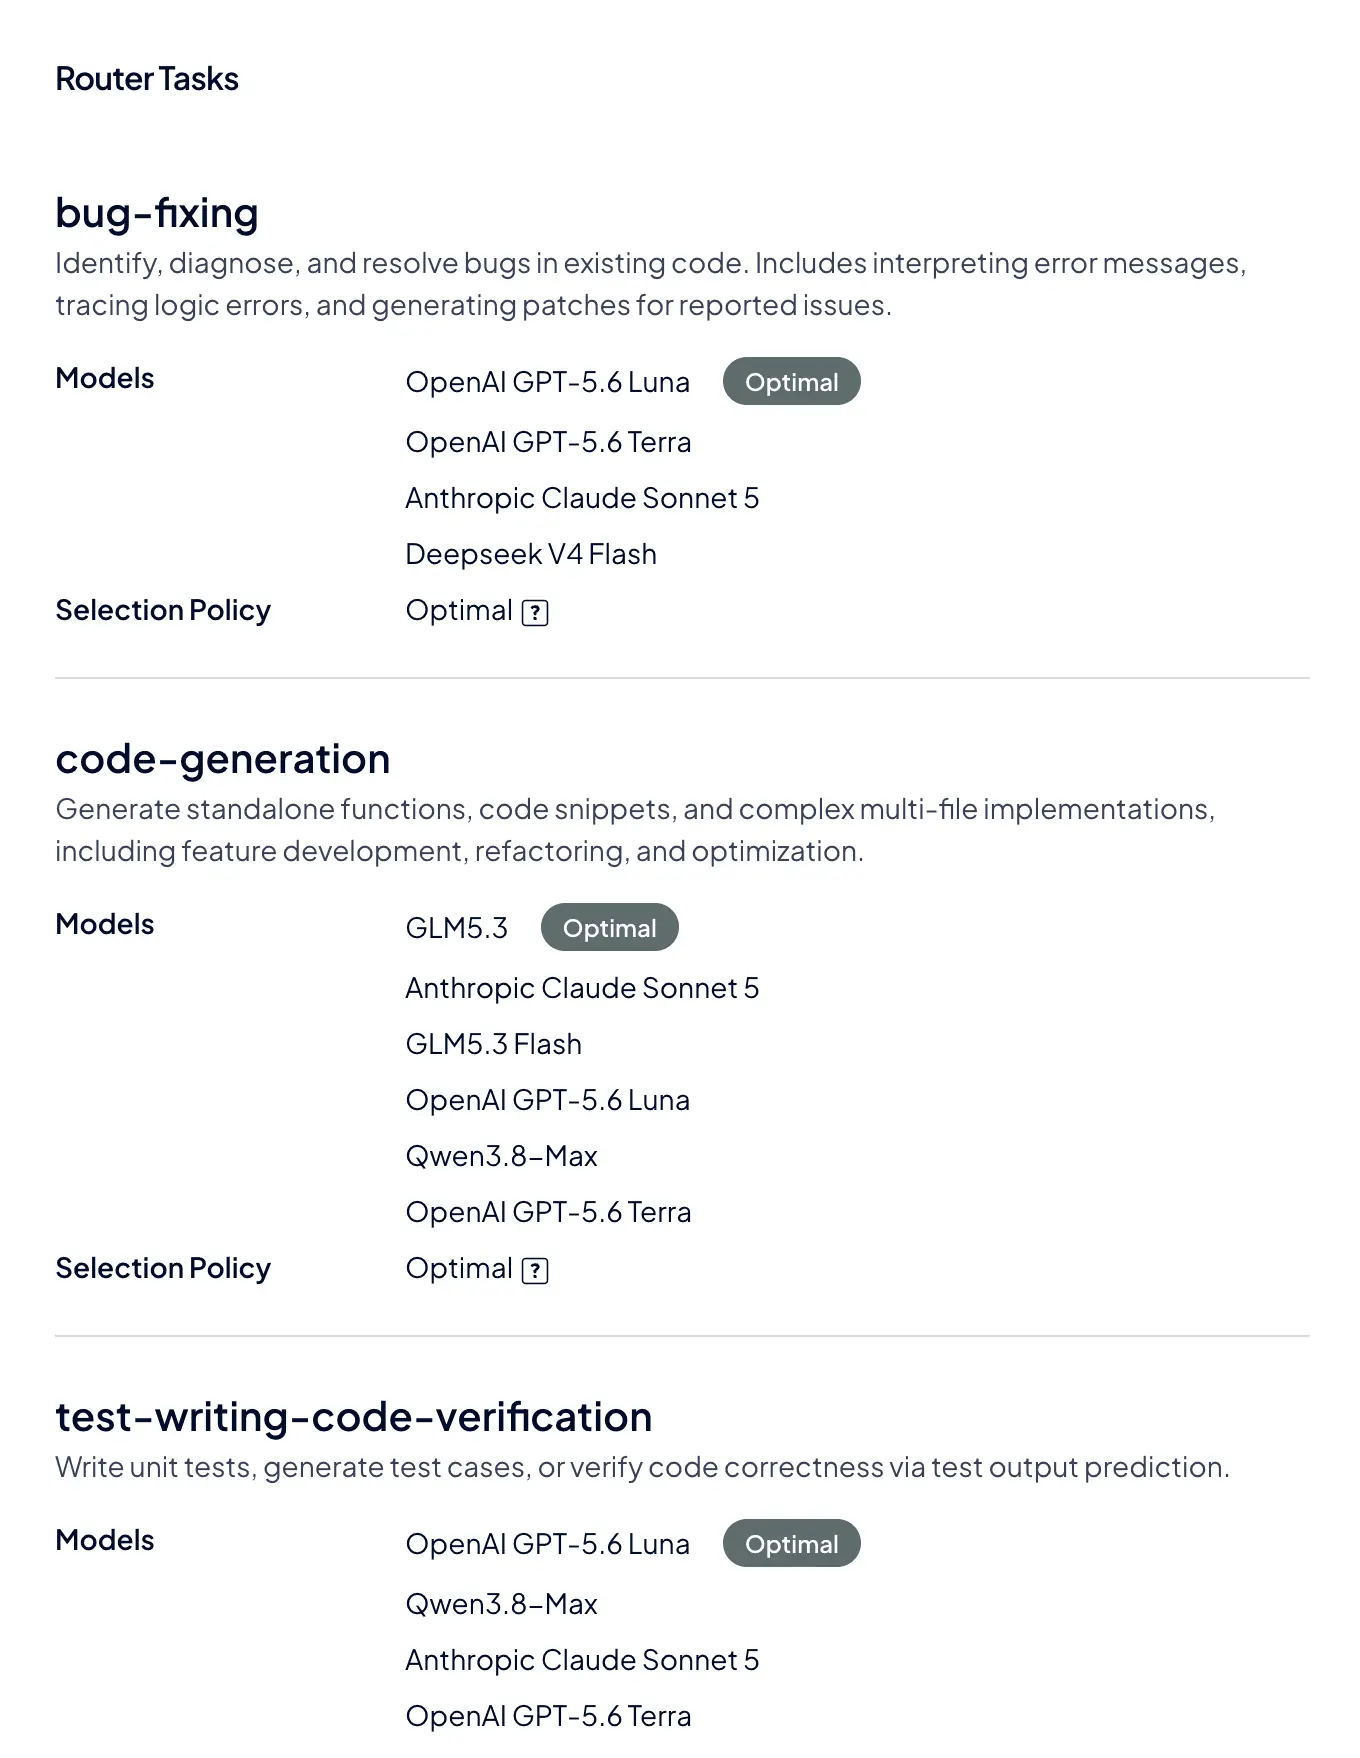
一个路由器可以配置多个任务(Task)。每个任务包含名称和自然语言描述,模型路由器会根据当前请求与这些描述的匹配情况判断任务类型。每个任务还可以配置允许使用的模型池,以及对应的选择策略,例如优先选择成本最低的模型、延迟最低的模型,或者按照预先设定的固定顺序选择。
如果请求没有匹配到任何任务,则会按照配置顺序尝试 Fallback 模型,从而避免请求因为没有匹配到对应任务而无法继续处理。
构建一个同时使用 Kimi K3 和 Claude 的推理路由器
下面这个示例配置了两个任务。
第一个任务用于处理短问题、摘要、快速查询等不需要太多推理,但可能调用量很大的工作;第二个任务负责多步骤编程、长时间工具调用和代码库分析等复杂任务。
对于这些任务,与其提前在应用代码中写死 Kimi K3 或 Claude,不如先把两个模型放进模型池,再让推理路由器根据配置的策略决定具体使用哪个模型。
bash
curl -X POST "https://api.digitalocean.com/v2/gen-ai/models/routers" \
  -H "Authorization: Bearer $DIGITALOCEAN_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "kimi-claude-router",
    "description": "Routes quick lookups and long-running agentic coding work across Kimi K3 and Claude",
    "policies": [
      {
        "custom_task": {
          "name": "quick_turnaround",
          "description": "Short questions, summaries, quick lookups, or single-step answers"
        },
        "models": ["kimi-k3", "anthropic-claude-sonnet-4.6"],
        "selection_policy": { "prefer": "cheapest" }
      },
      {
        "custom_task": {
          "name": "agentic_coding",
          "description": "Multi-step coding tasks, long-horizon tool use, or deep codebase analysis"
        },
        "models": ["anthropic-claude-opus-4.6", "kimi-k3"],
        "selection_policy": { "prefer": "fastest" }
      }
    ],
    "fallback_models": ["kimi-k3"]
}'
这里需要特别注意 custom_task 中的名称和描述。它们并不只是方便开发者阅读的标签,而是模型路由器判断请求属于哪个任务的重要依据。
如果描述写得太宽泛,例如"处理编程任务",很多本不属于这一类的请求也可能被匹配进来;如果描述过于具体,又可能漏掉原本应该进入这个任务的请求。因此,任务描述最好能够清楚说明任务的范围,同时让不同任务之间具有足够明显的区分度。
路由器创建完成后,接入现有 API 调用只需要修改一行:
bash
curl https://inference.do-ai.run/v1/chat/completions \
  -H "Authorization: Bearer $MODEL_ACCESS_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "router:kimi-claude-router",
    "messages": [
      {"role": "user", "content": "What does a KeyError mean in Python?"}
    ]
  }'
这个问题很短,而且只需要一步就能回答,因此应该会被识别为 quick_turnaround。接下来,路由器会在 Kimi K3 和 Claude Sonnet 之间选择当时成本更低的模型。这里的成本不是创建路由器时写死的,而是根据实际情况动态判断。
响应中也会保留模型路由信息:model 字段会告诉你最终由哪个模型完成回答,x-model-router-selected-route 响应头则会显示请求匹配到了哪个任务。
对于多轮 Agent 会话,还有一个容易被忽略的问题:模型不应该在每一轮对话中随意切换。
Anthropic 等平台会缓存对话前面的上下文,让后续请求可以复用已经处理过的内容,从而降低成本和延迟。但这类缓存通常与具体模型绑定。如果在同一段会话中途切换模型,之前建立的缓存可能无法继续复用。
因此,对于一个持续多轮的 Agent 任务,通常更适合让同一个模型从开始一直处理到任务结束,而不是每轮请求都重新进行模型选择。
DigitalOcean 推理路由器可以通过稳定的 X-Model-Affinity Header 保持这种会话亲和性。例如,可以使用应用本身已经维护的 Session ID 或 Task ID,让同一项工作持续交给同一个模型。
如果你仍然希望在成本或性能差异足够明显时允许会话中途切换模型,还可以通过 X-Routing-Max-Switch-Spend-Pct 设置切换模型时允许增加的最大成本。默认情况下,模型切换带来的额外成本不能超过继续使用当前模型成本的 20%。
检查模型路由是否真的有效
模型路由配置完成,并不意味着它一定适合直接进入生产环境。更稳妥的做法,是先用真实业务 Prompt 对它进行验证。
在 DigitalOcean Playground 中,可以使用相同的 Prompt,对比推理路由器和单一模型的表现,并直接查看两者的成本和延迟。Evals 则可以进一步使用带标签的数据集测试路由器,通过正确性和完整性评分判断模型路由是否影响回答质量。
这样可以在上线之前先回答一个很重要的问题:降低推理成本之后,任务完成质量有没有明显下降?
正式上线后,还需要持续观察路由器实际如何分配流量。Analyze Dashboard 可以查看请求匹配自定义任务与进入 Fallback 的比例、Kimi K3 与 Claude 之间的流量分布、缓存上下文的复用情况,以及不同模型和任务对应的延迟。
例如,如果 agentic_coding 请求有 90% 最终都被分配给 Claude,而模型池中明明也包含 Kimi K3,那么模型分布图会很快暴露这个问题。这种情况下,首先值得检查的通常不是"Kimi K3 是否做不了这个任务",而是任务描述是否写得过于偏向 Claude,导致模型路由器很少把请求分配给 Kimi K3。
模型路由也不是配置一次就可以永远不管。更合理的做法,是上线后至少观察一两周。
模型价格和实际延迟都可能发生变化。根据平台负载不同,同一个模型的响应时间在一天内也可能出现两三倍的波动。因此,推理路由器会参考实时数据进行选择,而不是永久执行创建时设定的一条静态规则。
随着业务流量结构发生变化,原本合理的模型路由配置也可能逐渐失去平衡。Fallback 比例持续升高,通常就是比较早出现的信号之一。
结论
所以,这从一开始就不是一个"Kimi K3 和 Claude 到底谁更好"的问题。
如果只选择其中一个模型,你最终还是会回到单模型架构:简单任务和复杂任务调用同一个模型,按照同一种价格付费。区别只在于,你选择的是哪一个模型。
把 Kimi K3 和 Claude 放进同一个模型池之后,思路就不一样了。真正需要更强推理能力的任务可以交给 Claude,而那些调用量很大、需要长时间运行或大量工具调用,同时又不需要为前沿闭源模型能力付费的任务,则可以交给 Kimi K3。
更重要的是,这种架构把"选择哪个模型"从应用代码中抽离了出来。未来模型价格发生变化、延迟出现波动,或者模型池里加入新的模型时,需要调整的是推理路由策略,而不是重新修改应用里的模型调用逻辑。
这才是模型路由真正有价值的地方:不是替你找出一个永远最好的模型,而是让应用不再需要把所有任务都押在同一个模型上。
如果你还想进一步了解如何使用 DigitalOcean 无服务器推理服务,以及更多折扣信息,可直接联系 DigitalOcean 中国区战略合作伙伴卓普云(aidroplet.com)。