多智能体不是越多越好:Google《Towards a Science of Scaling Agent Systems》论文深度解读
论文:Towards a Science of Scaling Agent Systems
arXiv:arxiv.org/abs/2512.08...
本文核验版本:arXiv v3
作者:Yubin Kim、Ken Gu、Chanwoo Park、Chunjong Park、Samuel Schmidgall 等
机构:Google Research、Google DeepMind、MIT
Google Research 官方解读:research.google/blog/toward...
核验日期:2026-09-14
图片说明:标注"图源:Google Research"的图来自官方博客;中文解释图由本文使用 GPT Image 2.5 生成。
中文封面:使用 GPT Image 2.5 生成
一句话读懂
Google 的结论不是"多智能体更强",而是"架构与任务对齐时,多智能体才更强":可并行分解的金融分析最高提升 80.8%,强顺序依赖的规划任务反而下降 39%~70%;决定效果的不是 Agent 数量,而是任务可分解性、工具密度、单智能体基线和协调成本。
前言:Agent Scaling 为什么需要一门"科学"?
过去两年,智能体系统很容易陷入一种工程直觉:
一个 Agent 不够强,就拆成多个;三个不够,再加到五个、十个。
这套直觉来自人类团队:分工通常能增加探索宽度,讨论能够纠错,管理者能够协调资源。但 LLM Agent 并不是人类。每个 Agent 都有独立上下文,彼此交换信息时必须将推理压缩成消息;团队越大,通信、同步、重复劳动和错误传播就越严重。
于是,多智能体系统同时存在两股相反力量:
- 协作收益:任务分解、并行搜索、观点多样性、交叉验证;
- 协调税:通信消耗、上下文碎片、状态不一致、错误级联。
问题是:收益和成本在什么条件下发生反转?
Google Research、Google DeepMind 与 MIT 的这篇论文试图把这个问题从经验判断变成可量化模型。最新版论文控制提示词、工具和计算预算,只改变模型能力与协调拓扑,在 6 个真实 Agent Benchmark、5 种架构、3 个模型家族、260 个配置上进行实验。
需要特别说明一个容易混淆的版本差异:
- Google 2026 年 1 月官方博客介绍的是较早实验快照:180 个配置、4 个 Benchmark;
- 本文以最新 arXiv v3 为准:加入 SWE-bench Verified 和 Terminal-Bench,扩展为 260 个配置、6 个 Benchmark。
1. 先定义:什么才是真正的 Agentic Task?
论文首先纠正了一个评测问题:很多所谓"多 Agent 评测",其实只是在 GSM8K、MMLU、HumanEval 等静态题目上让多个模型投票。这类任务并不能代表真实智能体。
作者要求 Agentic Task 同时具备三个特征:
- 持续、多步地与外部环境交互;
- 在部分可观测条件下迭代收集信息;
- 依据环境反馈动态调整策略。
例如:
| 任务 | 是否典型 Agentic | 原因 |
|---|---|---|
| MMLU 选择题 | 否 | 单次推理,不改变外部环境 |
| GSM8K 数学题 | 通常否 | 题目信息完整,可一次性求解 |
| HumanEval | 较弱 | 函数规格完整;若不运行测试,环境交互有限 |
| SWE-bench | 是 | 需要读仓库、编辑代码、执行测试、根据错误迭代 |
| Web 浏览 | 是 | 页面动态、信息分散,需要多轮搜索与综合 |
| CLI 系统任务 | 是 | 命令会改变系统状态,后续决策依赖反馈 |
这一区分很重要。静态问题上的多数投票,经常可以消除随机错误;真实 Agent 任务里,每次动作会改变世界状态,错误可能在后续十几步中继续放大。
论文指出:经过 10 次环境交互,不同 Agent 所处世界状态的重叠可能只剩约 34%。这时,"最后投票"无法像静态选择题那样简单纠错。
2. 五种典型智能体架构
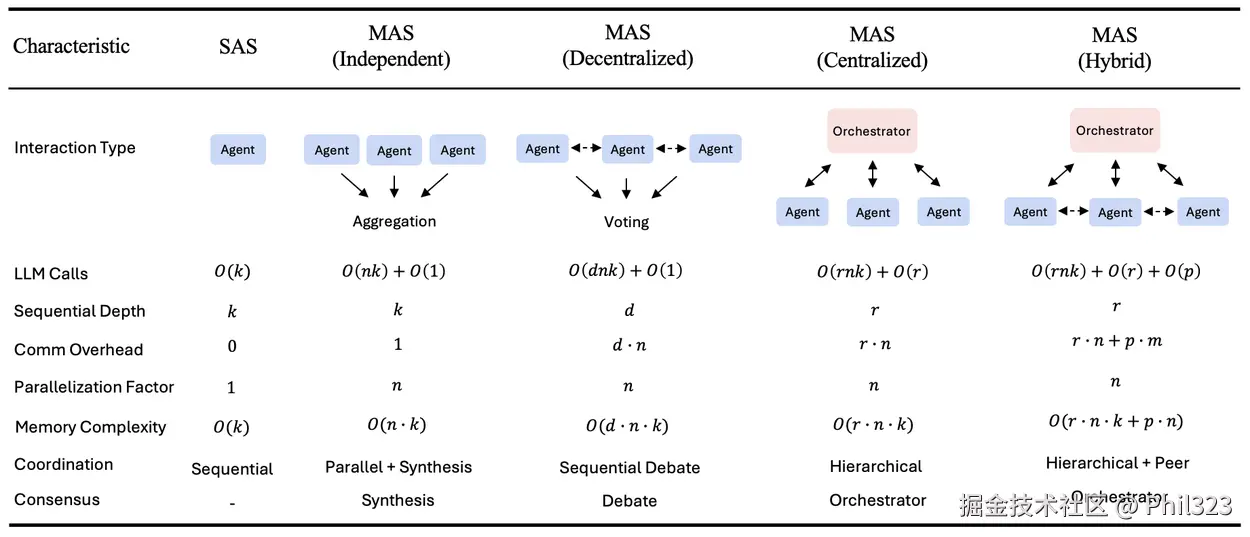
论文没有枚举所有可能的 Multi-Agent 设计,而是选取五种能够拆解协调机制的标准架构。
2.1 单智能体:Single-Agent System(SAS)
一个 Agent 完成感知、规划、工具调用与反思,所有历史进入同一条上下文。
优势:
- 上下文统一,没有同步损失;
- 工具调用与世界状态连续;
- 通信开销为零;
- 调试和归因最简单。
弱点:
- 探索宽度有限;
- 长任务容易受上下文窗口和注意力限制;
- 缺少独立验证者。
需要注意:同一个 Agent 的 self-reflection、ReAct、Chain-of-Thought 仍然属于单智能体,因为决策中心只有一个。
2.2 独立并行:Independent
多个 Agent 独立求解,互不通信,最后通过多数投票或聚合器合并结果。
它最大化并行性,但没有纠错通道。论文发现它是最危险的架构之一:当错误无法在聚合前被审查时,trace 级错误放大达到 17.2 倍。
2.3 中心化:Centralized
一个 Orchestrator 将任务分配给多个子 Agent,再统一检查和综合。
这是典型"主管---员工"结构:
text
             Orchestrator
           /      |       \
      Agent A  Agent B  Agent C
           \      |       /
              最终综合
中心协调者既是瓶颈,也是质量闸门。在论文中,它把错误放大从 Independent 的 17.2 倍压到 4.4 倍,并在金融分析任务中实现最大提升。
2.4 去中心化:Decentralized
Agent 之间点对点通信,通过讨论、辩论或共识形成答案。
它适合高熵搜索:不同 Agent 探索不同路径,再相互校验。缺点是全连接通信成本很高,团队增大时消息量快速膨胀。
2.5 混合架构:Hybrid
同时具有中心编排与横向通信:Orchestrator 控制方向,子 Agent 之间也可交换信息。
它看起来能力最完整,却不等于效果最好。论文中 Hybrid 的平均协调开销达到 515% ,平均每次任务 44.3 个推理回合,是单智能体 7.2 回合的 6.2 倍;过于复杂的协议还带来 12.4% 的协调失败。
2.6 五种架构工程对比
| 架构 | 并行性 | 通信 | 统一验证 | 典型优势 | 典型风险 |
|---|---|---|---|---|---|
| SAS | 无 | 无 | 自检 | 上下文连续、效率高 | 探索不足 |
| Independent | 最高 | 聚合时一次 | 弱 | 成本易并行、观点多样 | 错误直接进入结果 |
| Centralized | 高 | Agent↔编排器 | 强 | 分工、审查、综合 | 编排器瓶颈 |
| Decentralized | 中 | 点对点密集通信 | 共识式 | 高熵搜索、互相纠错 | 消息爆炸 |
| Hybrid | 中 | 层级+点对点 | 强 | 复杂组织能力 | 过度协调 |
3. 实验设计:260 个受控配置
3.1 六个 Benchmark
| Benchmark | 任务类型 | 评估内容 | 工具数 |
|---|---|---|---|
| BrowseComp-Plus | Web 浏览/检索 | 多网站定位、跨页综合 | 3 |
| Finance-Agent | 金融分析 | 定量推理、风险判断 | 5 |
| PlanCraft | Minecraft 规划 | 时空约束与顺序计划 | 4 |
| Workbench | 办公任务/工具选择 | 常见业务活动 | 16 |
| SWE-bench Verified | 软件工程 | GitHub Issue 修复 | 7 |
| Terminal-Bench | CLI 操作 | 系统管理、安全、ML | 2 |
前四个 Benchmark 每个包含 45 种配置(9 个模型 × 5 种架构);后两个因为 Claude Sonnet 3.7 已弃用,每个包含 40 种配置,总计 260。
3.2 三大模型家族
- OpenAI:GPT-5 nano、GPT-5 mini、GPT-5;
- Google:Gemini 2.0 Flash、Gemini 2.5 Flash、Gemini 2.5 Pro;
- Anthropic:Claude Sonnet 3.7、Sonnet 4、Sonnet 4.5。
模型的 Intelligence Index 覆盖 42~71。这个指数综合推理、编码和知识 Benchmark,用于表示基础模型能力。
3.3 为什么这组实验更可信?
作者控制了三个常见混杂变量:
- 同一个任务使用相同 Prompt;
- 所有架构拥有相同工具访问权;
- SAS 与 MAS 匹配总推理 Token 预算,平均每次试验约 4,800 Token。
因此,MAS 不是靠"偷偷多烧几倍 Token"获得优势。多 Agent 虽可并行,但每个 Agent 分到的推理预算更少;这正好暴露了协调与思考对固定预算的竞争。
4. 核心结果:任务结构比 Agent 数量更重要
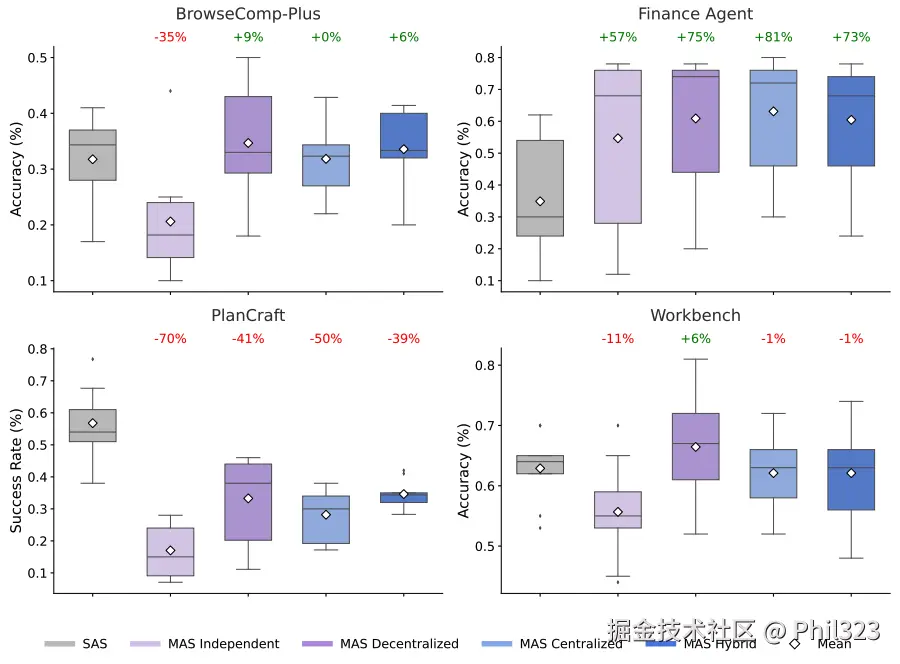
图源:Google Research;Finance-Agent 最高提升约 81%,PlanCraft 最差下降约 70%
4.1 Finance-Agent:中心化架构提升 80.8%
金融分析可自然拆成多个相对独立的信息流:
- Agent A:监管与新闻;
- Agent B:SEC 文件;
- Agent C:营收与成本;
- Agent D:运营影响;
- Orchestrator:验证并综合。
结果如下:
| 架构 | 平均成功率 | 相对 SAS |
|---|---|---|
| SAS | 0.349 | 基线 |
| Centralized | 0.631 | +80.8% |
| Decentralized | 0.609 | +74.5% |
| Hybrid | 0.604 | +73.1% |
| 最弱 MAS | --- | 仍有 +57% |
这是多智能体最擅长的任务:子问题可并行,每条信息流都有价值,中心编排器能完成跨来源验证。
4.2 PlanCraft:所有 MAS 都变差
PlanCraft 的任务类似:
text
查询配方 → 检查库存 → 移动物品 → 合成 → 确认结果它是严格顺序依赖。当前状态是下一步输入,不适合硬拆成并行任务。多 Agent 反而会产生伪分工:
text
Agent 1:查询配方(实际一次调用即可)
Agent 2:检查库存(状态本就共享)
Agent 3:执行合成(真正必要的工作)
编排器:等待并同步三者
结果:
| 架构 | 成功率 | 相对 SAS |
|---|---|---|
| SAS | 0.568 | 基线 |
| Hybrid | 0.346 | -39.1% |
| Decentralized | 0.332 | -41.5% |
| Centralized | 0.282 | -50.3% |
| Independent | 0.170 | -70.0% |
这就是论文所说的 Sequential Penalty(顺序惩罚):任务本身不能并行,分工只会割裂状态与推理链。
4.3 BrowseComp-Plus:去中心化仅提升 9.2%
动态 Web 搜索具有高熵探索特征,适合多个 Agent 搜索不同路径:
- Decentralized:0.347,相对 SAS 0.318 提升 9.2%;
- Centralized:只提升 0.2%;
- Independent:反而下降约 35%。
这里的难点不是搜索不到,而是网页世界不确定、信息难验证。Agent 交换了更多消息,却不一定增加可靠信息。因此收益远小于结构明确的金融分析。
4.4 Workbench:工具多,不等于更需要多 Agent
Workbench 有 16 个工具,但 MAS 效果接近持平:
- Decentralized:+5.6%;
- Centralized、Hybrid:约 -1.2%;
- 部分架构:最低约 -11%。
原因是工具越多,协调工具权限、调用顺序、参数和状态的成本越高。论文测得效率与工具数的交互系数为:
text
β = -0.096,p = 0.002也就是说,工具密集并不是"多 Agent 更有用"的证据,反而可能加重协调税。
4.5 SWE-bench Verified:强单 Agent 的"能力天花板"
SWE-bench Verified 中,SAS 平均成功率已达 0.522。所有 MAS 都下降:
| 架构 | 相对变化 |
|---|---|
| Hybrid | -2.1% |
| Centralized | -3.1% |
| Decentralized | -5.4% |
| Independent | -14.9% |
当单智能体已经能够读代码、编辑文件、跑测试并根据错误持续修正时,再加入协调层的边际收益很小。
4.6 Terminal-Bench:低工具数下,重编排不划算
Terminal-Bench 只有两个工具。Independent 有 +1.7% 的小幅收益,而 Centralized 下降 19.2%。任务虽然不容易,但工具结构简单,复杂 Orchestrator 没有足够工作来摊薄自身成本。
4.7 汇总:平均值几乎没有意义
六个 Benchmark 聚合后,MAS 平均只比 SAS 下降 0.3% ,95% 置信区间却从 -58.7% 到 +77.2%。
这并不表示多 Agent "平均无效",而是说明平均值掩盖了结构差异:
- 最好:Finance Centralized,+80.8%;
- 最差:PlanCraft Independent,-70.0%。
同一个"多智能体"标签可以覆盖 150 个百分点的结果差异。
5. 协调税:多智能体为什么会变笨?
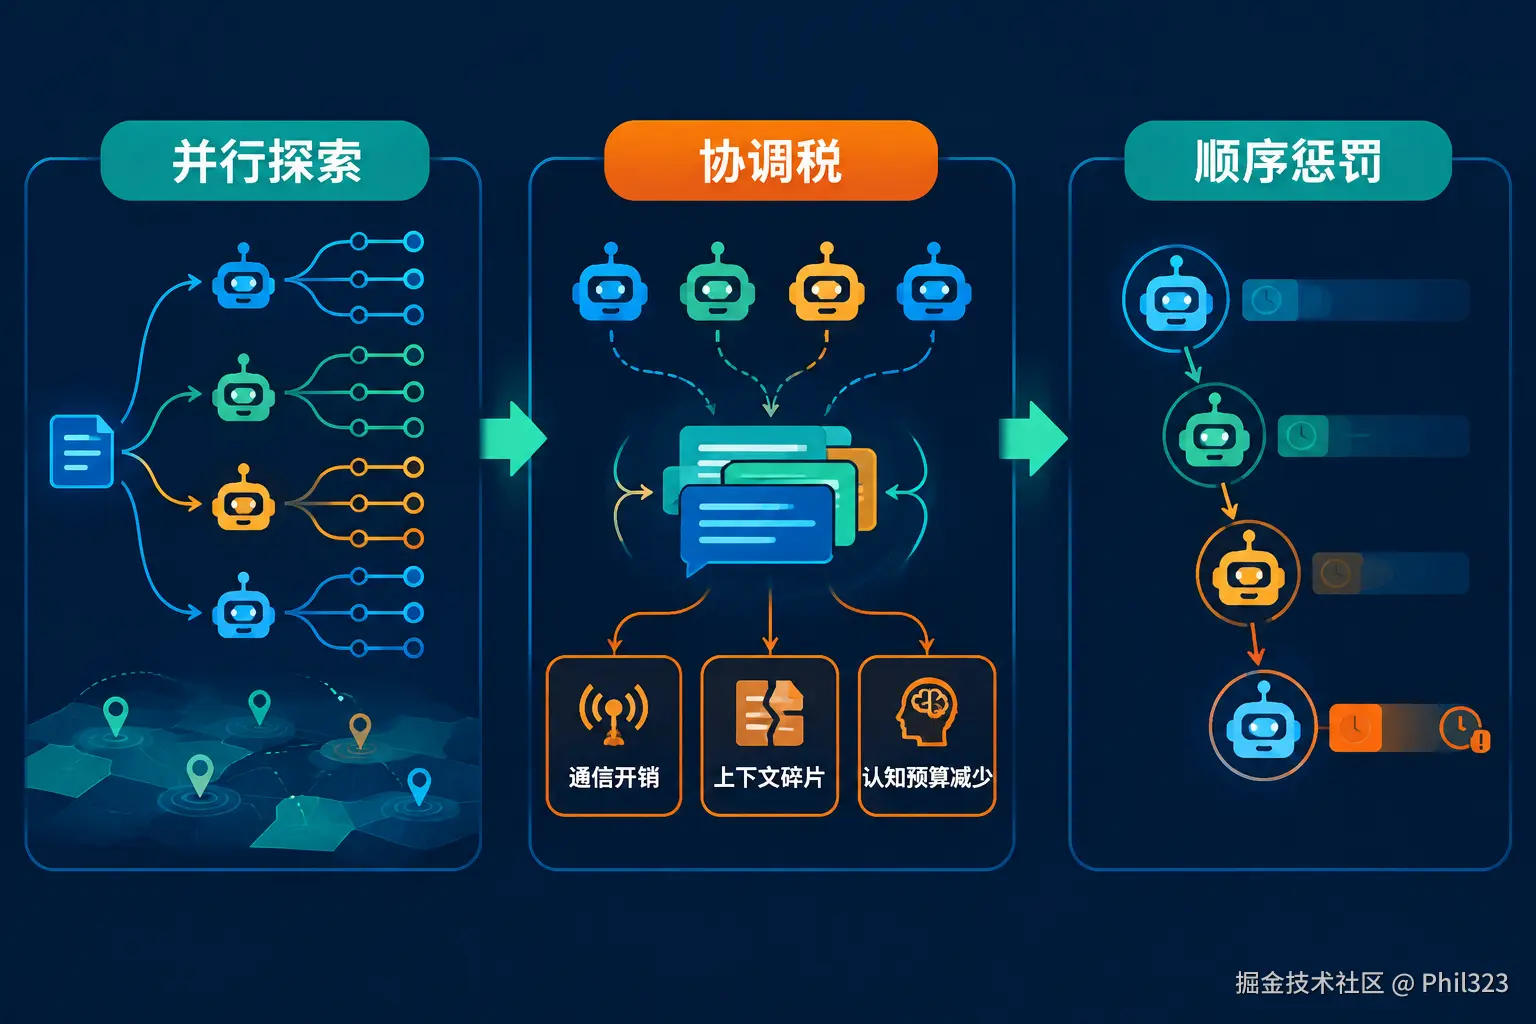
中文解释图:使用 GPT Image 2.5 生成
5.1 上下文从"共享记忆"变成"有损消息"
SAS 的所有推理都在一条记忆流里。MAS 中,一个 Agent 无法直接访问另一个 Agent 的完整内部状态,只能收到压缩后的消息。
压缩带来三种损失:
- 细节被删掉;
- 假设与证据分离;
- 世界状态不同步。
因此,多 Agent 虽增加探索多样性,却降低全局上下文整合能力。
5.2 推理回合呈超线性增长
论文拟合得到:
text
Turns = 2.72 × (n + 0.5)^1.724
R² = 0.974
指数 1.724 明显大于 1,说明 Agent 数增加时,回合数不是线性增长。作者外推:
- 6 个 Agent:约 69 回合;
- 10 个 Agent:约 157 回合;
- SAS:平均 7.2 回合。
固定 Token 预算下,通信越多,每个 Agent 真正思考的 Token 越少。
5.3 不同架构的成本账
| 指标 | SAS | Independent | Decentralized | Centralized | Hybrid |
|---|---|---|---|---|---|
| 平均成功率 | 0.466 | 0.370 | 0.477 | 0.463 | 0.452 |
| 平均回合数 | 7.2 | 11.4 | 26.1 | 27.7 | 44.3 |
| 协调开销 | 0% | 58% | 263% | 285% | 515% |
| 效率 | 0.466 | 0.234 | 0.132 | 0.120 | 0.074 |
| 错误放大 | 1.0× | 17.2× | 7.8× | 4.4× | 5.1× |
| 每千 Token 成功数 | 67.7 | 42.4 | 23.9 | 21.5 | 13.6 |
表里有一个值得细看、而不是简单排名的矛盾:
- Decentralized 平均成功率最高,为 0.477;
- 但效率只有 SAS 的约 28%;
- Hybrid 组织能力最复杂,却在成功率与效率上都没有领先。
生产系统不能只问"分数最高吗",还要问"每提升 1%,花了多少 Token、延迟和故障面?"
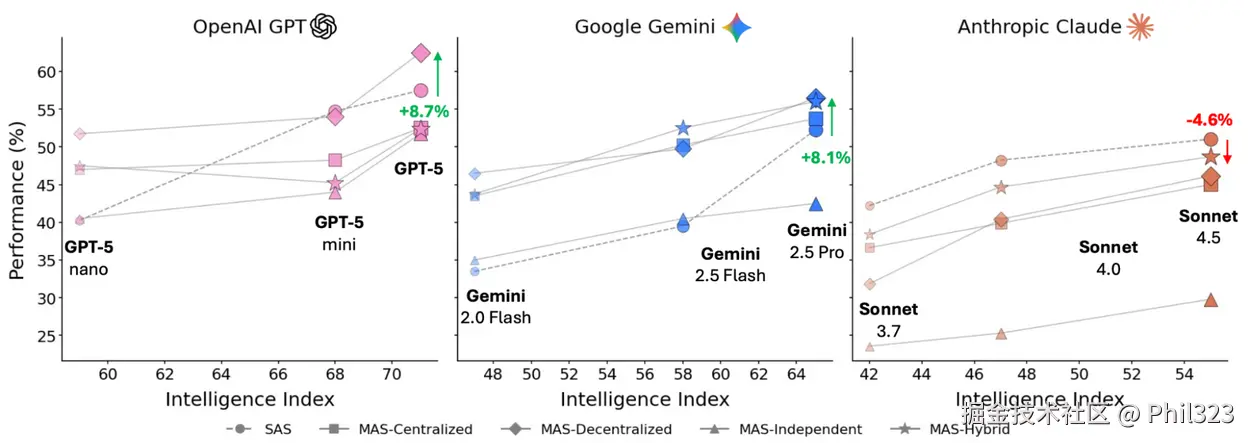
图源:Google Research;模型能力提高通常提升表现,但架构错配会抵消模型升级
6. 能力饱和:45% 是一个重要边界
回归模型发现显著的基线悖论:
text
Single-Agent Baseline × log(1 + Agent Count)
β = -0.236,p = 0.004
数据推导出的决策边界约为 单智能体成功率 45%:
- SAS < 45%:MAS 仍可能通过分工、冗余和验证获得收益;
- SAS > 45%:协调成本更容易超过剩余改进空间。
该阈值在 SWE-bench Verified 与 Terminal-Bench 的 16 个"模型×Benchmark"组合上得到 94% 匹配率。
这不是普适物理常数。它来自当前模型、预算、架构和六个 Benchmark,应被当作工程先验,而不是硬规则。但它提供了非常实用的起点:
在设计多 Agent 之前,先跑出单 Agent 基线。基线已经很高时,优先优化模型、上下文与工具,而不是扩充团队。
7. 架构也是安全机制:错误如何被放大?
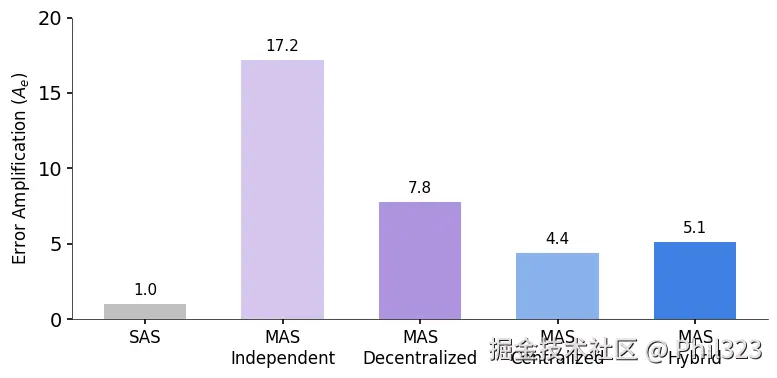
图源:Google Research;中心化架构在成功率与错误控制之间取得较好平衡
作者分析了四类错误:
| 错误类型 | 定义 | 架构表现 |
|---|---|---|
| 逻辑矛盾 | 同时断言 X 与非 X | Centralized 降至 9.1%,减少 36.4% |
| 数值漂移 | 舍入、单位转换误差累积超过 5% | Centralized/Decentralized 降至 18.3% |
| 上下文遗漏 | 忽略此前实体、关系或状态 | Centralized 降至 8.3%,减少 66.8% |
| 协调失败 | 任务冲突、消息误读、状态不同步 | Hybrid 最高,达到 12.4% |
为什么 Independent 放大错误 17.2 倍?
Independent 只有结果聚合,没有过程验证。如果三个 Agent 基于相同错误假设独立推理,多数投票只会强化错误,而不是纠正错误。
为什么 Centralized 只有 4.4 倍?
Orchestrator 创建了一个 Validation Bottleneck(验证瓶颈):
- 检查子 Agent 证据;
- 比较冲突结论;
- 拒绝无来源的推断;
- 统一状态后再生成答案。
因此,中心化不是单纯管理模式,也是一种可靠性边界。
过度讨论同样危险
成功运行中的矛盾信息占比中位数为 2.3%,失败运行中为 8.1%。适度共享有利于形成一致证据,但冗余率超过 0.50 后,成功率与冗余呈负相关。
论文测得最优冗余约为 0.41,接近 Centralized 的中位水平:既有足够重叠用于验证,又保留独立探索。
8. 到底需要几个 Agent?
作者用 Gemini 2.0 Flash 和 Gemini 2.5 Pro 测试了 1、3、5、7、9 个 Agent:
- Gemini 2.0 Flash 在部分架构下到 7 个 Agent 达到峰值,之后下降;
- Gemini 2.5 Pro 的去中心化架构更早到顶;
- 强模型的 Centralized 在超过 5 个 Agent 后出现明显边际递减。
这个结果反直觉:更强模型并不自动容纳更多 Agent。
原因是强模型的 SAS 基线更高,剩余提升空间更小;增加团队成员后,协调成本更快超过协作收益。
实践上可以这样做:
text
1 Agent → 建立基线
3 Agents → 测试是否存在并行收益
5 Agents → 仅在 3 Agent 明显改善后继续
7+ Agents → 必须用成本曲线和错误率证明价值
不要把 10 Agent 当默认配置。论文的超线性回合模型表明,超过 3~4 个 Agent 后,固定预算下每个 Agent 的推理质量会明显受压。
9. 混用强弱模型有用吗?
论文还研究了异构团队:高能力模型和低能力模型混用。
9.1 去中心化混合具有一定潜力
在 BrowseComp-Plus 上,混合能力的 Decentralized 接近或超过全高能力配置:
| 家族 | 混合能力 | 全高能力 |
|---|---|---|
| OpenAI | 0.53 | 0.50 |
| Anthropic | 0.47 | 0.37 |
| 0.42 | 0.43 |
说明点对点讨论有时能够利用强弱模型的探索差异。
9.2 中心化系统中,强执行者比强主管更重要
三大模型家族都表现出相同趋势:高能力子 Agent + 较弱 Orchestrator 往往优于强 Orchestrator + 弱子 Agent。
这是很实用的成本建议:
- 把最强模型用于关键检索、分析和代码修改;
- 编排器可使用较便宜但指令遵循稳定的模型;
- 但必须用评测证明,不能假设"小模型当主管"永远可行。
论文的 13 个异构配置也显示,模型混合并未绕过能力饱和:中心化异构配置平均比强模型同构团队低 12.6 个百分点;去中心化只有约 +2.0 个百分点的边际收益。
10. 预测模型:能否在开发前选对架构?
作者建立混合效应回归模型,输入包括:
- 模型能力:Intelligence Index 或 Agentic Capability Index(ACI);
- Agent 数量;
- 工具数量;
- 单智能体基线;
- 协调开销;
- 消息密度;
- 冗余率;
- 协调效率;
- trace 级错误放大。
10.1 模型效果
| 能力指标 | 训练 R² | 交叉验证 R² |
|---|---|---|
| Intelligence Index | 0.463 | 0.373 |
| ACI(六个 Agent Benchmark 的 SAS 均值) | 0.481 | 0.413 |
绝对性能预测的 R² 并不高,论文也没有回避这一点。跨任务环境差异巨大,一个统一方程很难精确预测每个分数。
但"选哪个架构最好"更稳定:对留出配置的最佳架构选择准确率达到 87%:
- 随机选择:20%;
- 仅按能力选择:54%;
- 完整协调模型:87%。
在三个训练范围之外的模型 GPT-5.2、Gemini 3.0 Pro、Gemini 3.0 Flash 上,15 个"架构×模型"组合的平均绝对误差为 0.077;MAS 的 MAE 为 0.061,优于 SAS 的 0.138。
因此,这个模型更适合:
对候选架构排序,而不是承诺"上线后一定有 63.1% 成功率"。
11. 一套可执行的架构选型规则
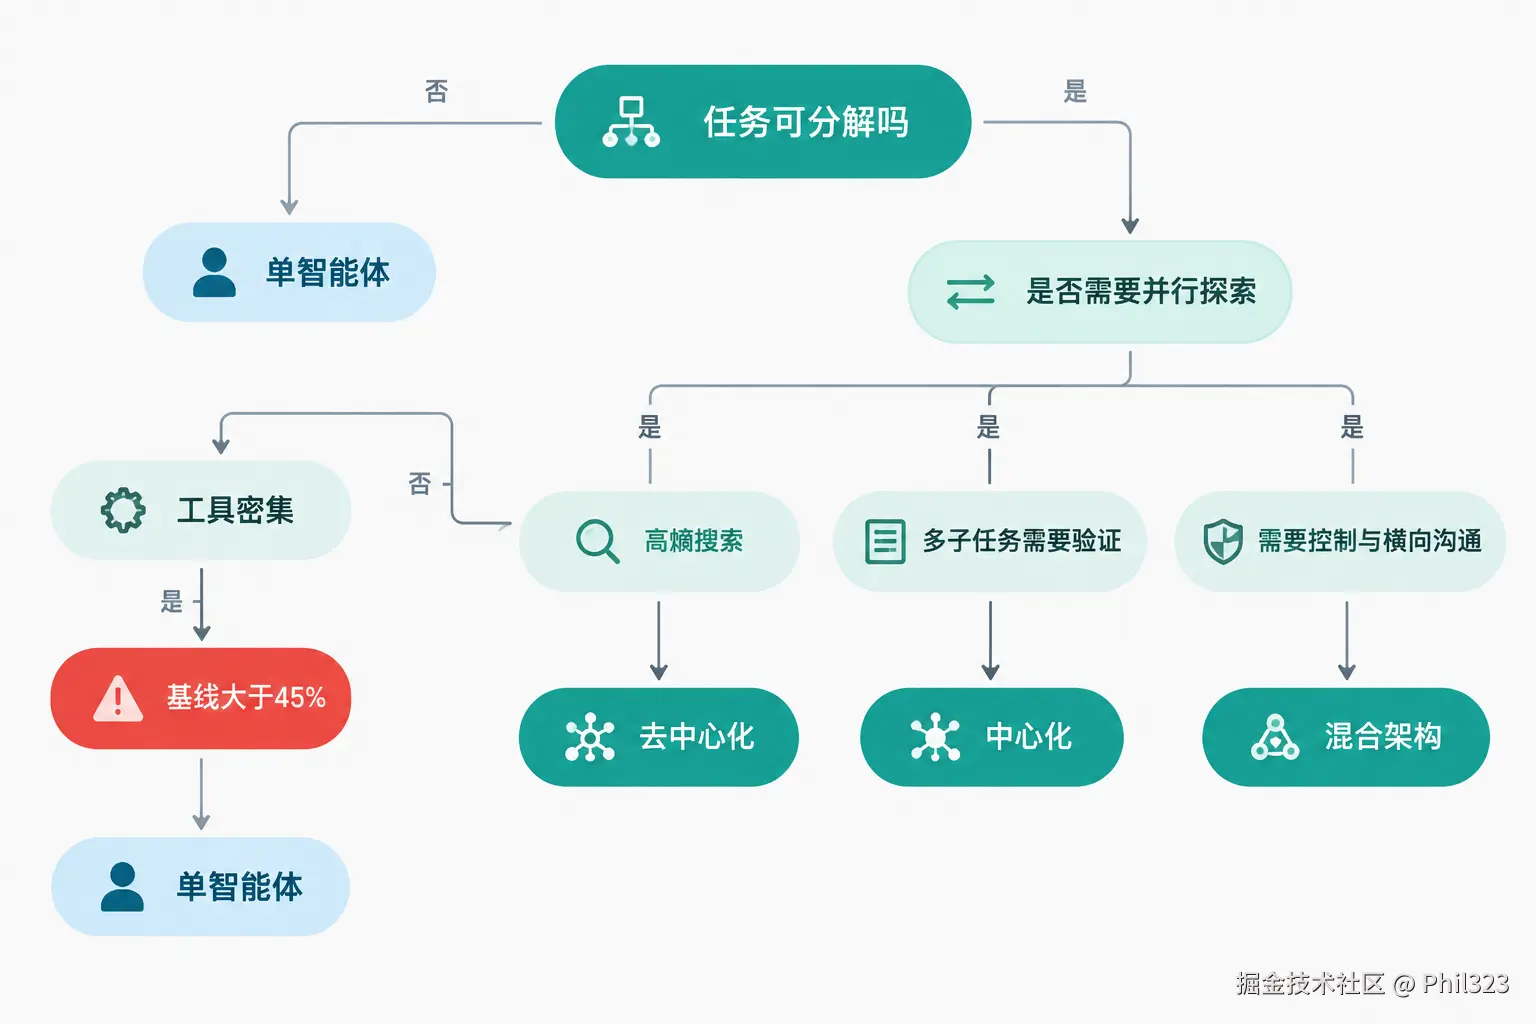
中文解释图:使用 GPT Image 2.5 生成
11.1 先问五个问题
- 任务是否能自然拆成相对独立的子问题?
- 子任务是否可以基于同一个初始状态并行执行?
- 工具数是否很多,工具调用是否改变共享状态?
- 单智能体成功率是否已经高于约 45%?
- 错误是否需要统一验证后才能进入最终输出?
11.2 选型建议
| 任务特征 | 推荐架构 | 论文证据 |
|---|---|---|
| 强顺序依赖、状态持续变化 | SAS | PlanCraft 中 MAS -39%~-70% |
| 可分解分析、需要统一综合 | Centralized | Finance +80.8%,错误放大仅 4.4× |
| 高熵搜索、路径多样 | Decentralized | BrowseComp +9.2% |
| 多个独立解、可客观投票 | Independent | 只适合结果易验证的静态或弱交互任务 |
| 同时需要层级控制和横向协作 | Hybrid,谨慎使用 | 开销 515%,协调失败 12.4% |
| SAS 基线 >45% | 优先 SAS | SWE-bench 中全部 MAS 下降 |
| 16+ 工具且共享状态复杂 | 先简化工具路由 | 工具×效率交互 β=-0.096 |
12. 一个最小工程实验:别先写多 Agent 框架
如果你准备开发一个"公司财报研究 Agent",正确顺序不是先搭 Orchestrator,而是做可对比实验。
12.1 建立三组配置
python
CONFIGS = {
    "sas": {
        "agents": 1,
        "architecture": "single",
        "token_budget": 4800,
    },
    "centralized_3": {
        "agents": 3,
        "architecture": "centralized",
        "token_budget": 4800,
    },
    "decentralized_3": {
        "agents": 3,
        "architecture": "decentralized",
        "token_budget": 4800,
    },
}
12.2 固定变量
- 同一模型版本;
- 同一系统提示词;
- 同一工具集;
- 同一总 Token / 迭代预算;
- 同一组任务;
- 温度和随机种子尽量固定。
12.3 至少记录这些指标
python
metrics = {
    "success": 0 or 1,
    "total_tokens": 0,
    "wall_time_seconds": 0.0,
    "tool_calls": 0,
    "coordination_messages": 0,
    "contradictions": 0,
    "retries": 0,
    "cost_usd": 0.0,
}
12.4 质量门槛
建议只在同时满足以下条件时采用 MAS:
text
成功率有统计意义地提高
AND 单次成功成本可接受
AND P95 延迟不越界
AND 错误放大没有恶化
AND 失败可归因、可重放
如果 MAS 只提升 2%,却多花 5 倍 Token、增加 3 倍延迟和新的状态同步故障,那不是 Scaling,而是系统复杂化。
13. 对 Agent 框架设计的启示
13.1 Orchestrator 应首先是验证器
很多项目把 Orchestrator 写成"转发任务的 Dispatcher"。论文说明它最重要的价值是错误吸收:
- 要求证据;
- 检查冲突;
- 对工具结果做 schema 验证;
- 对最终结论执行一致性检查;
- 在信息不足时拒绝聚合。
13.2 优先减少消息,而不是鼓励讨论
消息密度与性能呈对数饱和,约在 0.39~0.41 条消息/推理回合附近进入平台期。更多消息不一定带来更多信息。
可使用:
- 结构化消息 schema;
- 只传证据、结论和不确定性;
- 基于事件的通信,而非每轮广播;
- 设置最大协调轮次;
- 对重复内容去重。
13.3 工具要按能力路由
工具密集环境的主要问题不是 Agent 不够多,而是:
- 每个 Agent 看见太多工具;
- 工具权限重叠;
- 状态修改发生冲突;
- 编排器需要理解所有工具参数。
更有效的设计可能是给每个 Agent 一小组确定工具,并由中心状态机管理有副作用的调用。
13.4 先扩展模型,再扩展组织
论文中模型 Intelligence Index 的线性效应显著:
text
β = 0.126,p = 0.008在测试范围内,没有出现"Agent 越多带来超线性智能涌现"的证据。升级基础模型通常可靠地提高所有架构表现;错误的协调结构却能抵消模型升级。
14. 论文局限:这些数字不能机械套用
作者列出了多项限制,工程使用时必须保留:
- 只覆盖五种典型拓扑,没有穷尽动态路由、黑板系统、自组织层级;
- Agent 数最多测试到 9,大规模群体行为主要依赖外推;
- 大多数异构实验仍是同一家族不同能力档位;
- Prompt 为保证控制实验而保持一致,没有针对每个模型和架构优化;
- 只有六个 Benchmark,未覆盖具身智能、多用户协作等任务;
- SWE-bench 和 Terminal-Bench 每配置仅 20 个样本,单格置信区间较宽;
- 部分统计关系在 cluster-robust 修正后只应视为方向性模式;
- 45% 阈值来自当前数据分布,不是跨时代常数。
尤其值得注意:经过聚类稳健推断与多重比较修正后,能力饱和/单智能体基线是最稳健的结论;工具协调税虽然方向与大量实验一致,但跨域统计解释应更保守。
这反而增强了论文的可信度:它没有把有限实验包装成普适定律,而是给出了可继续验证的量化框架。
15. 总结:从"Agent 数量崇拜"回到系统工程
这篇论文最重要的价值,不是发明了一个新 Agent 框架,而是给多智能体工程划出几条边界:
结论一:可分解性决定协作上限
金融分析能自然并行,Centralized 提升 80.8%;PlanCraft 必须串行,MAS 最差下降 70%。
结论二:单 Agent 已经强时,不要硬组团队
约 45% 的 SAS 成功率是一个有用预警线。基线越高,多 Agent 的剩余提升空间越小。
结论三:工具越多,协调未必越有价值
16 个工具会放大权限、参数、状态与通信成本。工具复杂度和组织复杂度相乘,可能让系统更差。
结论四:中心编排器首先是可靠性组件
Independent 把错误放大 17.2 倍,Centralized 通过验证瓶颈压到 4.4 倍。
结论五:Agent Scaling 有硬成本
回合数随 Agent 数呈约 1.724 次幂增长。Hybrid 平均开销 515%,每千 Token 成功效率只有 SAS 的约五分之一。
所以,正确的问题不再是:
"我应该放几个 Agent?"
而是:
"这项任务有多少可并行的独立信息流?协调消息能增加多少可验证信息?在固定预算下,协作收益能否覆盖协调税?"
当团队能用实验回答这三个问题,多智能体系统才从 Demo 进入真正的工程科学。
参考资料
- Kim, Y. et al. Towards a Science of Scaling Agent Systems . arXiv:2512.08296:arxiv.org/abs/2512.08...
- Google Research 官方博客,Towards a science of scaling agent systems: When and why agent systems work :research.google/blog/toward...
- BrowseComp-Plus:arxiv.org/abs/2508.06...
- Finance-Agent:arxiv.org/abs/2508.00...
- PlanCraft:arxiv.org/abs/2412.21...
- WorkBench:arxiv.org/abs/2407.15...
- SWE-bench Verified:www.swebench.com/
- Terminal-Bench:www.tbench.ai/