摘 要
分心驾驶属于引发交通事故的关键因素之一,给道路交通安全带来极大威胁,传统的行为识别方法在复杂的驾驶场景当中存在准确率低,无法及时识别等情况。本文研究并完成了一套依靠深度学习的驾驶员分心驾驶行为识别系统,该系统把改良过的YOLOv8模型当作视觉识别的核心部分,可以针对驾驶员的照片,摄像机即时拍摄的画面以及驾驶录像做到精确的行为分类和定位,在涉及视频分析的时候,本文制定了一套包含取帧,多数投票以及风险积分的分析准则,还更新加入了通话记录相融合的逻辑,按照触摸中控屏,同个手机号以及通话启动之后十秒之内的这些规则,有效地分辨出了触摸中控屏和拨打电话这两种容易产生误解的行为。 系统采用前后端分离架构,其后端依托FastAPI框架给予RESTful接口,前端利用Vite塑造单页应用,从而达成了包括即时检测,媒体分析,历史会话管理,系统设置以及PDF报告导出等诸多完整功能,经过实验和系统检测可知,此系统可精准识别十种常见驾驶行为,并遵照风险积分模型给出恰当的驾驶安全判断,进而给驾驶员安全辅助赋予有效的技术保障。
关键词:分心驾驶;YOLOv8;深度学习;行为识别;风险积分;通话融合
ABSTRACT
Distracted driving is one of the main causes of traffic accidents and poses a serious threat to road traffic safety. Traditional behavior recognition methods face issues such as low accuracy and poor real-time performance in complex driving scenarios. This paper studies and implements a deep learning-based driver distracted driving behavior recognition system. The system uses an improved YOLOv8 model as the core for visual recognition, capable of accurately classifying and locating driver images, real-time camera footage, and driving videos. For video analysis scenarios, this paper designs an analysis rule combining frame extraction, majority voting, and risk scoring, and innovatively introduces a call record fusion logic. By using rules involving touching the central console, the same phone number, and a ten-second window from the call start time, it effectively distinguishes between the easily confused behaviors of touching the central console and making/receiving calls. The system adopts a front-end and back-end separation architecture, with the back-end providing RESTful interfaces based on the FastAPI framework, and the front-end using Vite to build a single-page application, achieving complete functions including real-time detection, media analysis, historical session management, system configuration, and PDF report export. Experiments and system tests show that the system can accurately recognize ten common driving behaviors and output reasonable driving safety conclusions based on the risk scoring model, providing effective technical support for driver safety assistance.
Key words: Distracted driving; YOLOv8; deep learning; behavior recognition; risk scoring; call integration
目 录
[第1章 绪论](#第1章 绪论)
[1.1 研究背景与意义](#1.1 研究背景与意义)
[1.2 国内外研究现状](#1.2 国内外研究现状)
[1.2.1 国外研究现状](#1.2.1 国外研究现状)
[1.2.2 国内研究现状](#1.2.2 国内研究现状)
[1.2.3 基于传统机器学习的行为识别方法](#1.2.3 基于传统机器学习的行为识别方法)
[1.2.4 基于深度学习的驾驶员行为识别](#1.2.4 基于深度学习的驾驶员行为识别)
[1.2.5 驾驶行为风险评估研究](#1.2.5 驾驶行为风险评估研究)
[1.3 本文主要研究内容](#1.3 本文主要研究内容)
[1.4 论文组织结构](#1.4 论文组织结构)
[第二章 相关技术基础](#第二章 相关技术基础)
[2.1 深度学习与卷积神经网络](#2.1 深度学习与卷积神经网络)
[2.1.1 神经网络基础](#2.1.1 神经网络基础)
[2.1.2 卷积神经网络](#2.1.2 卷积神经网络)
[2.2 YOLO目标检测算法](#2.2 YOLO目标检测算法)
[2.2.1 YOLOv1到YOLOv8的发展](#2.2.1 YOLOv1到YOLOv8的发展)
[2.2.2 YOLOv8模型架构](#2.2.2 YOLOv8模型架构)
[2.2.3 驾驶员行为识别中的YOLOv8应用](#2.2.3 驾驶员行为识别中的YOLOv8应用)
[2.3 FastAPI后端框架](#2.3 FastAPI后端框架)
[2.3.1 FastAPI的核心特性](#2.3.1 FastAPI的核心特性)
[2.3.2 在系统中的角色与应用](#2.3.2 在系统中的角色与应用)
[2.4 前端开发技术栈](#2.4 前端开发技术栈)
[2.4.2 原生ES Modules与模块化设计](#2.4.2 原生ES Modules与模块化设计)
[2.4.3 原生CSS视觉系统](#2.4.3 原生CSS视觉系统)
[第三章 系统总体设计](#第三章 系统总体设计)
[3.1 系统架构设计](#3.1 系统架构设计)
[3.2 功能模块划分](#3.2 功能模块划分)
[3.2.1 用户认证模块](#3.2.1 用户认证模块)
[3.2.2 实时检测模块](#3.2.2 实时检测模块)
[3.2.3 图片检测模块](#3.2.3 图片检测模块)
[3.2.4 视频分析模块](#3.2.4 视频分析模块)
[3.2.5 通话记录管理模块](#3.2.5 通话记录管理模块)
[3.2.6 历史会话管理模块](#3.2.6 历史会话管理模块)
[3.2.7 系统配置模块](#3.2.7 系统配置模块)
[3.2.8 个人资料模块](#3.2.8 个人资料模块)
[3.3 数据库设计](#3.3 数据库设计)
[3.3.1 用户表](#3.3.1 用户表)
[3.3.2 会话表](#3.3.2 会话表)
[3.3.3 事件表](#3.3.3 事件表)
[3.3.4 通话记录表](#3.3.4 通话记录表)
[3.3.5 系统配置表](#3.3.5 系统配置表)
[3.3.6 表间关系](#3.3.6 表间关系)
[第四章 核心算法与模型实现](#第四章 核心算法与模型实现)
[4.1 基于YOLOv8的驾驶行为检测模型](#4.1 基于YOLOv8的驾驶行为检测模型)
[4.1.1 模型训练与权重文件](#4.1.1 模型训练与权重文件)
[4.1.2 推理服务封装](#4.1.2 推理服务封装)
[4.1.3 模型热切换机制](#4.1.3 模型热切换机制)
[4.2 视频抽帧与事件抽取算法](#4.2 视频抽帧与事件抽取算法)
[4.2.1 视频抽帧策略](#4.2.1 视频抽帧策略)
[4.2.2 三秒分析段与多数投票规则](#4.2.2 三秒分析段与多数投票规则)
[4.2.3 事件截图保存](#4.2.3 事件截图保存)
[4.3 风险积分模型](#4.3 风险积分模型)
[4.3.1 行为权重设计](#4.3.1 行为权重设计)
[4.3.2 单事件风险得分计算](#4.3.2 单事件风险得分计算)
[4.3.3 疲劳风险等级划分](#4.3.3 疲劳风险等级划分)
[4.4 视觉与通话记录融合算法](#4.4 视觉与通话记录融合算法)
[4.4.1 融合算法设计思路](#4.4.1 融合算法设计思路)
[4.4.2 匹配规则与实现](#4.4.2 匹配规则与实现)
[4.4.3 实时检测中的融合](#4.4.3 实时检测中的融合)
[第五章 系统详细实现](#第五章 系统详细实现)
[5.1 后端API接口实现](#5.1 后端API接口实现)
[5.1.1 认证接口实现](#5.1.1 认证接口实现)
[5.1.2 实时检测接口实现](#5.1.2 实时检测接口实现)
[5.1.3 图片检测接口实现](#5.1.3 图片检测接口实现)
[5.1.4 视频分析接口实现](#5.1.4 视频分析接口实现)
[5.1.5 历史会话管理接口实现](#5.1.5 历史会话管理接口实现)
[5.1.6 系统配置接口实现](#5.1.6 系统配置接口实现)
[5.1.7 通话记录管理接口实现](#5.1.7 通话记录管理接口实现)
[5.2 前端页面实现](#5.2 前端页面实现)
[5.2.1 登录页面实现](#5.2.1 登录页面实现)
[5.2.2 仪表盘页面实现](#5.2.2 仪表盘页面实现)
[5.2.3 实时检测页面实现](#5.2.3 实时检测页面实现)
[5.2.4 图片检测页面实现](#5.2.4 图片检测页面实现)
[5.2.5 媒体检测页面实现](#5.2.5 媒体检测页面实现)
[5.2.6 历史会话页面实现](#5.2.6 历史会话页面实现)
[5.2.7 会话详情页面实现](#5.2.7 会话详情页面实现)
[5.2.8 系统配置页面实现](#5.2.8 系统配置页面实现)
[5.2.9 个人资料页面实现](#5.2.9 个人资料页面实现)
[5.3 关键业务流程实现](#5.3 关键业务流程实现)
[5.3.1 视频分析业务流程](#5.3.1 视频分析业务流程)
[5.3.2 实时检测业务流程](#5.3.2 实时检测业务流程)
[第六章 系统测试与结果分析](#第六章 系统测试与结果分析)
[6.1 测试环境与数据集](#6.1 测试环境与数据集)
[6.2 功能测试](#6.2 功能测试)
[6.2.1 用户认证测试](#6.2.1 用户认证测试)
[6.2.2 实时检测测试](#6.2.2 实时检测测试)
[6.2.3 图片检测测试](#6.2.3 图片检测测试)
[6.2.4 视频分析测试](#6.2.4 视频分析测试)
[6.2.5 历史会话管理测试](#6.2.5 历史会话管理测试)
[6.2.6 系统配置测试](#6.2.6 系统配置测试)
[6.3 性能测试](#6.3 性能测试)
[6.3.1 实时检测性能测试](#6.3.1 实时检测性能测试)
[6.3.2 视频分析性能测试](#6.3.2 视频分析性能测试)
[6.4 结果分析与讨论](#6.4 结果分析与讨论)
[第七章 总结与展望](#第七章 总结与展望)
[7.1 论文工作总结](#7.1 论文工作总结)
[7.2 系统创新点](#7.2 系统创新点)
[7.3 存在的不足](#7.3 存在的不足)
[7.4 未来展望](#7.4 未来展望)
第1章 绪论
1.1 研究背景与意义
汽车保有量不断增长之际,道路交通安全问题愈发突出,世界卫生组织的报告显示,全球每年大约有135万人丧生在道路交通事故当中,分心驾驶排在超速之后,是引发事故的第二大致因。所谓分心驾驶,即驾驶员在驾车时把注意力从驾驶任务上移开,其表现形式包含玩手机,摆弄车内操控系统,同乘客交流,吃东西等情形,此类举动大幅放慢了驾驶员的反应速度,加大了车辆失去控制的可能,极大地危及驾驶员,乘客以及其它道路参与者的生命财产安全。
传统的分心驾驶检测方法主要依赖于车辆行驶数据如方向盘转角、油门开度、车道偏离等或驾驶员生理信号如眼动、心电等。然而,这些方法存在局限性:车辆行驶数据受路况与驾驶习惯影响很大,生理信号检测设备既昂贵又侵入性强,很难普遍应用。近些年来,伴随计算机视觉和深度学习技术的极速发展,依靠视觉来认识驾驶员行为的方法因为具备非侵入性,成本较低而且所含信息量较多等优势,已经变成该领域的研究热点。
当下的视觉相关研究碰上不少难点,其一,驾驶舱内部情况复杂多变,受光照改变,物体遮挡以及背景噪音等影响,识别准确率难以保证,其二,部分极易混淆的动作,比如摸中控台和接打电话,在动作形态上十分接近,单纯依靠视觉信息很难加以区别,从而引发误判。其三,怎样把单一帧的检测成果转变成针对驾驶员综合驾驶能力的评判,并形成起一套全面且具合理性风险考量系统,这也是当前该领域研究遭遇的重大难题。
在此种背景之下,本文经由深度学习推出一套驾驶员分心驾驶行为识别系统,该系统把改良版的 YOLOv8 模型当作核心部分,希望借此解决前面提到的问题,其研究价值更多集中于改善识别的准确性上,采用领先的 YOLOv8 目标检测算法,针对驾驶员的十个典型动作实施精确的区分及定位,从而给后续的探究赋予可靠的资料依照。
革新融合策略,设计出一种结合视觉与通话记录的分析方法,利用外部数据源,很好地把触摸中控和接打电话这两种非常容易混淆的行为区分开来,明显改善了特定场景下行为识别的准确率。形成量化评价体系,给出一套依靠行为权重,连续出现次数以及时间窗的风险积分模型,把零散的行为事件转为成连续的风险评分,并且规定好阈值来做危险驾驶判断,从而给驾驶员给予直观,量化的安全反馈,给出完整系统方案,开发出前后端分离的驾驶安全分析系统,该系统整合了许多功能,包含即时监测,视频分析,历史回溯,参数设置等,这证实了前面提及的方法具备可行性与实用性,也为后续的研究和应用供应了完整的参照范例。
1.2 国内外研究现状
1.2.1 国外研究现状
从国际范围看,欧美国家较早启动了有关驾驶员分心行为检测的研究项目,特别是经由汽车厂商与研究机构的协作,相关技术已趋于成熟。
2012年,Zhao等人给出一种高效驾驶姿势特征获取方法,利用随机森林(RF)分类器针对驾驶姿势数据集执行了留外出法及交叉验证试验,试验结果显示,RF分类器在预定四类当中具有最高的分类准确率,格外是对于最难分类的"进食"类别,准确率超出88%1。
2016年,Hoang提出一种改良的Faster R-CNN算法即多尺度Faster R-CNN,用以判断驾驶员是否手持手机以及双手有无置于方向盘之上。MS - FRCNN把源自浅层卷积特征图的特征映射执行ROI池化,实验显示此方法在维持相近检测耗时的情况下优化了对手部及手机使用情况的识别精度,准确率达95%,无需参照面部标志点2。
2017年,Al - Akam等人利用这种方法来剖析人体运动,并从RGB - D视频当中辨别出人类行为,它们经由从全部视频帧里面获取局部时空特征以及形状保持特征来做动作识别,先是采用某种手段执行关键点检测;接着依靠直方图淘汰掉不合要求的特征值;再把特征值同Hu矩特征融合起来形成一个特征向量,这个系统对于缩放,旋转,平移以及光照改变具备较强的稳定性3,同一年,Arandjelovic等人给出了一种崭新的任务形式,即音频 - 视觉关联关系,目的在于考察经由观察并倾听很多未被标注过的视频能够获取到什么知识,他们训练了视觉和听觉网络去预估图片和声音是不是吻合,而且不需要额外的监管资料,所得出的结论表明,跨模态深度学习算法确实可以明显改善判断的正确比例4。
2018年Valeriano团队探究如何凭借深度学习和卷积神经网络自动识别驾驶员失慎行为,他们先计算连续帧间的光流数据,并融合垂直与水平的光流信息。之后,借助单张图片获取特征来综合评判驾驶员行为,这些方法的准确率均超过90%,其中最优秀的方法准确率达到约97%,同一年Xing等人提出一种端到端的驾驶相关任务识别系统,在模型训练前,原始图像需经由高斯混合模型分割以得到驾驶员区域,预训练的深度卷积神经网络模型可直接把处理过的RGB图像当作输入,并给出识别标签,而且采用迁移学习机制,结果显示,此系统检测准确率为79%,可充当低成本的驾驶员失慎识别方式。
2019年,Li等人提出空间 - 时间图结构,把它同遗传加权算法结合,用于依靠骨骼的驾驶员动作识别,这个方法先从视频里的关键帧当中做选择性采样来确定驾驶员的姿态,再把动态骨架当作输入送给图卷积网络,最后用遗传加权算法投票选出关联度最高的关节点,而且依照传感器输入和马上要发生的驾驶员行为之间的相关性来确定具体的动作7。
2022年,Zhenwu Fang等提出的模型是一种依靠迁移学习策略创建起来的视觉变换器模型,这个模型被用来检测驾驶员出现注意力分散情况时的行为特征,他们采用已经过训练的Transforme模型,并把它用在了驾驶员行为监测这样的任务之上,实验结果显示出,与当前已有的办法相比,这个新模型不但准确性更高,而且所需时间更短,并不需要地标点信息8。
2024年,Yingjie Gong 和 Xizhong Shen 提出了一种新算法,该算法依靠姿态特征及改良的 K 近邻算法来识别分心驾驶行为,此研究首先针对 Lightweight OpenPose 网络执行剪枝操作,缩减通道数量以预测并显示驾驶员上半身关键点坐标,而后依照人体工程学原理创建驾驶行为特征模型,利用几何计算得到五维特征值,鉴于样本间距离与样本数量存有联系,提出一种可调距离加权的 KNN 算法(ADW - KNN),用作分类及预测之用,实验结果表明,所提出的算法突出优化了识别准确率,给减轻因分心驾驶而产生的事故带来了有力支撑9。
1.2.2 国内研究现状
国外有关分心驾驶行为的研究开始得更早一些,不过国内学者渐渐深入这个领域以后,国内在这方面的研究就取得了不少进展。
2022 年,蒋把目标检测, 音频识别以及手机姿态多模态数据当作联合识别的对象,并凭借自行创建的数据集来探究分心行为,在蒋的研究当中,分别从图像识别, 音频识别, 图像与音频双模态识别, 图像, 音频和手机姿态多模态识别这四个方面展开实验设计,从实验结果来看,随着从单模态向多模态过渡,分心行为识别的准确率逐步得到改善,而且,还利用了联邦学习这种方法,既在某种程度上保障了信息源头,又能够填补由于用户数据短缺而产生的漏洞,多模态深度学习所带来的成果表现得更为明显10。
2023年,李就分心驾驶检测提出了依靠深度学习的办法,特别采用了双流混合细化校正图卷积网络,这个方法先凭借AlphaPose来做人体姿态估算,得到关节和骨骼的序列数据,结果表明,所提算法在SUST-DDDD和EBDDD数据集上的准确率做到了93.48%,同一年,朱创建起多视图分心驾驶行为识别模型,这依托多视图学习和多任务学习,而且经由3D物体识别领域的多视图模型MVCNN创建起了多视图分心驾驶行为识别模型MMobNet,实验显示,多视图模型比单视图模型的准确度高10%,采用三个视角既缩减了数据需求量又达成了较高的识别准确率12。
2024年,依托座椅压力与视觉图像的多模态驾驶员分心行为研究当中,由于座椅压力不会受光环境影响,所以借助此优势可优化驾驶分心行为识别的整体稳定性,并考察座椅压力监测驾驶行为是否可行13。
分心驾驶行为检测研究正在朝着多模态数据融合,时效性改进和隐私保护改善的方向飞速发展,从全球范围来看,多模态技术是加强分心驾驶行为检测准确性和鲁棒性的关键方法,经由整合视觉,音频,通信数据以及驾驶员姿态信息等,可以做到对复杂驾驶场景的全面监测,特别是在夜间或者强光这种极端情况下表现更好,而且,伴随深度学习技术持续提升,轻量化模型的研发又进一步加强了系统在嵌入式设备里的应用能力,也维持了即时检测性能。
隐私保护技术被采用,联邦学习,差分隐私等就是例子,它们可以解决数据共享和隐私保护之间的矛盾,给跨机构的数据协作赋予了安全的技术支撑,这种情况出现在国内外,特别在智能驾驶和自动驾驶技术发展的时候,分心驾驶行为检测技术会慢慢深入到车辆的自动驾驶系统和高级驾驶辅助系统里面,从而合成一种更智能的驾驶员监测系统,以后,由于交通数据和驾驶场景日益多种各类,所以按照区域特点制定专属方案将会成为研究的重点,进而为改善交通安全增添更多可能。
1.2.3 基于传统机器学习的行为识别方法
深度学习尚未普及之时,研究人员大多凭借传统机器学习方法来执行驾驶员行为识别,此方法往往牵涉特征获取及分类器设计这两个阶段。
研究者大多从图像或者视频当中获取人工设计的特征,比如 Hu 等人用梯度方向直方图特征去表现驾驶员的手部形态与姿态,然后配合支持向量机做分类,用来判断驾驶员是不是在打电话。还有 Zhao 等人给出一种方法,就是采用局部二值模式特征来获取纹理信息,并把主成分分析加进去实施降维,之后交给支持向量机分类器来做识别,这种方法也适用于注意力分散行为的判定,光流法同样可以捕捉到驾驶员头部以及手部的运动情况,从而决定是否存在注意力分散的现象,既然是讲到支持向量机,其实 K 近邻,决策树,随机森林,隐马尔可夫模型等等也都被普遍采纳,就像 Dong 等人就经由隐马尔可夫模型来创建驾驶员的视线,头部姿态以及手部动作序列,以此做到对分心状况的持续观测。
传统机器学习方法虽有取得一些成果,但它在很大程度上依赖人工特征的质量,处于光照改变,部分遮挡之类复杂场景的时候,这些特征的稳定性欠佳,很难得到预期的识别效果。
1.2.4 基于深度学习的驾驶员行为识别
近些年来,深度学习尤其是卷积神经网络在图像分类,目标检测,动作识别等领域收获了很大成果,还给驾驶员行为识别带来了新跨越。
早期研究大多利用卷积神经网络做特征提取器,执行端到端的图像分类任务,比如Kim等人构建起包含诸多卷积层与全连接层的卷积神经网络模型,并在自行创建的数据集里针对驾驶员的头部姿态及手部动作执行分类操作,得到优于传统方法的效果,伴随网络结构的发展,像VGGNet,ResNet,Inception这样的较深网络被应用进来,这又进一步优化了分类的准确性。
要达成行为分类与定位的目标,目标检测算法得到全面应用,YOLO系列算法能在速度和精度之间兼顾较好,所以是驾驶员行为识别的主要选项,YOLOv3,YOLOv4以及YOLOv5都先后被用在驾驶行为检测任务当中,研究人员经由对网络结构执行轻量化改良,并采用注意机制等方法,既保障了即时性又加强了检测精度。
针对视频序列中行为的识别,有人提出过3D 卷积神经网络,时序卷积网络等等,这些做法目的在于获取行为在时间方面的动态信息,Tran等人所提出的 C3D 网络经由 3D 卷积一起获取空间和时间上的特征,其在动作识别任务里表现良好,但是这种类型的方法计算量繁重,很难在资源不多的植入式平台即时执行,所以,很多研究采取调和措施,先是用 2D 卷积神经网络获取单帧的空间特性,然后凭借循环神经网络或者长期短期记忆网络来对时序信息实施建模,从而在确保即时性的前提之下也顾及到时序信息。
1.2.5 驾驶行为风险评估研究
行为识别之外,怎样评价驾驶员的总体安全状况同样属于研究热点,早些年的风险评定大多依靠行为出现的频次或者历时长短,比如计算一定时段内分心行为累计发生的次数,一旦超出预定界限就发出警示信号,此方法较为直接明了,不过却没考虑到各类行为给驾驶安全带来的影响存在差别。
近年来,研究者着手形成更为精准的风险考量模型,部分研究依照行为的危险等级分配不同权重,接打电话的风险权重高于调节空调,把这些权重相加便得出综合风险评分,有的研究采用时间衰减因子,该因子显示最近产生的注意力分散事件对当下风险影响较大,隐马尔可夫模型,贝叶斯网络等也被用来刻画行为间的转换概率及风险汇聚情形,当下的研究在风险模型的阐释能力,参数可调节性以及与外部数据源融合能力上尚需进一步提升,因而本文给出了一个整合行为权重,持续出现次数以及外部通话记录的,具有很强调节性的风险积分模型。
1.3 本文主要研究内容
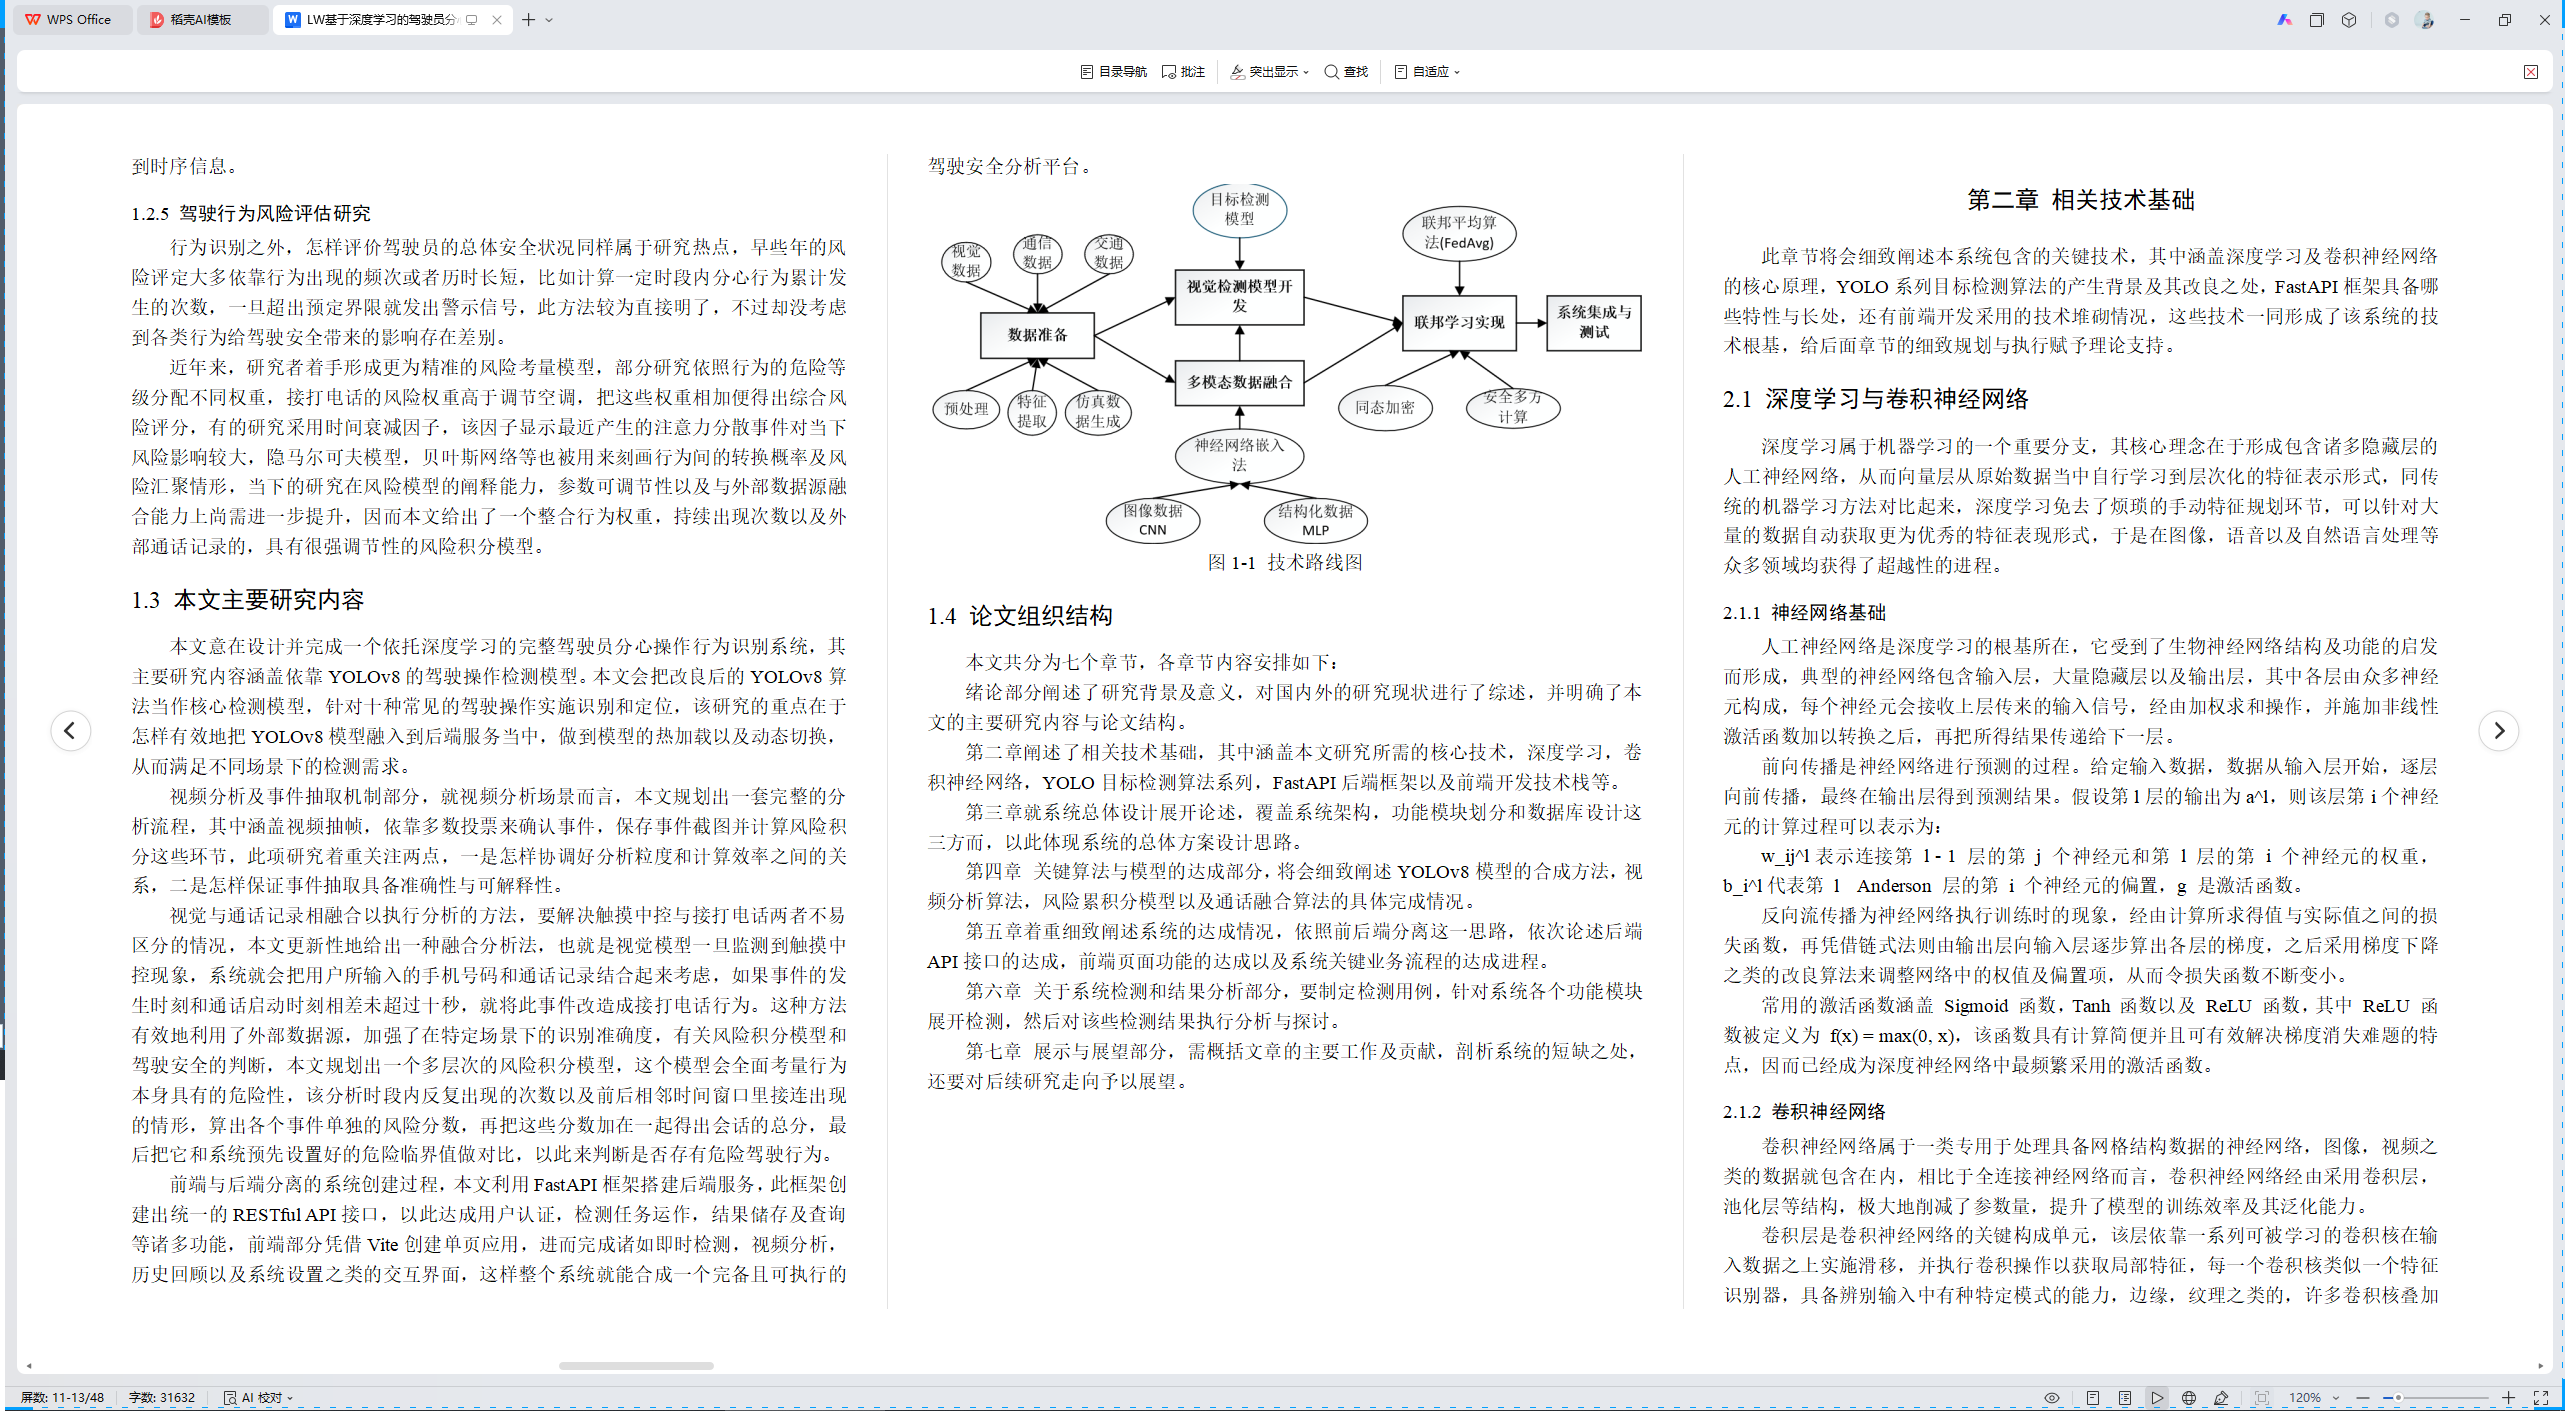
本文意在设计并完成一个依托深度学习的完整驾驶员分心操作行为识别系统,其主要研究内容涵盖依靠YOLOv8的驾驶操作检测模型。本文会把改良后的YOLOv8算法当作核心检测模型,针对十种常见的驾驶操作实施识别和定位,该研究的重点在于怎样有效地把YOLOv8模型融入到后端服务当中,做到模型的热加载以及动态切换,从而满足不同场景下的检测需求。
视频分析及事件抽取机制部分,就视频分析场景而言,本文规划出一套完整的分析流程,其中涵盖视频抽帧,依靠多数投票来确认事件,保存事件截图并计算风险积分这些环节,此项研究着重关注两点,一是怎样协调好分析粒度和计算效率之间的关系,二是怎样保证事件抽取具备准确性与可解释性。
视觉与通话记录相融合以执行分析的方法,要解决触摸中控与接打电话两者不易区分的情况,本文更新性地给出一种融合分析法,也就是视觉模型一旦监测到触摸中控现象,系统就会把用户所输入的手机号码和通话记录结合起来考虑,如果事件的发生时刻和通话启动时刻相差未超过十秒,就将此事件改造成接打电话行为。这种方法有效地利用了外部数据源,加强了在特定场景下的识别准确度,有关风险积分模型和驾驶安全的判断,本文规划出一个多层次的风险积分模型,这个模型会全面考量行为本身具有的危险性,该分析时段内反复出现的次数以及前后相邻时间窗口里接连出现的情形,算出各个事件单独的风险分数,再把这些分数加在一起得出会话的总分,最后把它和系统预先设置好的危险临界值做对比,以此来判断是否存有危险驾驶行为。
前端与后端分离的系统创建过程,本文利用FastAPI框架搭建后端服务,此框架创建出统一的RESTful API接口,以此达成用户认证,检测任务运作,结果储存及查询等诸多功能,前端部分凭借Vite创建单页应用,进而完成诸如即时检测,视频分析,历史回顾以及系统设置之类的交互界面,这样整个系统就能合成一个完备且可执行的驾驶安全分析平台。
图1-1 技术路线图
1.4 论文组织结构
本文共分为七个章节,各章节内容安排如下:
绪论部分阐述了研究背景及意义,对国内外的研究现状进行了综述,并明确了本文的主要研究内容与论文结构。
第二章阐述了相关技术基础,其中涵盖本文研究所需的核心技术,深度学习,卷积神经网络,YOLO目标检测算法系列,FastAPI后端框架以及前端开发技术栈等。
第三章就系统总体设计展开论述,覆盖系统架构,功能模块划分和数据库设计这三方而,以此体现系统的总体方案设计思路。
第四章 关键算法与模型的达成部分,将会细致阐述YOLOv8模型的合成方法,视频分析算法,风险累积分模型以及通话融合算法的具体完成情况。
第五章着重细致阐述系统的达成情况,依照前后端分离这一思路,依次论述后端API接口的达成,前端页面功能的达成以及系统关键业务流程的达成进程。
第六章 关于系统检测和结果分析部分,要制定检测用例,针对系统各个功能模块展开检测,然后对该些检测结果执行分析与探讨。
第七章 展示与展望部分,需概括文章的主要工作及贡献,剖析系统的短缺之处,还要对后续研究走向予以展望。
第二章 相关技术基础
此章节将会细致阐述本系统包含的关键技术,其中涵盖深度学习及卷积神经网络的核心原理,YOLO系列目标检测算法的产生背景及其改良之处,FastAPI框架具备哪些特性与长处,还有前端开发采用的技术堆砌情况,这些技术一同形成了该系统的技术根基,给后面章节的细致规划与执行赋予理论支持。
2.1 深度学习与卷积神经网络
深度学习属于机器学习的一个重要分支,其核心理念在于形成包含诸多隐藏层的人工神经网络,从而向量层从原始数据当中自行学习到层次化的特征表示形式,同传统的机器学习方法对比起来,深度学习免去了烦琐的手动特征规划环节,可以针对大量的数据自动获取更为优秀的特征表现形式,于是在图像,语音以及自然语言处理等众多领域均获得了超越性的进程。
2.1.1 神经网络基础
人工神经网络是深度学习的根基所在,它受到了生物神经网络结构及功能的启发而形成,典型的神经网络包含输入层,大量隐藏层以及输出层,其中各层由众多神经元构成,每个神经元会接收上层传来的输入信号,经由加权求和操作,并施加非线性激活函数加以转换之后,再把所得结果传递给下一层。
前向传播是神经网络进行预测的过程。给定输入数据,数据从输入层开始,逐层向前传播,最终在输出层得到预测结果。假设第l层的输出为a^l,则该层第i个神经元的计算过程可以表示为:
w_ij^l表示连接第 l - 1 层的第 j 个神经元和第 l 层的第 i 个神经元的权重,b_i^l代表第 l Anderson 层的第 i 个神经元的偏置,g 是激活函数。
反向流传播为神经网络执行训练时的现象,经由计算所求得值与实际值之间的损失函数,再凭借链式法则由输出层向输入层逐步算出各层的梯度,之后采用梯度下降之类的改良算法来调整网络中的权值及偏置项,从而令损失函数不断变小。
常用的激活函数涵盖 Sigmoid 函数,Tanh 函数以及 ReLU 函数,其中 ReLU 函数被定义为 f(x) = max(0, x),该函数具有计算简便并且可有效解决梯度消失难题的特点,因而已经成为深度神经网络中最频繁采用的激活函数。
2.1.2 卷积神经网络
卷积神经网络属于一类专用于处理具备网格结构数据的神经网络,图像,视频之类的数据就包含在内,相比于全连接神经网络而言,卷积神经网络经由采用卷积层,池化层等结构,极大地削减了参数量,提升了模型的训练效率及其泛化能力。
卷积层是卷积神经网络的关键构成单元,该层依靠一系列可被学习的卷积核在输入数据之上实施滑移,并执行卷积操作以获取局部特征,每一个卷积核类似一个特征识别器,具备辨别输入中有种特定模式的能力,边缘,纹理之类的,许多卷积核叠加起来以后,网络就能由低层级特征慢慢合成为高级别的语义特征。
池化层常位于卷积层之后,其作用在于对特征图执行下采样,压缩特征图的空间大小,增强特征的平移稳定性,常见的池化类型有最大池化和均值池化。最大池化选取池化区域中的最大值来保持关键特征,均值池化则选择池化区域内值的平均数以保留总体特征分布情况,卷积神经网络具有代表性的结构包含 LeNet, AlexNet, VGGNet 以及 ResNet 等,特别是 ResNet 经由采用残差连接的方式,化解了深层网络训练时存在的梯度消失难题,从而做到网络层多达上百层,大幅优化了模型的效果水平,残差连接的核心理念就是让网络去学习输入量与输出量之间的差别,这里 Fx 表示经由卷积层及其后续变换所得的结果,x 则代表原始输入数据,凭借这样的跳接途径,梯度才能够立即由深层传递至浅层,较为有效地改善了梯度消失这种状况。
2.2 YOLO目标检测算法
目标检测属于计算机视觉领域中的关键任务之列,其主要目的是在图片里找出感兴趣的目标,并判断该目标属于哪一类,YOLO系列算法具备端到端训练的一阶段检测结构,有着较好的即时响应能力,所以是目标检测方面的具有标志性的成果。
2.2.1 YOLOv1到YOLOv8的发展
YOLOv1是YOLO系列的第一个版本,2016年由Joseph Redmon等人所提出,它不同于当时主流依靠候选区域的两阶段检测算法(譬如R - CNN系列),把目标检测转为成回归问题,直接针对图像像素来预测边界框坐标以及类别概率。YOLOv1会将输入图像划分成S × S的网格,每个网格都要负责预测落入自身范围之中的目标,包含B个边界框和C个类别概率,这样一种端到端的设计令YOLOv1的检测速度高达45帧/秒,远胜同年代的其它算法,但存在小目标检测及定位准确度上的短缺。
YOLOv2针对YOLOv1执行诸多改进,它利用批归一化技术助力训练更快收敛,并具备正则化效果,利用高分辨率分类器实施微调,加强模型对细节的感知能力,运用锚点框机制,参照Faster R - CNN的理念,经由聚类方法自行决定锚点框的大小与比例,从而使模型更易于获取目标的位置信息,而且,YOLOv2给出了联合训练方案,同等地利用检测数据集和分类数据集开展训练,优化了模型对于更多类别的识别能力。
YOLOv3属于YOLO系列中的里程碑之作,它以更深的Darknet - 53作为骨干网络,并加入了残差结构,从而做到网络更深并且表达能力更强,在检测头方面,YOLOv3采用特征金字塔结构,分别在三个不同尺度的特征图上执行预测,有效地解决了多尺度目标检测的问题,YOLOv3的分类器不再用Softmax,而是变成了单独的二分类器,这样模型就能预判多种类别,就像同一个人既可能是行人也可能是男性。
YOLOv4和YOLOv5在网络结构与训练策略上做了进一步的改良,YOLOv4提出了CSPDarknet53骨干网络,该网络融入了跨阶段局部连接结构,既保留了精度又缩减了计算量,而且采用了Mish激活函数,PANet路径聚合网络以及CutMix数据增强等技术,全方位优化了检测性能。YOLOv5在工程化方面执行了诸多改良措施,其代码变得越发精简实用,训练与部署也更为方便快捷,从而成了工业界广泛采用的版本之一。
YOLOv6,YOLOv7以及YOLOv8均为YOLO系列近期所出的新版本,其中,YOLOv8由Ultralytics公司在2023年推出,该版本针对YOLOv5执行了全方位升级,其采用效率更高的无锚点检测头,全新的C2f模块以及更为灵活的数据加强策略,YOLOv8在COCO数据集中的检测精准度与速率均已跻身前列,并且包含目标检测,实例分割,姿态估计等诸多任务类型,而且部署极其简便,这使得它成了本文重点推荐的检测模型。
2.2.2 YOLOv8模型架构
YOLOv8的模型架构由三个主要部分组成:骨干网络、颈部网络和检测头。
骨干网络用于从输入图像当中获取特征,YOLOv8把改良过的CSPDarknet53当作骨干网络,其关键在于C2f模块,这个模块是依照CSPNet以及YOLOv5的C3模块而加以改良形成的,经由把特征图划分到许多分支,并执行融合操作,从而提升了特征的表达能力,而且依旧维持了比较高的计算效率。
颈部网络负责把不同尺度的特征整合起来,从而提升模型针对多尺度目标的检测能力,YOLOv8采用的是PANet结构,也就是特征金字塔网络和路径聚合网络相融合的形式。特征金字塔网络经由自顶向下的路径把高层的语义信息传送到低层,进而优化小目标的检测能力;而路径聚合网络则凭借自底向上的路径把底层的位置信息传递到高层,以此来改善大目标的定位准确度,这两条路径相互结合以后,使得特征融合变得越发全面细致。
检测头属于YOLOv8的关键改进之处,YOLOv5的检测头依靠锚点框,而YOLOv8则采用无锚点检测头,直接预测目标中心点偏移量,边界框的宽和高。这种设计精简了模型结构,削减了锚点框相关的超参数设置,模型训练更为稳定,对于形状不规则的目标检测效果也更好,检测头产生出三尺度的特征图,分别对应小,中,大三种尺寸的目标,每个特征图上的每一个位置都会预测一个边界框以及对应的类别概率。
2.2.3 驾驶员行为识别中的YOLOv8应用
在驾驶员行为识别任务当中,YOLOv8有着独有的优势,其一,驾驶员行为识别对即时性有较高要求,特别在即时检测场景里,系统必要迅速回应驾驶员状态的改变,而YOLOv8采用轻量化设计,并具备高效的推断速度,这可满足前述需求。其二,驾驶室场景中诸如手部,头部之类的目标往往较为微小,而且也许会遭受遮挡,但是YOLOv8具备多尺度预测机制以及出色的功能获取能力,可以有效地应对这些难点。
YOLOv8模型在本文中于自行创建的驾驶员行为数据集上展开微调训练,该数据集覆盖十类驾驶行为,正常驾驶,接打电话,触摸中控,操作手机,饮水,转头及与后排对话,与副驾交谈,施粉,操作车内设备以及疲劳驾驶等,借助针对这些数据执行迁移学习,模型可精准识别驾驶员各类注意力分散的行为,进而给后续的风险评定赋予可靠的输入源。
2.3 FastAPI后端框架
FastAPI属于现代且高效的Web框架,可用来创建Python API,该框架依靠Python的类型提示,具备自动产生API文档,执行数据校验及序列化等功能,很适宜用来创建RESTful服务。
2.3.1 FastAPI的核心特性
FastAPI具备高性能特点,它依靠Starlette框架和Pydantic库创建而成,其性能接近Node.js和Go,属于Python框架当中性能表现较为出色的行列,这要归功于它所具有的异步功能以及高效的数据处理体系。FastAPI具备自动生成文档的能力,可以从代码里的类型标注和文档注释出发,自动生成交互式的API文档,开发人员经由访问/docs或者/redoc相关路径之后,就能看到各类API的具体详情,而且还可以直接在文档界面做接口调测工作,从而极大地简化开发调试流程。
FastAPI凭借Pydantic库执行数据模型的定义及验证工作,开发者能够定义请求体和响应体的数据模型,FastAPI会自动针对请求数据的类型和结构展开验证,还将响应数据序列化为JSON格式,以此来保障数据具有一致性与安全性,FastAPI具备一个简单又有力的依赖注入系统,这个系统利于去管理诸如数据库关联,用户认证之类的共享资源,经由对依赖项加以定义,便可在不同的路由函数里重复利用相同的逻辑,从而提升代码的可守护性。
FastAPI原生便支持Python的异步编程模型,这使得它能够利用async和await关键字来定义异步路由函数,从而高效应对诸如数据库查询,文件操作以及网络请求之类的I/O密集型任务。
2.3.2 在系统中的角色与应用
在本系统中,FastAPI扮演着核心后端框架的角色,承担着以下几方面的职责:
系统给予统一的API接口,其包含所有功能,如用户注册登录,即时检测,视频分析,历史会话守护,系统设置等,这些功能皆经由FastAPI所定义的路由函数向外展示,供前端加以调用。
执行数据验证与序列化操作,用Pydantic来界定请求体和响应体的数据结构,保证前后端通信时数据格式既准确又完备,比如,对请求中的图像数据,视频分析任务的参数等等都会实施严格的验证。
管理静态文件时,利用挂载StaticFiles中间件把检测结果图片之类的静态文件变成可访问的URL,这样前端就能直接显示它们。对于跨域请求的处理,则经由设置CORSMiddleware来允许前端开发服务访问后端API,从而解决前后端分离开发过程中存在的跨域问题,至于生命周期管理方面,采用FastAPI的lifespan功能,在应用启动之际初始化数据库连接,并创建诸如结果存储目录,上传目录之类必要的目录,在应用关闭之时清除资源,以保证系统能够正常运行。
2.4 前端开发技术栈
本系统前端以 Vite 创建的原生 JavaScript 单页应用架构形成,它并不依赖重量级框架,从而保留了系统的轻量化与灵活性。
2.4.1 Vite构建工具
Vite 是新一代前端构建工具,由 Vue.js 的作者尤雨溪所开发,不同于 Webpack 这类传统前端构建工具,Vite 利用浏览器固有的 ES Module 特性,在开发环境里不用打包,直接开启开发服务器,做到了冷启动时延缩短到秒级,热模块替换变得即时,极大地优化了开发体验。
Vite具备一些核心特性,其开发环境凭借原生 ES Module来供应服务,无需执行打包步骤;而在生产环境当中,则利用 Rollup 执行打包操作,并生成改良过的静态资源。它具有丰富的插件生态,能够轻易整合各类前端工具及库,本身自带对 TypeScript, CSS 预处理程序,静态资源等方面的支撑,在此系统里,Vite承担着前端项目依赖的维持工作,还会启动开发服务器,创建生产用的静态文件,经由设置代理,可以把/api 和 /results 等路径的请求转送至后端服务,从而解决开发环境中的跨域困扰。
2.4.2 原生ES Modules与模块化设计
本系统前端利用原生ES Modules做模块化开发,并未采用Vue,React等大型框架,保留了代码的精练度与可控性,ES Modules属于JavaScript官方的模块化方案,依靠import和export关键字达成模块的导入及导出功能,每份JavaScript文件可当作单独的模块,模块内部所定义的变量和函数默认处于私有状态,唯有经过export明确导出才允许其他模块加以访问。
系统前端当中,页面被整合成独立模块,每个页面对应一个 JavaScript 文件,存放在 src/pages 目录下。布局组件,图表面板,上传面板这些公共组件存在于 src/components 目录下,src/api 目录负责 API 调用的封装,src/utils 目录存放工具函数,这样的模块化组织形式可使代码结构清晰,职责分明,利于维持与拓展。
2.4.3 原生CSS视觉系统
系统的视觉样式采用原生CSS编写,通过CSS变量实现主题的统一管理。CSS变量可以在全局范围内定义颜色、字体、间距等设计令牌,然后在各个组件样式中引用,保证了视觉风格的一致性。系统采用了简洁现代的视觉风格,主要元素包括:卡片布局承载着各种功能模块,其具备圆角,阴影以及边框特性,按钮组件涵盖主要按钮,次要按钮和危险按钮等多种样式,表单控件包含输入框,下拉选择,复选框等内容,图表组件依靠Chart.js库来创建行为统计图表。
系统具备响应式布局功能,可适配不同屏幕大小的设备,在桌面端时,侧边栏导航会固定显示,而在移动端则能被折叠起来,主体内容区域依循余下的宽度来自动调整,以此保证系统在各种设备上均具有可用性。
第三章 系统总体设计
本章站在宏观层面论述系统的总体设计思路,覆盖系统架构设计,功能模块划分以及数据库设计等方面,该系统采取前后端分离的架构形式,各个模块职责清晰且彼此间耦合度较低,这样便利于开展开发,检测以及后续的维护工作。
3.1 系统架构设计
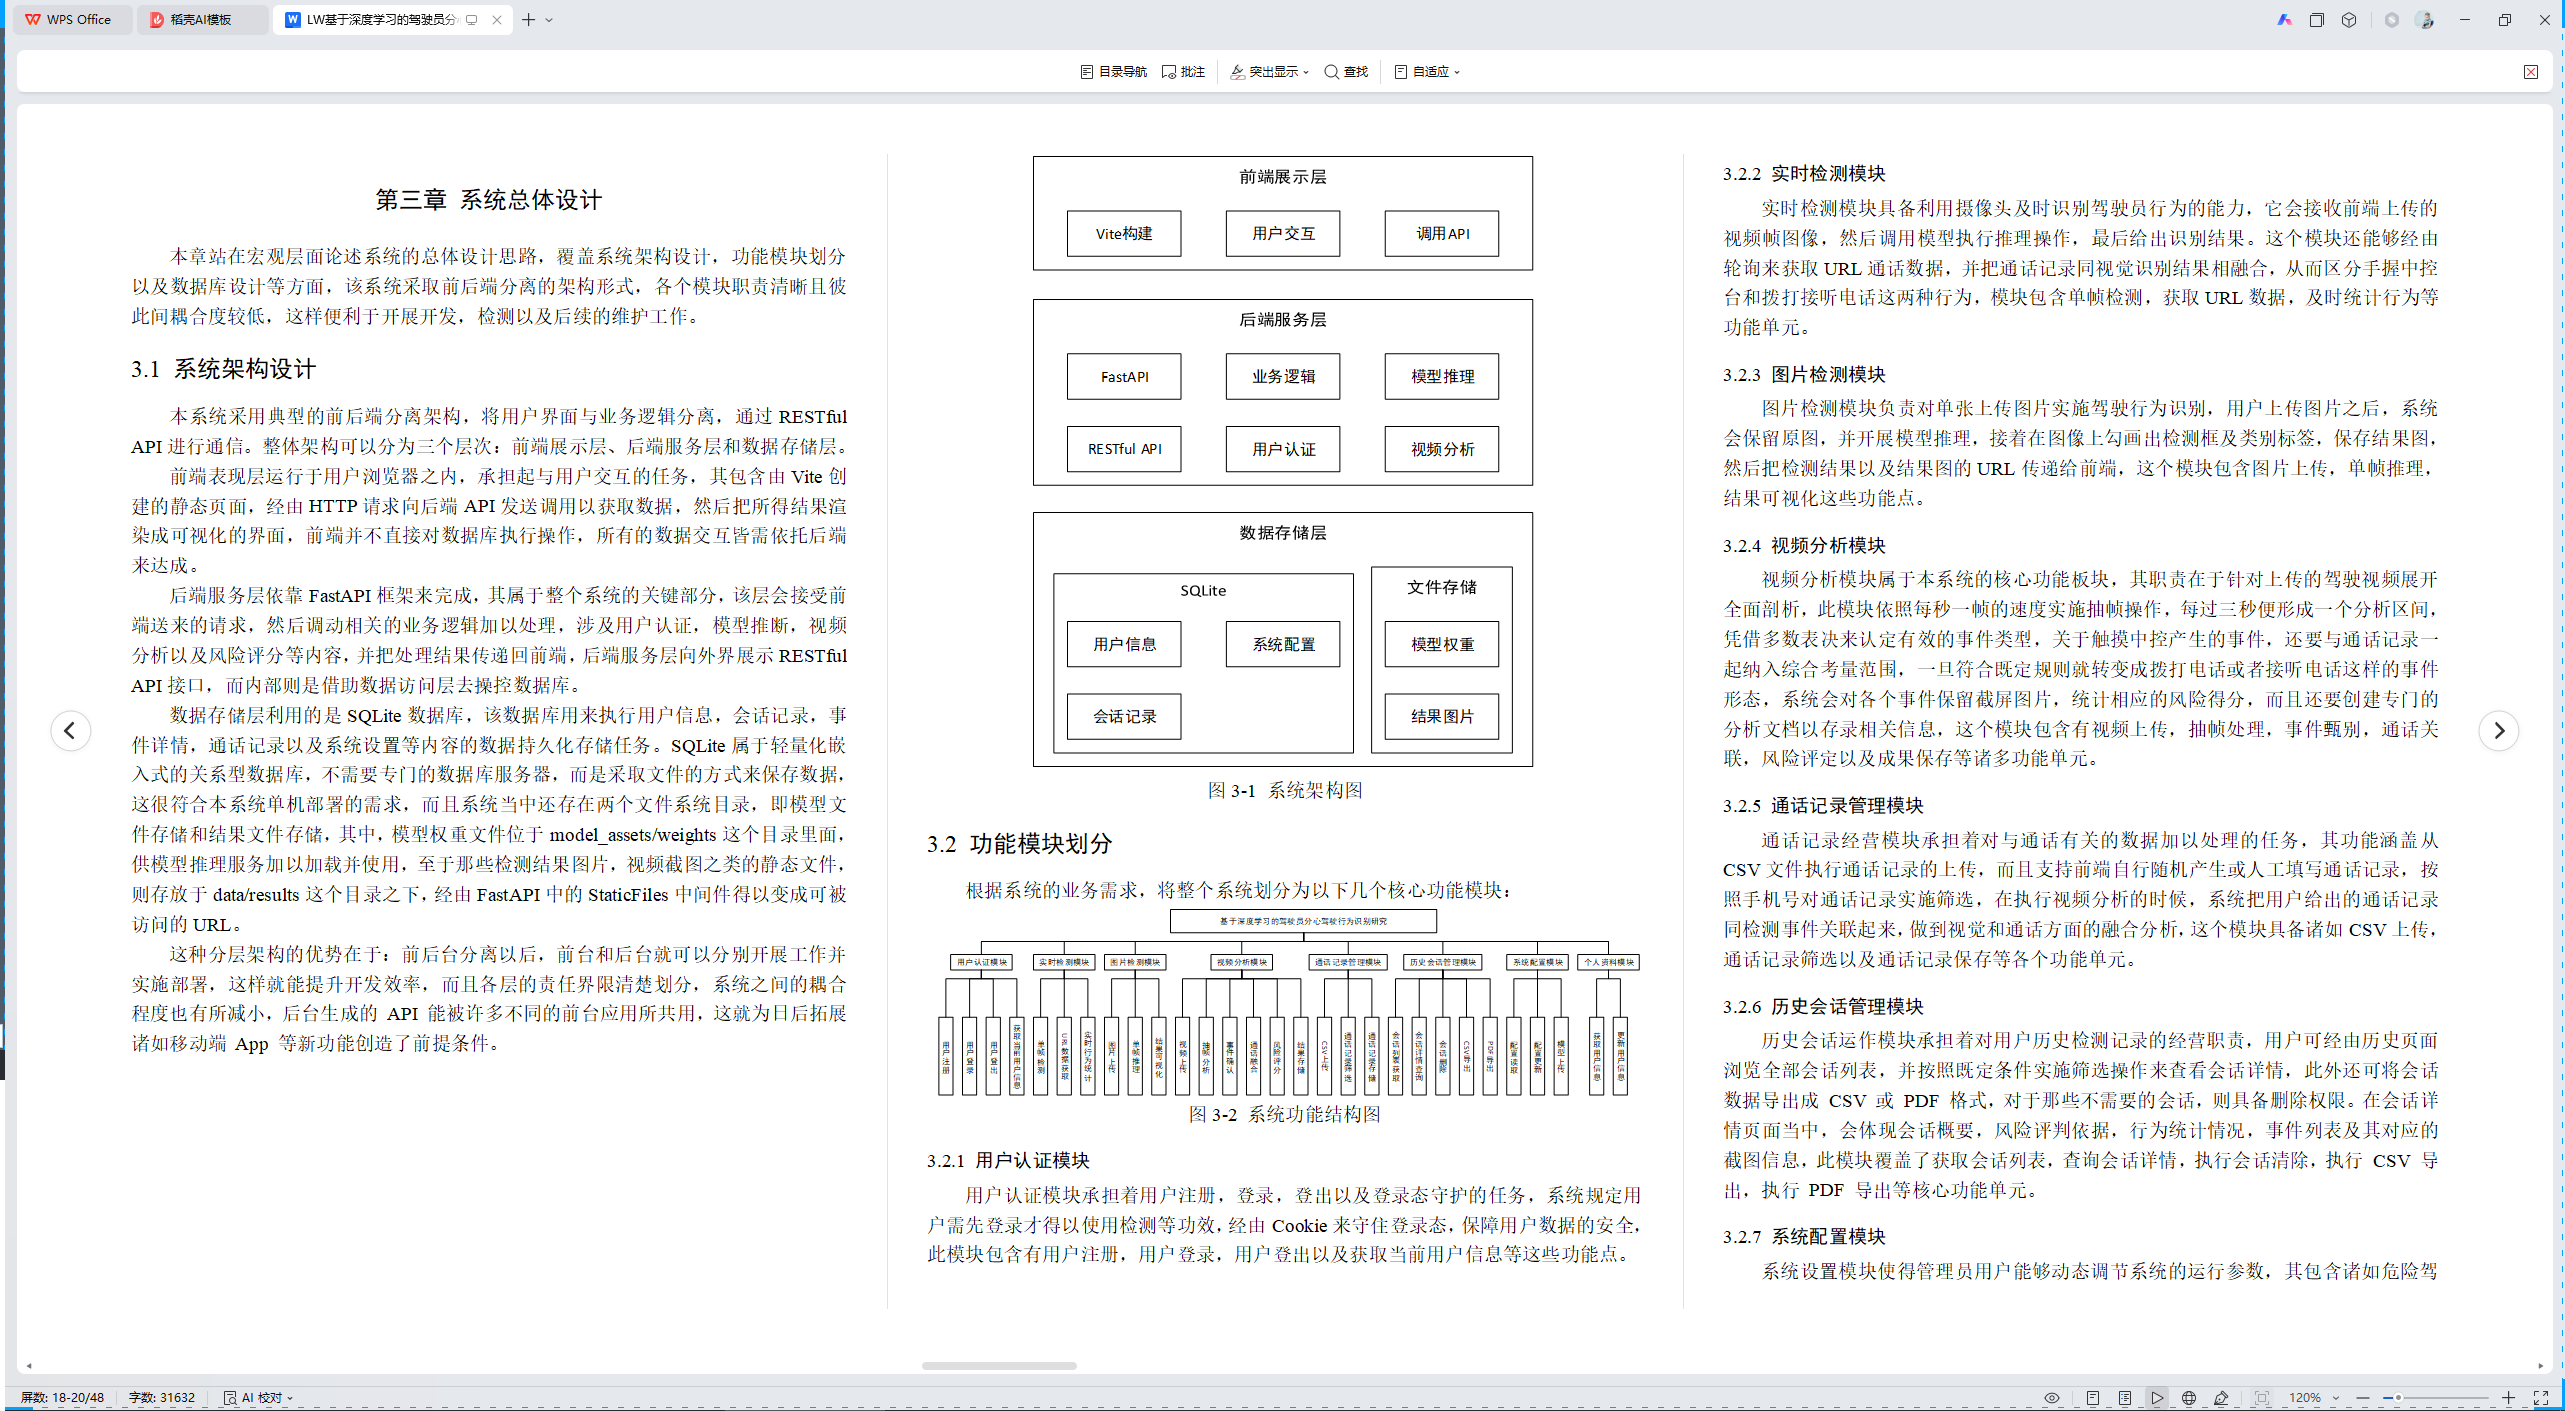
本系统采用典型的前后端分离架构,将用户界面与业务逻辑分离,通过RESTful API进行通信。整体架构可以分为三个层次:前端展示层、后端服务层和数据存储层。
前端表现层运行于用户浏览器之内,承担起与用户交互的任务,其包含由Vite创建的静态页面,经由HTTP请求向后端API发送调用以获取数据,然后把所得结果渲染成可视化的界面,前端并不直接对数据库执行操作,所有的数据交互皆需依托后端来达成。
后端服务层依靠FastAPI框架来完成,其属于整个系统的关键部分,该层会接受前端送来的请求,然后调动相关的业务逻辑加以处理,涉及用户认证,模型推断,视频分析以及风险评分等内容,并把处理结果传递回前端,后端服务层向外界展示RESTful API接口,而内部则是借助数据访问层去操控数据库。
数据存储层利用的是SQLite数据库,该数据库用来执行用户信息,会话记录,事件详情,通话记录以及系统设置等内容的数据持久化存储任务。SQLite属于轻量化嵌入式的关系型数据库,不需要专门的数据库服务器,而是采取文件的方式来保存数据,这很符合本系统单机部署的需求,而且系统当中还存在两个文件系统目录,即模型文件存储和结果文件存储,其中,模型权重文件位于model_assets/weights这个目录里面,供模型推理服务加以加载并使用,至于那些检测结果图片,视频截图之类的静态文件,则存放于data/results这个目录之下,经由FastAPI中的StaticFiles中间件得以变成可被访问的URL。
这种分层架构的优势在于:前后台分离以后,前台和后台就可以分别开展工作并实施部署,这样就能提升开发效率,而且各层的责任界限清楚划分,系统之间的耦合程度也有所减小,后台生成的 API 能被许多不同的前台应用所共用,这就为日后拓展诸如移动端 App 等新功能创造了前提条件。
图3-1 系统架构图
3.2 功能模块划分
根据系统的业务需求,将整个系统划分为以下几个核心功能模块:
图3-2 系统功能结构图
3.2.1 用户认证模块
用户认证模块承担着用户注册,登录,登出以及登录态守护的任务,系统规定用户需先登录才得以使用检测等功效,经由Cookie来守住登录态,保障用户数据的安全,此模块包含有用户注册,用户登录,用户登出以及获取当前用户信息等这些功能点。
3.2.2 实时检测模块
实时检测模块具备利用摄像头及时识别驾驶员行为的能力,它会接收前端上传的视频帧图像,然后调用模型执行推理操作,最后给出识别结果。这个模块还能够经由轮询来获取URL通话数据,并把通话记录同视觉识别结果相融合,从而区分手握中控台和拨打接听电话这两种行为,模块包含单帧检测,获取URL数据,及时统计行为等功能单元。
3.2.3 图片检测模块
图片检测模块负责对单张上传图片实施驾驶行为识别,用户上传图片之后,系统会保留原图,并开展模型推理,接着在图像上勾画出检测框及类别标签,保存结果图,然后把检测结果以及结果图的URL传递给前端,这个模块包含图片上传,单帧推理,结果可视化这些功能点。
3.2.4 视频分析模块
视频分析模块属于本系统的核心功能板块,其职责在于针对上传的驾驶视频展开全面剖析,此模块依照每秒一帧的速度实施抽帧操作,每过三秒便形成一个分析区间,凭借多数表决来认定有效的事件类型,关于触摸中控产生的事件,还要与通话记录一起纳入综合考量范围,一旦符合既定规则就转变成拨打电话或者接听电话这样的事件形态,系统会对各个事件保留截屏图片,统计相应的风险得分,而且还要创建专门的分析文档以存录相关信息,这个模块包含有视频上传,抽帧处理,事件甄别,通话关联,风险评定以及成果保存等诸多功能单元。
3.2.5 通话记录管理模块
通话记录经营模块承担着对与通话有关的数据加以处理的任务,其功能涵盖从CSV文件执行通话记录的上传,而且支持前端自行随机产生或人工填写通话记录,按照手机号对通话记录实施筛选,在执行视频分析的时候,系统把用户给出的通话记录同检测事件关联起来,做到视觉和通话方面的融合分析,这个模块具备诸如CSV上传,通话记录筛选以及通话记录保存等各个功能单元。
3.2.6 历史会话管理模块
历史会话运作模块承担着对用户历史检测记录的经营职责,用户可经由历史页面浏览全部会话列表,并按照既定条件实施筛选操作来查看会话详情,此外还可将会话数据导出成 CSV 或 PDF 格式,对于那些不需要的会话,则具备删除权限。在会话详情页面当中,会体现会话概要,风险评判依据,行为统计情况,事件列表及其对应的截图信息,此模块覆盖了获取会话列表,查询会话详情,执行会话清除,执行 CSV 导出,执行 PDF 导出等核心功能单元。
3.2.7 系统配置模块
系统设置模块使得管理员用户能够动态调节系统的运行参数,其包含诸如危险驾驶的临界值,不同行为的基本权重,通话适配的时间范围以及当下被采用的模型权重等诸多可调节的参数,用户可经由设置界面上传新的模型权重文件,系统将会自动更换当前正在使用的预测模型,此模块具备设置读取,设置更新以及模型上传等功能单元。
3.2.8 个人资料模块
个人资料模块可让用户查看并修改自身信息,涉及用户名,邮箱等内容,此模块具备获取当前用户信息以及更新用户信息的能力。
3.3 数据库设计
本系统把SQLite当作数据库,按照功能需求规划了如下主要数据表。
3.3.1 用户表
用户表负责储存系统用户的各项基本资料,其中涉及用户ID,用户名,密码哈希值,电子邮箱,创建时间以及更新时间这些字段,这里,用户ID充当主键,而用户名和电子邮箱则被设定成唯一限制,以此来保障用户数据具有唯一性。
用户表的主要字段包括:id为整型且主键自增,username属于字符串类型,此字段唯一且不可为空,用以执行用户登录操作,password_hash同样是字符串类型,其不可为空,用以保存经过加密处理的密码,email亦为字符串形式,该字段具有唯一性,可作为联系用户之用,created_at与updated_at均为时间戳格式,其中created_at用以记录用户注册的时间,而updated_at则用于记载最后的更新时刻。
表3.1 用户表
|---------------|--------------|------------------------------------|----------------------|
| 字段名 | 数据类型 | 约束 | 描述 |
| id | INTEGER | PRIMARY KEY AUTOINCREMENT | 用户唯一标识,自增主键 |
| username | VARCHAR(50) | NOT NULL UNIQUE | 用户名,用于登录,长度不超过50字符 |
| password_hash | VARCHAR(128) | NOT NULL | 密码哈希值,使用bcrypt算法加密存储 |
| email | VARCHAR(100) | UNIQUE | 电子邮箱地址,用于联系用户和密码找回 |
| created_at | TIMESTAMP | NOT NULL DEFAULT CURRENT_TIMESTAMP | 用户注册时间 |
| updated_at | TIMESTAMP | NOT NULL DEFAULT CURRENT_TIMESTAMP | 用户信息最后更新时间 |
设置用户名和邮箱时施加唯一约束,这样系统内就不会存在相同的用户名和邮箱地址,密码哈希字段保存的是执行了加盐哈希处理的密码,并非原始密码,以此保证用户数据的安全性,触发器可自动更新updated_at字段,即在每次记录更新的时候把此字段设为当前时间。
3.3.2 会话表
会话表用来存放每次检测任务的元信息,其涵盖会话ID,用户ID,会话类型,会话名称,原始文件路径,会话摘要,总风险分数,风险等级以及危险驾驶判定结果,还有创建时间和完成时间这些内容。
会话类型涵盖图片检测,即时检测以及视频分析这三种,它们用来辨别各类检测模式,会话摘要采取JSON格式来保留分析结果的概要信息,其中涉及行为统计次数之类的情况,按照总风险分数的大小可以得到风险等级,其级别划分包含低风险,中风险和高风险,而危险驾驶的判断结果体现为一个布尔值,表明当前会话是否属于危险驾驶范畴。
表3.2 会话表
|--------------|--------------|-------------------------------------------|---------------------------|
| 字段名 | 数据类型 | 约束 | 描述 |
| id | INTEGER | PRIMARY KEY AUTOINCREMENT | 会话唯一标识,自增主键 |
| user_id | INTEGER | NOT NULL FOREIGN KEY REFERENCES users(id) | 所属用户的ID,关联用户表 |
| session_type | VARCHAR(20) | NOT NULL | 会话类型:image、realtime、video |
| session_name | VARCHAR(200) | | 会话名称,用户自定义或系统自动生成 |
| file_path | VARCHAR(500) | | 原始文件路径,图片或视频的存储路径 |
| summary | TEXT | | 会话摘要,JSON格式存储统计信息 |
| total_score | REAL | DEFAULT 0 | 总风险分数,所有事件风险分之和 |
| risk_level | VARCHAR(20) | DEFAULT 'low' | 风险等级:low、medium、high |
| is_dangerous | BOOLEAN | DEFAULT 0 | 是否危险驾驶,0表示否,1表示是 |
| created_at | TIMESTAMP | NOT NULL DEFAULT CURRENT_TIMESTAMP | 会话创建时间 |
会话类型包括三种:image代表图片检测会话,realtime代表即时检测会话,video代表视频分析会话,会话摘要把分析结果的概要信息存为JSON格式,包含各种行为的统计次数,视频时长等,这样就能在历史会话列表里快速显示出来,风险等级按照总风险分数来计算,低于阈值的30%属于低风险,30%到70%属于中风险,超过70%则是高风险,危险驾驶的判定结果是个布尔值,表明这个会话有没有被判定为危险驾驶,判定的依照就是总风险分数是否超出系统设置的危险阈值。
3.3.3 事件表
事件表用于存放每个分析段所确认的事件细节,其包含事件ID,会话ID,事件类型,发生时间,风险分值,截图路径以及创建时间这些内容。
事件类型对应着十类驾驶行为中的某一种,其包含正常驾驶,接打电话,触摸中控,操作手机,饮水,转头与后排交流,与副驾交流,化妆以及操作车载设备,疲劳驾驶等。发生时间是指从视频开始播放起到事件发生为止所经过的时间,它以秒作为计量单位,而风险分值则是按照行为所占权重,重复次数以及是否连续出现这些因素来计算得出的该事件对于整体风险的贡献大小,截图路径则用来表示存有事件截图的图片在文件夹中的相对位置,方便网页页面予以显示。
表3.3 事件表
|-----------------|--------------|----------------------------------------------|------------------|
| 字段名 | 数据类型 | 约束 | 描述 |
| id | INTEGER | PRIMARY KEY AUTOINCREMENT | 事件唯一标识,自增主键 |
| session_id | INTEGER | NOT NULL FOREIGN KEY REFERENCES sessions(id) | 所属会话的ID,关联会话表 |
| event_type | VARCHAR(30) | NOT NULL | 事件类型,对应十类驾驶行为 |
| timestamp_sec | INTEGER | NOT NULL | 发生时间,从视频开始算起的秒数 |
| risk_score | REAL | NOT NULL DEFAULT 0 | 风险分值,该事件的风险贡献 |
| screenshot_path | VARCHAR(500) | | 截图路径,事件截图图片的相对路径 |
事件类型对应十类驾驶行为,具体包括:normal_driving指正常驾驶状态,phone_call指的是接听或者拨打手机电话,touch_console意味着碰触中控台,operating_phone就是操作手机的意思,drinking自然就是喝水这一举动,talking_rear是指向后座人员说话,也就是转头交流,talking_passenger则是同副驾驶位乘客讲话,makeup代表化妆行为,operating_device就是操控车内设备,而fatigue显示的是疲劳驾驶状况,所提及的发生时间从视频开头计算起,属于相对时间,采用秒作单位,可以据此找到视频的具体部分,风险分值依照行为重要程度,重复频率以及是否连贯出现等因素来计算得到,而且和当前对话的总体风险得分相加存在关联,截图路径即事件截图照片所保存之处的相对路径,其存储格式为 results / session_会话ID / event_时间戳.jpg,依靠后台静态文件服务被展示成可被访问的网址。
3.3.4 通话记录表
通话记录表用来储存用户上传的通话记录,里面包含通话ID,用户ID,手机号,通话起始时间,通话终止时间,来源以及生成时间这些信息。
手机号用来和左边填写的手机号实施比对,从而确认通话记录是不是属于当前驾驶员,通话的起止时间可用来判定事件发生时问是否包含在通话范围之内,来源字段则标注了通话记录的获取途径,比如是经过CSV上传,随机产生还是人工填写等。
表3.4 通话记录表
|--------------|-------------|-------------------------------------------|-----------------------------|
| 字段名 | 数据类型 | 约束 | 描述 |
| id | INTEGER | PRIMARY KEY AUTOINCREMENT | 通话记录唯一标识,自增主键 |
| user_id | INTEGER | NOT NULL FOREIGN KEY REFERENCES users(id) | 所属用户的ID,关联用户表 |
| phone_number | VARCHAR(20) | NOT NULL | 手机号,用于匹配驾驶员身份 |
| start_time | TIMESTAMP | NOT NULL | 通话开始时间 |
| end_time | TIMESTAMP | | 通话结束时间,可为空表示通话中 |
| source | VARCHAR(20) | NOT NULL DEFAULT 'manual' | 来源:csv_upload、random、manual |
手机号字段用来与用户在视频分析时所录入的手机号做比对,从而判定通话记录是否归于当前驾驶员名下,通话的起始时间与终止时间可用来判断事件发生时刻是否处于通话时段之内,在视频分析环节当中,系统依照起始时间来实施比对,至于终止时间则暂时未被采用,但被保留下来以便日后拓展应用,来源字段表明通话记录的获取途径,存在三种情形,即从CSV文件上传而来,随机创建或者人工填写,这样就能清楚地追寻到通话记录的源头所在。
3.3.5 系统配置表
系统设置表用以保存系统运行时的设置参数,包含设置ID,设置键,设置值,说明以及更新时间等内容。
配置键是一种独特的标识符,它包含诸如danger_threshold这样用来表现危险驾驶阈值的键,也存在像call_match_window这样的键,其代表通话契合的时间窗口。class_weights这个配置键用于储存各种行为所对应的基本权重,而current_model_path则负责保存当下正在采用的模型权重文件所在路径,而且,这些配置值都是以JSON这种格式来存贮的,这样就可以很方便地保存那些结构比较复杂的资料。
表3.5 配置表
|-------------|--------------|------------------------------------|---------------|
| 字段名 | 数据类型 | 约束 | 描述 |
| id | INTEGER | PRIMARY KEY AUTOINCREMENT | 配置唯一标识,自增主键 |
| key | VARCHAR(50) | NOT NULL UNIQUE | 配置键,唯一标识一个配置项 |
| value | TEXT | NOT NULL | 配置值,JSON格式存储 |
| description | VARCHAR(200) | | 配置项的描述说明 |
| updated_at | TIMESTAMP | NOT NULL DEFAULT CURRENT_TIMESTAMP | 最后更新时间 |
3.3.6 表间关系
用户表和会话表形成一对多关系,即一个用户存在许多检测会话,这种联系靠user_id这个外键达成,一旦该用户被删除,其全部会话记录就会按照 ON DELETE CASCADE 级联规则一同消失,从而保障数据的一致性,会话表和事件表也是类似的一对多关系,单个会话可能包含诸多分析事件,凭借 session_id 这个外键来建立联系,当会话结束的时候,其所有的事件记录也会跟着一同被清除,而且系统还会自动清理有关的截图文件,用户表和通话记录表同样处于一种一对多的关系之中,一个用户可以产生很多通话记录,利用 user_id 这个外键就可以把它们关联起来,如果某个用户被删除,那么它所对应的全部通话记录也会被级联式地清除掉。 系统设置表属于独立的设置存储表,与其它表不存在直接关联关系,系统依靠设置键完成设置项的读取及更新工作,具备动态设置能力,无需重新启动服务就能做到这一点。外键约束需经由PRAGMA foreign_keys = ON命令激活,以保证数据的参照完整性,创建各种索引目的在于提升查询效率,格外是对以用户ID和会话ID为依据的查询任务而言,借助前面述及的数据库设计方案,该系统能够全面保留用户资料,检测结论,事件状况以及自身设置信息,给后续的检索,统计及分析环节赋予稳固的数据支撑。
第四章 核心算法与模型实现
本章会详细阐述本系统的核心算法及模型的达成情况,包含YOLOv8模型的整合与推断服务,视频取帧和事件提取算法,风险积分模型以及视觉与通话记录相融合的算法。
4.1 基于YOLOv8的驾驶行为检测模型
本系统视觉识别的核心在于依靠YOLOv8的驾驶行为检测模型,该模型经由对自行创建数据集实施微调训练之后,可以辨别十种日常的驾驶行为,此部分将会阐述模型的合成形式,如何达成推理服务以及模型的热交换机制。
4.1.1 模型训练与权重文件
本系统所用 YOLV8 模型针对自行创建的驾驶员行为数据集执行了训练,该数据集包含诸多描绘驾驶场景的图片,覆盖十种驾驶行为类别,各类别的标注图片数目达数千张,训练期间采取迁移学习策略,即把在 COCO 数据集上预先训练好的 YOLV8 权重当作初始参数,再于驾驶员行为数据集上展开微调,以此来加快收敛速率并改进识别准确度,训练完毕的模型以 .pt 文件形式被保存到 backend/model_assets/weights 目录当中,系统可储存大量的权重文件,用户经由前端界面上传新的权重文件之后,可以挑选其中一个作为当下的预测模型。
4.1.2 推理服务封装
系统设计出InferenceService类以达成模型推理功能的统一调用,此类承担模型的加载,推理及结果解读工作,其核心功能在于利用Ultralytics供应的YOLO类来加载模型,只需给出权重文件路径便能完成模型加载。鉴于模型加载耗时较长,InferenceService采取单例模式,把加载好的模型对象存放在内存里,免除因重复加载而产生的性能损耗,在推理阶段,该过程接收OpenCV格式的图像数组,并调用模型的predict方法实施预测,predict方法具备诸多可设参数,比如置信度阈值,交并比阈值之类,这些参数能够依循需求加以调整。 模型所返回的结果为一个列表,其中各个元素包含检测框的坐标,置信度以及类别索引信息,结果解读环节会将模型输出的原始数据转成成结构化数据形式,该结构化数据包含类别名称,置信度以及边界框坐标等内容,而类别名称则依照预先设定好的 CLASS_NAME 映射表经由类别索引来获取。
4.1.3 模型热切换机制
系统可在无需重启服务的前提下切换所用模型,管理员经由前端上传新权重文件时,后台会先把该文件存入weights 目录,接着更新系统设置表里的 current_model_path,在ferenceService察觉到当前模型路径出现变动之后,就会重新获取新模型,更新已缓存的模型对象,如此一来,系统就能依循需求灵活换模,进而契合各种不同的应用环境。
4.2 视频抽帧与事件抽取算法
视频分析属于该系统的核心功能,要针对上传的视频开展抽帧,分析及事件获取工作,此部分将会细致阐述视频抽帧策略,依靠多数投票的事件确认原理以及事件截图的保存办法。
4.2.1 视频抽帧策略
系统要保证分析精度并且控制计算量,于是采用了每秒一帧的抽帧策略,视频按照录制帧率来运行,即每秒钟抽取一帧图像执行分析。假如视频的帧率为FPS,那么就会每隔FPS帧抽取一帧,针对时长大于自身的视频而言,这样的策略可有效地缩减必要处理的帧数,而且不会漏掉那些持续时间短暂的分心行为。抽帧操作由OpenCV的VideoCapture类来达成,经由调用cap.set方法把读取位置设置成预定的毫秒数,之后再利用cap.read方法去读取该位置附近的关键帧或者最邻近的帧,要是抽帧精确到秒这种程度的时候,就先算出目标毫秒数(等于秒数乘以一千),接着再做设置读取位置的步骤并执行帧的读取动作。
4.2.2 三秒分析段与多数投票规则
系统将连续的每秒抽帧结果按三秒一组划分为分析段。在每个三秒分析段内,对三帧图像的检测结果进行多数投票,只有当某种行为出现两帧或以上时,才确认该分析段内存在该行为事件。这种设计基于以下考虑:驾驶员的行为一般具备一定的持续性,单帧误检可能由光线改变,局部遮挡等引发短暂干扰,经由多数投票规则,可剔除此类短暂误检,优化事件确认的准确率,而且,三秒的分析段时延能兼顾时间分辨率与噪声抑制,既不会因分析段过短而增添大量噪声,又不会因分析段过长而忽略短暂的注意力分散情况。
每个经确认的事件,系统都会登记事件开始发生的时间,也就是此分析时段的第一秒所对应的时间点,事件截图选取在分析时段内检测到该行为的那一帧图片,亦或是选取三帧当中可信度最高的那一帧,以此来供后续的显示和记录之用。
4.2.3 事件截图保存
每个被确认的事件,系统都会存下一张截屏,放在会话详情页面显示。截屏是在原始视频帧上画上了检测框和类别标签,这样用户就能马上看出模型检测到的行为以及该行为出现在什么地方,截屏保存利用的是OpenCV的绘图功能,按照检测框的坐标用cv2.rectangle函数来画矩形框,框的颜色会依不同类别而变化,再用cv2.putText函数在矩形框上方或者旁边写上类别名称和置信度文字。 绘制完毕的图像经由cv2.imwrite保存到指定路径,其路径格式为 results/session_会话ID/event_时间戳.jpg,保存结束后,把该路径转为成可访问的URL,提供给前端予以显示。
4.3 风险积分模型
风险积分模型属于该系统评判驾驶安全水准的关键机制,它会把分散的行为事件转为成连续的风险分数,再经由累加获取会话总分,最后与阈值做比较来判断是否出现危险驾驶情况,这一部分将会细致阐述行为权重的设定,单事件风险得分的计算办法以及疲劳风险等级的划分情况。
4.3.1 行为权重设计
不同的分心行为对驾驶安全所构成的威胁程度存在差别,接打电话会占用驾驶员的视觉,听觉以及手动资源,风险比较高,调节空调之类的操作所需时间较短,风险相对要低一些,凭借这样的认知,系统针对各类行为制定了基本权重,将其当作风险计算的依照。
基础权重的取值处于0到10之间,正常行驶时的权重被设定为0,这体现出没有风险的情况。其他行为按照其危险程度被赋予不同的权重值,拨打电话,玩手机属于最危险的行为,所以权重最大;触及中控或者操作车内设备位居其次;喝水,化妆之类的行为权重就比较低,这些权重值能够经由系统设置页面实施动态调节,从而适应各种不同场景的需求。
4.3.2 单事件风险得分计算
单事件风险得分会考量行为的基础权重,还会全面考虑事件在分析时段中的重复出现频率,以及周边时间窗口里的接连出现状况,事件在分析时段里若多次出现,则表明此种行为具有持续性或者强度较大,比如在一个历时三秒的分析时段当中,某种行为出现了两三次,这就显示驾驶员在该段时间里一直存在注意力分散的现象,风险更大,系统会按照重复次数对基础权重实施放大处理,重复两次就乘上系数1.2,重复三次就乘上系数1.5。
邻近时间窗内持续出现某种情况,这体现出分心行为具有一定延续性,假如前面的分析时段也监测到此类行为,那么就表明驾驶员已长时间处于分心状态,风险叠加特征越发突出,系统保留一个历时范围较小的时间窗口,计算该段时间之前相同行为累计出现了多少次,并把这一数值当作倍率应用到基本权重之上以执行放大处理,经过这样一番运算之后,系统得出每个独立事件所包含的风险值等于原本设定好的权重与重复系数以及连贯性系数相乘得到的结果,如此一来便使得系统针对分心风险表现得更为精确细腻。
4.3.3 疲劳风险等级划分
会话的风险总分为所有事件风险得分的累加。根据总分的大小,系统将驾驶状态划分为三个等级:低风险、中风险和高风险。
低风险表明驾驶员的整体驾驶状况较好,偶尔会有轻微的注意力不集中现象,这种状况对安全的影响不大,中风险意味着驾驶员存在一定的注意力分散情况,应当受到关注。高风险则说明驾驶员频繁发生注意力不集中的情况,或者做出像接打电话这样的危险举动,这已属于危险驾驶范畴,系统将会清楚地给出关于危险驾驶的评判结果,危险临界值由系统设置来确定,经营者可依循实际需求去调整这个临界值,一旦会话的累计分数超出此临界值,系统就会判别为危险驾驶情形,临界值既能够设定成固定的数值,又可以依照视频的持续时间实施标准化调整。
4.4 视觉与通话记录融合算法
要解决触摸中控和接打电话行为在视觉上难以区分的问题,系统更新采用了通话记录融合算法,此算法检测到触摸中控行为时,经由比对手机号和通话时间窗口,把符合条件的触摸中控事件修正成接打电话事件。
4.4.1 融合算法设计思路
接打电话行为与触摸中控行为在视觉上具有很高的相似性:驾驶员的手往往会朝着耳朵附近或者中控区域去,仅仅依靠图像特征很难精准地区分这两者,不过,从本质上说,二者是有区别的:接打电话一般会留下通话记录,触摸中控则不会。
基于这一观察,本文设计了融合算法,利用通话记录这一外部数据源来辅助区分两种行为。算法的核心思想是:视觉模型监测到触摸中控之后,并不会马上把这当作最后的结果,它会按照事件发生的时机以及用户给出的手机号,在通话记录里面执行对照动作,一旦对照完成,就表明驾驶者那会儿正在接打电话,那么这个事件就要被改成接打电话;倘若对照没有达成,则仍然维持触摸中控这个状态。
4.4.2 匹配规则与实现
融合算法以手机号一致为原则,当用户执行视频分析操作时,需输入驾驶员手机号,系统会按照此号码于通话记录里实施过滤,仅保留符合手机号相符条件的通话记录。
事件时间必须在通话开始时间的十秒范围内。系统计算触摸中控事件发生时间与通话开始时间的绝对差值,如果差值不超过十秒,则认为该触摸中控行为与本次通话相关,应转为接打电话。十秒的时间窗口是基于以下考虑:驾驶员接打手机电话,从拿起手机直至开始通话,大概会花费两三秒,通话完毕后把手机放回去,又得花费两三秒。如此一来,十秒这样的时间间隔就足以涵盖这些细微差别,从而保障匹配精准无误。
匹配过程的达成包含从通话记录当中筛选出手机号相符的记录,针对每条符合的记录,算出事件时间与通话开始时间的绝对差值,如果这个差值小于等于预先设置好的窗口值,就返回匹配完成,若差值大于窗口值,则接着去查看下一条记录。
4.4.3 实时检测中的融合
在即时检测场景当中,融合算法的达成存在一些差异,即时检测不可能事先知晓通话记录,所以它会采取轮询的方式经由 URL 获取即时通话数据。
用户需设置一个包含通话数据的 URL以及轮询间隔,系统会遵照设置的间隔定时调用此 URL以获取最新的通话记录。一旦即时检测察觉到触摸中控的情况,系统便把当前时间当作参照,再加上用户给出的手机号以及最近一次获取的通话记录,并依照同样的规则展开比对,若比对结果相符,那么前端就会依照接打电话的行为执行统计并予以显示,这样的设计让系统在即时检测的时候也能利用外部的通话数据,从而改善识别的准确程度,给用户带来更为可靠的即时观察服务。
第五章 系统详细实现
此章节会细致阐述系统的具体达成情况,包含后端 API 接口的达成,前端页面的达成以及关键业务流程的达成情况,系统采取前后端分离的架构形式,其后端利用 FastAPI 框架,前端凭借 Vite 来创建原生 JavaScript 应用。
5.1 后端API接口实现
后端API接口拆解成许多路由模块,各个模块承担不同领域功能的处理工作,此部分会依次阐述各模块关键接口的达成情况。
5.1.1 认证接口实现
认证接口具备注册,登录,登出以及获取当前用户信息这些功能,注册接口收到用户名,密码以及邮箱之后,会对密码执行哈希加密处理然后存进数据库当中,当注册操作达成的时候,系统会自动形成登录会话,并且设定好 Cookie 返回到前端去,登录接口负责校验用户名和密码,只有在验证无误之后才会创建登录会话并且设置好 Cookie,登出接口则起到清除当前用户登录时所对应的 Cookie 的作用,而获取当前用户信息这个接口,它会从请求消息里的 Cookie 部分拿到用户 ID,接着去查询数据库,最后把用户的相关信息反馈回来。
认证功能经由依赖注入来达成,定义get_current_user这个依赖项,从中获取Cookie里的用户ID,并且查询数据库核实用户是否存在于其中,那些须要用户认证的接口,仅仅要表明这个依赖就可以了。
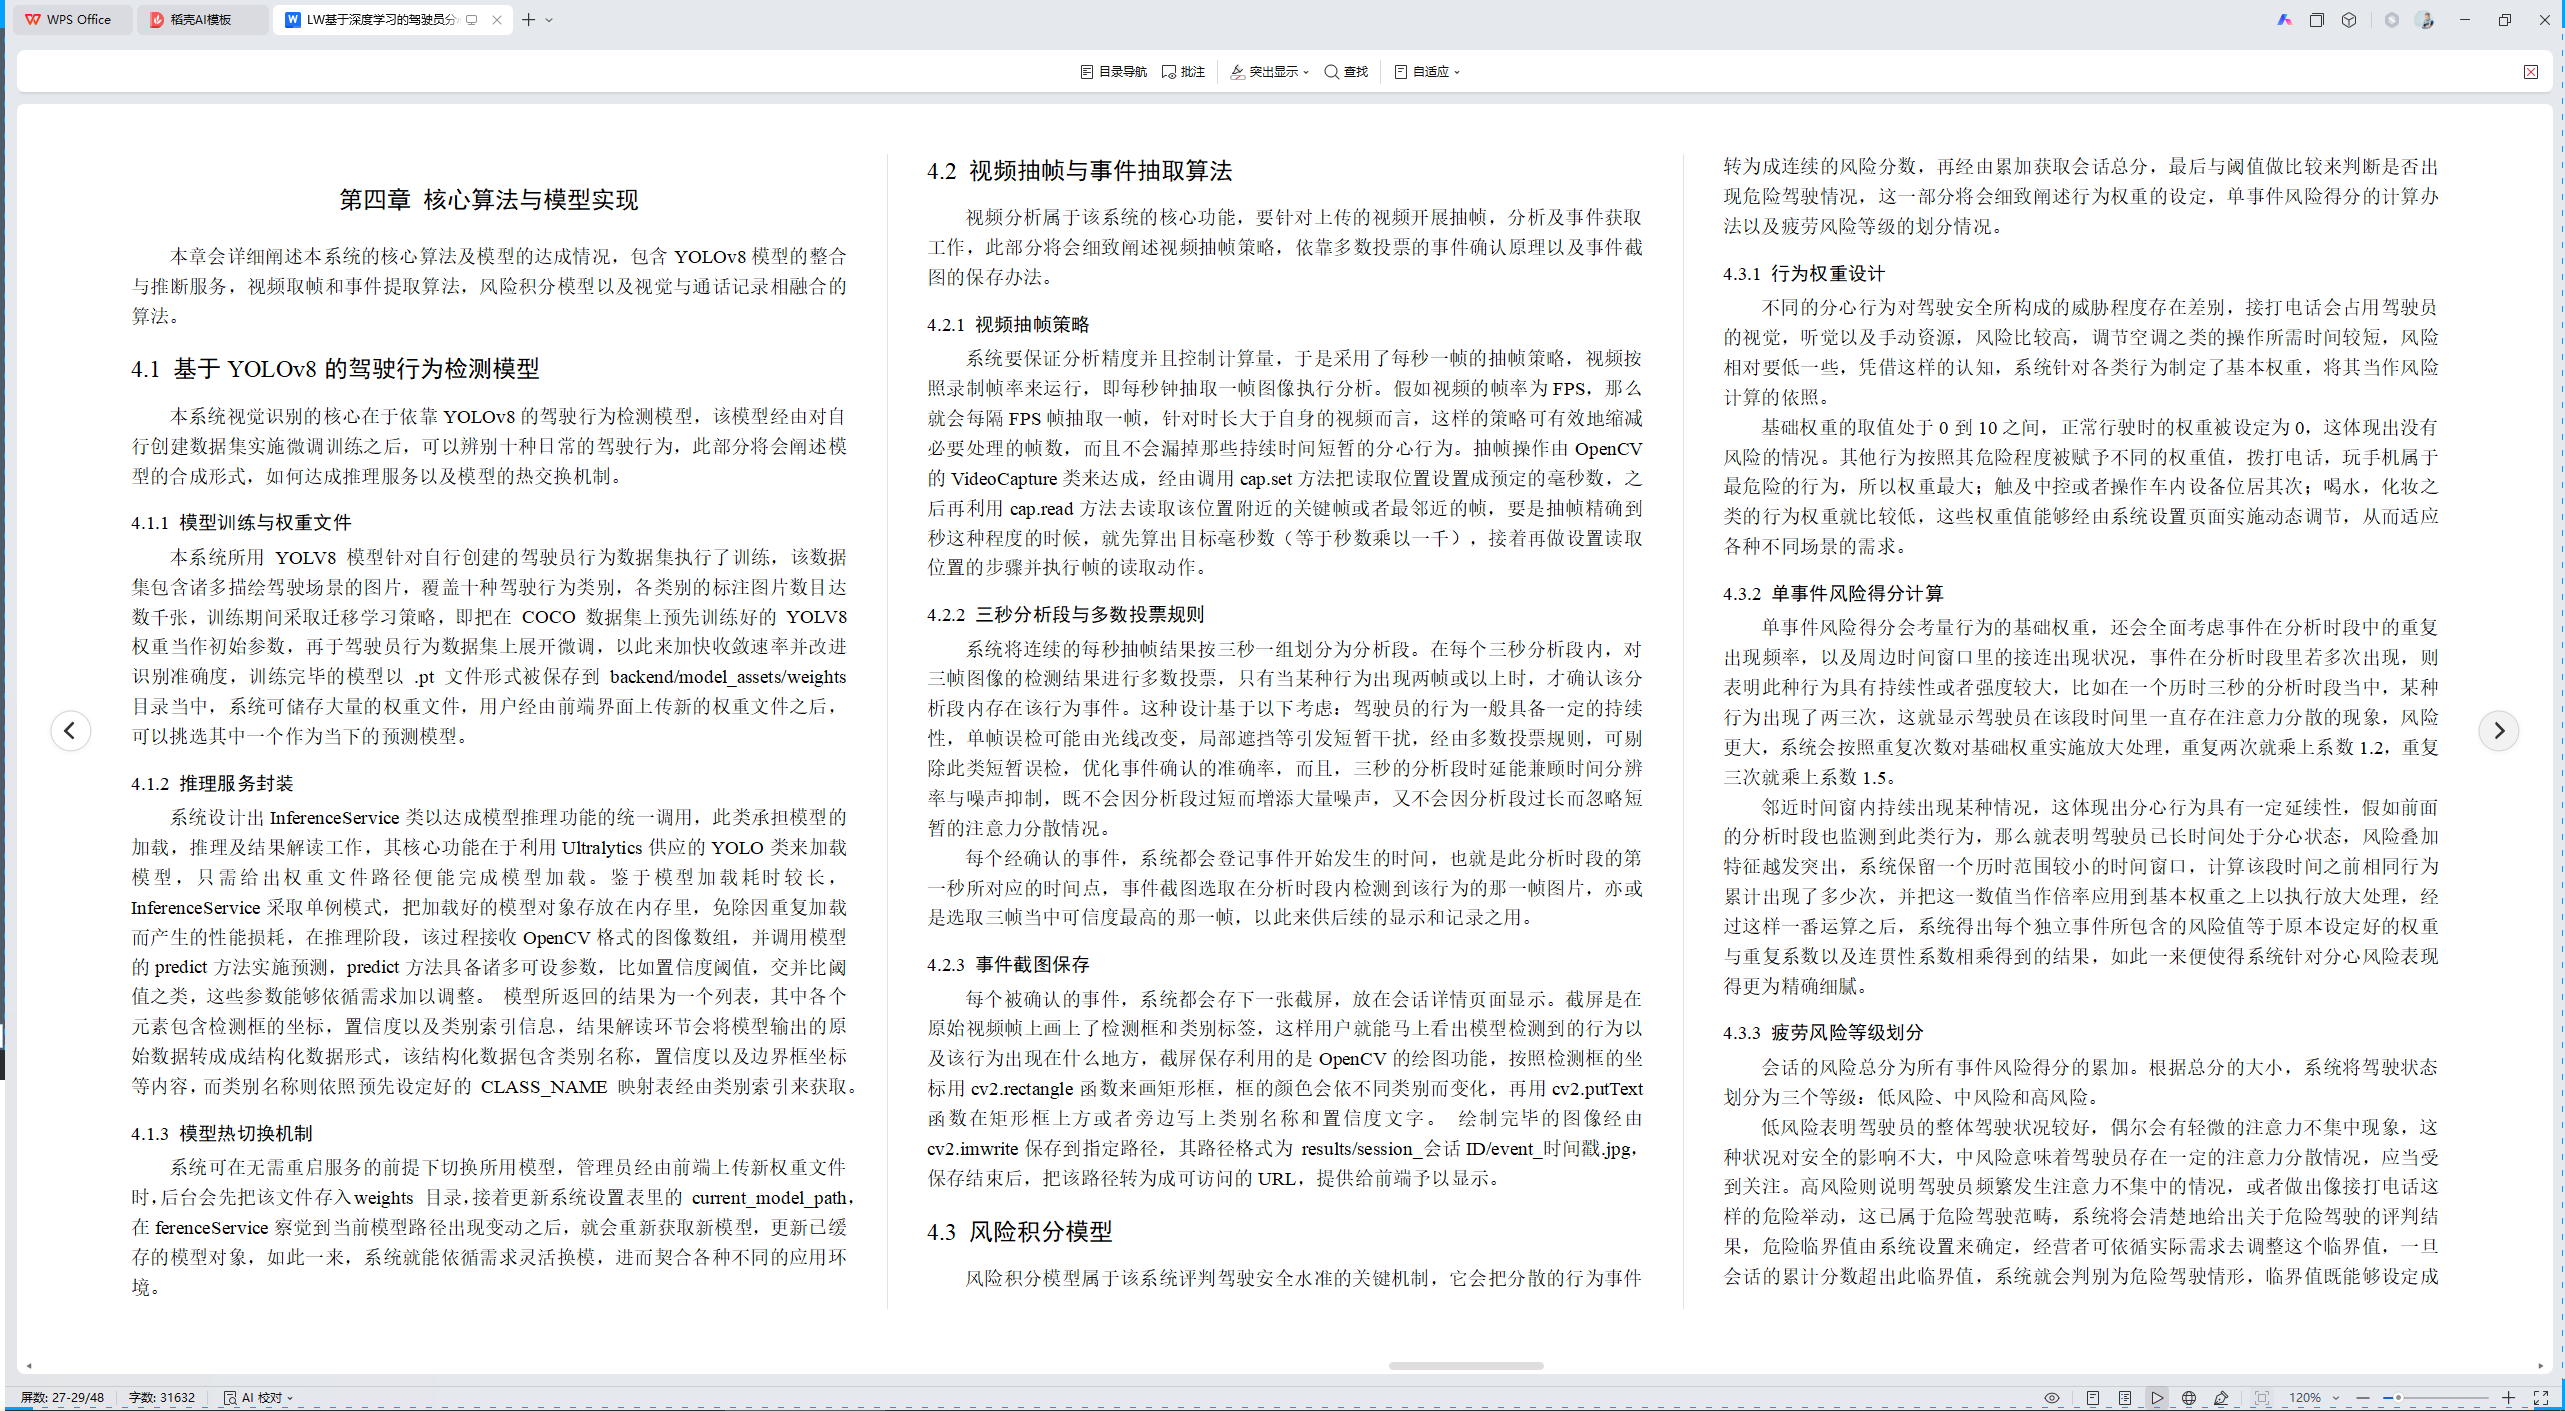
5.1.2 实时检测接口实现
实时检测接口具有单帧检测和URL数据获取这两个主要功能,单帧检测接口收到前端上传的Base64编码图像之后,会将其解码成OpenCV格式,接着调用InferenceService开展推理,然后返回类别名称,置信度以及边界框坐标。URL数据获取接口接收到一个URL地址以后,经由HTTP请求来获取这个地址所对应的数据,接口假定返回的数据是JSON格式的,而且包含通话记录列表,接口会对返回的数据执行标准化处理,从中提炼出手机号,通话开始时间等关键字段,再传递给前端。
图5-1 实时检测页面
5.1.3 图片检测接口实现
图片检测接口收到上传的图片文件时,会先把原始图片存放在上传目录当中,接着实施解码和推断步骤,当推断得出检测结果之后,便在原图之上描绘检测框及标签,再把结果图片存储到结果目录里面,之后还要在数据库里生成与图片相关的会话记录,而且把检测结果以及结果图片的网址告知给前端页面。
5.1.4 视频分析接口实现
视频分析接口属于本系统比较复杂的接口,其具备视频上传,状态查询以及事件获取等功能。
视频上传接口负责接收视频文件,手机号,录制开始时间以及可选的通话记录数据,该接口先将视频文件存入上传目录,接着在数据库里生成会话记录。视频分析属于耗时操作,所以接口不必等待分析结束就直接返回会话ID,由前端经由查询状态接口得知分析进程。
视频分析属于后台任务运行范畴,经由 FastAPI 的后台任务功能来提交分析函数并使其在后台执行,该分析函数调用 VideoAnalysisService 实现全面的视频分析流程,其中牵涉到诸如抽帧,事件确认,截图保存,风险计算这些环节,当分析完毕之后,把会话状态更新为已完成,而状态查询接口能够显示会话当下的状态信息,比如完成情况,总风险评分,风险级别以及危险驾驶判断等内容,至于事件获取接口,则会给出会话内所有事件的具体详情,包含事件种类,产生时间,风险数值,截图存放位置等方面的信息。
5.1.5 历史会话管理接口实现
历史会话运作接口具备一些功能,比如会话列表的获取,会话详情的探寻,会话的剔除以及会话的导出等。会话列表获取接口会给出当前用户所有的会话,并且支持依照会话类型,时间范围之类的条件实施筛选,探寻结果按照创建时间倒序排列,刚刚创建的会话位于前面。
会话详情查询接口会返回单个会话的完整信息,其中包含会话元数据,事件列表以及行为统计,会话删除接口负责删除会话及其相关的全部数据,涉及事件记录,截取文件以及上传的视频文件,会话导出接口把会话数据导出成CSV格式的文件,至于事件导出,则是把事件列表导出到CSV当中,每一行对应一个事件。
5.1.6 系统配置接口实现
系统设置接口包含设置读取,设置更新以及模型上传等职能,设置读取接口从数据库获取系统设置,其中涉及危险阈值,通话窗口,行为权重以及当前模型路径等信息。设置更新接口接收前端传送的设置参数,经过校验之后存入数据库,模型上传接口接收以.pt为扩展名的权重文件,并将其保存在weights目录下,接着会更新当下模型路径的设置,还会清空InferenceService的模型缓存,从而让新的模型立刻产生效果。
5.1.7 通话记录管理接口实现
通话记录经营接口具备诸如CSV上传,通话记录筛选之类的功能,其CSV上传接口负责接收欲上传的CSV文件,并对该文件内容加以分析,从中获取像手机号,通话开始时刻,通话终止时刻这些字段信息,然后把经由此类分析得到的通话记录清单反馈给前端部分,而且该接口所指定的CSV文件格式允许列名由用户来自定义,于是它会遵照预设好的列名对照关系自行判断各个列对应的是什么内容。
5.2 前端页面实现
前端部分采取单页应用这种架构形式,各个页面都是借助路由来实施动态加载以及渲染,接下来会阐述核心页面的达成情况。
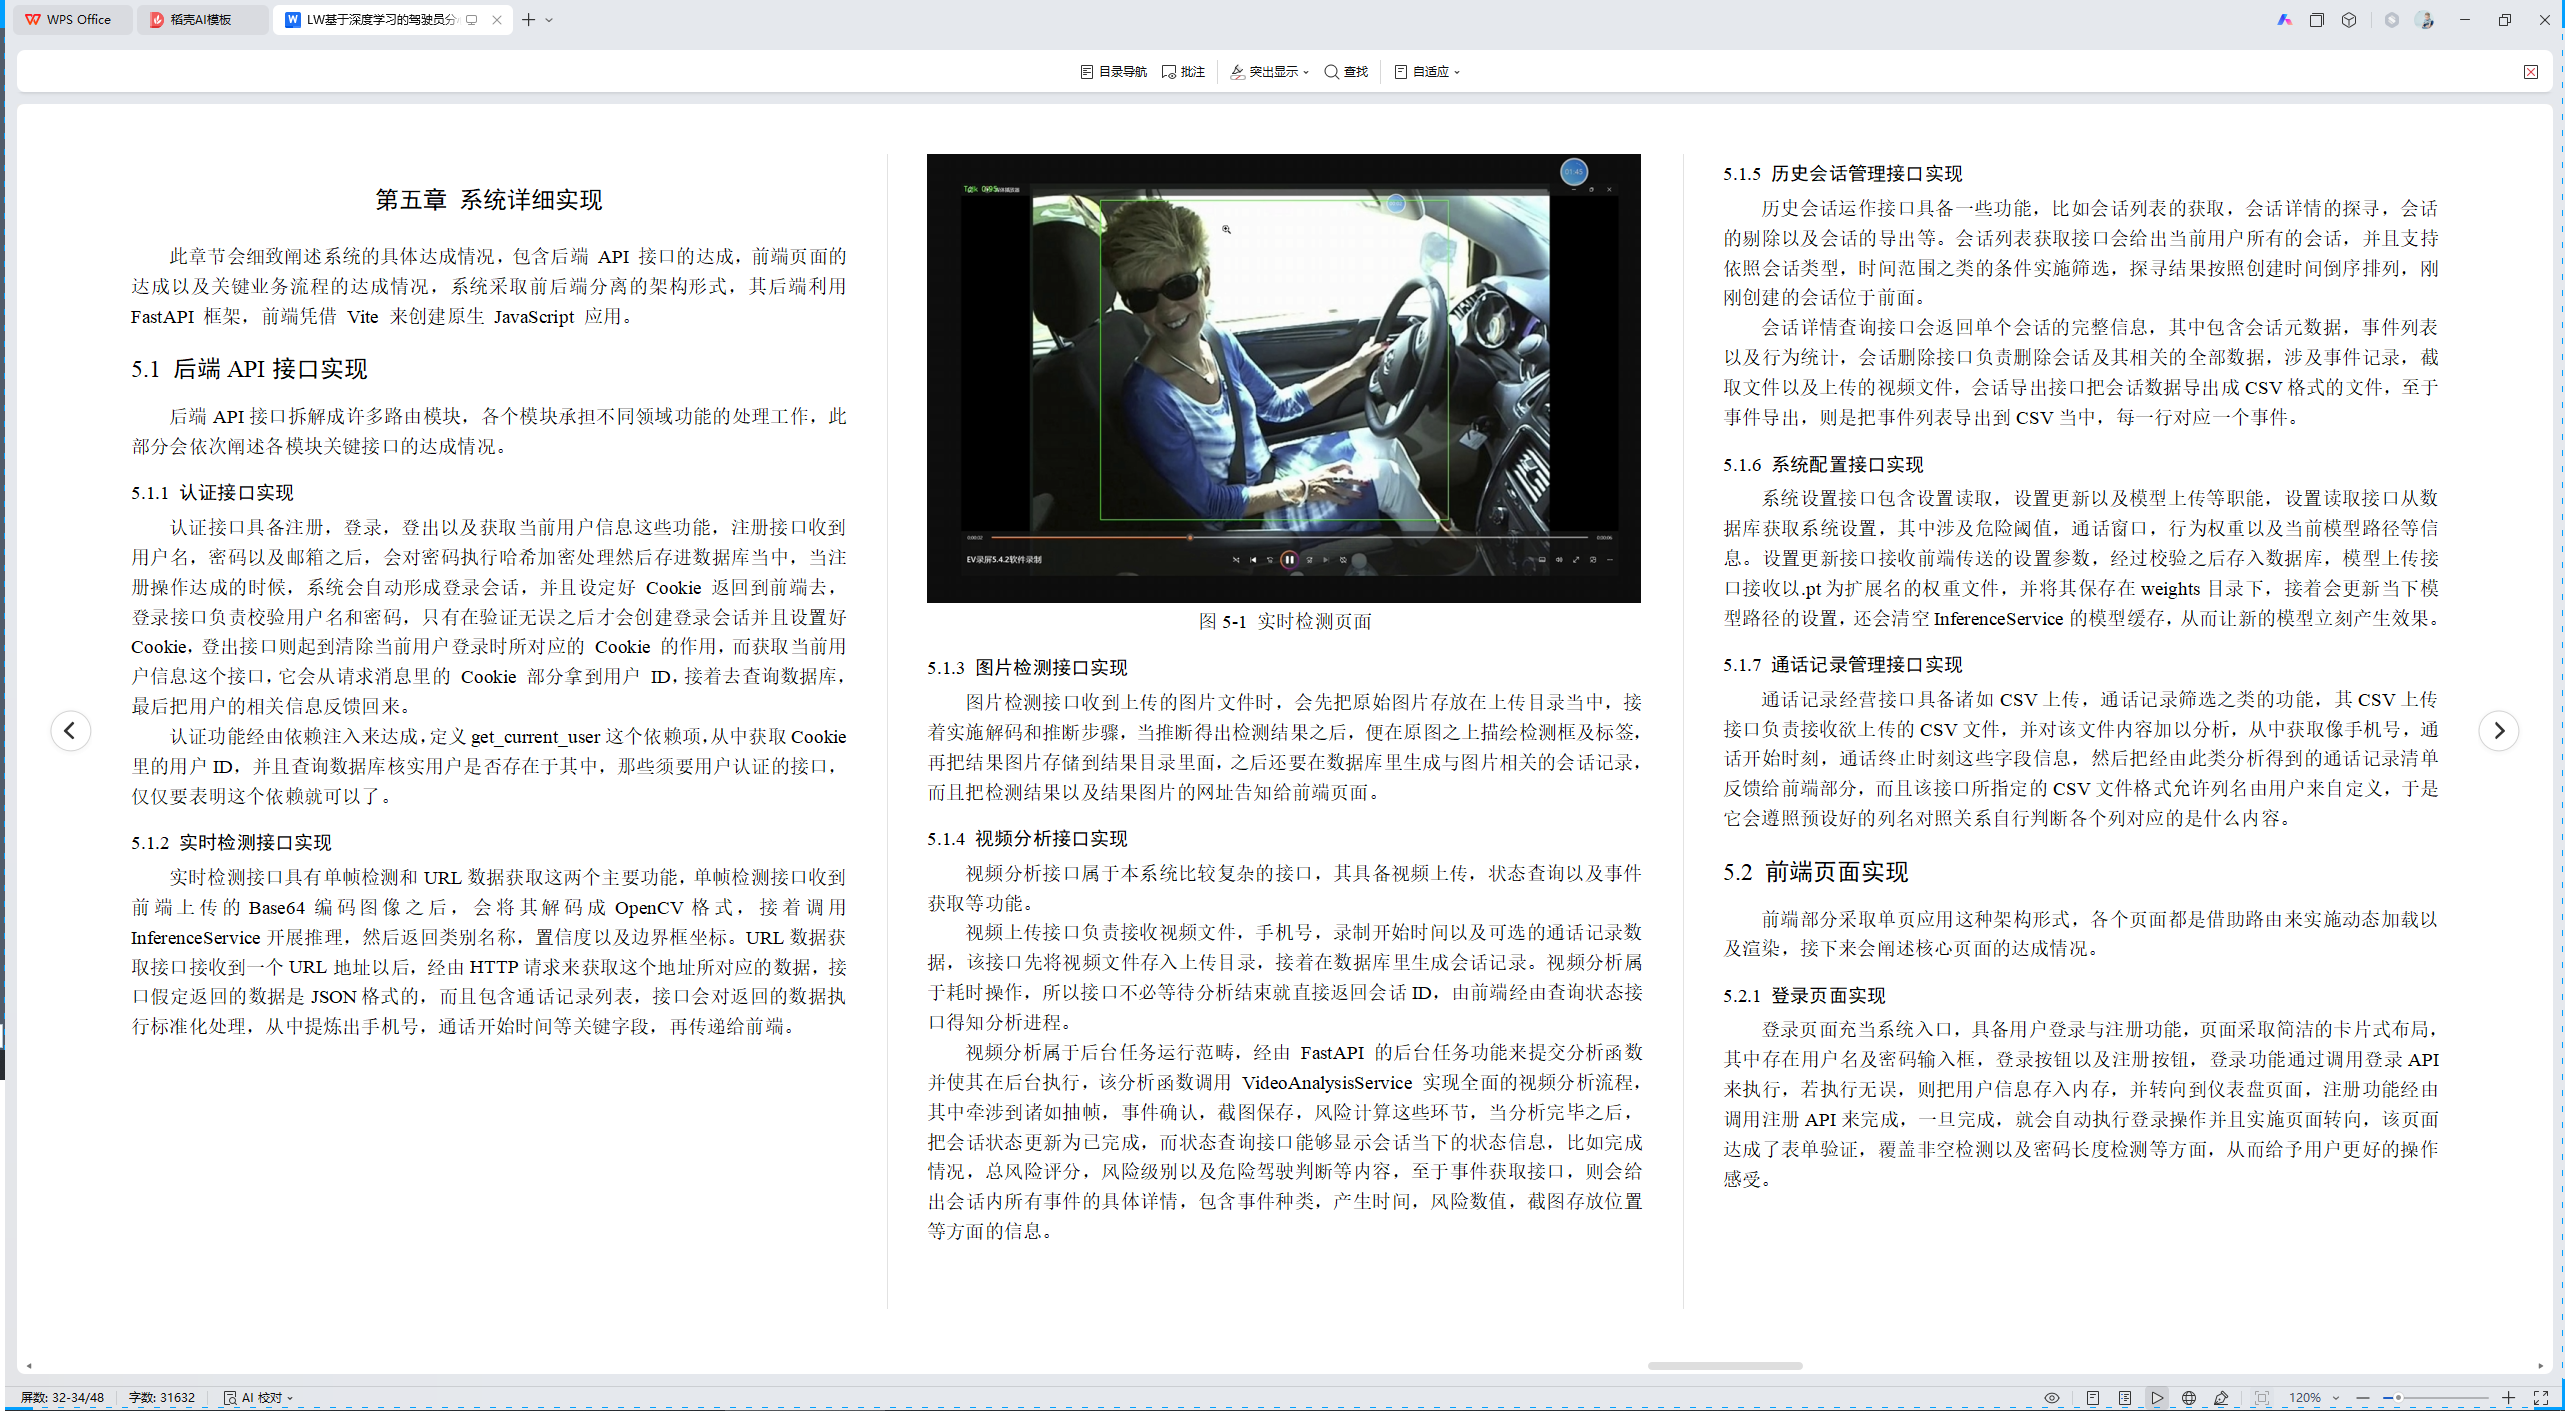
5.2.1 登录页面实现
登录页面充当系统入口,具备用户登录与注册功能,页面采取简洁的卡片式布局,其中存在用户名及密码输入框,登录按钮以及注册按钮,登录功能通过调用登录API来执行,若执行无误,则把用户信息存入内存,并转向到仪表盘页面,注册功能经由调用注册API来完成,一旦完成,就会自动执行登录操作并且实施页面转向,该页面达成了表单验证,覆盖非空检测以及密码长度检测等方面,从而给予用户更好的操作感受。
图5-2 登录注册页面
5.2.2 仪表盘页面实现
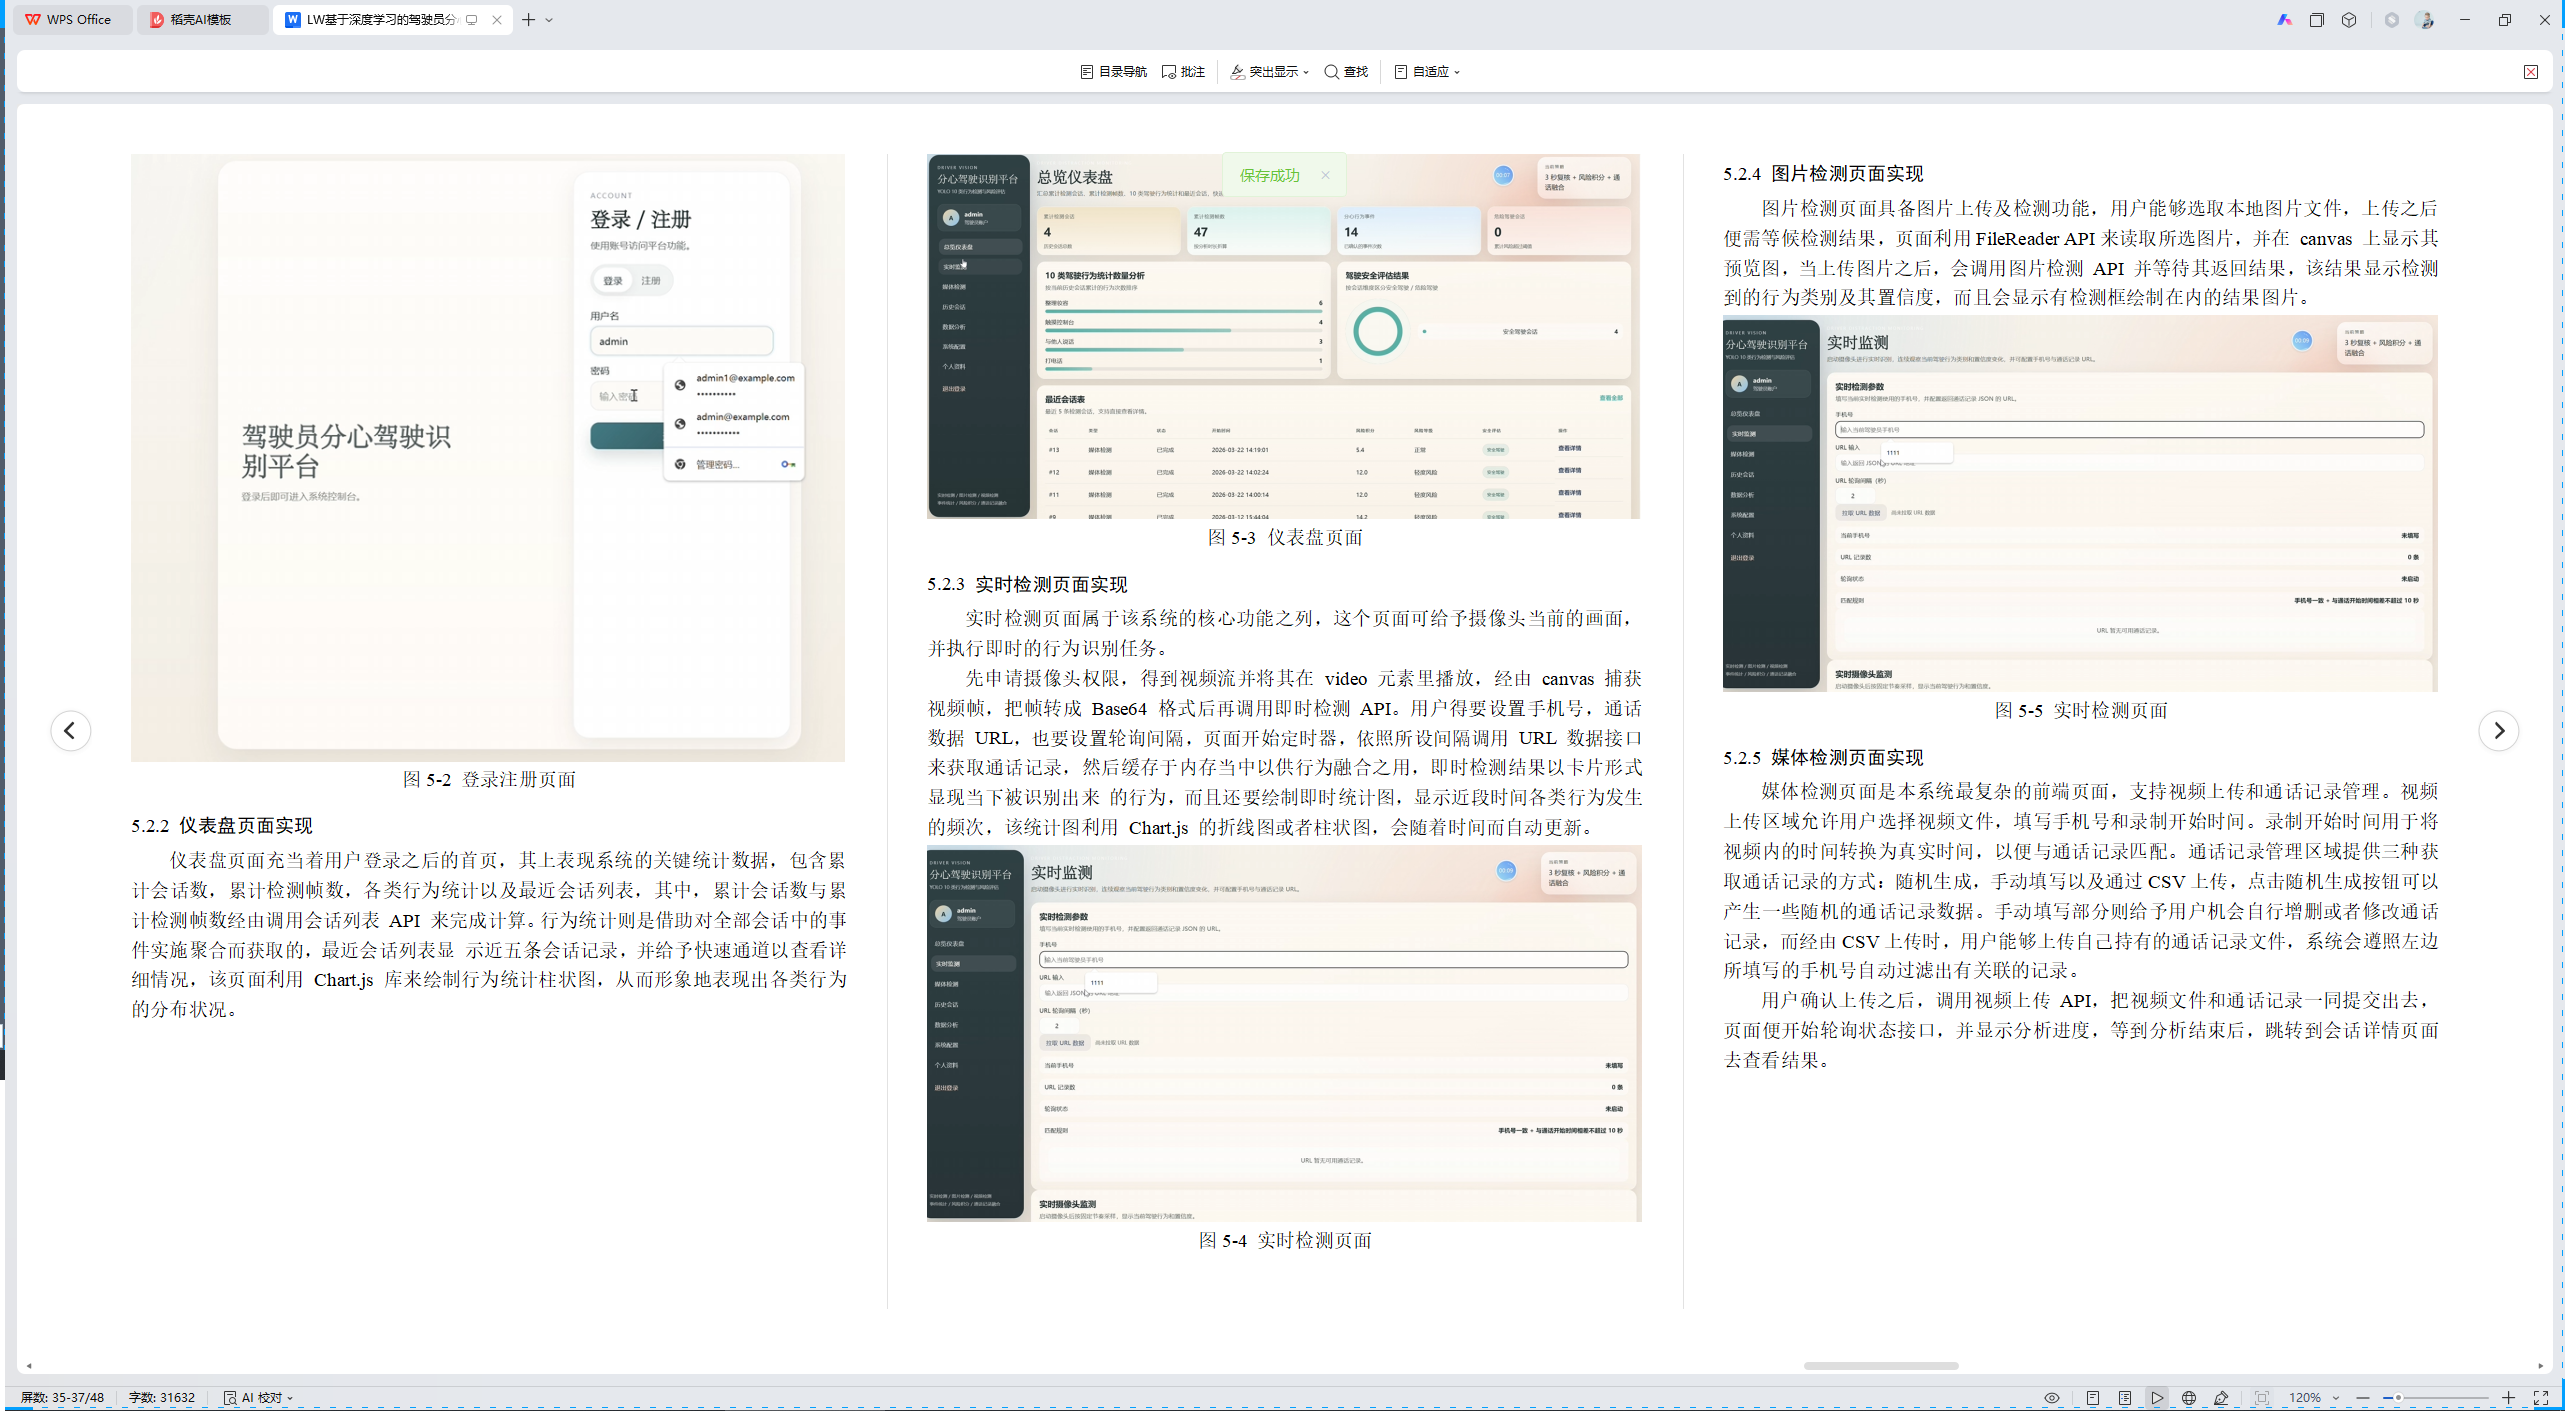
仪表盘页面充当着用户登录之后的首页,其上表现系统的关键统计数据,包含累计会话数,累计检测帧数,各类行为统计以及最近会话列表,其中,累计会话数与累计检测帧数经由调用会话列表 API 来完成计算。行为统计则是借助对全部会话中的事件实施聚合而获取的,最近会话列表显 示近五条会话记录,并给予快速通道以查看详细情况,该页面利用 Chart.js 库来绘制行为统计柱状图,从而形象地表现出各类行为的分布状况。
图5-3 仪表盘页面
5.2.3 实时检测页面实现
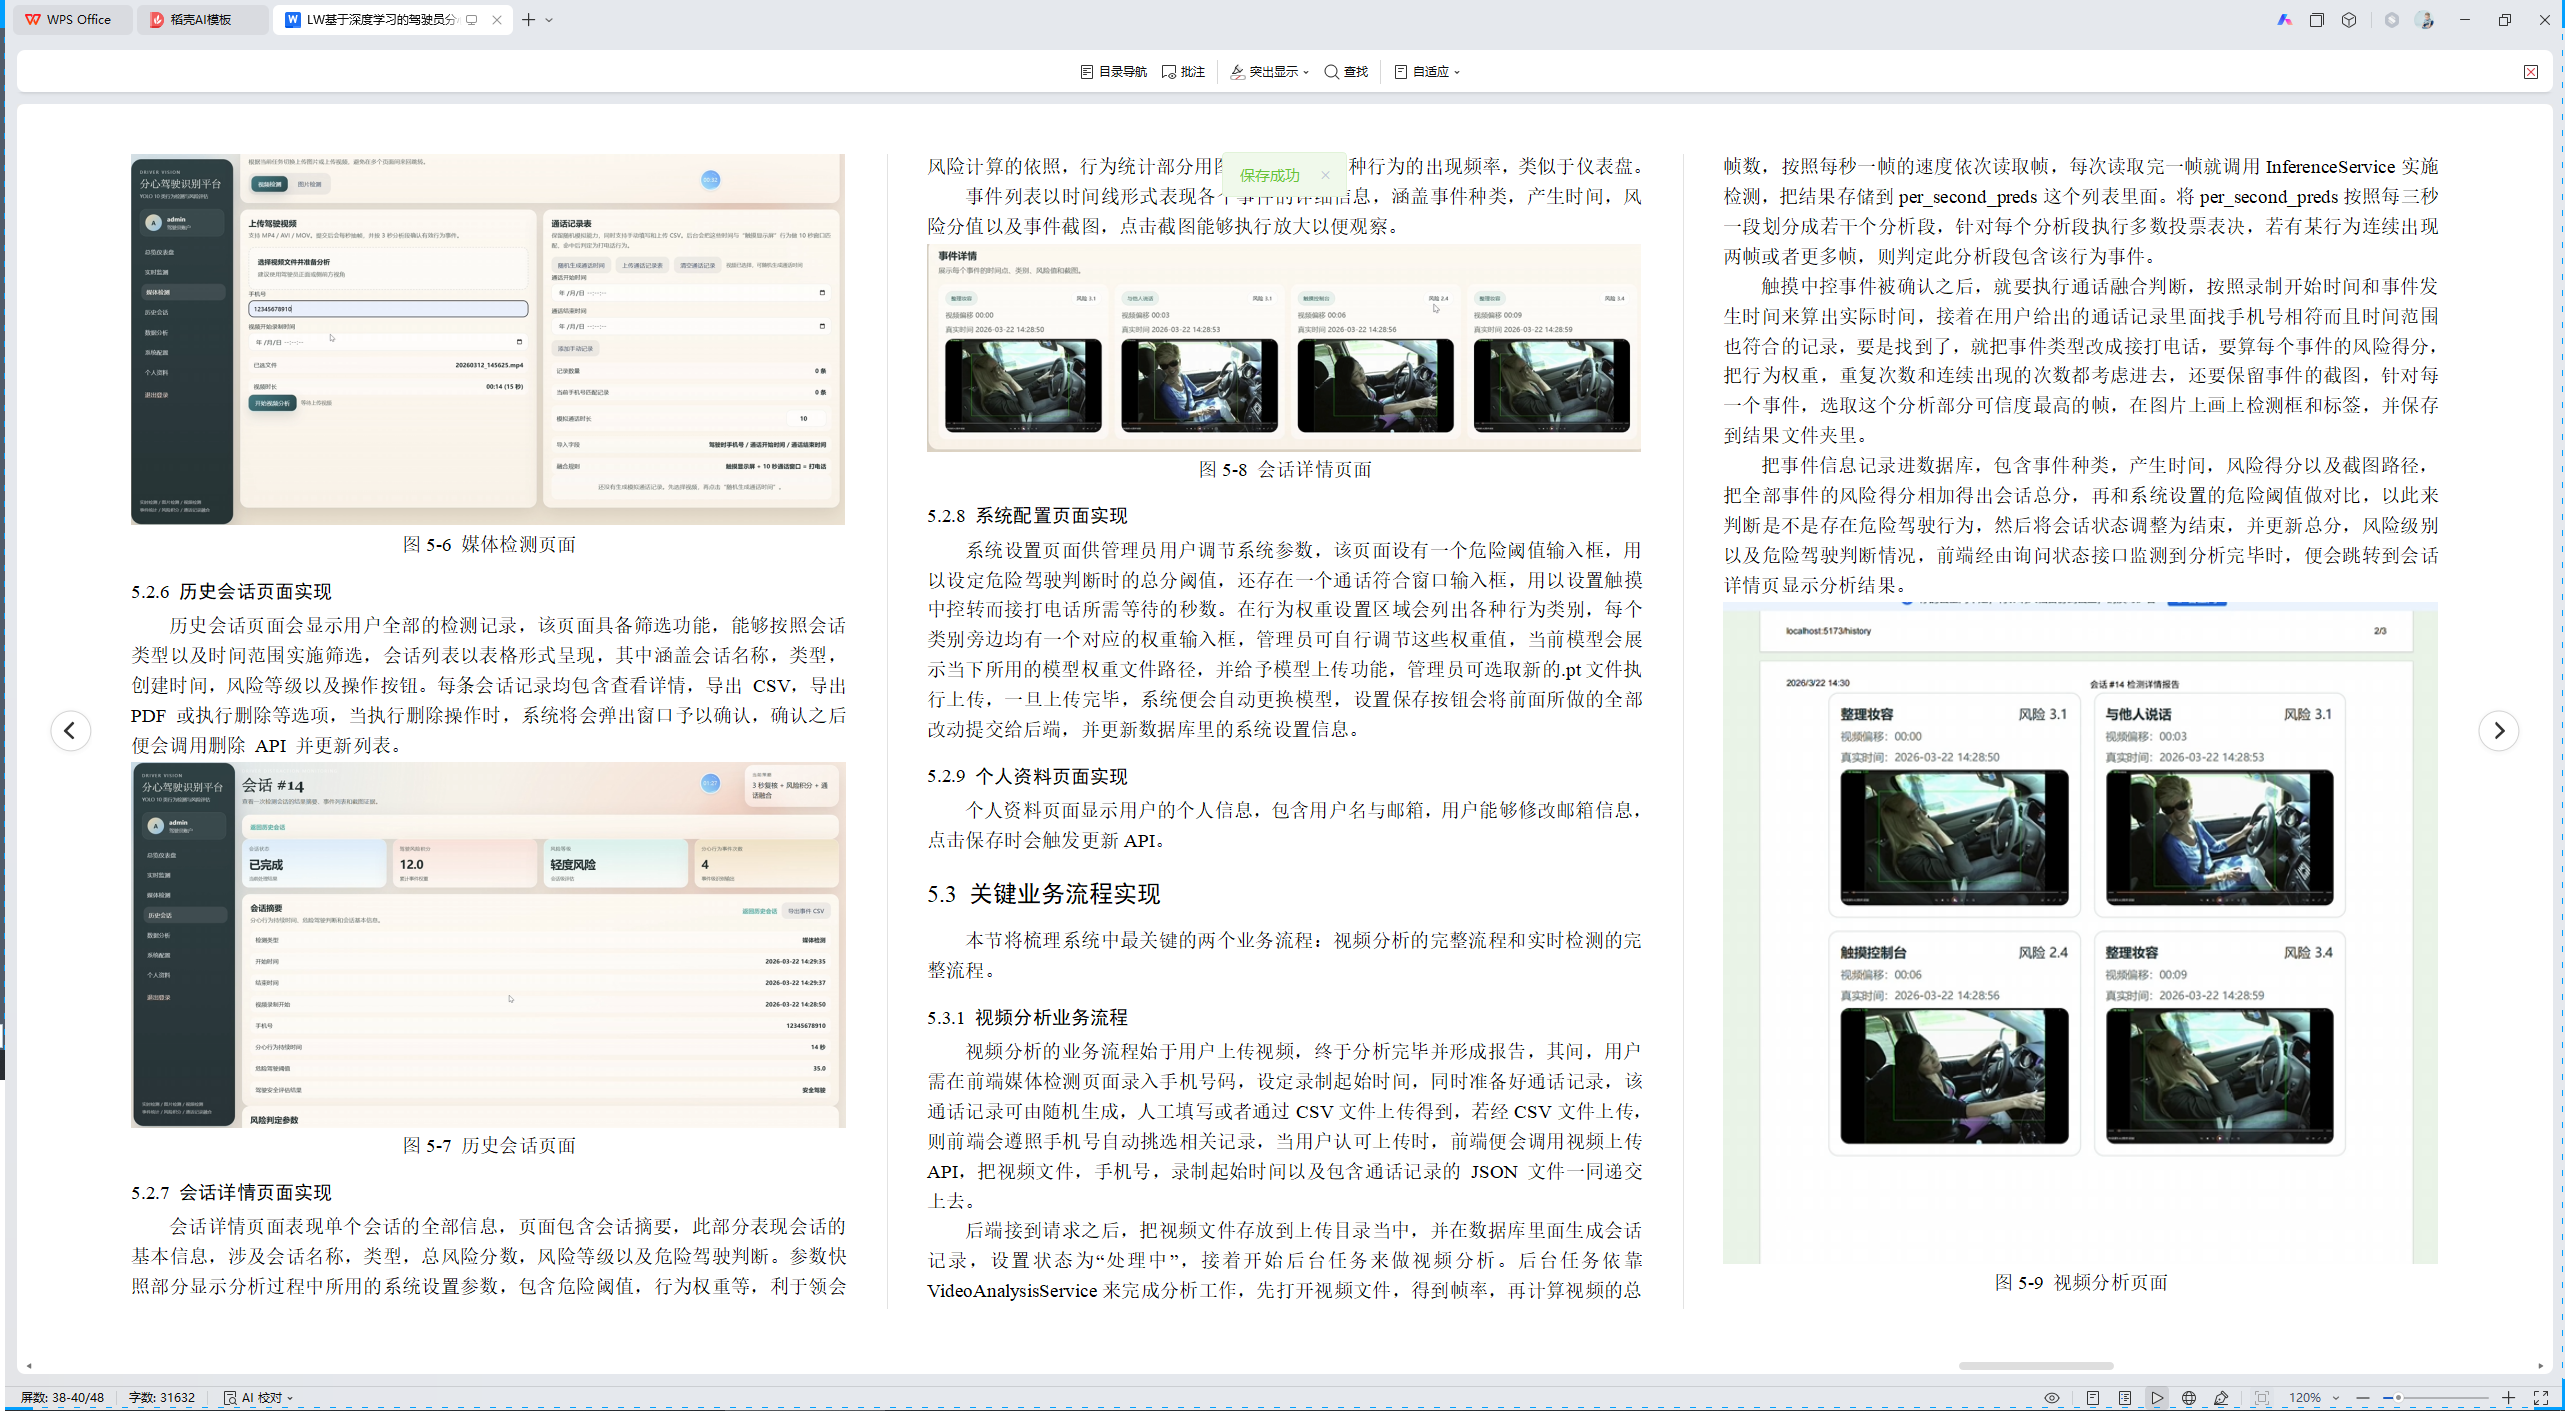
实时检测页面属于该系统的核心功能之列,这个页面可给予摄像头当前的画面,并执行即时的行为识别任务。
先申请摄像头权限,得到视频流并将其在 video 元素里播放,经由 canvas 捕获视频帧,把帧转成 Base64 格式后再调用即时检测 API。用户得要设置手机号,通话数据 URL,也要设置轮询间隔,页面开始定时器,依照所设间隔调用 URL 数据接口来获取通话记录,然后缓存于内存当中以供行为融合之用,即时检测结果以卡片形式显现当下被识别出来 的行为,而且还要绘制即时统计图,显示近段时间各类行为发生的频次,该统计图利用 Chart.js 的折线图或者柱状图,会随着时间而自动更新。
图5-4 实时检测页面
5.2.4 图片检测页面实现
图片检测页面具备图片上传及检测功能,用户能够选取本地图片文件,上传之后便需等候检测结果,页面利用FileReader API来读取所选图片,并在 canvas 上显示其预览图,当上传图片之后,会调用图片检测 API 并等待其返回结果,该结果显示检测到的行为类别及其置信度,而且会显示有检测框绘制在内的结果图片。
图5-5 实时检测页面
5.2.5 媒体检测页面实现
媒体检测页面是本系统最复杂的前端页面,支持视频上传和通话记录管理。视频上传区域允许用户选择视频文件,填写手机号和录制开始时间。录制开始时间用于将视频内的时间转换为真实时间,以便与通话记录匹配。通话记录管理区域提供三种获取通话记录的方式:随机生成,手动填写以及通过CSV上传,点击随机生成按钮可以产生一些随机的通话记录数据。手动填写部分则给予用户机会自行增删或者修改通话记录,而经由CSV上传时,用户能够上传自己持有的通话记录文件,系统会遵照左边所填写的手机号自动过滤出有关联的记录。
用户确认上传之后,调用视频上传 API,把视频文件和通话记录一同提交出去,页面便开始轮询状态接口,并显示分析进度,等到分析结束后,跳转到会话详情页面去查看结果。
图5-6 媒体检测页面
5.2.6 历史会话页面实现
历史会话页面会显示用户全部的检测记录,该页面具备筛选功能,能够按照会话类型以及时间范围实施筛选,会话列表以表格形式呈现,其中涵盖会话名称,类型,创建时间,风险等级以及操作按钮。每条会话记录均包含查看详情,导出 CSV,导出 PDF 或执行删除等选项,当执行删除操作时,系统将会弹出窗口予以确认,确认之后便会调用删除 API 并更新列表。
图5-7 历史会话页面
5.2.7 会话详情页面实现
会话详情页面表现单个会话的全部信息,页面包含会话摘要,此部分表现会话的基本信息,涉及会话名称,类型,总风险分数,风险等级以及危险驾驶判断。参数快照部分显示分析过程中所用的系统设置参数,包含危险阈值,行为权重等,利于领会风险计算的依照,行为统计部分用图表形式表现各种行为的出现频率,类似于仪表盘。
事件列表以时间线形式表现各个事件的详细信息,涵盖事件种类,产生时间,风险分值以及事件截图,点击截图能够执行放大以便观察。
图5-8 会话详情页面
5.2.8 系统配置页面实现
系统设置页面供管理员用户调节系统参数,该页面设有一个危险阈值输入框,用以设定危险驾驶判断时的总分阈值,还存在一个通话符合窗口输入框,用以设置触摸中控转而接打电话所需等待的秒数。在行为权重设置区域会列出各种行为类别,每个类别旁边均有一个对应的权重输入框,管理员可自行调节这些权重值,当前模型会展示当下所用的模型权重文件路径,并给予模型上传功能,管理员可选取新的.pt文件执行上传,一旦上传完毕,系统便会自动更换模型,设置保存按钮会将前面所做的全部改动提交给后端,并更新数据库里的系统设置信息。
5.2.9 个人资料页面实现
个人资料页面显示用户的个人信息,包含用户名与邮箱,用户能够修改邮箱信息,点击保存时会触发更新API。
5.3 关键业务流程实现
本节将梳理系统中最关键的两个业务流程:视频分析的完整流程和实时检测的完整流程。
5.3.1 视频分析业务流程
视频分析的业务流程始于用户上传视频,终于分析完毕并形成报告,其间,用户需在前端媒体检测页面录入手机号码,设定录制起始时间,同时准备好通话记录,该通话记录可由随机生成,人工填写或者通过CSV文件上传得到,若经CSV文件上传,则前端会遵照手机号自动挑选相关记录,当用户认可上传时,前端便会调用视频上传 API,把视频文件,手机号,录制起始时间以及包含通话记录的 JSON 文件一同递交上去。
后端接到请求之后,把视频文件存放到上传目录当中,并在数据库里面生成会话记录,设置状态为"处理中",接着开始后台任务来做视频分析。后台任务依靠VideoAnalysisService来完成分析工作,先打开视频文件,得到帧率,再计算视频的总帧数,按照每秒一帧的速度依次读取帧,每次读取完一帧就调用InferenceService实施检测,把结果存储到per_second_preds这个列表里面。将per_second_preds按照每三秒一段划分成若干个分析段,针对每个分析段执行多数投票表决,若有某行为连续出现两帧或者更多帧,则判定此分析段包含该行为事件。
触摸中控事件被确认之后,就要执行通话融合判断,按照录制开始时间和事件发生时间来算出实际时间,接着在用户给出的通话记录里面找手机号相符而且时间范围也符合的记录,要是找到了,就把事件类型改成接打电话,要算每个事件的风险得分,把行为权重,重复次数和连续出现的次数都考虑进去,还要保留事件的截图,针对每一个事件,选取这个分析部分可信度最高的帧,在图片上画上检测框和标签,并保存到结果文件夹里。
把事件信息记录进数据库,包含事件种类,产生时间,风险得分以及截图路径,把全部事件的风险得分相加得出会话总分,再和系统设置的危险阈值做对比,以此来判断是不是存在危险驾驶行为,然后将会话状态调整为结束,并更新总分,风险级别以及危险驾驶判断情况,前端经由询问状态接口监测到分析完毕时,便会跳转到会话详情页显示分析结果。
图5-9 视频分析页面
图5-10 视频分析流程图
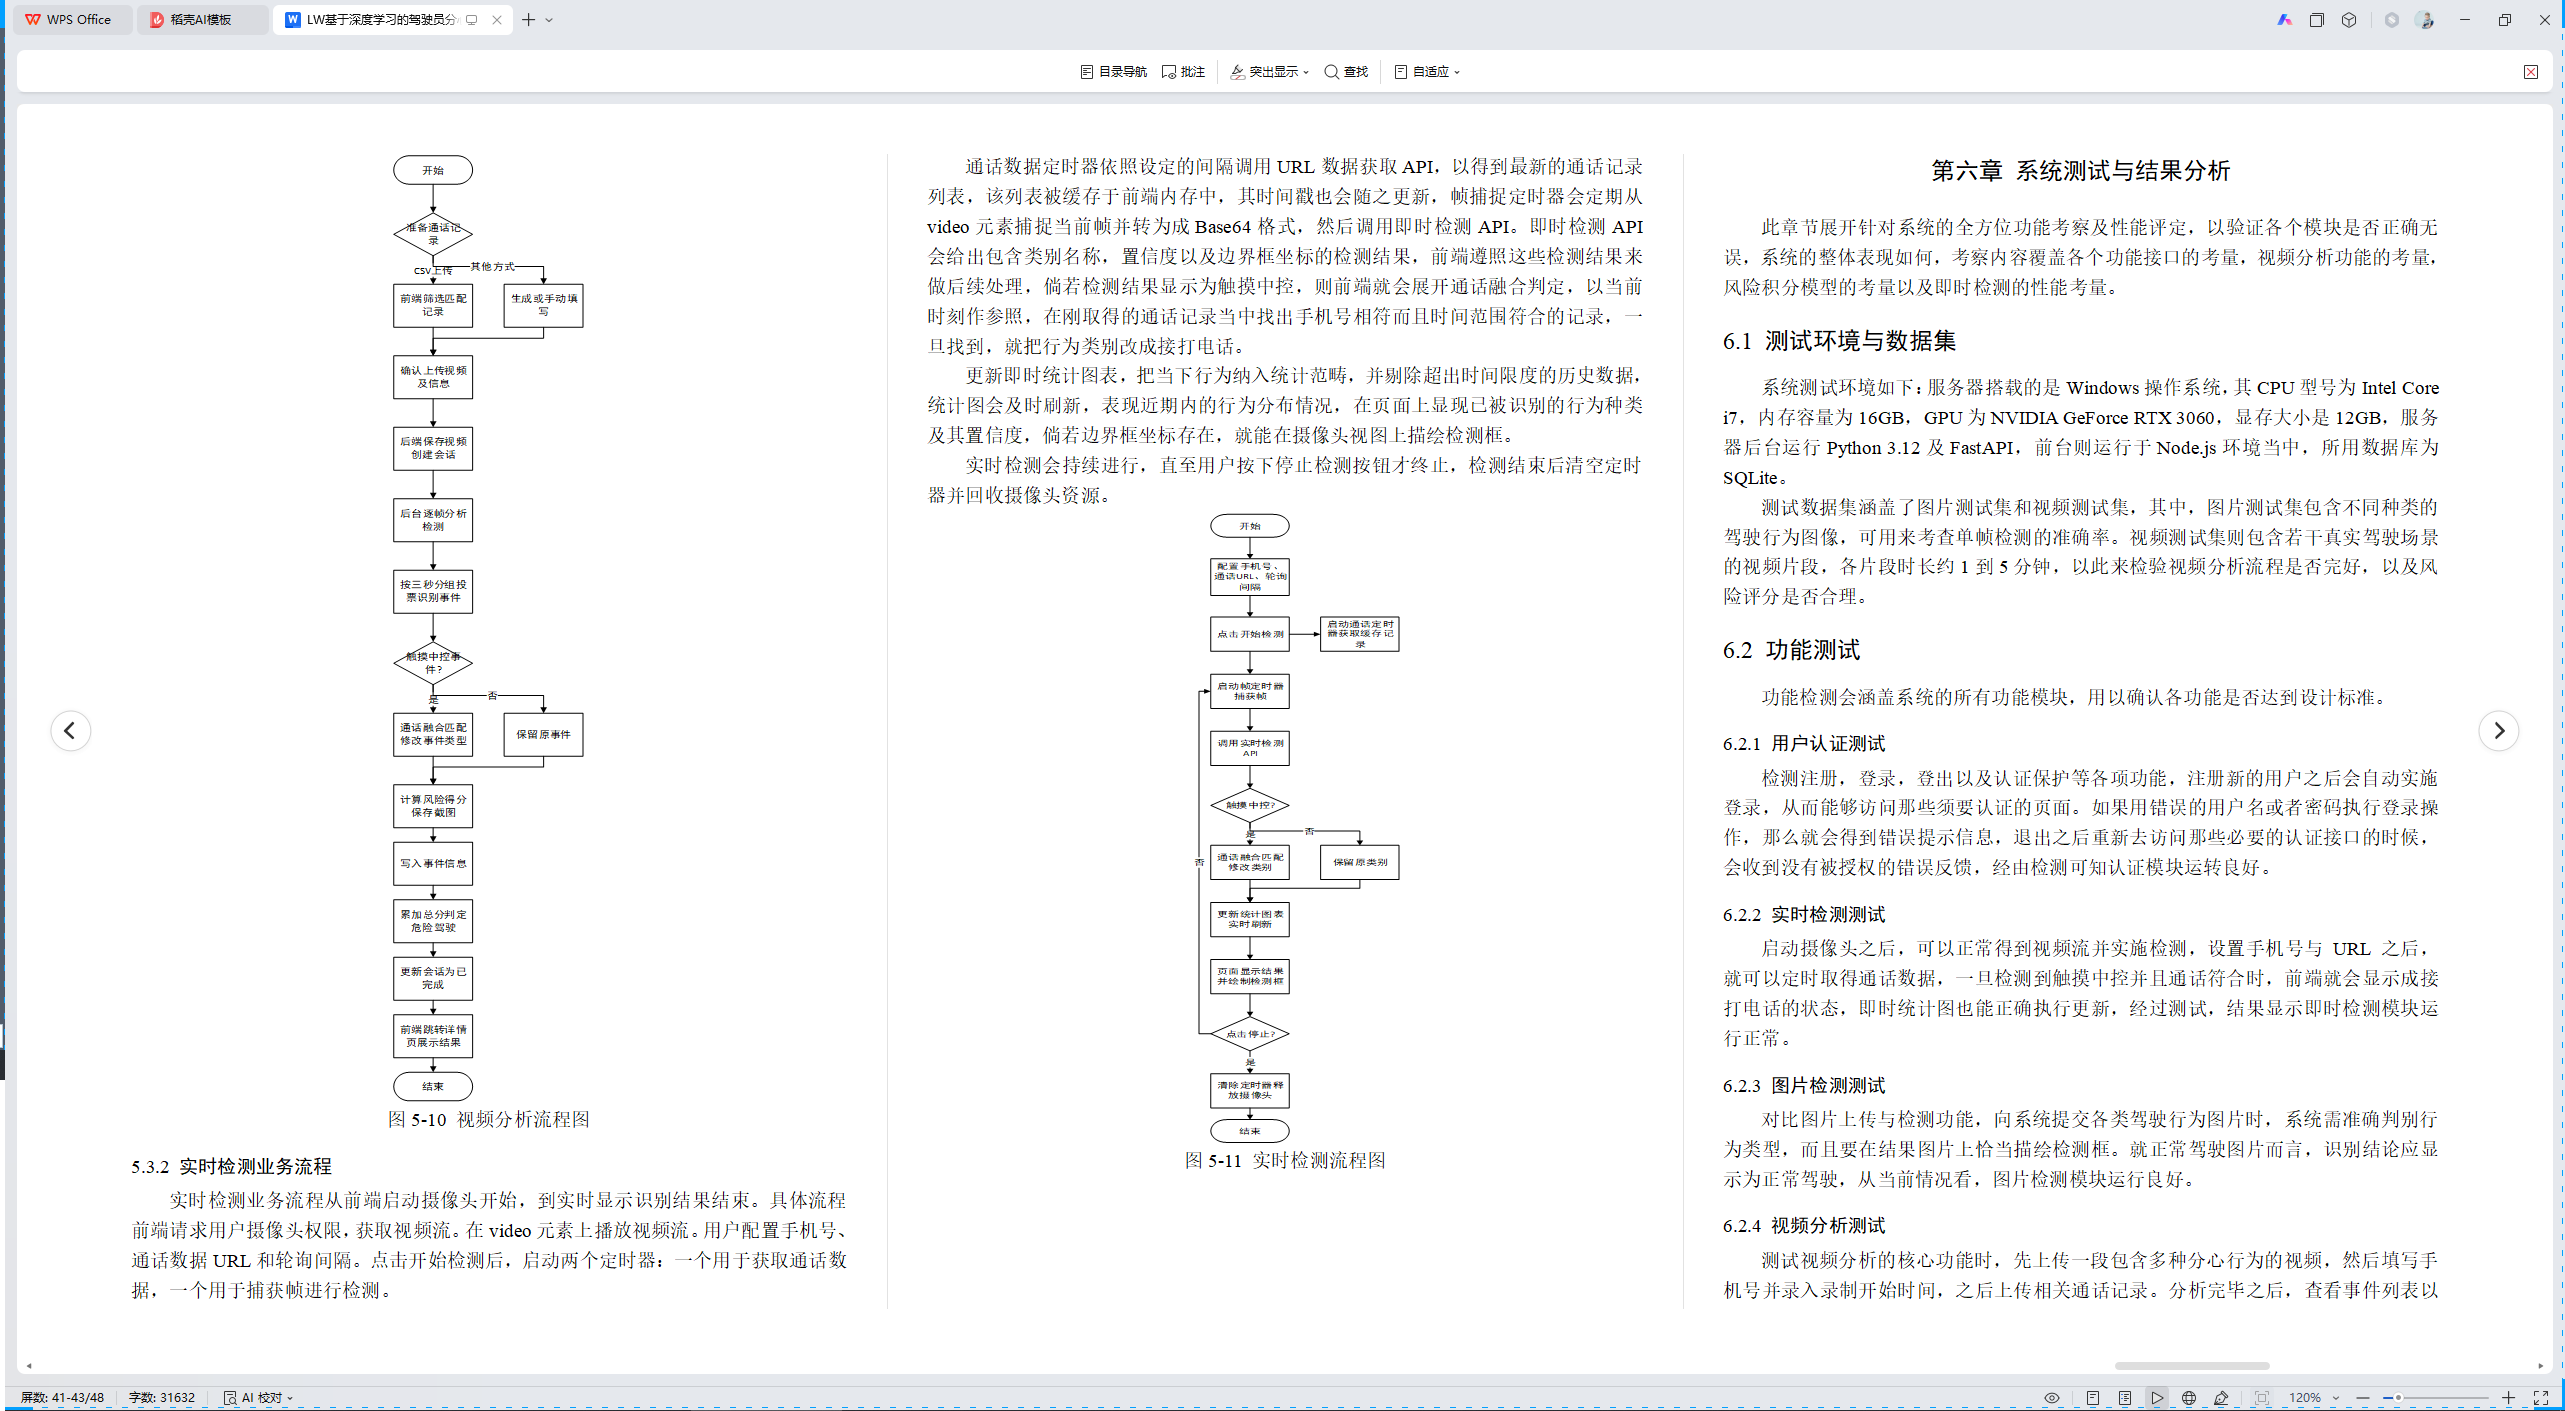
5.3.2 实时检测业务流程
实时检测业务流程从前端启动摄像头开始,到实时显示识别结果结束。具体流程前端请求用户摄像头权限,获取视频流。在video元素上播放视频流。用户配置手机号、通话数据URL和轮询间隔。点击开始检测后,启动两个定时器:一个用于获取通话数据,一个用于捕获帧进行检测。
通话数据定时器依照设定的间隔调用URL数据获取API,以得到最新的通话记录列表,该列表被缓存于前端内存中,其时间戳也会随之更新,帧捕捉定时器会定期从video元素捕捉当前帧并转为成Base64格式,然后调用即时检测API。即时检测API会给出包含类别名称,置信度以及边界框坐标的检测结果,前端遵照这些检测结果来做后续处理,倘若检测结果显示为触摸中控,则前端就会展开通话融合判定,以当前时刻作参照,在刚取得的通话记录当中找出手机号相符而且时间范围符合的记录,一旦找到,就把行为类别改成接打电话。
更新即时统计图表,把当下行为纳入统计范畴,并剔除超出时间限度的历史数据,统计图会及时刷新,表现近期内的行为分布情况,在页面上显现已被识别的行为种类及其置信度,倘若边界框坐标存在,就能在摄像头视图上描绘检测框。
实时检测会持续进行,直至用户按下停止检测按钮才终止,检测结束后清空定时器并回收摄像头资源。
图5-11 实时检测流程图
第六章 系统测试与结果分析
此章节展开针对系统的全方位功能考察及性能评定,以验证各个模块是否正确无误,系统的整体表现如何,考察内容覆盖各个功能接口的考量,视频分析功能的考量,风险积分模型的考量以及即时检测的性能考量。
6.1 测试环境与数据集
系统测试环境如下:服务器搭载的是Windows操作系统,其CPU型号为Intel Core i7,内存容量为16GB,GPU为NVIDIA GeForce RTX 3060,显存大小是12GB,服务器后台运行Python 3.12及FastAPI,前台则运行于Node.js环境当中,所用数据库为SQLite。
测试数据集涵盖了图片测试集和视频测试集,其中,图片测试集包含不同种类的驾驶行为图像,可用来考查单帧检测的准确率。视频测试集则包含若干真实驾驶场景的视频片段,各片段时长约1到5分钟,以此来检验视频分析流程是否完好,以及风险评分是否合理。
6.2 功能测试
功能检测会涵盖系统的所有功能模块,用以确认各功能是否达到设计标准。
6.2.1 用户认证测试
检测注册,登录,登出以及认证保护等各项功能,注册新的用户之后会自动实施登录,从而能够访问那些须要认证的页面。如果用错误的用户名或者密码执行登录操作,那么就会得到错误提示信息,退出之后重新去访问那些必要的认证接口的时候,会收到没有被授权的错误反馈,经由检测可知认证模块运转良好。
6.2.2 实时检测测试
启动摄像头之后,可以正常得到视频流并实施检测,设置手机号与 URL 之后,就可以定时取得通话数据,一旦检测到触摸中控并且通话符合时,前端就会显示成接打电话的状态,即时统计图也能正确执行更新,经过测试,结果显示即时检测模块运行正常。
6.2.3 图片检测测试
对比图片上传与检测功能,向系统提交各类驾驶行为图片时,系统需准确判别行为类型,而且要在结果图片上恰当描绘检测框。就正常驾驶图片而言,识别结论应显示为正常驾驶,从当前情况看,图片检测模块运行良好。
6.2.4 视频分析测试
测试视频分析的核心功能时,先上传一段包含多种分心行为的视频,然后填写手机号并录入录制开始时间,之后上传相关通话记录。分析完毕之后,查看事件列表以确认每个事件都被正确识别出来,特别是触摸中控事件,在经过与通话记录匹配之后,应当被转换成接打电话状态,其风险分数的计算需合理,危险驾驶的判断也要符合预期,如此,测试结果就能显示视频分析模块运行正常。
6.2.5 历史会话管理测试
测试历史会话的查看,导出和删除功能,可以正确显示全部会话并依照条件筛选执行,查看会话详情时会显示完整的事件列表及截图。导出为CSV文件时内容准确无误,包含关于会话或者事件的所有信息,删除会话之后,相关的事件记录以及文件会被清除,从检测结果来看,历史会话运作模块运行正常。
6.2.6 系统配置测试
考查系统的设置读取,修改以及模型切换功能,系统可以正确读取当下的设置并展现在页面之上,更改阈值和权重之后予以保存,新的设置将在下次视频分析时生效。上传新的模型权重之后,系统能够正确地切换并加载新模型,经过检测结果显示系统设置模块运行正常。
6.3 性能测试
性能测试主要关注实时检测的帧率和视频分析的处理速度。
6.3.1 实时检测性能测试
实时检测性能考察从捕捉帧开始直至返回检测结果为止的整个过程所历时延,在GPU环境当中,单帧检测均值时延大概为50毫秒,再考虑网络输送及前端加工因素之后,总的时延就在100毫秒左右,如此看来其大致符合即时检测的要求。
6.3.2 视频分析性能测试
视频分析性能检测会考量处理一分钟视频所要耗费的时间,在GPU环境下,处理完一分钟的视频大概必要15到20秒,处理速度大约为即时速度的3到4倍,针对时长大规模的视频,采取后台任务的异步处理方式,这不会影响用户执行其他的操作。
6.4 结果分析与讨论
对系统检测结果加以分析之后就可知,依靠YOLOv8创建起来的驾驶行为检测模型在测试集当中有着较好的识别能力,它可以精准识别出十种驾驶行为,给后续的风险评定赋予了可信的输入。三秒分析阶段同多数投票规则有效地减小了单帧误检给事件确认带来的影响,加强了事件提取的准确性,视觉与通话记录相融合的算法把部分触摸中控事件转变成了接打电话事件,很好地解决了两种行为很难从视觉上区分开来的情况,从而改善了特定场景下识别的准确性,风险积分模型能够较为合理地体现各类别行为之间的风险差别,而且会遵照行为的连续性和反复性来做动态调节,最终作出的危险驾驶判断同人工评价结果相差无几。 系统总体的响应速度符合实际使用的需要,即时检测能够顺畅运行,视频分析也能在可接受的时间范围内完成。