先提前叠个甲 :本人6年开发,分享文章仅是我个人心得,就当看个乐呵。
RAG 的基础流程 5.5 讲过了,这篇讲它怎么一代代长出来、每一代解决了什么问题。
结论先给:主干就三代 ,Naive、Advanced、Modular。网上流传的"五代""三种架构"数的是另外两个维度,混着数一定打架。丑话说前面,RAG 2.0、3.0、Better RAG、Systemic RAG 都是社区叫法,没有一个是官方版本号。
一、演进地图:RAG 到底几代
先看一张流传很广的图。
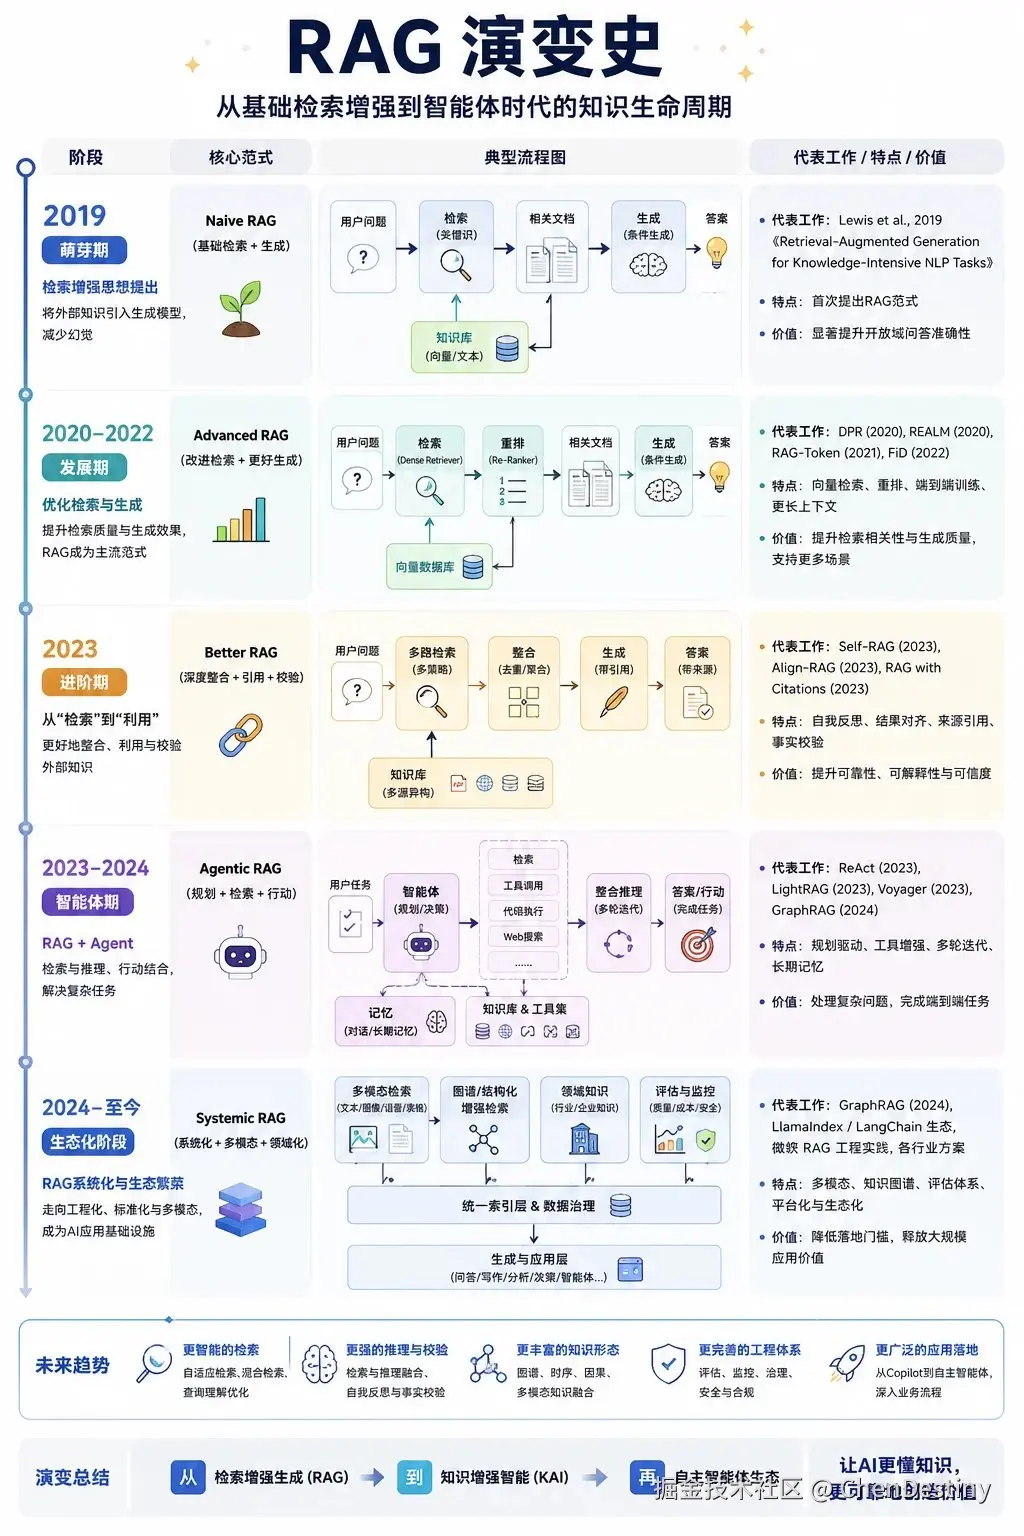
它按时间线把 RAG 分成五代:2019 Naive、2020-2022 Advanced、2023 Better、2023-2024 Agentic、2024 至今 Systemic。思路是对的,但有两处得纠正。
一是 Better RAG、Systemic RAG 不是标准术语,论文里翻不到这两个词,是社区为了讲演进自己起的名字。二是图里把 Lewis 那篇标成 2019,实际是 2020(arXiv:2005.11401,NeurIPS 2020)。
问题不在图,在"代"这个词被混用了。常见的三张图,其实在数三个不同的维度:
| 维度 | 数的是什么 | 典型说法 |
|---|---|---|
| 时间线 | 行业热点怎么变 | 五代:Naive / Advanced / Better / Agentic / Systemic |
| 学术范式 | 架构范式怎么演进 | 三代:Naive / Advanced / Modular(Gao et al., 2023, arXiv:2312.10997) |
| 知识表示 | 检索底座换成什么 | 三类:经典 / Graph / Agentic |
三条里只有"学术范式"这一条有明确出处。Gao 那篇综述把 RAG 划成 Naive、Advanced、Modular 三个范式,是目前最可引用的口径。另外两条都是社区归纳。
所以我的口径是:主干走学术三代,其余下沉为分支。
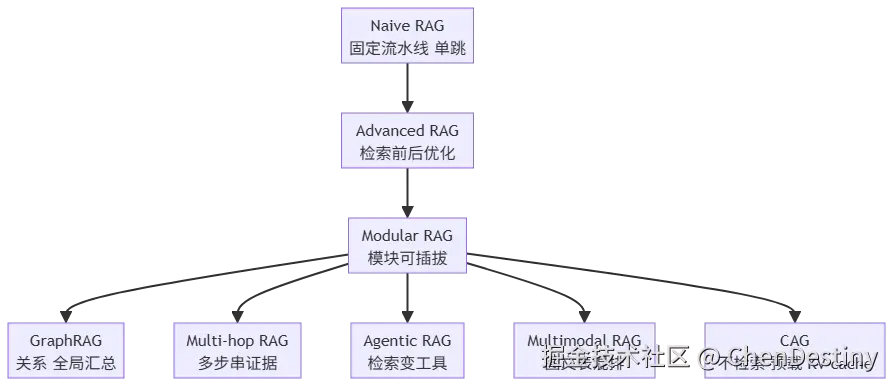
这张图一句话解释:前三代是主干,Graph、Multi-hop、Agentic、Multimodal 都是 Modular 这一代里的模块。Modular 的定义本来就是"可插拔组合",把它们单独称代反而站不住。CAG 挂在末尾但画成另一支,因为它压根不检索,是"要不要 RAG"的另一种答案。
二、Naive RAG:把 RAG 从零搭起来的那一代
先说定位。切块、向量化、存库、Top-K 召回、拼上下文、生成,这套流程就是 Naive RAG,它是这一代的全部,也是后面所有演进的地基。
流水线固定得像一条产线:
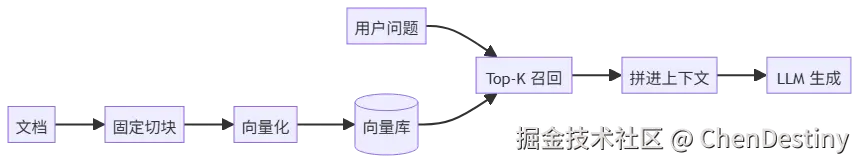
它解决了什么:从无到有。在它之前,模型只能靠训练时记下的东西答题,私域知识一问三不知,还爱编。Naive RAG 第一次让"模型照着资料说话"变成工程上能落地的事。
它没解决什么,三个天花板,后面每一代基本都在补这三个:
(1)关系丢了 。文档里反复出现"公司 A 投资了公司 B,公司 B 收购了项目 C",一打散切块,这层关系就糊了,回答不了"A 的投资版图里有没有 C"这类全局问题。
(2)Top-K 是拍脑袋定的 。top_k 设 3 还是 5 全凭经验,不看问题难易。
(3)检索是死的。模型还没看懂问题,系统已经把检索做完了,捞回来的该不该捞,没人管。
【我的踩坑】 我第一版就是纯 Naive,top_k 凭感觉设了 3。有个问题要跨三份文档才答得全,它永远只能捞到其中一段,答案一直缺一块。后来加了重排和混合检索才补上,那时候已经进到下一代了。
三、Advanced RAG:在 Naive 上加三处工程化
Advanced RAG 最容易被误读成"换了套架构"。没有。它的流水线和 Naive 一模一样,只是在三个位置各补了一处工程化。
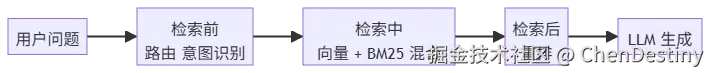
三处分别是:
(1)检索前加路由。按问题意图决定走哪个库、用哪种检索方式,说白了就是意图识别。这块应用很广,多库、多业务线的场景基本都绕不开。
(2)检索中加 BM25。纯向量的老毛病是关键词强、语义弱的查询会挂,加一路 BM25 混合召回兜底 ,两路结果再用 RRF 融合。
(3)检索后加重排。粗召回捞回来一堆,上 Reranker 做二阶段精排,把最相关的顶进 Top-N。这一处现在已经是 RAG 的必备项,不是可选项。
实现细节这里不重复。这一代真正的贡献,是把"召回"从一次打分变成了一串工序,精度和召回都明显好过 Naive。DPR、REALM、FiD 这批工作就是往这个方向铺路的。
但它有个根子没动:检索依然发生在模型理解任务之前。系统先按固定流程捞一批,再交给模型,捞错了模型也只能硬着头皮答。这个根子要等第三代才动。
四、Modular RAG:从流水线到可插拔模块
到这一代,RAG 不再是一条固定流水线,而是一堆能按任务拼装的模块。这也是 GraphRAG、Agentic RAG 这些名字层出不穷的原因:它们不是新的一代,是这一代里换了个模块。
挑四条主线说。
4.1 GraphRAG:把"关系"还给检索
先说人话:传统检索像按关键词搜书,你搜"苹果",它给你一堆提到"苹果"/"水果"的文章;GraphRAG 像顺着关系网找人,搜"苹果"时把跟它有关的"乔布斯"/"库克"也一起带出来。
它补的是 Naive 的第一个天花板。Naive 只看字面相似度,文档里写的是"公司 A 是公司 B 的大股东",没出现"投资"两个字,你问"公司 A 投了谁",它就找不到这条线索。GraphRAG 提前用大模型把文档里的实体和关系抽出来,建成一张知识图谱,检索时顺着图谱"走"到相邻节点,A 到 B 本来就有边,顺着走就命中。
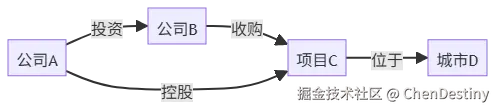
微软那篇 GraphRAG(Edge et al., 2024, arXiv:2404.16130)是这个思路的旗号。KWeaver 这个企业级 agent 项目里有个更完整的生产版。
它的图谱比论文里多两层。普通图谱只存"公司 A 投资了公司 B"这种点线关系;KWeaver 在每条关系上又挂了风险 和动作,这条关系有什么隐患("投资比例过高")、发现隐患该干什么("发预警")。说白了,普通图谱回答"谁认识谁",它回答"谁对谁做了什么、有什么后果、该谁处理"。这四层合起来叫 ORMKR 四元组,整个知识底座叫 BKN(业务知识网络)。
检索时它不捞文本块,而是查"对象"。拿一道真题走一遍:"2023 年投资额超过 1 亿、而且有风险的公司有哪些?"一半是硬条件(年份、金额),一半是软描述("有风险"),一条路走不通。
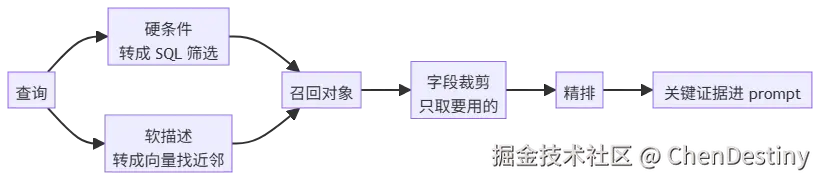
两种条件不是查两遍再拼,而是写在同一个查询里:结构化的生成 SQL 的 where 子句,语义的把"有风险"向量化、生成一个找近邻的子句,挂进同一棵条件树一起下发。为什么非得合在一起?只用结构化条件,"有风险"写不出来;只用向量,"投资额 > 1 亿"又会被相似度带偏。
两个细节值得记:权限在查询构造期就织进去了 ,不能看的字段压根不写进查询条件,从源头取不到;结果写回对象,agent 干完活不是追加一段新文本,而是落回对应对象上,出了错能回溯到是哪条对象、哪次操作带来的。
但它不是银弹。关系密集、需要"顺藤摸瓜"式推理的场景(财报持股、产业链、论文引用链、审批流)才值得上;纯 FAQ、知识点彼此独立的文档,普通向量检索更便宜。别一上来就上图谱:建图要 LLM 批量抽取(贵)、图要维护、还得防抽取幻觉污染图谱。KWeaver 敢这么做,是因为它面向的就是高价值企业决策场景,成本摊得回来。
4.2 Multi-hop RAG:一次查不够,就串着查
补的是"一个问题要跨好几段材料才答得全"的场景。做法是把问题拆成子问题链,第一跳的结果喂给第二跳,一步步逼近答案。它和 GraphRAG 的区别在走法:GraphRAG 靠图谱结构走,Multi-hop 靠问题分解走,不一定要建图。
代价是误差会累积。第一跳捞偏了,后面几跳都跟着偏,所以每一跳之后的验证不能省。
4.3 Agentic RAG:把检索变成模型手里的工具
它补的是 Naive 的第三个天花板。说白了,这一支就是把 RAG 从 workflow 变成 agent loop:路径不再由工程师写死,改由模型运行时决定。检索不再是前置步骤,而是循环里可以反复调用的工具,模型自己决定要不要检索、检索什么、结果够不够、要不要再来一轮。
学术上有两个坐标:Self-RAG (Asai et al., 2023, arXiv:2310.11511)让模型自己反思"要不要检索、结果靠不靠谱、答案有没有被支撑";CRAG(Yan et al., 2024, arXiv:2401.15884)在检索后加一道质量评估,发现检索垃圾就触发纠错,改写 query 或换数据源。工程上的实现,基本是这两类思路加 ReAct 循环(Yao et al., arXiv:2210.03629)的合流。
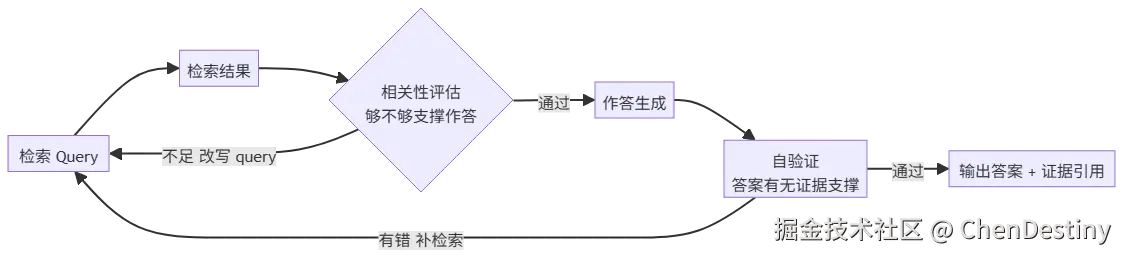
【我的实践结论】 问答场景加了"评估-重写"这一环后,幻觉明显少了,代价是延迟和 token 成本都上去了。所以它适合对准确度要求高、能接受慢一点的场景,不适合实时高并发。工程细节放到下一篇展开。
4.4 Multimodal RAG:图文表一起检
补的是数据形态的天花板。前面几代默认知识都是文本,但真实文档里表格、图表、扫描件占了一大块。做法是把图片、表格也编码进同一个向量空间,或者让模型直接读版面,检索时文本和图像一起召回。
这一支我没在生产里跑过,只讲机制,不装作有经验。
五、岔路:CAG,长窗口够用就不检索
前面四支都在"怎么把检索做得更好"里打转。CAG 换了个问法:能不能不检索。
CAG(Cache-Augmented Generation,arXiv:2412.15605)的做法是,知识集不大的时候干脆把它全塞进模型上下文,预先把 KV cache 算好存起来,查询时直接复用缓存,跳过检索这一步。
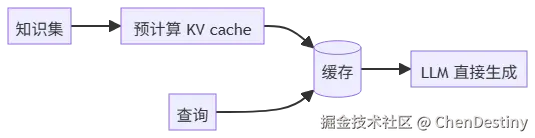
它的适用边界很窄:知识集要能一次性塞进窗口,而且要相对稳定。但它提醒了一件事:RAG 不是唯一解,检索是有成本的,当窗口大到能装下全部知识时,不检索反而更快更准。
六、未来:决定权在谁手里
回头看这三代,主线其实只有一条:检索的决定权,从工程师手里一步步交到模型手里。
- Naive:检索流程写死在代码里;
- Advanced:流程照样写死,只是每一环调优;
- Modular:流程可拼装,检索方式开始按任务选;
- 再往前,就是模型自己规划检索路径,检索变成推理过程中随时能调用的工具。
行业里把这条趋势叫"从检索增强生成(RAG)到知识增强智能(KAI)"。叫法不重要,看决定权在谁手里。
小结
三句话收:
(1)RAG 主干三代,Naive、Advanced、Modular,这是唯一有出处的口径;Graph、Agentic、Multimodal 是第三代的模块,不是新的代。
(2)每一代都在补前一代的天花板:Naive 补"从无到有",Advanced 补精度和召回,Modular 补"检索方式得跟着任务变"。
(3)CAG 是岔路,提醒你检索不是免费的。
选型、Agent 冲击、工程化落地这些放到下一篇讲。这一篇只干一件事:把地图画清楚。