CLIP 图文对齐:先核对正样本,再相信检索分数
开源 AI 论文复现实验与代码解读 · 第五轮 / 071
面向研究生、科研新人和工程型研究者;检索与实验日期:2026-09-12。
目录
- 复现价值:确定要验证的命题
- 核心思想与公式
- 官方代码阅读路线
- 最小实验与实际结果
- 评测协议:相关集合比行号重要
- 失败排查与证据边界
- 后续科研问题
- 总结与参考资料
复现价值:确定要验证的命题
CLIP 是对比式语言图像预训练:两个编码器分别处理图片和文本,将两种输入映射到可比较的表示空间。Radford、Kim 等人在 ICML 2021 发表原论文,研究大规模图文监督能否支持迁移。这里的"论文报告"只用于界定研究背景,不把论文中的自然图像表现当成本次结果。论文出版页
本次验证的命题更窄:对齐损失能否学到给定配对关系,以及评测能否区分"关系学对"和"行号对上"。小模型的价值在于可以保存每次输入、梯度和排名,排除下载权重、显卡和分布式训练的干扰。代价同样明确:简单颜色形状任务无法证明自然语言理解、开放词汇迁移或真实图像鲁棒性。
核心思想与公式
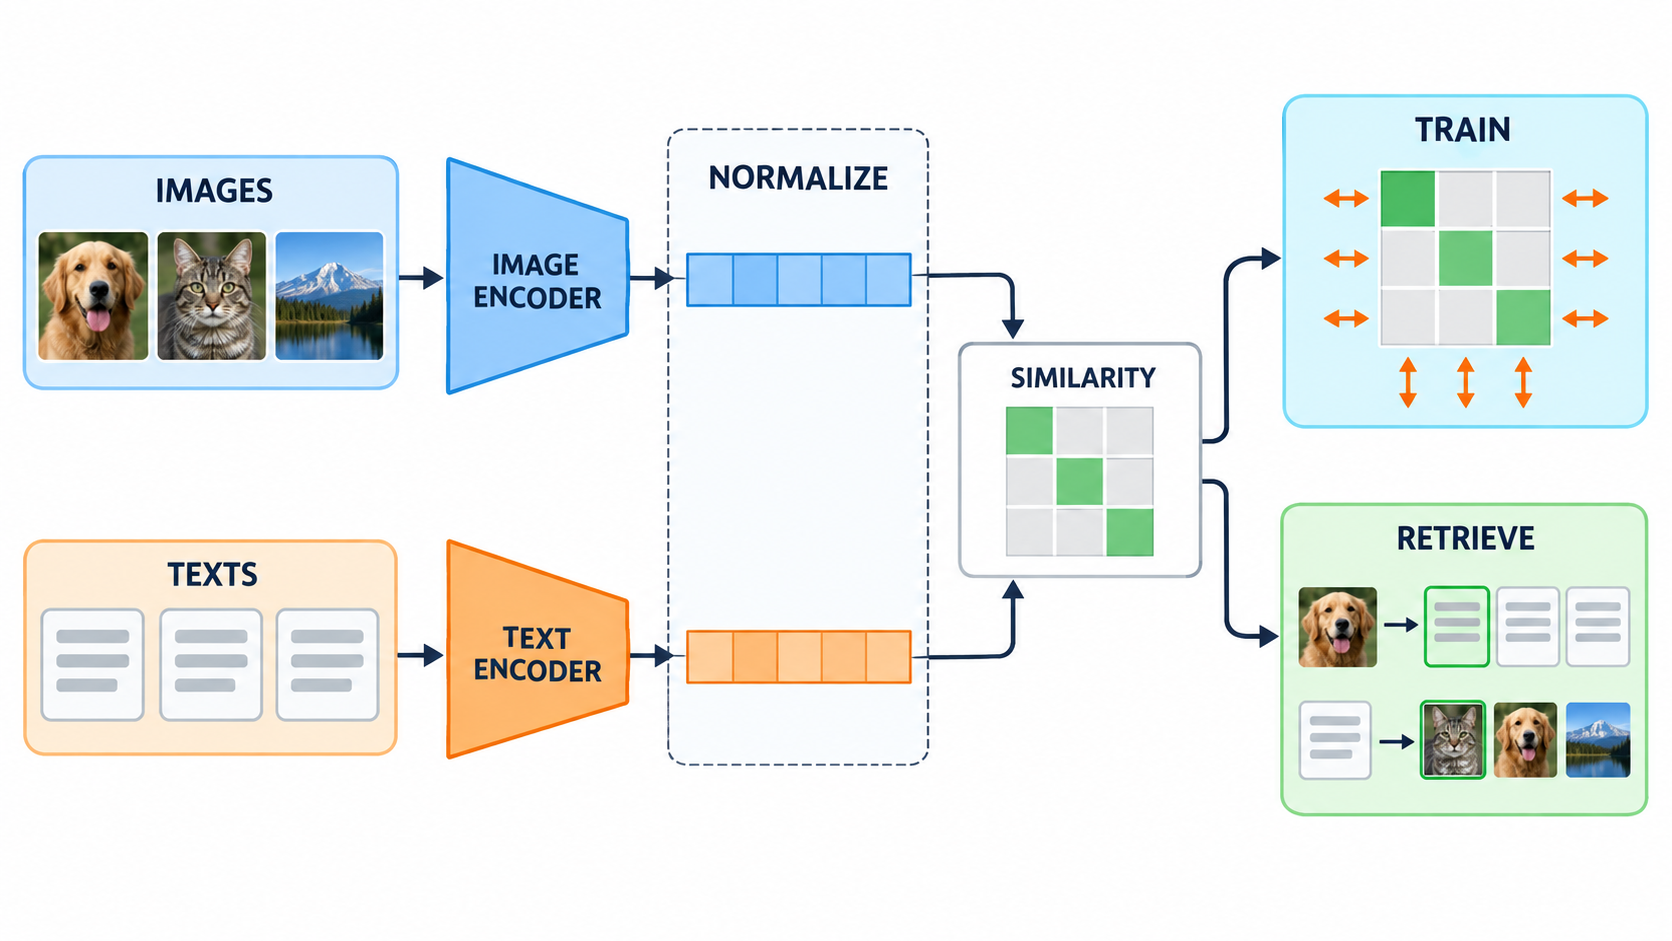
图中两条通道保持独立,在相似度矩阵处比较。训练和检索是使用矩阵的两种方式;绿色对角线示意单配对批次,不表示所有数据都只有一个正样本。
记投影后的图片表示为 u i u_i ui,文本表示为 v j v_j vj,则
KaTeX parse error: Can't use function '' in math mode at position 71: ...uad S_{ij}=\\exp̲a$\hat u_i^\top...
每个向量有 d d d 个分量;一批 B B B 对输入产生两个 B × d B\times d B×d 矩阵及一个 B × B B\times B B×B 分数矩阵。归一化去掉长度影响,点积成为余弦相似度; a a a 是对数尺度,常写成温度倒数的对数。尺度改变分布尖锐度。
在第 i i i 张图仅与第 i i i 条文本配对时,对称目标可写为
L = − 1 2 B ∑ i log e S i i ∑ j e S i j + log e S i i ∑ j e S j i . L=-\frac{1}{2B}\sum_i\left \\log\\frac{e\^{S_{ii}}}{\\sum_j e\^{S_{ij}}} +\\log\\frac{e\^{S_{ii}}}{\\sum_j e\^{S_{ji}}}\\right. L=−2B1i∑log∑jeSijeSii+log∑jeSjieSii.
第一项逐行找文本,第二项逐列找图片,各占一半;同批其他条目充当负样本。这对应原论文图三的核心计算。论文正文
作者推断:如果两条描述完全相同,强行只奖励其中一个行号,就把另一个语义正样本当成竞争者。因此首先需要检查数据标注是否支持这个目标,再讨论更大批次是否带来收益。相似度高只说明模型在这个表示空间里更偏好该候选,不能独立证明描述中的数量、关系和属性都正确。
官方代码阅读路线
从 OpenAI 的 CLIP 仓库进入,先对照接口输入输出,再深入网络。仓库提供模型和预处理加载接口,不能把成功运行推理示例等同于重跑了原始预训练。以下属于本次实际静态核对,未执行官方模型。
第一站是 clip.py:load 同时返回模型与预处理。图像要经过指定缩放、中心裁剪、RGB 转换及通道标准化;tokenize 默认长度为 77,超长输入默认报错,可显式选择截断。自己换一套裁剪而沿用同名权重,会改变实验条件。
第二站是 model.py:追踪 encode_image、encode_text 到 forward。文本取结束标记位置的表示后投影;两个独立编码接口返回的特征还需要归一化,完整前向才计算带指数尺度的点积及其转置。手动调用编码器时漏掉这一步,是可定位的实现偏差。
第三站看社区 OpenCLIP 的固定版本 v2.32.0 ClipLoss。它不是原作者完整训练脚本,但可核对双向交叉熵,以及多卡局部损失中的标签偏移和特征收集。把全局负样本改为局部批次,会改变训练问题,不能只比较代码能否运行。
本次 OpenAI 源码读取的是当日 main,未固定提交;获取提交号的网络请求失败。后续复现实验应补记提交哈希、权重校验值、依赖和数据版本。动态源码是否变化、官方完整运行结果均为"待人工核验"。
最小实验与实际结果
代码在 minimal_clip.py,环境和完整协议见 依赖说明。实际使用 Python 3.12.14、NumPy 2.3.5 和 CPU 双精度运行,不依赖 PyTorch。实验直接生成十六乘十六的 RGB 数组:红绿蓝三色与方块、十字、圆环组合为九类,再随机改变中心、亮度和背景噪声;没有使用预训练图像特征。
每个种子生成一百零八张训练图、四十五张测试图,分别每类十二张和五张。文本是九条两词描述,用六维词袋表示,即每一维指示一个颜色或形状词是否出现。图片展平成七百六十八维;两侧各用无偏置线性映射投影到十六维,共一万二千三百八十四个参数。
每批九张图、每类一张,避免训练批次重复描述。固定四百步、Adam 学习率 0.01、尺度十,不学习原模型的温度。三个种子为 71、72、73,同时改变数据扰动、初始化及抽样;训练步数预先固定,不通过测试分数挑选检查点。正常配对和循环错配两组共享初始化与图像批次。
在代码目录执行:
bash
python -m pip install -r requirements.txt
python -m py_compile minimal_clip.py audit_results.py
python minimal_clip.py
python audit_results.py
安装命令供读者使用;本次复用已有运行环境。脚本打印训练像素、文本、嵌入和分数形状,并保存数据、权重、每步 loss 与完整测试矩阵。
下表全部是本次合成任务实测,单位为百分比,报告三个种子的均值与样本标准差;不是置信区间,也不是原论文复现分数。
| 实验条件 | 图搜文 Hit@1 | 文搜图 Hit@1 |
|---|---|---|
| 未训练初始化 | 2.96 ± 1.28 | 11.11 ± 11.11 |
| 正常图文配对 | 88.89 ± 6.67 | 100.00 ± 0.00 |
| 固定循环错配 | 1.48 ± 2.57 | 0.00 ± 0.00 |
种子七十一的正常组末批 loss 为 0.003447,错配组为 0.003498,几乎一样低。这是故意构造的反例:优化器可以认真学会错误的数据关联。因此"loss 下降"只说明拟合了指定训练目标,不能代替独立语义标签评测。实际日志
评测协议:相关集合比行号重要
图搜文使用四十五张测试图查询九条描述,每图一个相关候选;文搜图使用九条描述查询四十五张图,每条描述有五张相关图。两边均搜索完整测试图库,不用一个小批次的排名冒充完整检索。匹配依据是颜色形状组合,候选同分时按原始索引升序,协议在计算之前固定。
H i t @ k = 1 Q ∑ q 1 A q k ∩ R q ≠ ∅ , R e c a l l r e l @ k = 1 Q ∑ q ∣ A q k ∩ R q ∣ ∣ R q ∣ . \mathrm{Hit@}k=\frac1Q\sum_q\mathbf1A_q\^k\\cap R_q\\ne\\varnothing,\qquad \mathrm{Recall}_{rel}@k=\frac1Q\sum_q\frac{|A_q^k\cap R_q|}{|R_q|}. Hit@k=Q1q∑1Aqk∩Rq=∅,Recallrel@k=Q1q∑∣Rq∣∣Aqk∩Rq∣.
这里 Q Q Q 是查询数, A q k A_q^k Aqk 是前 (k) 项, R q R_q Rq 是全部相关项集合。前者问"有没有找到一个",后者问"找回了多少相关项"。本文显式分开命名,避免只写含义不明的 R@K。文搜图首位正确时,Hit@1 是一,相关项召回只有五分之一;同一次实验的两个值都正确。
另一个确定性检查建立九组、每组三个完全等价成员的理想相似度矩阵。语义首位命中为一,若误用行号作唯一答案则为三分之一。尺度十时,对角交叉熵为 1.098975;将所有同组正样本概率相加再取负对数为 0.000363,相差恰为 ln(3)。这是代数诊断,不是多正样本训练方案优于原目标的实验证据。
同时记录首个相关结果倒数排名的均值 MRR,以及前一、三、五项的两种指标。扩大图库会改变任务难度,增加重复项会改变概率分母;只有查询、候选集合和相关性标注一致的分数才适合直接比较。
失败排查与证据边界
本次独立审计未导入训练函数,而从保存权重用标量乘加重建三千六百四十五个余弦值,复算四百八十六个查询的排名。与保存矩阵最大差为 1.22e-15;三十二个小型检查参数的数值梯度最大误差为 1.29e-9。训练测试像素哈希无交集,语法、烟雾测试和结果审计均通过。审计记录
正常组共十五次图搜文首位错误,全部是颜色相同、形状不同。作者推断是颜色信息较易保留,平移后的轮廓较难由线性映射稳定区分;这还不是因果结论。要验证原因,应分别固定位置、去除颜色或换用卷积编码器,并保留相同测试协议。
排查顺序可以从输入开始:先看裁剪是否移除了对象、描述是否被截断,再查归一化与标签置换,最后检查负样本和图库。给全部分数乘同一个正尺度,在嵌入和候选固定时不会改变排序,所以单改推理温度不能修复这些排序错误;训练中改变温度会改变梯度,是另一个实验。
数据哈希不重复只排除了完全相同的像素。本实验训练与测试共享九种组合,不能声称未见概念泛化。原版 CLIP 的模型卡还指出计数、细粒度识别及语言范围等限制;英文合成描述的成功,不能外推为中文检索有效。官方权重、真实数据集、多卡训练、显存和延迟均未测试,待人工核验。
后续科研问题
第一个问题是正样本如何定义。可在人工标注的一图多文集合中比较单配对、批次去重和多正样本目标,同时核对近义描述是否遗漏关键属性。若把"红色物体"与"红色方块"粗暴视作完全等价,也可能掩盖形状识别错误。
第二个问题是组合泛化。预先留出某些颜色形状组合,保证训练时每个单独属性仍出现,再与当前同类新样本测试分开报告。这样能检验模型是否重组属性,而不是只辨认熟悉的九个类别。
第三个问题是困难负样本是否有效。加入同色不同形或同形不同色的候选,先统计错误类型,再比较方法增益与方差;固定图库并保留人工裁定,避免"难负样本"其实是漏标正样本。以上都是研究计划,本次没有执行或预告数值收益。
总结
复现 CLIP 的第一步,是把编码、归一化、配对和检索评测接成可检查的链条。本次最小实验验证了目标函数和排名协议,也暴露出低损失、错误配对和多正样本之间的关系。读者下一步应先复算保存的矩阵,再更换编码器或真实数据;每扩大一层实验范围,就重新说明证据能支持什么。
参考资料
以下一手链接均于 2026-09-12 实际打开,题名、作者或维护主体及版本已核对。
- Alec Radford、Jong Wook Kim 等十二位作者,2021,Learning Transferable Visual Models From Natural Language Supervision,ICML / PMLR 139:8748--8763;出版正文 PDF,用于双向目标及研究背景。
- OpenAI,CLIP 官方仓库,当日 main;clip.py 与 model.py,用于预处理、编码与相似度路径。提交号未固定,待人工核验。
- ML Foundations / OpenCLIP 贡献者,ClipLoss 实现,固定 v2.32.0 标签,社区实现;用于损失和多卡标签阅读。
- OpenAI,CLIP Model Card,当日 main,模型日期标注 2021 年 1 月、含后续发布记录;用于能力与数据开放边界。