还记得AI刚出来的时候,大家用 AI 基本都是同一个姿势,人打开网页或应用,字斟句酌地敲下一段提示词,AI再给出回答,交互便告一段落。
但其实很多事情根本不是一问一答就能解决的。比如盯着某个开源项目的代码更新、排查一个藏得很深的安全漏洞、或者连续几天跟踪某项技术的发展。这类事情线索长、变动多,需要人一直盯着。如果每一次都要人去重新提问、把前因后果再讲一遍,这工具还不如不用呢。
最近大家讨论比较多的 Grok Bot 以及常驻型助手,就不同了,系统不再只是坐在屏幕对面等我们打字,而是转到后台一直待命,有事情发生就自己先去处理,这样的 AI 才是好 AI。
Grok Bot 是什么东西
马斯克家的 xAI 最新发布的Grok Bot,是另一个OpenClaw 吗?
普通对话工具很像对讲机,按一下说一句,松开手就断了,聊完这段,刚才的内容很快就被系统清空。Grok Bot就不同了,他就像我们牛马,on call 24小时的那种。它用的是 xAI 的 Grok-2 模型,底层一直连着网络数据,不仅能一直在线,还能自己去翻资料、跑程序,最后把做好的结果交出来。
直接连着实时消息
很多工具想查网上的新消息,得去搜索引擎里慢慢翻网页,经常只能翻到好几天前的内容。这套系统直接接入了社交网络和公开平台的数据通道,网上刚发出来的新讨论、刚提交的新代码,它几乎马上就能看到。
自己去调外部工具
有些任务光靠嘴说没用,得动手算或者查数据库。模型学会了看懂代码指令,遇到需要算数或者查表格的事情,它会自己写出规范的请求,把外部的工具叫起来帮它干活,不用人中间倒手。
交代完事情就能走开
使用者可以给它安排一个需要盯很久的事情,比如盯着某个软件库一整天。这期间不需要有人在旁边守着屏幕,系统在后台自己忙活,只有查到了重要动静,或者把事情办完了,才会给使用者发一条总结通知。
它在后台到底是怎样干活的
如果让一个工具一直挂在后台,它到底是怎么一步一步把事情做完的?其实主要靠三个动作互相配合。
有动静才处理,不再傻傻定时刷新
早期的自动脚本很笨,不管有没有新情况,每隔几分钟就去刷新一次网页。这种做法既浪费电,又很占网络资源,而且刷新慢了还会漏掉事情。
这套系统改成了事件触发。平时网上的海量闲聊会被外层的过滤规则直接挡掉,系统安安静静地待着。只有当某个话题的讨论热度突然升高,或者出现了提前设定的关键词,背后的推理模块才会真正被叫醒。这样既保证了灵敏,又不会白白烧钱。
既能记住眼前的事,也能翻出以前的旧账
大家用 AI 最怕它记性不好,聊着聊着就忘了前面的话。
常驻系统把记忆分成了两层。眼前正在办的事情、刚查到的临时数据,放在快速读取的临时区,方便随时拿来用。以前聊过的习惯、处理过的案例,会被总结成一条条短小的笔记存进数据库。哪怕过了两三个月,又碰到了类似的事情,它还能把当时的笔记翻出来参考,处理起来前后的风格就能保持一致。
代码报错了自己改,不用人盯着
以前的工具给出一段有 Bug 的代码,跑不通就直接报错卡住,只能等人工去看报错日志再重新问一遍。
在配套的独立运行盒子里,系统可以自己把生成的代码跑一遍试试看。如果发现少装了某个组件,或者语法写错了,它不会直接把错误扔给使用者,而是把报错信息自己看一遍,换个写法再试一次。自己改对了,再把最终可用的结果拿出来。
从帮忙补全句子,到直接接管操作环境
不少程序员在对比 Cursor 的后台功能和 Grok Bot,其实这两者的方向是一样的。
大家用辅助工具写代码,经历过三个阶段。
最初是行内提示,敲两个字母,屏幕上灰色的字跳出来补全剩下的半截,人一刻也不能分心。
后来变成了侧边栏聊天,遇到看不懂的报错,把日志复制过去问它,等它吐出修改方案,人再手动复制回文件里,人成了搬运工。
现在走到的新阶段,是系统自己去看整个文件夹。它可以自己查看终端命令行,看懂版本修改记录,甚至自己建一个新的分支把测试跑一遍。
Grok Bot 也是同样的道理。它不再只是浏览器里的一个网页标签,而是变成了一个有独立工作环境的助手。它直接在属于它的小空间里把收集、分析、测试全套做完,不需要人在中间一段一段地搬运文字。
Grok Bot vs OpenClaw,有什么不一样
聊到二十四小时挂在后台干活的助手,很多关注开源项目的朋友会联想到前阵子很火的 OpenClaw。这两个东西经常被放在一起讨论,因为大家初看都会觉得:它们不都是不用等回复、自己跑后台的智能体吗?
两者的设计理念确实很像,都想把人从聊天框里拽出来。但在具体路线和拿手绝活上,它们完全不是一回事。
谁是官方成品,谁是自己动手的开源框架
Grok Bot 是 xAI 官方打造的商业产品。它的大脑是固定的,由 xAI 自家的 Grok-2 系列模型直接驱动,整套服务跑在官方的云端集群里,开箱即用。
OpenClaw 则是开源社区里的项目。它本身并不是一个大语言模型,而是一套完整的管家骨架。使用者把它下载下来部署在自己的设备或服务器上,大脑部分可以自由选配,既能插 OpenAI、Claude 的接口,也能连开源模型。一个是直接给你一辆组装好的整车,另一个是给你一套动力底盘,发动机装谁家的由自己挑。
全网情报雷达对比私人生活管家
两者的业务长项截然不同。
Grok Bot 的拿手本领是抓取全网最新情报。依托社交网络 X 的实时数据通道,它就像一个雷达,最擅长在海量公开信息里抓取突发新闻、技术争议和行业动态。
OpenClaw 则是奔着私人全能管家的方向去的。因为部署在受自己控制的环境里,它可以放心拿到很高的个人权限,比如直接翻看日常的邮箱、检查日程日历、管理智能家居,甚至在后台帮着比对航班信息。它的核心任务不是去全网抓热点,而是帮个人处理繁杂的日常琐事。
用什么方式给它派活
两者的交互入口也完全不一样。
Grok Bot 主要通过网页端、平台内置入口或者官方 API 接口来接收任务和反馈简报。
OpenClaw 则主打贴近大家的日常聊天习惯。它专门把 Telegram、WhatsApp、Discord 甚至苹果的 iMessage 做成了操作界面。在外面散步时,打开平时的聊天软件给它发一句话,它就在后台默默把邮件整理好、把日程填进日历。一个偏向云端的情报与任务处理中枢,一个更像装在聊天列表里的私人数字员工。
放在实际工作里,能帮我们做什么
说得再多,还是得看它放进日常干活里灵不灵。我们可以看几个具体的例子。
开源库出漏洞,自动查代码跑测试
很多团队用着成百上千个开源代码包,一旦某个底层包爆出安全问题,工程师得挨个查自己哪些项目受了影响。
如果让后台助手来做,它监测到官方发了漏洞通告,就自己提炼出这个漏洞的特征。接着它调出项目代码的备份,在安全的隔离盒子里跑一段专门的测试脚本,看看到底能不能攻进来。试完之后,直接把受影响的文件位置、测试日志以及建议换用的安全版本整理成一张清单交上来。
长期盯一个行业,筛掉吹水只留干货
不少人每天要花很多时间看技术新闻和论坛,但网上充斥着很多标题党和复制粘贴的假消息。
系统可以一直在后台当情报筛选员。追踪某个新产品时,它一边搜集各种爆料,一边对比这些发言者以前说话的靠谱程度。它能认出哪些是营销号在瞎编,哪些是一线技术员透露的干货。攒了一周后,交出来的不是几百个乱七八糟的网页链接,而是一份条理清晰的对比表,把大家争论的分歧点清清楚楚列出来。
在开源社区里先替管理员把关
很多知名项目的维护者每天被大量重复的提问淹没。
把项目资料库和提问区的权限开放给助手后,只要有人提了新问题,助手先去读对方贴出来的报错截图。如果是一看就属于配置写错的新手问题,它几秒钟内就能贴出正确的配置示范。如果是别人都没见过的真问题,它会客客气气地提醒对方补充操作系统版本和重现步骤,把杂乱的求助先整理得规规矩矩。
让助手全天跑着不掉线,ServBay AI gateway 能帮上什么忙
看完上面这些顺畅的工作流,大家可能会觉得马上就能这么用起来了。但在实际搭建这类后台助手的过程中,很快就会踩到几个很烦人的坑。
让助手全天挂着干活,调用的请求是连续不断的。如果直接连某一家模型的官方接口,往往会遇到麻烦。
第一个麻烦是网络不稳定和频次受限。官方接口总有偶发抽风、线路维护或者调得太频繁被限流的时候。一旦网络断一下,跑了一半的长任务就直接崩了。
第二个麻烦是不同工具的接口格式不一样。市面上的工具生态各用各的规则,有的按 OpenAI 的格式写,有的按 Anthropic 的格式写,还有的认 Google Gemini。如果一个工作流里想混用不同家的模型,光改接口代码就能把人绕晕。
第三个麻烦是钱花得太快,账单分不清。让高级模型整天读海量废话,消耗的额度非常惊人,而且多个项目混用同一个密钥,月底根本分不清哪个任务花得多。
为了解决这些现实问题,在实际部署中通常会在中间加一层 ServBay AI gateway,让它来负责管账、分发和转换。
抹平接口格式,不管什么协议都能直接连
在很多开发场景下,大家最头疼的就是接口格式对不上。ServBay 本身具备完善的协议转换能力,不管上层软件发过来的是 OpenAI、Anthropic 还是 Gemini 的格式,网关在中间都能自动转成标准数据。下层的脚本、工具和后台助手只管放心调用,完全不需要在代码里做恶心的格式兼容。
多个渠道一起用,一个断了自动切下一个
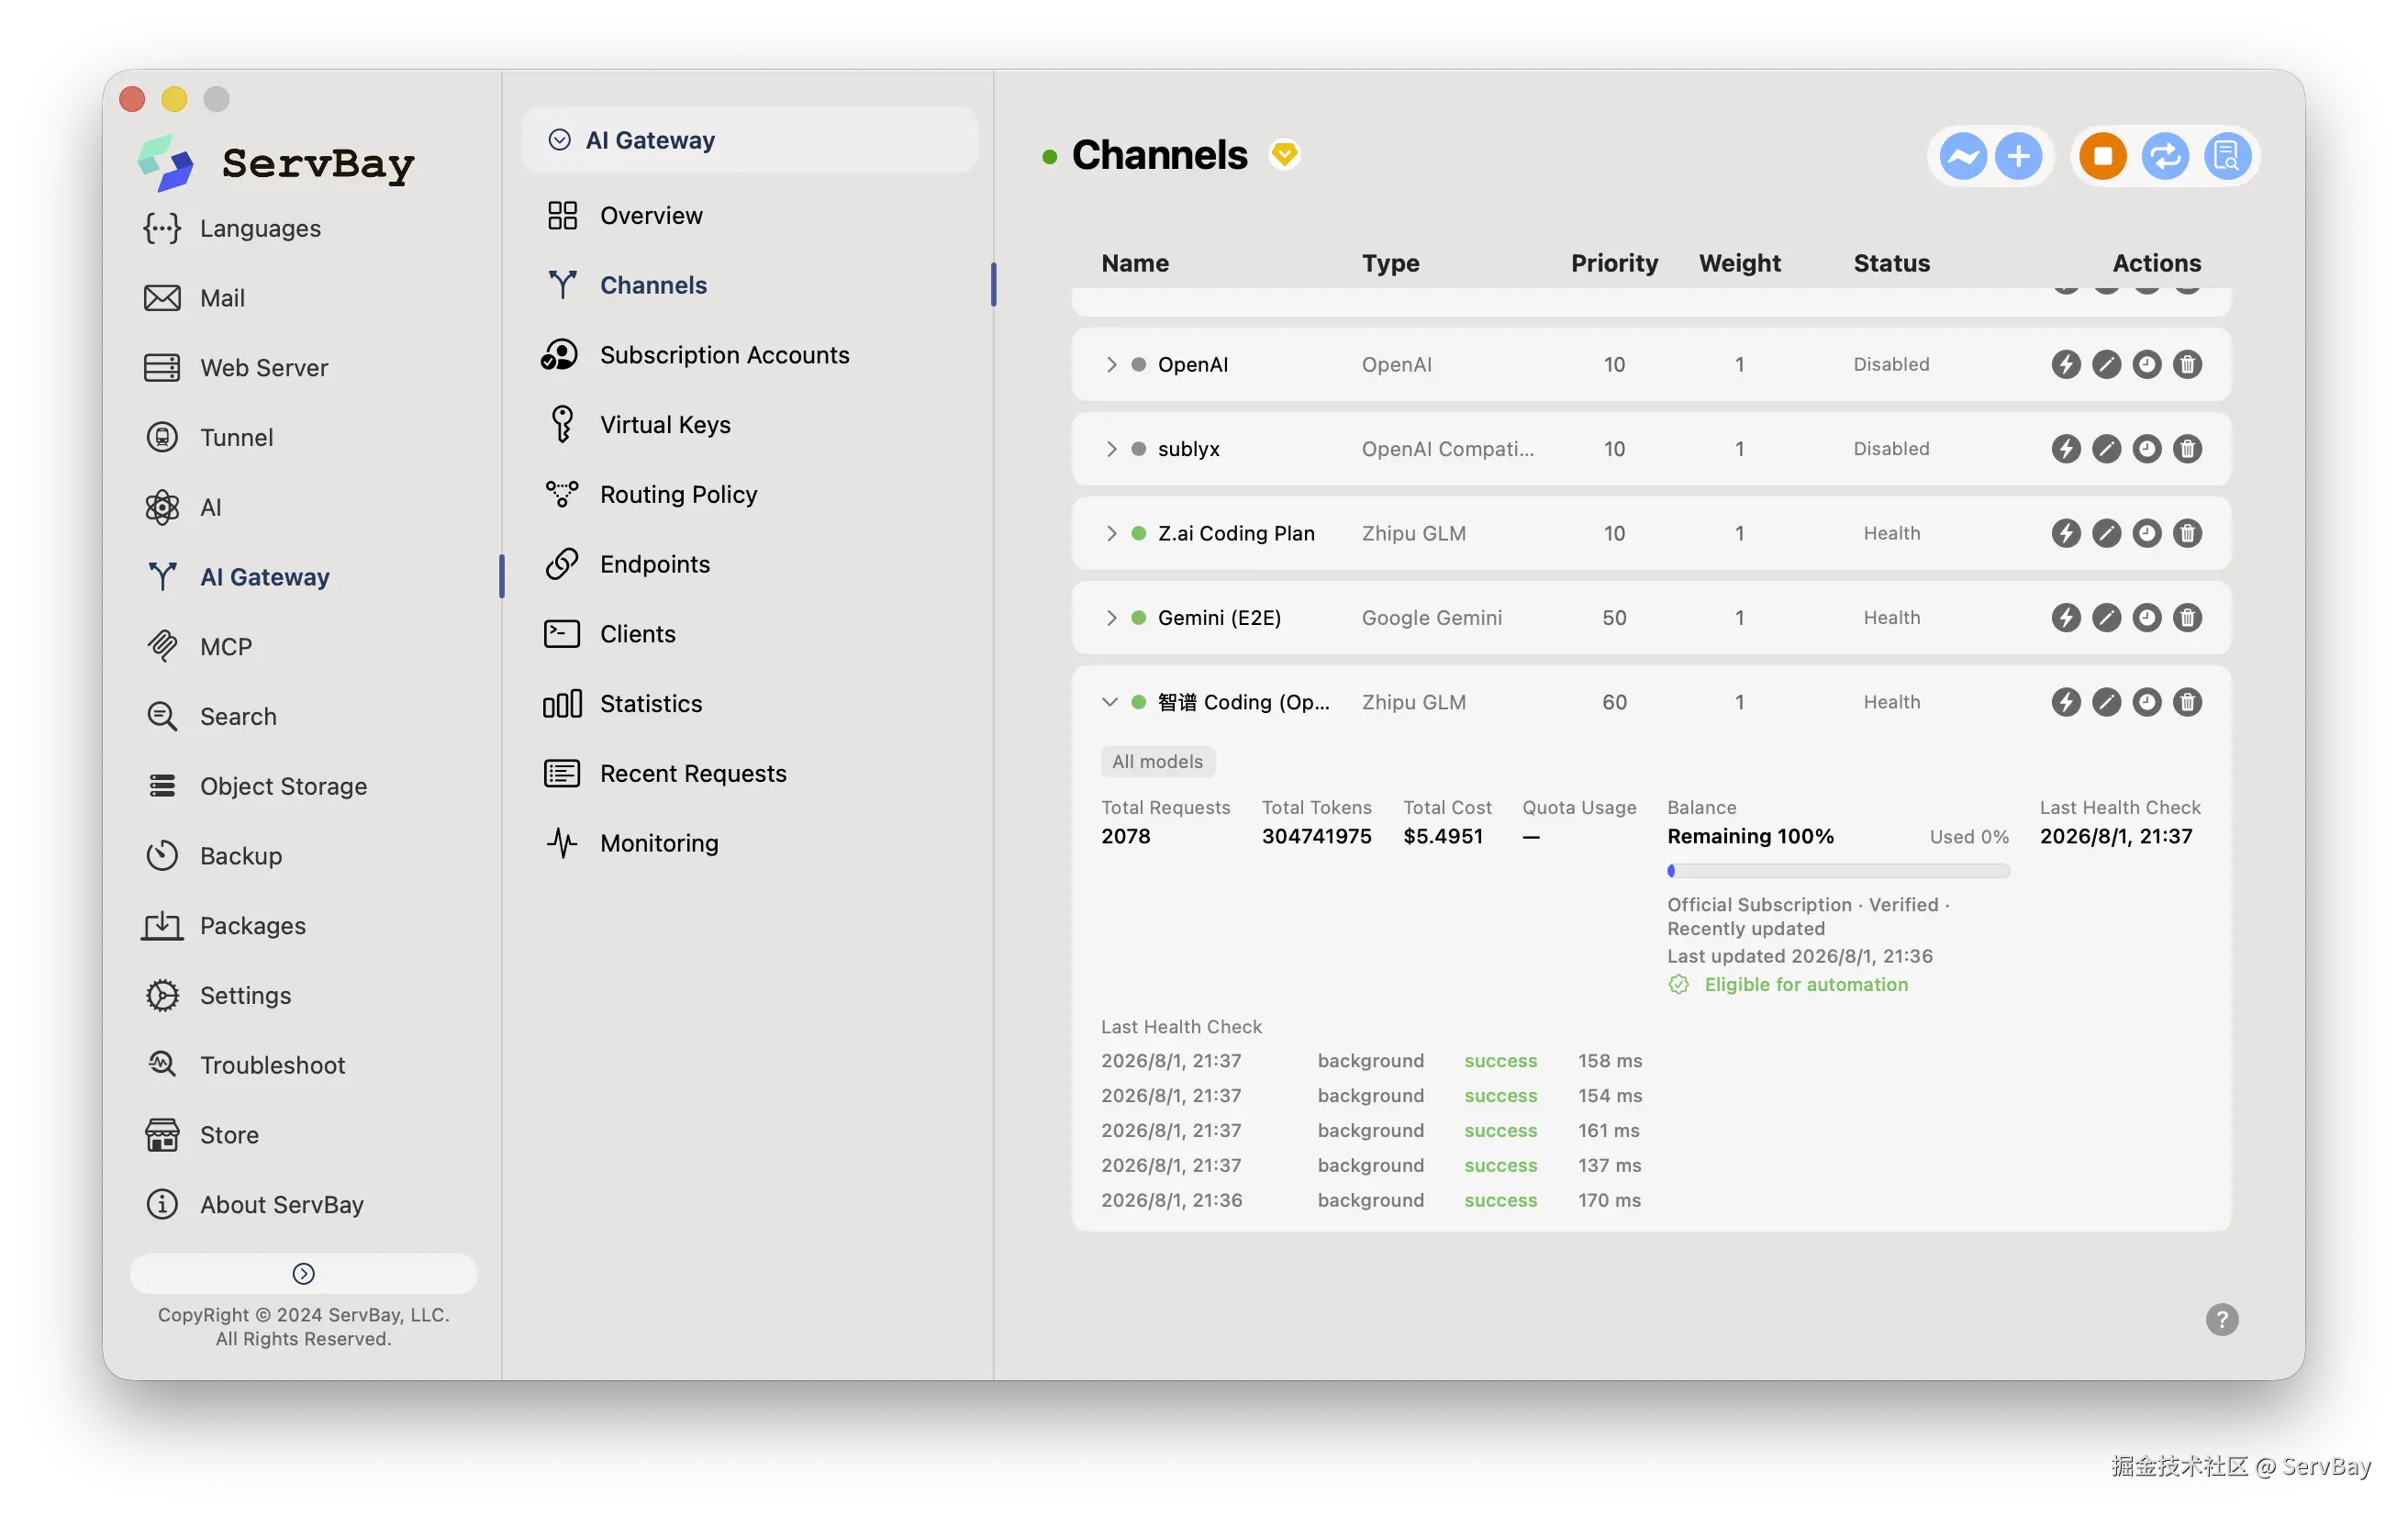
为了让后台助手不掉线,ServBay AI gateway支持把各家的官方 API、订阅账号以及常用的中转渠道全部加进来统一管理。在后台可以按需要设置优先级和流量分配规则。一旦当前正在用的主渠道网络卡顿或者超出了频次限制,网关会自动完成热切换,把任务无缝转到备用渠道上去,后台的自动化任务完全不会因此中断。
把贵模型换成便宜模型,帮忙省点钱
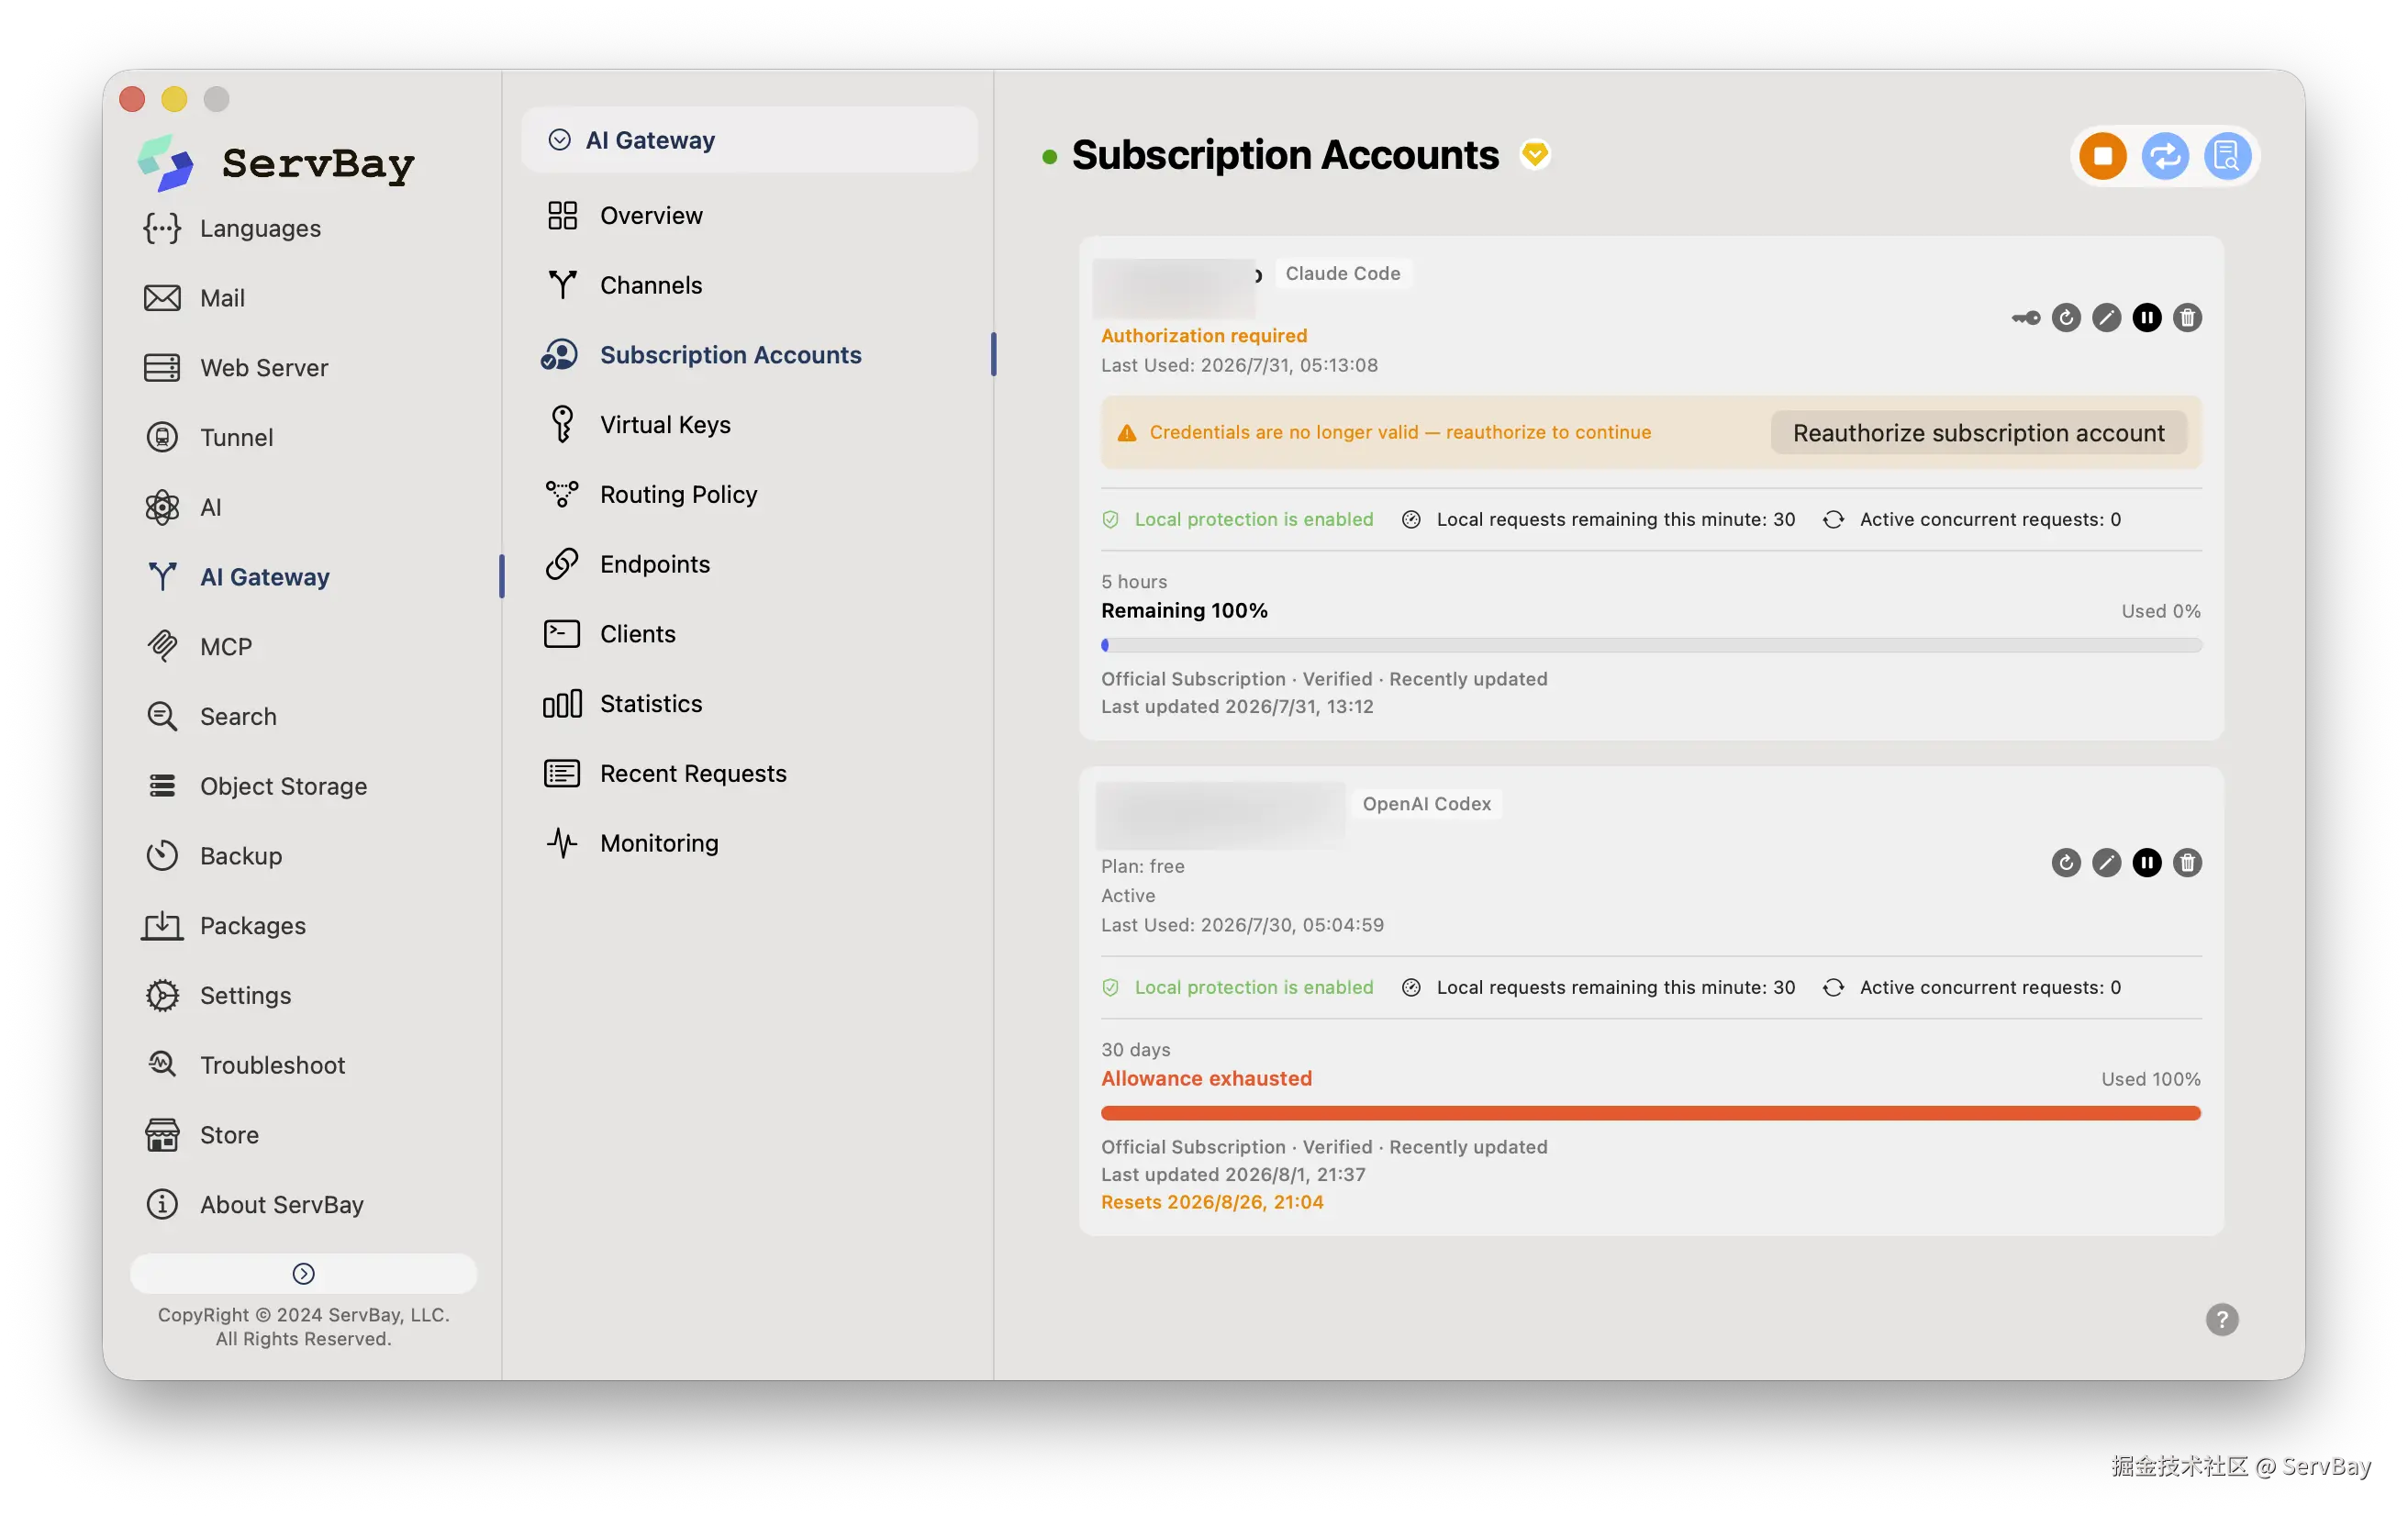
并不是所有后台杂活都必须交给最贵的模型去做。在前期盯盘、读初级垃圾信息的时候,用顶级模型确实有些烧钱。ServBay 提供了模型映射功能,可以在后台自己定规则,比如把请求里的 claude-opus-5 自动替换成便宜好用的 glm-5.2 来跑。上层的程序不需要改任何代码,但后台的费用却能降下一大截,等到真正需要复杂推理的时候再换回好模型,既省钱又省心。
给不同项目分发钥匙,各用各的算得清
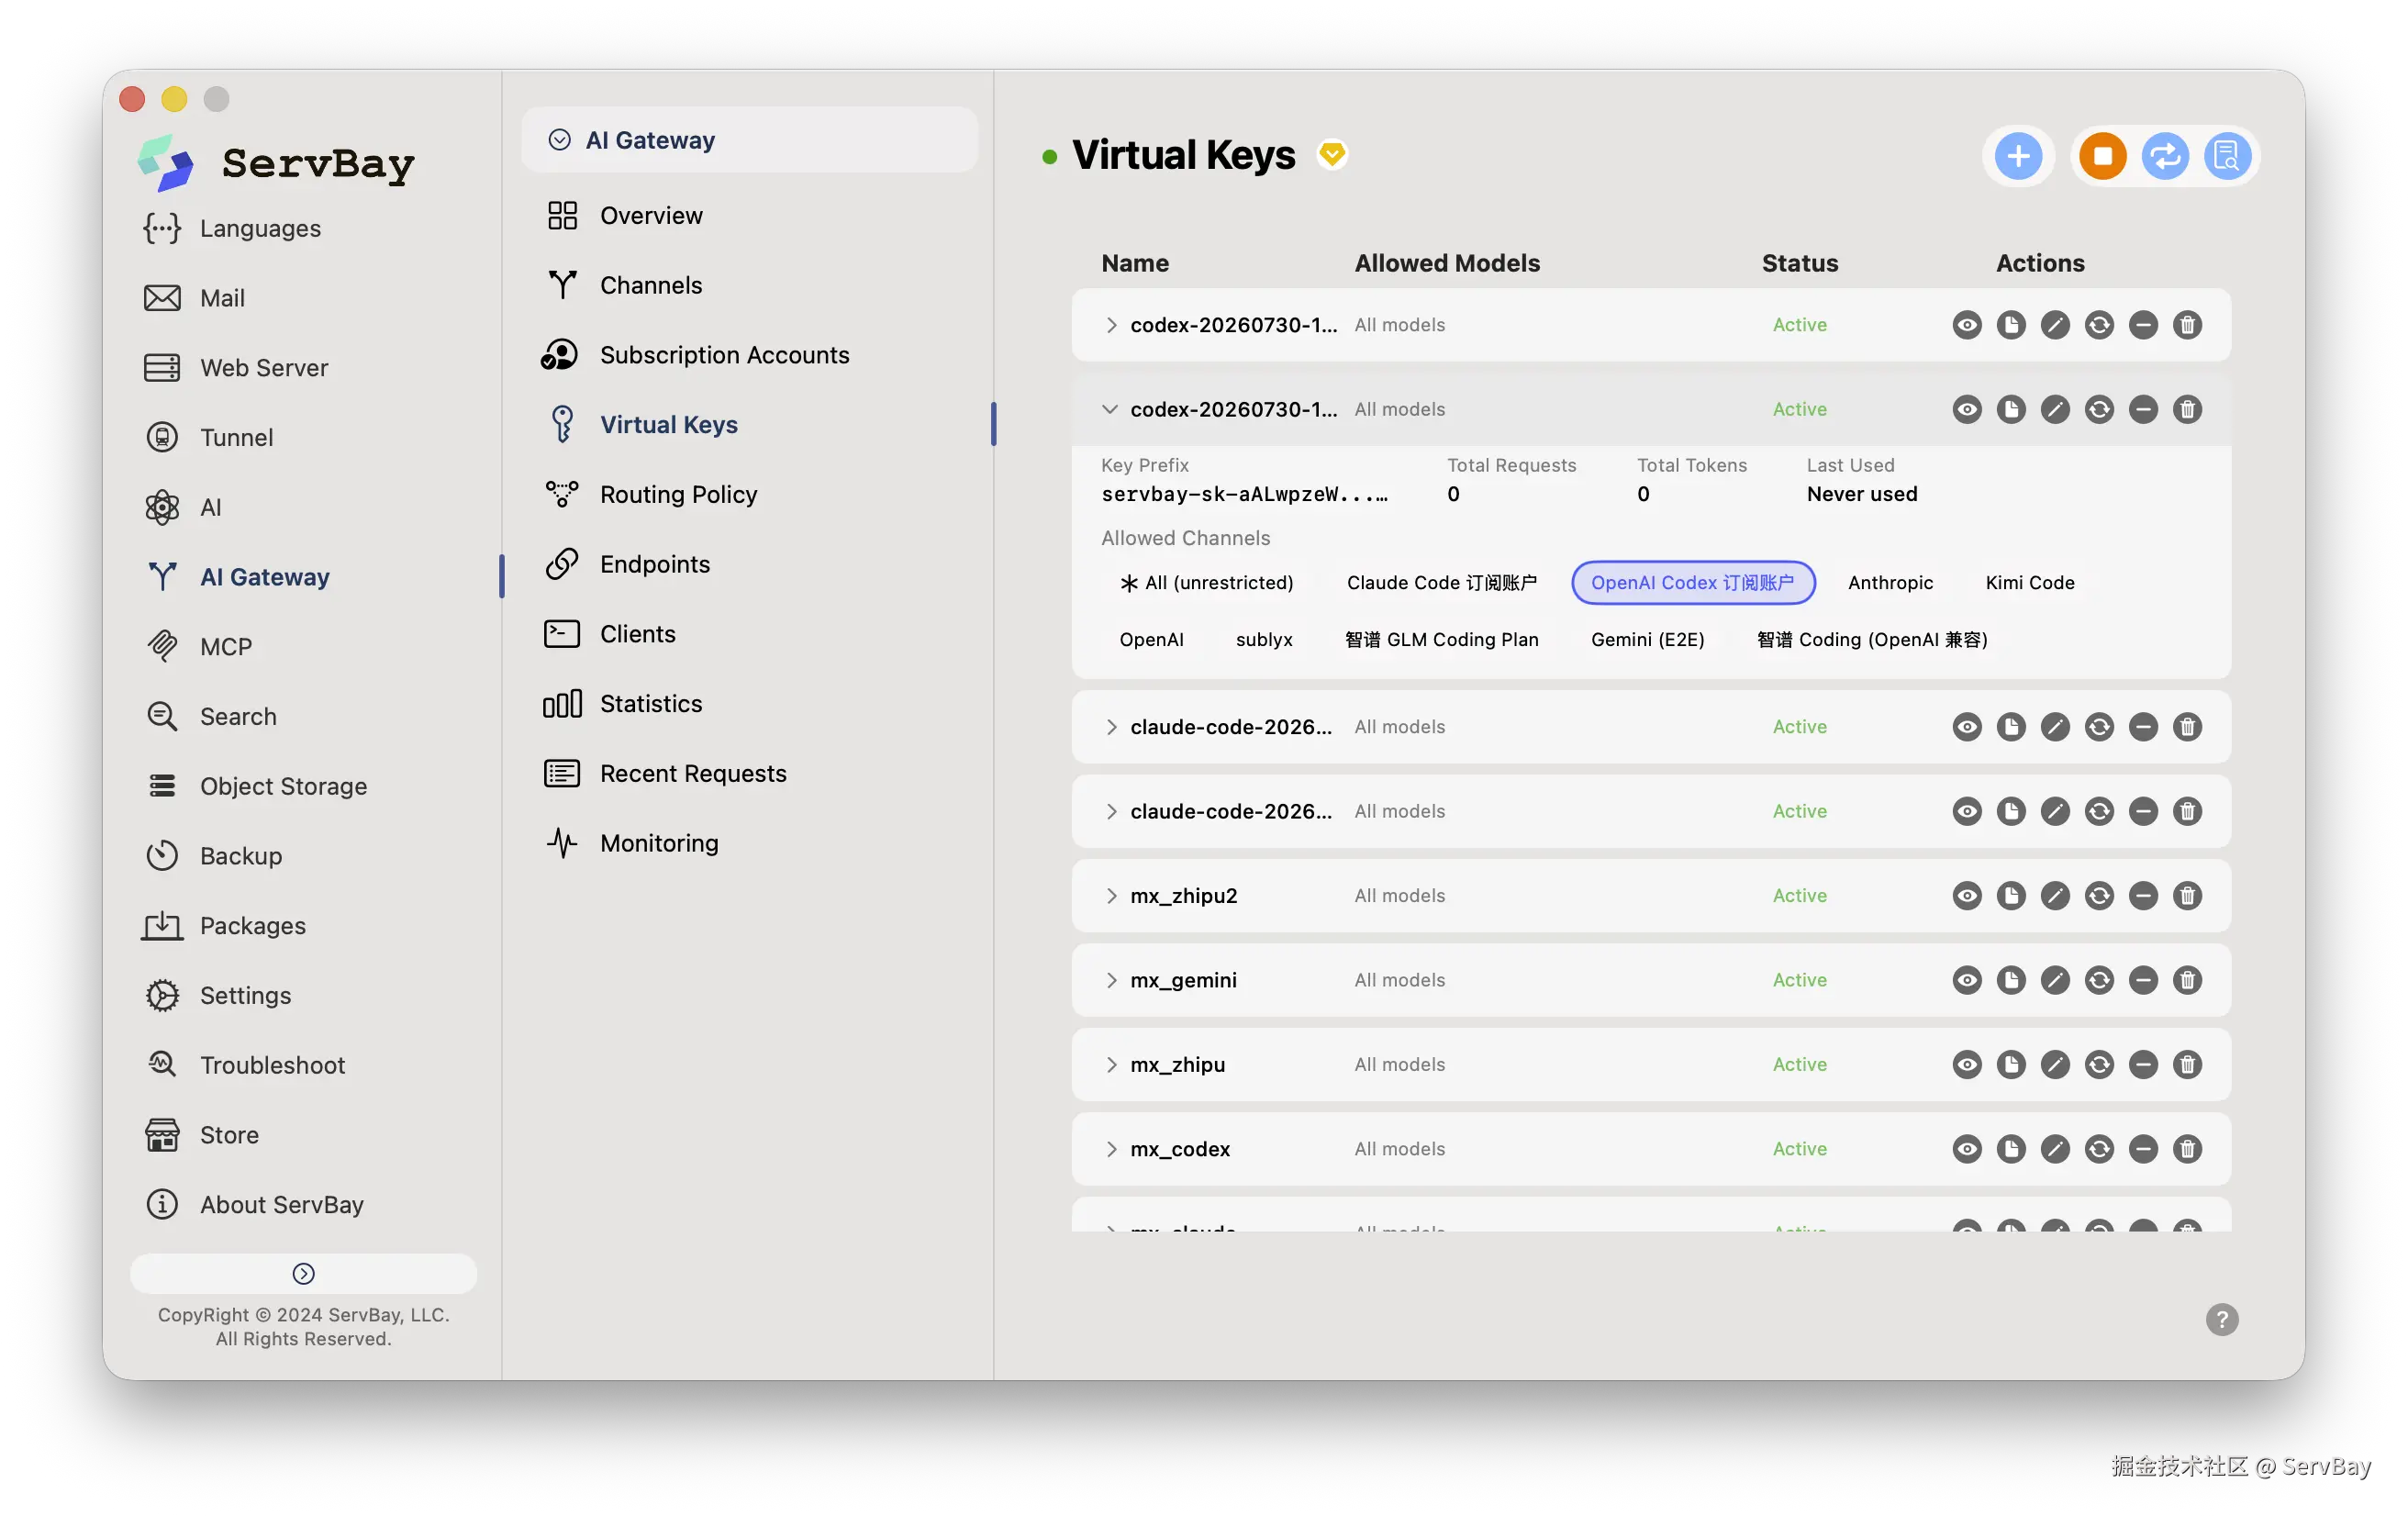
如果几个任务共用一套接口密码,出了故障排查起来会很痛苦。在 ServBay 里可以建出多个不同的虚拟 Key,分给不同的项目或者不同的脚本。网关会把每个 Key 调了多少次、响应快不快、花了多少额度记录得清清楚楚。哪个项目超支了一目了然,必要时还能单独限制额度,管理起来踏实很多。
最后:人和 AI 的分工正在变轻松
聊完这些技术细节,回过头来看常驻助手的发展,它带来的真正改变,其实是把人从电脑前解放出来,程序员好像离失业更近一步了(bushi)。
过去我们更像是一个打字员,得时时刻刻坐在屏幕前盯着它打字,哪句话说得不对还得马上打断。现在随着能够长期运行、会自己动手调用工具的系统成熟起来,人的角色开始退到了监督者的位置。
大家的主要精力,变成了给它划定可以活动的范围、用像 ServBay AI gateway 这样的工具把底层的通道搭结实,最后在它交出办好的事情时把把关。
大语言模型从最开始只会在网页里陪人闲聊,到现在能在后台帮人默默盯着杂活,技术确实是在一点一点变得更实用。少一点夸张的噱头,多一些稳当的基础设施,工作才能真正变得轻松起来。