改表之前的必修课:用列级血缘做影响分析
Esther 数据治理实战 · 第 7 篇。上一篇讲
SELECT *的元数据展开,结尾留了个问题:要把employees.phone从 VARCHAR(20) 改成 VARCHAR(11),动手前你会先做什么?今天兑现。系列前五篇都在讲"血缘图怎么建出来",这篇讲"图怎么用"------它最直接、最值钱的用法:影响分析。本文每一段输出都是真实运行结果,不是示意图。
一、先说结论:影响分析就是血缘图的"下游读法"
改表之前,工程师真正想知道的只有一件事:这个字段被谁在用?
- 改类型、改长度------哪些下游表要跟着改?
- 改取值口径------哪些报表、哪些接口的数字会变?
- 直接删掉------哪些链路会当场断掉?
血缘图天然能回答这个问题。它是一张有向图:列是节点,数据流是边。从要改的那个列出发,沿着出边一路往下走,走到的每一个节点,都在受影响名单上。
影响分析不神秘,它就是血缘图的下游读法。难的一直不是"读",而是前面五篇反复解决的事:把图建准、建全、建到列。
二、翻车现场:改一个字段,炸 30 张表
假设一个大多数数据团队都不陌生的场景:公司要统一手机号收号规范,user_phone 字段从 VARCHAR(20) 收紧到 VARCHAR(11),顺手清洗历史脏数据。DBA 看了看:"就是改个字段类型,十分钟的事。"
第二天:客服报表跑挂了,某个做了三年手机号截断处理的下游视图直接报错;风控名单接口返回的号码格式对不上;运营的触达清单更新了一半,一半是空......
炸的表可能有 30 张,但根因只有一次失误:动手前没做影响分析。
为什么影响分析这么难做?常规手段各有各的盲区:
| 手段 | 盲区 |
|---|---|
| 全局搜字段名 | 只能搜代码仓库。视图定义在数据库里,不在仓库里;三层视图嵌套背后的间接引用,搜索无能为力 |
| 问老员工 | 问得到这张表,问不到那个视图。知识在离职那天也跟着走了 |
| 表级血缘 | 能圈出 30 张"沾边"的表,但其中可能只有 8 张真读这个字段。粒度太粗,评估要么虚惊一场,要么恰恰漏掉 |
表级血缘的困境值得多说一句:它告诉你"动过这张表的人都要小心",于是所有人如临大敌;但"小心"不是答案,回答不了"改这一列,到底要动哪几个下游"。列级血缘把名单从 30 张表收敛到 8 个列------这才是能排期、能分工的变更评估。
三、思路转变:血缘图天生就是影响分析的数据结构
把血缘存进图数据库之后,影响分析只剩一次图遍历。一张合格的列级血缘图,恰好具备影响分析需要的三个性质:
- 列级粒度------节点精确到列,名单天然收敛;
- 有向------数据只能顺流而下,"改上游影响谁"沿出边走,"这个数从哪来"沿入边走,方向不会乱;
- 带类型------边不是铁板一块,直接流、聚合、条件过滤各是各的类型,"怎么个影响法"写在边上。
于是变更评估的流程变成:改哪列 → 在图上找到那个节点 → 沿出边走到底 → 受影响清单自动出来。不再翻代码、不再猜链路、不再 depends on 谁的记忆。
四、一条查询拉通 N 层
血缘落到图库里之后,"改一个字段查它全族"这件事,从"应用层一层层递归查"变成了一条查询。
思路很简单:图库里支持变长路径遍历------起点给定后,沿着边连续走 N 层,一次匹配全部命中,不需要应用代码自己写循环、自己记"查过了没"。
下面这段是示意写法(基于开源图数据库的通用 Cypher 语法):
cypher
-- 示意:从目标列出发,沿血缘边向下游走,深度不限
MATCH (start:Column {fqn: $fqn})-[:FLOWS_TO*1..N]->(affected)
RETURN DISTINCT affected
两个实用细节:
- 默认拉通全链路------不设深度限制,走到底为止;图上再深、中间隔多少层视图,一次全出来;
- 深度可调------只想看"明天上线前的直接影响"?把深度收窄到 1~2 跳,名单立刻聚焦。
层次感是图遍历免费送的:哪些是第一跳的直接影响、哪些隔着三四层间接传导,一条查询里全带着。这正是"30 张表"故事里最要命的那类隐性传导------视图套视图,人脑数不过来,变长路径数得过来。
五、走一遍真实演示
光说不练假把式。构造一条教科书级的数仓分层链------原始层、明细视图、两个汇总视图(在这里分叉)、一张应用层报表:
sql
CREATE TABLE ods.orders (
    order_id    BIGINT PRIMARY KEY,
    user_phone  VARCHAR(20),
    amount      DECIMAL(10,2),
    status      VARCHAR(20),
    created_at  TIMESTAMP
);

CREATE VIEW dwd.orders_detail AS
SELECT order_id, user_phone, amount, status, created_at
FROM ods.orders
WHERE status IS NOT NULL;

CREATE VIEW dws.user_order_summary AS
SELECT user_phone,
       COUNT(*)    AS order_cnt,
       SUM(amount) AS total_amount
FROM dwd.orders_detail
GROUP BY user_phone;

CREATE VIEW dws.risk_phone_list AS
SELECT DISTINCT user_phone
FROM dwd.orders_detail
WHERE amount > 10000;

CREATE TABLE ads.contact_report AS
SELECT user_phone, order_cnt, total_amount
FROM dws.user_order_summary;
先整体分析入库(真实命令、真实输出):
bash
python cli.py analyze --dialect postgres --file warehouse.sql \
    --db-path esther.db --project dw
# Saved to esther.db (project=dw, id=a00930faf1)
# 整条脚本:42 个节点、27 条边,五张表/视图全部连上现在做影响分析:如果要把 user_phone 从 VARCHAR(20) 改成 VARCHAR(11),谁受影响? 通过血缘查询接口沿下游拉通全链(direction=downstream,深度不限),真实返回:
less
fqn: ods.orders.user_phone   direction: downstream   depth: -1
node_count: 9   edge_count: 8
9 个节点里 1 个是起点自身,8 个是下游受影响节点。8 条边连成的完整链条(原文输出按 FQN 展示,这里按业务对象收拢,__xxx_src__ 是每条建表/建视图语句的"计算过程"中间节点,属于解析器的如实记录):
markdown
ods.orders.user_phone(源头:原始订单表)
  └─ dwd.orders_detail.user_phone           明细层视图,第 1 层
       ├─ dws.user_order_summary.user_phone 汇总层:按手机号聚合订单,第 2 层
       │    └─ ads.contact_report.user_phone 应用层触达报表,第 3 层
       └─ dws.risk_phone_list.user_phone    汇总层:大额订单风控名单,第 2 层
一张清单,四个层次,一处分叉。 变更评估可以直接照着排期:明细视图要改、按手机号聚合的汇总表要跟着改、它下游的触达报表要重刷、风控名单要从新的号码口径重新生成------谁也跑不掉,谁也不会被冤枉。
改表前看一眼这张图和动手后炸 30 张表,是两种完全不同的职业生涯。
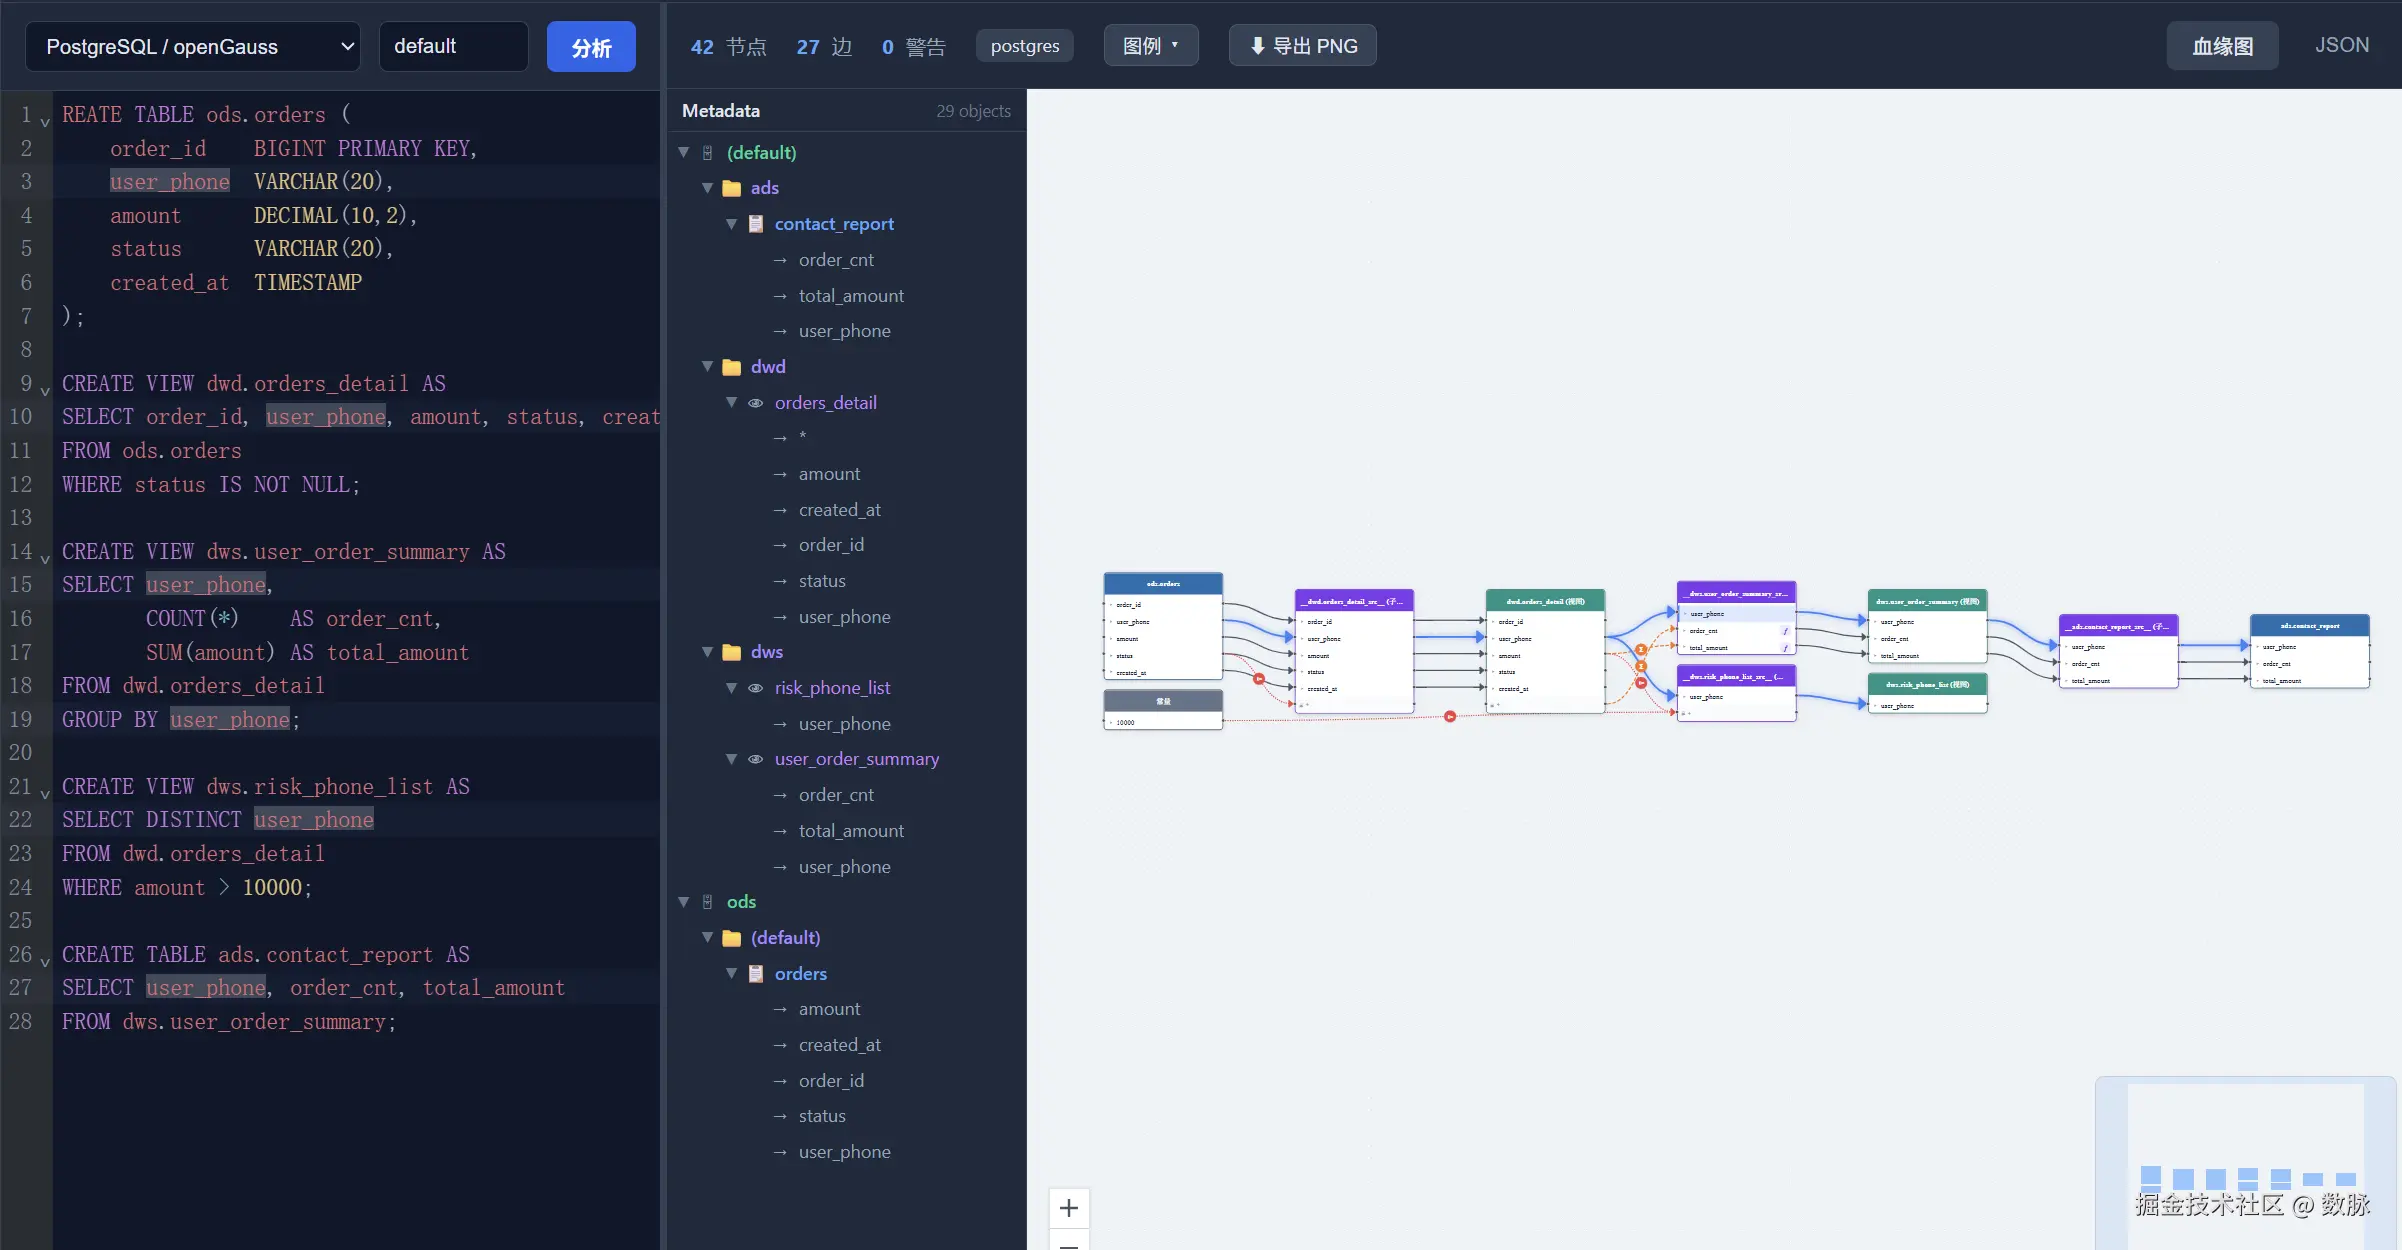
六、不只回答"谁受影响",还回答"怎么个影响法"
影响分析如果只给一份名单,还是半成品。同一个字段流出去,方式不同,改法就不同------这写在边的类型上。
把起点换成 amount(金额字段),从真实输出里摘三行,DIRECT、AGGREGATION、FILTER 三种边同框:
scss
ods.orders.amount → __dwd.orders_detail_src__.amount                    [DIRECT]
dwd.orders_detail.amount → __dws.user_order_summary_src__.total_amount
                           [AGGREGATION] SUM(amount) GROUP BY user_phone
dwd.orders_detail.amount → __dws.risk_phone_list_src__.* [FILTER]- AGGREGATION 边 :
amount被聚合成了total_amount,边上还挂着表达式原文SUM(amount) GROUP BY user_phone------改金额精度,下游要重算的是哪些列,一目了然; - FILTER 边 :
amount还参与了WHERE amount > 10000的筛选条件------它不只被"算",还被"拿来判断"。这条边最容易被漏掉,也最危险:金额口径一变,风控名单的圈定范围跟着变,数据没报错,但名单已经悄悄不是原来那批人了。
再看 status 字段,它的故事全在一条 FILTER 边上:
css
ods.orders.status → __dwd.orders_detail_src__.* [FILTER]明细视图建在 WHERE status IS NOT NULL 之上------改 status 的取值枚举,最先变的不是哪个数字,而是哪些行能流过这条链路。
第 5 篇讲存储过程时说过"语境跟着血缘一起交付",这里是同一个思想在影响分析里的兑现:血缘图不但告诉你数据从哪来、到哪去,还告诉你这条流在什么条件下、以什么方式发生。直接读写要改代码、聚合列要重跑数、过滤条件要对口径------三种边,三种改法,一张图上分得清清楚楚。
七、怎么用起来
三个入口,按场景选:
CLI------一条命令,分析入库:
bash
python cli.py analyze --dialect postgres --file warehouse.sql --db-path esther.db --project dw分析结果落进嵌入式图库,供后续查询。适合脚本化:交付脚本分析、CI 流水线里定期重建血缘。
REST API------影响分析查询:
bash
GET /api/v1/lineage/ods.orders.user_phone?asset_type=column&direction=downstream&depth=-1direction 决定方向:downstream 做变更评估(改了它,影响谁),upstream 做来源追溯(这个数从哪来),both 看全链路;depth=-1 不限深度。返回受影响节点、边和计数,node_count / edge_count 可以直接进变更工单。
Web UI------点一下列,整条链路亮起来。在血缘图上点中某个列,它的全部上下游链路自动高亮点亮,一眼看到传导范围;再点中间任何一条连线,SQL 编辑器里同步高亮算出这条边的原始语句------从图回到代码,一步到位。
如实交代一句产品边界:在线分析页是沙箱,结果即算即还、不入库;要进图库做影响分析,走上面的 CLI 或数据管道任务,再通过 API / UI 查询。建图、存图、用图,三步各走各的门。
八、写在最后
影响分析的方法论,三条:
- 改表之前,先读图的下游------受影响名单不是问出来的,是从列级血缘图上走出来的;
- 列级粒度才有可执行的评估------30 张表是警报,8 个列才是排期;
- 边的类型就是变更类型------直接流改代码、聚合边重跑数、过滤边对口径,怎么改写在边上。
最后留个尾巴:这套流程管住了结构层 的传导------字段类型变了、链路断了、下游炸了,图上都看得见。但还有一类事故,图上看不出来:order_cnt 这个指标,A 团队算的是"全部订单数",B 团队算的是"已支付订单数",C 报表里又剔除了测试账号------同一个指标,三个口径。结构没断,数字打架。这种"语义层的血缘"怎么管?下一篇讲它:《同一个指标三个口径,谁来管?术语表与指标口径管理》。
▎ Esther 是一个企业级 SQL 数据血缘分析平台:28 种方言、列级血缘、元数据管理、私有化部署。如果你也在改表前心里没底,欢迎交流。
▎ 这篇的演示脚本和影响分析查询都整理在仓库里了,照着跑就能复现同款"全链路亮灯":github.com/estherdata2026
▎ 下一篇预告:《同一个指标三个口径,谁来管?术语表与指标口径管理》
数据血缘、影响分析、变更评估、列级血缘、数据治理