💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
基于大数据的北京市租房数据可视化分析
文章目录
1、研究背景
随着北京市城市化进程不断加快和人口流动规模持续扩大,住房租赁市场产生的数据体量呈现爆发式增长。传统的统计工具与单机数据处理方式难以应对海量房源信息的实时采集、存储与多维分析需求。租房平台每天产生涵盖地理位置、户型结构、装修状态、周边配套设施以及价格波动等维度的复杂数据。面对如此庞杂的信息,借助Python生态与Hadoop、Spark等大数据分布式计算框架,结合MySQL进行数据持久化管理,成为解决数据积压和处理瓶颈的必然选择。通过引入数据挖掘与机器学习算法,能够从海量非结构化与结构化数据中提取隐藏的市场规律。前端采用Vue框架配合Echarts可视化图表库,可以将晦涩的数据转化为直观的交互式大屏与驾驶舱界面,满足用户对北京市各区租金分布、配套画像以及价值洞察的迫切需求。
2、研究目的和意义
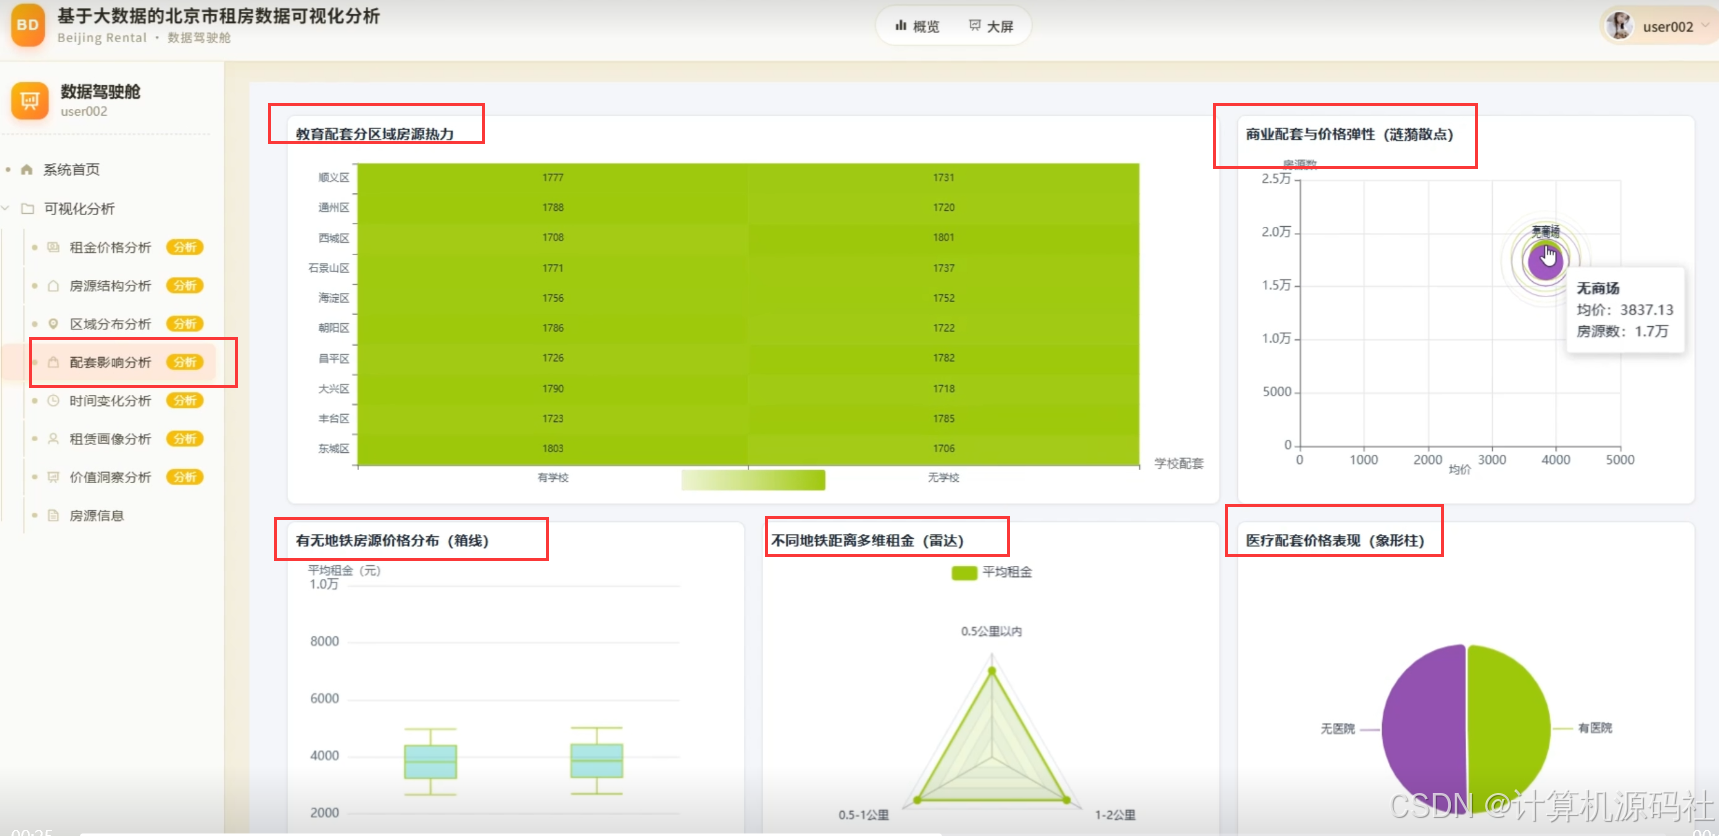
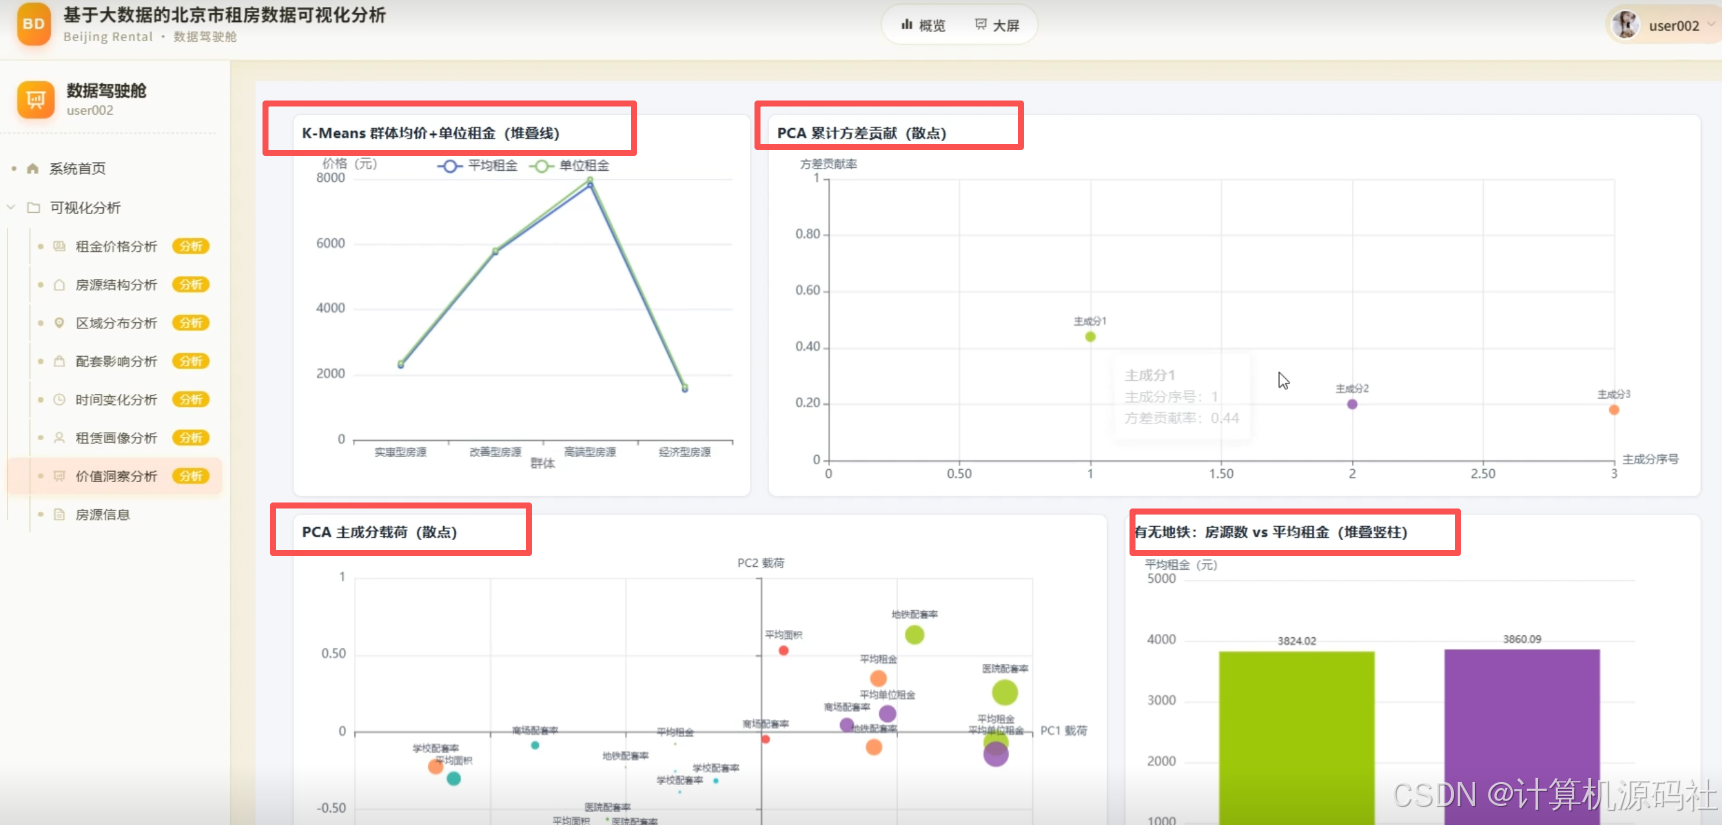
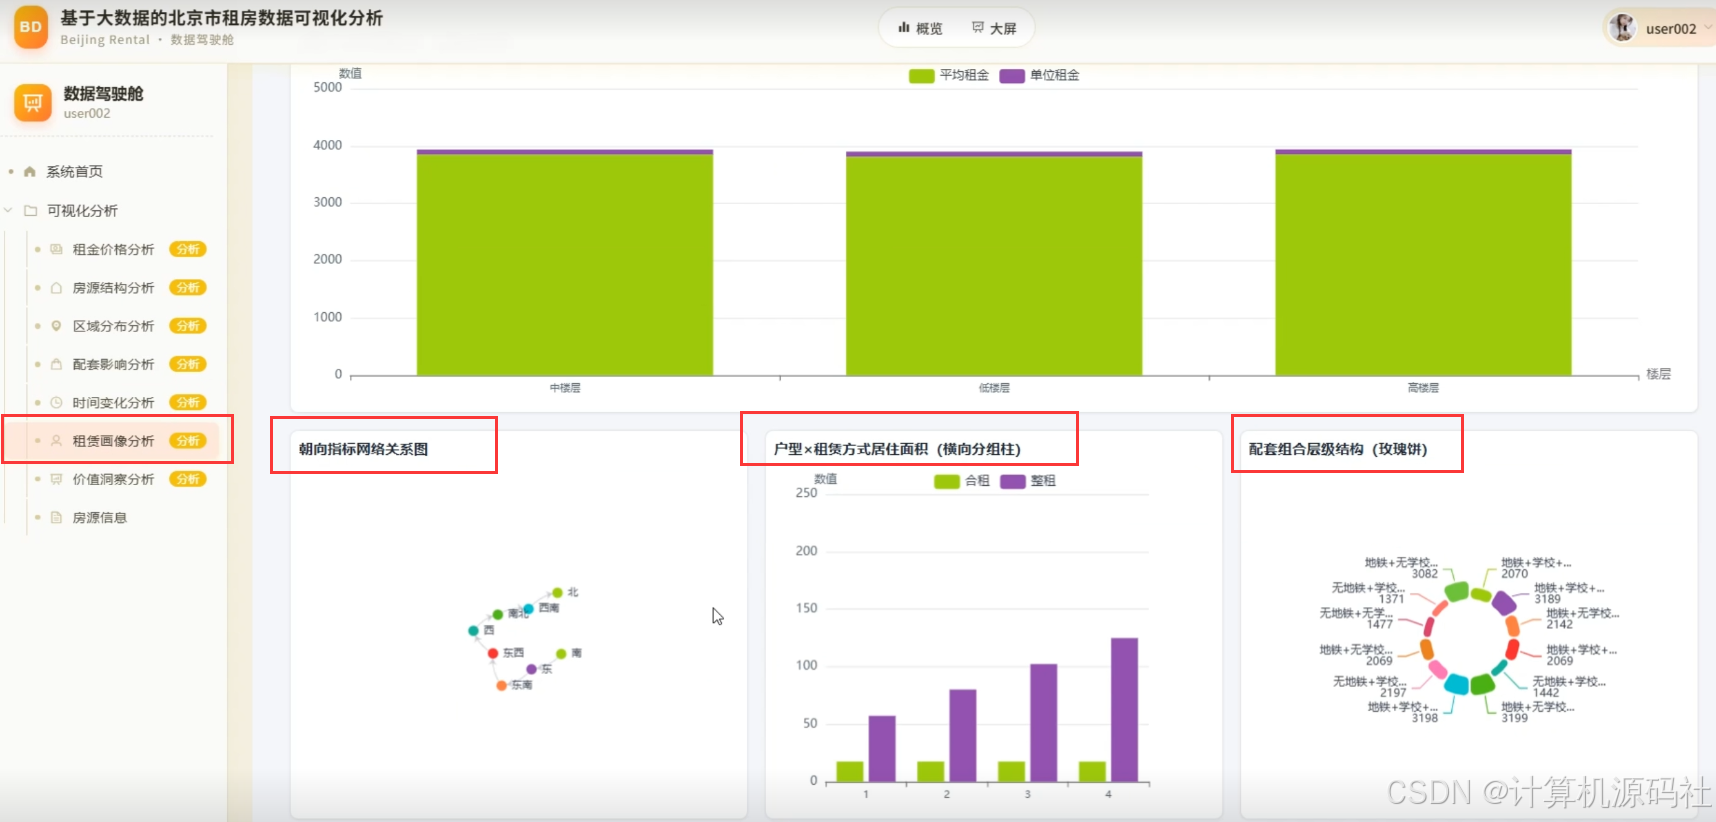
构建该系统的核心目标在于打造一个全方位、多维度的北京市租房数据可视化分析平台,打破数据孤岛,实现从数据清洗、挖掘到可视化呈现的完整闭环。系统旨在利用Spark强大的计算能力对房源信息表进行高效查询与聚合,将户型、面积、装修方式等基础属性与地铁、学校、商场、医院等配套因素进行深度关联。通过Echarts渲染雷达图、箱线图、平行坐标图、旭日图等丰富图表,直观展示租金价格分布、区域房源热力、租赁画像以及配套组合画像。引入K-Means聚类与PCA主成分分析,挖掘不同群体的均价与单位租金特征,评估商业配套与价格弹性。系统还提供房源明细的精确检索与分页展示,帮助租客快速定位高性价比房源,辅助房东与中介机构合理制定租金策略。
该系统的开发对于推动租房市场的信息透明化与科学决策具有深远意义。通过Hadoop与Spark构建的大数据底座,能够高效处理数万条乃至百万条级别的房源记录,极大提升了数据处理的时效性与准确性。将机器学习算法应用于价值洞察模块,可以客观量化地铁距离、学区配套、医疗资源以及商业圈对租金的实际影响系数,从而避免传统经验定价带来的偏差。可视化大屏以直观的图形语言替代枯燥的数据表格,使得区域分布规律、月度挂牌趋势以及异常房源单价一目了然。系统为政府监管部门监测市场异常波动提供了数据抓手,为租房群体提供了清晰的市场画像,也为房地产企业优化房源配置和精准营销提供了科学依据,有力促进了住房租赁市场的健康与可持续发展。
3、系统研究内容
系统开发内容紧密围绕大数据处理与可视化分析展开,涵盖数据采集、存储、计算与展示全链路。底层依托Hadoop与Spark分布式架构,结合MySQL数据库,对房源标题、所在区、小区、月租金、面积、单价、户型、装修状态等核心字段进行清洗与结构化存储。数据分析层运用Spark SQL与数据挖掘技术,构建租金价格分析、区域分布分析、配套影响分析、租赁画像分析、价值洞察分析以及房源信息管理六大核心模块。租金模块通过分组柱状图与双轴图分析户型与面积段均价;区域模块利用平行坐标与主题河流图展示各区域设施对比与房源流向;配套模块结合气泡图与箱线图剖析商业、地铁与医疗对价格弹性的影响。价值洞察模块运用K-Means算法与PCA降维技术进行群体聚类与主成分载荷分析。前端采用Vue与Echarts构建响应式驾驶舱,实现图表联动与明细数据的动态查询。
4、系统页面设计
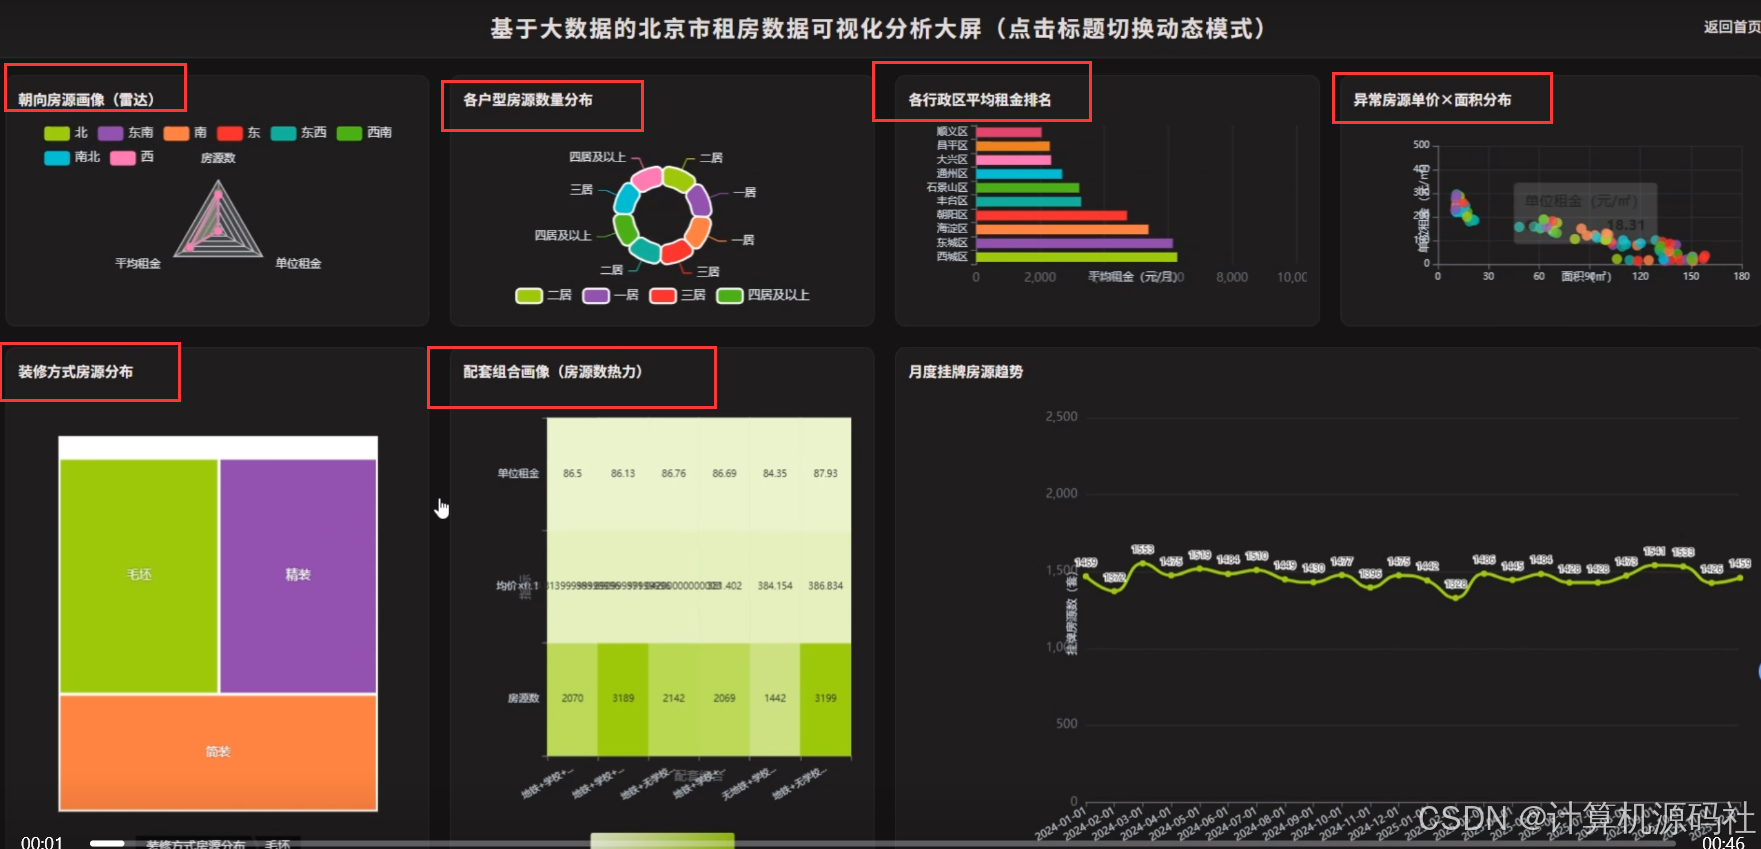
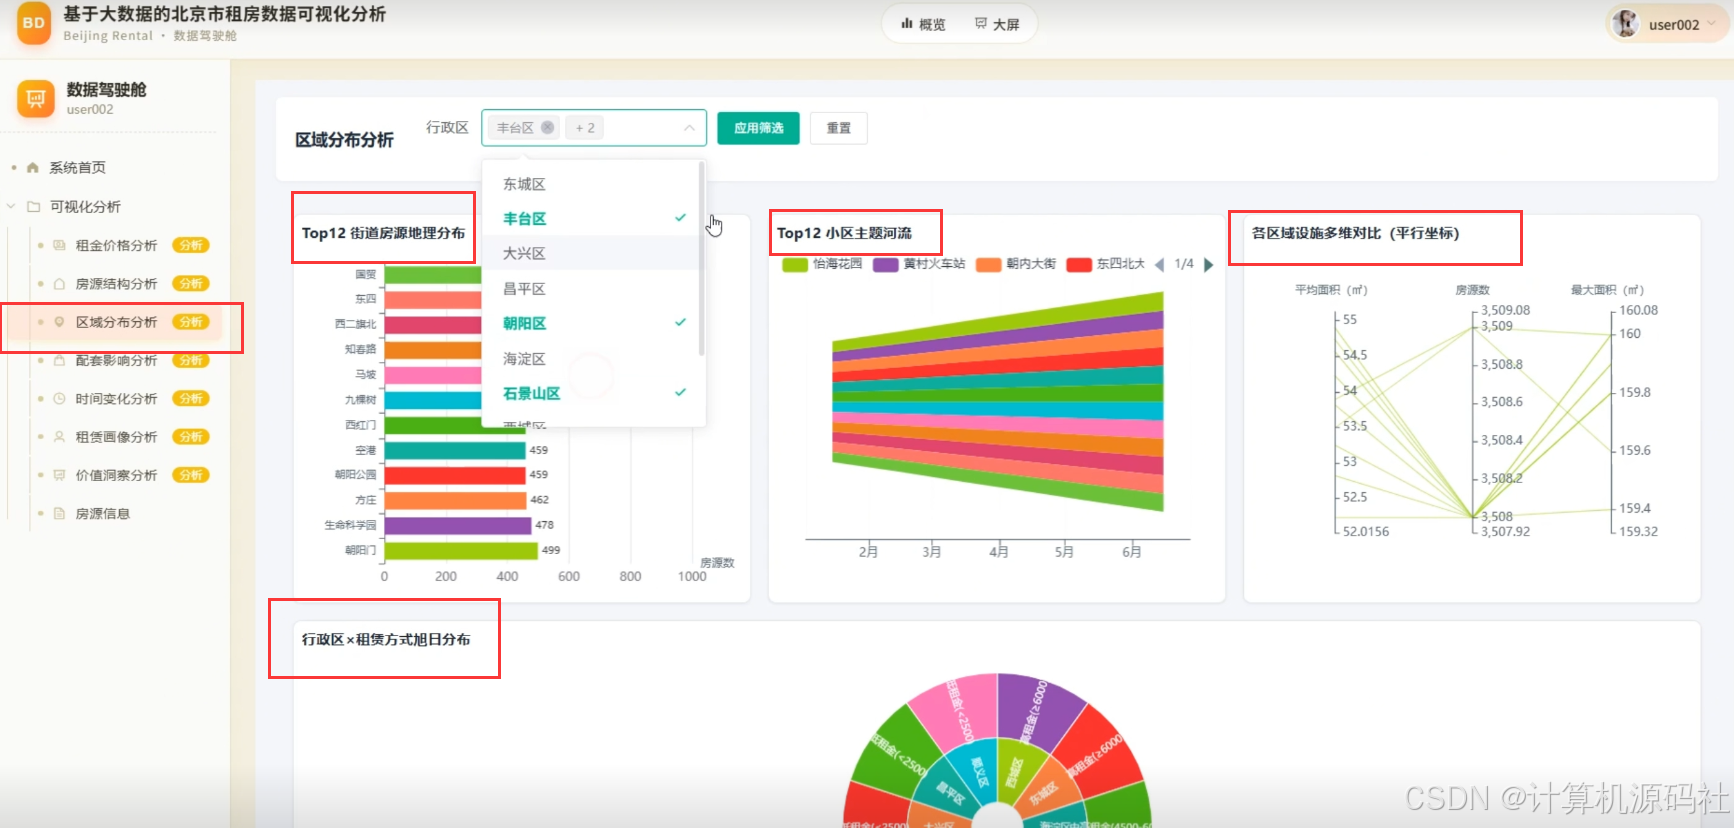
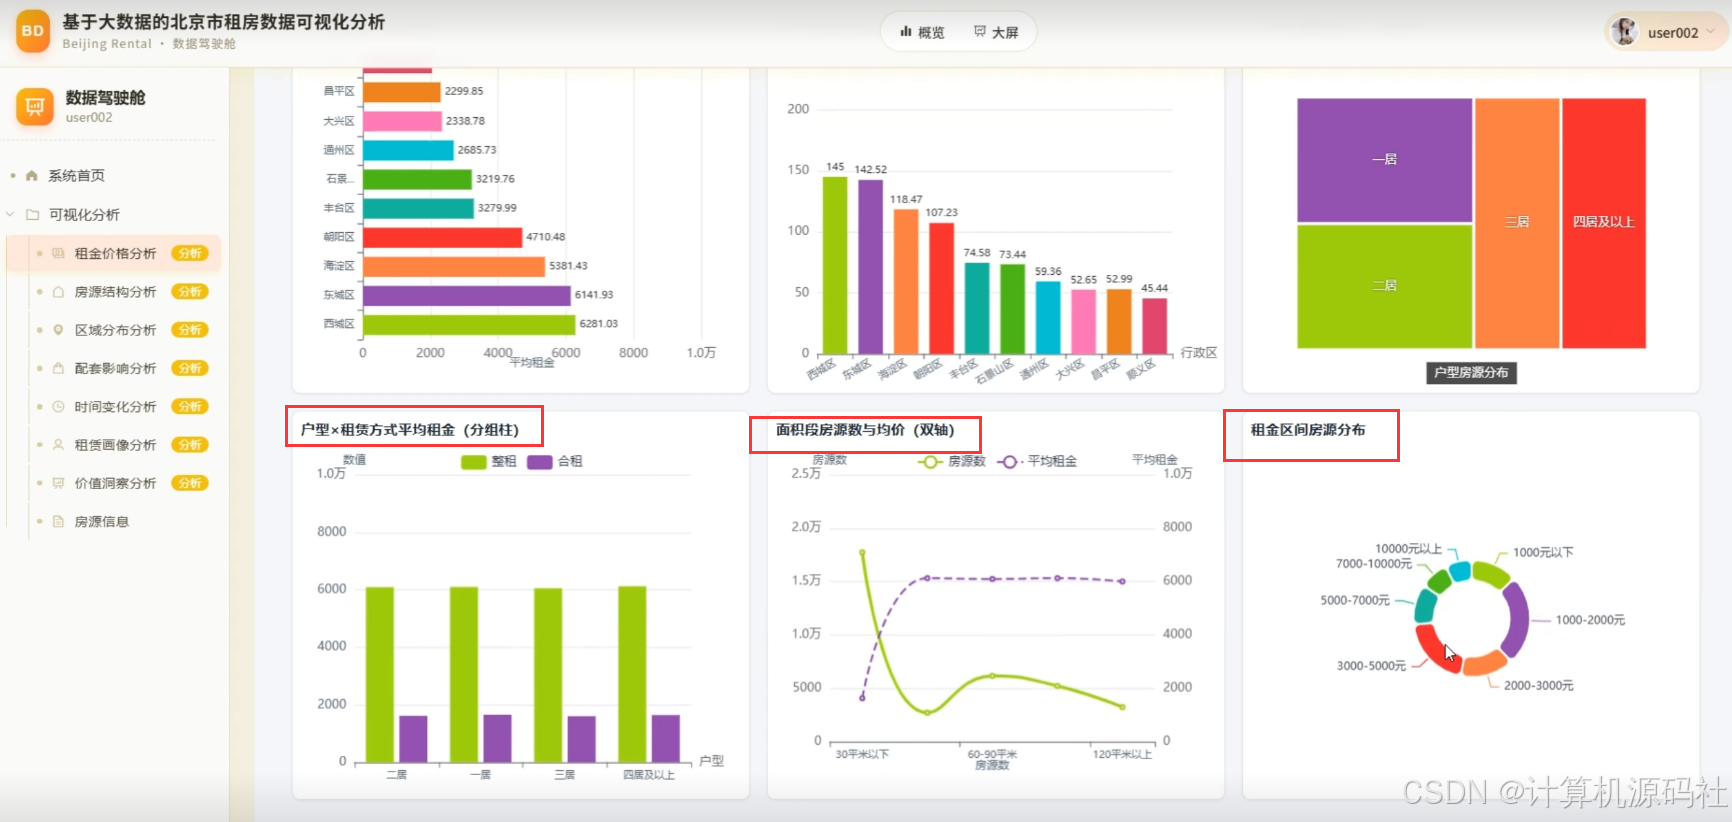
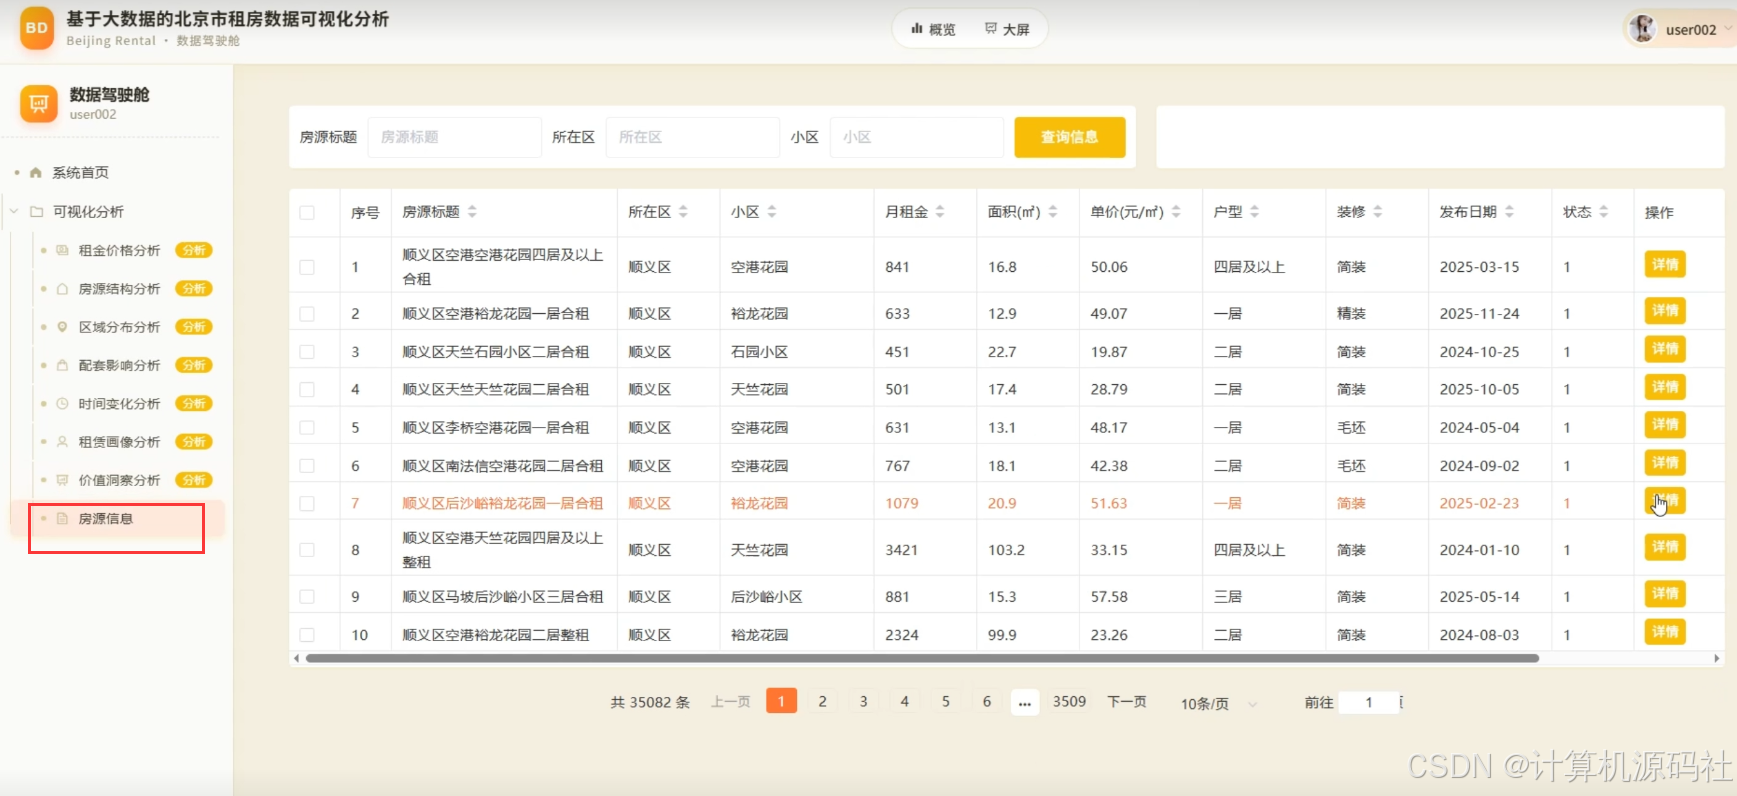
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1陈华. SQL数据分析技术在住房保障审计中的应用J.审计月刊,2025,(1):30-31.DOI:10.15882/j.cnki.sjyk.2025.01.006.
2王丽云,刘欢. 巧用大数据抓取公租房违规线索J.审计月刊,2024,(10):38-39.DOI:10.15882/j.cnki.sjyk.2024.10.013.
3李天瑞,纪圣塨,易修文.城市大数据智能M.机械工业出版社: 2023.
4周海伟. 基于人脸识别大数据的杭州公租房违规行为特征分析与应用研究J.科技通报,2022,38(9):41-46.DOI:10.13774/j.cnki.kjtb.2022.09.007.
5左铭书.基于数据挖掘的在线短租房销量影响因素分析D.山东师范大学,2022.DOI:10.27280/d.cnki.gsdsu.2022.000414.
6李涛. 基于Python的租房信息可视化及价格预测J.现代信息科技,2021,5(16):96-99.DOI:10.19850/j.cnki.2096-4706.2021.16.024.
7武帅,张苗,夏换,等. K-Means聚类和时间序列的在线短租共享经济分析J.信息技术与信息化,2021,(8):41-46.
8陈永俊,夏艳锋,高宇航,等. 基于NLP技术的警情文本数据分析应用J.警察技术,2021,(2):39-42.
9刘艾旺.基于电力营销大数据的用电客户精准营销D.浙江大学,2021.DOI:10.27461/d.cnki.gzjdx.2021.002552.
10王慧东.数据挖掘技术在租房数据中的应用研究D.昆明理工大学,2020.DOI:10.27200/d.cnki.gkmlu.2020.000952.
11岳福梅,郭欣,张丽坤,等. 基于居民用水数据的实有人口估测算法J.信息技术与信息化,2019,(8):86-89.
12 大数据分析Airbnb租房J.中国科技信息,2019,(13):8-9.
13郅臻.昆明勘测设计研究院职工宿舍管理系统的研究与分析D.云南大学,2018.
14韩学伟.房产经纪人网络营销系统的设计与实现D.山东大学,2018.
15黄文柱.三明学院公租房管理信息系统的研究与分析D.云南大学,2017.
16罗腾.公共租赁住房管理系统的研究与分析D.云南大学,2016.
17梅承茏.房产中介管理系统的研究与分析D.云南大学,2016.
18王惠平.基于数据挖掘的公租房管理系统设计与实现D.苏州大学,2016.
19秦欣欣.潍坊市住房保障管理系统的设计与实现D.山东大学,2015.
20杨文碧.昆明市公共租赁住房管理信息系统的研究与分析D.云南大学,2015.
6、核心代码
java
 模块二:基于K-Means的价格群体分群模块核心代码
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator

# 读取整合后的多维价格特征数据,包含农贸价、批发价、超市价及价差数据
price_df = spark.read.format("jdbc").option("url", "jdbc:mysql://localhost:3306/carp_db").option("dbtable", "price_features").option("user", "root").option("password", "password").load()

# 构建特征向量,用于聚类分析
cluster_assembler = VectorAssembler(inputCols=["farm_price", "wholesale_price", "supermarket_price", "price_diff"], outputCol="cluster_features")
cluster_data = cluster_assembler.transform(price_df)

# 设置K-Means算法,将价格群体分为3类(偏高价位群体、中位常态群体、偏低价位群体)
kmeans = KMeans(featuresCol="cluster_features", k=3, seed=1)

# 训练K-Means模型
kmeans_model = kmeans.fit(cluster_data)

# 对数据进行聚类预测,打上群体标签
clustered_data = kmeans_model.transform(cluster_data)

# 计算聚类中心,用于分析不同群体的价格特征
centers = kmeans_model.clusterCenters()
print("Cluster Centers: ")
for center in centers:
    print(center)

# 使用轮廓系数评估聚类效果
evaluator = ClusteringEvaluator(featuresCol="cluster_features", predictionCol="prediction", metricName="silhouette")
silhouette = evaluator.evaluate(clustered_data)
print("Silhouette with squared euclidean distance = " + str(silhouette))

# 将分群结果保存至MySQL,供前端Echarts图表展示
clustered_data.select("farm_price", "wholesale_price", "supermarket_price", "prediction").write.format("jdbc").option("url", "jdbc:mysql://localhost:3306/carp_db").option("dbtable", "price_clusters").option("user", "root").option("password", "password").mode("overwrite").save()💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询