长上下文 Agent 的成本,本质上只有两笔账:一次性算完 prompt 的计算量,和之后每一步都要背着的 KV 缓存。 前者随序列长度线性增长,后者要常驻显存,还要在 HBM、主机内存、SSD 之间来回搬。
上个月的普遍判断是:KV Cache 已经不是首要矛盾了------压缩到这个程度,再压的边际收益有限。
9 月 10 日,DeepSeek 用一份 51 页的技术报告回应了这件事:V4.1-Flash 把常驻 HBM 的全局 KV 从上一代的 3514 字节/token 压到 890 字节/token ;持久化 KV 压到上一代的约 1/8 ;上下文从 4K 拉到 1M(256 倍),单 token 解码 FLOPs 只增加约 25%。
但这份报告最有价值的部分不是这些数字,而是它诚实地交代了三件事:解码计算量一点没省、持久化 KV 的重建是近似的、以及"缓存恢复边界"还需要更多压力测试。 这篇文章讲清楚它改了什么、没改什么,以及你的场景到底该不该上。
一、旧范式的原罪:两笔账,而且是分开的两笔
标准 Decoder-only Transformer 在长上下文下的开销来自两处,性质完全不同:
| 成本 | 复杂度 | 发生时机 | 受什么约束 |
|---|---|---|---|
| Prefill(预填充) | O(N·L),随序列长度 N 与层数 L 线性增长 | 每轮请求一次(前缀命中可省) | 算力(FLOPs) |
| KV Cache 常驻 | O(N·L·d),随上下文累积 | 请求整个生命周期 | 显存容量 + 访存带宽 |
| Decode(解码) | 每步读一遍相关 KV | 每个输出 token 一次 | 访存带宽 |
关键在最后一行:解码阶段的性能瓶颈通常不是算力,而是把 KV 从显存搬进计算单元的带宽。 上下文越长,每一步要搬运的数据越多。
Agent 场景把这个矛盾放大了。一份技术报告里的表述很准确:长程 Agent 让工作负载越来越 input-heavy(输入重)------一次任务包含数百次工具调用,上下文轻松到几十万 token。于是 prefill 的计算、KV 的存储、KV 的搬运,三样一起构成部署成本的主要瓶颈。
markdown
Decoder-only 的成本随上下文长度的变化

  成本 │
       │                                    ╱ KV 存储(线性增长 → 显存墙)
       │                              ╱
       │                        ╱
       │                  ╱
       │            ╱
       │      ╱
       │  ╱ ──────────────────────────────── Prefill 计算(线性增长)
       └────────────────────────────────────► 上下文长度
          4K                              1M

  V4.1-Flash 的目标:把这两条线的斜率都压下来
二、先把口径算清楚:890 字节到底是什么
这是最容易误读的一步。报告里的"890 字节/token"不是"这个模型的 KV 只有 890 字节",它有非常明确的限定。
2.1 每 token 的 KV 分两类
V4.1-Flash 除最前两层外,每一层都有两条注意力分支:
| 分支 | 覆盖范围 | 产生的 KV | 随序列长度怎么变 |
|---|---|---|---|
| global(全局注意力) | 整个上下文 | main KV (压缩后的 KV 条目)+ indexer K(供稀疏选择打分) | 线性增长 ← 长上下文的大头 |
| SWA(滑动窗口注意力) | 最近 128 个 token | SWA KV(窗口内未压缩) | 只取决于窗口大小,恒定 |
890 字节/token 说的是 global 分支那两类(合称 global KV)常驻 HBM 的量。 不含 SWA KV,不含 Engram 参数,不含激活值,不含模型权重。
2.2 三级存储,各层保留策略完全不同
| 层级 | 放什么 | 介质 | 保留时长 |
|---|---|---|---|
| 运行时常驻 | 活跃请求的 global + SWA KV | HBM | 请求生命周期 |
| SWA 复用池(V4.1 起新增) | SWA KV,供活跃会话跨轮复用 | 每台机器划出的 10% 主机内存 | 分钟级 TTL |
| 持久化层(persistent KV) | 供跨请求复用的 KV | SSD + 主机内存 | ≥ 72 小时,LRU 管理 |
第二、三层用的是同一类介质(主机 DRAM),区别在保留策略:SWA KV 只在活跃会话的分钟级窗口里被复用,把它塞进 72 小时的前缀缓存纯属浪费。
2.3 1/4 和 1/8,是两个相乘的因子
这是整篇报告里最漂亮的一处算术,也是最容易被人混为一谈的地方:
csharp
V4 的持久化 KV
├── SWA KV   ≈ 一半容量  →  V4.1 不再持久化(改放主机内存专用池 + 有界重放)
└── global KV ≈ 另一半   →  V4.1 用 CSA2 + FP4 压到 1/4

              1/2  ×  1/4  =  1/8
              ↑           ↑
        SWA 退出持久层    global KV 本身(架构 + 精度)
"1/4"是 global 分支 KV 本身的压缩比,"1/8"是再叠加架构层面的存储调度之后的部署结果。 两个数字都对,但说的不是同一件事。
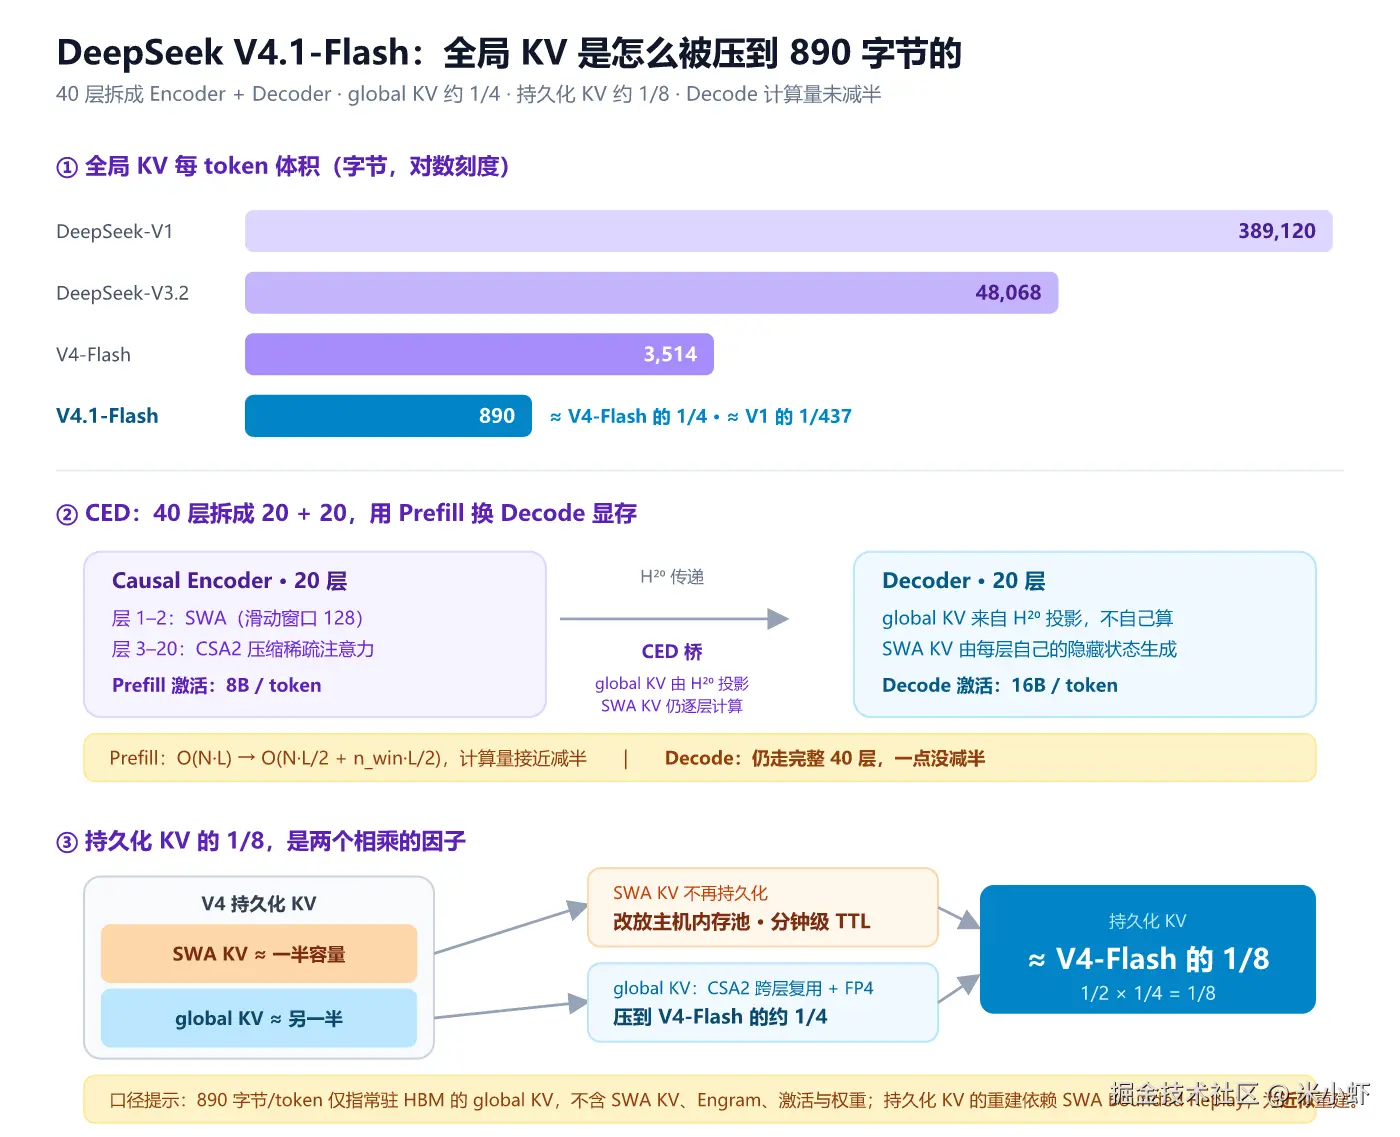
历代对比(同口径,报告 Figure 1(b)):
| 代次 | 全局 KV(字节/token) | 相对 V4-Flash |
|---|---|---|
| DeepSeek-V1 | 389,120 | --- |
| DeepSeek-V3.2 | 48,068 | --- |
| DeepSeek-V4-Flash | 3,514 | 1× |
| DeepSeek-V4.1-Flash | 890 | 约 1/4(相对 V1 约 1/437) |
还有一处常被误用的对比:vLLM 博客曾给出 V4-Pro 在 1M 上下文、bf16 下约 9.62 GiB/序列 。这个数字和 890 B/token 不能相除 ------前者是 61 层、bf16、含 main KV + c4a 索引器 + SWA 窗口;后者是 40 层、main KV 为 FP4、只算常驻 HBM 的 global KV。异源数字相除没有意义。9.62 GiB 的唯一用处是提供量级感:890 B/token 在 1M 上下文下不到 1 GB。
三、理论骨架:KV 成本的三个乘性维度
报告 §2.3 是全文理论价值最高的一段。它把 KV 存储拆成三个相乘的维度:
arduino
KV 存储成本 = entry size(每个条目多大)× sequence(几个 token 压成一条)× layer(几层共用一份)| 维度 | 怎么压 | 代表工作 |
|---|---|---|
| entry size | GQA 减 KV 头数;MLA 用低秩 latent 表示 | GQA、MLA |
| sequence | 每 m 个 token 压成一个条目 | CSA、HCA(V4) |
| layer | 跨层复用 KV 或索引 | IndexCache、YOIO、HySparse |
然后报告点名了现有跨层工作的三个缺口,这段话值得原样记下来:
- IndexCache :复用 Top-K 索引,省下的是索引计算,不省 main KV 存储;
- YOIO :稀疏路由算一次全层共享,但全网络共享限制了性能;
- HySparse :稀疏层复用稠密层的 KV,仍是 hybrid 设计,保留了全量注意力层。
结论是:没有一个是三个维度同时覆盖的。 CSA2 的主张就是三个一起上,并且把"缓存共享"和"索引复用"解耦------这两件事从此可以独立决定。
这里有一处与业界既有判断的正面冲突。此前有一种看法是:V4 压缩后单层每 token 只剩约 18 字节,跨层共享"基本无意义"------看起来确实没有压缩余地了。V4.1 给出了相反的答案:当单层的绝对量已经很小,压缩的杠杆就从"每层压多少"转向了"几层共用一份"。
四、CED:把 prefill 砍一半,代价写在同一页上
4.1 机制
CED(Causal Encoder-Decoder)的灵感来自 YoCo:让 Transformer 的上半层直接共享下半层产生的 KV。V4.1 在此基础上改了两件事------KV 的容量,以及 KV 生成的计算深度。
40 层被切成两半:
yaml
                    Causal Encoder (20 层)              Decoder (20 层)
                 ┌─────────────────────────┐        ┌──────────────────────┐
   Embedding ───►│ 层 1-2:  SWA (窗口 128) │        │                      │
                 │ 层 3-20: CSA2           │──H²⁰──►│  global KV 由 H²⁰ 投影│──► 输出
                 │                         │  CED 桥│  SWA KV 仍逐层计算    │
                 └─────────────────────────┘        └──────────────────────┘

   Prefill: prompt token 走完 Encoder 即停 → 只需算一半层
   Decode:  生成一个 token 仍走完整 40 层
Decoder 的 global KV 不从自己的隐藏状态来,而是从 Encoder 最后一层的隐藏状态投影得到(报告式 1):
ini
C_l = H_{L/2} · W_l^KV , Z_l = H_{L/2} · W_l^Z , l > L/2于是 prefill 复杂度从 O(N·L) 降到近似 O(N·L/2 + n_win·L/2),长 prompt 的计算量接近减半。
config.json 里 kv_source_layer_ids = [2, 8, 14, 20] 正是这四个 Full Mode 层(Encoder 三个 CSA2 组的首层 2/8/14,加上 Decoder 首层 20)------它们是各组 main KV 的生产者,字段名里的"KV 源"指的就是这个。
4.2 代价,报告自己写得很清楚
第一,Decode 计算量一点没减半。 CED 只省了 Prefill;每生成一个 token 仍然要走完整 40 层。
配套的是一组不对称激活:
| 阶段 | 每 token 激活参数 |
|---|---|
| Prefill | 8B |
| Decode | 16B |
这个不对称是对着 Agent 负载的形态设计的------输入重、输出轻,所以 prefill 侧的激活量被单独拿出来优化。
第二,SWA 保留了逐层计算。 CED 刻意让 SWA KV 仍从每层自己的隐藏状态生成(理由是增加 SWA KV 生成的计算深度),代价是 Decoder 侧要额外处理 n_win × L/2 个 token(窗口 128,层数 40)。在短 prompt 的多轮对话里,这笔开销并不小。
这一处正是下面要讲的 SWA Bounded Replay 的由来------SWA 的每个设计决定,后面都要还。
五、CSA2:38 层里只有 8 层在真干活
CSA2(Compressed Sparse Attention 2)把每个层的角色静态分成三种模式:
| 模式 | main KV | indexer K | Top-K 索引 |
|---|---|---|---|
| Full | 自己算 | 自己投影 | 自己跑 indexer 产生 |
| Reindex | 复用前面层 | 复用 | 用自己的 indexer Q 重打分(选择可逐层变化) |
| Reuse | 复用 | 复用 | 复用,不跑 indexer |
三种模式都自己算 main Q 和 SWA KV。
层排布:
- Encoder 的 18 个 CSA2 层:压缩率 2,分 3 组 × 6 层(1 Full + 5 Reuse)
- Decoder 的 20 层:压缩率 1,分 5 组 × 4 层(首组 Full + 3 Reuse;其余 Reindex + 3 Reuse)
38 个 CSA2 层里,只有 4 层产出 main KV ,另有 4 层复用 main KV 但自己重算索引 ,剩下 30 层连索引都直接复用。
分层稀疏索引:把"大海捞针"变成"小池捞鱼"
scss
第 20 层 (Full):对整个上下文打分
         │
         │  历史切成 2048 block × 8 位置 = 16,384 个候选
         ▼
   选出 Top-512 ──────► 构建 Shared Candidate Pool(固定大小)
                                   │
   后续 Reindex 层 ────────────────┘
         只在这个池内打分,不再扫描全上下文
         → 搜索规模被候选池设置"封顶",复杂度近似常数
这是"上下文涨 256 倍、Decode FLOPs 只涨约 25%"的关键之一。
CSA2 相对上一代 CSA 还做了几处简化:去掉重叠窗口、去掉绝对位置编码、indexer Key 直接从 main KV 投影得到(而不是走一条独立的隐藏状态压缩路径)------压缩路径与索引路径解耦。
六、FP4 与有界重放:两个"看起来省了,其实换了东西"的设计
6.1 FP4 Main KV
| 项 | 设置 |
|---|---|
| main KV 精度 | FP4(E2M1),每 16 通道共享一个 E4M3 scale(NVFP4 去掉 global scale) |
| SWA KV 精度 | FP8 |
| 引入方式 | 后训练阶段的量化感知训练(QAT) |
| 效果 | 相对 V4 的 FP8 缓存,存储再降约一半 |
注意报告里 Decode FLOPs 那条曲线是按精度加权计算的(BF16 记 1、FP8 记 0.5、FP4 记 0.25)。所以 FP4 的引入本身就在往下压这条曲线------"只涨 25%"这个漂亮数字里,有一部分是精度换算贡献的,不全是架构功劳。
6.2 SWA Bounded Replay:持久化 KV 的重建是近似的
如果还把每层的 SWA 状态都持久化,前面省下的存储会被吃回去。V4.1 的做法是:
- SWA KV 不再落 SSD,改放每台机器划出 10% 主机内存的分布式池,分钟级 TTL;
- global KV 保留 72 小时;
- miss 时,用 Encoder SWA Bounded Replay 只重放最近 128 个 token 来重建,而不是重放
层数 × 窗口个 token。
但这是近似重建。 精确重建需要把窗口通过每一层相关层重放一遍。报告称在其测试条件下退化可忽略,同时明确写道:缓存恢复边界(cache-resumption boundaries)是一个需要更多压力测试的领域。
这句话应该被每个打算在生产里依赖持久化 KV 的团队抄下来。
七、顺带一提:Engram 和另外三板斧
Engram(196B 条件记忆) :放在第 1、14 层,用 N-gram 哈希去查一张超大 Embedding 表(2/3/4-gram,每阶 8 个 hash head,每 head 约 16M 条目,FP8,放主机内存 + RDMA 预取)。思路是用查表替代重复的模式化 Attention ,把早期网络深度和 Attention 容量释放出来。官方数据:在 Multi-Query Needle-in-a-Haystack 上把分数从 84.2 提到 97.0。
Single-Pass mHC :把输入混合系数提前一层,解除输入混合与系数预测的依赖,让融合 kernel 能把激活内存流量从 (4n+4)d 降到 (2n+2)d,接近理论下界。
DSpark 投机解码 :dspark_block_size = 5,目标层 [37, 38, 39],预训练后冻结骨干单独训练。
训练侧 :45T 多模态 token(文本:多模态 ≈ 7:1);稀疏注意力从零训练 ,64K 序列长度,无 dense warmup ;在 34T token 处把上下文扩到 1M。后训练没有新算法,增益来自大规模可验证 Agent 任务合成、跨异构 scaffold 的 RL(Claude Code / Codex / OpenCode / Pi / mini-SWE / 自研 Harness),以及 40+ 教师的 on-policy 蒸馏。
八、理想丰满,现实骨感:五个工程死结
这一节决定了你该不该上,比前面所有数字都重要。
死结一:Decode 没有变便宜,变便宜的是显存
CED 只省 prefill。对"短 prompt、多轮、小输出"的典型对话场景,收益几乎全部来自 KV 压缩,而不是算力。 而这类场景本来就不受显存墙约束------它受的是首 token 延迟和单步延迟约束。
更麻烦的是:SWA 逐层计算被保留,短 prompt 下 n_win × L/2 这笔开销占比反而更高。
判据:你的负载是不是 input-heavy? 一次任务几百次工具调用、上下文几十万 token------是,CED 直接命中;几轮十几个 token 的问答------不是,你在为别人设计的约束付复杂度成本。
死结二:890 字节不会出现在你的 nvidia-smi 里
890 B/token 只算常驻 HBM 的 global KV。真实部署还要加上:SWA KV、Engram 的主机内存与 RDMA 预取开销、激活值、MoE 路由的专家参数常驻、以及框架本身的碎片。
论文数字和显存读数之间隔着一整个 serving 栈。 做容量规划时,用同代同条件的倍数(1/4、1/8)比用绝对值可靠。
死结三:稀疏注意力是近似的,Top-512 意味着绝大多数位置从未被打分
每层只读 512 个位置,而且后续 Reindex 层只在一个 16,384 的固定候选池里选。这是一个"先粗筛再精选"的结构,粗筛漏掉的,后面再也找不回来。
对"大海捞针"式的精确检索,风险是实打实的:如果那个关键信息在第 20 层的首次全量扫描里没进候选池,它在后面所有层都不会被看到。Engram 把 Multi-Query NIAH 从 84.2 提到 97.0 这个数据反过来说明------基线是 84.2,不是 100。
死结四:FP4 main KV 的精度损失没有公开的边界
main KV 量化到 E2M1(4 bit),这是通过 QAT 引入的,说明它是有损的,且需要训练配合。但报告没有给出"什么类型的任务上会崩"的公开边界。
保守做法:数值敏感、金融计算、需要精确复现长程推理链的任务,先跑自己的回归集再决定。 精度损失在 Agent 循环里会被步数复合放大------这正是我们在《4-bit 量化"几乎无损"?》那篇里讲过的同一类问题,只是这次损伤发生在 KV 而不是权重。
死结五:benchmark 口径差异大到不能混用
这是最需要警惕的一条。同一系列 benchmark,报告给出了两个差了 60 分的数字:
| Benchmark | V4.1-Flash 得分 | 对手区间 / 说明 |
|---|---|---|
| Terminal-Bench 3.0 | 30.0 | 对手 17.7--43.3 |
| Terminal-Bench 2.1(DeepSeek 自家 Harness) | 90.5--90.6 | 厂商自测口径 |
| DeepSWE v1.1 | 74.2 | 对手 66.9--74.0 |
| CyberGym | 88.1 | 对手 80.0--84.5 |
| Automation-Bench | 54.8 | 对手 45.8--50.3 |
版本不同(2.1 vs 3.0)、Harness 不同(第三方 vs 自家),不能直接相减 。但它说明了一件事:同一家厂商、同一个 benchmark 名字,口径差异可以造成 60 分的量级差。
官方也标注了"上述指标属于内部框架与自测口径,独立第三方评测仍待社区验证"。另外,多 Agent 的收益报告自己承认是 early results,且 wall-clock 收益"高度依赖 Harness 设计与子 Agent 隔离质量"(ProgramBench 8h:30.04% vs 单智能体 20.39%)。
九、什么场景赚,什么场景亏
赚的场景
| 场景 | 为什么赚 |
|---|---|
| 长程 Agent / 编码智能体(数百次工具调用) | input-heavy 正对 CED 的靶心;KV 是主要瓶颈 |
| 长文档问答、代码库级检索 | 1M 上下文 + 890 B/token,显存不再是约束 |
| 高并发、长会话的在线服务 | 单会话 KV 占用降到 1/4,直接换算成并发密度 |
| 重复局部模式密集的任务(代码、结构化文档) | Engram 的查表记忆命中率高 |
亏的场景
| 场景 | 为什么亏 |
|---|---|
| 短 prompt、多轮、小输出 | CED 省的是 prefill,你不受 prefill 约束;SWA 逐层重算反而占比更高 |
| 数值/金融敏感任务 | FP4 main KV 的有损性没有公开边界 |
| 依赖长上下文精确检索、且失败代价高 | Top-512 + 固定候选池是粗筛,漏了找不回来 |
| 高度创造性、低重复的任务 | Engram 的 196B 参数可能变成纯负担 |
| 想自己复现这套架构的团队 | 稀疏注意力需从零训练(64K,无 dense warmup)、34T token 处扩到 1M------这不是微调能解决的 |
决策树
css
你的负载是 input-heavy 吗(上下文 > 100K,工具调用频繁)?
│
├─ 否 ──► 别为 CED 付复杂度成本。选一个同能力的标准架构模型,
│         把精力放在 prompt 与工具设计上。
│
└─ 是 ──► 显存是主要瓶颈吗(并发上不去 / KV 落盘)?
          │
          ├─ 否 ──► 你受的是延迟约束,CED 帮不上。先看投机解码与批处理。
          │
          └─ 是 ──► 任务对长程精确检索的容错度如何?
                    │
                    ├─ 低(法务/金融/医疗)──► 跑自己的 needle-in-a-haystack 回归集,
                    │                        重点测"关键信息不在候选池"的场景;
                    │                        同时评估 FP4 对数值任务的影响。
                    │
                    └─ 高(编码/文档/通用 Agent)──► 上。
                       并做三件事:
                       1) 用 1/4 和 1/8 做容量规划,不要用 890 B/token 绝对值
                       2) 压测缓存恢复路径(报告自己说这里需要更多测试)
                       3) 用 reasoning_effort 做成本闸门(报告称 60--80 已拿到
                          大部分 Max 能力,effort 25→100 输出 token 约 2.5 倍)
十、我的判断
第一,这不是一次"KV 压缩",是一次架构范式的回潮。 Encoder-Decoder 在 LLM 时代被 Decoder-only 打了很多年,现在它回来了,但回来得很有针对性------不是为了更好的表示学习,而是为了把"读"和"写"的成本拆开:读 prompt 走一半网络,写 token 走全部网络。这个拆分能不能成立,取决于负载是不是真的读多写少。Agent 是,聊天不是。
第二,真正的创新是"三个乘性维度同时压缩 + 缓存共享与索引复用解耦"。 此前业界的共识是单层 KV 已经压无可压、跨层共享"基本无意义"。V4.1 证明了:当单维度的边际收益耗尽,杠杆会转移到维度之间的组合方式上。这个方法论比 890 这个数字更有迁移价值。
第三,1M 上下文是能力,不是刚需。 多数业务 prompt 远不到 1M。为"能否撑住 1M"付出的架构复杂度------分层索引器、候选池、FP4 反量化内核、Engram 的 RDMA 预取------是否对你的场景划算,只能靠自己的回归集回答。别因为一个模型宣称支持 1M 就把它当成选型理由。
第四,最值得关注的下一个信号不是 KV 数字,是第三方复现。 现在所有漂亮数字都是厂商自测。等到有独立团队在非自家 Harness 上跑出 Terminal-Bench 3.0 的分数、以及有人在"缓存恢复边界"上做出压力测试,这套架构的真实边界才算被标定。在那之前,把它当成一份设计文档读,而不是一份性能保证书。
参考
- DeepSeek-V4.1-Flash 技术报告(51 页,2026 年 9 月),模型仓库:
deepseek-ai/DeepSeek-V4.1-Flash(Hugging Face,MIT 许可)。本文所有架构图与数据表均引自该报告 Figure 1(b)、Figure 2、Figure 3、Figure 4、Figure 6,并与官方config.json字段逐条核对。 - 相关架构:YOCO(You Only Cache Once)、MLA(Multi-head Latent Attention)、GQA、DeepSeekMoE、NVFP4。
- 对比工作:IndexCache、YOIO、HySparse(报告 §2.3 点名的三个跨层共享方案及其缺口)。
- vLLM 关于 V4 在 1M 上下文下约 9.62 GiB/序列的估算(bf16、61 层、含 main KV + c4a 索引器 + SWA 窗口)------与 890 B/token 不同口径,不可直接比较。
- 部署路径:vLLM、SGLang、Transformers;API 提供
reasoning_effort(Low=50 / High=75 / Max=100)。
免责说明:本文引用的 benchmark 数字均为 DeepSeek 官方自测口径,其中 Terminal-Bench 存在 2.1(自家 Harness,90.5--90.6)与 3.0(30.0)两个不同版本与 Harness 的结果,不可直接对比。多 Agent 相关结论报告自述为初步实验结果。独立第三方评测结果以社区复现为准。