摘要 :本文解读 AISTATS 2011 论文 A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning。行为克隆在专家数据上训练,但部署时模型会走到自己造成的状态,离线准确率无法直接换算成自主运行可靠性。DAgger(Dataset Aggregation)让学习者产生自己会遇到的状态,请专家为这些状态标注动作,再把新旧数据聚合训练,从而把模仿学习归约为无遗憾在线学习。文章依次说明离线准确率与自主运行的差距、一次失误为何拖累后续多步、DAgger 的"谁执行、谁标注"循环、无遗憾理论保证、任务代价与模仿误差的关系、原论文三个实验,并给出一个 20 步抽象控制环境的实际运行例子,最后推演如何把该思想用于 LLM 工具调用智能体。
一个代码智能体在示范数据里学会了"读文件、改代码、跑测试"。离线评测不错,真正交给它一个仓库,却可能在第一次切错目录后连续调用错误的路径。接下来的输入,已经不是示范里那些整洁的上下文了。
这时,再补充一百条成功示范,未必能告诉它:当你已经走偏,下一步应该怎么办。
2011 年,Stéphane Ross、Geoffrey J. Gordon 和 J. Andrew Bagnell 提出了 DAgger,名字来自 Dataset Aggregation,数据聚合。它把这个问题落到一个可操作的训练循环:让学习者产生自己会遇到的状态,请专家为这些状态标注动作,再把新旧数据放在一起训练。1
本文解读 AISTATS 2011 的会议论文 A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning。下文分开说明原论文的结果、本文实际运行的教学例子,以及面向 LLM 智能体的工程推演。原实验使用线性模型,论文没有做大语言模型实验。
离线准确率,回答了哪个问题
先想象一辆从专家驾驶中学习转向的车。训练集里,车通常位于道路中间,方向盘的动作也很小。学习者稍微打偏一次,车靠近路边;再下一步,它看到的道路构图已经变了。原来的训练集可能几乎没有这种画面。
问题不只在于"犯了一次错"。这次动作还改变了后续输入。
普通行为克隆(Behavioral Cloning,BC)在专家数据上做监督学习。假设专家是 π*,学习者是 π,任务持续 T 步。用 dₜ(π) 表示执行 π 时,第 t 步的状态分布;把各时刻平均起来,得到访问分布:
d_π = (1/T) Σₜ₌₁ᵀ dₜ(π)
这里的"状态分布"可以理解为:在许多次运行中,模型有多大概率出现在每一种局面。它由环境和策略共同决定。同一个模型换一个动作,下一步到达哪里也可能改变。
设 ℓ(s, π) 是在状态 s 上,π 与专家的模仿损失。BC 通常最小化 E_{s∼d_π*}ℓ(s, π) ,但自主执行更关心 E_{s∼d_π}ℓ(s, π)。前一个期望由专家带路,后一个由学习者自己带路。1, §2
两者可能相差很大。专家附近的 95% 准确率,不能直接读成自主运行时每一步都有 95% 的可靠性。
对代码智能体也一样。上下文不仅包含用户需求,还包含先前调用的工具、工具实际返回的错误、当前文件和已完成的操作。训练只见过正确路径,部署却要求它理解"文件不存在""测试执行了一半""已经写入了错误内容"。这些状态并不会因为成功示范变多而自动出现。
这也解释了论文标题里的"结构化预测"。识别一个单词时,如果模型把前一个字符的预测作为后一个字符的输入,那么先前的预测就成为后续状态的一部分。外部环境很简单,输入分布仍会被模型自己改变。
一次失误,为什么可能拖累后面很多步
把每步任务代价 C(s, a) 归一化到 0, 1,总期望代价记为 J(π)。代价可以是偏离道路,也可以是一个需要惩罚的错误;它不必等于训练用的模仿损失。
若学习者在专家访问分布上的动作错误率为 ε,经典最坏情况上界是:
J(π) ≤ J(π*) + T²ε
这个二次项有一个直观来源:第 t 步之前的任意一次偏差,都可能把系统送出专家数据覆盖的区域。粗略用联合界估计,前面出过错的概率随 t 增长,再把所有时刻的损失加起来,就出现了 T² 量级。1, §2.1
它是最坏情况界,并不意味着每个 BC 系统都会出现平方增长。因为每步代价至多为 1,总代价本身不会超过 T;当 T²ε 已经很大时,这个界也可能没有实际预测价值。
因此,"20 步、每步准确率 95%,成功率就是 0.95²⁰"只适合非常特定的独立性与失败定义。一般交互任务里,各步输入会变,各步错误会相关,有些错误能恢复,有些错误会终止任务。直接连乘,会把这些差异全部藏起来。
DAgger 对准的是其中一个可改变的因素:学习者出错后见到的状态,也应该进入监督学习的数据。
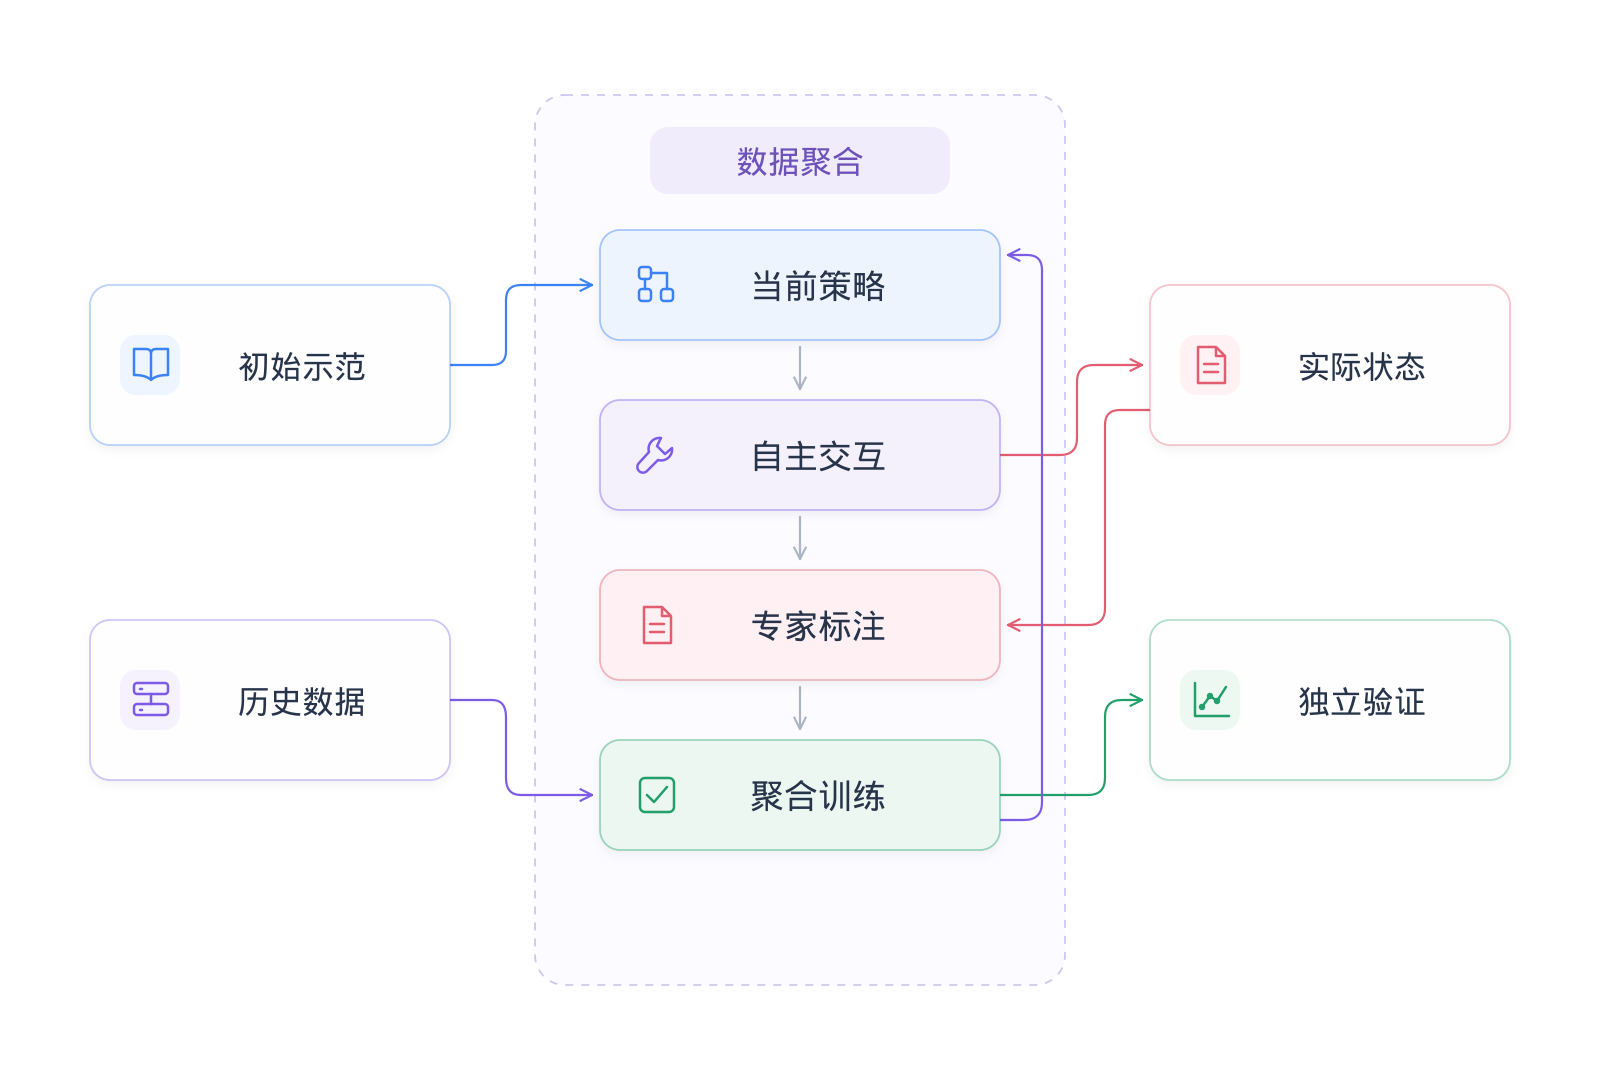
图 1|数据聚合的训练循环。中央箭头表示一轮中的主要步骤,右侧"实际状态"提供专家标注的输入,左侧"历史数据"进入聚合训练,紫色回路表示更新后继续采集。初始专家示范可用于启动;最终策略通过独立验证选择。为突出主体,图中没有展开逐步的专家接管概率。根据原算法重绘。1, §3
DAgger 的关键:让谁执行,让谁标注
DAgger 并没有要求换掉监督学习算法。它改变了训练样本从哪里来。
第 i 轮,当前学习者是 π̂ᵢ。采集策略允许以概率 βᵢ 执行专家动作,以概率 1−βᵢ 执行学习者动作,记作 πᵢ = βᵢπ* + (1−βᵢ)π̂ᵢ。这是每一步随机选择谁控制,不是把两个方向盘角度求平均,也不是把两个 LLM 的 token 概率直接混合。
一个完整的训练循环是:
- 用 πᵢ 在环境中运行,记录实际访问的状态。
- 对这些状态查询专家动作,形成 Dᵢ = {(s, π*(s))}。
- 把 Dᵢ 加进历史数据 D,而不是用它替换全部旧数据。
- 在聚合数据上训练下一个学习者 π̂ᵢ₊₁,保存这一轮模型。
- 继续采集和训练,最后用验证表现选择策略。1, §3
第二步最容易写错。如果模型在状态 s 上执行了错误动作 a,却把 (s, a) 原样当作监督目标保存,那么它可能只是再次学会自己的错误。DAgger 要保留的是状态 s 与专家给出的动作,实际执行动作另外记录。
βᵢ = 0 只表示专家不接管环境,仍然需要查询专家标签。这里的"自主"描述执行权,不代表训练摆脱了专家。
一种简单做法是首轮完全由专家执行,之后全部由学习者执行。也可以让 βᵢ 按 pⁱ⁻¹ 衰减,给早期策略一些帮助。原文要求平均接管概率 (Σᵢβᵢ)/N 随 N 增大趋向零;定量的轮数结论还使用更具体的衰减条件。逐渐减少接管,是为了让采集分布越来越接近学习者独立运行时的分布。
即使每步接管概率不大,长任务里"至少接管一次"的概率仍是 1−(1−βᵢ)ᵀ。在 100 步任务中,每步 1% 的接管概率,对应约 63.4% 的整条轨迹曾被干预。这是按公式计算的说明值。把这种评测叫作完全自主运行,会高估模型本身的能力。
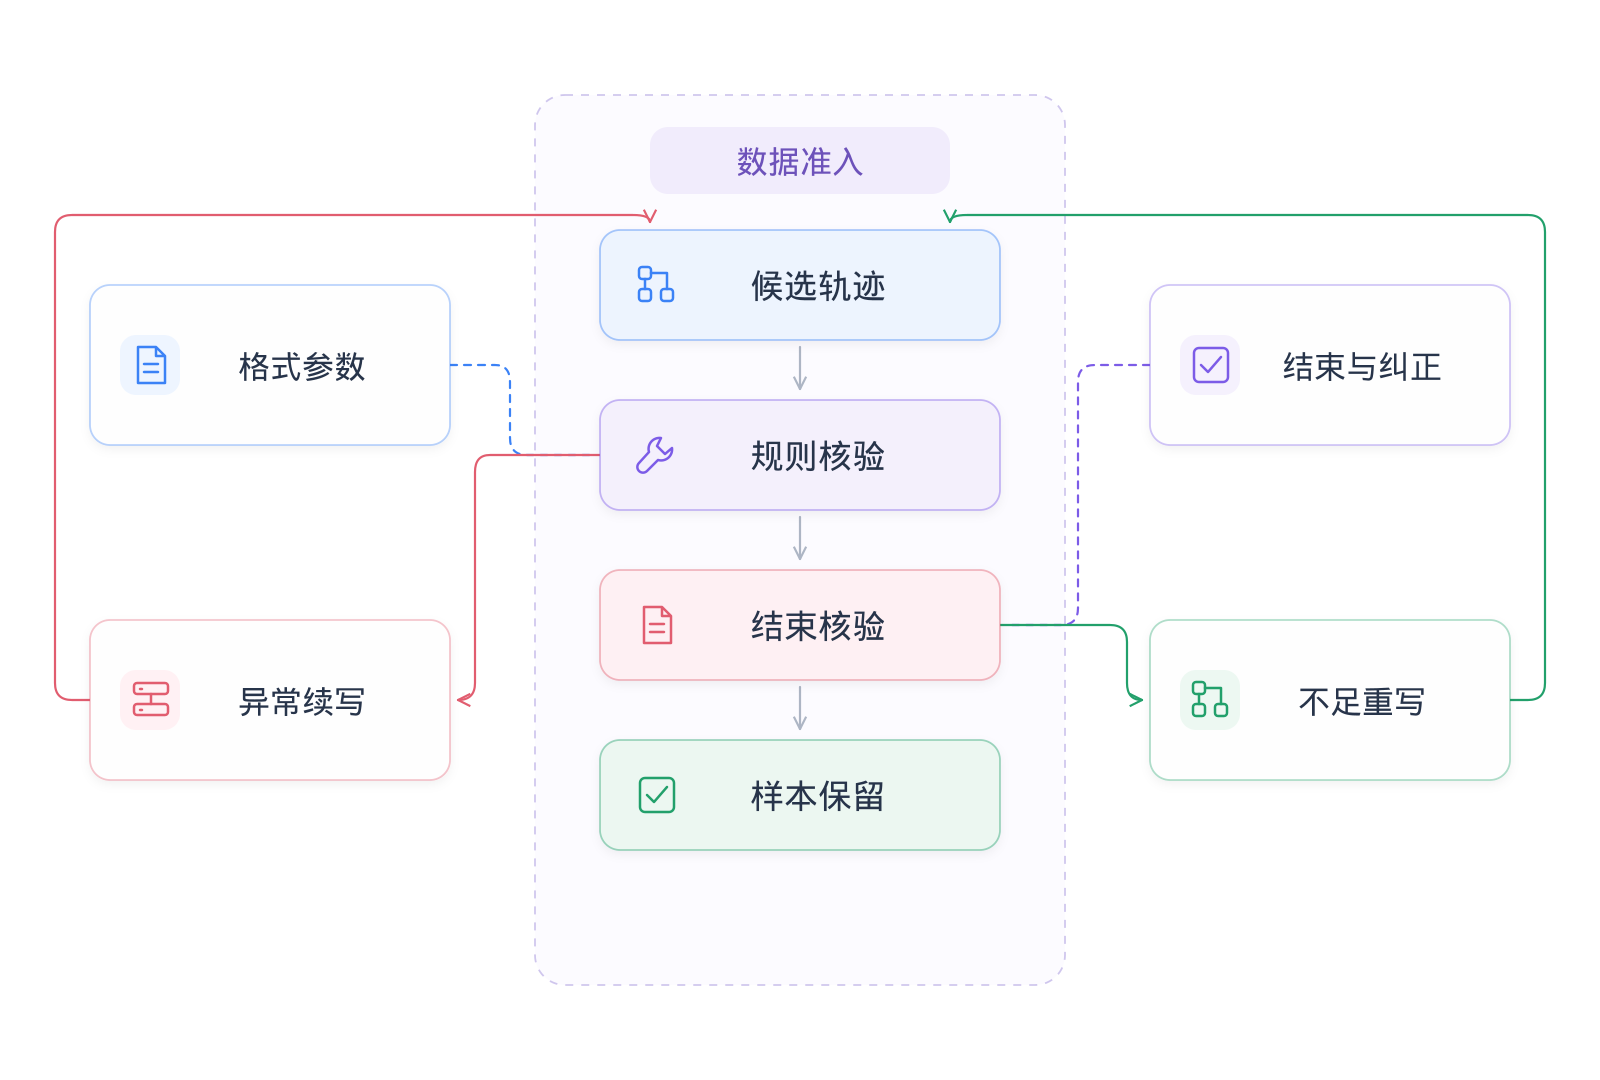
图 2|执行动作与监督标签分开保存。图中学习者在当前状态执行动作,环境产生后续状态,再对这个后续状态查询专家纠正;监督对是"后续状态---专家纠正",不能错配到先前状态。循环实现也可以在每个当前状态先查询标签、再执行学习者动作,配对原则相同。查询专家本身不会改变环境;需要接管时,才另外执行专家动作。
一个最小循环可以写成:
python
data = initial_expert_examples
learner = fit(data)
checkpoints = [learner]

for beta in beta_schedule:
    batch = []
    state = env.reset()
    while not env.done:
        expert_action = expert.label(state)      # 当前状态的监督目标
        learner_action = learner.act(state)
        batch.append((state.snapshot(), expert_action))
        executed = expert_action if random() < beta else learner_action
        state = env.step(executed)                # 由实际执行动作推进环境
    data.extend(batch)
    learner = fit(data)                           # 包含历史数据
    checkpoints.append(learner)

return select_on_autonomous_validation(checkpoints)
这段代码是机制伪代码,省略了多条轨迹采样和具体训练器。实际实现还要保存执行动作、下一状态以及策略版本,才能审计样本的来历。官方 imitation 库的采集器也明确区分保存的专家动作和真正送入环境的动作。3
"聚合"有另一个作用:保留过去轮次已经发现的局面。只训练最新一批数据,可能修好这轮问题,又忘掉之前的能力。DAgger 可以看作 Follow-The-Leader:每轮重新寻找在目前所有数据上表现好的策略。不过,这种直觉还不等于任何训练器都拥有下一节的理论保证。
为什么它能被归约为"无遗憾"在线学习
在线学习中的"轮"是一次采集与更新,不是一次工具调用。每轮都会产生一个新的损失函数:
fᵢ(π) = E_{s∼d_πᵢ}ℓ(s, π)
这一轮见过哪些状态,就在这些状态上比较不同策略的模仿损失。后续轮次的状态分布会变化,在线学习正好允许损失随轮次变化。
把策略类记为 Π。事后看完 N 轮,选一个固定策略,在全部轮次上取得的最小平均损失是 ε_N:
ε_N = min_{π∈Π} (1/N) Σᵢ₌₁ᴺ fᵢ(π)
再把算法实际使用的策略序列,与这个固定策略比较,平均遗憾为:
γ_N = (1/N) Σᵢ₌₁ᴺ fᵢ(π̂ᵢ) − ε_N
无遗憾算法保证这项差距的上界随轮数增加趋近于零。"事后最优"仍然受 Π 的表达能力限制;它不是可以每轮重新挑选、每个状态都正确的无限能力专家。
如果图像太模糊、模型没看到必要的历史,或策略类表达不了专家行为,ε_N 可以一直很大。DAgger 能改变数据覆盖,不能凭空补回模型输入里缺失的信息。
证明还要处理一个差别:训练数据可能由专家与学习者的混合策略采集,部署却只运行学习者。用同一组环境随机性耦合两次运行,只要这一条轨迹从未接管,两者就一致。因此两个访问分布的 L₁ 距离至多为 2Tβᵢ,同时也不会超过 2。1, §4.2
把这部分差异记为 B_N,可得到一个易读的保证:
minᵢ E_{s∼d_π̂ᵢ}ℓ(s, π̂ᵢ) ≤ ε_N + γ_N + B_N
B_N = (2ℓ_max/N) Σᵢ₌₁ᴺ min(1, Tβᵢ)
这是把原文定理 4.1 的证明中间式整理出来的表达;β 非递增时,与原文按 βᵢ 是否大于 1/T 分段的写法对应。ℓ_max 是损失的统一上界。
| 右侧项 | 它在检查什么 | 增加数据是否足够 |
|---|---|---|
| ε_N:策略类中最佳固定策略的损失 | 输入与模型能否学到专家的动作 | 缺失信息或表达能力不足时,通常还要改输入或模型 |
| γ_N:平均遗憾 | 更新过程能否跟上各轮损失 | 需要合适的在线学习方法与优化条件 |
| B_N:混合分布的差异 | 专家接管是否让训练状态偏离自主状态 | 需要控制接管日程,不能只增加接管下的轨迹 |
**保证的是历史策略里至少存在一个表现好的策略。**它没有承诺每轮都变好,也没有承诺最后一轮一定最好。原算法写了验证选择,实际训练不应顺手把这一步删掉。
原文用有界、强凸的代理损失来支持 Follow-The-Leader 的无遗憾性质;也允许换用其他具有无遗憾保证的在线算法。深度网络或 LLM 的一次监督微调,并不会自动满足这些前提。把"数据聚合有效"的经验,与"该训练过程满足定理"的证明分开,才方便判断收益来自哪里。1, §3--4
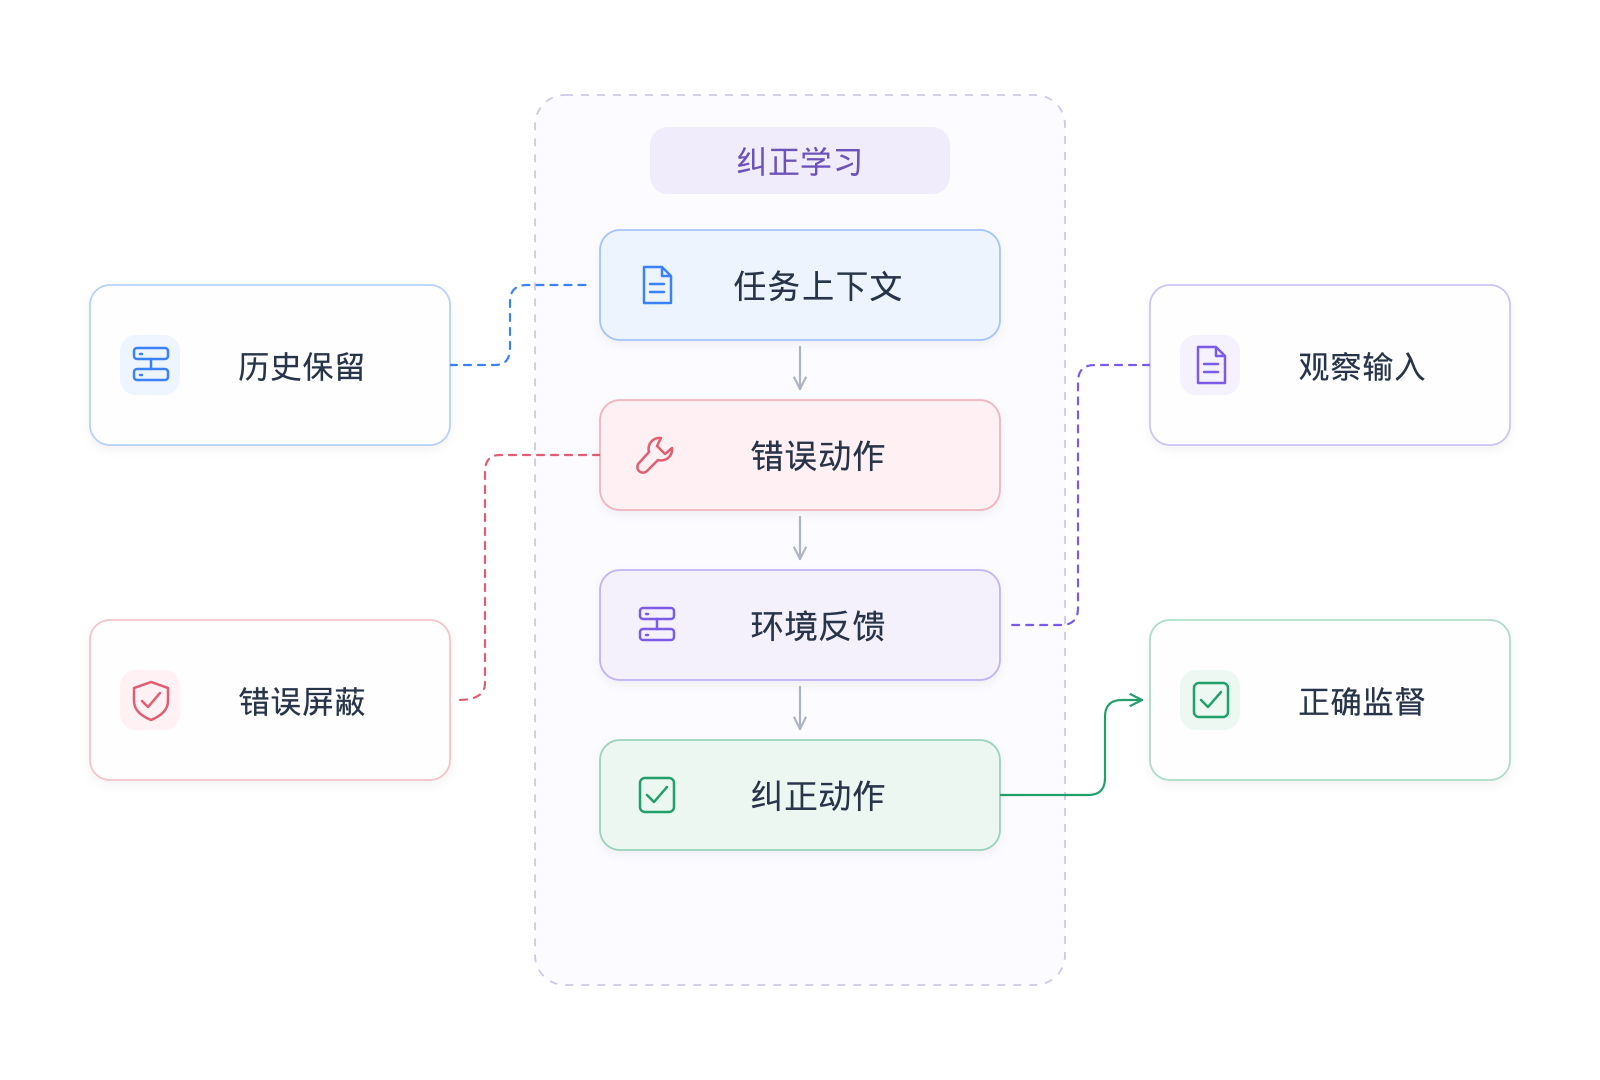
图 3|理论结论的依赖关系。虚线侧卡提示附加项或条件:策略容量进入比较基准,专家混合造成分布差异,有限采样再引入统计误差。自身模仿误差转换成任务代价时,还需要检查出错后的代价增量 u;图中的箭头不表示这些条件会自动成立。
模仿误差下降,任务代价就一定线性下降吗
还需要知道:一个错误动作会带来多大的后续代价。
设学习者在自己访问的状态上,与专家的动作分歧率为 ε。原文用 u 上界这样一种代价增量:在某个状态先执行一个不同动作,然后让专家接手完成剩余任务,相比从这一刻就执行专家动作,最坏会多付出多少代价。
在这个假设下,有:
J(π) ≤ J(π*) + uTε
若专家能很快把偏离的车拉回道路,u 可以与 T 无关;如果一次动作就把车送下悬崖,剩余任务全部损失,u 本身就可能随 T 增长。此时,式子里的 uT 也可能回到 T² 量级。1, §2.2
所以,DAgger 对"能从偏离状态恢复"的任务尤其有吸引力。对于已经不可逆的操作,训练时再准确的下一步标签,也不能把发生过的损失撤回。对智能体而言,是否能回滚文件、重置页面、撤销一次写入,是任务结构的一部分。
还有一个容易混淆的特例:如果任务代价 C 本身被代理损失 ℓ 上界,则可以直接用模仿损失控制总代价。原文给出的 Tε_N + O(1) 属于这种关系;对于任意任务代价,须保留专家基准 J(π*) 和 u,不能把两种结论混写。
理论还有有限数据版本。设每轮采集 m 条轨迹,进行 N 轮,δ 是允许的失败概率。把 ε̂_N 定义为聚合样本上最佳固定策略的平均损失,把 γ̂_N 定义为对这些样本损失的平均遗憾,则以至少 1−δ 的概率,存在一个历史策略满足:
自身模仿损失 ≤ ε̂_N + γ̂_N + B_N + ℓ_max√(2 ln(1/δ)/(mN))
这里用帽子明确区分了样本量与前一节的总体分布量,原文沿用 γ_N 记号。这个额外项提醒我们:采集数量有限,经验损失与真实运行损失还有统计差距。1, §4.2
| 原文结果 | 在原文条件下的充分轮数量级 | 需要一起记住的前提 |
|---|---|---|
| 定理 3.1:自身模仿损失接近 ε_N,差距 O(1/T) | 无限样本时 Õ(T) | 有界强凸损失;专家混合按足够快的日程衰减 |
| 定理 3.2:任意任务代价的对应保证 | 无限样本时 Õ(uT) | 还需代理损失上界动作分歧,以及代价增量界 u |
| 定理 3.3:有限采样下,自身损失接近 ε̂_N | 每轮常数条轨迹时 O(T² ln(1/δ)) | 采样误差也要降到 O(1/T) |
| 定理 3.4:有限采样下,任意任务代价的对应保证 | 每轮常数条轨迹时 O(u²T² ln(1/δ)) | 同时保留 u 和有限采样条件 |
Õ 隐去了对数因子。这些是保证所需的量级分析,不是实践中一定要跑的轮数,也不是任何深度模型的最小样本复杂度。原文讨论了借助强凸性进一步收紧有限采样分析的可能性,但没有把这个可能性当作已经完成的通用结论。
尤其不要把一条长度 T 的轨迹,直接算成 T 个独立样本。相邻状态相互影响。上面的统计项以 mN 条轨迹为单位,不能未经分析就把分母换成 mNT。
原论文的三个实验,分别验证了什么
这篇论文用控制任务和结构化预测检验了同一个想法。各实验的指标不同,不能放进一张"成功率排行榜"。下面只采用正文明确报告的数值或定性描述,没有从曲线像素推断额外的小数。1, §5
| 任务与设置 | 指标 | 原文观察 | 证据边界 |
|---|---|---|---|
| Super Tux Kart,固定赛道与速度;线性转向回归;每轮一圈,约 1,000 个样本,共 20 轮 | 平均每圈跌出赛道次数,越低越好 | DAgger 约在第 15 轮后不再观察到跌出;SMILe 20 轮后仍约每圈 2 次 | 这是该实验中的观察;不能推成任何赛道都不会出错 |
| Super Mario Bros,随机难度 1 关卡,60 秒时限;4 个二元动作的线性 SVM;每轮 5,000 个样本,共 20 轮 | 死亡、超时或通关前的平均前进距离,越高越好 | 首轮后不接管约 2,980;βᵢ = 0.5ⁱ⁻¹ 约 3,030;更慢的衰减收敛较慢 | 数值是距离,不是百分比;0.5 是比较多种日程后的较优结果 |
| 手写单词识别,约 6,600 个词、超过 52,000 个字符;10 折交叉验证,训练 20 轮 | 字符准确率 | 无前字结构特征 82%;结构化监督学习 83.6%;DAgger 85.5% | 从 83.6% 到 85.5% 是 1.9 个百分点;并非在所有对照方法中独占优势 |
赛车控制器读取的是缩小后的图像特征:800×600 的画面变为 25×19 的 LAB 特征,用岭回归预测连续转向,控制频率为 5Hz。这里不是端到端视觉大模型。
Mario 的专家则是能够利用内部状态与环境模拟的规划器;学习者使用 27,152 维稀疏特征,包括当前附近网格、最近四帧、最近六个动作和角色状态,以 5Hz 更新动作。**专家与学习者的信息条件并不相同。**即使数据无限,受限特征也未必能完整表达专家策略,这与理论里的 ε_N 有关。
Mario 的失败局面很有解释力:专家通常提前跳过障碍,学习者却可能贴着障碍卡住。多看"提前跳跃"示范,不一定学会"已经卡在面前时如何脱身"。随着学习者自己运行,DAgger 收集到这些局面,再得到专家动作,才补上了相应训练信号。
OCR 则展示了另一个边界。模型从左到右识别字符,并使用前一个字符作为特征。结构化监督训练可以拿到前一个字符的真值,部署时却只能用模型先前的预测;这是同一种分布偏移,但只影响输入中的一小部分。该实验中,SEARN 的一些设置也取得相近表现,包括不保留历史混合策略的设置。不能把 Mario 中某种更新的不稳定,扩大为它在所有任务中都不行。
在方法脉络上,早期 Forward Training 为不同时间步训练不同策略,对很长的任务不够方便;SMILe 保留历史策略的随机混合。DAgger 通过聚合数据,最后可以部署一个选出的固定策略。这里的"固定"表示同一个策略贯穿任务,不表示环境不变,也不限制输入包含历史。1, §1--22
一个实际运行的小例子:同样 95%,差别在哪里
为了把数据覆盖与模型容量分开,我们构造一个 20 步的抽象控制环境。它不模拟真实赛车,也不复现论文基准;代码只用 Python 标准库,全部结果都来自本次实际运行。
环境中有一次特殊转弯,位置可以是 20 个时间步中的任意一个。正常状态下,专家通常选动作 +1,遇到特殊转弯时选 −1。如果学习者选错,偏移量变为 1;已经偏离时,+1 继续增加偏移,−1 则减少偏移。
**学习者只能观察偏移量,看不到转弯位置;专家能看到完整状态。**学习者按每个偏移量上的专家标签多数决定动作,未见过的偏移量默认 +1。这一限制是刻意设置的:在道路中央,它无法区分普通时刻与特殊转弯,因而保留 5% 的不可消除分类误差。
初始数据包含 20 条专家轨迹,共 400 个标签。专家从不走偏,因此数据全部来自偏移量为 0 的状态。
再给两种方案各 20 个新标签:
- 继续增加专家示范:专家再完整执行一条轨迹,新样本仍全部在道路中央。
- 做一轮数据聚合:让初始学习者执行一条轨迹,对它实际到达的状态查询专家;专家只标注,不接管。学习者出错后越走越偏,因此这一批数据包含偏移量 1 到 13 的纠正标签。新旧数据一起拟合。
采集时,两种方案都把特殊转弯放在从 0 开始计数的第 6 步。评估则穷举全部 20 个转弯位置,每种设置运行 20 步。它是透明的机制演示,不是随机种子统计,也不是留出测试集的泛化实验。
| 运行后得到的指标 | 继续增加专家示范 | 一轮数据聚合 |
|---|---|---|
| 总训练标签数 | 420 | 420 |
| 专家访问状态上的动作准确率 | 95% | 95% |
| 自主运行时,与专家动作一致的比例 | 47.5% | 95% |
| 每条轨迹平均处于偏离状态的步数,越低越好 | 10.5 | 1.0 |
| 任务结束时回到中央的比例 | 0/20 | 19/20 |
聚合后的策略仍会在那次特殊转弯上犯错。但它已经知道:偏移量为 1 时,应该选 −1 回到中央。改善来自"出错后怎样继续",而不是中央状态的离线准确率变高。
它仍有一个失败设置:特殊转弯发生在最后一步,任务已经结束,没有下一步可供恢复。这正好说明恢复机会与任务时限的关系。若把偏离改成不可逆终止,这个环境里的改善也会消失。
素材包中提供完整程序、逐设置 CSV、汇总 JSON,以及逐步的"实际执行动作---专家标签"记录。解压后运行:
bash
python3 demo/run_demo.py程序会重新生成 data/ 下的结果,并检查标签预算一致、专家轨迹不偏离、执行动作与标签确实分开等性质。这个多数表策略不满足本文强凸损失分析的全部前提,因此例子用于解释机制,不用于验证无遗憾定理。
把这个思想用到 LLM 智能体时,先设计标注协议
以下是根据 DAgger 机制做的工程推演,不是 2011 年论文中的实验结论。
对一个工具调用智能体,可以把"状态"视为模型当前能够看到的完整上下文:任务目标、对话与调用历史、工具返回值,以及环境的可观察快照。专家标签可以是一条合法的下一步调用,也可以是带参数的动作。关键是它适用于这一刻真实存在的环境。
比如模型调用了错误路径,工具返回"文件不存在"。老师应根据这个路径错误、当前工作目录和文件快照给出下一步动作。把成功示范里的一条 edit_file 调用直接移植过来,可能引用一个当前根本不存在的文件。
用另一个 LLM 当老师,也只解决了"谁来生成候选标签"。老师能否看见必要状态、参数是否有效、多个合法动作如何处理、执行后是否完成任务,还要有明确的核验协议。在部分可观察环境里,老师拥有隐藏信息时,还应检查学习者是否可能从自己的输入推断同样动作。
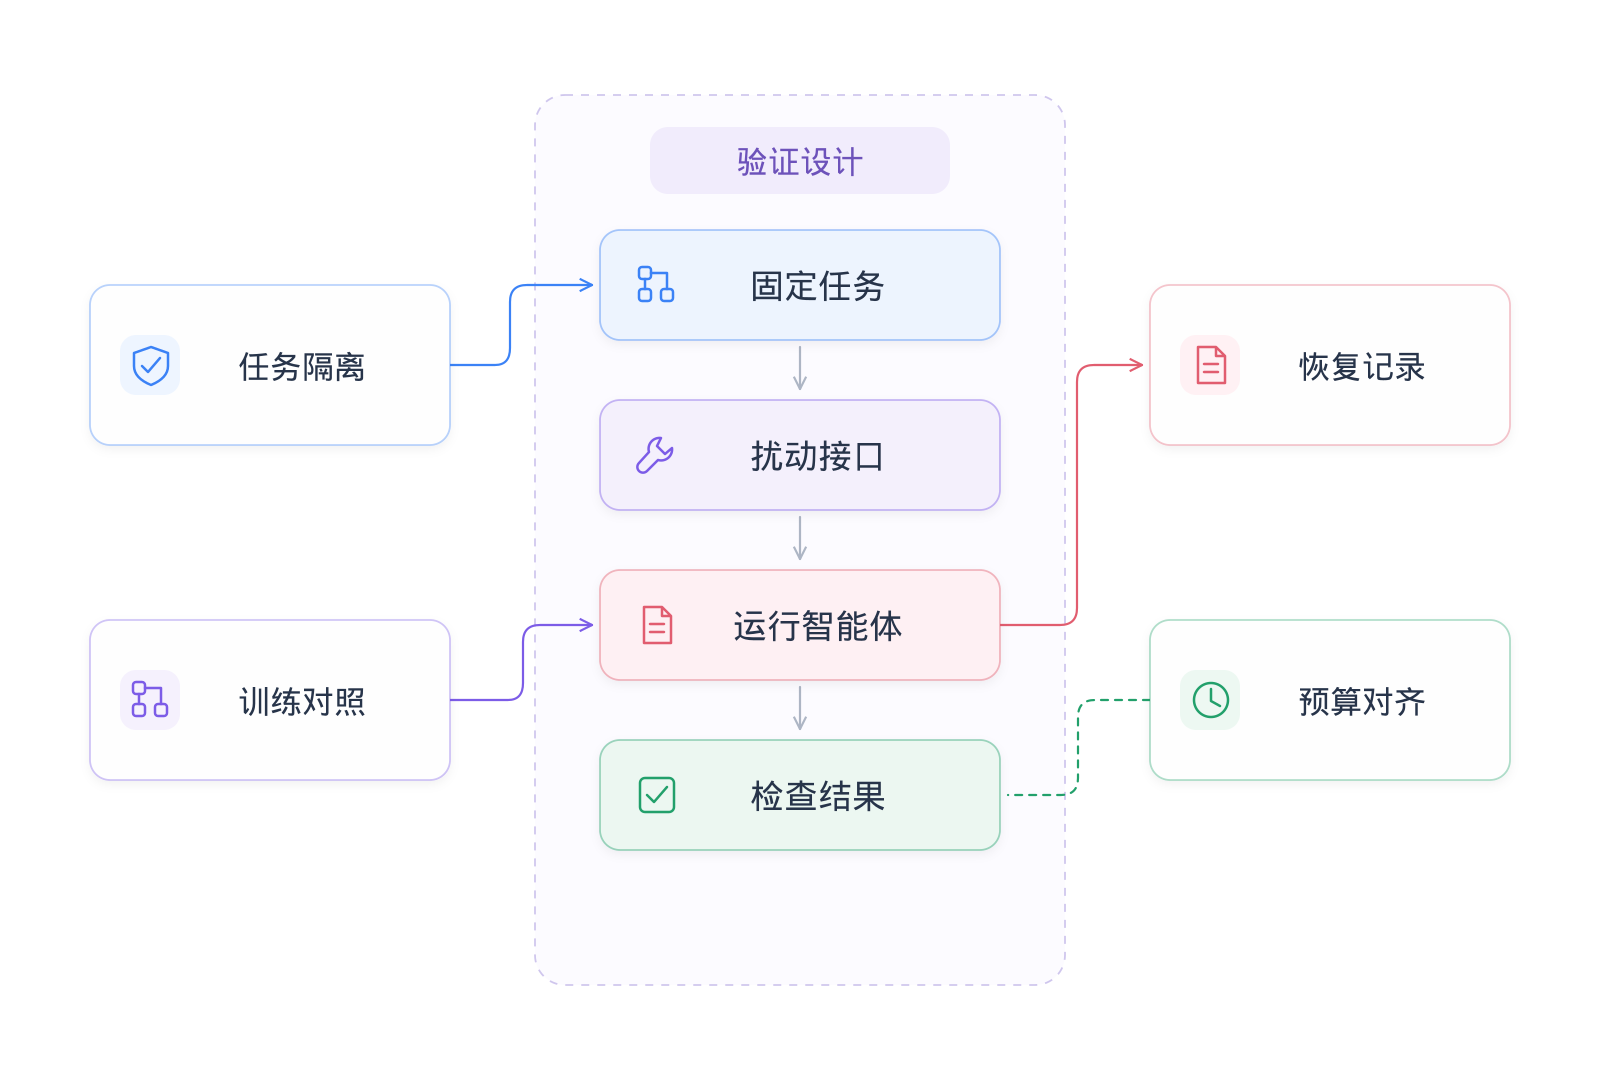
图 4|面向工具调用智能体的建议流程,属于本文工程推演。冻结任务与环境配置后采集实际轨迹,专家依据状态快照提供并核验标签;历史样本参与复训,验证时对齐调用预算。循环中的状态记录和纠正标签必须能对应到同一环境时刻。
| 样本或评测要保留的内容 | 原因 |
|---|---|
| 当前可观察上下文、环境快照、快照版本 | 使专家标签对应可检查的真实状态 |
| 学习者提议的动作、真正执行的动作、工具结果 | 区分模型行为与专家接管造成的轨迹 |
| 专家动作、标注者版本、有效性检查结果 | 监督目标需要有出处,并且能在该状态执行 |
| 轮次、β 日程、策略版本、历史数据来源 | 分析数据分布怎样变化,避免只留下最新一轮 |
| 独立任务划分、调用预算、完成与恢复指标 | 选择策略时评估自主能力,并控制比较条件 |
一次实际试验可以固定初始训练集和新增标注预算,对比"继续增加专家轨迹"与"标注学习者访问状态"。两边使用同一模型、训练预算和验证环境。除了任务完成率,还要观察出错后的恢复比例、工具调用次数,以及专家查询花费。
这里还有训练输入的选择:错误调用和实际错误返回,应保留在后续状态的上下文里;需要监督的是专家给出的合法下一步动作。对于自回归模型,可以用相应的损失屏蔽实现这种区分。把失败历史删掉,只留下老师的正确续写,训练输入又回到了一个比部署更干净的世界。这是从 DAgger 的状态标注原则延伸出来的做法,不是原论文指定的 LLM 训练配方。
如果只能拿到一份固定专家数据,无法在学习者产生的新状态上查询标签,就缺少标准 DAgger 的关键访问条件。若用预先合成的错误、老师修订旧轨迹或纯成功样本自训练,则还要单独说明错误状态从哪里来、是否代表当前策略的行为。它们可能有价值,但需要自己的证据。
DAgger 给长期交互系统留下了一个很具体的检查方法:看训练数据时,除了问专家做得有多好,还要问,里面有没有模型自己会走到的位置,以及在那些位置继续完成任务的示范。
参考资料
- Ross, S., Gordon, G. J., & Bagnell, J. A. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning. AISTATS 2011,PMLR 15:627--635。论文页面 · 会议版 PDF。本文主要依据,已核对正文、算法、定理与证明,以及三个实验的文字和图表。
- Ross, S., & Bagnell, J. A. Efficient Reductions for Imitation Learning. AISTATS 2010,PMLR 9:661--668。官方页面与摘要。用于说明此前工作背景;本文对 Forward Training、SMILe 的具体比较依据 2011 年论文中的讨论,不声称另行完整复核 2010 年证明。
- imitation:DAgger 官方文档。 算法与采集器接口。用于交叉核对动作执行、专家标签保存及历史数据训练的实现语义。