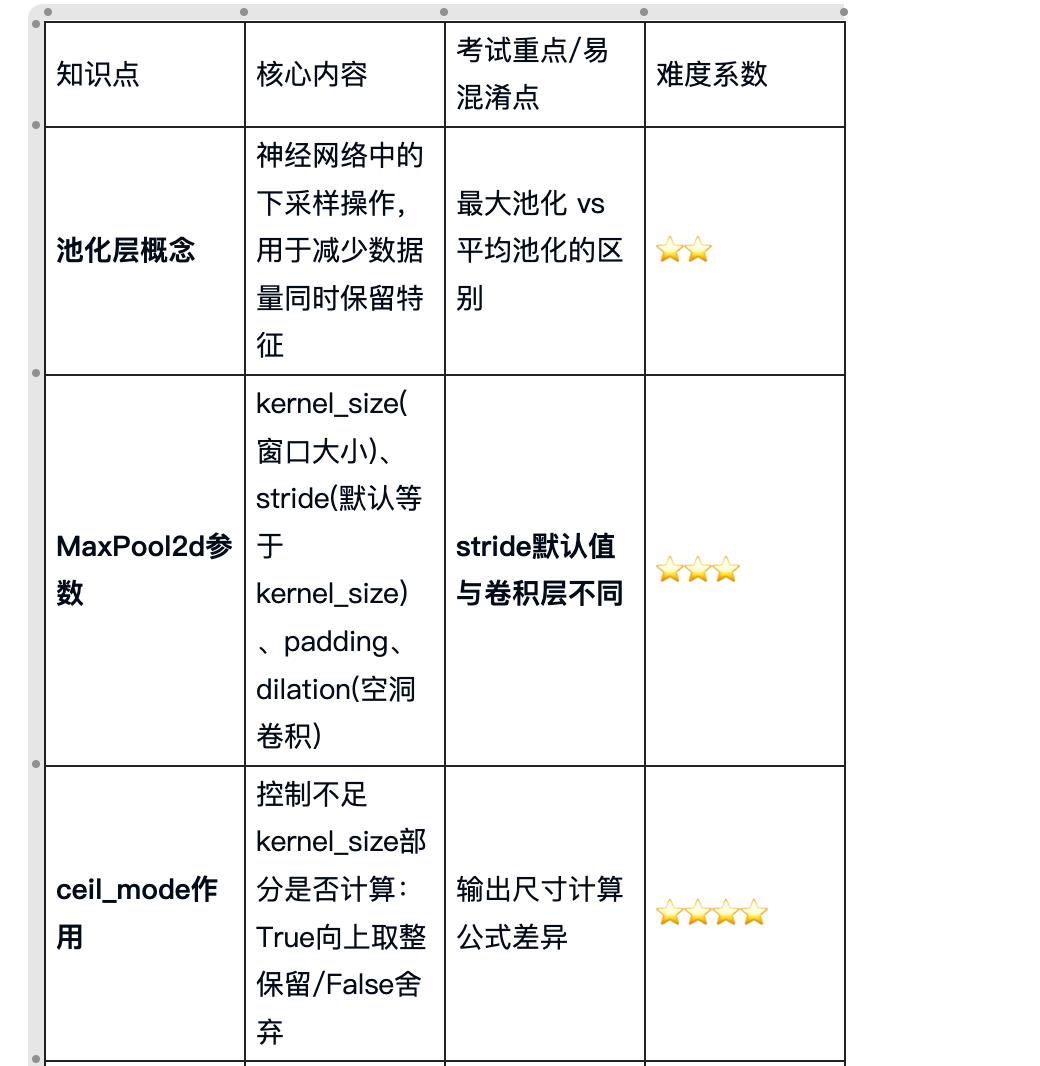
torch.nn.pooling layers池化层
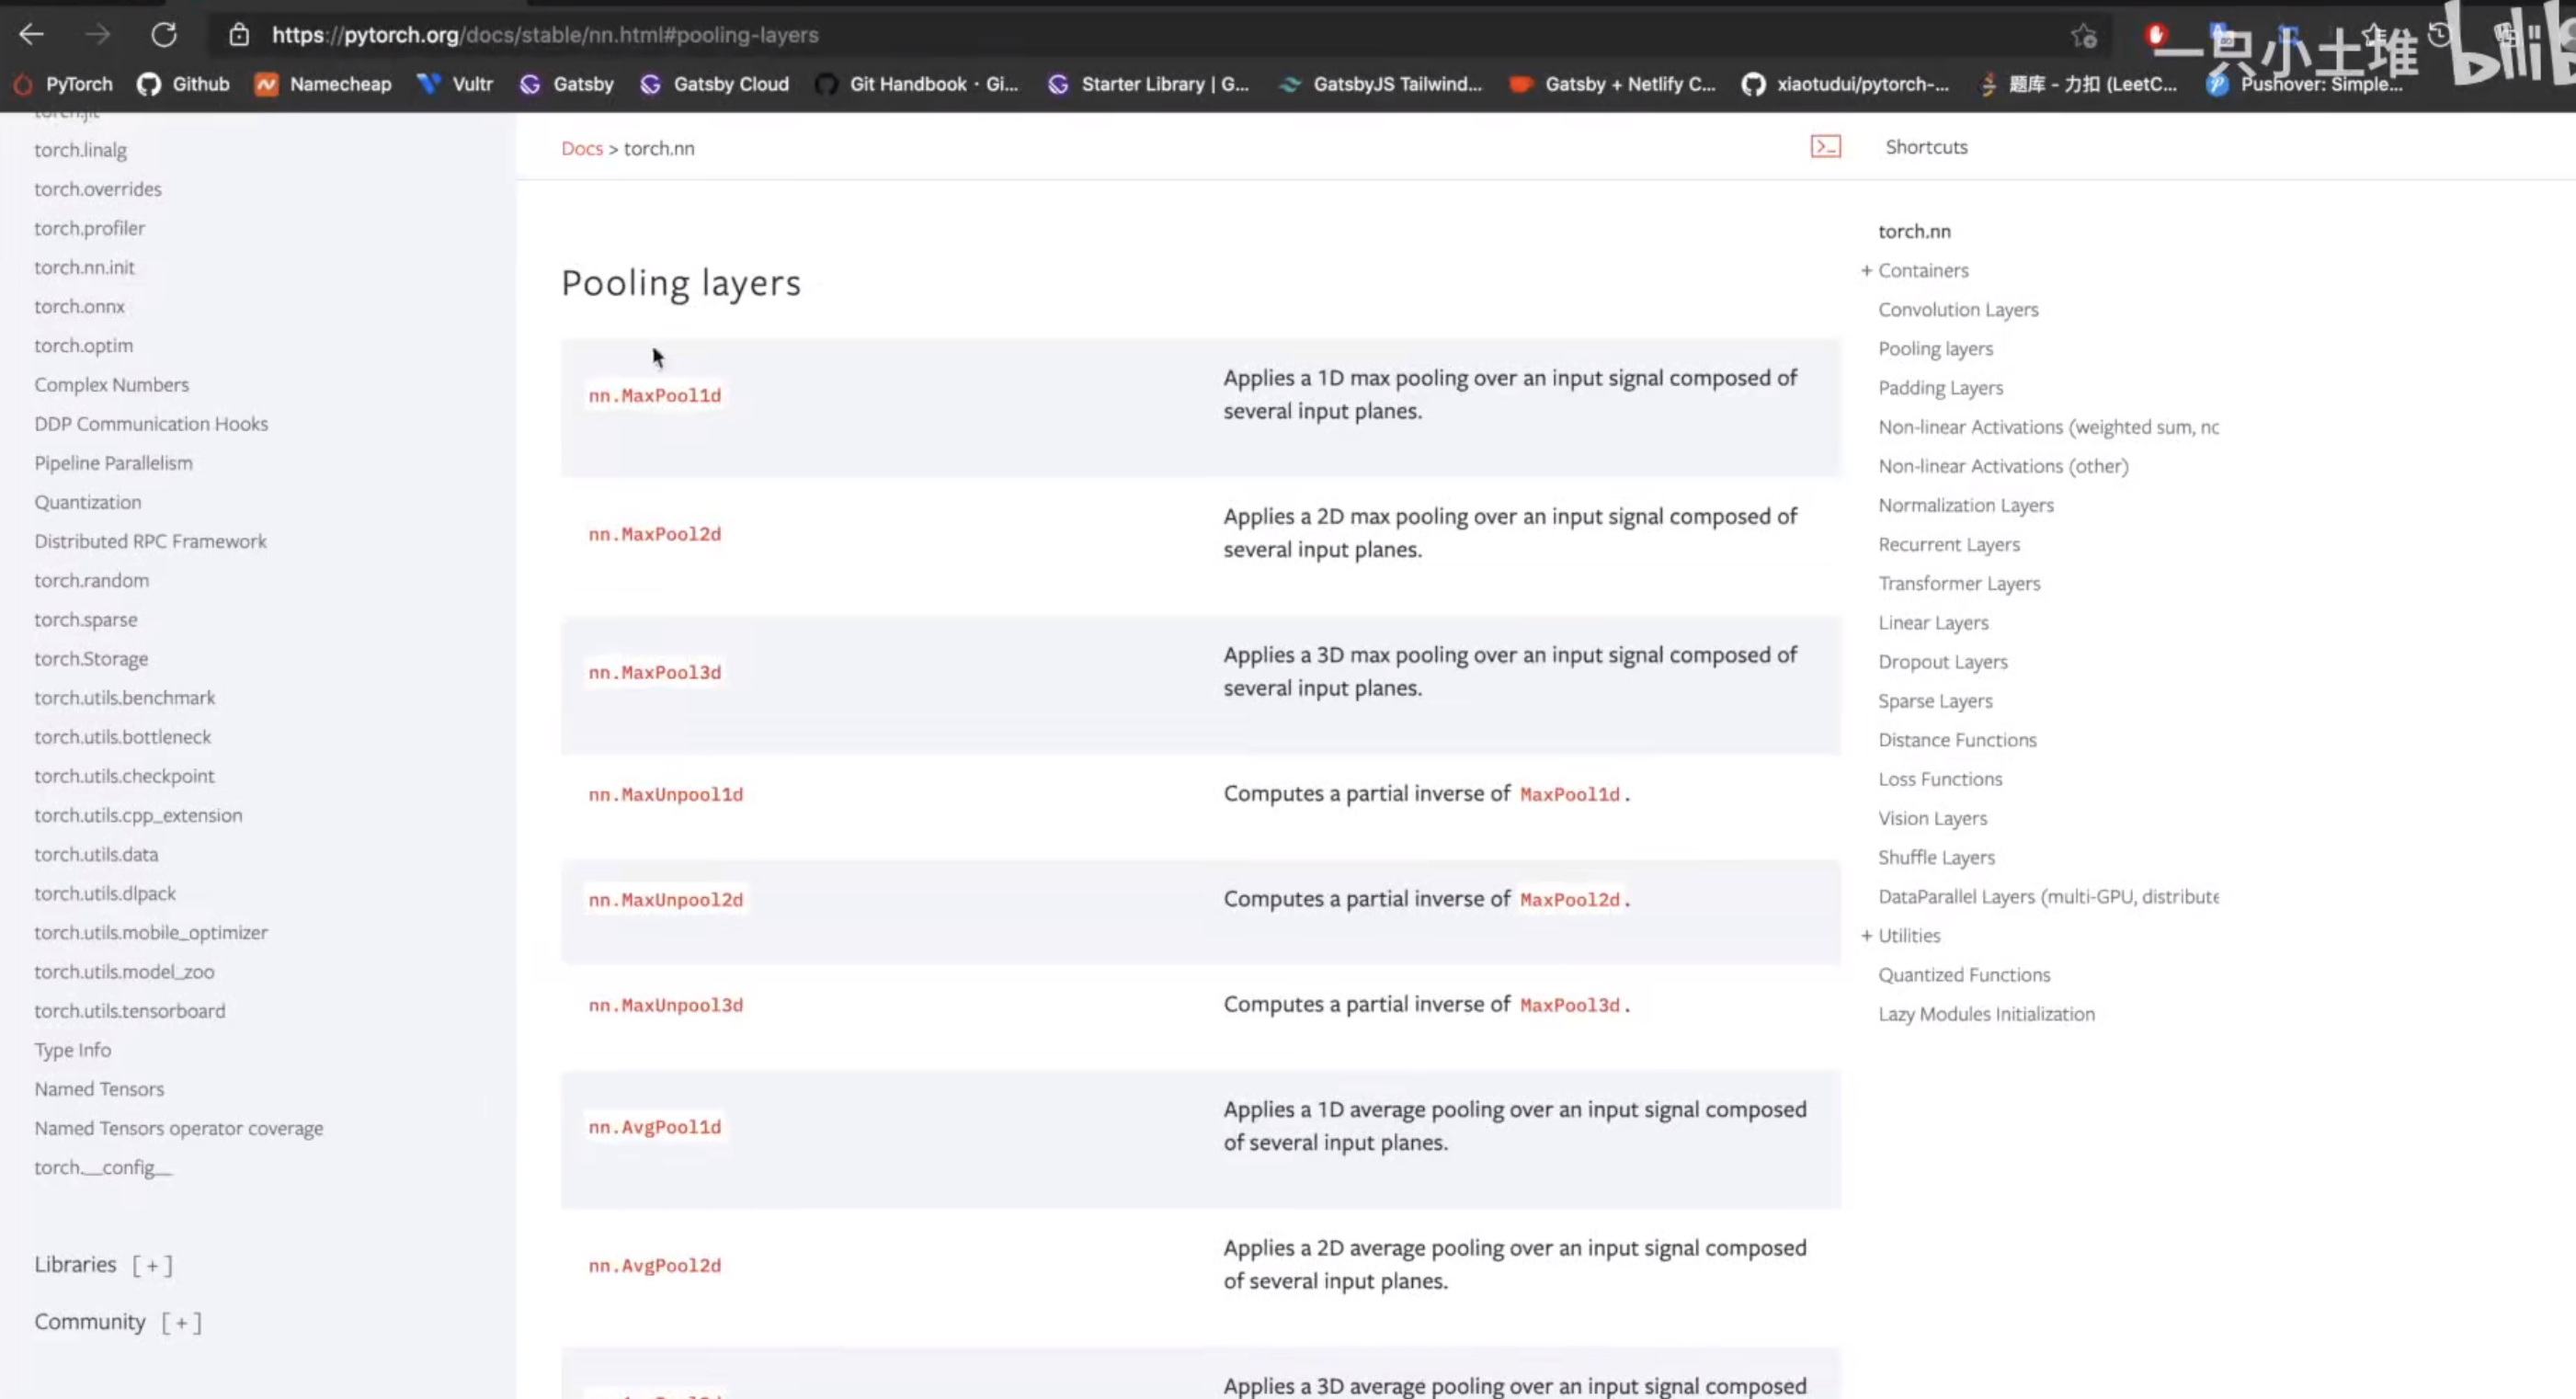
常用池化层类型:
MaxPool1d/2d/3d:最大池化(最常用),也被称为下采样
MaxUnpool1d/2d/3d:最大反池化(在池化前加"Un"),实现上采样
AvgPool1d/2d/3d:平均池化
自适应池化层(较少使用)
MaxPool2d参数详解
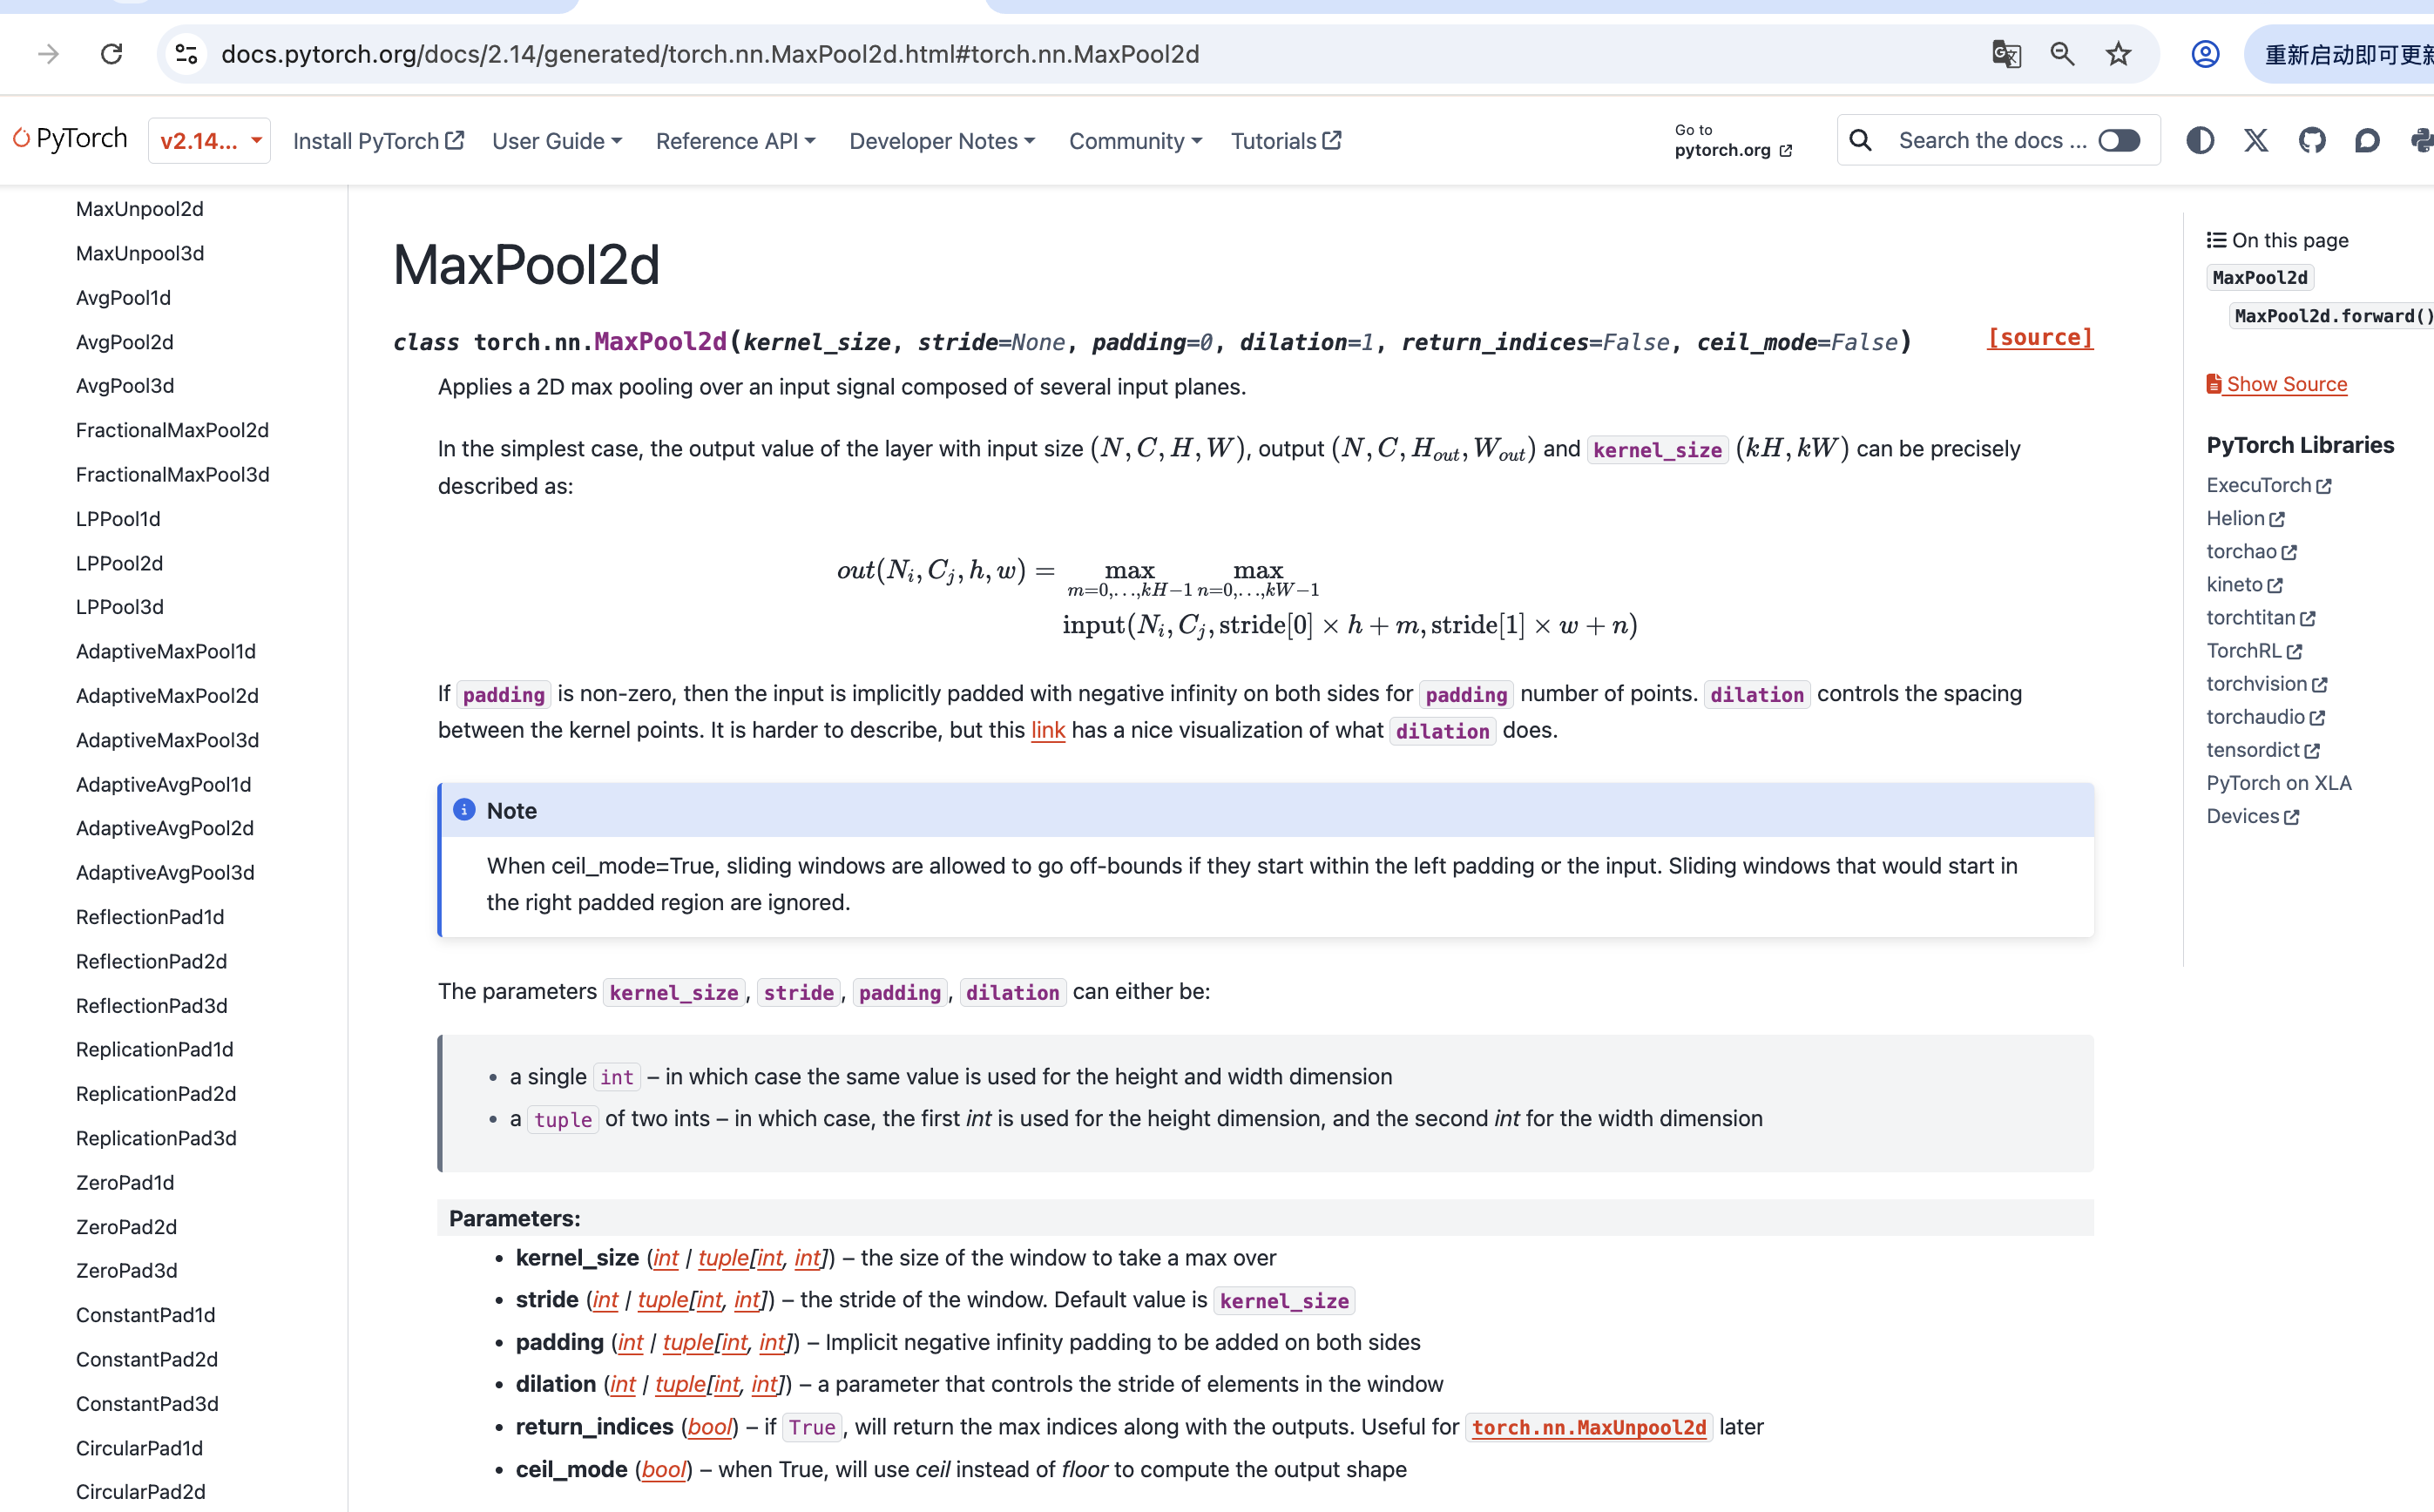
核心参数:
1.kernel_size:池化窗口大小
可设为单个int(如3表示3×3窗口)
也可设为元组(如(2,3)表示2×3窗口)
2.stride:滑动步长
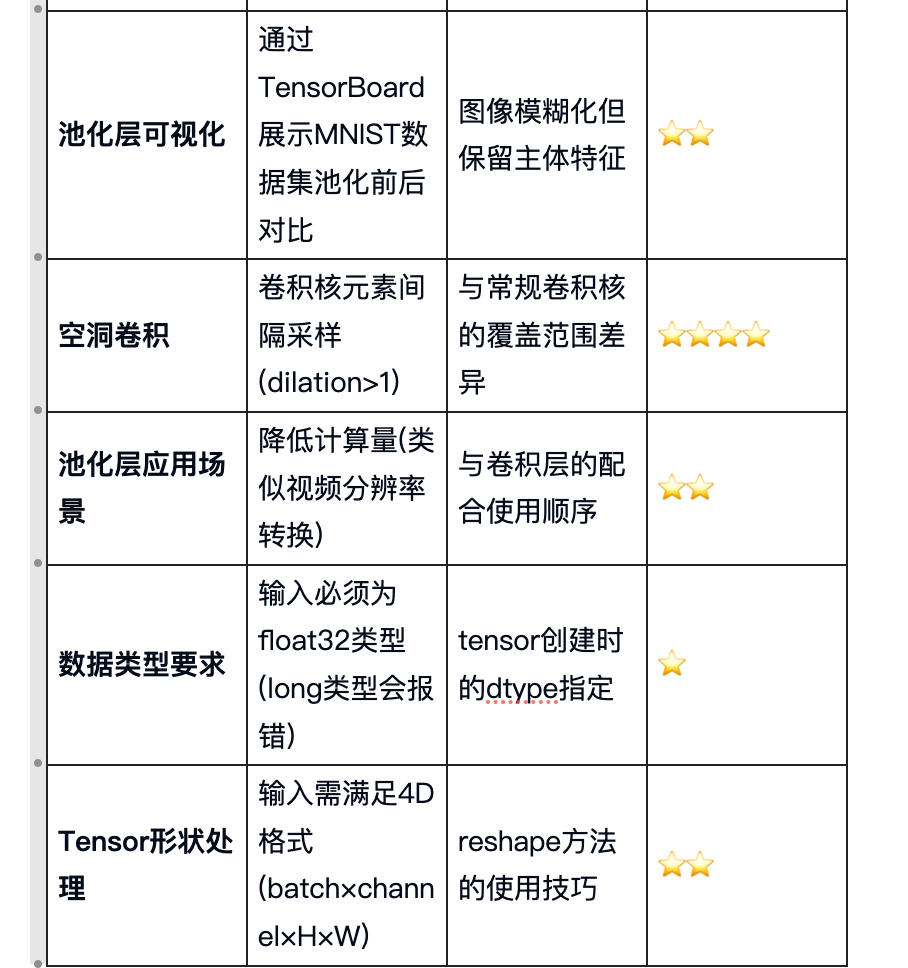
默认值= kernel_size(与卷积层不同,卷积层默认stride=1)
3.padding:填充方式(与卷积层相同)
4.dilation:控制窗口元素间距的参数
5.return_indices:是否返回最大值索引(用于后续MaxUnpool操作),通常很少使用
6.ceil_mode:计算输出形状时使用ceil还是floor模式,True时使用ceil计算输出形状(默认使用floor)
注意事项:
最大池化是最常用的池化方式
池化层主要作用是降维(下采样)和特征提取
与卷积层参数的主要区别在于stride默认值不同
dilation参数
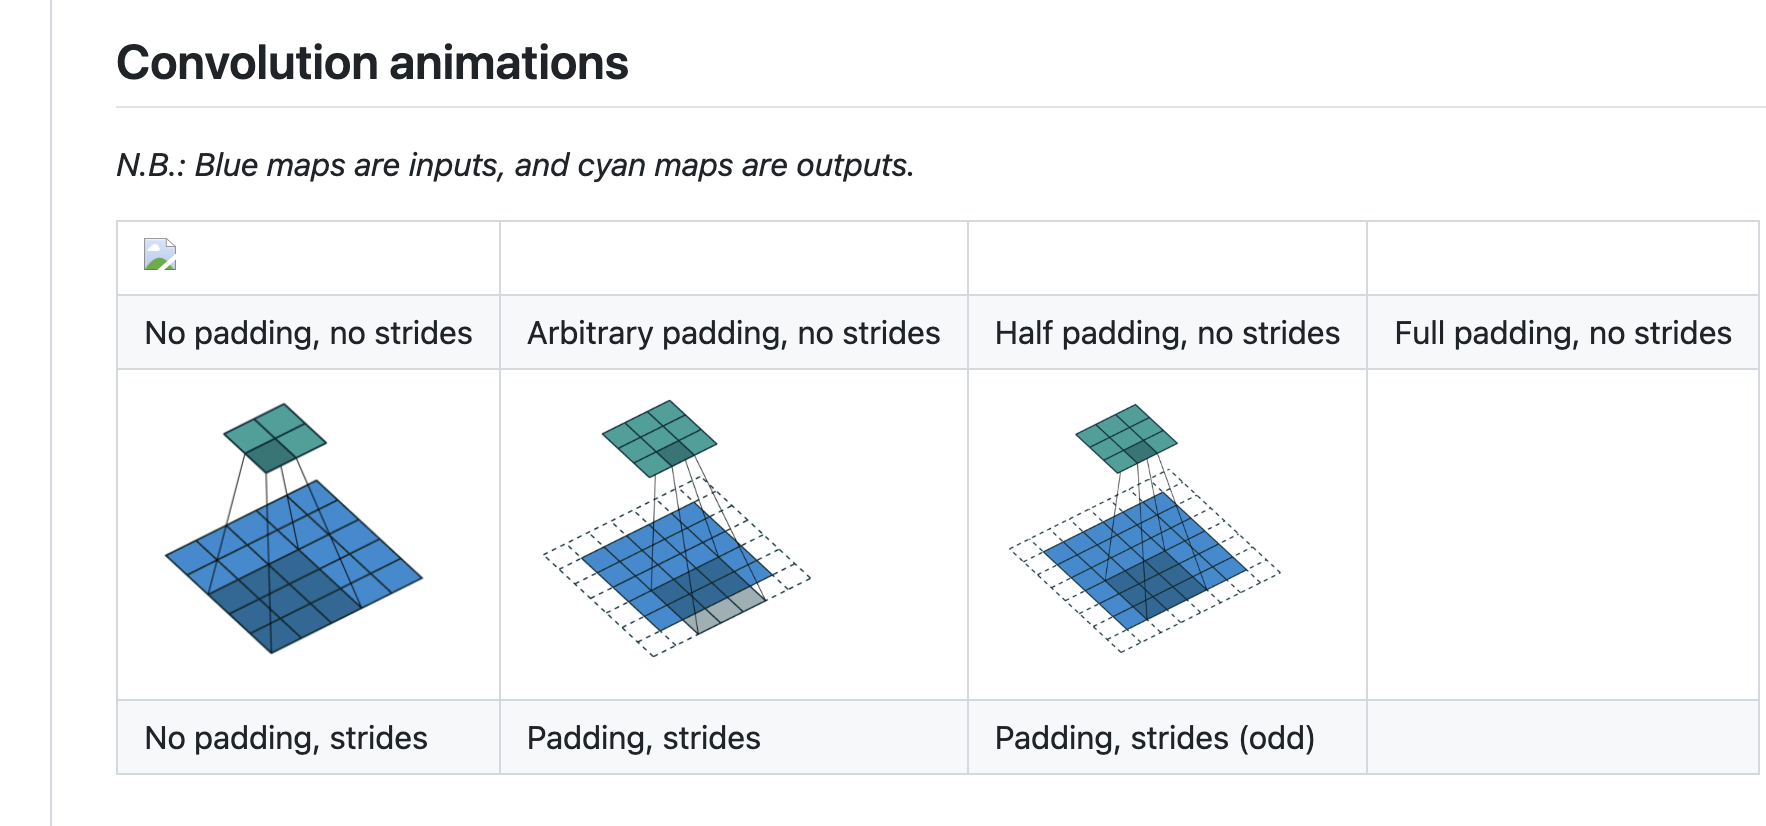
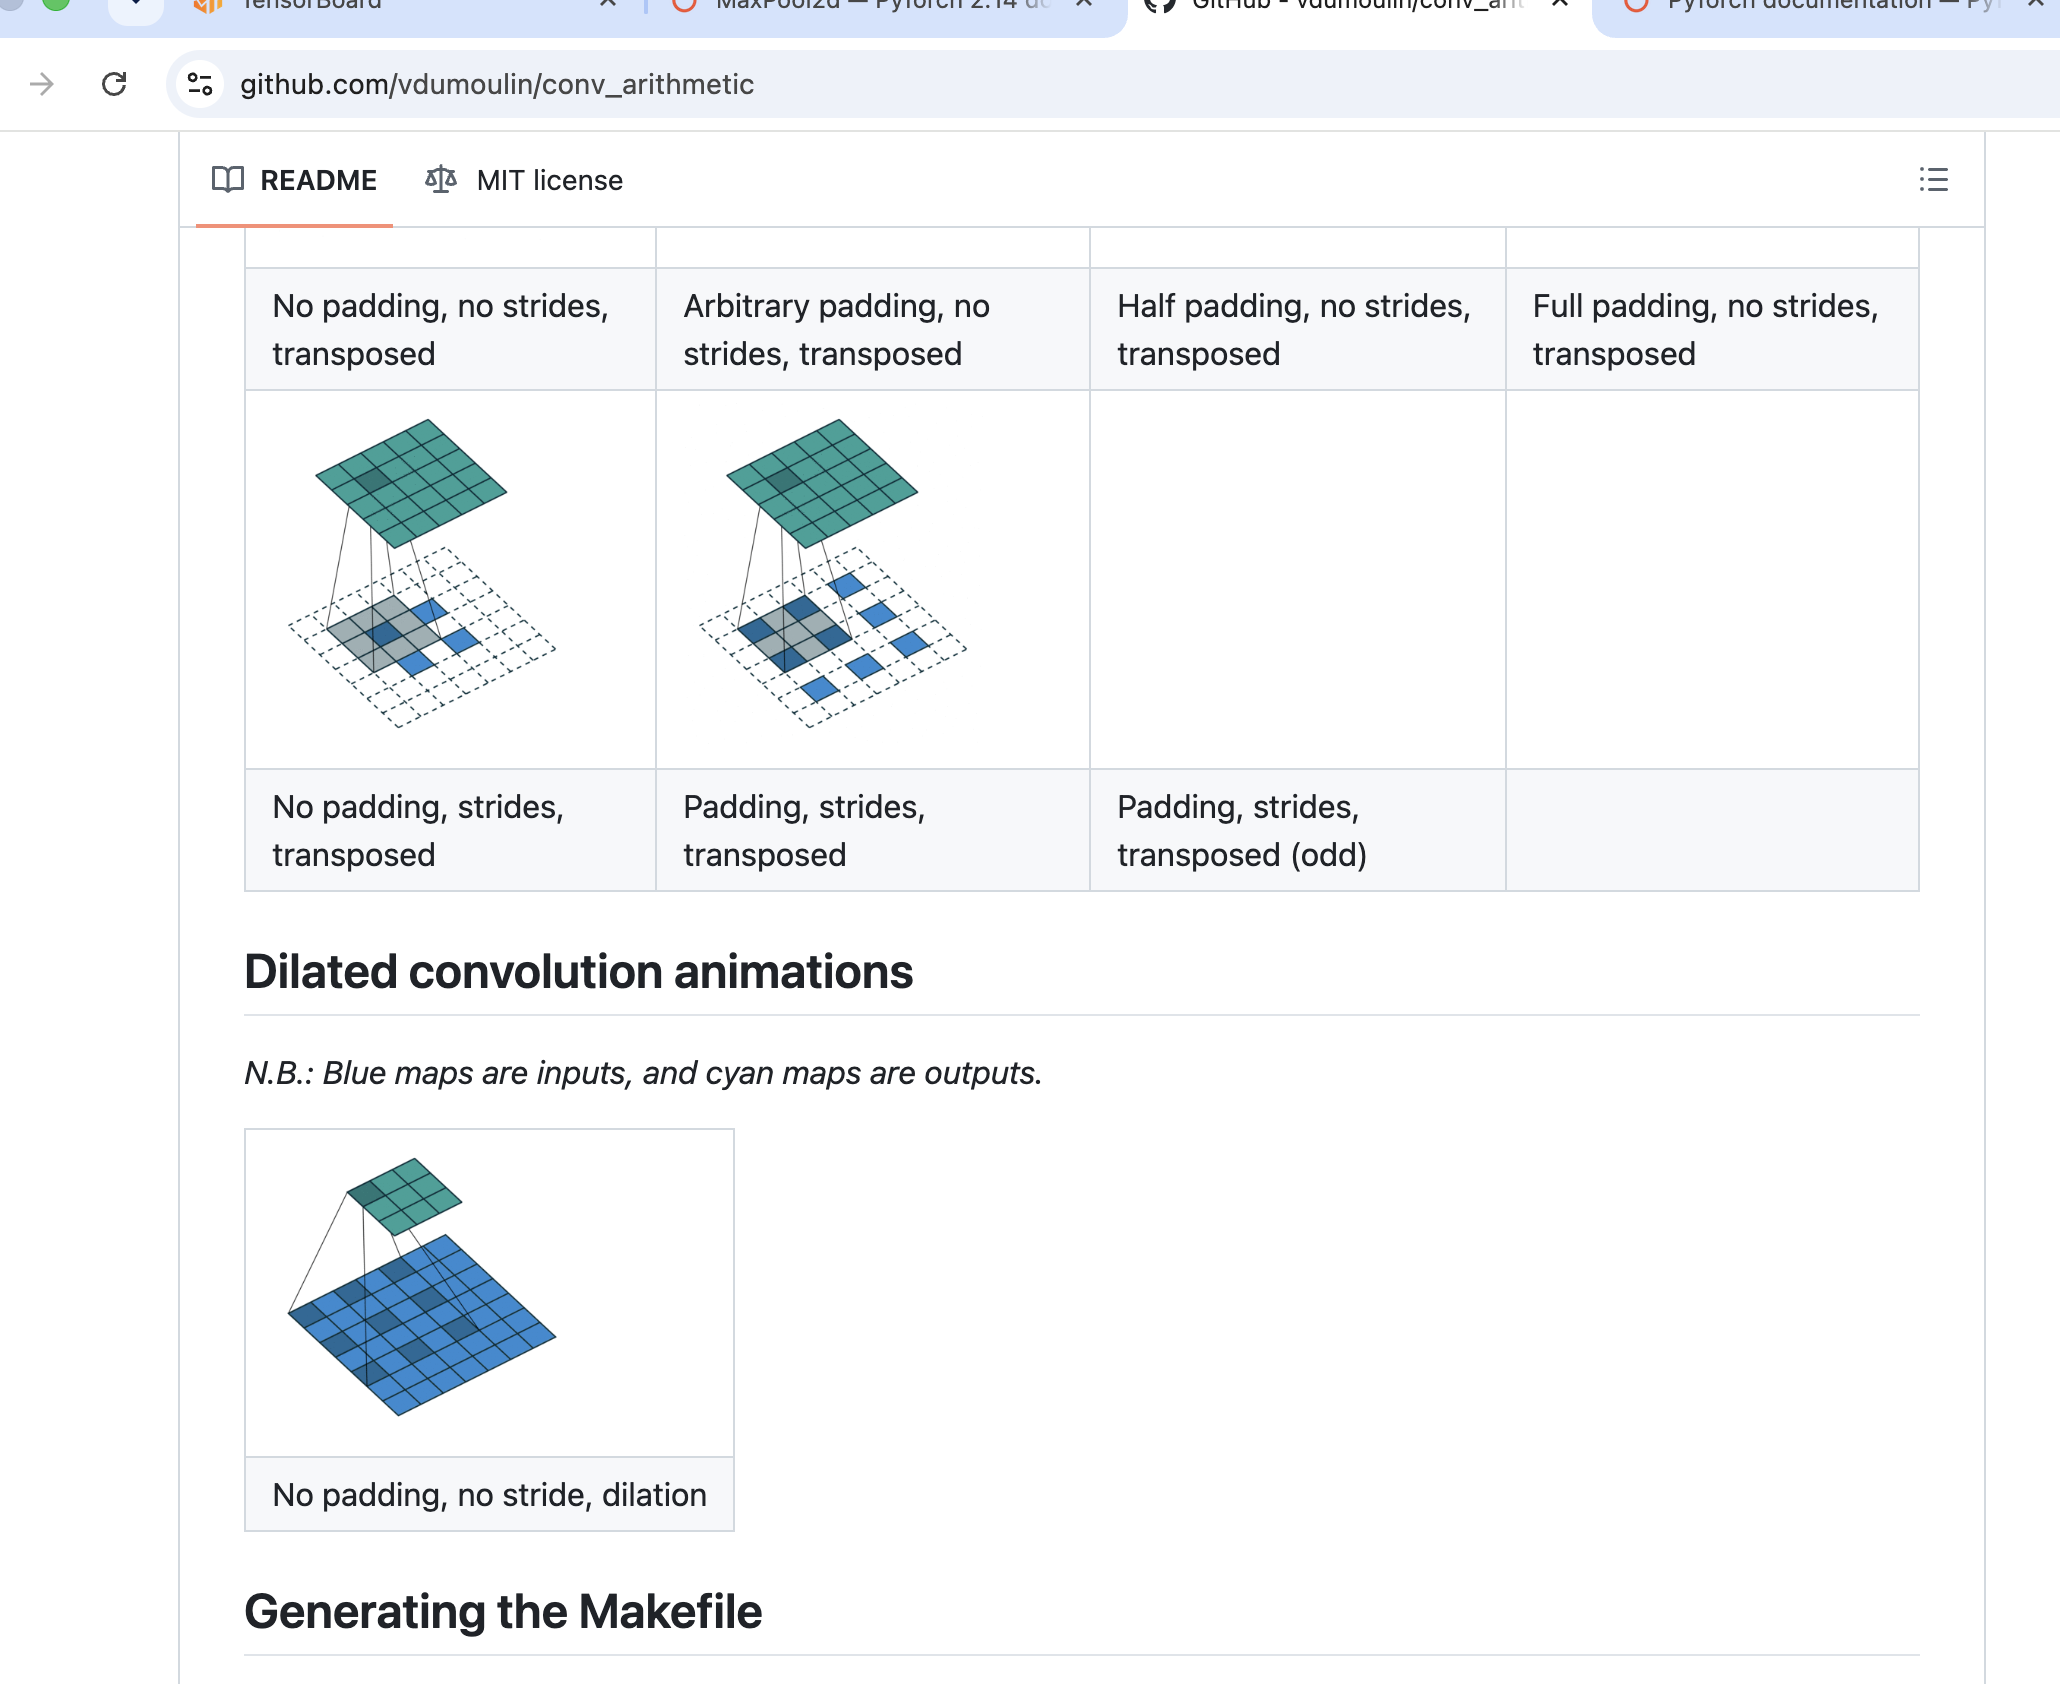
这里解释下dilation的作用,像上图中dilation是1的情况下,卷积核的每个元素都是紧挨着的。而下图dilation为2的情况下,卷积核的每个元素之间间隔1方格,这个叫做空洞卷积,因为中间有了洞。
空洞卷积说明:
当dilation>1时,卷积核元素之间会产生间隔
例如3×3卷积核在dilation=1时紧密排列,dilation=2时元素间会间隔1个位置
这种间隔形成的"空洞"效果,因此称为空洞卷积
ceil_mode参数
模式区别:
floor模式: 向下取整,如2.3取2
ceil模式: 向上取整,如2.3取3
在MaxPool2d中影响输出形状的计算方式
ceil_mode实际应用案例:
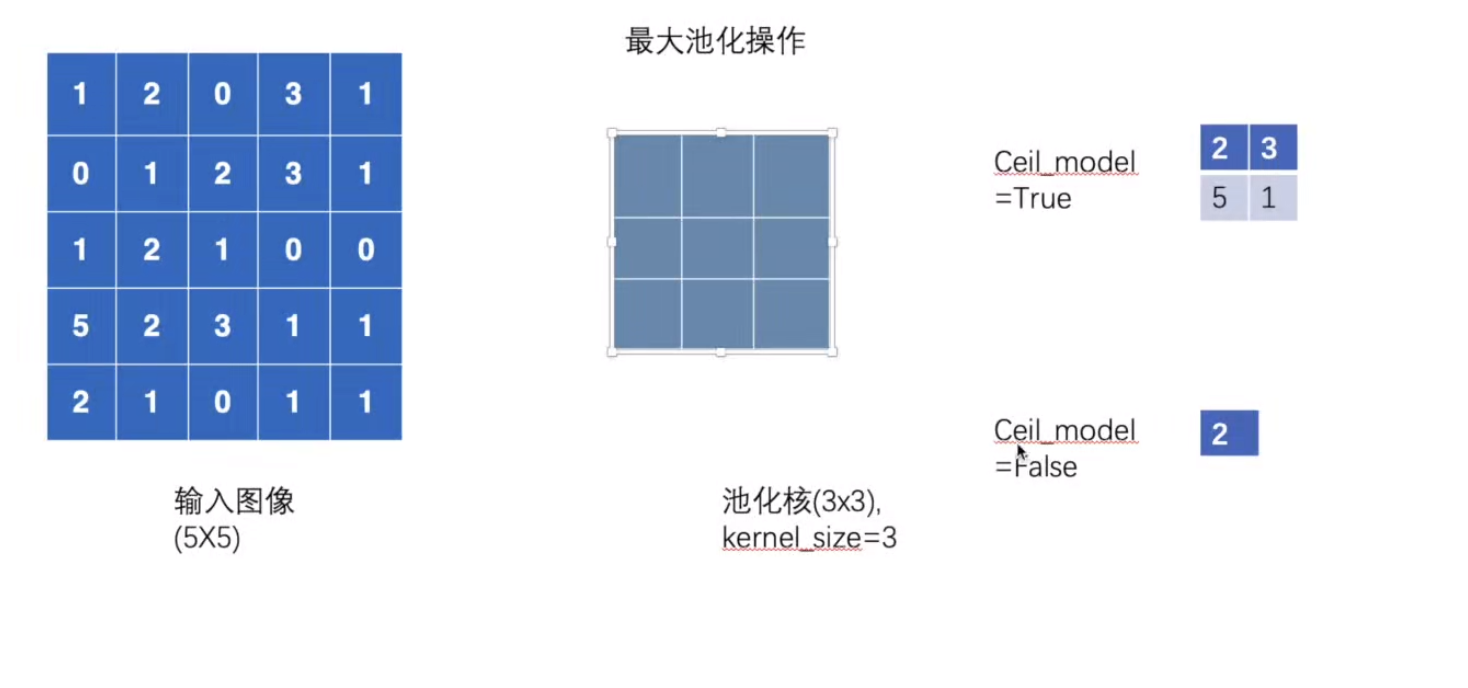
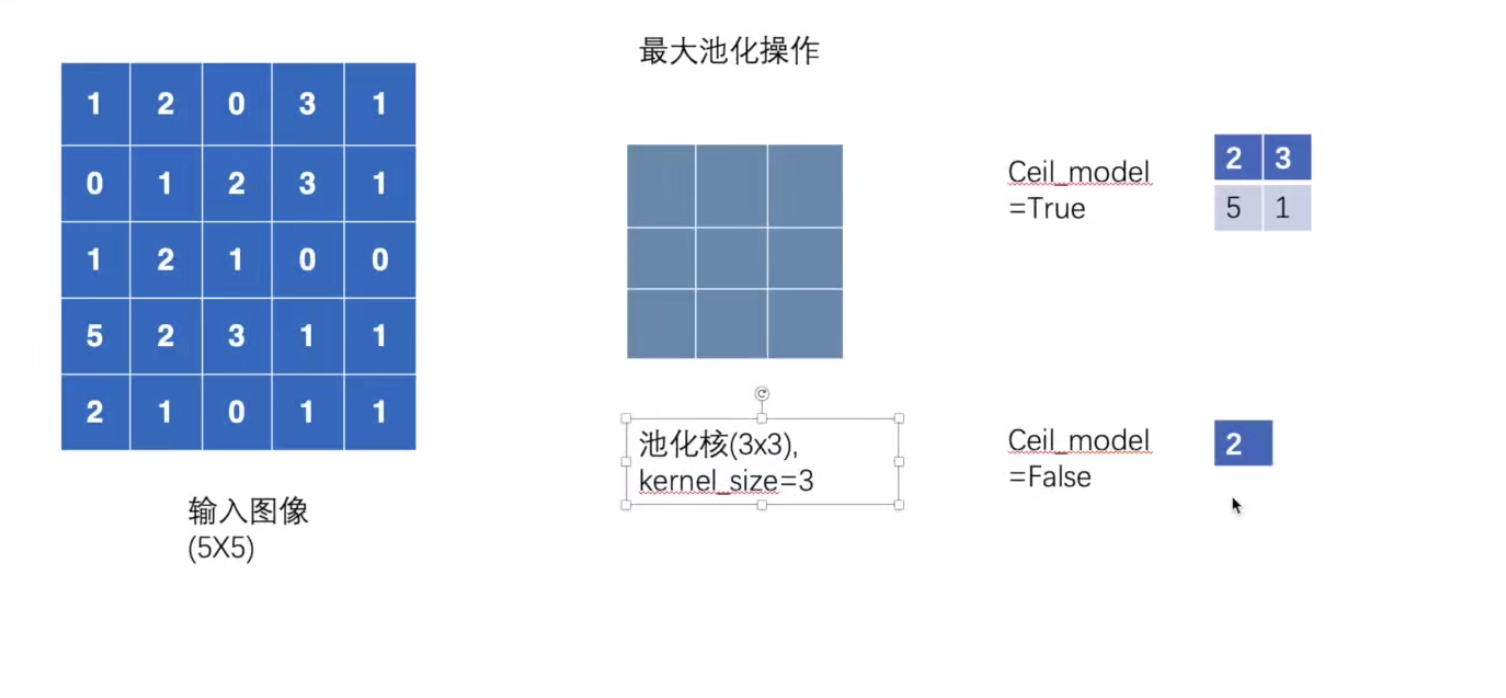
池化操作示意图
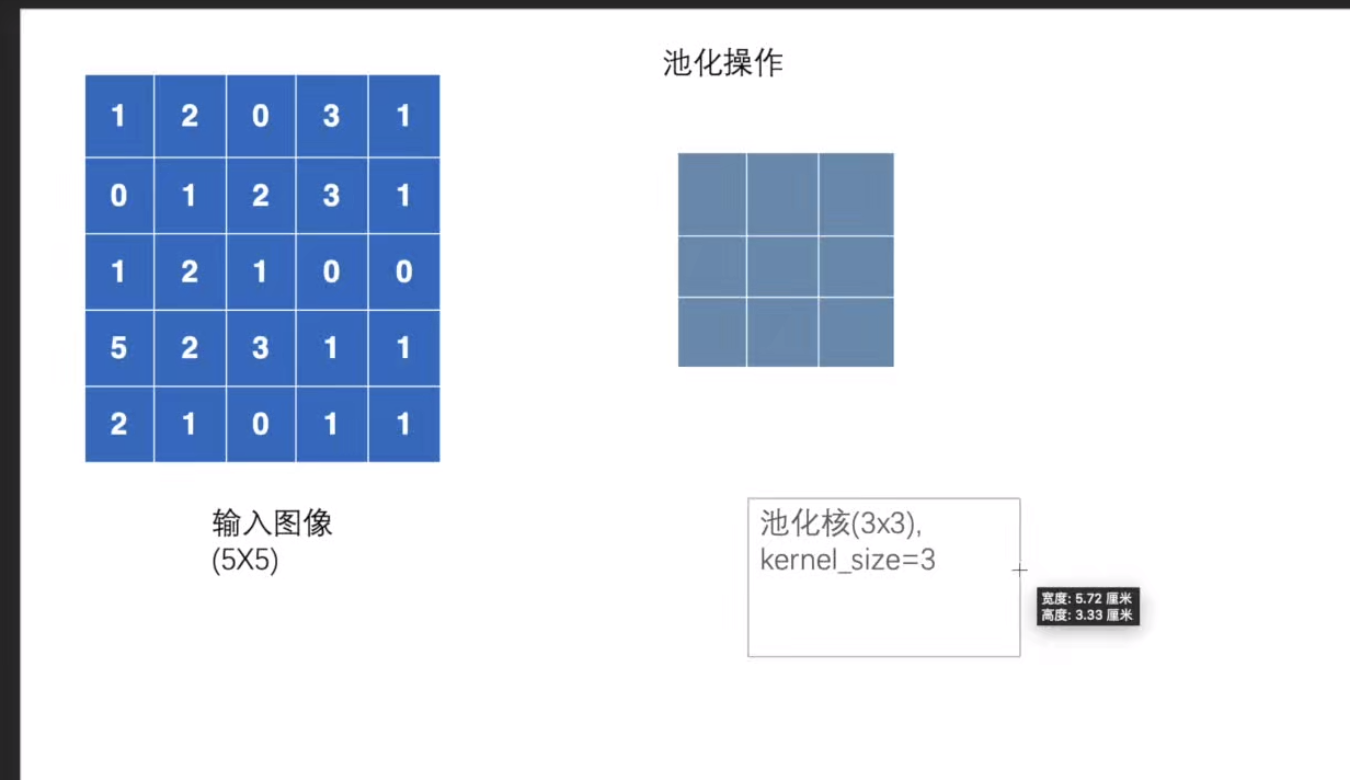
输入图像尺寸: 示例中为5 X 5 的矩阵
池化核设置:默认情况下kernel_size与池化核尺寸相同,示例中设置为3 X 3的窗口
最大池化操作
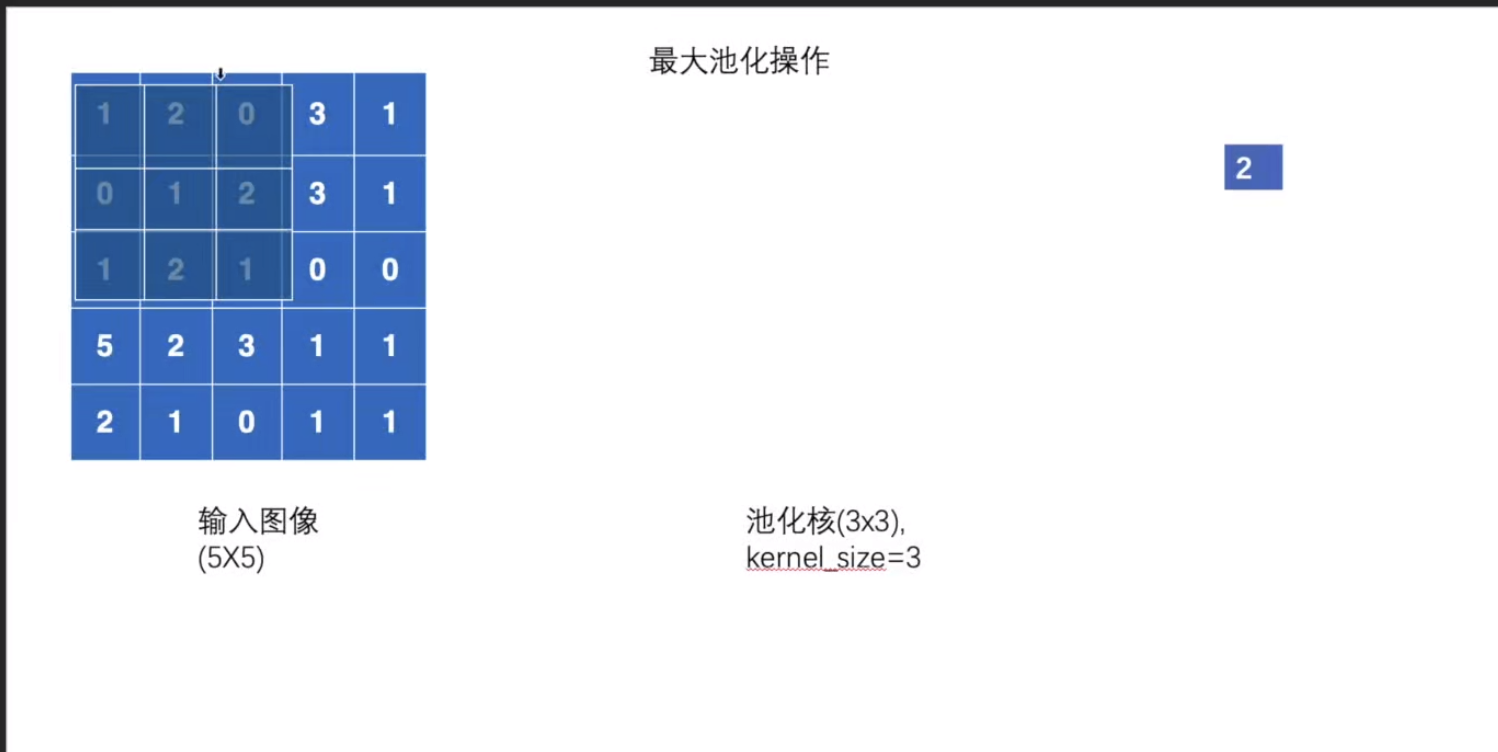
操作原理:
将池化核覆盖输入图像的9个数值
取覆盖区域内的最大值作为输出
示例输出:
第一位置覆盖区域最大值为2
输出结果为1 X 1 的数值2
池化步长与边界处理
默认步长:
步长(stride)默认等于池化核尺寸
示例中每次移动3个单位
边界情况:
当覆盖区域不足9个数时(如只剩6个)
处理方式由ceil_model参数决定
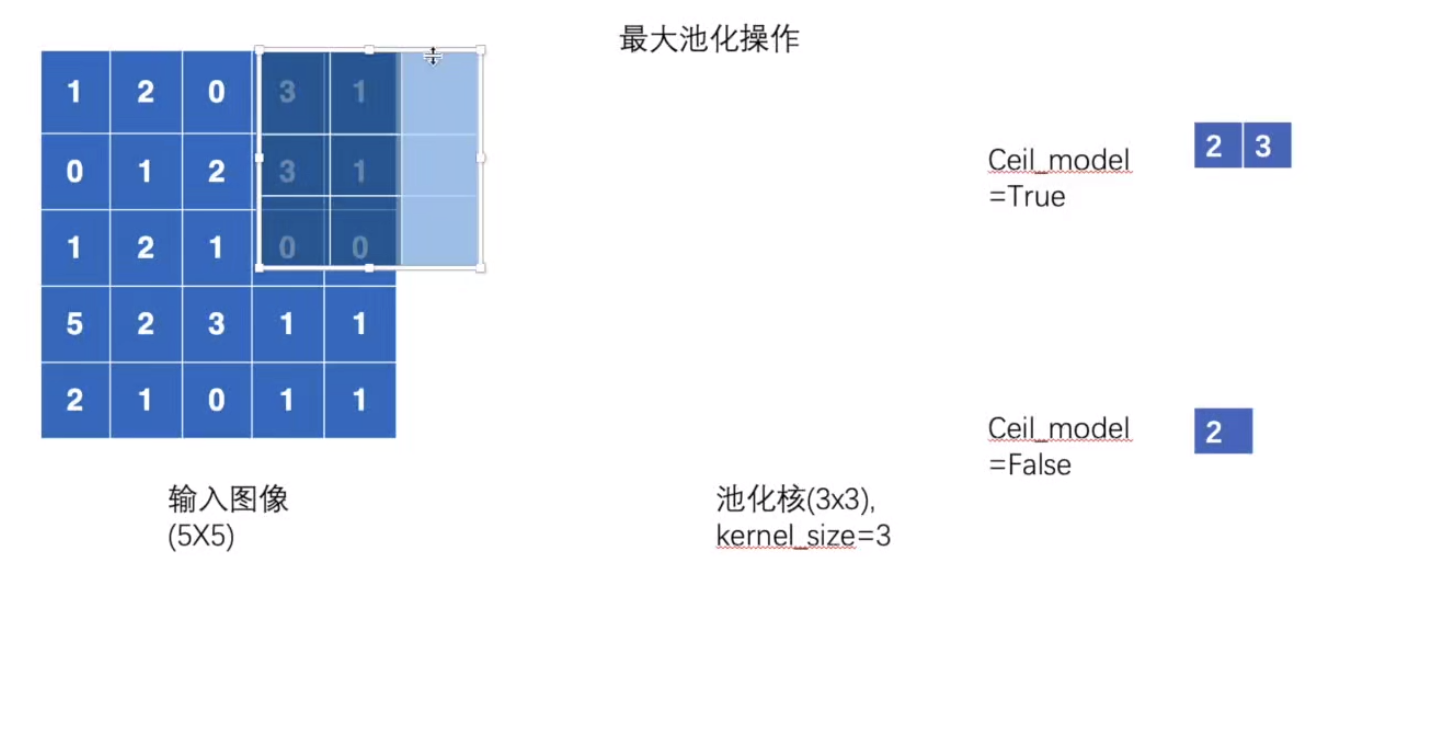
(1)True模式:
允许保留不完整覆盖区域
取有效区域内的最大值
示例图上图中六数区域最大值为3
(2)False模式:
放弃不完整覆盖区域
示例图上图中六数区域不输出结果
实际应用:
一般情况下保持默认False
需要保留边界特征时可设为True
输出尺寸差异需特别注意
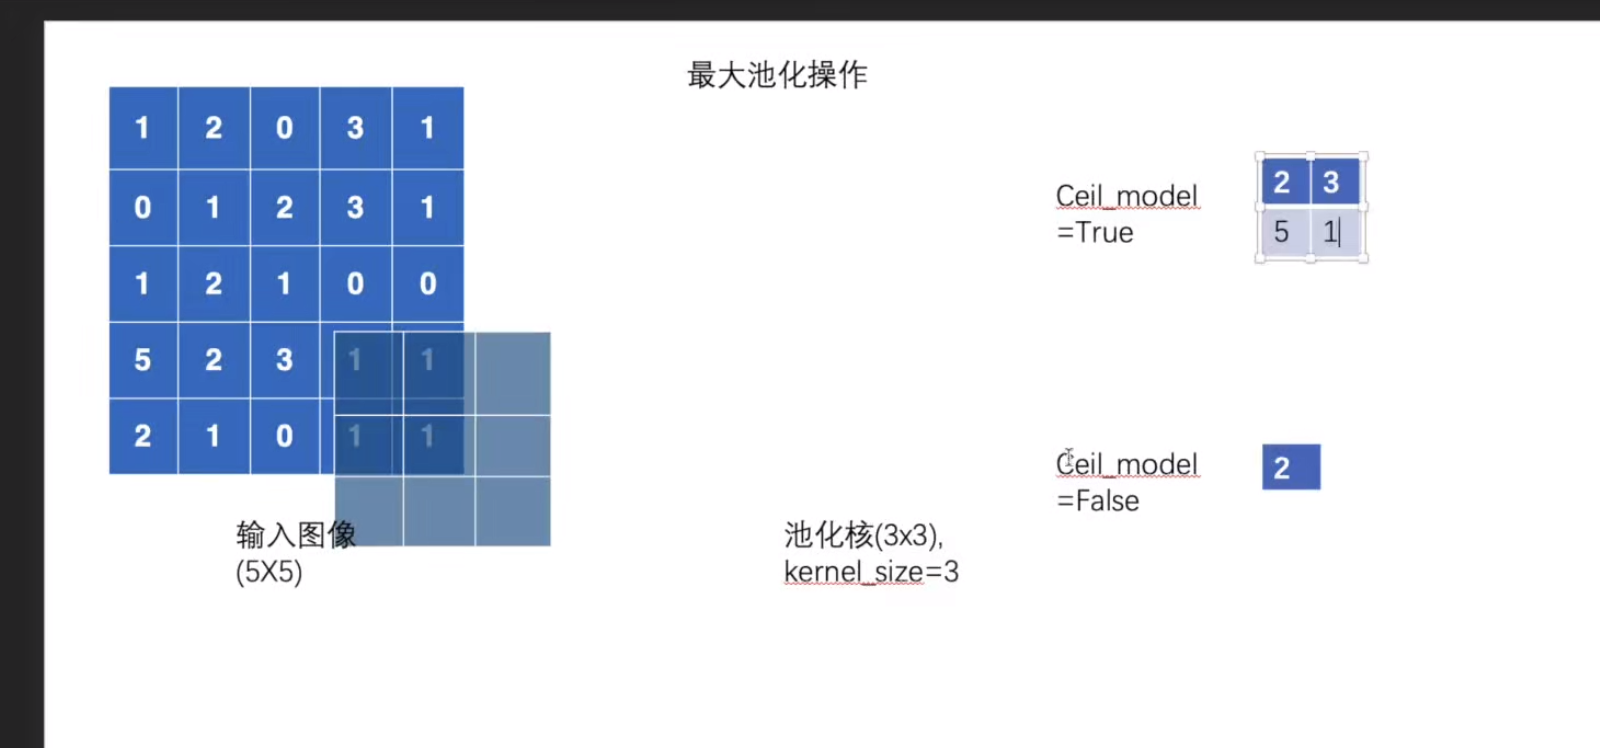
最大池化操作结果
作用与意义
形状变化:输入(5 x 5)经过(3 x 3)池化后输出(2 x 2)或(1 x 1)
数据压缩:类似视频分辨率从1080p降到720p,保留主要特征同时减小数据量
计算优势:减少网络参数数量 | 加快训练速度
网络应用:通常与卷积层配合使用,形成"卷积-池化-激活"的标准结构
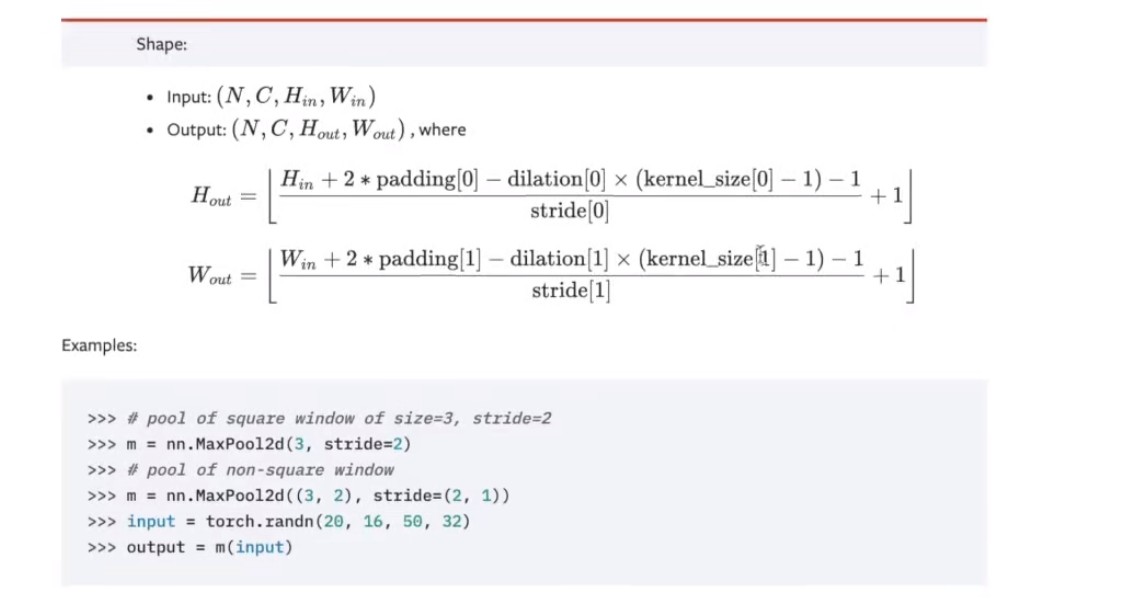
输出尺寸计算公式
如下为输出尺寸的计算公式,可以不用记忆,仅供查阅。
以上面的演示为例,我们输入尺寸高度是5,padding是(0,0),dilation是(1,1),所以输出高度计算得到。(5 - (3-1)-1 )/3 + 1 =1.667
如果开启了ceil_model模式,那么我们对结果取ceil,得到输出的尺寸高度是2.
如果关闭了ceil_model模式,那么我们对结果取floor,得到输出的尺寸高度是1.
计算结果与演示中表现的一致。
对如上池化演示操作进行代码实现
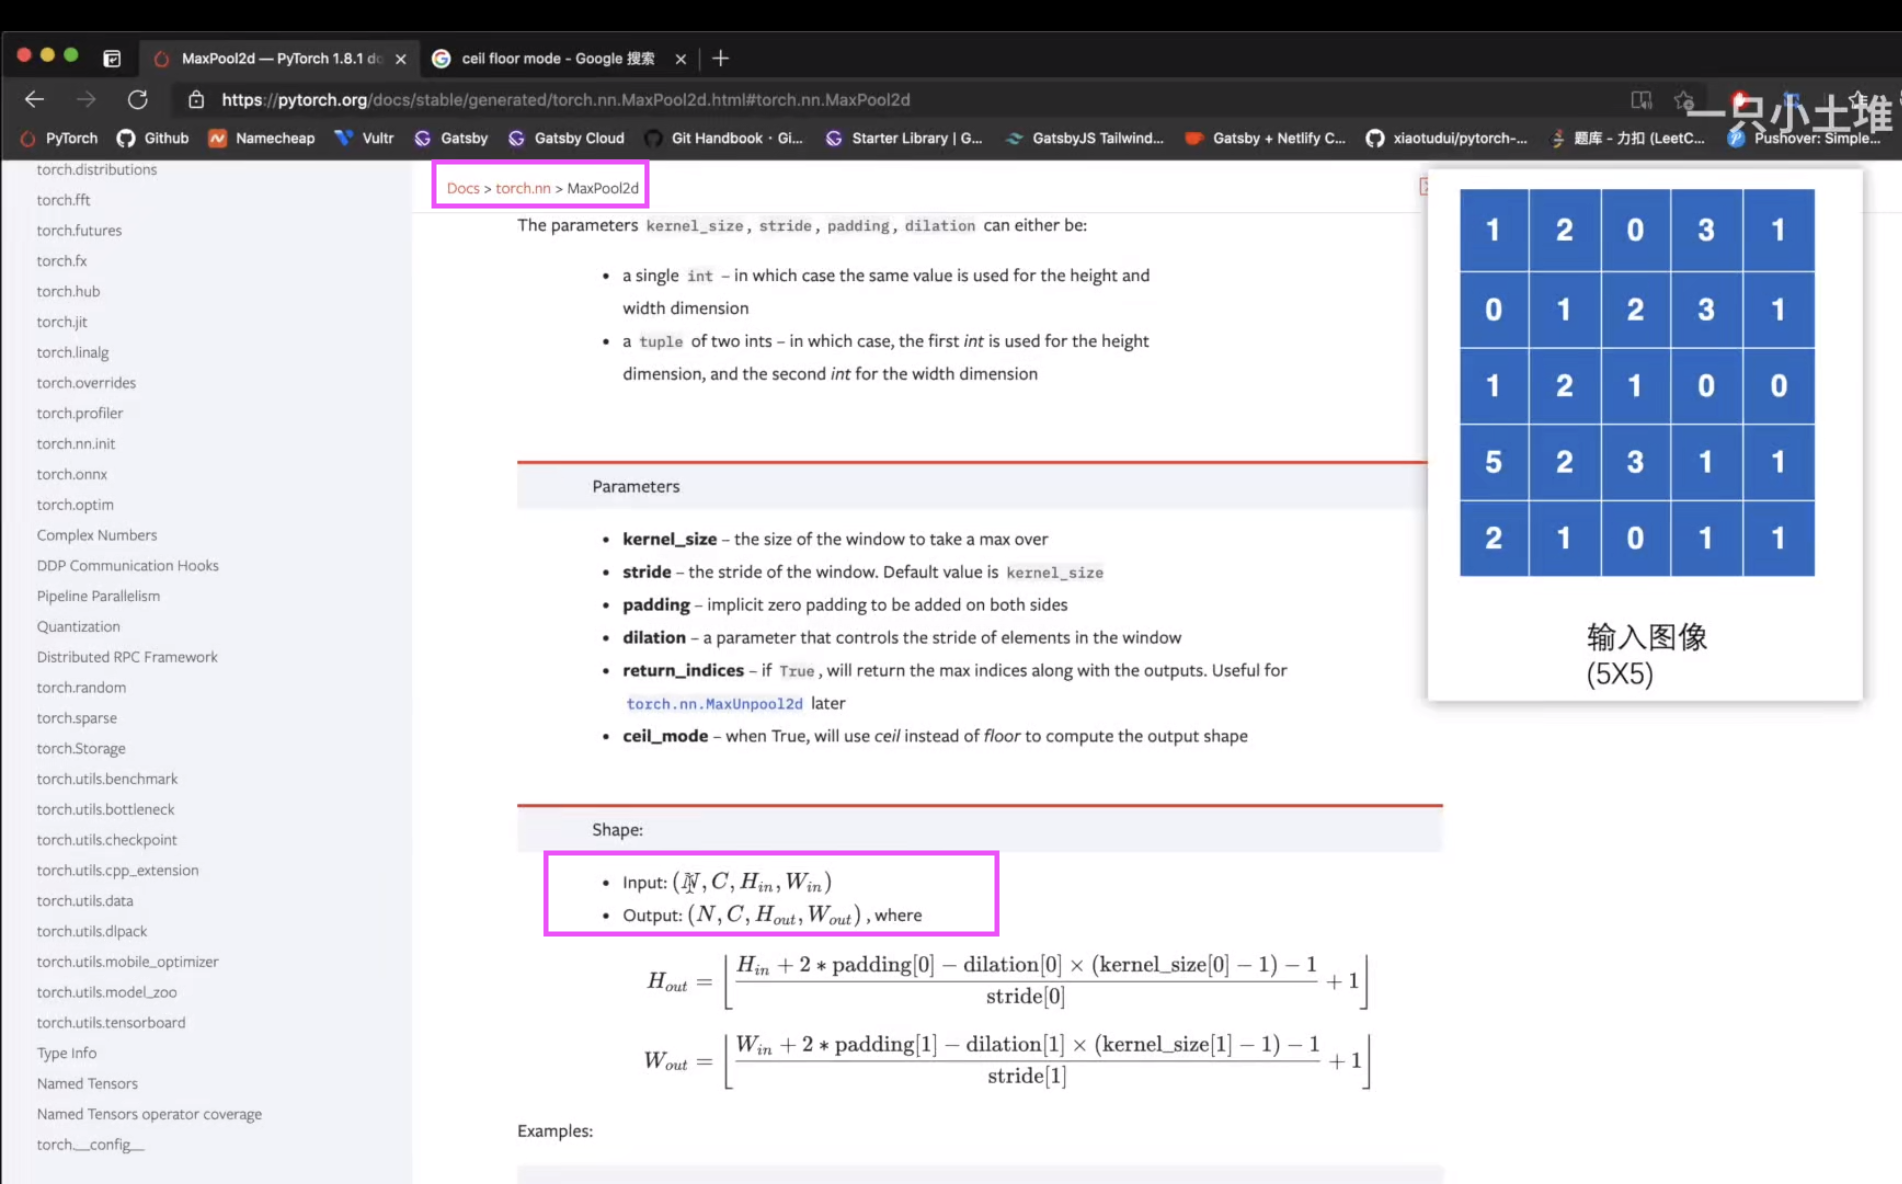
注意池化操作中input的N是 batch_size,C是通道channel通道数,因为我们的输入图像只有1层,所以channel是1,然后我们想让它自己去计算batch_size,所以我们batch_size这里写-1,
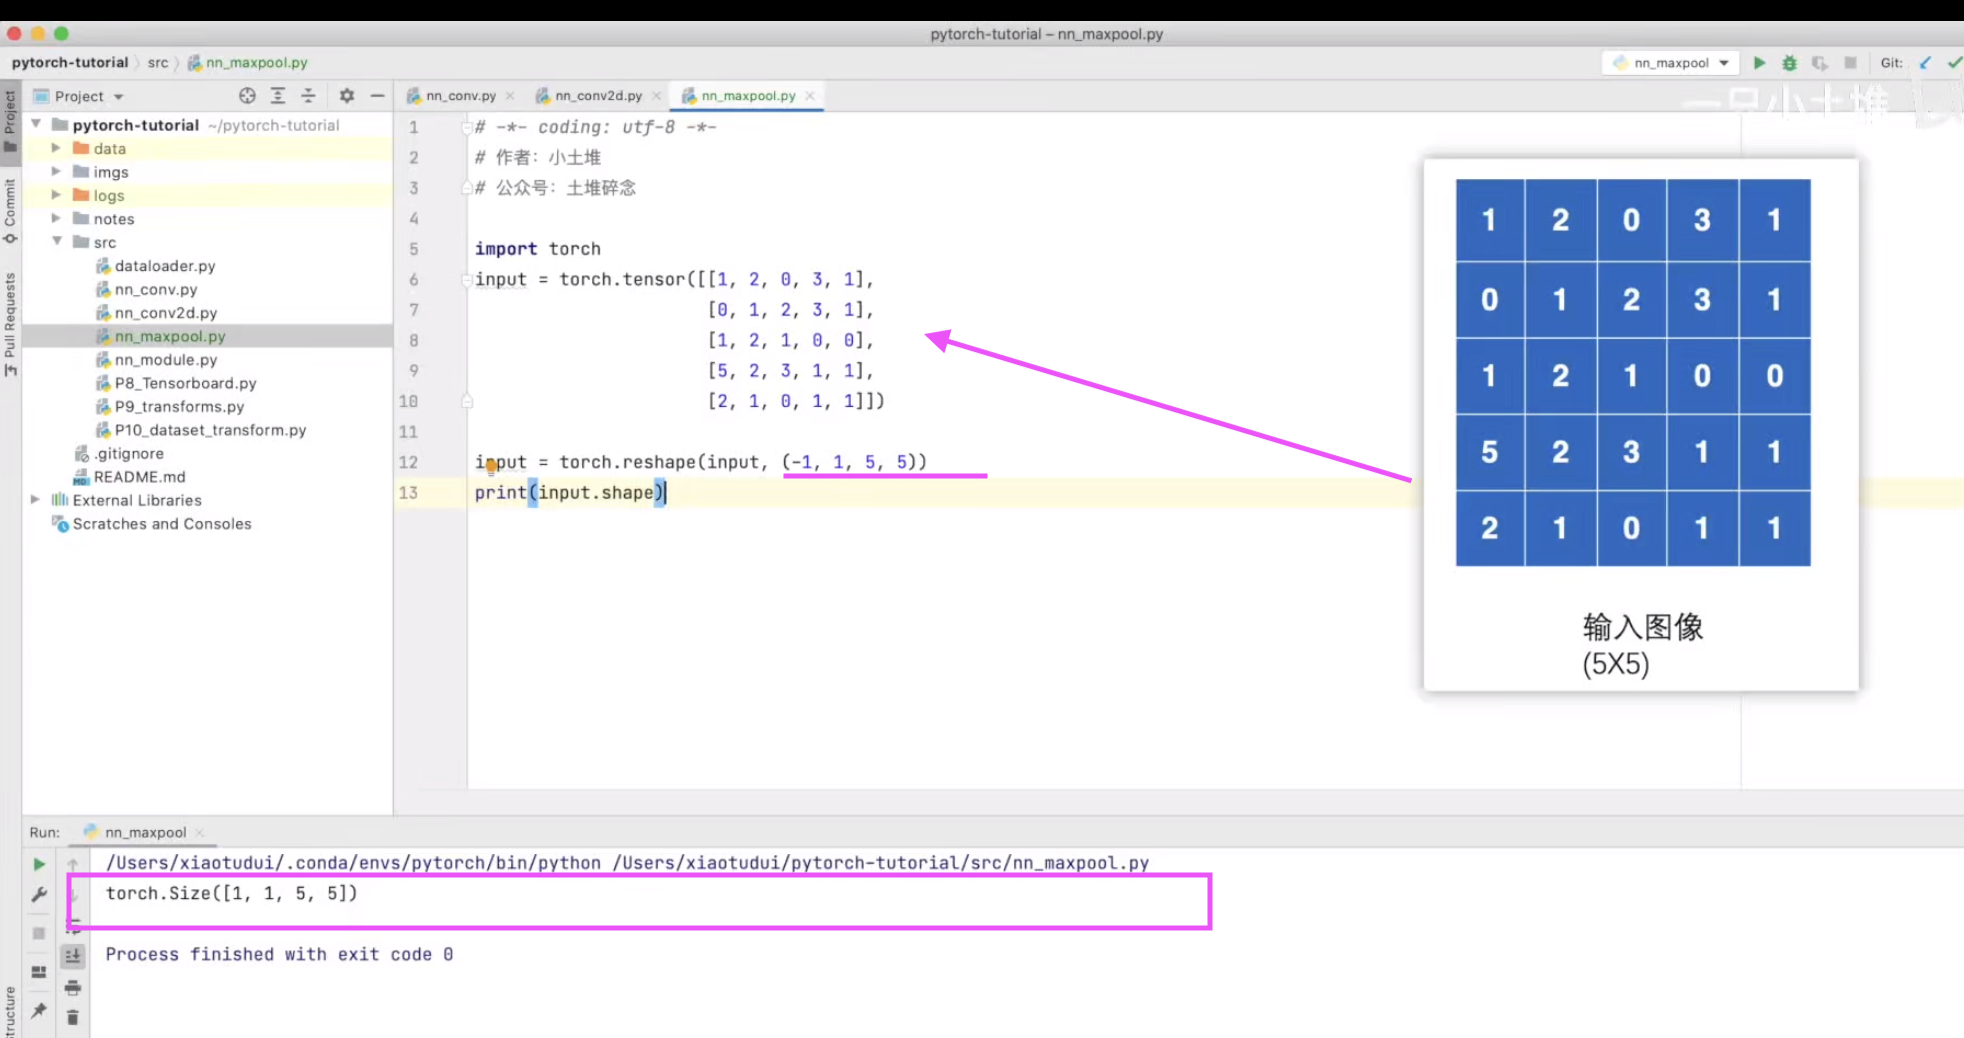
我们执行如下图中代码后,结果报错:
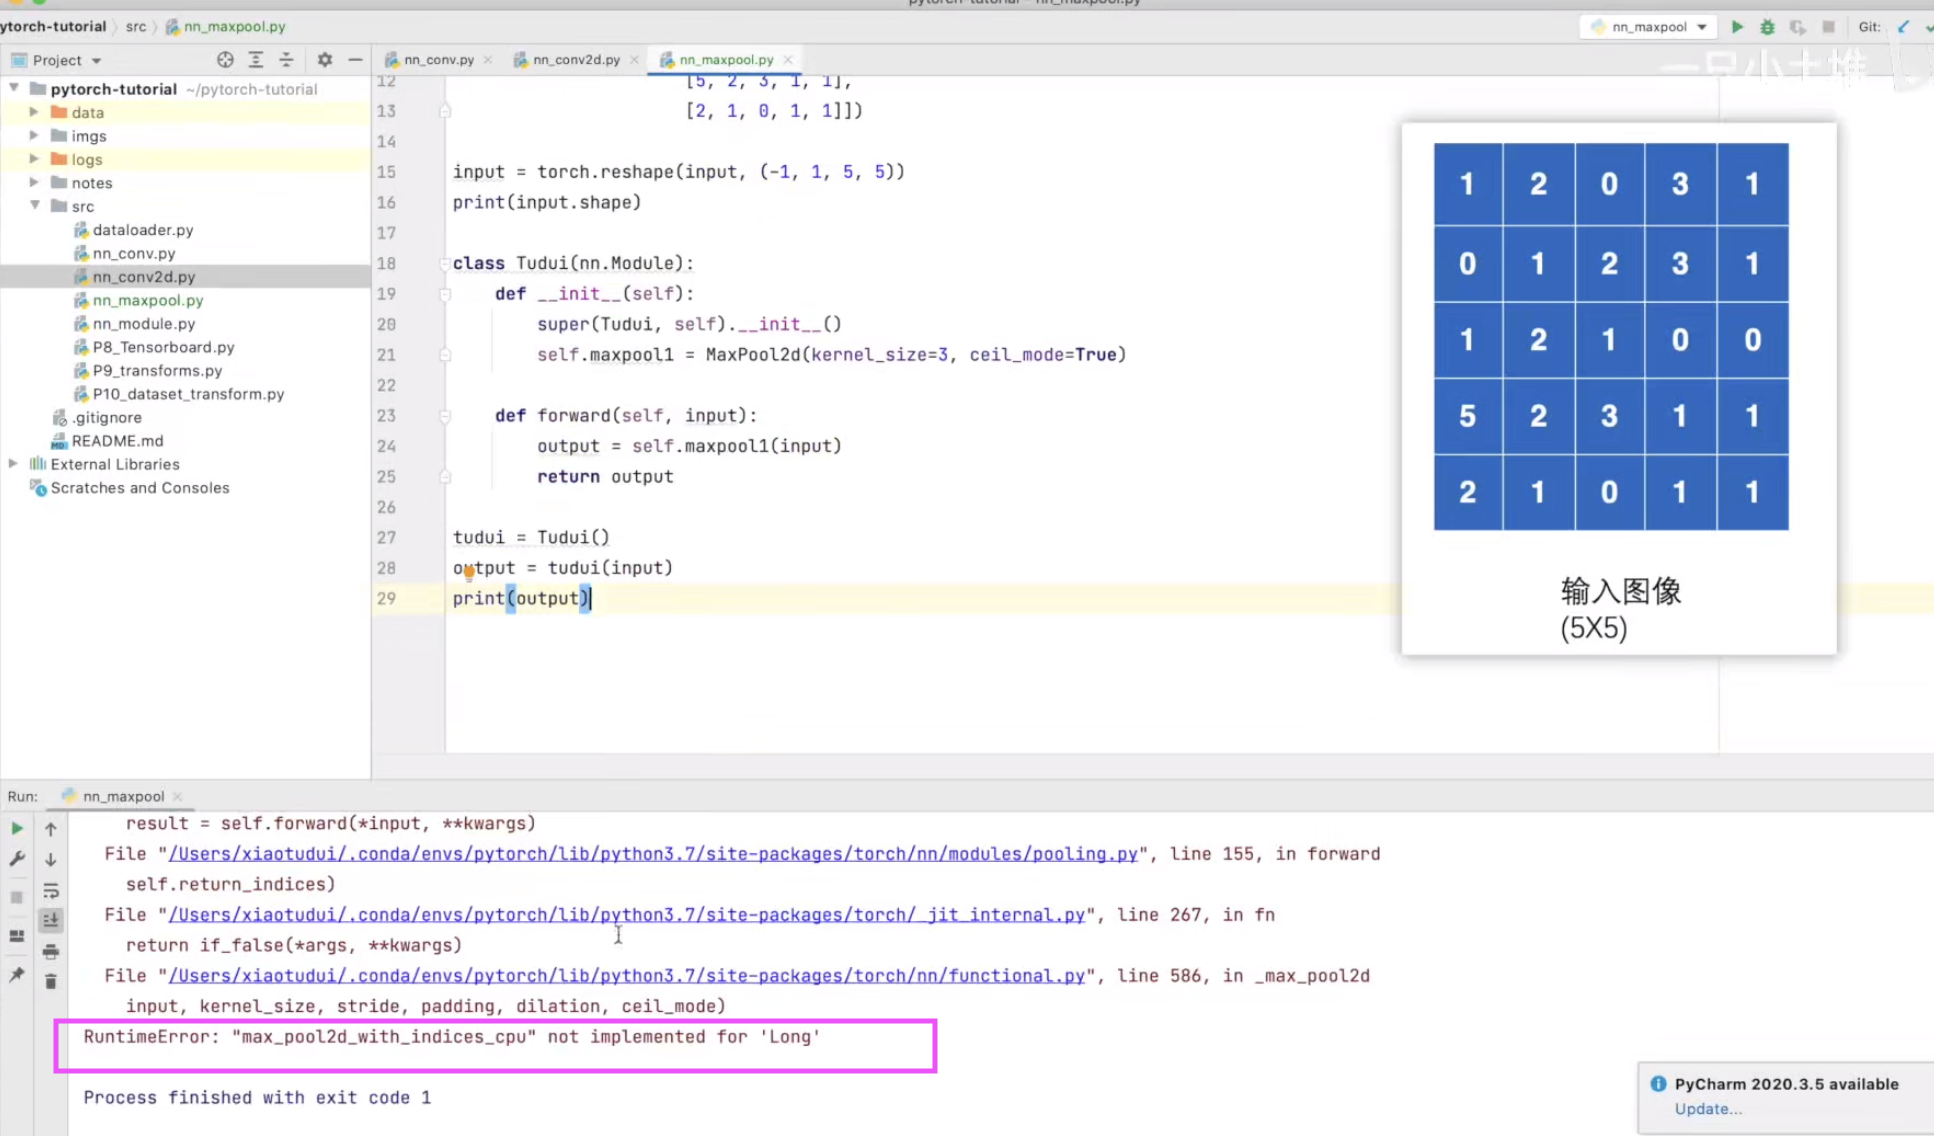
报错原因是最大池化无法对long对数据类型进行实现。因为我们的input矩阵的元素都是1,2,3,它会认为这个是整数。
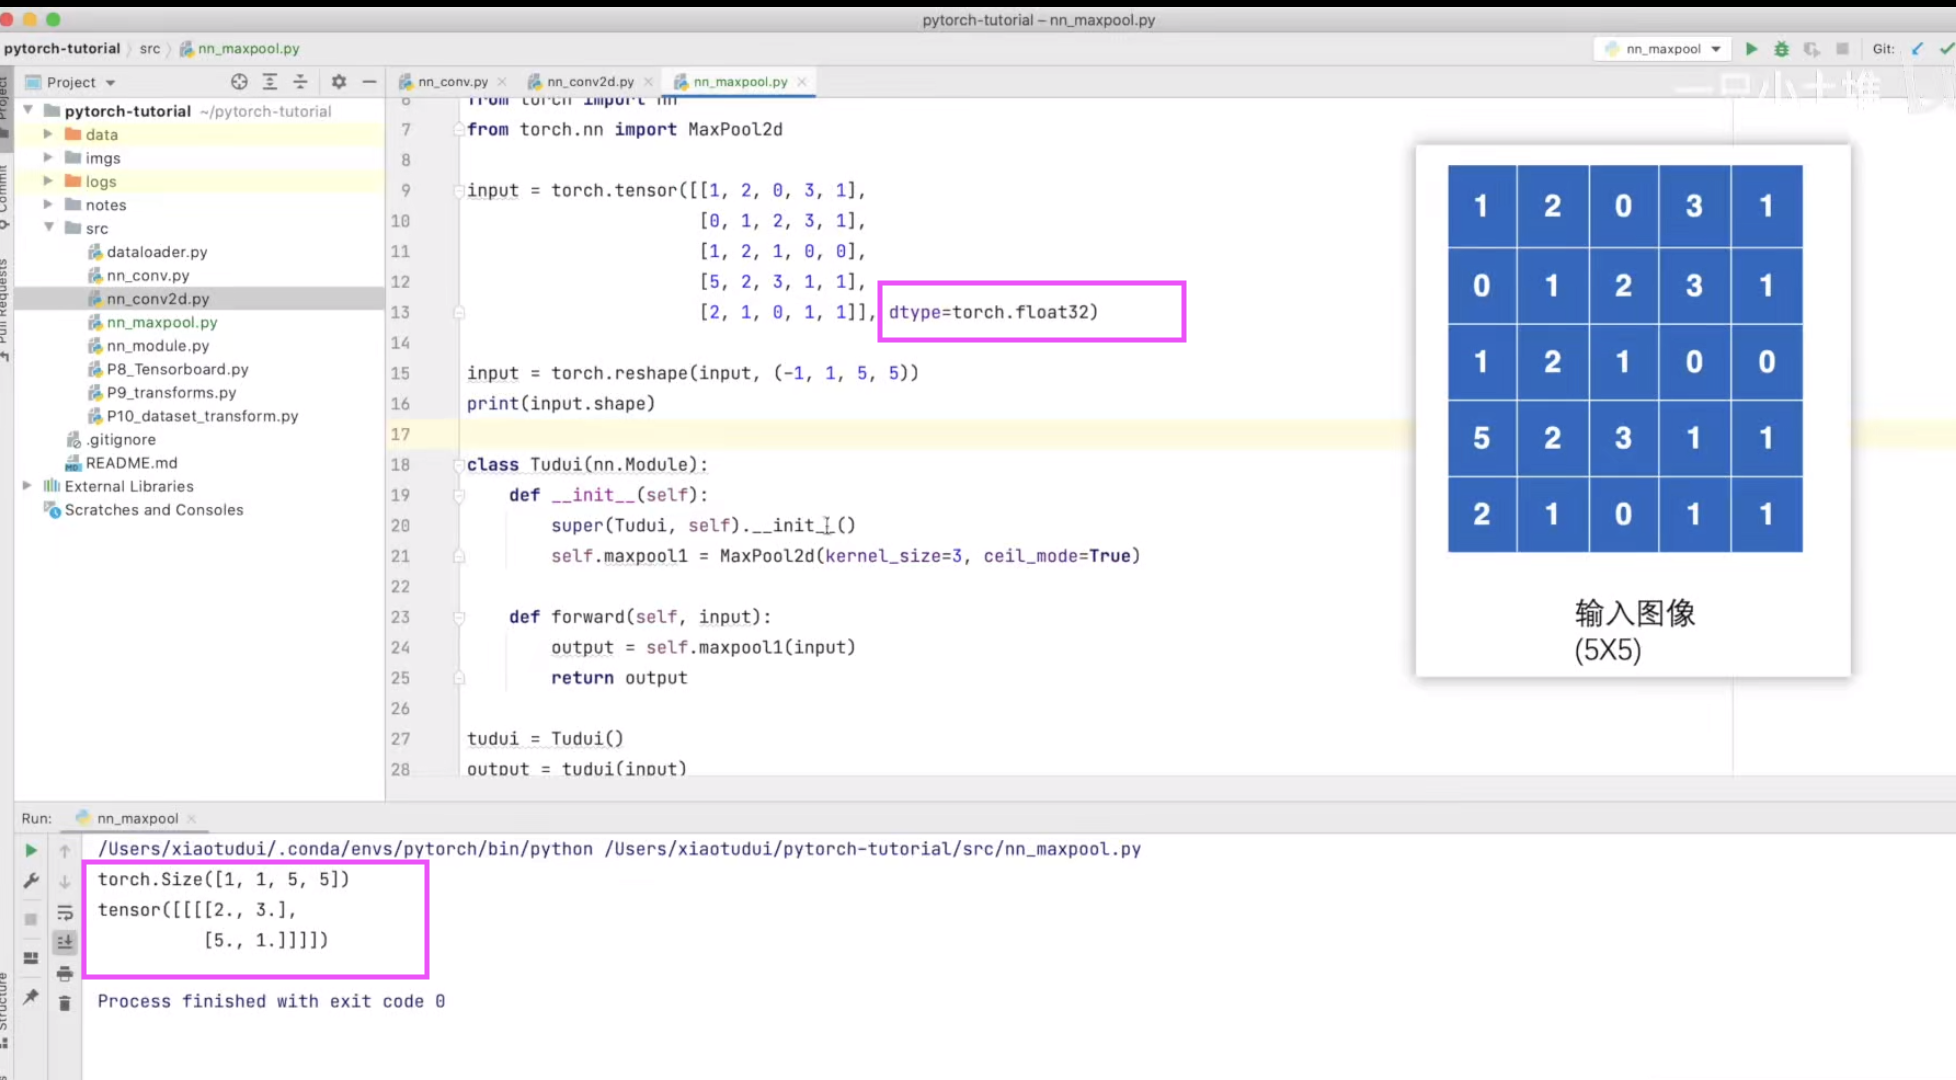
数据类型必须使用浮点型tensor,整数型会报错,可通过dtype=torch.float32指定
我们如下图修改数据类型后,代码能正常执行。
我们将ceil_mode由true改成false,查看池化结果。
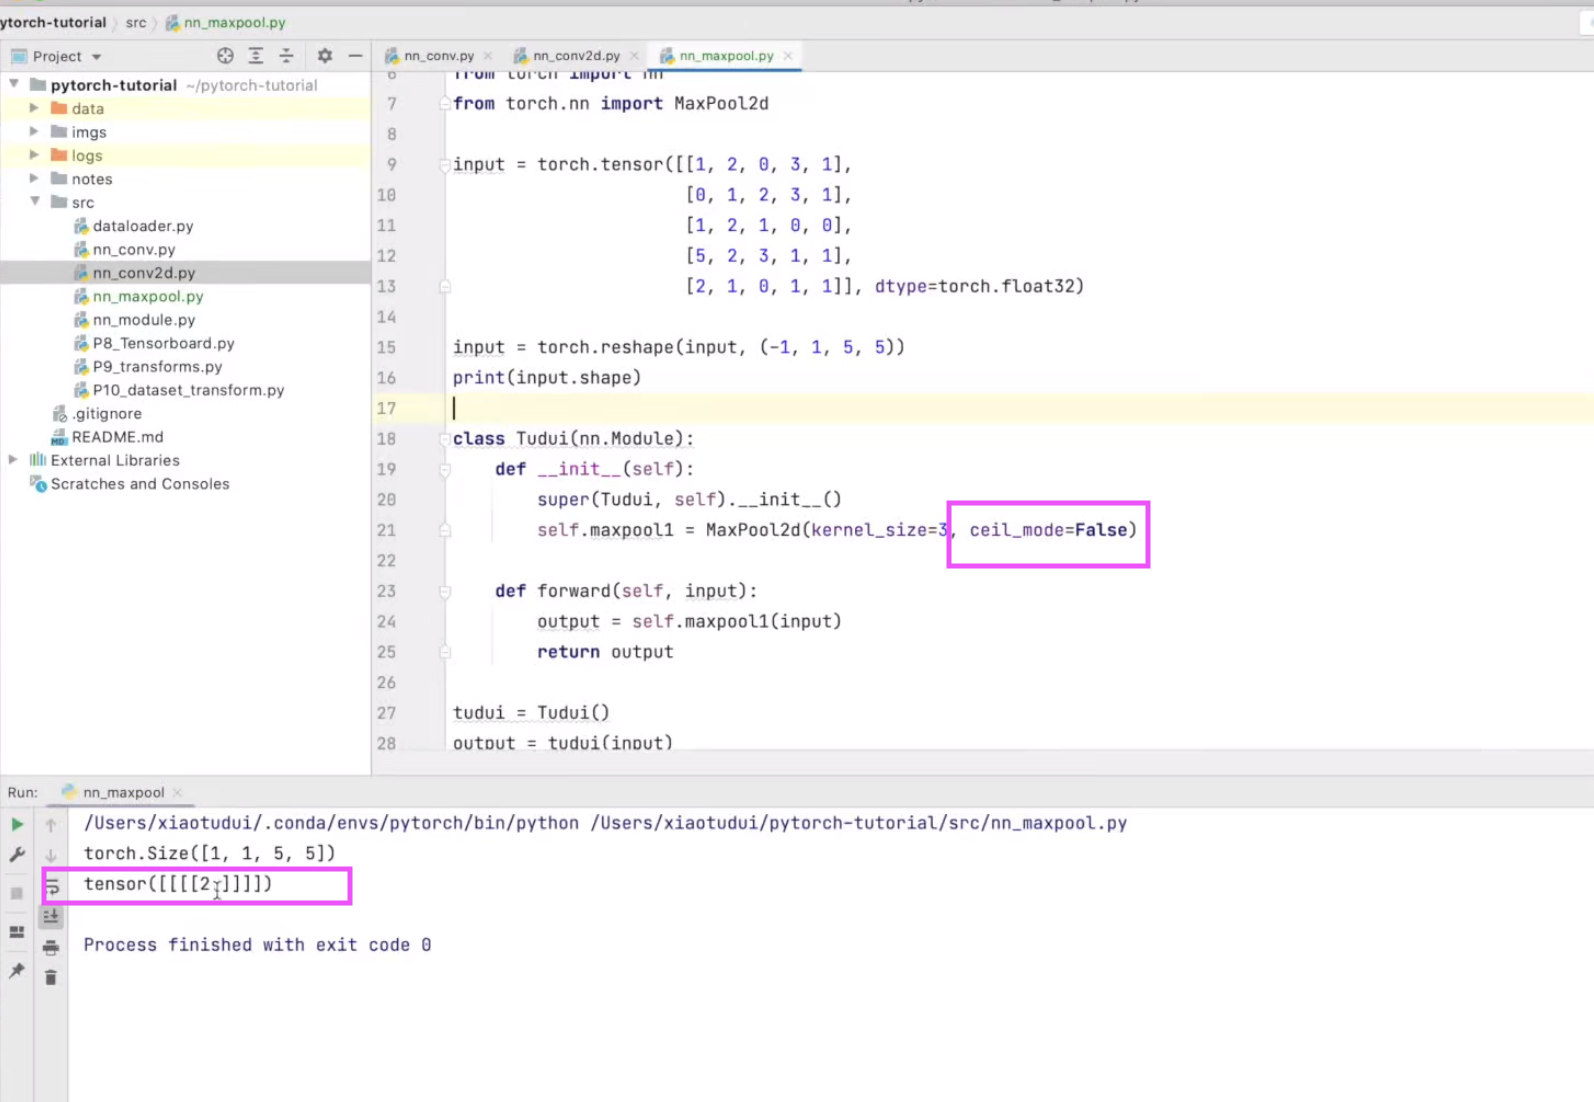
比对代码执行结果和我们演示中的结果,输出图像的值是一致的。
演示操作的整体代码
python
import torch
import torchvision
from torch import nn
from torch.nn import MaxPool2d
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

input = torch.tensor([[1,2,0,3,1],[0,1,2,3,1],[1,2,1,0,0],[5,2,3,1,1],[2,1,0,1,1]],dtype=torch.float32)
input = torch.reshape(input,(-1,1,5,5))
class Tudui(nn.Module):
    def __init__(self):
        super(Tudui, self).__init__()
        self.maxpool1 = MaxPool2d(kernel_size=3, ceil_mode=False)

    def forward(self, input):
        output = self.maxpool1(input)
        return output

tudui = Tudui()
output = tudui(input)
print(output)
最大池化的作用
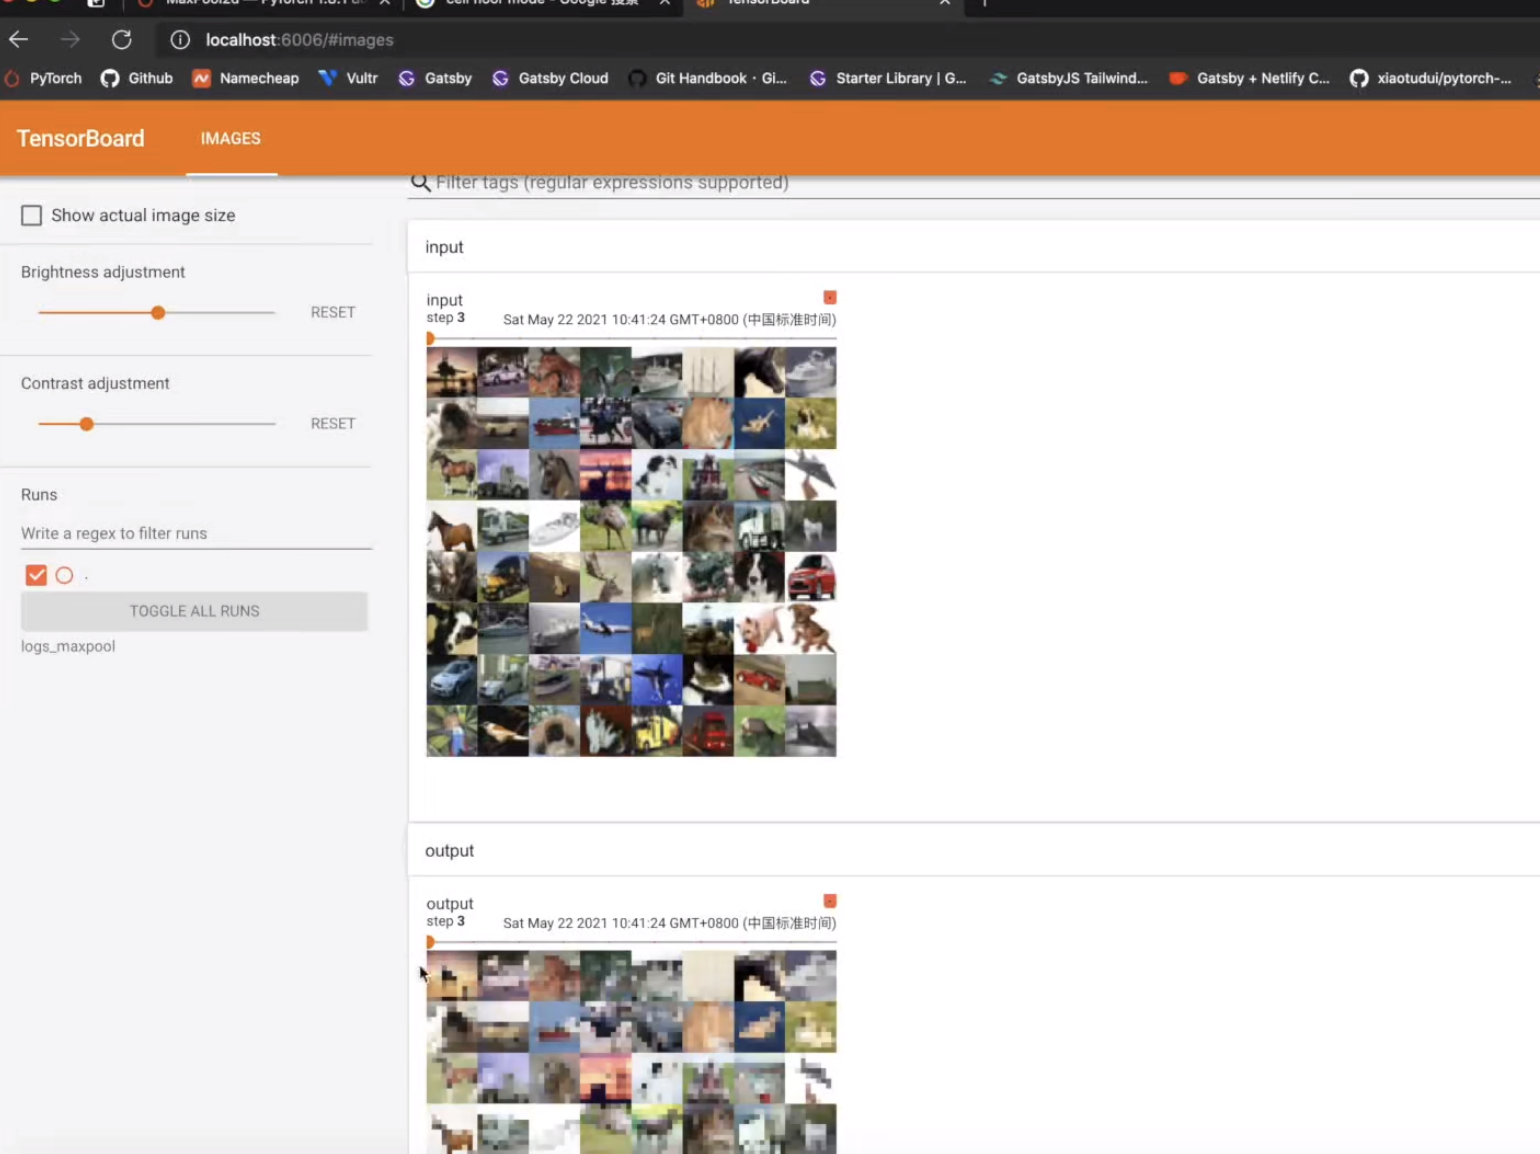
保留数据特征,同时将数据量减小,会训练的更快。
数据压缩:类似视频分辨率从1080p降到720p,保留主要特征同时减小数据量
真实图像的整体代码
下面我们加载真实图像来演示最大池化的效果。
代码关键点:
数据集加载:使用CIFAR10数据集,转换为tensor格式
可视化工具:使用TensorBoard记录输入输出对比
python
# -*- coding: utf-8 -*-
# 作者:小土堆
# 公众号:土堆碎念

import torch
import torchvision
from torch import nn
from torch.nn import MaxPool2d
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

dataset = torchvision.datasets.CIFAR10("../data", train=False, download=True,
                                       transform=torchvision.transforms.ToTensor())

dataloader = DataLoader(dataset, batch_size=64)


class Tudui(nn.Module):
    def __init__(self):
        super(Tudui, self).__init__()
        self.maxpool1 = MaxPool2d(kernel_size=3, ceil_mode=False)

    def forward(self, input):
        output = self.maxpool1(input)
        return output

tudui = Tudui()

writer = SummaryWriter("../logs_maxpool")
step = 0

for data in dataloader:
    imgs, targets = data
    writer.add_images("input", imgs, step)
    output = tudui(imgs)
    writer.add_images("output", output, step)
    step = step + 1

writer.close()
我们在终端运行 tensorboard --logdir="logs_maxpool" 可查看如下可视化结果。我们发现图像经过最大池化后,变得模糊,但是保留了主体特征。
知识总结: