现在,YOLO几乎成了实时目标检测的代名词,但很少有人完整了解它从何而来,经历了什么,如今走到哪一步。
1.故事的开始:计算机怎么学会看?
计算机视觉的起点,比很多人想象的要早。20世纪50年代末,科学家David Hubel和Torsten Wiesel做了一系列实验,对象是猫。他们把电极插入猫的大脑,观察神经元对视觉刺激的反应,结果发现大脑处理视觉信息是有层次的------先检测边缘和线条这类简单图案,再逐层组合成复杂画面。这个发现影响深远,它让研究者意识到**,** 视觉可以被拆解成一步步的特征提取,而不只是一个神秘的整体过程。
1966年,麻省理工学院启动了一个夏季视觉项目,目标是让计算机自动分离图像的前景和背景。项目本身没有完全成功,但它吸引了一批研究者进入这个领域,计算机视觉作为一门学科正式起步。接下来的几十年里,目标检测走了一条"手工设计特征"的路。Haar Cascade被用来做人脸检测,HOG加SVM用来识别人形和车辆。这些方法在特定场景下能用,但换个环境就容易失灵,速度也远远不够快。
2.两阶段检测器:速度上去了,精度没跟上
2010年代,深度学习爆发,卷积神经网络(CNN)让计算机能自动从数据里学习特征,不用再靠人工设计,检测精度一下子被拉高了一大截。R-CNN是这一时期的代表,它的思路是:先在图像里找出可能含有目标的候选区域,再对这些区域逐个分类。精度确实高,但流程太慢,一张图要跑几千个候选区域,每个都要过一遍网络。
Fast R-CNN和Faster R-CNN改进了候选区域的选择方式,速度有所提升,但架构决定了它们的天花板:两阶段就是两阶段,再优化也快不到哪里去。自动驾驶、视频监控、工业流水线,都在等一个更快的方案。
3.YOLO登场:一次不讲武德的颠覆
2015年,Joseph Redmon等人提出了YOLO,全称"You Only Look Once"------你只看一次,这个名字本身就是对两阶段检测器的挑衅。R-CNN要"看两次":先找候选区域,再分类;YOLO说:不用,我看一次就够了。
它的做法是把整张图划分成网格,每个网格直接预测边界框和类别概率,没有候选区域,没有多阶段流程,一张图进去,框和类别一起出来,在当时是相当大胆的设计。因为"快"和"准"在目标检测里长期是一对矛盾,大家都默认要牺牲一个换另一个。YOLO证明了一件事:实时和高精度,不一定非要二选一。
当然,初代YOLO也不是没有代价。它在小目标和密集场景下的表现不如两阶段检测器。但方向已经明确了。
4.十年迭代:从v1到v11,一路进化
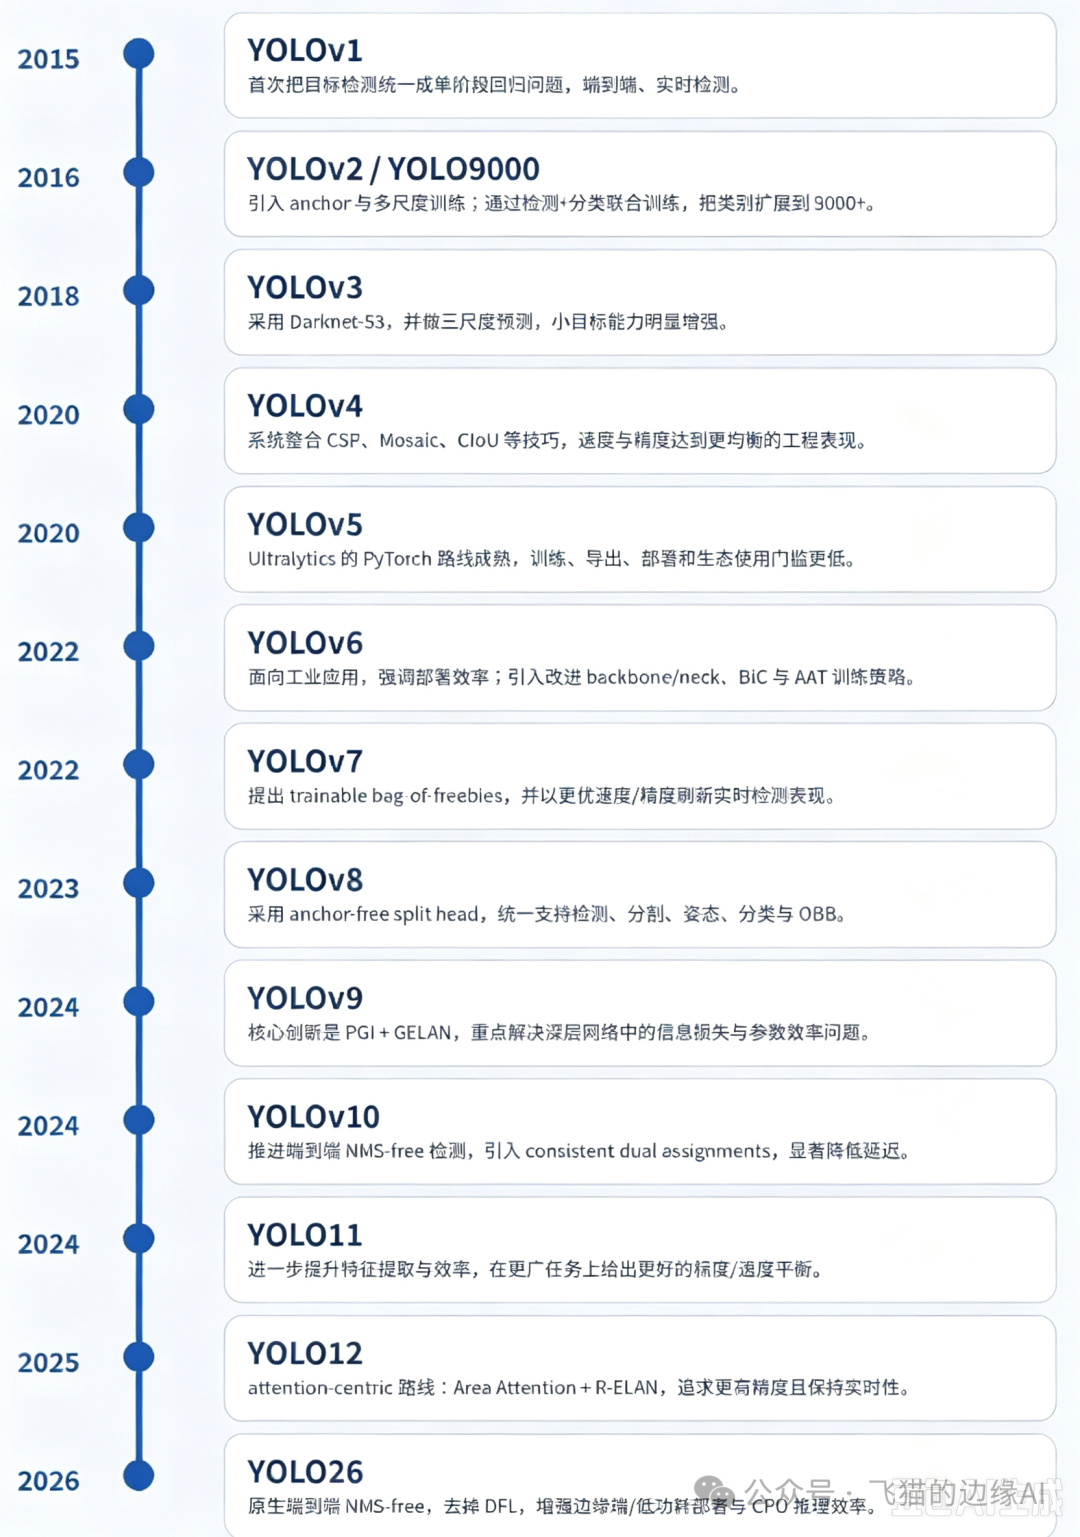
YOLO不是一款固定不变的软件,而是一个持续迭代的系列,十年里它换了多次"引擎"。
1.从学术项目变成工程产品。 YOLOv1到v3由原作者团队维护,偏学术风格。v4和v5开始有更多社区参与,其中YOLOv5是一个转折点------它用PyTorch重新实现,部署体验大幅改善。此后,Ultralytics接手维护,YOLO从一篇论文变成了一个真正好用的工具。
2.架构持续调整。 锚框用不用、骨干网络怎么设计、检测尺度设几个,每一代都在试。YOLOv8是一个重要节点,它转向了无锚框设计,不再依赖预定义的锚框来匹配目标。同时,它开始支持分割和姿态估计,不再只做检测。
3.能力边界不断扩展。 从只做目标检测,到能做实例分割、姿态估计、图像分类。YOLO从一个"检测器"逐渐变成一个"多任务视觉框架"。
这条进化线看似平顺,其实每一步都在回答同一个问题:怎么在速度、精度和部署成本之间找到更好的平衡点。
5.YOLOv26:为边缘设备从新设计
2026年1月,Ultralytics正式发布了YOLO26,定位是"迄今为止最先进、最易部署的YOLO模型"。这款模型最初在YOLO Vision 2025大会上首次亮相,经过数月打磨后正式推出。这一代有两个核心变化:
第一,砍掉了DFL。DFL(分布焦点损失)此前被用来建模边界框坐标的分布,精度上有帮助,但它会拖慢推理速度,还对硬件兼容性不友好。YOLO26直接把它移除了。边界框预测变简单了,边缘设备上跑起来更顺畅。
第二,端到端推理成为原生设计。传统检测模型推理后需要一个叫NMS的后处理步骤,用来过滤重叠的框。NMS本身不复杂,但它增加了部署环节,也引入了额外的延迟。YOLO26训练时同时优化两个"头":一个多对一头,一个一对一头。默认情况下,预测和验证走的是多对一头加NMS,但导出模型时,你可以设置 nms=False,让模型直接输出 (N, 300, 6) 格式的结果,包含 x1, y1, x2, y2, confidence, class_id,完全不需要NMS。对于想把模型塞进摄像头、无人机或工业设备的开发者来说,这个选项省掉了整个后处理环节,部署链路更短,延迟也更可控。
除了架构上的改动,YOLO26在训练策略上也做了调整。ProgLoss在训练早期优先优化一对多头来稳定学习,后期逐渐向一对一头转移;STAL则专门解决小目标的问题------在640像素输入下,小于8像素的物体原本可能一个锚点都分不到,STAL强制给它们分配至少四个锚点,确保这些小目标也能参与训练。
效果如何?官方数据显示,YOLO26n在Intel Xeon CPU上的ONNX推理速度比YOLO11n快了43%,参数量只有2.4M。在多任务上,实例分割掩码AP最高提升3.7,姿态估计AP最高提升7.2,旋转目标检测mAP最高提升3.4。
6.一个模型,多种能力
YOLO26延续了多任务统一的路线。在一个框架里,它支持目标检测、实例分割、图像分类、姿态估计、旋转目标检测(OBB)和目标跟踪,这意味着开发者不需要为每个任务单独找模型、单独搭流程,同一套工具链,训练、验证、推理、导出都能覆盖。
YOLO26还引入了一个新优化器:MuSGD。它把SGD和Muon结合起来,借鉴了大语言模型训练中的一些思路。具体来说,维度大于等于2的参数用Muon风格的更新,低维参数(比如BatchNorm和偏置)保持标准SGD行为。当设置optimizer=auto 时,训练迭代超过10000次会自动选择MuSGD,短训练则回退到AdamW。
这个改动不一定直接体现在推理速度上,但它影响的是训练效率和稳定性,对于想自己训练模型的人来说值得关注。
7.YOLO World:让检测不再受限于预定义类别
除了YOLO26,还有一个值得关注的方向:YOLO-World。它由腾讯AI Lab团队提出,论文发表于CVPR 2024,现已被集成到Ultralytics生态中。传统检测模型只能识别训练时定义好的类别,比如COCO的80类。想检测一个新类别,就得重新训练。YOLO-World支持开放词汇检测------你可以直接用文本提示告诉它要检测什么,比如"检测人和公交车",它就能识别,不需要重新训练。
这种能力被称为"Grounding",把自然语言和视觉数据连接起来。它代表了目标检测和多模态AI融合的一个方向。
8.结语
从2015年YOLOv1的横空出世,到2026年YOLO26的边缘优先设计,YOLO走过了十年。这十年里,目标检测从两阶段走到单阶段,从有锚框走到无锚框,从必须NMS走到可选端到端推理。YOLO的每一次迭代,都在回答同一个问题:怎么让机器更快、更准地看懂这个世界。
YOLO26不是终点。它的双头架构、可选的无NMS推理、多任务统一能力,正在为下一代视觉AI打基础。而对于开发者和爱好者来说,理解这段进化史,比记住某个版本的参数更重要------因为它揭示了技术演进的逻辑:每一次突破,都是在速度、精度和部署成本之间重新找平衡。
说明:1.文章参考公开报道并借助AI工具进行整理和分析,如有不妥之处欢迎指正。2.部分市场数据基于行业估算、发布以及官方报道,具体精确数据请以权威机构为准。3.欢迎长期追踪边缘AI的朋友一起探讨。