论文:Sequence Transduction with Recurrent Neural Networks · arxiv:1211.3711
一句话导读:这篇在 CTC 基础上做了两件事:把"单条 T-长路径"扩展成 T×U 网格里的路径积分(输出长度不再受输入长度限制)、把"帧级独立"的输出替换成"依赖已发 label 的递推"(隐式带了语言模型)。RNN-T/Transducer 后来成为多家工业流式端到端 ASR(Google/Meta/微软等公司都有相关系统)的核心路线之一。
一、CTC 留下的两个坑
CTC(Connectionist Temporal Classification,Graves et al. 2006)用 blank + collapse 规则(合并相邻重复、删 blank)+ 所有对齐路径概率求和作 loss,让 RNN 不靠帧级人工对齐就能端到端训序列识别------但留了两个结构性限制。
符号约定 :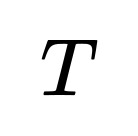 = 输入序列长度(比如声学帧数);
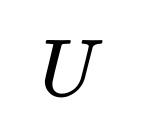 = 目标序列长度(比如音素/字符数);
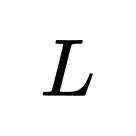 = label 集合;
- / 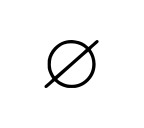 表示 blank。
坑一:输出长度必须 ≤ 输入长度。
CTC 的路径长度固定为 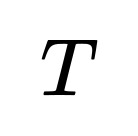 :每个输入步只能发一个 blank 或 label。collapse 之后,非-blank label 数最多也只有
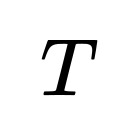 个 。ASR 里
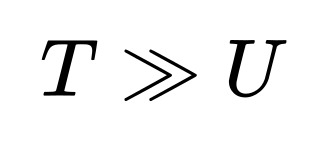 (1000 帧 / 20 phone)通常没问题;但如果源序列 5 个 token、目标序列 8 个 token,CTC 结构上就没有合法路径能装下 8 个目标词。
这个例子只说明长度边界 ------RNN-T 后面会解除 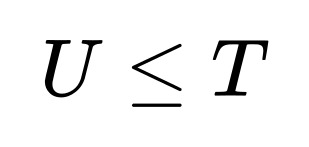 ,但 lattice 仍是单调对齐,不能处理 MT 里常见的词序重排;这类非单调对齐要靠 Attention / Transformer。
坑二:输出之间没有条件依赖。
CTC 的 loss 是:
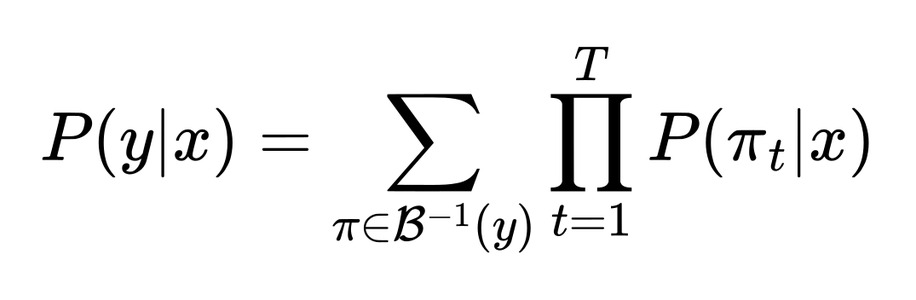
关键在 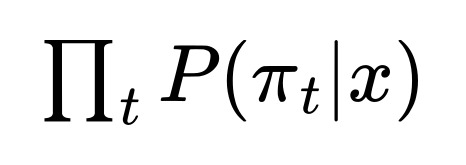 :每一帧的发射只条件于输入 ,不条件于已经发过的 token ------等价于说"给定
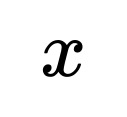 ,帧级发射 token
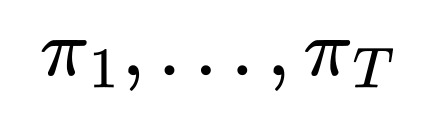 条件独立"(
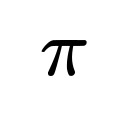 是 collapse 之前的帧级 token,
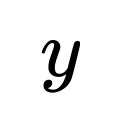 是 collapse 之后的目标序列------即便
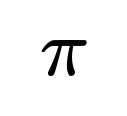 独立,
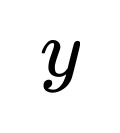 仍由多路径求和得到)。RNN-T 引入 predictor,让下一个 label 的分布显式依赖历史输出------相当于把部分语言模型能力放进端到端结构内部。
RNN-T 的两个改动,正是分别补这两个坑。
二、核心思想:从"一条路径"到"T×U 网格里的所有路径"
一张图讲完两个改动:
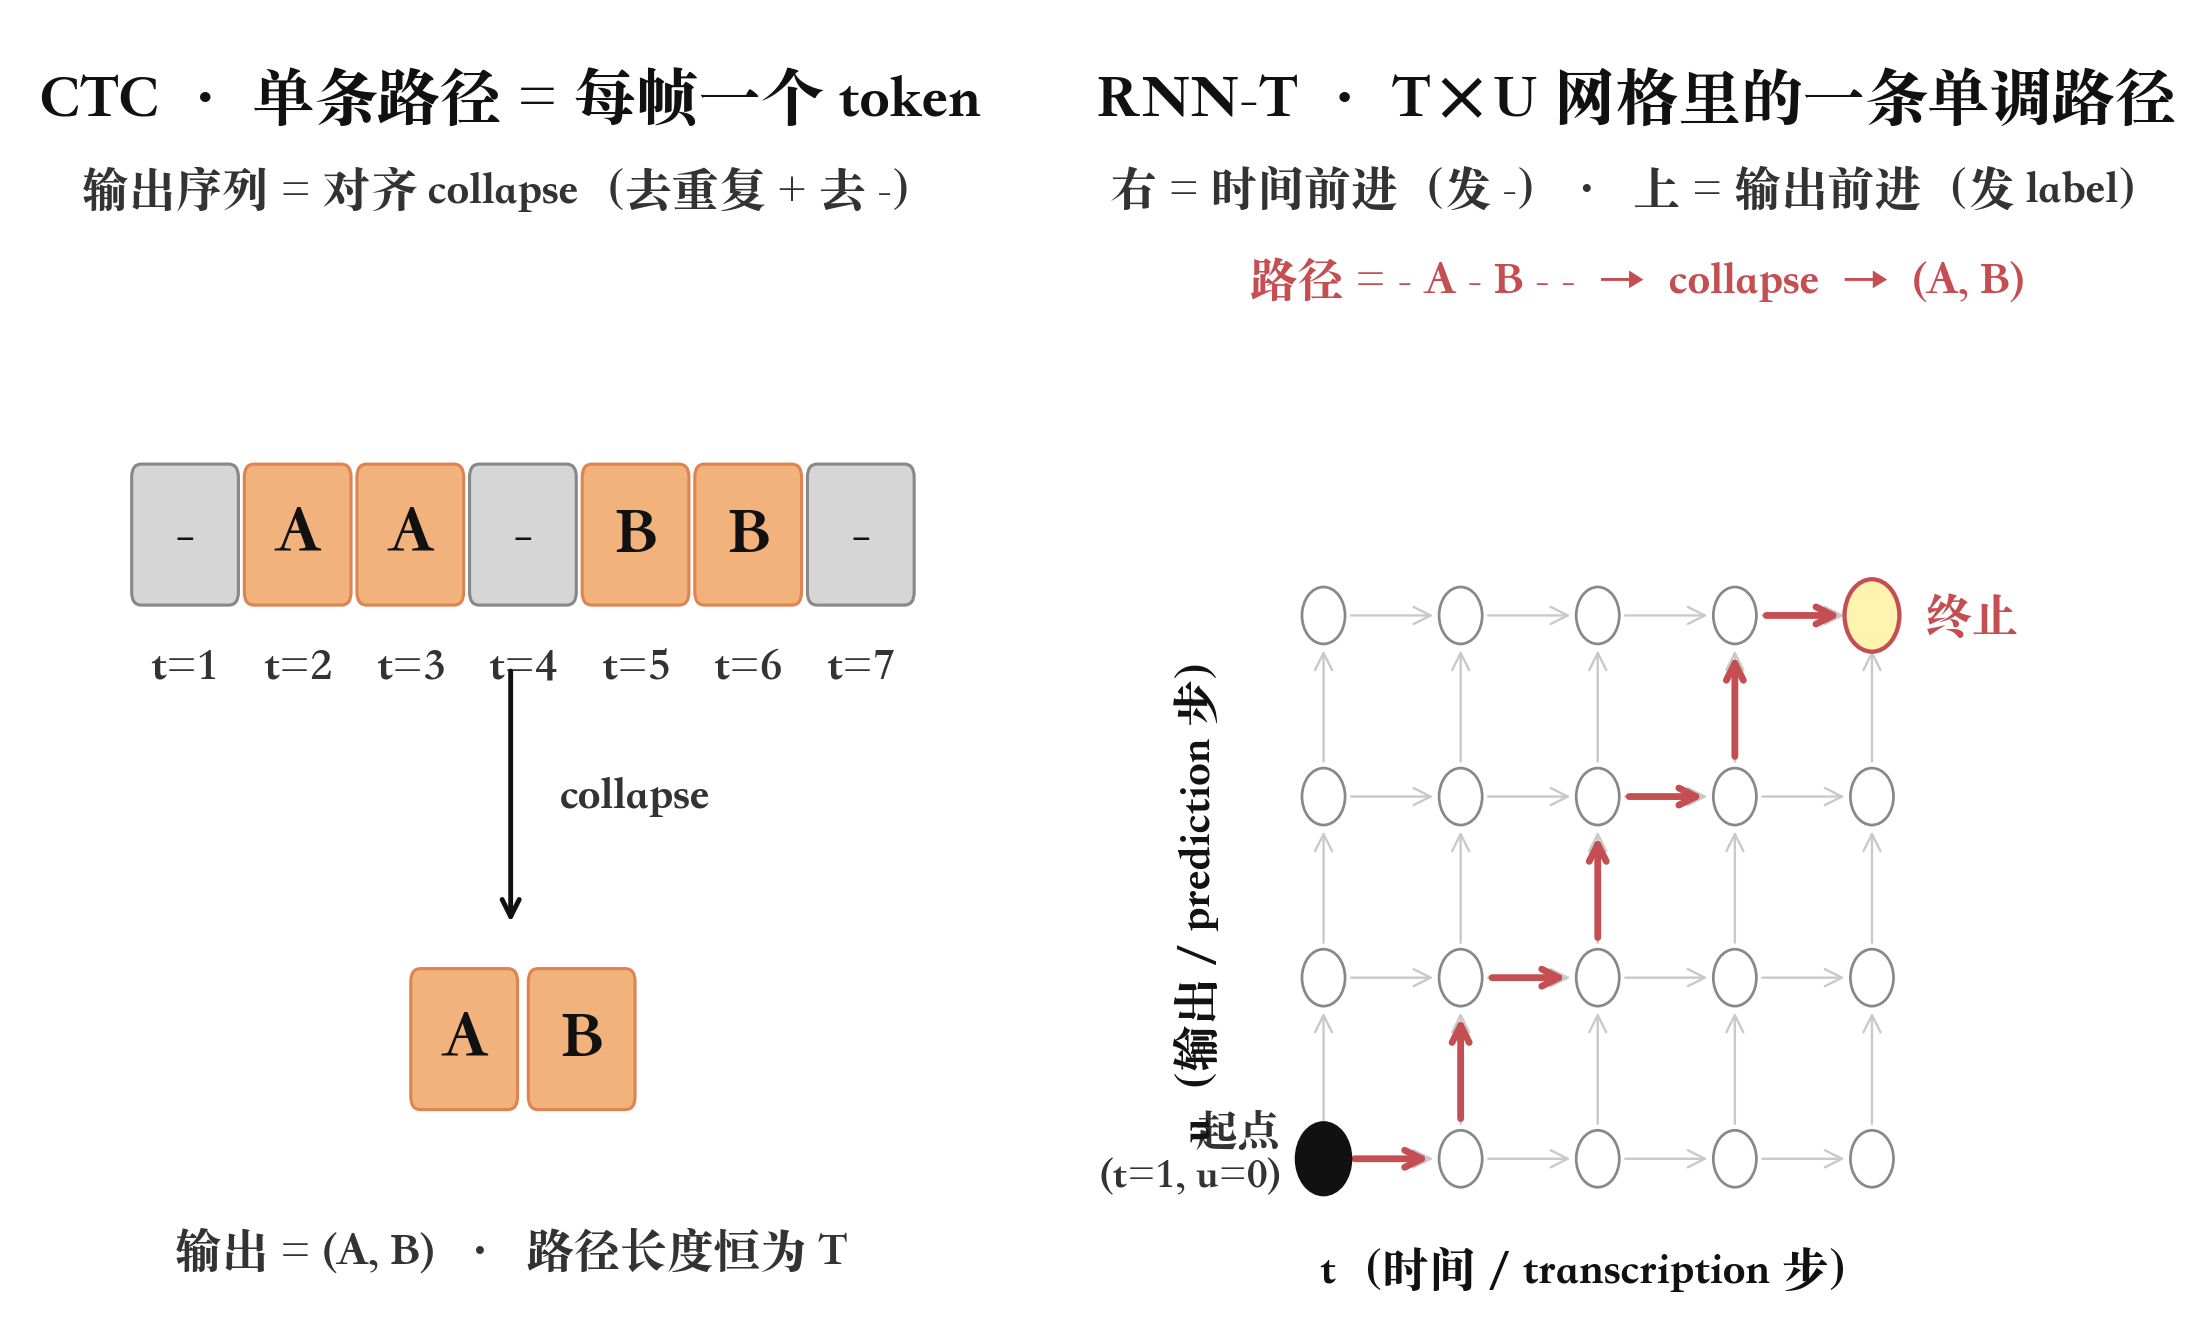
左边 CTC:路径是水平的,长度恒等于 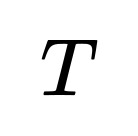 ,每一格填一个 token,最后 collapse 得到输出序列。
右边 RNN-T:路径是二维的,从 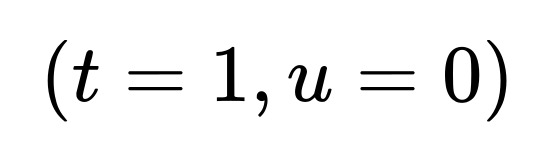 走到
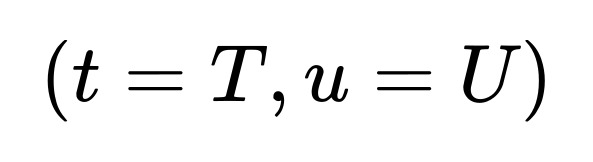 ------每一步要么向右 (发 blank
-,时间 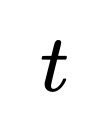 前进一位、输出
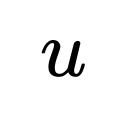 不动),要么向上 (发下一个真实 label,输出
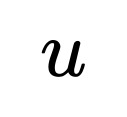 前进一位、时间
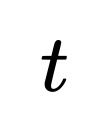 不动)。到达终点后再发一个终止 blank。
两件事同时被解决:
- 纵向可以走多次不消耗时间 ------同一个
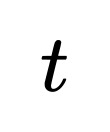 上可以连续向上走多个 label(如 A→B 都在
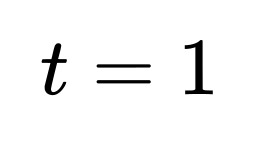 发出),所以
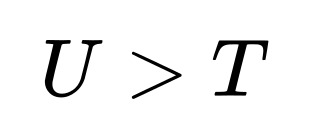 也没问题
- 横向可以走多次不消耗输出------同一个 上可以连续向右走几个 blank,等模型觉得该发下一个 label 时再向上走
回头看 CTC 的路径:它其实是"每步都必须向右"的退化情形------不过要注意两者 collapse 规则不同 :CTC 会先合并相邻重复 label 再去 blank(AAB → AB → AB),RNN-T 只去 blank(A-B → AB)。所以从"路径 → 目标"的映射也不完全一样,两者不能严格视为同一个模型的特例。
三、从真实 ASR 场景到压缩例子:三网络怎么协作
3.1 先看真实 ASR 里的预测形态
一段 10 秒真实语音大约 1000 声学帧(每 10ms 一帧),目标可能是 20 个 phone 或 subword------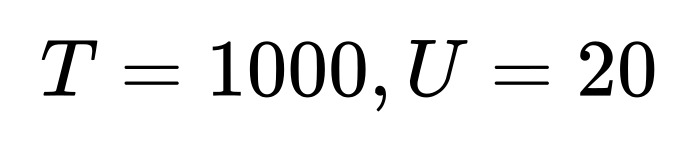 ,
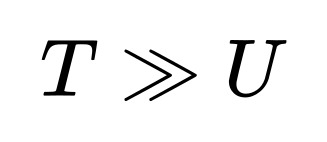 。
RNN-T 在这种数据上跑,每个 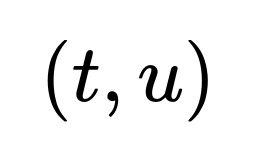 位置都会输出一个 维分布,但大多数位置分布的最大质量都落在 blank 上 :模型在"读"声学帧、还没准备好发下一个 label。只有在少数关键的 上,某个具体 label 的概率会明显抬高。T×U 网格上的一条高概率路径大致长这样 :
- - - - ... A - - - B - - ...------一大堆 blank 中间点缀 label。这个"稀疏发射 + 少数尖峰"的形态会在 §五 用论文原图(fig3 forward-backward 热图)具体看到。
但直接讲 1000×20 的网格没法手算 ------路径数是 ,天文数字。所以下面把它压缩到 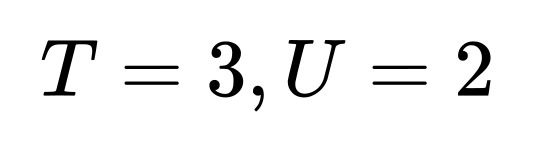 、把 6 条路径全部展开------压缩的是维度、不是机制 。压缩后的例子里 就当作两个 phone 或 subword,具体值不重要------重点是"发 label 让
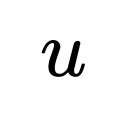 前进、发 blank 让
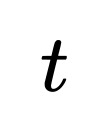 前进"这套决策规则跟真实 RNN-T 完全一样。
3.2 三个网络在一个 (t, u) 格子里怎么协作
先讲单个 格子上的决策,不急着展开所有路径。
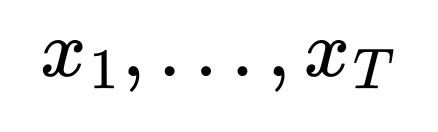
- Transcription 网络 (encoder) :2012 论文用双向 LSTM ,扫全部输入
 ,为每个时间步 输出与 label 维度对齐的声学 logit / 表征
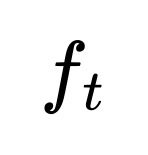 (长度 )。
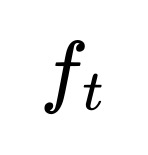 本身不是 token 分布 ------它要跟 predictor 的
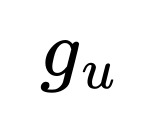 在 joint 里相加后才 softmax 变成分布。后来的流式 RNN-T 换成单向或有限右上下文 encoder,双向不是必需。
- Prediction 网络 (RNN-T 加进来的新东西):单向 LSTM,输入是已发出 的 label 序列
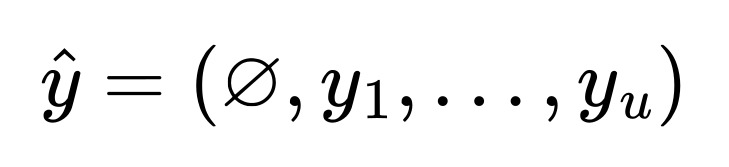 (首位加 表示"什么都还没发"),输出 ------代表"已发 个 label、下一个应该发什么"。它承担类似语言模型的角色,但不是独立训练的 text-only LM:跟 encoder 通过 joint 端到端联合优化。
- Joint 网络 ------ 把
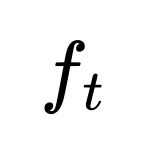 和 加法融合后 softmax:
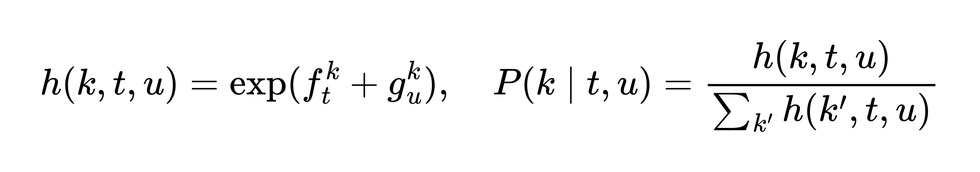
其中 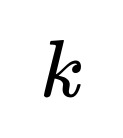 是候选 token( 个之一),上标
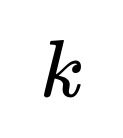 表示
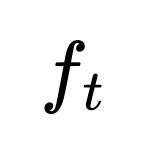 、 向量的第
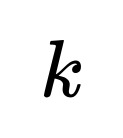 个分量。为什么加法?
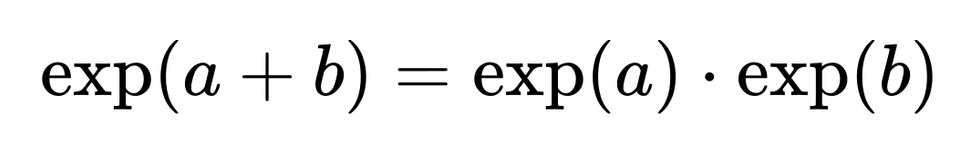 ------可以先缓存
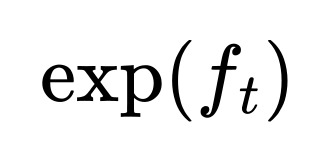 、、再乘一次得到每个
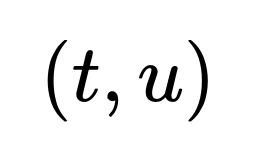 的分布,softmax 分母的指数运算次数从 降到 。
在任意 格子上,joint 只给两条边打分:
- 向右(发 blank):------ 推进、 不变
- 向上(发下一个目标 label):------ 推进、 不变
坐标约定 : 的直觉含义 = 当前看第 个声学位置、已经输出了 个非-blank label。 时下一个 label 是目标第 1 位、 时已发完只能发 blank 到终止节点。注意 只依赖 、不依赖 ------predictor 计算量跟 无关、只在"新发一个 label"时前进一步(输出驱动)。这是 RNN-T 能流式的关键条件之一(另一个是 encoder 也得是单向 / 有限右上下文)。
3.3 压缩到 :6 条路径都 collapse 成
现在把 §3.2 的单节点决策链起来看整条路径。,从起点 走到 ------一共走 步(2 步向右 + 2 步向上), 种排列:
这 6 条不是 6 个候选输出,而是把同一个输出 对齐到 3 个声学时间步上的 6 种方式------因为 collapse 规则只删 blank、把 label 按顺序保留,所有 6 条都 collapse 到 。所以:
(每条路径末尾还有一个终止 blank 从 走到终止节点,图里 6 条前缀路径已省略这一步;具体乘法见下节。)
跟 CTC 对照 :CTC 目标 、 时合法路径是 AAB / ABB / A-B / -AB / AB-------5 条。差别不在数字,而在自由度:CTC 每步必须发一个 token、路径长度恒等于 ;RNN-T 允许 不动 前进,同一个 上可以连发多个 label( 也能覆盖)。
3.4 挑一条路径 - A - B - 逐步展开
选中间一条来看每一步的 转移、每步用哪个 、取哪个概率:
| 步 | 动作 | 从 | 到 | encoder 用 | predictor 用 | 该步概率 |
|---|---|---|---|---|---|---|
| 1 | 发 - |
(空前缀) | ||||
| 2 | 发 A |
(空前缀) | ||||
| 3 | 发 - |
(已发 ) | ||||
| 4 | 发 B |
(已发 ) | ||||
| 5 | 终止 blank | 终止 | (已发 ) |
整条路径的概率 = 5 个条件概率连乘:
三个关键观察:
- 发 blank 时 前进 不变 → 下一步 encoder 换 、predictor 仍用同一个
- 发 label 时 前进 不变 → 下一步 encoder 仍用同一个 、predictor 换 (把新发的 label 喂进去更新一步)
- 同一个 被多个不同 的格子复用( 在 、 都用到)------同一个 predictor state 跨 复用,正是 predictor caching 优化的基础
6 条路径都这么算、每条得到一个概率、加起来 = 。 稍大就变组合数级------§五 讲 的 forward-backward DP 高效算这个和。
3.5 回到真实 ASR:为什么大多数格子都选 blank
回到 §3.1 那个 1000 帧 / 20 phone 的场景。真实 RNN-T 里,模型倾向在绝大多数 上发 blank ("这一帧还没积累到足够证据、再听一帧")、只在少数关键 上让某个具体 label 的概率超过 blank。等价地说: 网格里的高概率路径带集中在斜对角上、其它区域概率极低------这正是 §五 论文原图 fig3 里" 和 都呈一条从左下到右上的高亮对角带"背后的直觉。
四、CTC 帧独立 vs RNN-T 输出依赖:一图对照
回头对比 CTC 和 RNN-T 在图模型层面的不同:
注意左右两边符号不同、只讲一件事 ------CTC 面板是 (帧级发射 token,长度 )之间条件独立;RNN-T 面板是 (目标序列元素,长度 )之间显式建模依赖。图右只画了 predictor 的历史依赖 (),并不是 RNN-T 的完整概率分解------完整分解还包含 blank 和 上的路径求和,见 §二 网格图。CTC 独立的是 、不是最终目标 :后者仍由多条 路径求和得到,不能简单看成独立。RNN-T 的 之间那条红边就是 predictor LSTM 的递归连接。
RNN-T 因此可以不外挂 语言模型(依赖关系已内置在结构里、跟声学联合端到端训);但要注意 predictor 不等价于独立的 text-only LM------它只见过训练集里目标标注序列、能力受这个规模封顶、还跟 blank/声学项在 joint 里竞争概率。生产系统里 shallow fusion 或 rescoring 外挂 LM 仍然常用。
五、训练:T×U 网格上的 forward-backward
有了每个 的输出分布 ,剩下的问题是:怎么算 ------所有能 collapse 到目标 的路径概率之和?
在网格上,每个节点 有两条出边:
- 向右(发 blank):概率
- 向上(发 ):概率
forward 变量 :从起点 走到 的所有路径概率之和。递推有两条入边------从下方节点 上来(发 label)、从左方节点 过来(发 blank):
初值 。边界约定:越界节点(、 之类)视为 ,所以第一行 / 第一列只保留有效入边; 处的终止 blank 边单独处理,不进 递推。
总概率:
(终点从 发一个终止 blank 结束)。
backward 变量 对称定义:从 走到终点的路径概率之和。
初值 。同样约定:越界节点 、 视为 。
乘积 是"经过 的所有路径的总概率"。论文里的 Figure 3 直接把这三个量画成热图:
左 / 中 / 右三块分别是 (forward)、(backward)、(product)三个量的对数值热图;每块下方是对应同一段输入的 spectrogram。图里 label 序列 "THAT DOESN'T MEAN HE WILL TRY TO BUY MCDERMOTT" 竖排在最左侧(原论文排版);每张热图横轴是 transcription 步 、纵轴是输出步 。三个观察:
- 从起点向终点累计------低 区已经能覆盖多种对齐(亮度沿高 方向发散)
- 从终点向起点累计------高 区往回反推(对称形态)
- 乘积集中在一条从起点到终点的对角带------所有对齐的高概率区域重合
loss 就是 ,对 和 求梯度,再 BPTT 到两个 RNN 的参数。梯度的核心表达式------只写有效出边(label 分支要求 、blank 分支要求 ;终止 blank 边 单独处理):
直观含义: 处发某个 的梯度权重 = (走到这里的路径质量)× (从这里到终点的路径质量),再对总概率归一化------每条路径按 posterior 加权分摊 loss。
六、推理:beam search
训练 vs 推理的搜索空间 :训练时目标 已知、只有对齐未知,、 时能 collapse 到 的路径数是 ------不枚举这些路径,§五 的 forward-backward 在 个格点上就把这 条路径的概率求和算完了,这就是那两个递推公式的意义。推理时更难: 本身未知,label 序列空间已是指数级(长度和内容都不定),每个候选 又对应指数级对齐路径。严格求 不能靠枚举。
问题 :predictor 依赖已经决定发的 label()------所以 predictor 不能预先算完,得随着 beam 展开一步步递推。
实践做法 :beam search 只在 label 前缀树(不含 blank)上保留宽度 的候选,把"对所有对齐做 log-sum-exp"的严格分数近似成"只在保留下来的前缀/对齐里累计概率质量"------被剪掉的路径质量不再回来。 是精度和延迟的权衡:论文在 TIMIT 上用 (目标 phone 序列短、可以搜得很宽),线上系统通常小得多、按延迟预算调到几到十几。
教学版 beam search 骨架 (论文 Algorithm 1 意译;省略了 prefix 概率合并 ------ 完整算法里"同一序列可能被多条前缀+扩展凑到"要显式合并;停止条件也简化了):
初始化 B = {空序列}, P(空) = 1
对 t = 1..T:
    A = B, B = {}
    while B 里的元素数量还不够 W (beam width):
        y* = A 里概率最高的序列
        从 A 中移除 y*
        p_old = P(y*)                                # 保留原分数
        # 分支 1: 在 t 处发 blank,序列不变,进入 B(下一步 t)
        P(y*)_new = p_old * P(blank | y*, t)
        把 y* 加入 B
        # 分支 2: 在 t 处发某个 label k,序列长度 +1,仍留在 A(同 t 再展开)
        for k in labels:
            P(y* + k) = p_old * P(k | y*, t)
            把 y* + k 加入 A
    B 只保留概率最高的 W 个
返回 B 里长度归一化 log 概率最高的
关键 :blank 分支和 label 分支都用 原始的 展开,别改写 P(y*) 后再拿去乘 label------不然 label 分支会多乘一次 blank 概率。
关键实现优化 :predictor 是输出驱动的------一个序列 只要 label 内容不变,predictor state 就不变,跨 复用。作者论文里明确说"stored the hidden vectors for all "------这正是后来所有生产系统里 predictor caching 的雏形。
length normalization:最后按 排最优------否则 raw log-prob 会系统性偏向短输出(长序列更多因子相乘、概率越小)。
七、实验:TIMIT PER
数据:TIMIT 音素识别(3696 训练 / 192 测试 / 39 phone 目标)。作者对三个模型做对照:
| 模型 | Epochs | Log-loss (bits/phoneme) | Error Rate |
|---|---|---|---|
| Prediction 单独 | 58 | 4.0 | 72.9%(next-phone 分类错误率) |
| CTC 单独 | 96 | 1.3 | 25.5%(序列 PER) |
| RNN-Transducer | 76 | 1.0 | 23.2%(序列 PER,比 CTC pp) |
注意三行 Error Rate 口径不同:Prediction 行是"给定前 个音素、下一个音素分类是否正确"的分类错误率,CTC/RNN-T 行是序列 PER(输出与目标的编辑距离 / 目标长度)。三者能看趋势,但不是同一个评测任务。挑几个点看:
- Prediction 单独 72.9% 分类错误率 说明只有语言模型、没有声学输入,下一个 phone 几乎猜不对------更直接的证据是它的 log-loss 4.0 bits/phone 只比目标分布熵 4.6 bits 好一点
- RNN-T 比 CTC 少 2.3 个百分点 PER ,但差距没有想象中大。作者自己承认:TIMIT 只有约 150K phone 标注,predictor 见过的语言数据太少,隐式 LM 学不出多少东西;语言模型训练数据通常需要百万级 token
- 论文 Figure 4 的 jacobian 分析(下图)展示了模型学到的输入-输出敏感度------注意这张图不是 TIMIT 音素识别的结果 ,而是论文附带的字符级端到端语音识别实验可视化(把 spectrogram 直接转成字符序列):
图中各块位置说明:右上 是 的概率格子高亮对角带;右下 是输入 spectrogram;下方黑红热图 是当前十字点处对声学输入的敏感度;左侧红黑热图 是十字点对历史输出 (predictor 输入)的敏感度;中左 是黑底白点的历史字符 one-hot 输入;左下柱状图给出 transcription(红)、prediction(绿)、joint(蓝)三个源在十字点对候选字符的偏好。作者用这张图想说:两个 RNN 都学到了长程依赖(predictor 不是只看前一个字符、transcription 也不是只看当前帧)。柱状本身能看出 transcription 和 prediction 常有不同偏好、joint 把两者合成为最终分布。
八、局限与分析
论文自己已经点出两个问题:TIMIT 只有约 150K phone 标注,predictor 学不到强语言先验,所以相比 CTC 提升有限(2.3 pt PER);beam search 因为 predictor 依赖历史输出,天然 sequential,只能靠 state caching 缓解。作者建议 predictor 先在大目标语料预训、再联合微调------这个思路后来也进入了工业 RNN-T 系统的常见训练 recipe。
三个值得强调的判断:
-
两个改动的重要性不对称 。 网格解除 是结构上重要的扩展,但 ASR 里 通常不是瓶颈;RNN-T 后来在流式 ASR 里成为主流路线之一,核心还是 predictor 带来的输出依赖。 的能力主要被后续 Attention seq2seq / Transformer 类模型(TTS、MT 场景)用上,不是 RNN-T 本身的主战场。
-
RNN-T 的适用边界是单调对齐 。它能在同一个 连续发多个 label、也能靠 blank 推进时间,但 只能向前走、不能回头查询任意输入位置------所以适合 ASR / TTS 这类近似单调任务,做不了 MT 的词序重排。要真做流式,还必须把 2012 论文里的双向 encoder 换成 causal 或有限右上下文的(Chunk-BLSTM、Emformer 都属这类改造)。流式的三件事缺一不可:blank 推进 + label 原地展开 + causal encoder。
-
训练成本和内存压力通常显著高于 CTC 。forward-backward 本身 ,但朴素 joiner 若 materialize 全部 logits/probs 会到 级别;warp-transducer(
github.com/HawkAaron/warp-transducer)、k2pruned RNN-T loss、pruned lattice 这些工程优化本质都是在压这个成本。
Joint 的加法融合表达力有限,但计算简单、可预计算 、内存友好------这是它能工程化上生产的重要原因,Conformer-T / Stateless Transducer 的改进都在这层微调。
跟 CTC 对比的一句总结:CTC 是"绕过对齐"的最小方案,RNN-T 是"绕过对齐 + 内置输出依赖"的最小方案。后续 Transformer-T、Neural Transducer、SqueezeFormer-T 主要在 encoder / predictor / joint / loss 工程上继续改,网格路径求和这个核心框架沿用至今。