题目链接:P3384 【模板】重链剖分 / 树链剖分 - 洛谷
注:由于树链剖分通常结合线段树进行维护,建议还是先学会线段树再来学习树剖。如有兴趣可查看本人博客文章:【数据结构进阶】万字图解线段树:从前缀和到区间修改的完美进化 (洛谷P3372 附C++模板)-CSDN博客
维护一个线性的数组是很常见的,方法也有很多,比如前缀和,差分,线段树等等方法,可以让我们快速的对数组里的值进行增删改查。但是如果现在要求的并不是维护数组,而是要求维护一棵树上节点的权值,也要支持快速地增删改查,这似乎并不容易。因为相比来说,数组的值是连续的,找到一个区间非常简单;树上要想找到一个"区间"(视作两点间的最短路径上所有的节点,最短路径即两点通过最近公共祖先 LCA 的路径),这显然是非连续的值,看上去我们只能逐层跳跃进行查找这些值,而这实在是太慢了。为了解决在树上的两点最短路径的快速增删改查问题 ,就需要利用树链剖分来解决。
树剖原理
树链剖分的核心思想非常简单:既然数组维护起来很简单,那就将树按某种规则划分成一条条链条,使其转化为线性的数组,从而可以用维护数组的方法去维护树了。
而我们划分树上每一个链条的时候,都是按照优先递归划分"重儿子"方向,后递归"轻儿子"方向去划分,直到到达叶子节点。(看不懂没关系结合后面的剖分示例或许能理解)所以有时候树链剖分也称作重链剖分。一个节点的重儿子很好理解就是包含节点数量最多的子树,除此之外都是轻儿子。至于为什么要按照先递归重儿子去划分暂且不提,先记住后面再仔细说明。
我们以下面这个树为例演示一次如何进行剖分,链头表示这条链以哪个节点作为起点。
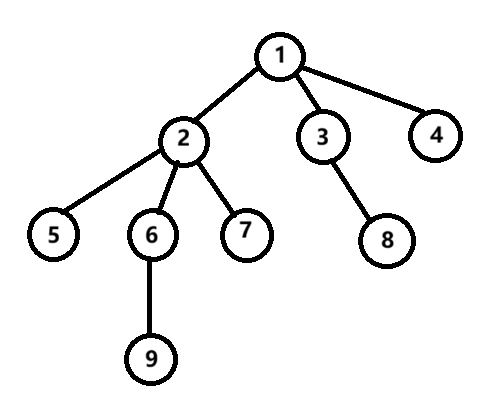
从根节点 1 开始,很显然我们一眼看出节点 2 方向是节点 1 的重儿子,而节点 6 也是节点 2 的重儿子,节点 6 的重儿子是节点 9 。那么由此找出第一条树链就是 1 2 6 9 ,链头就是节点 1 了。
找出第一条链后,节点 2 这里它的其他儿子还没有进行划分呢,由于节点 2 这个地方的重儿子划分好了,节点 2 的轻儿子都可以各自作为一个链头,即 5 和 7 都是链头,恰好节点 5 和 7 都没有儿子了,那么这里又划分出来两条链分别是 5 和 7 。
这个时候节点 1 的重儿子节点 2 已经划分完成了,接下来就是处理节点 1 的轻儿子节点 3 和 4 了。和刚刚一样,节点 3 和 4 都作为各自新一条链的链头,明显节点 3 这里划分的一条链就是 3 8 ,节点 4 这划分得到的链是 4 。到此这棵树的划分就完成了,存入数组 a 就变成了如下图所示,底下画着一条红线代表是一条链,按顺序的整齐放好,非常直观。
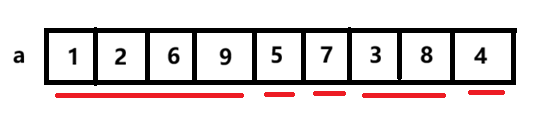
现在发现,按照我们刚刚的逻辑,我们成功地把树形结构按我们的想法映射到了数组上,我们达成了我们的目标,可以用我们应用到数组的所有维护区间的办法去维护这个树形结构的节点权值了。
但还有问题,我们把好好的树弄成了数组,那我们还怎么找树上的路径呢?怎么解决树上路径的问题呢?这个时候每条链的链头的作用就发挥出来了。我们假定我们就是用线段树去维护这个数组 a ,已经写好了 update 修改区间和与 ask 查询区间和的函数了,idi 指的是节点 i 在刚刚划分出来的数组 a 里的下标。
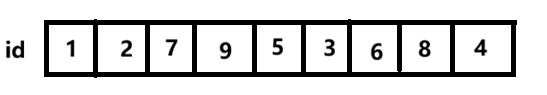
假设我们现在要将节点 9 到节点 8 的最短路径上的点都加上 x ,我们可以看到节点 9 的链头是节点 1 ,节点 8 的链头是节点 3 ,他们的链头不同,说明他们肯定是不在同一条链上的。我们的目标,是在向上爬升过程中使得他们爬上到同一条链上 。可以看到节点 3 的深度比节点 1 要大,我们要让链头较深的一方先行爬升,那么我们的节点 8 往上,我们要爬到链头的父节点上去 ,即节点 1,这样才能到达另一条链嘛。那既然向上爬了,那我们肯定要对路径上的节点 3 和 8 进行操作,我们可以发现,在数组 a 里面,处于同一条链的节点是必然连续的 ,那么我们要对链头为 3 ,节点 3 到节点 8 的这个路径进行 update 操作,直接进行 update(id3,id8) 即可。
从节点 8 爬到了节点 1 ,这时我们发现节点 1 和节点 9 的链头都是节点 1,说明他们已经在同一条链上了,和刚刚的操作一样,既然在同一条链上在数组 a 里面必然是连续区间,直接 update(id1,id9) 修改数组值就好了。可以看到,这里只用了两步就直接完成了从节点 9 到节点 8 足足有 6 个节点的权值修改。
至于从节点 x 到节点 y 最短路径的权值和,和刚刚的修改操作其实几乎完全一样,只需要把中途的权值和累加起来即可,此处就不再进行演示了。
其实到了现在我们就可以解开刚刚我们为什么采用优先递归重儿子的疑惑了。可以看到我们刚刚的跳跃过程都是在链上直接跳到链头的父节点的,优先走重儿子进行划分,可以使得链相对来说更长一点,那么在树上爬升的时候就很容易跳过很多个点从而达到加速的目的,毕竟同一条链上在数组里是连续的,怎么操作都可以;但如果是随便走一个轻儿子呢,很容易想到可能就会使得划分的链都比较的短,就相对较慢了。优先走重儿子,可以让我们的爬升次数稳定在 O(logN) 左右。
实现思路
结合我们刚刚的思路,实现起来的代码也是并不算特别复杂的,主要复杂的在线段树部分。主要逻辑其实就是两次 DFS ,第一次是预处理找出我们需要的树里面的信息比如深度和子树大小之类的,第二次 DFS 才是划分树链的过程。我们需要开的数组还是很多的,必须要一个个理清楚。首先是记录以节点 i 为根的子树大小 szi 了,这是我们用来找出重儿子的依据,然后我们可以用一个 hs 数组来记录一下每个节点的重儿子,方便第二次 DFS 可以快速找到重儿子进行划分。节点深度,父节点这种数组也是不必再说的。
cpp
int sz[maxn];//节点i为根的树大小
int d[maxn];//节点i的深度
int arr[maxn];//原树节点i的权值
int id[maxn];//记录划分后节点i在a数组里对应的下标,方便线段树的查询修改
int top[maxn];//记录节点i的链头
int a[maxn];//记录划分后的链
int fa[maxn];//节点i的父节点
int hs[maxn];//节点i的重儿子
第一次 DFS 还是比较简单的,收集树上的有效信息。
cpp
void dfs1(int p,int fp,int dep){
    d[p]=dep;//深度
    ++sz[p];
    fa[p]=fp;//父节点
    int szmax=-1;//记录当前子树的最大值
    for(int i:g[p]){
        if(i==fp) continue;
        dfs1(i,p,dep+1);
        sz[p]+=sz[i];//递归算出子树大小
        //找出重儿子
        if(sz[i]>szmax){
            szmax=sz[i];
            hs[p]=i;
        }
    }
}
第二次 DFS 进行划分逻辑也并不困难,主要是记录链头这个可能有点麻烦,但是只需要在 DFS 里面加入一个参数 op 就能很好解决了。
cpp
int cnt;//分配编号
//op变量用于分辨当前这个节点是链头还是非链头
void dfs2(int p,int fp,int op){
    id[p]=++cnt;//分配编号
    a[id[p]]=p;//放入数组a中
    //op==1说明当前这个点非链头,直接继承上一个节点fp就能拿到链头了
    //op==0说明当前这个点作为链头,直接等于自身
    if(op){
        top[p]=top[fp];
    }else{
        top[p]=p;
    }
    if(hs[p]==-1) return;//没有重儿子直接return,说明肯定连儿子都没有
    dfs2(hs[p],p,1);//优先递归重儿子,op==1
    //后递归轻儿子,此时轻儿子必然都是链头,op==0
    for(int i:g[p]){
        if(i==fp||i==hs[p]) continue;
        dfs2(i,p,0);
    }
}
可以看到两次 DFS 都并不难,就已经完成了树链剖分的核心部分了。比较麻烦的是和线段树结合的逻辑还有修改查询的时候的在树上爬升的逻辑,不过能看到这里想必大家都对线段树有基础的,我就直接放出我完整的 P3384 代码及注释再进行详细的说明。
cpp
#include <bits/stdc++.h>
#define int long long
using namespace std;
const int maxn=1e5+10;
int n,m,r,mod;
vector<vector<int>> g(maxn);
int sz[maxn];//节点i为根的树大小
int d[maxn];//节点i的深度
int arr[maxn];//原树节点i的权值
int id[maxn];//记录划分后节点i在a数组里对应的下标,方便线段树的查询修改
int top[maxn];//记录节点i的链头
int a[maxn];//记录划分后的链
int fa[maxn];//节点i的父节点
int hs[maxn];//节点i的重儿子
void dfs1(int p,int fp,int dep){
    d[p]=dep;//深度
    ++sz[p];
    fa[p]=fp;//父节点
    int szmax=-1;//记录当前子树的最大值
    for(int i:g[p]){
        if(i==fp) continue;
        dfs1(i,p,dep+1);
        sz[p]+=sz[i];//递归算出子树大小
        //找出重儿子
        if(sz[i]>szmax){
            szmax=sz[i];
            hs[p]=i;
        }
    }
}
int cnt;//分配编号
//op变量用于分辨当前这个节点是链头还是非链头
void dfs2(int p,int fp,int op){
    id[p]=++cnt;//分配编号
    a[id[p]]=p;//放入数组a中
    //op==1说明当前这个点非链头,直接继承上一个节点fp就能拿到链头了
    //op==0说明当前这个点作为链头,直接等于自身
    if(op){
        top[p]=top[fp];
    }else{
        top[p]=p;
    }
    if(hs[p]==-1) return;//没有重儿子直接return,说明肯定连儿子都没有
    dfs2(hs[p],p,1);//优先递归重儿子,op==1
    //后递归轻儿子,此时轻儿子必然都是链头,op==0
    for(int i:g[p]){
        if(i==fp||i==hs[p]) continue;
        dfs2(i,p,0);
    }
}
//=====以下是线段树=====//
struct node{
    int l,r;
    int lazy,sum;
}tr[maxn<<2];
void pushup(int p){
    tr[p].sum=(tr[p<<1].sum+tr[(p<<1)+1].sum)%mod;
}
void build(int p,int l,int r){
    tr[p].l=l;
    tr[p].r=r;
    tr[p].lazy=0;
    if(l>=r){
        tr[p].sum=arr[a[l]]%mod;//利用数组a进行初始化
        return;
    }
    int mid=(l+r)>>1;
    build(p<<1,l,mid);
    build((p<<1)+1,mid+1,r);
    pushup(p);
}
void pushdown(int p){
    if(tr[p].lazy){
        tr[p<<1].sum=(tr[p<<1].sum+(tr[p].lazy*(tr[p<<1].r-tr[p<<1].l+1))%mod)%mod;
        tr[(p<<1)+1].sum=(tr[(p<<1)+1].sum+(tr[p].lazy*(tr[(p<<1)+1].r-tr[(p<<1)+1].l+1))%mod)%mod;
        tr[p<<1].lazy=(tr[p<<1].lazy+tr[p].lazy)%mod;
        tr[(p<<1)+1].lazy=(tr[(p<<1)+1].lazy+tr[p].lazy)%mod;
        tr[p].lazy=0;
    }
}
void update(int p,int l,int r,int x){
    if(tr[p].l>=l&&tr[p].r<=r){
        tr[p].sum=(tr[p].sum+((tr[p].r-tr[p].l+1)*x)%mod)%mod;
        tr[p].lazy=(tr[p].lazy+x)%mod;
        return;
    }
    pushdown(p);
    int mid=(tr[p].l+tr[p].r)>>1;
    if(l<=mid) update(p<<1,l,r,x);
    if(r>mid) update((p<<1)+1,l,r,x);
    pushup(p);
}
int ask(int p,int l,int r){
    if(tr[p].l>=l&&tr[p].r<=r) return tr[p].sum%mod;
    pushdown(p);
    int mid=(tr[p].l+tr[p].r)>>1;
    int ans=0;
    if(l<=mid) ans=(ans+ask(p<<1,l,r))%mod;
    if(r>mid) ans=(ans+ask((p<<1)+1,l,r))%mod;
    return ans%mod;
}
//================//
//=====以下为题目要求的4种操作=====//
void first(int x,int y,int z){
    while(top[x]!=top[y]){
        if(d[top[x]]>d[top[y]]) swap(x,y);//时刻保持y链头深度较大,只对y操作即可,逻辑简单
        update(1,id[top[y]],id[y],z);//更新链头到y的这段区间的值
        y=fa[top[y]];//跳到链头的父节点
    }
    if(d[x]>d[y]) swap(x,y);//保证y的深度一定大,这样进行update更新才不会出问题
    update(1,id[x],id[y],z);
}
//和上述的update逻辑同理
int second(int x,int y){
    int ans=0;
    while(top[x]!=top[y]){
        if(d[top[x]]>d[top[y]]) swap(x,y);
        ans=(ans+ask(1,id[top[y]],id[y]))%mod;
        y=fa[top[y]];
    }
    if(d[x]>d[y]) swap(x,y);
    return (ans+ask(1,id[x],id[y]))%mod;
}
void third(int x,int z){
    update(1,id[x],id[x]+sz[x]-1,z);
}
int fourth(int x){
    return ask(1,id[x],id[x]+sz[x]-1);
}
//====================//
void solve(){
    cin>>n>>m>>r>>mod;
    memset(hs,-1,sizeof(hs));
    for(int i=1;i<=n;++i) cin>>arr[i];
    for(int i=1;i<n;++i){
        int u,v;
        cin>>u>>v;
        g[u].push_back(v);
        g[v].push_back(u);
    }
    dfs1(r,0,0);
    dfs2(r,0,0);
    build(1,1,n);
    for(int i=1;i<=m;++i){
        int op;
        cin>>op;
        if(op==1){
            int x,y,z;
            cin>>x>>y>>z;
            first(x,y,z);
        }else if(op==2){
            int x,y;
            cin>>x>>y;
            cout<<second(x,y)<<'\n';
        }else if(op==3){
            int x,z;
            cin>>x>>z;
            third(x,z);
        }else{
            int x;
            cin>>x;
            cout<<fourth(x)<<'\n';
        }
    }
}
signed main(){
    ios::sync_with_stdio(false);cin.tie(0);cout.tie(0);
    int T=1;
    //cin>>T;
    while(T--){
        solve();
    }
}
对于题目要求的 1 2 这两种对于两点间的路径操作,最好的办法就是固定只操作其中一方比如我代码中只操作 y ,只需要时刻要求 y 的深度是较小即可,代码逻辑更加简洁一点。还有需要注意的就是所有涉及线段树的操作都必须使用 id 数组进行操作,绝对不能再用原来的节点编号了必须是新的下标,有时候写着写着就很容易忘记了。
另外就是题目要求的 3 4 操作是对以 x 为根节点的子树进行操作,这个就非常简单了。我们可以观察一下我们的 a 数组,回想一下我们的 DFS ,不难发现对于某一个节点 x ,他的后面 szx-1 个数组都是他的子树成员。所以对于整个子树进行操作只需要对 idx 到 idx+szx-1 这个区间进行操作即可。
这个树链剖分虽然写起来非常的麻烦,但是好歹也是提高了不少的效率,从原本的暴力 O(N) 提速到 O(log\^2N) (树上爬升 O(logN) ,每次爬升都进行一次线段树操作 O(logN))。