一、开篇:一个被反复问到的行业问题
过去几年,我参与过不少工业与物联网场景的数据系统建设。有一个问题出现的频率高得惊人,几乎每个项目在时序数据库落地半年之后都会冒出来:
"我把时序数据存下来了,接下来要怎么用?"
这个问题背后是一组非常具体的业务焦虑:
一架民航客机上有成千上万个零部件,航空公司想知道能不能在彻底故障之前就判断出"什么时候该修了";
一座城市的电网想知道明后天的居民用电负荷,以便安排机组出力,但没人说得清气温、湿度、节假日、工业开工率这些变量各自的影响到底有多大;
一个工厂的设备管理者盯着一条温度曲线,肉眼能看出趋势不太对,但他真正想知道的是"我该在哪个时间点介入"。
这些场景有一个共同的名字------时序数据分析与预测。而它们也有一个共同的困境:数据存好了,但用不起来。
这个困境不是存储问题。以 Apache IoTDB 生态为例,今天把时序数据低成本、高可靠地存下来已经是非常成熟的能力了。真正卡住人的,是从"存储"跨越到"分析"的这段路------它需要的不是更多的磁盘,而是模型能力、算法人才和漫长的验证周期。
天谋科技给出的答案,是把这段路铺平。一边是已经被中车四方、中国核电、国家电网、博世力士乐、长安汽车、宝武钢铁等一批头部企业验证过的工业时序数据底座,另一边是本次要重点拆解的时序大模型云平台 TimechoAI。
这篇文章不谈空泛的行业趋势判断,我想把三件事讲透:
为什么传统时序分析方案在工业场景里如此昂贵,以及时序大模型在技术定位上到底改变了什么;
TimechoAI 提供了哪些可落地的能力,它和通用大语言模型有什么本质区别;
具体的接入路径------从申请 API Key 到跑通第一次预测,再到把它集成进生产链路,包含完整可运行的代码。
二、为什么传统时序分析走到了瓶颈
2.1 三代技术范式的各自天花板
时序预测不是一个新问题。过去几十年,工业界在这条路上走过三代技术范式,每一代都解决了一部分问题,也都留下了新的天花板。
第一代:统计模型。 以 ARIMA、指数平滑、Prophet 为代表。这类方法的优点非常明确------可解释性强、计算量小、在数据平稳且规律明显的场景下表现稳定。但它的假设过于理想:要求序列具有相对稳定的统计特性,对非平稳、强突变、多变量耦合的工业数据往往力不从心。更麻烦的是,ARIMA 的阶数选择本身就需要专业判断,一个工厂里有几千个测点,你不可能为每个测点手工调一遍参数。
第二代:机器学习模型。 以 XGBoost、LightGBM 为代表。通过特征工程把时序问题转化成有监督回归问题。效果上确实比统计模型强不少,但它的能力上限被特征工程死死锁住。你能不能预测准,很大程度上取决于你有没有想到那个关键的影响因子。在工业场景里,光"找齐影响因素"这一步就足以让项目组卡上几周------而且这个知识通常只存在于几位老师傅的脑子里。
第三代:深度学习模型。 LSTM、TCN、Transformer 架构开始被用于时序任务。表达能力强了很多,也终于能自动捕捉一些长期依赖关系。但代价是:每个场景都要从零训练一个专属模型。你要有标注好的数据、要有 GPU 资源、要有人会设计网络架构和调参。在学术界这没问题,但在一个只想知道"我的风机轴承下周会不会出问题"的工厂里,这套流程的成本高得离谱。
三代范式共同的结构性缺陷在于:它们都是"从零开始的模型"。每接一个新场景,都要重新走一遍完整流程。经验无法跨场景积累,能力无法复用。
2.2 CRISP-DM 六步流程的真实成本
行业里有一个标准流程叫 CRISP-DM,它把数据挖掘项目拆成六步:业务理解、数据理解、数据准备、模型构建、模型评估、模型部署。
纸面上看很清晰。但真正做过项目的人都知道,最难的往往是前两步,而且这两步恰恰是最缺工具支撑的。业务理解和数据理解本质上依赖人的经验,如果这里判断错了,后面所有数据工程师和算法工程师的投入都会打水漂。
更现实的问题是人。一个完整的时序预测项目,通常需要三类角色同时在场:
领域专家:懂设备、懂零件、懂业务,回答"什么问题值得解决";
算法工程师:懂模型、懂训练、懂调参,回答"这个问题能不能用算法解";
数据工程师:懂采集、懂清洗、懂存储,负责把训练数据准备好。
这三类人要坐在一起反复磨合。这种碰撞,在顺利的情况下持续数周,在不顺利的情况下可以拖到数月。而大多数企业------尤其是中小型制造企业------根本不具备同时凑齐这三类人的条件。
这就是为什么大量的时序数据至今仍在"沉睡":不是没有价值,而是开采成本高于预期收益。
三、TimechoAI 的解法:把通用能力沉淀成底座
3.1 Timer:从清华实验室走出的时序基础模型
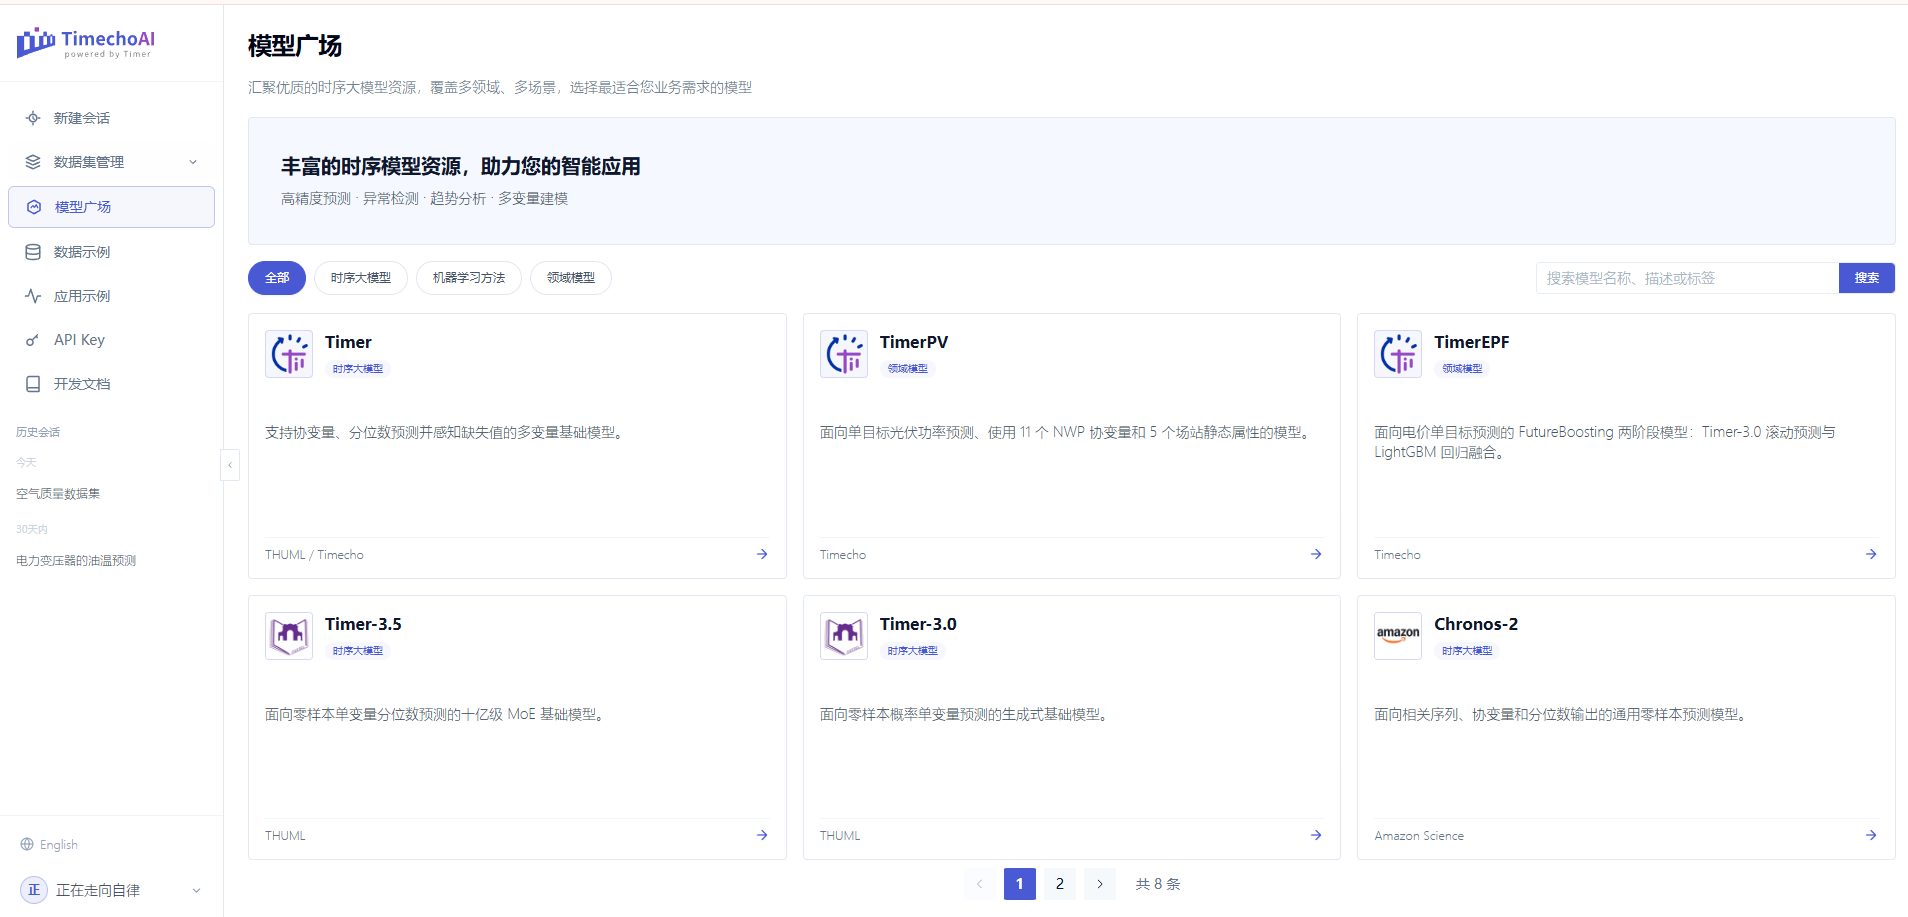
TimechoAI 的模型内核是 Timer 系列时序大模型,背后的团队来自清华大学软件学院带领的大数据团队------这也是 Apache IoTDB 的发源地。这个背景很关键,因为它解释了为什么 Timer 在工业数据上的表现不像一个"学术 demo"。
在 Timer 正式发布之前,团队已经有过硬核的落地验证:自研的气象大模型被用于服务中国气象局的日常天气预报,相关成果发表于 Nature 正刊。能在气象这种对精度和稳定性要求极高的场景中通过检验,说明这套技术栈不是空中楼阁。
Timer 至今迭代了四个主要版本,每一代都在解决一个明确的瓶颈:
Timer 1.0:验证"开箱即用"能力,明确时序大模型的基本定位------零样本也能用。
Timer 2.0(Timer-XL):多变量扩展,上下文从数百提升至数千,能输入更多历史序列,长上下文预测精度提升。
Timer 3.0(Sundial):引入生成式预测,输出带概率分布。从"给一个数"变成"给一个分布",可量化不确定性。
Timer-3.5(Timer-S1):参数规模扩展至 83 亿,验证规模化定律,在 GIFT-Eval 通用预测基准上排名第一。
其中两个节点值得单独说明。
Timer 3.0 的生成式预测是理念上的一次跃迁。传统预测模型输出的是单点估计------"明天下午 3 点负荷是 4200 MW"。但现实世界的预测天然带有不确定性,一个负责任的系统应该回答"4200 MW 这个值,我有多大的把握?"。Sundial 输出的概率分布让置信区间成为一等公民,这对工业决策至关重要:同样是预测明天出现过载风险,置信区间宽的预测和置信区间窄的预测,对应的调度策略应该完全不同。
Timer-3.5 的规模跃迁则证明了时序领域同样存在规模化定律。83 亿参数带来的效果提升,让它在时间序列通用预测基准 GIFT-Eval 上拿下第一。这件事的意义不在于一个榜单名次,而在于:国产时序大模型已经具备与国际大厂同类模型同台竞技的实力。对于关键行业用户来说,这个能力自持性本身就是选型时的重要权重。
3.2 大模型 + 小模型:正确的期待值
这里需要给一个理性的判断,避免把期待值抬得过高。
TimechoAI 团队自己的定位表述很清醒:一个成熟的时序大模型,就像一个刚毕业的本科生。
它完成了"基本高等教育"------见过大量不同类型的时序数据,懂得曲线的基本规律;
它有基础的判断能力------给一段历史数据,它能猜出接下来大概会怎么走;
但它不一定精通特定领域------真要解决具体领域的问题,还需要领域专家"带一带"。
这就是"大模型 + 小模型/专家知识"的完整路径。大模型负责通用底座能力,小模型或领域机理知识负责最后一公里的精度适配。
这种定位带来的两个实实在在的好处:
第一,降低模型研发难度。原来从零设计一个领域模型,从网络架构到参数调优可能耗时数月。有了大模型底座,在这个基础上做适配或直接零样本推理,周期大幅缩短。
第二,显著减少数据需求。纯小模型训练需要大量高质量样本才能达到可用效果。而借助大模型在多类数据集上积累的预训练知识,对样本量的需求显著降低。甚至在很多场景下根本不需要训练,直接就能用------这就是零样本推理,也意味着那些原来因为"数据不够"或"没有建模能力"而做不起来的需求,现在有了解法。
这个定位还有一个重要价值:它把"验证成本"降到了极低。在决定要不要投入一个算法团队之前,你可以先花半天时间验证这件事在你的场景里到底有没有价值。这个决策顺序的改变,价值远大于模型本身。
四、平台能力全景:TimechoAI 到底提供了什么
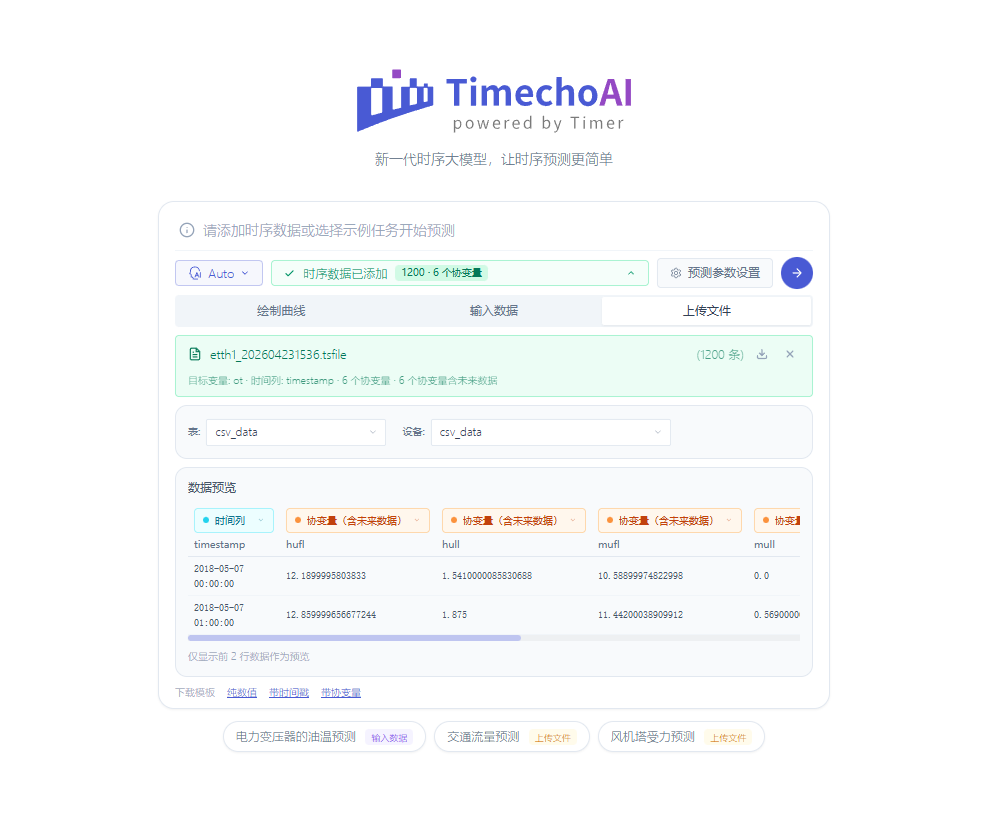
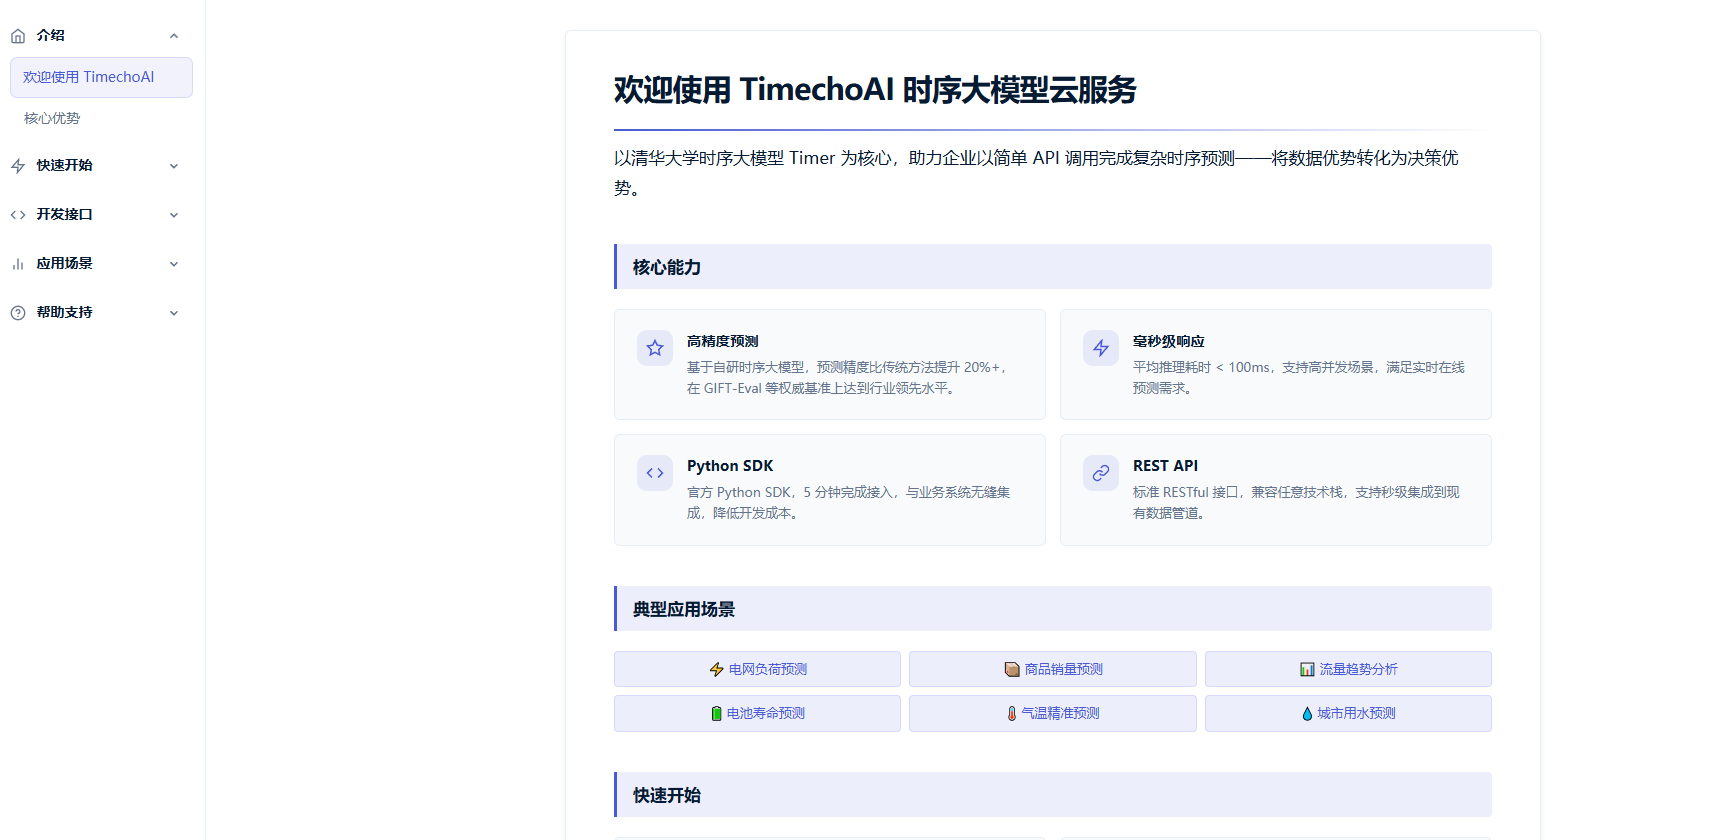
打开 TimechoAI 平台,第一眼看到的是对话式的交互界面。但它的能力远不止"上传数据看预测"这么简单。TimechoAI 的设计目标是把时序智能分析的完整链路产品化:数据准备 → 数据治理 → 模型训练 → 推理 → 评估。
4.1 三种预测模式
这是理解 TimechoAI 建模能力的核心。平台支持三种预测模式:
**模式一:纯目标变量预测。** 只输入你想预测的那条序列本身,模型基于自身对曲线规律的理解给出未来走势。适合规律相对明显、外部因素影响较弱的场景,比如规律性极强的日负荷曲线、季节性销量。
**模式二:历史协变量预测。** 除了目标变量,还提供在历史区间上同步观测到的其他变量。比如预测变压器温度时,同时输入负载率、环境温度、电流的历史值。模型会学习这些变量与目标之间的耦合关系,从而提升预测精度。
**模式三:未来协变量预测。** 最高阶的用法。你不仅提供历史协变量,还能提供预测区间内已知的未来变量。这在工业场景中非常实用:比如温度预报数据是提前已知的,节假日日程是提前已知的,生产排产计划也是提前已知的。把这些"已知的未来"喂给模型,预测精度会有明显提升。
从工程视角看,这三种模式的区分非常符合实际------真正的项目里,你的协变量能不能拿到未来值,直接决定了你能用哪种模式,也直接决定了预测精度上限。很多方案在这一点上含糊其辞,把所有协变量一锅炖,结果上线后才发现未来值根本拿不到,模型直接失效。TimechoAI 在接口层面就把这个约束显式化了,这是负责任的设计。
4.2 数据侧:四维质量评估与 TsFile 原生支持
工业数据脏是常态。传感器丢点、时钟漂移、量纲错乱、通信中断补传,这些问题在实验室数据集里看不到,在真实产线上天天发生。很多预测项目失败,不是模型不行,而是数据不行。
TimechoAI 内置了四维数据质量评估:
完整性:数据点有没有缺失,缺失比例和时间分布如何;
一致性:跨设备、跨测点的数据在时间对齐和量纲上是否统一;
有效性:数值是否落在物理合理区间内,是否存在明显异常值;
时效性:数据更新的及时程度,是否存在长期滞后。
而且支持多粒度钻取------你可以从全局概览一路下钻到具体某个测点某段时间的明细。这意味着数据质量问题在建模之前就会被暴露出来,而不是等模型跑完发现效果差再去猜原因。
数据组织方面,TimechoAI 原生支持 TsFile 格式。TsFile 是 Apache IoTDB 自研的专为时序设计的列式文件格式,具备高压缩、高写入、高查询效率的优势。这个设计带来的实际好处是:存储侧和分析侧共享同一个数据底座,不需要在系统之间来回搬运和格式转换。同时平台支持多路径 TsFile 数据源叠加配置,并可按权重混合采样构建训练集------这为"用多个工厂/多个设备类型的数据联合建模"提供了直接的工程手段。
4.3 训练侧:任务管理、实时监控与模型版本管理
对于需要用自己的内网工况数据训练专属模型的用户,TimechoAI 提供了一套完整的训练管理能力:
训练任务管理:支持新建、追踪和管理训练任务,可配置模型、数据、GPU 与训练超参数;
训练实时监控:实时展示 GPU 利用率、显存、温度、Loss 和训练日志,训练过程不再是一个黑盒;
模型版本管理:自动记录模型版本、训练参数与 Checkpoint 路径,并支持训练完成后自动注册到推理服务。
最后这一点在工程上很关键。很多自建方案里,"训练出模型"和"模型上线服务"是两件割裂的事,中间隔着一堆手工操作和配置文件。自动注册打通了这段路,让"训练即上线"成为可能。
另外值得一提的是一条来自官方的生态进展:TimechoAI 已与海光 DCU-3G 系列人工智能训练推理芯片完成生态兼容性认证,实现了国产时序大模型内核与国产 AI 算力节点的全栈适配。对于有信创要求的行业用户,这条信息的分量不轻。
4.4 接入侧:Web / REST API / Python SDK 三通道
同一个预测能力,TimechoAI 提供了三种接入方式,覆盖从个人验证到企业集成的全部需求:
Web 控制台:零代码。支持手动输入、绘制曲线、上传 CSV 三种数据提交方式,结果以图表展示并支持导出。适合快速验证和业务人员自助分析。
REST API:标准 RESTful 接口,兼容任意技术栈。可以秒级嵌入已有的数据管道。
Python SDK:官方 SDK,安装后 5 分钟内完成集成,显著降低开发开销。
平台给出的性能指标是:平均推理延迟 < 100ms,预测精度相较传统方法提升 20% 以上。毫秒级延迟这个数字意味着它完全可以支撑高并发、实时性的预测需求,而不只是一个离线分析工具。
五、实操:5 分钟跑通第一次时序预测
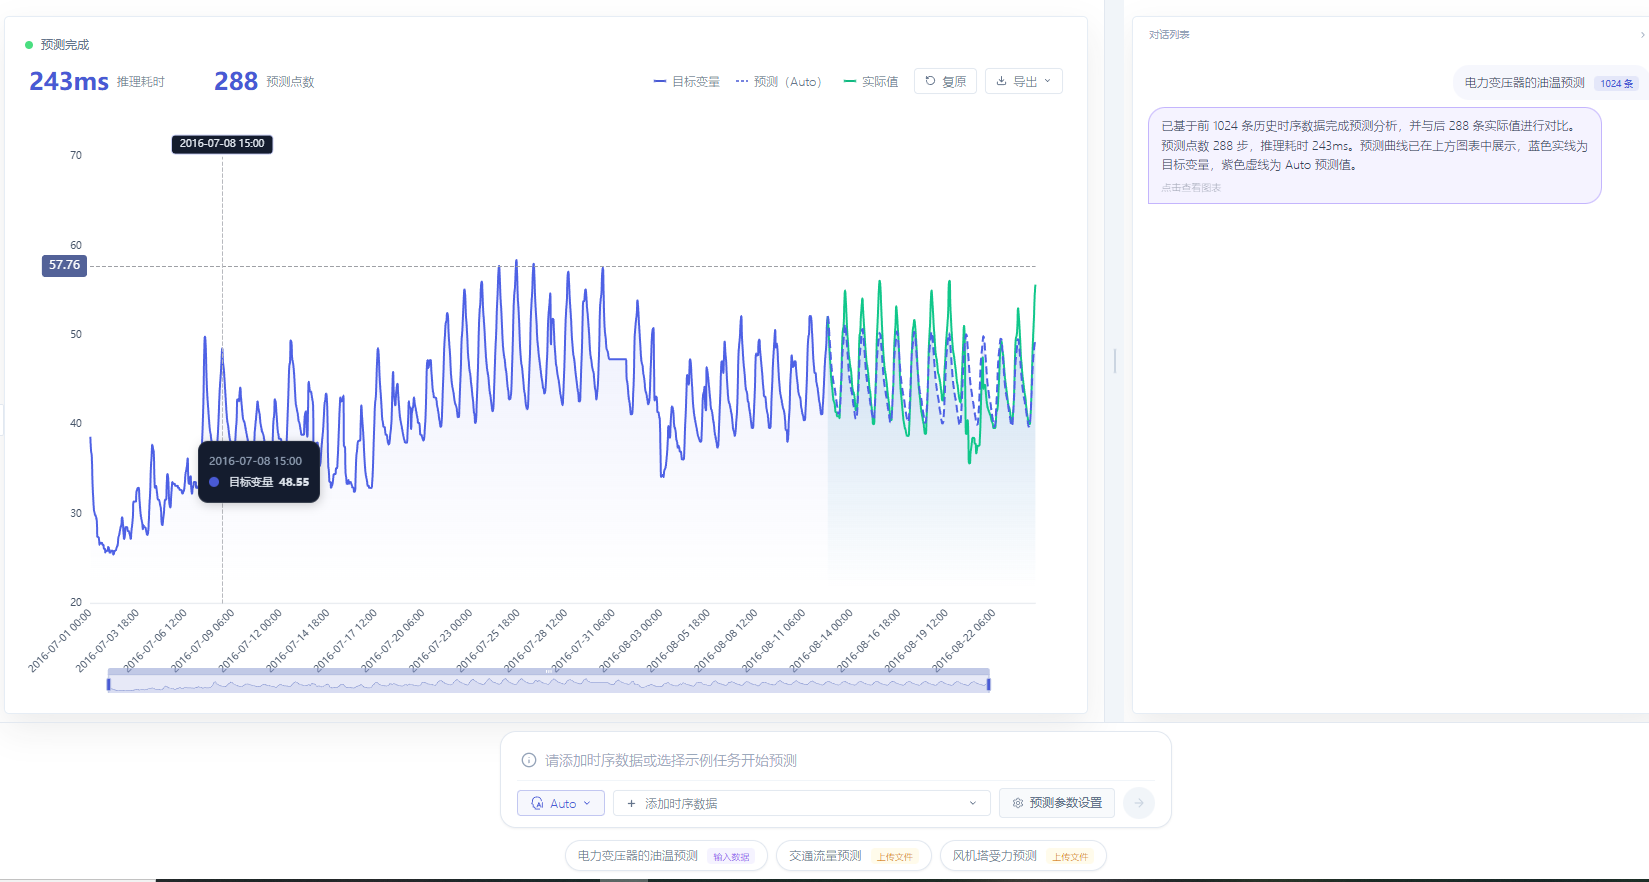
前面讲了这么多能力,不如直接动手。以下是我按官方文档整理的完整接入路径。
5.1 第一步:获取凭证
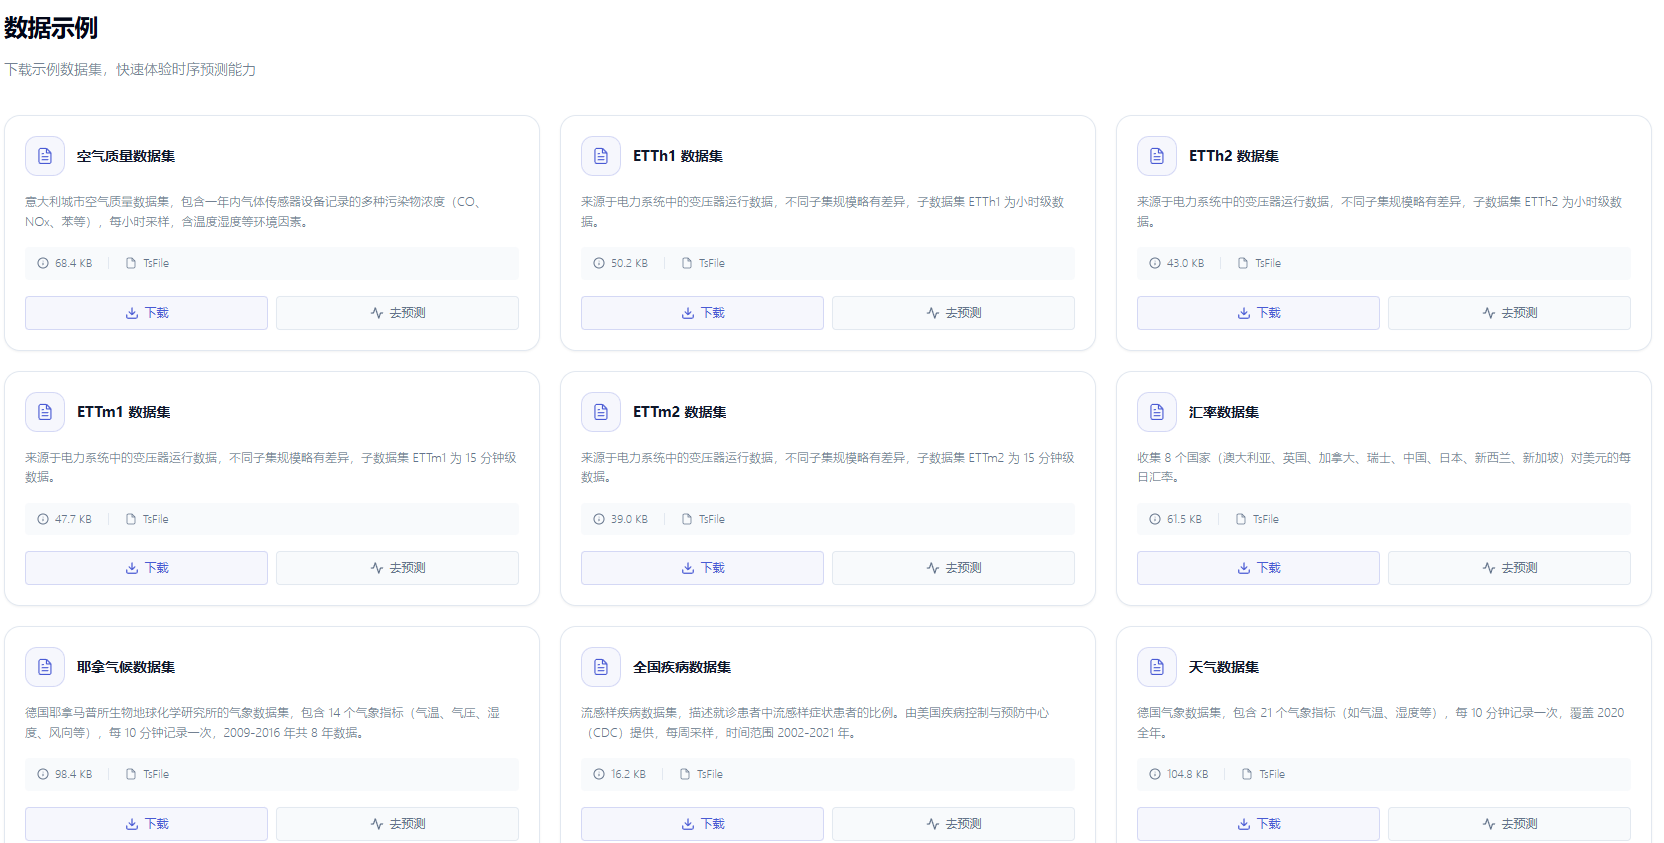
访问 TimechoAI 平台,注册登录后在控制台申请试用资格并获取 API Key。官方也提供了可直接下载的示例数据集和真实案例(比如基于气象数据实时预测未来几天温度),可以先用它们验证链路是否通畅,再换成自己的数据。
5.2 第二步:环境准备
Python SDK 对版本有明确要求:Python 3.10 ~ 3.12。
安装命令:
bash
pip install timecho-ai5.3 第三步:单变量预测(16 点预测未来 8 点)
先跑通最简单的情况------只给目标变量。
python
import pandas as pd
from timecho_ai import TimechoAIClient

raw_df = pd.read_csv("https://ai.timecho.com/data/sample.csv")

client = TimechoAIClient(api_key="你的_API_Key")

target = raw_df[["time", "target"]][:16]

result = client.forecast(
    targets=target,
    output_length=8
)

print(result[0])
这段代码只有 5 行有效逻辑,但它已经完整跑通了"数据 → 模型 → 预测"的全链路。
5.4 第四步:带协变量的预测
真实场景很少有单变量的。加上协变量:
bash
raw_df = pd.read_csv("https://ai.timecho.com/data/sample_cov.csv")

target = raw_df[["time", "target"]][:16]
history_covs = raw_df[["time", "temperature", "humidity"]][:16]

result = client.forecast(
    targets=target,
    history_covs=history_covs,
    output_length=8,
    time_col="time",
    auto_adapt=True
)

print(result[0])
注意这里多了一个 auto_adapt=True,默认开启,用于自动做数据自适应。对于量纲差异大、存在缺失的工业数据,这个开关能省掉大量手工预处理工作。
5.5 第五步:REST API 方式
如果你的技术栈不是 Python,直接用 REST 接口:
接口地址:POST https://ai.timecho.com/ai/api/v1/forecast
请求头:
| 参数 | 是否必填 | 说明 |
|---|---|---|
| Content-Type | 是 | 固定值 application/json |
| Authorization | 是 | Bearer {API-Key},替换为你的密钥 |
单变量请求示例:
bash
curl -s -X POST https://ai.timecho.com/ai/api/v1/forecast \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 你的_API_Key" \
  -d '{
    "targets": [{
      "columns": ["value"],
      "data": [[120],[135],[142],[168],[195],[220],[285],[310]]
    }],
    "output_length": [5]
  }'
带协变量的请求只是在同一层级加上 history_covs 字段:
bash
{
  "targets": [{
    "columns": ["value"],
    "data": [[120],[135],[142],[168],[195]]
  }],
  "history_covs": [{
    "columns": ["temperature", "humidity"],
    "data": [[30, 60], [31, 58], [32, 55], [33, 52], [34, 50]]
  }],
  "output_length": [3]
}
响应结构非常规整:
bash
{
  "code": 200,
  "message": "success",
  "data": {
    "results": [{
      "data": [
        {"timestamp": 1726300800000, "value": 210.5},
        {"timestamp": 1726301100000, "value": 225.3},
        {"timestamp": 1726301400000, "value": 238.7}
      ]
    }]
  }
}
code=200 表示成功,data.results\[\].data 就是预测点的时间戳与预测值。结构清晰,任何语言都能在三行代码内解析。
六、时序分析能力深挖:那些文档里没写透的细节
跑通 Demo 只是开始。真正决定项目成败的,是对参数约束和边界条件的理解。这一节我把官方接口定义里那些容易被忽略、但上线后一定会踩的细节展开讲。
6.1 预测长度与预测间隔的工程含义
先看 targets 的约束:输入序列长度必须在 16, 2880 之间。
这个约束看起来简单,但直接决定了你的数据组织方式:
下限 16 是模型理解曲线规律的最低要求。少于 16 个点,模型无法可靠地识别周期性或趋势性。所以如果你的测点采样间隔是 1 小时,至少需要积累 16 小时的连续数据才能发起预测。
上限 2880 意味着模型的有效上下文窗口是有限的。2880 这个数字很有意思------如果按小时采样,正好是 120 天;按 15 分钟采样,是 30 天;按分钟采样,是 2 天。所以你需要根据采样频率反推能用多长的历史窗口,而不是无脑把全部历史数据塞进去。
再看 output_length:预测范围 1, 720,且不同模型默认值不同------Timer-3.5 默认为 272,其他模型默认为 96。
这个默认值差异本身就是信息。Timer-3.5 参数规模更大、上下文能力更强,因此默认支持更长的预测视野。而 272 这个非整十的数字,恰恰说明它是模型训练时输出长度的自然边界,而不是产品经理拍的脑袋。在做长周期预测(比如未来 30 天日负荷)时,优先选 Timer-3.5。
还有一个容易被低估的关键参数:output_start_time------预测起始时间必须晚于最新历史时间戳。这个约束的工程含义是:TimechoAI 做的是严格的"向前预测",不允许在历史区间内插值或回填。如果你需要做"历史回测",正确做法是把数据截断到某个时间点,假装不知道之后的数据,再发起预测,然后与真实值比对。这是评估模型效果的唯一正确姿势。
6.2 协变量工程的三个层次
history_covs 和 future_covs 的区别不只是"有没有未来值",它背后是三种完全不同的问题建模深度:
| 层次 | 使用字段 | 适用判断标准 | 典型场景 |
|---|---|---|---|
| L1 自回归 | 仅 targets | 目标序列自身规律性强,外部影响弱 | 规律性极强的日/周负荷曲线 |
| L2 历史耦合 | targets + history_covs | 外部变量有影响,但影响滞后于观测 | 设备温度受历史负载影响 |
| L3 未来已知 | targets + history_covs + future_covs | 未来区间内的驱动变量可提前获得 | 气温预报驱动的用电预测 |
一个非常实用的选型原则:先问"我在预测区间开始之前,能不能拿到协变量在预测区间内的值?"
能拿到 → 用 L3,精度天花板最高。比如天气预报是可以提前拿到的,排产计划是可以提前拿到的。
拿不到 → 用 L2,让模型自己从历史耦合关系中推断协变量的未来走势。
连协变量都找不齐 → 从 L1 开始,先把基线跑出来。
特别提醒一个技术约束:future_covs 只支持数值型。如果你的协变量里有"是否为节假日""设备运行模式"这类类别型变量,需要先做编码(独热编码或整数映射)再传入。这是个容易踩的坑。
另外注意长度对齐规则:
history_covs 长度必须等于目标序列长度;
future_covs 长度必须等于 output_length。
长度不匹配会直接触发 422 语义校验错误。在写数据准备代码时,这两个断言建议直接加在代码里,别等接口报错才发现。
6.3 auto_adapt:被低估的"脏数据保险"
auto_adapt 默认 True,用于自动数据自适应。这个开关在处理真实工业数据时的价值远大于它朴素的名字。
典型工业数据的问题包括:量纲差异巨大(电流是安培量级、温度是摄氏度量级)、存在通信中断导致的连续缺失、存在传感器跳变产生的离群点。如果全靠人工预处理,每个测点都要写一遍清洗逻辑,几千个测点就是几千份重复劳动。
auto_adapt 把这些通用预处理交给平台自动完成。建议生产环境保持开启,除非你已经做了严格的离线清洗并且需要完全可控的数值变换------这种情况下可以关闭它以保证预测值与输入值在同一数值空间内,便于做误差分析。
6.4 异常检测:从预测到预警的闭环
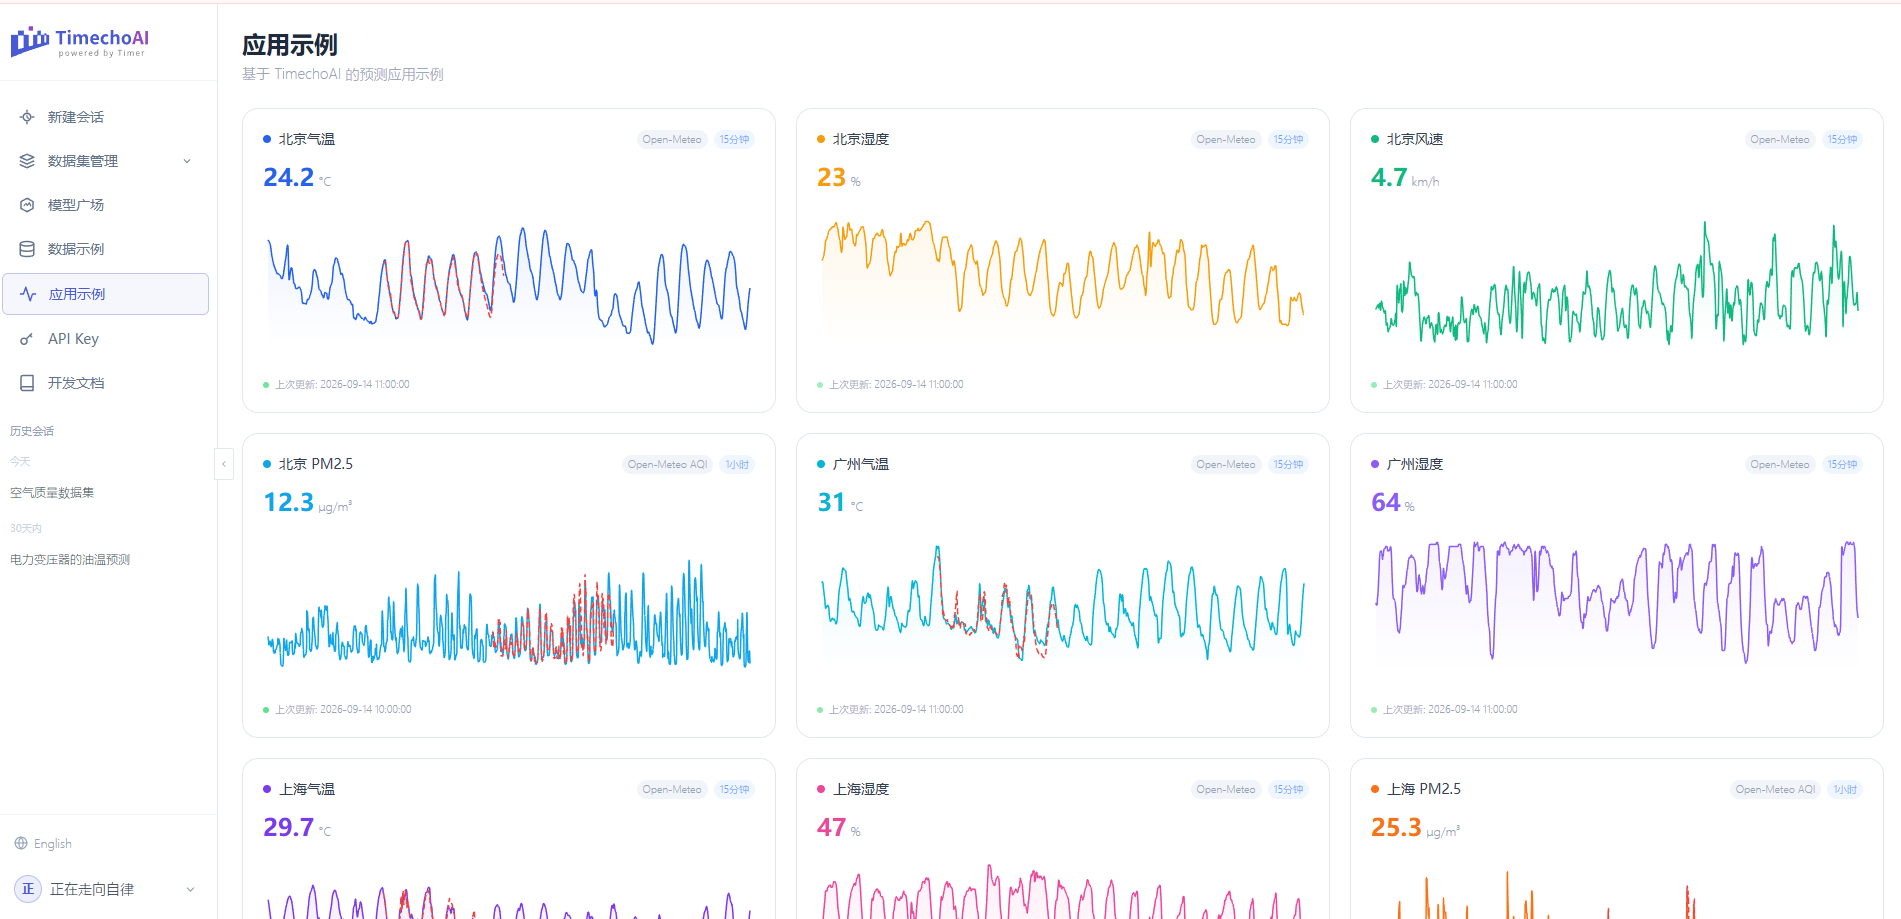
TimechoAI 的官方面向能力清单里明确包含异常检测,而预测正是异常检测最自然的实现路径。
思路很直接:用模型预测出置信区间,再把真实值与置信区间比对。
真实值落在置信区间内 → 正常;
真实值持续越出置信区间上界或下界 → 异常。
相比传统的固定阈值告警,这套方法有三个明显优势:
第一,自适应。阈值不再需要人工配置。设备的正常运行范围会随工况、季节、老化程度漂移,固定阈值要么误报要么漏报,而基于预测区间的判定天然跟随数据的实际分布。
第二,能捕捉缓慢漂移。固定阈值对渐变型异常几乎无能为力------设备从正常值缓慢漂移到故障值,全程都不越界,直到突然崩溃。而预测模型会敏锐地察觉到"实际走势偏离了预期走势",即使绝对值仍在合理区间内。
第三,区分突变与趋势。突变型异常表现为单点剧烈越界,渐变型异常表现为持续单向偏离。通过观察越界的时间模式,可以初步区分异常类型,为根因分析提供线索。
这就是为什么 Timer 3.0 引入的生成式预测(输出概率分布)如此重要------没有概率分布,你就没有置信区间;没有置信区间,异常检测就退化成简单的点误差比较,鲁棒性会差很多。
6.5 错误处理与可观测性
生产集成必须考虑失败路径。SDK 把 HTTP 错误转换成了明确的异常类型,这个设计值得称赞------它让你能针对不同失败原因做不同的处理策略,而不是笼统地重试:
| 异常类型 | 触发条件 | 建议处理策略 |
|---|---|---|
| BadRequestError | HTTP 400,请求格式错误/参数非法 | 代码缺陷,修复后重发,不要重试 |
| AuthenticationError | HTTP 401,凭证缺失或无效 | 检查 API Key,告警人工介入 |
| PermissionDeniedError | HTTP 403,凭证有效但无权限 | 检查账号权限配置 |
| NotFoundError | HTTP 404,引用的模型/文件不存在 | 检查 model_id 拼写,告警 |
| ConflictError | HTTP 409,资源状态冲突 | 检查资源状态,谨慎重试 |
| UnprocessableEntityError | HTTP 422,语义校验失败 | 检查 output_length 范围、目标变量数量等 |
| RateLimitError | HTTP 429,触发限流 | 指数退避重试,并考虑降低并发 |
| InternalServerError | HTTP 500,服务端未处理异常 | 记录上下文,退避重试,持续失败则联系支持 |
| ServiceUnavailableError | HTTP 503,服务暂时不可用 | 通常可重试,建议指数退避 |
| ConnectionError | 传输层连接失败 | 检查网络,重试 |
| TimeoutError | 传输层请求超时 | 重试,或检查是否输入序列过长 |
| ValidationError | 客户端本地输入校验失败 | 请求未发出,检查本地数据结构 |
从这张表能读出一条重要的工程信息:422 和 ValidationError 属于"我的代码有问题",429/500/503/超时 属于"环境暂时有问题"。把这两类混在一起做无脑重试,是很多系统稳定性问题的根源------参数错误重试一万次也不会成功,反而会持续占用连接资源。
推荐的生产实践:对 RateLimitError、ServiceUnavailableError、TimeoutError 实施带抖动的指数退避重试(比如 1s、2s、4s、8s,最多 4 次);对 4xx 类参数错误直接失败并记录完整请求体用于排查;所有异常都统一上报到监控系统。
6.6 精度评估:GIFT-Eval 与"20%+"背后的方法论
选择平台给出的两个精度声明需要正确理解:
"相较传统方法提升 20% 以上"------这是相对基准(如 AutoARIMA、Holt-Winters)的改进幅度。注意这是相对提升,不是绝对精度。绝对精度高度依赖你的具体场景,必须自己验证。
"GIFT-Eval 通用预测基准排名第一"------GIFT-Eval 是时间序列领域的通用预测基准,覆盖多种数据集和预测长度。榜单排名说明的是模型在广泛场景下的平均泛化能力,这是"开箱即用"能力的重要背书,但不等于在你特定的产线数据上一定最优。
所以评估方法必须是:拿你自己的数据,做你自己的回测。
具体做法很简单,但很多人不做:
取一段有真实后续数据的连续历史(比如过去 3 个月);
在时间点 T 处截断,只用 T 之前的数据发起预测,预测 T 之后 N 步;
把预测值与 T 之后的真实值比对,计算 MAE / RMSE / MAPE;
用同样的方法跑一遍 AutoARIMA 作为基线;
对比两者,得到"在你的场景里,时序大模型相对传统方法提升了多少"这个属于你自己的数字。
这个动作的价值在于:它把一个营销数字变成你的决策依据。而且由于 TimechoAI 支持指定 model_id,你可以用同一份数据快速横向对比 Timer-3.5、Timer-3.0、Chronos-2、AutoARIMA、Holt-Winters 的表现,选出最适合当前场景的模型。这种"同平台多模型对照"的能力,本身就是选型效率的巨大提升。
七、典型场景与架构集成
7.1 场景选型矩阵
TimechoAI 官方给出的典型场景包括电网负荷预测、销量预测、流量分析、电池健康度、温度预测、用水量预测。我按"数据可得性 + 业务价值"两个维度给一个更实用的选型参考:
| 场景 | 推荐模式 | 关键协变量 | 业务价值点 |
|---|---|---|---|
| 电网负荷预测 | L3(未来协变量) | 气温预报、节假日、工业开工率 | 机组调度、降低备用容量成本 |
| 设备预测性维护 | L2(历史协变量) | 转速、负载、电流、环境温度 | 变"定期修"为"预测修",避免非计划停机 |
| 销量预测 | L3(未来协变量) | 促销计划、节假日、竞品价格 | 库存周转、供应链备货 |
| 新能源功率预测 | L3(未来协变量) | 辐照度预报、风速预报、云量 | 并网调度、减少弃风弃光 |
| 电池健康度评估 | L2(历史协变量) | 充放电电流、温度、循环次数 | SOH 预警、梯次利用决策 |
| 交通流量分析 | L2(历史协变量) | 天气、日期类型、历史同期 | 信号配时、路网调度 |
一个通用的选型判断顺序:
先问业务上真正关心什么指标(不是所有能预测的都有价值);
再盘协变量资源------能拿到未来值的协变量是最高优先级;
最后检查数据长度是否满足 16, 2880 的约束。
7.2 与 TimechoDB 的联动架构
TimechoAI 是"多模态时序数智化软件栈"中的 AI 组件。这个栈的结构值得说明,因为它直接决定了集成架构的优雅程度。
关键点在于 Apache TsFile 作为贯穿端、边、云的统一数据底座。这意味着:
存储侧和分析侧共享同一份数据格式,不需要手工导出、格式转换、数据搬运;
数据不出域。对于关键行业,这一点是硬性要求。TimechoAI 原生对接 TimechoDB,可以在内网闭环完成"存储 → 训练 → 推理",无需把原始敏感数据导出到外部环境,完全契合关键行业"数据不出域"的安全政策要求。
顺带说一下底座的成熟度,因为这决定了时序大模型能否发挥价值。TimechoDB 已经在多个高要求场景中得到验证:
中车四方:300 辆列车、3200 测点/列车,可管理列车数增加 1 倍,采样时间提升 60%,服务器数量降为 1/13,月数据增量压缩后下降 95%;
中国核电:应用于五大核电基地关键与敏感设备可靠性管理,支持至少 100TB 时序数据存储,可靠性达 99.9%;
长安汽车:接入车辆约 57 万台,测点数约 8000 万,托管时间序列约 1.5 亿,写入量级 150 万条/秒,诊断系统查询效率从分钟级提升到毫秒级;
国家气象局:为 MICAPS4 天气预报系统提供全国 10 万个国家级地面气象观测站数据的存储与实况分析能力。
这些数字的意义在于:模型的上限取决于数据的厚度。一个能管理数十亿测点的数据底座,才配得上一个 83 亿参数的时序大模型。
7.3 云边协同
考虑到工业现场的真实约束,部署形态上还有一层设计空间:
云端批量训练:利用云端更强的算力训练专属模型;
边缘轻量化推理:边缘网关、车载终端等低算力硬件上做轻量推理。
这对于网络受限、数据不能外传或者要求低延迟响应的现场环境(比如车载终端、厂区边缘网关)非常关键。"重训练放云上、轻推理放边缘"是目前工业 AI 落地最务实的一种分工。
八、工程最佳实践清单
把上面的内容压缩成一份可以直接照着做的清单:
数据准备阶段
输入序列长度严格控制在 16, 2880,按采样频率反推可用的历史窗口长度,不要无脑塞入全部历史;
时间列如果存在,所有输入(目标、历史协变量、未来协变量)都必须带上 time_col 指定的同名列;
类别型协变量必须先编码为数值,future_covs 只接受数值;
长度对齐做成代码里的断言:history_covs 长度 = 目标长度,future_covs 长度 = output_length。
建模阶段
先用官方示例数据集验证链路通畅,再换自己的数据;
从 L1(纯目标变量)起步建立基线,再逐级加入协变量观察精度增益,这样能明确知道每个协变量贡献了多少价值;
生产环境保持 auto_adapt=True,除非已做严格离线清洗且需要完全可控的数值变换;
长周期预测优先选 Timer-3.5(默认输出 272 步),短周期可用其他模型(默认 96 步)。
评估阶段
必须自己做回测:截断历史数据预测未来,与真实值比对,同时跑 AutoARIMA 作为对照基线;
用同一份数据横向对比多个 model_id,选当前场景的最优解,而不是默认全用最大的模型;
记录你场景专属的 MAE/RMSE/MAPE,这是后续模型迭代的基准线。
生产集成阶段
按错误类型分级处理:参数类错误(400/422)直接失败告警,服务类错误(429/500/503)指数退避重试;
对预测结果建立置信区间监控,用"真实值是否持续越界"作为异常检测信号;
接口调用加超时控制,避免长序列预测阻塞上游业务链路。
安全合规阶段
关键行业优先采用内网闭环方案,利用 TimechoAI 与 TimechoDB 的原生对接避免数据导出;
有信创要求的场景,可以关注 TimechoAI 与国产算力芯片的适配进展。
九、结语:让"存下来的数据"真正变成"对未来的判断"
回头看开头那个问题------"我把时序数据存下来了,接下来要怎么用?"
过去这个问题的答案往往是一份长达数月的项目计划书,需要三类专家协作、走完 CRISP-DM 六步流程,还要承担业务理解出错导致全盘重来的风险。这也是为什么大量时序数据至今仍在沉睡。
时序大模型改变的正是这个决策结构。它把"通用时序理解能力"变成了一个可以随时调用的服务。你不再需要先组建团队、先训练模型,才能知道这件事有没有价值;你可以先用半天时间,拿自己的一段真实数据跑一次预测,看到结果之后再做投入决策。
TimechoAI 的定位很清醒------它不是一个"一键解决所有问题"的银弹,而是一个让上层应用得以生长的基础底座。通用模型解决通用问题,领域问题还需要领域知识,"大模型 + 小模型/专家知识"才是完整路径。这个判断我认为是对的,也是负责任的。
具体到执行层面,它提供了三个实实在在的价值:
更低门槛:没有专业模型研发团队,也能快速上手并体验价值。打开网页就能用,不需要准备 GPU 服务器,不需要安装模型,甚至不需要写代码;
更低成本:云服务开箱即用,无需搭建部署环境。毫秒级推理延迟意味着它可以直接嵌入实时业务链路;
更快验证:从架构上把"数据准备 → 治理 → 训练 → 推理 → 评估"全链路打通,把验证周期从数月压缩到数天。
时序大模型的边界在哪里,不是研发团队单方面说了算的,需要更多真实用户一起探索。这大概也是官方把能力直接开放出来供大家体验的原因------别听我们描述,用你自己的数据验证一次。
纸上得来终觉浅,如果你也在面对"时序数据存而不用"的困惑,我建议的动作顺序是:
先访问企业版官网,了解一下时序数据底座的成熟度,看看有没有和你同行业的落地案例可以参考; 企业版官方链接:https://timecho.com
然后直接去 TimechoAI 平台申请试用,用官方示例数据集跑通第一次预测,感受一下从数据到预测需要几步;
最后换上你自己的一段真实产线数据,做一次回测,得出属于你的那个"精度提升了多少"的数字。
数据存下来只是第一步。能把"过去"变成对"未来"的判断,才是真正的价值所在。
时序大模型 TimechoAI:TimechoAI - 时序大模型云服务平台