摘要: 本文面向物联网边缘场景的数据库使用者与运维工程师,分享在双节点、无人值守的资源受限环境下,使用 DRBD 与 Pacemaker 为 KaiwuDB 构建高可用方案的实践。内容涵盖数据复制原理、双节点设计约束、方案架构与部署步骤,以及 KaiwuDB 四种高可用方案的选型对比。
文章目录
- 一、数据副本的三种实现方式
- 二、DRBD:块级别的数据镜像
-
- [什么是 DRBD](#什么是 DRBD)
- [DRBD 的三种复制协议](#DRBD 的三种复制协议)
- [KaiwuDB 为什么选择 DRBD?](#KaiwuDB 为什么选择 DRBD?)
- 三、Pacemaker:集群资源的管理者
- [四、KaiwuDB 方案架构](#四、KaiwuDB 方案架构)
- [五、KaiwuDB 高可用方案部署实战](#五、KaiwuDB 高可用方案部署实战)
- 方案部署
-
- [搭建 Pacemaker 集群](#搭建 Pacemaker 集群)
- [建立 DRBD 复制关系](#建立 DRBD 复制关系)
- 部署高可用环境
- 方案验证
- 写在最后
- 相关阅读:
一、数据副本的三种实现方式
数据库高可用要解决两个独立的问题:数据不丢(另一台机器上有一份实时副本)和服务不断(故障时能自动检测并切换)。第一个问题的答案,决定了方案的 RPO;第二个问题的答案,决定了方案的 RTO。数据副本怎么实现?按照复制发生的系统层级,有三种路线:
| 复制层级 | 代表技术 | 复制对象 | 数据库是否感知 | 实时性 |
|---|---|---|---|---|
| 应用层(日志级) | WAL 主备复制 | 数据库日志记录 | 感知,依赖数据库复制协议 | 高 |
| 文件层 | rsync、快照同步 | 数据文件 | 感知,需处理文件一致性 | 低,通常非实时 |
| 块级 | DRBD | 磁盘块(通常 4KB) | 无感知,完全透明 | 高,可做到写时同步 |
三条路线各有取舍:日志级复制由数据库精细控制(如 KaiwuDB 备库对 DML 并行回放、对 DDL 串行原子回放),但要求数据库实现相应协议;文件级复制实现简单,但很难保证复制过程中文件的一致性;块级复制位于文件系统之下,对任何应用完全透明,不挑数据库、不需要修改配置,代价是复制粒度粗,切换过程需要集群软件编排。
二、DRBD:块级别的数据镜像
什么是 DRBD
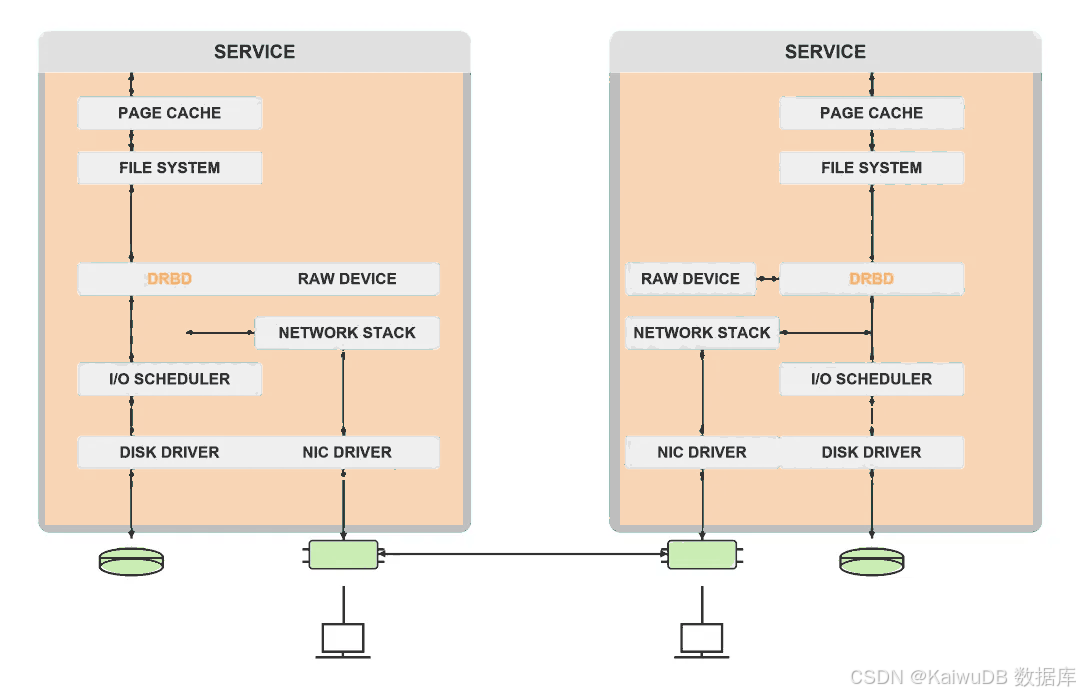
DRBD(Distributed Replicated Block Device,分布式复制块设备)是一个运行在 Linux 内核中的模块,能在两台服务器之间以块为单位实时镜像数据。两台机器各自准备一个容量相等的块设备(硬盘、分区、逻辑卷均可),DRBD 将主节点设备上的每一次写入同步到备节点的对应设备上。
DRBD 镜像数据具有以下特点:
- 实时:应用程序修改设备上的数据时,复制将连续进行。
- 透明:应用程序无需关心数据存储在多个主机上的细节。
- 同步或异步:DRBD 提供同步和异步两种复制模式。在同步模式下,只有所有连接的主机都完成写操作后,应用程序才会收到写完成的通知。在异步模式下,本地完成写入时(通常在镜像数据传输到其他节点之前)应用程序就会收到写完成的通知。
DRBD 的三种复制协议
DRBD 提供三种复制协议,对应不同的性能与一致性权衡:
| 协议 | 级别 | 写入确认时机 | 数据安全性 | 写入性能 |
|---|---|---|---|---|
| 协议 A | 异步 | 本地写入完成即确认 | 低,可能丢失未同步数据 | 最高 |
| 协议 B | 半同步 | 本地写入完成 + 备机接收到数据 | 中 | 中等 |
| 协议 C | 完全同步 | 本地与备机均写入完成才确认 | 最高,RPO = 0 | 较低 |
KaiwuDB 建议优先使用协议 C,以保证主备节点数据完全一致,实现 RPO = 0;如果写入性能成为瓶颈,可在充分评估数据丢失风险后改用异步模式。
KaiwuDB 为什么选择 DRBD?
这是很多人会关心的一个问题,数据库本身不是有 WAL 日志复制吗,为什么还需要 DRBD?这里我们从两个关键角度来说明。
首先是 DRBD 方案的成熟性。下表罗列了三种主流方式的核心差异对比,其中块级复制 DRBD 核心优势在于透明性,不挑数据库、不挑应用,任何把数据写到磁盘上的程序都可以被保护。而且经过长期生产环境验证的块级复制方案,稳定性和可靠性都有充分保障,在关键业务场景中已有大量成功实践。
| 维度 | 日志级复制(如 WAL 传输) | 文件级复制(如 rsync) | 块级复制(DRBD) |
|---|---|---|---|
| 复制粒度 | 日志记录 | 文件 | 磁盘块(通常 4KB) |
| 工作层级 | 应用层 | 应用层 | 内核层(文件系统之下、磁盘驱动之上) |
| 对数据库的要求 | 需要数据库复制协议支持 | 需要保证文件一致性,通常需停写或快照 | 完全透明,数据库无感知 |
| 写入路径 | 应用 → 文件系统 → 磁盘 → 网络 → 备库重放 | 应用 → 文件系统 → 磁盘 → 定时拷贝 | 应用 → 文件系统 → DRBD → 本地磁盘 + 网络 → 备机磁盘 |
| 复制延迟 | 取决于日志生成与回放速度 | 高,取决于同步周期 | 同步模式近乎实时,异步模式毫秒级 |
其次是 KaiwuDB 在内核层面无需实现完整的主从复制,有效降低了数据库内核的复杂性。WAL 日志复制虽然能实现数据同步,但要在内核层面完整实现主从复制,涉及日志传输、冲突处理、故障切换、一致性保障等一系列复杂逻辑,开发和维护成本都很高。借助 DRBD 这样的成熟块级复制方案,KaiwuDB 可以把这部分职责下沉到存储层,内核只需聚焦于数据库本身的核心能力,整体架构更清晰,也更容易保证稳定性。
三、Pacemaker:集群资源的管理者
有了数据副本,还需要解决第二个问题:谁来发现故障、谁来执行切换?Pacemaker 是 Linux-HA 工程下的开源高可用集群资源管理器,也是目前应用最广泛的开源 HA 软件之一。它通过两项基础技术构建高可用集群:
- 心跳服务:节点间周期性地互相探测,及时发现对端失联;
- 集群通信:维护集群成员关系与全局状态,保证所有节点对资源配置和状态有一致认知。
在此基础上,Pacemaker 将集群中的各类资源------DRBD 设备、文件系统挂载、虚拟 IP、systemd 服务------统一建模,持续监控其运行状态,并在故障发生时按预设的依赖关系和约束条件执行资源漂移、主备切换。例如,它可以表达并强制执行这样一条规则:DRBD 设备提升为 Primary 之后,才能挂载文件系统;文件系统就绪之后,才能启动数据库服务和绑定虚拟 IP。
四、KaiwuDB 方案架构
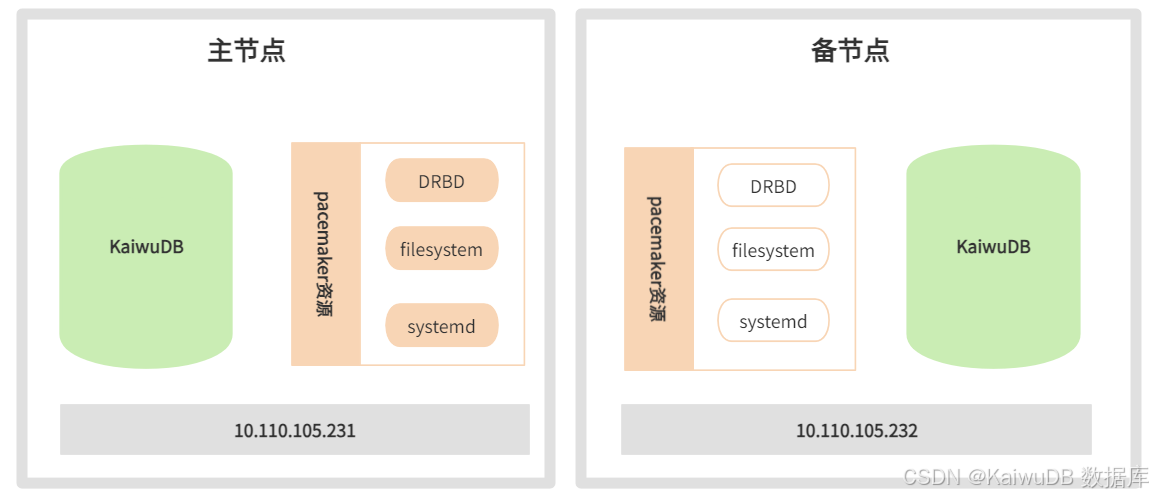
DRBD 与 Pacemaker 的组合由此形成清晰的分工:DRBD 负责数据不丢,Pacemaker 负责服务不断,方案涉及组件及职责分工见下表。典型的适用场景包括:工业物联网边缘网关(工厂车间、矿山、油田的数据采集节点)、新能源场站(光伏、风电、储能电站的本地监控)、智慧交通路侧单元(公路、桥梁、隧道的监控数据汇聚)、小型园区楼宇(门禁、能耗、环境监测的本地存储),以及施工现场、野外勘探、车载系统等临时或移动部署。
| 组件 | 职责 | 所在层级 |
|---|---|---|
| DRBD | 块设备实时镜像,保证主备节点数据一致 | 数据层 |
| Pacemaker | 心跳检测、故障判断、资源编排与自动切换 | 集群管理层 |
| KaiwuDB | 正常提供数据库服务,对底层复制无感知 | 应用层 |
其中数据流向如下:应用对 KaiwuDB 的每次写入,经文件系统落到 DRBD 设备后,DRBD 内核模块将数据块通过网络同步到备节点的对应设备。方案采用同步复制模式(DRBD 协议 C),备节点落盘完成后主节点才向应用返回写成功,从而保证 RPO = 0。备节点上 DRBD 处于 Secondary 角色,设备不可写,KaiwuDB 服务处于停止状态,全部资源由 Pacemaker 统一编排。
基于 DRBD 的高可用性方案技术重点如下:
- 在主备节点各使用一个容量相等的块设备,用于 DRBD 主备复制。
- 主备节点的安装部署应保持完全一致,包括用户数据目录(即安装部署时指定的 data_root 目录)。
- 将 DRBD 设备挂载到用户数据目录,通过 DRBD 复制软件进行数据同步复制。
- CA 证书等文件由于未存放在用户数据目录中,需要从主节点手工同步至备节点(非安全部署方式无需执行本步骤)。
- 使用 systemd 服务来管理 KaiwuDB 的启动和停止操作。
- 将 DRBD 设备、文件系统及 systemd 服务等资源统一定义在 Pacemaker 集群软件中,通过 Pacemaker 进行状态监控和管理。
五、KaiwuDB 高可用方案部署实战
环境要求
除需满足 KaiwuDB 安装部署要求外,高可用性方案还需额外满足以下环境要求:
- 网卡:千兆或万兆
- DRBD: 9.11.0
- Pacemaker: 2.0.3
配置 IP 地址和主机名
在主备节点的/etc/hosts文件中配置主备节点的 IP 地址和主机名。示例:
bash
your-master-host-ip   ha-node01
your-backup-host-ip   ha-node02
配置非交互式 SSH 登录
1、登录主节点,生成公私密钥对:
bash
ssh-keygen -f ~/.ssh/id_rsa -N ""参数说明:
-f:指定生成的密钥对文件名。-N:指定密钥的密码,为实现非交互式登录,将密码设置为空。
2、将公钥分发到备节点:
bash
ssh-copy-id -f -i ~/.ssh/id_rsa.pub -o StrictHostKeyChecking=no <secondary_node> 3、检查主节点能否非交互式地登录备节点:
bash
ssh <secondary_node>4、登录备节点,配置非交互式 SSH 登录主节点。
关闭相关服务
1、查看系统的/bin/sh文件的详细信息:
Bash
ls -al /bin/sh2、在主备节点上重新配置 dash shell,选择 no:
Bash
sudo dpkg-reconfigure dash3、在主备节点停止并禁用 multipathd.socket、multipath-tools 和 multipath 服务:
Bash
systemctl stop multipathd.socket
systemctl disable multipathd.socket
systemctl stop multipath-tools.service
systemctl disable multipath-tools.service
systemctl stop multipath
systemctl disable multipath
方案部署
本节以Ubuntu 20.04,DRBD 9.11.0,Pacemaker 2.0.3,pcs 0.10.4为例说明如何部署基于 DRBD 的高可用性方案。使用不同版本的 Linux 系统、 DRBD 软件和 Pacemaker 软件时,操作命令格式可能会有所不同。
搭建 Pacemaker 集群
前提条件:
-
主备节点的 IP 地址在同一子网内,且子网内有未分配的 IP 地址用于建立虚拟 IP 地址(virtual IP)。
-
主备节点已通过 NTP 协议进行时间同步。提示:可以通过安装 chrony 包来实现 NTP 时间同步。
-
主备节点已配置非交互式 SSH 登录。
步骤如下:
1、在主备节点安装 Pacemaker、corosync 和 pcs 软件包,安装完成之后系统会默认创建 hacluster 用户。
Bash
apt install pacemaker corosync pcs2、授权操作用户。
在主备节点为 hacluster 用户设置密码:
Bash
passwd hacluster 在任一节点销毁软件安装后自动建立的默认集群:
Bash
pcs cluster destroy 在任一节点授权用户管理节点,根据系统提示输入密码。
Bash
pcs host auth <primary_node> <secondary_node> -u hacluster 示例:
Bash
pcs host auth ha-node01 ha-node02 -u hacluster 3、在任一节点创建并启动高可用集群
Bash
pcs cluster setup <cluster_name> <primary_node> <secondary_node> --start --enable --force参数说明:
-
cluster_name:新创建的集群名称。 -
primary_node:主节点的主机名。 -
secondary_node:备节点的主机名。 -
--start:创建集群后启动高可用集群。 -
--enable:设置集群开机自启动。 -
--force:删除之前残留的集群配置信息。
示例:
Bash
root@ha-node01:~# pcs cluster setup ha-cluster ha-node01 ha-node02 --start --enable --force
No addresses specified for host 'ha-node01', using 'ha-node01'
No addresses specified for host 'ha-node02', using 'ha-node02'
Destroying cluster on hosts: 'ha-node01','ha-node02'...
ha-node01: Successfully destroyed cluster
ha-node02: Successfully destroyed cluster
Requesting remove 'pcsd settings' from 'ha-node01','ha-node02'
ha-node01: successful removal of the file 'pcsd settings'
ha-node02: successful removal of the file 'pcsd settings'
Sending 'corosync authkey', 'pacemaker authkey' to 'ha-node01','ha-node02'
ha-node01: successful distribution of the file 'corosync authkey'
ha-node01: successful distribution of the file 'pacemaker authkey'
ha-node02: successful distribution of the file 'corosync authkey'
ha-node02: successful distribution of the file 'pacemaker authkey'
Sending 'corosync.conf' to 'ha-node01','ha-node02'
ha-node01: successful distribution of the file 'corosync.conf'
ha-node02: successful distribution of the file 'corosync.conf'
cluster has been successfully set up.
Enabling cluster on hosts:'ha-node01','ha-node02'...
ha-node01: Cluster enabled
ha-node02: Cluster enabled
Starting cluster on hosts: 'ha-node01','ha-node02'...
4、在任一节点配置强行关机协议:
Bash
pcs property set stonith-enabled=false
pcs property set no-quorum-policy=ignore
5、在任一节点检查集群状态:
Bash
pcs status示例:
Bash
root@ha-node01:~# pcs status
Cluster name: ha-cluster
Cluster Summary:
   * Stack: corosync
   * Current DC: ha-node01 (version 2.0.4-4b1f869f0f) - partition with quorum
   * Last updated: Tue Sep 26 03:49:28 2023
   * Last change: Tue Sep 26 03:48:20 2023 by root via cibadmin on ha-node01
   * 2 nodes configured
   * 0 resource instances configured

Node List:
   * Online: [ ha-node01 ha-node02 ]

Full List of Resources:
   * No resources

Daemon Status:
   corosync: active/enabled
   pacemaker: active/enabled
   pcsd: active/enabled
6、在任一节点创建虚拟 IP 资源(ClusterIP),配置属性和监控操作:
Bash
pcs resource create ClusterIP ocf:heartbeat:IPaddr2 ip=<virtual_ip_address> cidr_netmask=24 op monitor interval=30s参数说明:
virtual_ip_address:虚拟 IP 地址。
7、(可选)检查资源是否创建成功:
Bash
pcs resource示例:
Bash
root@ha-node01:/etc# pcs resource
ClusterIP (ocf::heartbeat:IPaddr2): Started ha-node018、(可选)使用arp -vn检查虚拟 IP 地址的 MAC 地址是否和主节点的网卡 MAC 地址一致:
-
在任一节点模拟计划内停机事件来测试资源漂移,Pacemaker 集群会自动将 ClusterIP 资源漂移到备节点上。
- 将主节点设置为待机状态:
Bashpcs node standby <primary_node>- 等待一段时间后,解除主节点的待机状态:
Bashpcs node unstandby <primary_node> -
(可选)检查资源漂移结果:
Bash
pcs resource示例:
Bash
root@ha-node02:~# pcs resource
ClusterIP      (ocf::heartbeat:IPaddr2):       Started ha-node02
建立 DRBD 复制关系
前提条件:
-
已在主备节点预备容量相等的块设备(硬盘、分区、逻辑卷)。
-
如果使用磁盘或磁盘分区,例如
/dev/sdd,由于磁盘或磁盘分区名称会因为系统重启而变化,已通过udevadm info命令获取到磁盘位于/dev/disk/by-id/的稳定标识符作为该磁盘的唯一标识符。
Bash
udevadm info /dev/sdd
...
E: DEVLINKS= .../dev/disk/by-id/scsi-36f80f41ffaf5a00028e0acde21f326ff
E: TAGS=:systemd:
步骤:
- 在主备节点安装 DRBD 软件;提示:配置类型建议选择"No configuration"。
Bash
apt install drbd-utils -
在主备节点配置 DRBD 参数。
- 切换至
/etc/drbd.d目录:
SQLcd /etc/drbd.d-
修改
global_common.conf配置文件,定义 DRBD 的全局性参数以及默认参数。 -
示例:
Bash# DRBD is the result of over a decade of development by LINBIT.# In case you need professional services for DRBD or have# feature requests visit http://www.linbit.com global { usage-count no;# minor-count dialog-refresh disable-ip-verification# cmd-timeout-short 5; cmd-timeout-medium 121; cmd-timeout-long 600;} common { protocol C; handlers {# These are EXAMPLE handlers only.# They may have severe implications,# like hard resetting the node under certain circumstances.# Be careful when chosing your poison.# pri-on-incon-degr "/usr/lib/drbd/notify-pri-on-incon-degr.sh; /usr/lib/drbd/notify-emergency-reboot.sh; echo b > /proc/sysrq-trigger ; reboot -f";# pri-lost-after-sb "/usr/lib/drbd/notify-pri-lost-after-sb.sh; /usr/lib/drbd/notify-emergency-reboot.sh; echo b > /proc/sysrq-trigger ; reboot -f";# local-io-error "/usr/lib/drbd/notify-io-error.sh; /usr/lib/drbd/notify-emergency-shutdown.sh; echo o > /proc/sysrq-trigger ; halt -f";# fence-peer "/usr/lib/drbd/crm-fence-peer.sh";# split-brain "/usr/lib/drbd/notify-split-brain.sh root";# out-of-sync "/usr/lib/drbd/notify-out-of-sync.sh root";# before-resync-target "/usr/lib/drbd/snapshot-resync-target-lvm.sh -p 15 -- -c 16k";# after-resync-target /usr/lib/drbd/unsnapshot-resync-target-lvm.sh;} startup {# wfc-timeout degr-wfc-timeout outdated-wfc-timeout wait-after-sb} options {# cpu-mask on-no-data-accessible} disk {# size on-io-error fencing disk-barrier disk-flushes# disk-drain md-flushes resync-rate resync-after al-extents# c-plan-ahead c-delay-target c-fill-target c-max-rate# c-min-rate disk-timeout on-io-error detach; no-disk-flushes; no-md-flushes;} net {# protocol timeout max-epoch-size max-buffers# connect-int ping-int sndbuf-size rcvbuf-size ko-count# allow-two-primaries cram-hmac-alg shared-secret after-sb-0pri# after-sb-1pri after-sb-2pri always-asbp rr-conflict# ping-timeout data-integrity-alg tcp-cork on-congestion# congestion-fill congestion-extents csums-alg verify-alg# use-rle sndbuf-size 512k; max-buffers 8000; max-epoch-size 8000; unplug-watermark 1024; cram-hmac-alg "sha1"; shared-secret "justaverificationtest";#after-sb-0pri disconnect;#after-sb-1pri disconnect;#after-sb-2pri disconnect; after-sb-0pri discard-zero-changes; after-sb-1pri discard-secondary; after-sb-2pri disconnect; rr-conflict disconnect; } syncer { rate 330M; al-extents 517; verify-alg crc32c;}}-
修改
*.res配置文件,定义通过 DRBD 复制的块设备资源,文件名称支持自定义。 -
示例:
Bashresource drbd3 { ##与文件名相同 on ha-node01 { ##主节点主机名 device /dev/drbd3; ##自定义设备名称 disk /dev/sde; ##挂载的供同步的磁盘盘符 address your-master-host-ip:port; ##主节点IP meta-disk internal;} on ha-node02 { ##备节点主机名 device /dev/drbd3; ##自定义设备名称 disk /dev/sde; ##挂载的供同步的磁盘盘符 address your-backup-host-ip:port; ##备节点IP meta-disk internal;} - 切换至
-
配置文件生效后,在主备节点写入元数据:
示例:
Bash
drbdadm create-md drbd3
drbdadm adjust all-
登录主节点,启动主备复制。命令执行后即启动初始化复制,复制时间可能会因存储大小而较长。
-
此命令会覆盖备节点磁盘中所有的数据,只需第一次初始化复制时执行。
Bash
drbdadm -- --overwrite-data-of-peer primary drbd3- (可选)执行
drbdadm status命令查看复制进度。
示例:
- 复制进行中
Bash
root@ha-node01:/etc/drbd.d# drbdadm status drbd3
drbd3 role:Secondary
  disk:Inconsistent
  peer role:Primary
replication:SyncTarget peer-disk:UpToDate done:24.90

root@ha-node02:/etc/drbd.d# drbdadm status drbd3
drbd3 role:Primary
  disk:UpToDate
  peer role:Secondary congested:yes
replication:SyncSource peer-disk:Inconsistent done:25.28- 复制完成
Bash
root@ha-node01:/etc/drbd.d# drbdadm status drbd3
drbd3 role:Secondary
  disk:UpToDate
  peer role:Primary
replication:Established peer-disk:UpToDate

root@ha-node02:/etc/drbd.d# drbdadm status drbd3
drbd3 role:Primary
  disk:UpToDate
  peer role:Secondary
replication:Established peer-disk:UpToDate- 完成复制后,在主节点的块设备上创建文件系统。文件系统创建完成之后就可以挂载文件系统并正常使用。
示例:
Bash
mkfs.ext4 /dev/drbd3部署高可用环境
- 在主备节点创建数据库目录。示例:
Bash
mkdir --p /var/lib/kaiwudb- 在资源活动节点挂载文件系统。示例:
Bash
mount /dev/drbd3 /var/lib/kaiwudb- 登录任一节点,在 Pacemaker 高可用集群中创建 DRBD 资源,由 Pacemaker 统一管理 DRBD 复制。示例:
Bash
pcs resource create KaiwuData ocf:linbit:drbd drbd_resource="drbd3" op monitor interval=10s #创建名为KaiwuData的资源,指定DRBD资源名为drbd3,每 10 秒监控一次资源状态
pcs resource promotable KaiwuData promoted-max=1 promoted-node-max=1 clone-max=2 clone-node-max=1 notify=true #支持资源节点内移动、指定可提升节点数和可克隆节点数
pcs resource refresh KaiwuData #刷新资源状态- 在任一节点检查 Pacemaker 集群中 DRBD 资源的状态。提示:
如果发现资源状态不正确,可先通过drbdadm status命令检查 DRBD 状态;如果仍有问题,可以通过systemctl restart drbd命令重启 DRBD 服务来尝试修复。示例:
Plain
pcs resource
* Clone Set: KaiwuData-clone [KaiwuData] (promotable):
* Promoted: [ ha-node02 ]
* Stopped: [ ha-node01 ] - 在任一节点定义 Filesystem 资源以及 Filesystem 资源与 DRBD 资源的依赖关系,由 Pacemaker 管理主备切换时的挂载操作。示例:
Bash
pcs resource create KaiwuFS ocf:heartbeat:Filesystem device="/dev/drbd3" directory="/var/lib/kaiwudb" fstype="ext4" #创建名为 KaiwuFS的文件系统资源,指定DRBD设备文件、挂载点和文件系统类型
pcs constraint colocation add KaiwuFS  with KaiwuData-clone  INFINITY with-rsc-role=Master #添加亲和性约束
pcs constraint order promote KaiwuData-clone then start KaiwuFS #添加启动顺序约束- 在备节点安装 KaiwuDB。
-
检查当前 DRBD 和 Filesystem 资源的活动节点是否为备节点,如果活动节点为主节点需要先将资源迁移到备节点上,然后恢复主节点的在线状态。
- 将主节点设置为待机状态:
Bashpcs node standby <primary_node>- 等待一段时间后,解除主节点的待机状态:
Bashpcs node unstandby <primary_node> -
安装部署 KaiwuDB,具体安装步骤见单节点部署。
-
注意
  - 确保在部署时,将 `data_root` 配置为文件系统资源,示例中 KaiwuFS 指定的目录。

  - 备节点安装完成后,删除 `data_root` 所指定目录中的所有文件,之后将通过 DRBD 复制将从主节点该目录中的数据复制到备节点中。
- 在主节点安装 KaiwuDB。
-
确保 DRBD 和 Filesystem 资源的活跃节点为主节点。
-
安装部署 KaiwuDB,具体安装步骤见单节点部署。
-
配置主节点证书允许通过备节点 IP 和 VIP 访问。
-
提示
-
如果主备节点采用非安全部署方式则无需执行本步骤操作。
-  删除`/etc/kaiwudb/certs`目录下已有的`node.crt`和`node.key`文件。

 -  执行证书生成命令,允许备节点和虚拟IP地址访问主节点证书。

 ```Bash
 kwbase cert create-node <primary_node_ip> <secondary_node_ip> <virtual_ip> 127.0.0.1 0.0.0.0 localhost --certs-dir=/etc/kaiwudb/certs --ca-key=ca.key
 ```

 -  将主节点 `/etc/kwdb/certs/*` 中的证书文件复制到备节点相同目录。

 ```Bash
 scp /etc/kaiwudb/certs/* ha-node02:/etc/kaiwudb/certs/
 ```
-
在任一节点的 Pacemaker 集群中定义 KaiwuDB 数据库资源以及与其它资源的依赖关系。
-
示例:
Bash
pcs resource create KaiwuDB systemd:kaiwudb.service op monitor on-fail=restart #创建新资源
pcs resource defaults migration-threshold=2 #设置资源默认值
pcs resource meta KaiwuDB failure-timeout=10s #设置资源元数据
pcs constraint colocation add KaiwuDB  with KaiwuFS  INFINITY #设置亲和性约束
pcs constraint order start KaiwuFS then start KaiwuDB #设置启动顺序约束
pcs resource group add KaiwuDBGrp KaiwuFS KaiwuDB #创建资源组,对资源进行统一管理-
在任一节点创建虚拟 IP 地址与数据库资源之间的依赖关系。
-
示例:
Bash
pcs constraint colocation add ClusterIP with KaiwuDB INFINITY -
在任一节点检查高可用集群状态。
- 通过
pcs status命令查看集群状态。示例:
Bashroot@ha-node01: ~# pcs status Cluster name: ha-cluster Cluster Summary: * Stack: corosync * Current DC: ha-node01 (version 2.0.3-4b1f869fof) - partition with quorum * Last updated: Mon Jul 1 16:15:01 2024 * Last change: Mon Jul 1 10:58:57 2024 by root via cibadmin on ha-node02 * 2 nodes configured * 5 resource instances configured Node List: * Online: [ ha-node01 ha-node02 ] Full List of Resources: * ClusterIP (ocf::heartbeat:IPaddr2): Started ha-node01 * Clone Set: KaiwuData-clone [KaiduData] (promotable): * Masters: [ ha-node01 ] * Slaves: [ ha-node02 ] * Resource Group: KaiwuDBGrp: * KaiwuFS (ocf::heartbeat:Filesystem): Started ha-node01 * KaiwuDB (systemd: kaiwudb.service): Started ha-node01 Daemon Status: corosync: active/enabled pacemaker: active/enabled pcsd: active/enabled - 通过
通过pcs constraint命令检查集群资源之间的依赖关系。更多 Pacemaker 相关的操作指令见 Pacemaker 参考文档open in new window。
方案验证
步骤:
-
连接 KaiwuDB 数据库,更多操作信息见连接 KaiwuDB。
-
执行数据库增删改查操作。
-
将主节点设置为待机状态。
Bash
pcs node standby <primary_node>- 大约经过 40 秒左右,查询集群状态。示例:
Bash
root@ha-node01: ~# pcs status
Cluster name: ha-cluster
Cluster Summary:
* Stack: corosync
* Current DC: ha-node01 (version 2.0.3-4b1f869fof) - partition with quorum
* Last updated: Mon Jul 1 16:15:01 2024
* Last change: Mon Jul 1 10:58:57 2024 by root via cibadmin on ha-node02
* 2 nodes configured
* 5 resource instances configured

Node List:
* Online: [ ha-node02 ]

Full List of Resources:
* ClusterIP (ocf::heartbeat:IPaddr2):   Started ha-node02
* Clone Set: KaiwuData-clone [KaiduData] (promotable):
* Masters: [ ha-node02 ]
* Stopped: [ ha-node01 ]
* Resource Group: KaiwuDBGrp:
* KaiwuFS (ocf::heartbeat:Filesystem): Started ha-node02
* KaiwuDB (systemd: kaiwudb.service):  Started ha-node02

Daemon Status:
corosync: active/enabled
pacemaker: active/enabled
pcsd: active/enabled- 将主节点设置为在线状态。示例:
Bash
pcs node unstandby ha-node01- (可选)查看集群状态。示例:
Bash
root@ha-node01: ~# pcs status
Cluster name: ha-cluster
Cluster Summary:
* Stack: corosync
* Current DC: ha-node01 (version 2.0.3-4b1f869fof) - partition with quorum
* Last updated: Mon Jul 1 16:15:01 2024
* Last change: Mon Jul 1 10:58:57 2024 by root via cibadmin on ha-node02
* 2 nodes configured
* 5 resource instances configured

Node List:
* Online: [ ha-node01 ha-node02 ]

Full List of Resources:
* ClusterIP (ocf::heartbeat:IPaddr2):   Started ha-node02
* Clone Set: KaiwuData-clone [KaiduData] (promotable):
* Masters: [ ha-node02 ]
* Slaves: [ ha-node01 ]
* Resource Group: KaiwuDBGrp:
* KaiwuFS (ocf::heartbeat:Filesystem): Started ha-node02
* KaiwuDB (systemd: kaiwudb.service):  Started ha-node02

Daemon Status:
corosync: active/enabled
pacemaker: active/enabled
pcsd: active/enabled-
通过备节点登录数据库。
-
执行数据库增删改查操作。主备切换之后数据没有丢失,数据库读写正常。
-
通过同样的方式将活跃节点回切到主节点,通过主节点登录数据库,检查表中的数据是否符合预期。
写在最后
高可用方案的本质,是对"数据副本怎么同步"和"故障服务怎么接管"两个问题的回答。双节点场景受限于共识协议的多数派约束,无法直接套用多副本集群,DRBD 以块级同步复制保证数据一致,Pacemaker 以资源编排实现自动切换,两者组合填补了这一空白。
欢迎获取安装包体验:https://www.kaiwudb.com/download?tab=1
详细文档:https://www.kaiwudb.com/docs/#/v3.2.1/best-practices/single-ha-drbd.html
附录一:术语表
| 术语 | 全称 | 说明 |
|---|---|---|
| RPO | Recovery Point Objective,恢复点目标 | 故障场景下可容忍的数据丢失量。RPO=0 表示零数据丢失 |
| RTO | Recovery Time Objective,恢复时间目标 | 故障场景下恢复对外服务所允许的最长时间 |
| DRBD | Distributed Replicated Block Device,分布式复制块设备 | 基于 Linux 内核的块级数据复制软件,支持同步与异步两种模式 |
| 协议 C / Protocol C | --- | DRBD 的完全同步复制协议:主备两端均写盘完成后才返回写成功,保证 RPO=0 |
| Pacemaker | --- | Linux-HA 工程下的开源集群资源管理器,通过心跳与集群通信监控资源状态,执行故障转移 |
| Corosync | --- | 为 Pacemaker 提供集群通信与成员关系管理的基础设施 |
| WAL | Write-Ahead Logging,预写日志 | 数据库先写日志再写数据的机制,WAL 主备复制方案的数据同步载体 |
附录二:FAQ
Q1:KaiwuDB 的 DRBD 方案和 WAL 主备方案有什么区别?
两者都只需要两台服务器,区别在于:WAL 主备是应用层日志复制,使用 KaiwuDB 内置 SQL 命令管理,配置简单,主库故障后需手动执行切换,计划内切换 RTO < 10 秒;DRBD 是块级复制加 Pacemaker 资源管理,部署复杂度更高,但实现自动故障切换。简言之:有人值守、希望轻量,选 WAL 主备;无人值守、要求自动恢复,选 DRBD。
Q2:同步复制(协议 C)对写入性能影响大吗?
协议 C 的写入延迟 = 本地落盘 + 网络传输 + 备机落盘。在机房内千兆/万兆网络下,额外延迟通常在毫秒级。官方文档建议优先使用同步复制以保障数据一致性;若写入延迟成为瓶颈,可在评估数据丢失风险后改用异步模式。
Q3:DRBD 可以替代备份吗?
不能。DRBD 是设备级冗余,主备数据逻辑等价,误删除、错误写入同样会同步到备机。备份应使用 KaiwuDB 的导入导出能力定期执行,并将备份文件保存到 DRBD 之外的独立存储。