相关链接
论文arXiv地址: https://arxiv.org/abs/2509.14933
开源代码仓库: https://github.com/decisionintelligence/DAG
思路及改进讲解:https://space.bilibili.com/51422950?spm_id_from=333.1007.0.0
摘要
时序预测在众多领域都至关重要。相比只依赖内生变量(即目标变量),把外生变量(即协变量)纳入考虑能够提供额外的预测信息,往往带来更准确的预测。然而,现有面向带外生变量时序预测(TSF-X)的方法存在两个缺点:①它们没有利用未来外生变量;②它们未能充分考虑内生变量与外生变量之间的相关性。
为了更好地利用外生变量、尤其是未来外生变量,作者提出DAG,沿时间维与通道维构建双相关网络(Dual correlAtion network for TSF with exoGenous variables)。DAG包含两个核心组件:时间相关模块与通道相关模块,两个模块都由一个相关发现子模块和一个相关注入子模块构成;前者分别刻画历史外生变量对未来外生变量、以及对历史内生变量的相关效应,后者则把发现的相关关系注入到基于历史内生变量和未来外生变量预测未来内生变量的过程中。
在12个满足TSF-X条件的真实数据集以及8个常用多变量数据集上的大量实验表明,DAG在MSE上取得10个第一、在MAE上取得11个第一,第一名次数为所有方法之最,整体明显优于TimeXer、TFT等强基线。
Q1:这个模型试图解决什么问题?
核心问题是:在带外生变量的时序预测中,天气、日历、节假日、未来促销计划等协变量往往事先已知、包含目标变量自身历史所没有的预测信息(尤其是未来外生变量);但现有方法要么完全不用外生变量、要么只看历史外生变量,且普遍没有显式建模内生变量与外生变量之间在时间维与通道维上的相关关系,导致这部分可执行的先验信息被浪费。
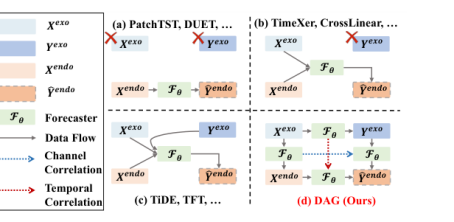
图注: 现有时序预测算法的四类划分。(a)不含外生变量的单变量/多变量算法,如PatchTST、DUET;(b)只考虑历史外生变量,如TimeXer、CrossLinear;(c)同时考虑历史与未来外生变量,如TiDE、TFT;(d)DAG同时考虑外生变量与相关关系。
1. **外生变量的价值被低估:**外生变量不是直接预测目标、却会影响内生变量,且常可提前获知,例如交通场景中未来天气可改善对未来车流量的估计,零售场景中节假日安排与促销活动可改善备货计划;只学单一或多个内生变量的时间依赖、等于放弃了这部分额外信息;
2. **缺点①:不利用未来外生变量:**多数预测器只输入历史观测,即使未来外生变量在预测时已经近似已知或高度准确也不使用;少数方法(TiDE、TFT)虽纳入未来外生变量,却没有进一步刻画变量间的相关结构;
3. **缺点②:未充分考虑内生与外生的相关性:**现有方法通常把多源信息简单拼接或融合,没有沿时间维刻画"历史外生如何影响未来外生"、也没有沿通道维刻画"外生如何影响内生",而这两类相关关系恰恰是可以迁移到内生预测中的关键信号。
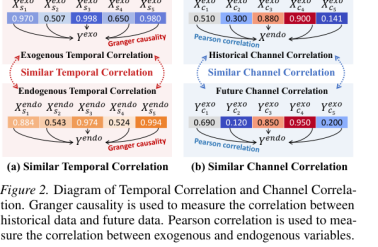
图注: 两类可迁移相关的动机示意。(a)相似时间相关:历史外生到未来外生的影响(用Granger因果衡量)在结构上类似于历史内生到未来内生的演化;(b)相似通道相关:外生变量之间、外生与内生之间的相关(用Pearson相关衡量)可迁移,但未来外生与未来内生之间的相关在现有方法中欠建模。
Q2:相关研究
单变量与多变量时序预测
现有时间序列预测模型通常按输入与输出方式分为单变量与多变量两类。单变量/通道独立方法(如PatchTST)对每条序列单独建模、共享参数,避免通道间噪声干扰;多变量方法则尝试跨通道建模依赖。但这些方法都不使用外生变量,对应图1(a)。
带外生变量的预测
面向TSF-X的方法可进一步分为:只使用历史外生变量的方法(如TimeXer、CrossLinear,对应图1(b)),以及同时使用历史与未来外生变量的方法(如TiDE、TFT,对应图1(c))。前者无法利用预测时点已经可知的未来协变量,后者虽使用未来外生变量,却没有显式发现并注入外生变量内部、外生与内生之间的相关关系,仍存在建模缺口;DAG正是补上这一缺口(图1(d))。
Q3:作者是如何解决的?
问题定义
记内生时序Xendo∈R^(N×T)为要预测的主要目标变量,外生时序分为过去外生变量Xexo∈R^(D×T)与未来外生变量Yexo∈R^(D×F),其中D为外生变量数、T为历史步长、F为预测步长。目标是学习映射Ŷendo=Fθ(Xendo,Xexo,Yexo),预测未来内生变量。
结构总览
DAG沿时间维与通道维各构建一个相关模块,每个模块都由"相关发现"和"相关注入"两个子模块组成:时间相关模块用Fθ1发现历史外生对未来外生的影响、再用Gθ2把该相关注入基于历史内生的预测;通道相关模块用Fθ3发现历史外生对历史内生的影响、再用Gθ4把该相关注入基于未来外生的预测;两路注入输出加权融合得到最终预测。
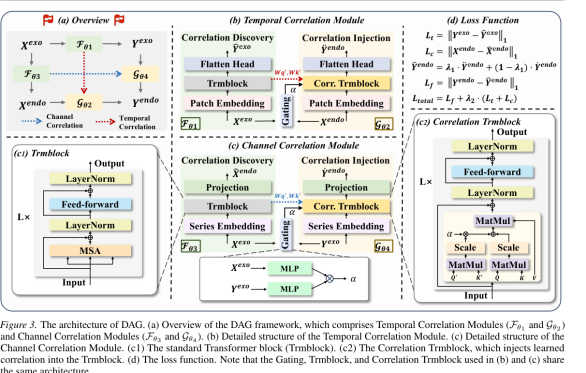
图注: DAG整体架构。(a)总览,含时间相关模块(Fθ1、Gθ2)与通道相关模块(Fθ3、Gθ4);(b)时间相关模块;(c)通道相关模块;(c1)标准Transformer块Trmblock;(c2)把学到的相关注入注意力的Correlation Trmblock;(d)损失函数。
时间相关模块:相关发现
发现子模块采用patch-wise表示:把每条历史外生变量切成多个patch、每个patch经PatchEmbed投影成时间token(式2);随后用标准Transformer块,以Q=S·Wq′、K=S·Wk′、V=S·Wv′计算注意力,建模不同patch对未来外生变量的影响权重(式3-4);token经前馈层后展平投影,预测未来外生变量Ŷexo(式5),并用Lt=‖Yexo−Ŷexo‖₁作为时间相关损失(式6)。
为增强鲁棒性,DAG不直接把生成的注意力分数传给注入模块,而是抽取生成该分数的多头自注意力中可学习的查询矩阵Wq′与键矩阵Wk′,作为待注入的时间相关表示------参数比单一注意力图更稳定、更易迁移。
时间相关模块:相关注入
注入子模块对历史内生变量同样做patch表示得到P(式7),再用Correlation Trmblock:一方面用块内自身的Wq、Wk、Wv生成Q、K、V(式9),另一方面用发现模块传来的Wq′、Wk′生成Q′、K′(式8);两套注意力分数经缩放softmax后,由可学习权重α融合为Sfused=α·σ(QKᵀ/√d)+(1−α)·σ(Q′K′ᵀ/√d)(式10),再与V相乘(式11),从而把时间相关结构显式注入注意力,最后预测未来内生变量Ÿendo(式13)。
门控机制(式12):以历史外生Xexo和历史内生Xendo为输入,分别经两个MLP编码为非线性表示,再做点积得到标量权重α=MLP(Xexo)ᵀ·MLP(Xendo),据此根据历史外生与内生之间的实际影响强度自适应组合两套注意力,提升建模精度与鲁棒性。
通道相关模块:相关发现
通道发现子模块采用series-wise表示:用series embedding把每条历史外生变量沿时间编码成一个整序列token(式14),经标准Trmblock自注意力(式15-16)后,通过投影层预测历史内生变量X̂endo(式17),并以Lc=‖Xendo−X̂endo‖₁作为通道相关损失(式18);同样抽取注意力的Wq′、Wk′作为待注入的通道相关表示。
通道相关模块:相关注入
通道注入子模块用相同的series embedding编码未来外生变量Yexo(式19),在Correlation Trmblock中分别用自身参数生成Q、K、V(式21)、用发现模块参数生成Q′、K′(式20);门控权重由历史外生与未来外生经两个MLP点积得到α=MLP(Xexo)ᵀ·MLP(Yexo)(式22),融合两套注意力(式23-24),最终预测未来内生变量Ẏendo(式25)。
损失函数与输出融合
最终预测由两路注入输出加权融合:Ŷendo=λ1·Ÿendo+(1−λ1)·Ẏendo(式26);预测损失Lf=‖Yendo−Ŷendo‖₁(式27);总损失Ltotal=Lf+λ2·(Lt+Lc)(式28),λ2用于平衡相关建模的贡献,三损失端到端联合优化。
未来外生变量缺失时的实用化处理
考虑到并非所有数据集都能获得未来外生变量,推理时DAG直接用Fθ1预测出的Ŷexo代替真实Yexo送入Gθ4来预测内生变量,从而规避未来外生不可得的问题;这一设计使同一模型在有无未来外生两种场景下都可工作。
Q4:实验效果如何?
数据集、基线与实现
实验在两类数据上进行:①12个满足TSF-X条件的真实数据集,包括5个EPF电力价格数据集(NP、PJM、BE、FR、DE)和7个作者自采数据集(Energy、Colbún、Rapel、Sdwpfm1、Sdwpfm2、Sdwpfh1、Sdwpfh2),其未来外生变量近似已知或高度准确;②8个常用多变量数据集(ETT四个子集、Weather、Exchange、Electricity、Traffic),这些数据未来外生未知,按TimeXer、CrossLinear的做法把多变量最后一维当作内生、其余维当作外生。
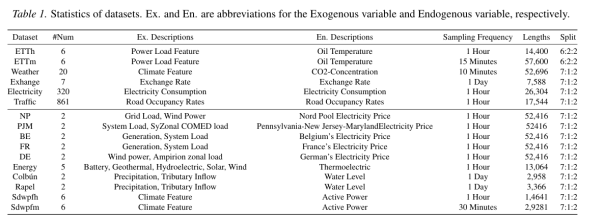
图注: 数据集统计。#Num为变量数,另给出外生/内生变量描述、采样频率、序列长度与训练/验证/测试划分比例。
基线共9个:原生支持未来外生变量的GCGNet、TimeXer、TFT、TiDE;原本不支持的DUET、CrossLinear、Amplifier、TimeKAN、PatchTST,对后者用MLP融合方式适配未来外生变量(附录Algorithm 1)。指标为MSE与MAE,基于TFB代码库、遵循其评测协议且不使用drop-last,长预测(96步)用180步预训练、短预测(30步)用30步预训练。
主结果:TSF-X设置
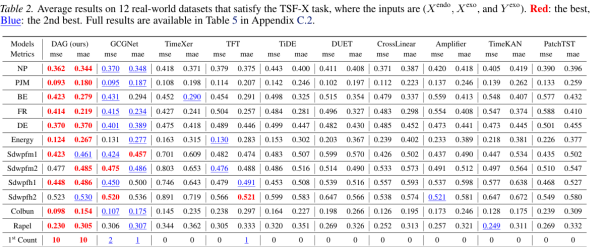
图注: 12个TSF-X数据集上的平均结果(输入为Xendo、Xexo、Yexo),红色最佳、蓝色次佳。DAG在NP(0.362/0.344)、PJM(0.093/0.180)、BE(0.423/0.279)、FR(0.414/0.219)、DE(0.370/0.370)、Energy(0.124/0.267)、Colbún(0.098/0.154)、Rapel(0.230/0.305)等多数数据集领先,1st Count为MSE 10、MAE 11。
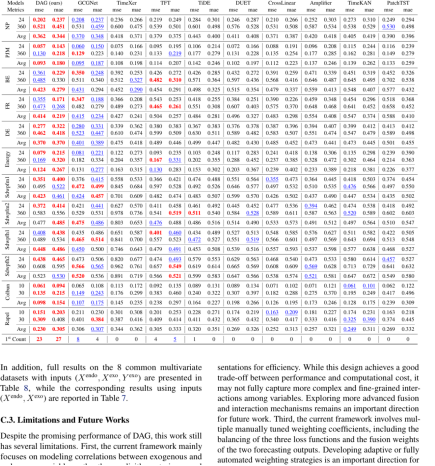
图注: 12个TSF-X数据集的完整结果,按两个预测时长(如EPF与Energy为24/360、Colbún与Rapel为10/30)分别给出,并附两行平均Avg;DAG的1st Count为MSE 23、MAE 27。
主结果有两点结论:①相比各种结构的预测器,DAG取得最多第一(MSE 10个、MAE 11个),明显优于TimeXer、TFT;②原生支持未来外生变量的方法(TFT、TimeXer等)普遍优于不支持的方法(PatchTST、DLinear),即使后者经MLP融合增强也是如此;DAG在利用外生输入的同时显式建模相关关系,从而在几乎所有指标上反超这些强基线。
分析一:不使用未来外生变量
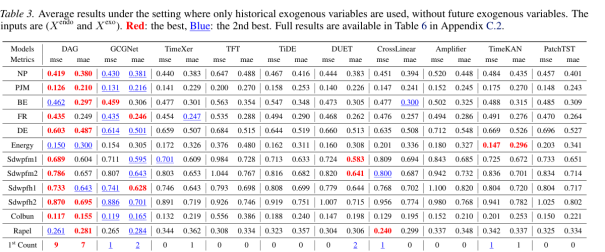
图注: 只用历史外生变量、不含未来外生变量时的平均结果(输入为Xendo、Xexo),DAG在NP(0.419/0.380)、PJM(0.126/0.210)、Energy(0.150/0.300)等数据集仍表现优秀,而通道独立的PatchTST整体偏差。
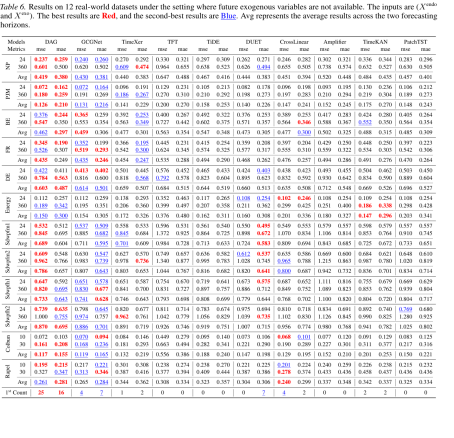
图注: 12个数据集在无未来外生设置下的完整结果,DAG的1st Count为MSE 25、MAE 16。结果表明TimeXer、CrossLinear等重视历史外生建模的方法以及灵活建模通道关系的DUET表现较好,通道独立的PatchTST较差。
分析二:8个常用多变量数据集
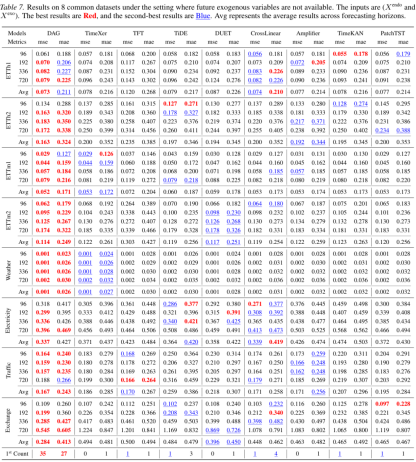
图注: 8个常用数据集在无未来外生设置下的完整结果(预测时长96/192/336/720),DAG的1st Count为MSE 35、MAE 27;在Weather等数据集上DAG与各基线数值非常接近、竞争激烈。
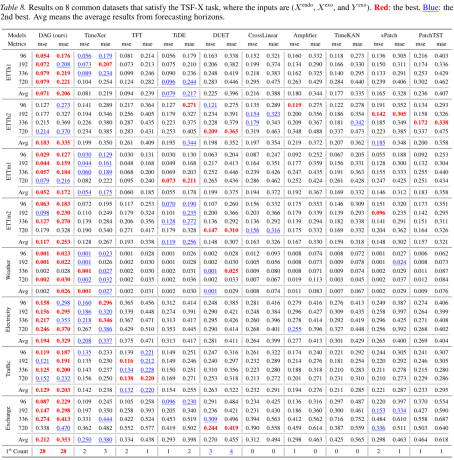
图注: 8个常用数据集在TSF-X设置(把最后一维当内生、其余当外生)下的完整结果,DAG的1st Count为MSE 28、MAE 28,整体保持最强竞争力。
分析三:参数敏感性
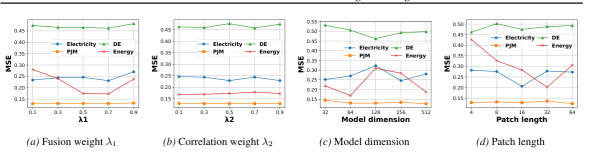
图注: 主要超参数的敏感性。(a)融合权重λ1与(b)相关权重λ2在0.3至0.7区间最优、模型在很宽范围内稳定;(c)模型维度在64至256之间较好地平衡精度与复杂度;(d)patch长度在8至32之间较优,过短会引入噪声、过长会削弱局部依赖。
分析四:消融实验
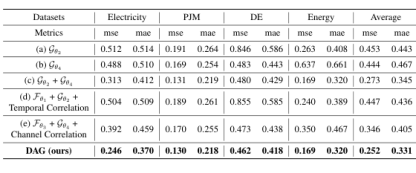
图注: 在Electricity、PJM、DE、Energy上的消融(附平均)。只用历史内生的Gθ2(0.453/0.443)或只用未来外生的Gθ4(0.444/0.467)都次优,二者结合Gθ2+Gθ4(0.273/0.345)显著提升;加入时间相关(0.447/0.436)或通道相关(0.346/0.405)均优于对应单输入版本,完整DAG(0.252/0.331)最优。
消融给出四点结论:①只依赖单一输入源(Gθ2或Gθ4)不足以获得高质量预测;②Gθ2与Gθ4结合显著提升、二者互补;③时间相关模块与通道相关模块分别优于其单输入对照,验证两类相关建模都有效;④融合双相关的完整DAG表现最好,说明对TSF-X建模双相关结构十分必要。
分析五:增大回看窗口
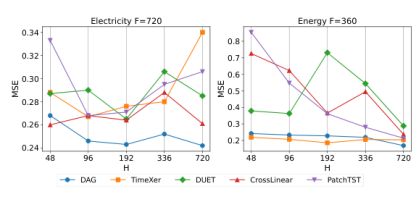
图注: Electricity(预测F=720)与Energy(预测F=360)上、回看窗口H取48/96/192/336/720时的MSE。DAG在两个数据集上一致优于TimeXer、DUET、CrossLinear、PatchTST,且随回看窗口增大MSE持续下降,说明其能够建模更长序列。
分析六:预测结果可视化
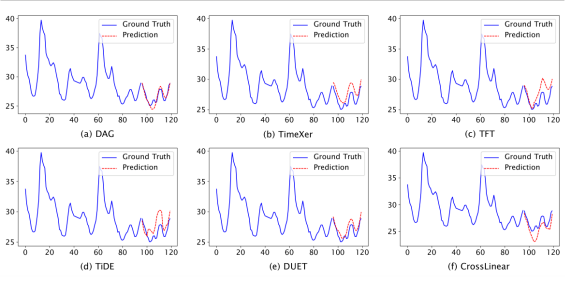
图注: NP数据集上、未来外生变量可用时6个模型的预测曲线。DAG(子图a)的预测(红虚线)在末端波动处最贴合GroundTruth(蓝实线),TimeXer、TFT、TiDE、DUET、CrossLinear均出现不同程度的相位或幅度偏差。
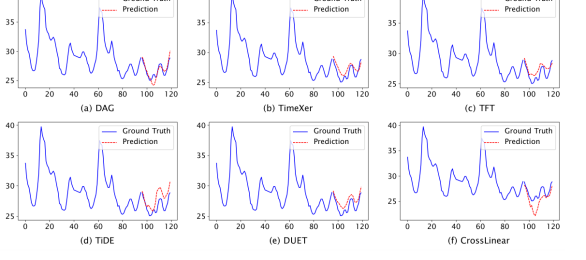
图注: NP数据集上、未来外生变量不可用时同样6个模型的预测曲线。DAG仍最贴近真实曲线,表明其在时间维与通道维都有效发现并注入了相关关系、充分利用了外生变量。
Q5:有哪些可以继续探索的点?
1. **从相关走向因果:**当前框架主要建模外生变量与内生变量之间的相关关系,而非显式捕捉因果;可引入因果发现技术,进一步识别外生变量对内生变量的因果方向与因果强度;
2. **更强的融合与交互机制:**门控目前采用两个MLP表示做点积这一较简单的交互方式,虽在效率与算力间取得良好平衡,却可能不足以刻画更复杂、更细粒度的变量交互,可探索更先进的融合与交互机制;
3. **自适应权重取代手动调参:**框架目前含多个需手动调节的权重系数,包括三个损失的平衡以及两个预测输出的融合权重,可发展自适应或全自动的加权策略,减少调参成本;
4. **扩展到更多外生模态:**可把文本事件、图像等更多类型的外生信息纳入同一相关发现---注入框架,并研究相关表示在不同数据集、不同预测时长下的迁移规律。
Q6:总结
DAG面向带外生变量的时序预测,核心思路是沿时间维与通道维分别构建"相关发现+相关注入"模块:时间相关模块先刻画历史外生对未来外生的影响、再把该相关注入基于历史内生的预测;通道相关模块先刻画历史外生对历史内生的影响、再用未来外生增强内生预测;两路输出融合、三损失端到端优化。在未来外生缺失时,模型还能用预测出的外生变量替代真实值,保证实用性。
在12个TSF-X真实数据集与8个常用多变量数据集上,DAG取得最多的第一名次,并在无未来外生、参数敏感性、消融、扩展回看与可视化等多组分析中一致占优,验证了"显式发现并注入双相关关系"对充分利用外生变量、提升预测精度的关键作用。