VisionMind:一个 Agent 图像标注软件
友情提示:个人开发可能不完善,欢迎体验:https://github.com/li554/VisionMind
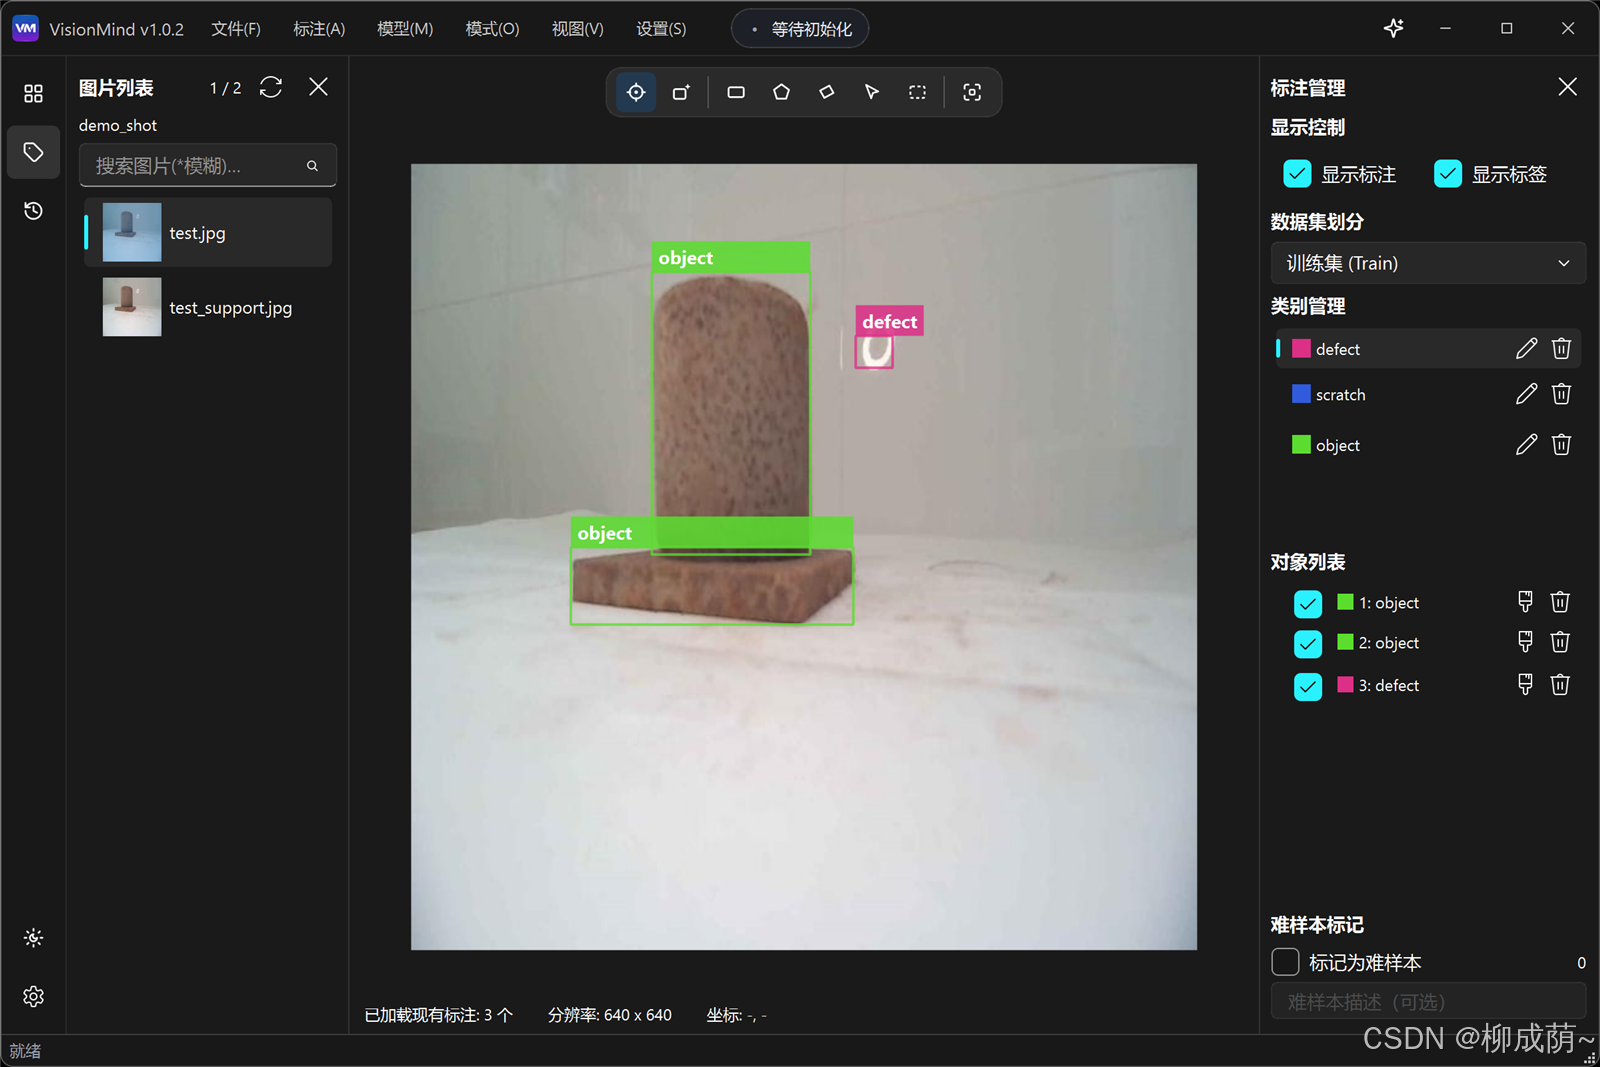
第一部分:智能化 ------ 让 Agent 替我们操作软件
1.1 用说话代替点菜单
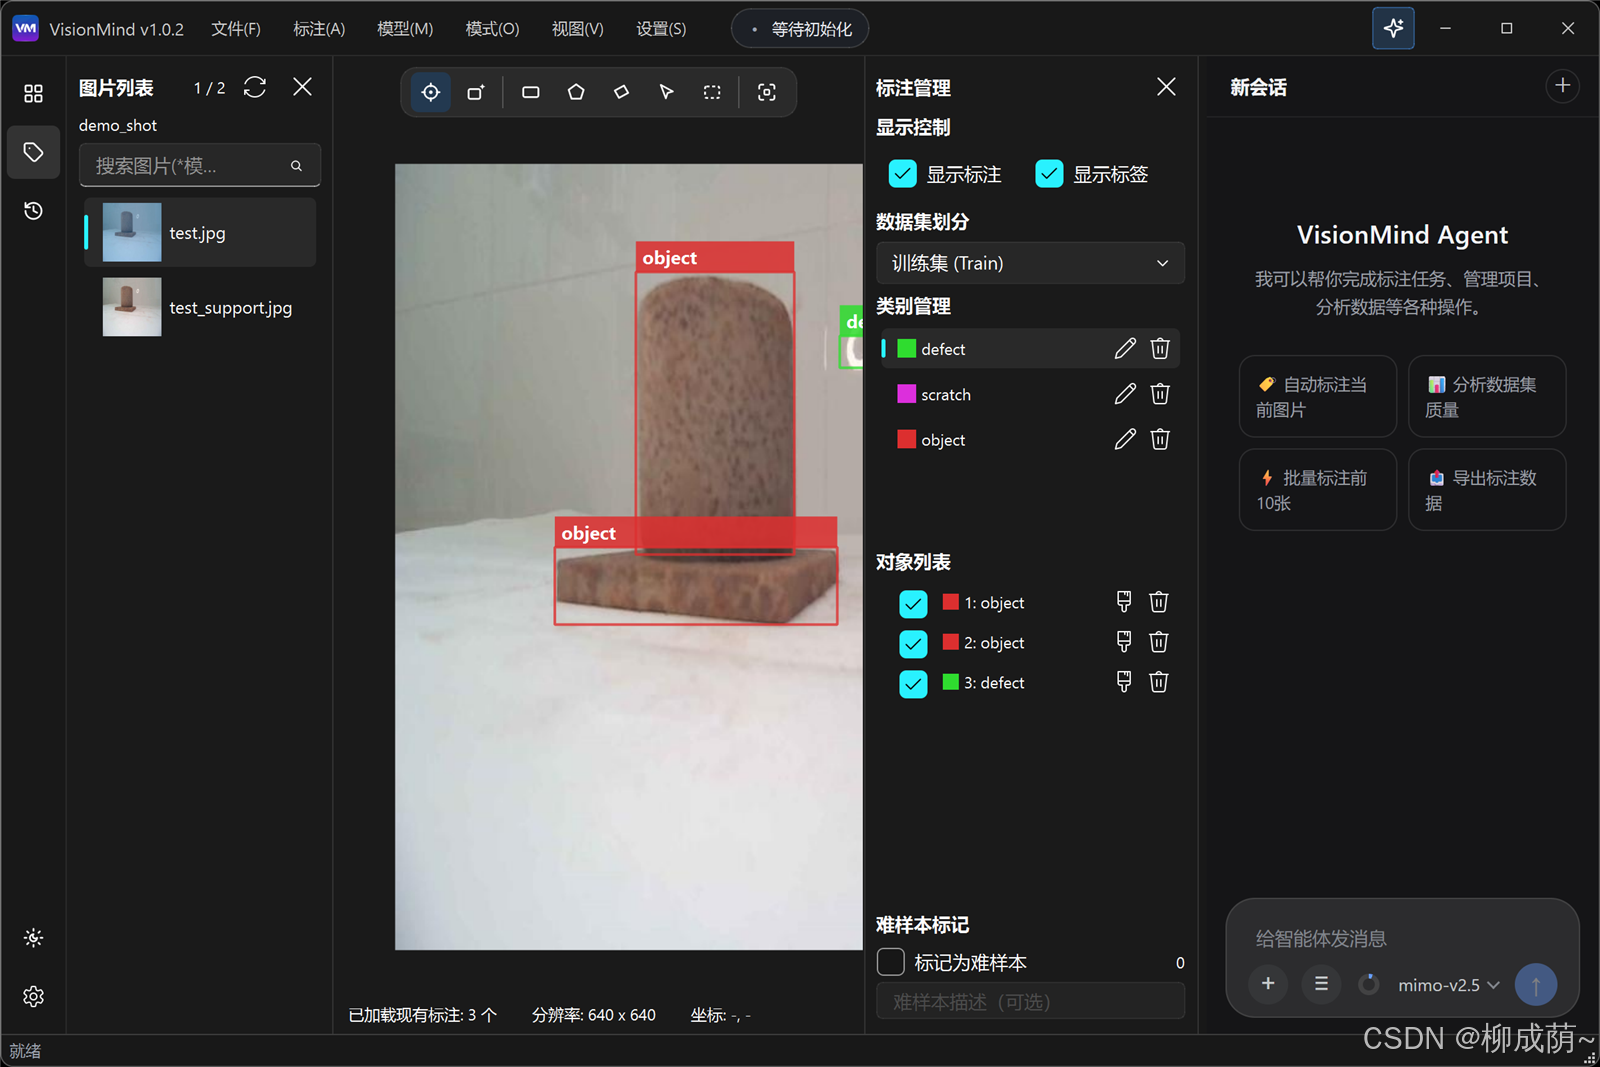
我做了一个对话式 Agent 侧栏,可以直接下指令,比如:
"加载 demo 项目,把 defect 类别里还没标过的图列出来。"
"把当前这张图里面积小于 200 像素的标注删掉。"
"导出一个 YOLO 格式的版本,然后读一下导出结果,确认结构对不对。"
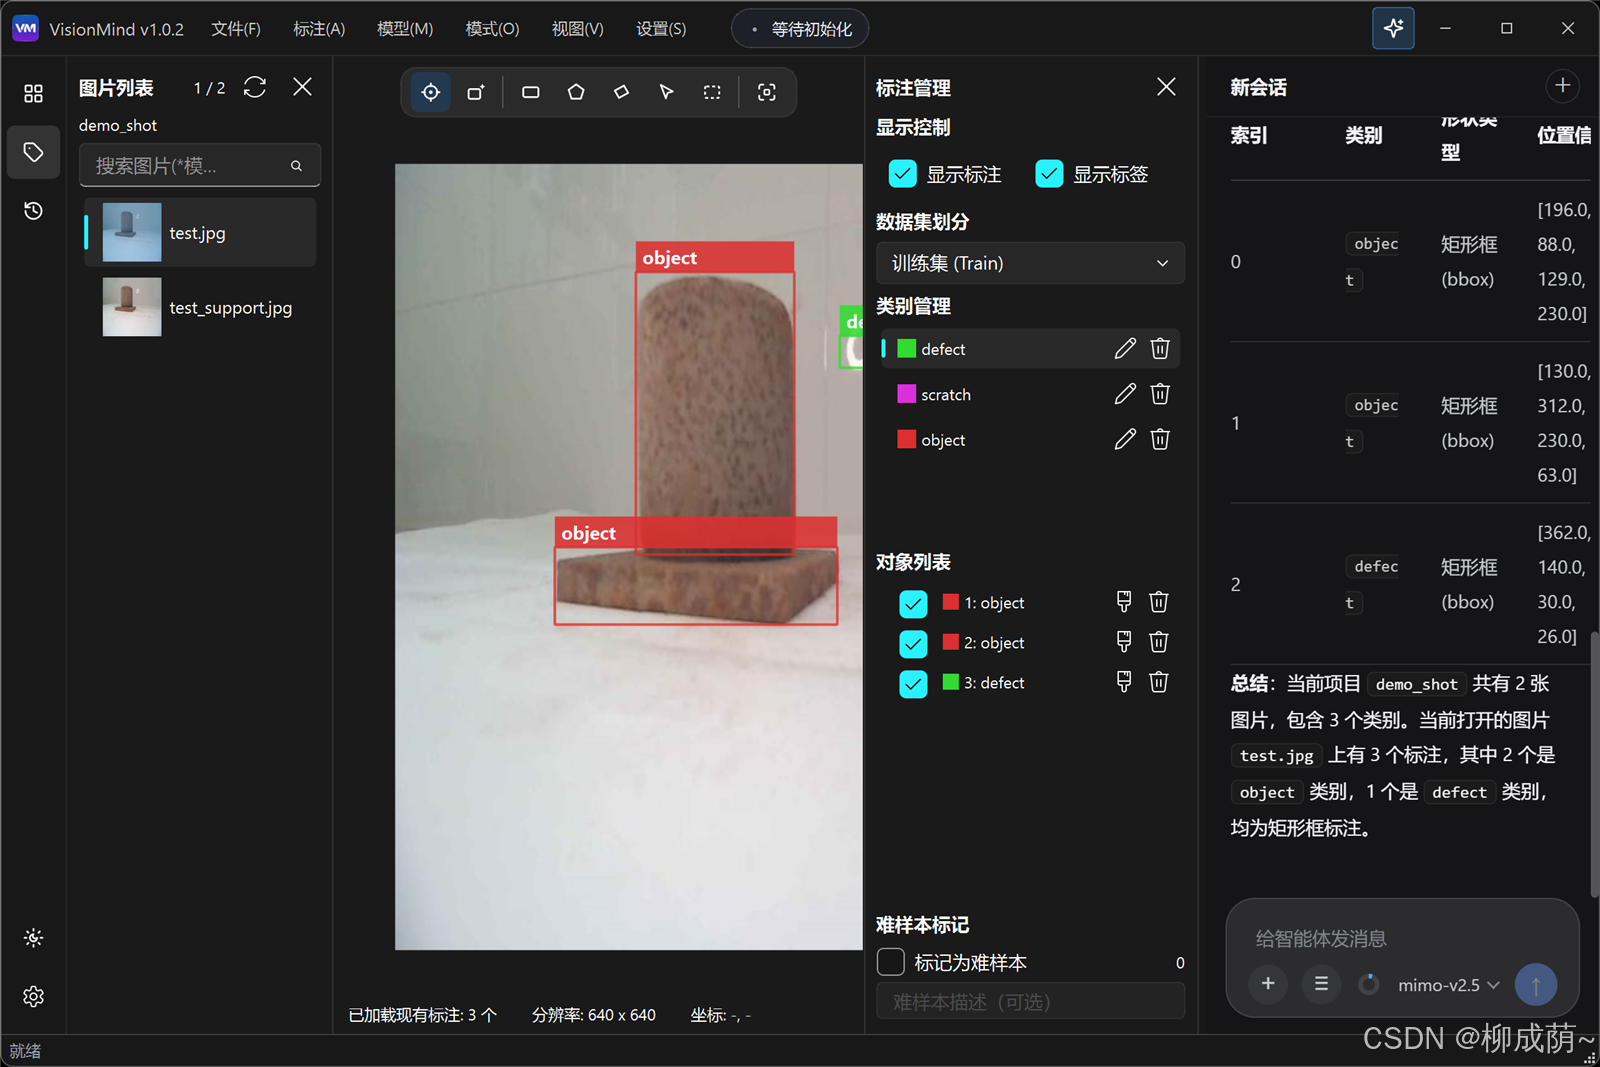
它不是只聊天,而是真的去调软件里的动作:切界面、加载项目、设筛选、改标注、跑导出。侧栏里能看到每次工具调用的过程------调了哪个动作、什么参数、返回了什么。
1.2 意图分析:先给建议,人再决定
自然语言天然含糊。所以除了直接执行,我还加了一层意图分析:把你的话翻译成几条可执行的操作建议,用卡片摆出来,你觉得对就点一下,不对就改一句再说。顶栏常驻一个小悬浮球,提示当前状态和一些快捷入口。
这套做法的思路是"先别让它自己拍板":熟练的人可以直接下指令,不熟的人看着卡片一步步走。
1.3 顺手把 187 个动作都变成了工具
动作体系基于 @action 装饰器:目前整个软件注册了 187 个可调用动作,其中 92 个(scope=agent 的那些)会自动转成 LLM 的工具 schema 暴露出去。
这样做的直接好处是:不用为 Agent 单独维护一套接口。一个功能按规范注册成 action,就同时能被界面调用、被测试脚本调用、被 Agent 调用。写插件的人不用专门考虑"怎么让 AI 用上我"。
1.4 让它读图的方式多几种
只给模型一段文字,它基本靠猜。所以我给了三种读图模式:原图 、ROI 裁剪 (只看关心的区域,省 token 也少干扰)、标注叠加(把现有标注画上去,问它"这里是不是漏了或标错了")。也支持手动附加图片或文件当上下文。
1.5 有些事让它算,别让它估
"这个缺陷大概多大""这批框是不是偏细长"这类问题,让模型目测不太靠谱。所以配了一个受限环境下的 Python 执行 ,可以用 cv2 / numpy 对当前图片实际算一遍。
从"看起来差不多"变成"算出来是多少",结果的可信度会好一些。
1.6 工具给太多,它反而会瞎找
这是踩过坑才意识到的:把 92 个工具一股脑塞给模型,它常常在工具列表里翻来翻去,决策变慢、token 涨、还容易挑错工具。
后来我改成按需裁剪工具面:按当前所在界面、按指令里的关键词命中的分类、按工具跟指令的相关性排序,先把最可能用上的那十几个摆出来;被裁掉的不是消失------还能被检索、被激活,下一轮再回到台面上。
1.7 AI 辅助标注:示例、文本、模型三条路
这可能是"智能化"里最实用的一块。三种模式,都可以对当前图或全部图片批量执行:
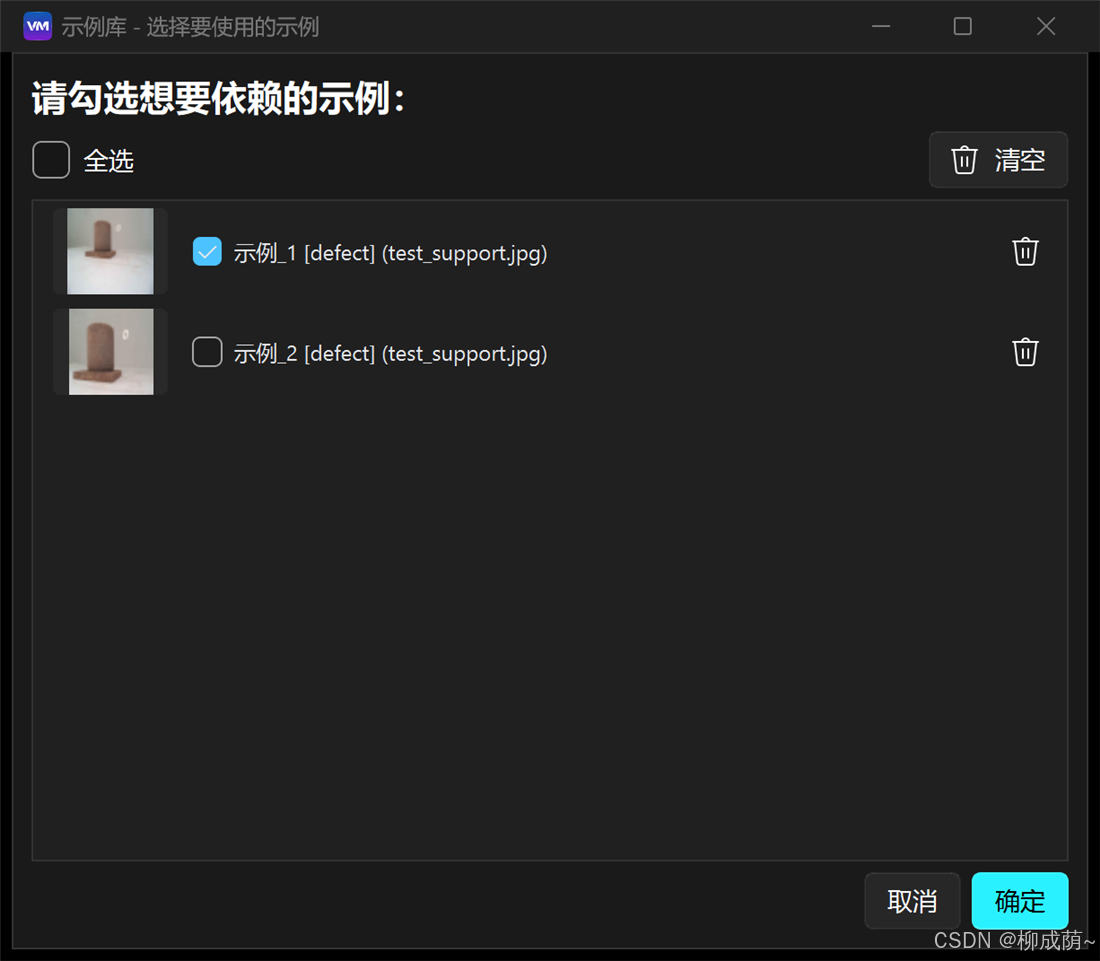
- 基于示例 :在当前图上把某个已保存的标注设为示例 ,它就进了这个项目的示例库(放在项目内的
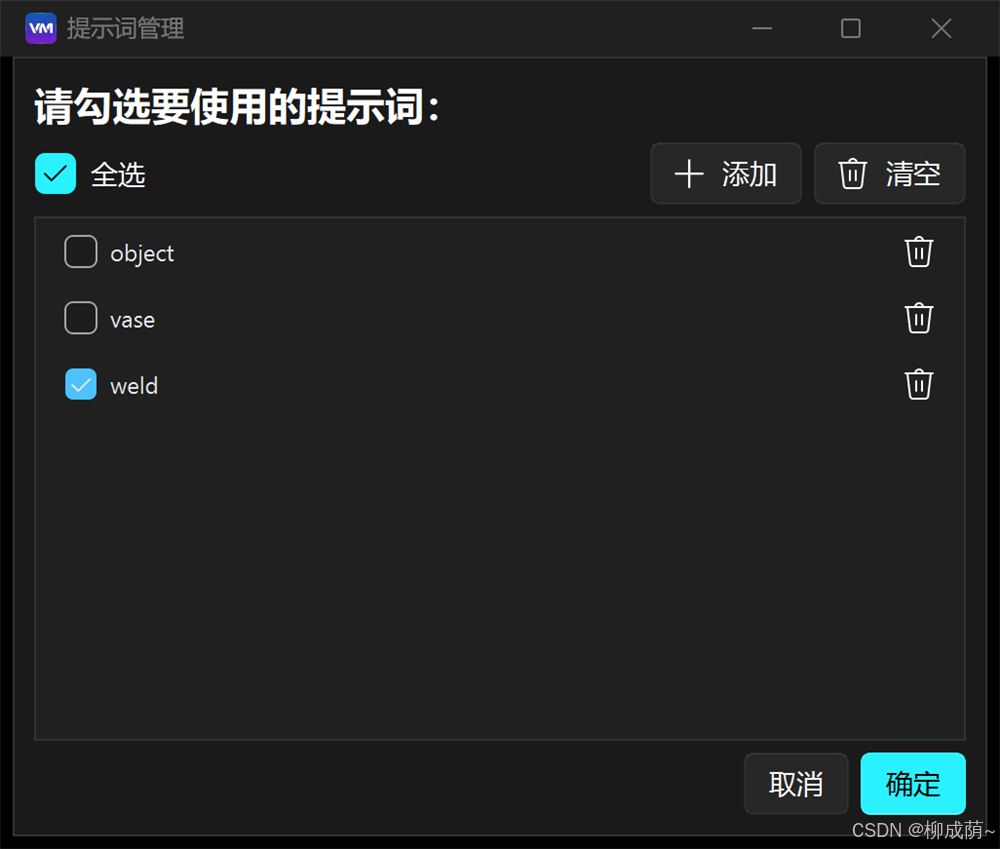
support_sets目录,跟着项目走)。之后让模型照着示例把其余的图标一遍,人只做审核和修边。 - 基于文本:SAM3 短语描述要找的目标,存进项目级提示词库,下个批次复用。
- 基于模型:YOLOv8 / YOLOE 这类检测模型直接推理;训练好的权重丢进来就能注册成可用模型,不用改代码。
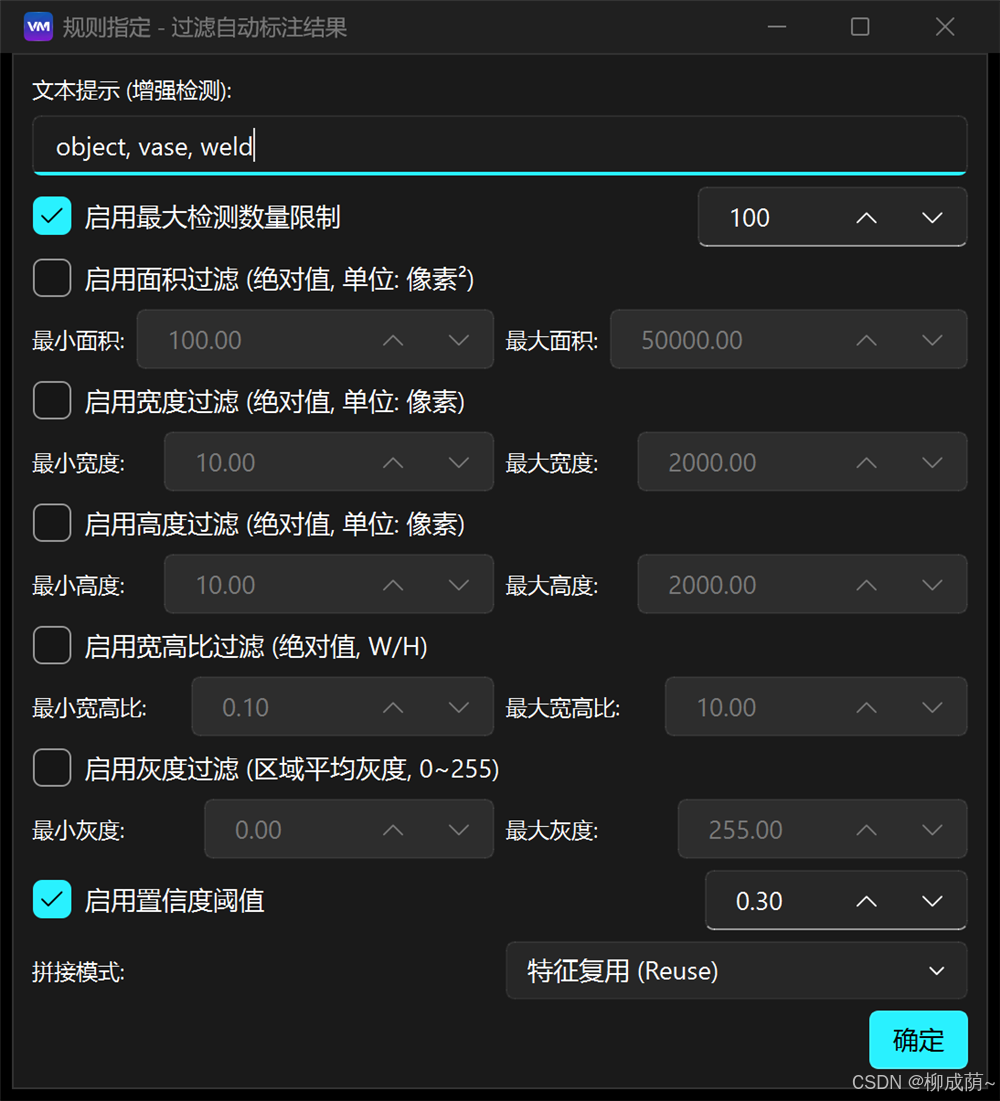
外面再挂一层规则过滤:最大保留数量、置信度阈值、面积上下限。模型可以多吐,规则负责把明显不合理的挡在入库之前,少产生一点脏数据。
第二部分:痛点优化 ------ 那些每天都碰到的小麻烦
智能化决定它"有多聪明",这部分决定它"用起来顺不顺"。出发点特别朴素:我自己用的时候,哪里烦就改哪里。
2.1 自动聚焦
一张图上百个目标,标注列表也一百多行。以前改一条的流程是:看列表 → 猜位置 → 缩放滚动找 → 没找到 → 再猜。
现在按 ↑ / ↓ 在标注之间跳,画布会自动放大 4 倍并居中到那个对象;改完按一下就是下一个;按 V 键退出聚焦回到全图。
人工审核的时候,对于一些有很多小目标的图片,"找图、找框"花的时间远远比"纠正"多,自动聚焦极大解决了我的痛点。
另外做了一些缩小范围的东西:筛选 (类别、预设尺寸、面积、宽高比、标注状态)和搜图(文件名关键词、支持通配符,搜索结果会叠加当前筛选)。
2.2 副标注对比
这是审核时最实在的一个心结:新模型看着更准,但它万一把原来标好的弄坏了呢?
于是有了副标注 :把另一套标注(新模型跑出来的,或者另一个版本导出的)作为"副标注"加载进来,系统会把它和当前主标注逐条匹配。然后:
- 匹配上的能直接看差异,采纳到指定的那条主标注 ,或者把副标注追加为主标注;
- 匹配不上的,说明模型多标了、或者人漏标了,一眼能看到;
- 觉得不对就清掉副标注,主标注完全没动。
它想解决两个场景:模型迭代后的回归对比 ,和人机标注的差异定位。
最后提一嘴
这个软件目前还谈不上成熟,一开始可能就没想过做Agent,本来只是想做一个符合我手感的标注软件,让我打标能轻松一点。Agent是后来加的,它不是每次都稳,也不是什么都能做,对于这种工具数量较大的上下文工程我尝试了很多策略。前后推翻重做的设计也不在少数,但仍然有待改进。还有很多想法,受限于软件开发经验不好推进,希望这个软件能更加系统化、规范化,然后自由拓展!!
项目地址 :https://github.com/li554/VisionMind(PySide6 + QFluentWidgets,SAM / SAM2 / SAM3 / HQ-SAM、YOLOv8 / YOLOE,GPL-3.0)