一次性读取整个 Obsidian:自动把我的 Markdown 变成 AI 知识库
系列:《从 0 打造我的本地 AI 知识库:Obsidian + Ollama + Milvus + RAG + MCP + Agent》
上一篇:《第一次完整 RAG:让本地大模型真正"读懂"我的知识库》
本文关键词:
ObsidianMarkdownChunkEmbeddingMilvusRAG自动索引Python
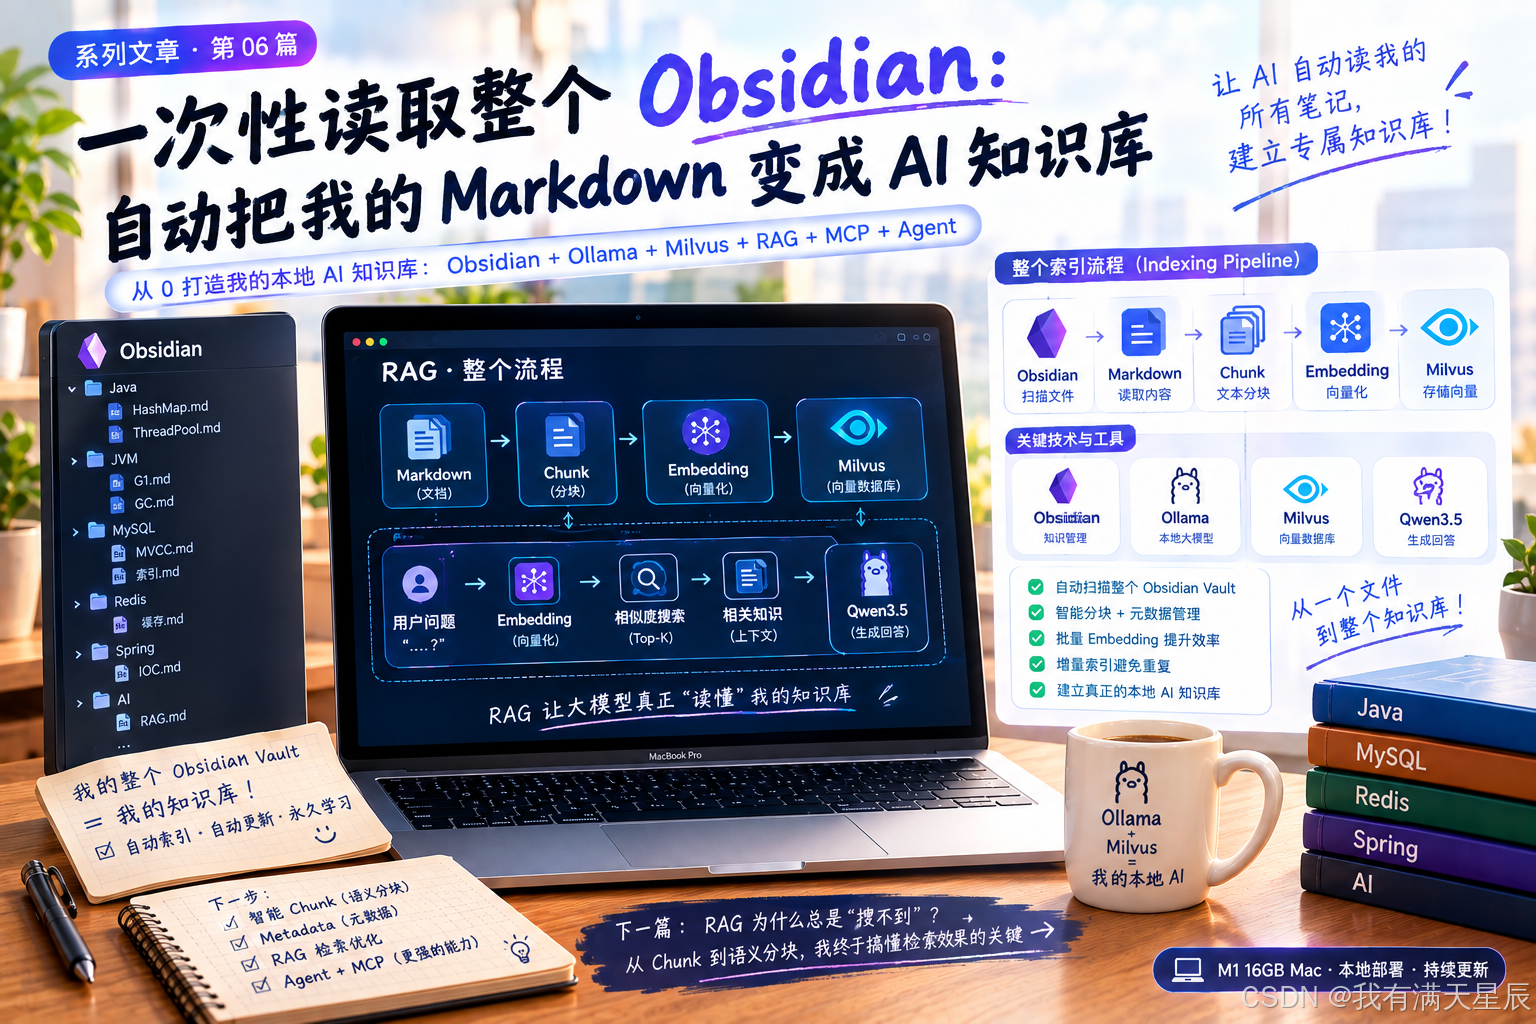
前几篇,我已经成功完成了一个非常小的实验:
text
Markdown
   ↓
Embedding
   ↓
Milvus
   ↓
向量搜索
   ↓
Qwen3.5
   ↓
AI回答
第一次跑通的时候,我确实有一种:
"我的本地 AI 终于活了。"
的感觉。
但是冷静下来一看,我马上发现了一个问题。
我的知识库只有:
text
obsidian/
└── test.md
这根本不能叫知识库。
这最多只能叫:
一个 RAG Demo。
真正的知识库应该是:
text
obsidian/
├── Java/
├── JVM/
├── MySQL/
├── Redis/
├── Spring/
├── AI/
└── Interview/
里面可能有:
text
100
1000
10000
篇 Markdown。
所以这一篇,我要解决一个非常实际的问题:
能不能让程序自动读取整个 Obsidian?
答案是:
可以。
而且这一步之后,我的项目才真正开始从:
"实验代码"
变成:
"知识库系统"。
一、先把最终目标画出来
这一篇最终要实现:
text
                    Obsidian
                       │
                       │
                整个 Vault
                       │
                       ▼
              扫描所有 Markdown
                       │
                       ▼
                  读取文件
                       │
                       ▼
                    Chunk
                       │
                       ▼
                  Embedding
                       │
                       ▼
                    Milvus
                       │
                       ▼
                  Vector DB
也就是说,以后我只需要:
bash
python indexer.py程序就可以自动发现:
text
Java/HashMap.md
Java/ThreadPool.md
JVM/G1.md
MySQL/MVCC.md
Redis/缓存.md
AI/RAG.md
而不用再手动指定:
python
FILE_PATH = "./obsidian/test.md"二、以前的方式有多麻烦?
之前我的代码是:
python
FILE_PATH = "./obsidian/test.md"程序只能处理:
text
test.md如果我又创建:
text
HashMap.md
ThreadLocal.md
G1.md
MVCC.md
Redis.md
RAG.md
那我是不是得修改代码:
python
FILE_PATH = "./obsidian/HashMap.md"再运行一次?
然后:
python
FILE_PATH = "./obsidian/G1.md"再运行一次?
显然不可能。
所以我们真正需要的是:
让程序自己寻找 Markdown 文件。
三、Python 怎么寻找整个目录?
Python 有一个非常好用的工具:
python
pathlib它是 Python 标准库,不需要额外安装。
例如:
python
from pathlib import Path然后:
python
vault_path = Path("./obsidian")现在:
text
vault_path就代表:
text
obsidian/接下来可以让 Python 找到所有:
text
*.md文件。
四、第一次自动扫描 Markdown
创建:
text
indexer.py先写最简单的版本:
python
from pathlib import Path


VAULT_PATH = Path("./obsidian")


markdown_files = list(
    VAULT_PATH.rglob("*.md")
)


print("发现 Markdown 文件:")
print()


for file in markdown_files:
    print(file)
运行:
bash
python indexer.py如果目录是:
text
obsidian/
├── test.md
├── Java/
│   └── HashMap.md
├── JVM/
│   └── G1.md
└── MySQL/
    └── MVCC.md
程序就可以自动发现:
text
obsidian/test.md
obsidian/Java/HashMap.md
obsidian/JVM/G1.md
obsidian/MySQL/MVCC.md
这一步看起来很简单。
但它非常重要。
因为:
我的程序第一次真正认识了整个 Obsidian。
五、为什么使用 rglob?
这里有一个容易忽略的地方:
python
VAULT_PATH.rglob("*.md")不是简单的:
python
glob("*.md")rglob 中的:
text
r可以理解成:
recursive【递归】
也就是:
text
obsidian/
│
├── test.md
│
├── Java/
│   ├── HashMap.md
│   └── ThreadPool.md
│
└── JVM/
    └── G1/
        └── RememberedSet.md
不管 Markdown 藏在多少层目录:
text
rglob("*.md")都可以继续往下面寻找。
所以非常适合 Obsidian。
六、找到文件以后,下一步是什么?
当然是:
读取 Markdown。
代码非常简单:
python
from pathlib import Path


file_path = Path("./obsidian/test.md")


text = file_path.read_text(
    encoding="utf-8"
)


print(text)
现在:
text
Markdown 文件
      ↓
Python
      ↓
字符串
例如:
markdown
# MySQL MVCC

MVCC 是多版本并发控制。

InnoDB 通过 Undo Log 和 Read View 实现 MVCC。
会变成 Python 中的:
python
text七、但是新的问题出现了
假设我有一篇:
text
JVM.md内容:
text
10000 字现在如果直接:
text
10000字
 ↓
Embedding
 ↓
一个向量
就不太理想。
因为用户问:
G1 的 Remembered Set 是什么?
真正相关的可能只有:
text
500 字而不是整篇 10000 字。
所以:
我需要 Chunk。
八、Chunk 到底是什么?
Chunk 可以简单理解为:
把一篇长文切成多个可以独立检索的知识片段。
例如:
text
JVM.md
   │
   ├── Chunk 1
   │   JVM 内存结构
   │
   ├── Chunk 2
   │   对象创建
   │
   ├── Chunk 3
   │   GC Roots
   │
   ├── Chunk 4
   │   G1
   │
   ├── Chunk 5
   │   Remembered Set
   │
   └── Chunk 6
       Write Barrier
然后:
text
每一个 Chunk
      ↓
Embedding
      ↓
一个 Vector
      ↓
Milvus
最终:
text
JVM.md
  │
  ├── Chunk 1 → Vector 1
  ├── Chunk 2 → Vector 2
  ├── Chunk 3 → Vector 3
  ├── Chunk 4 → Vector 4
  ├── Chunk 5 → Vector 5
  └── Chunk 6 → Vector 6
这才是比较标准的 RAG 数据处理方式。
九、第一版 Chunk 不需要搞得太复杂
很多 RAG 教程一上来就讲:
text
Recursive Character Text Splitter
Semantic Chunking
Parent-Child Retrieval
Late Chunking
Hierarchical Retrieval
第一次学习的时候很容易直接懵掉。
我现在的目标不是:
一步做到企业级 RAG。
而是:
先把完整链路跑通。
所以第一版可以采用非常简单的:
按字符长度切分
例如:
text
每 1000 个字符
切成一个 Chunk
再设置:
text
100 字符 overlap也就是:
text
Chunk 1
[--------------------]
                ↑
              100字符

Chunk 2
        [--------------------]
这样可以减少因为硬切导致的上下文断裂。
十、为什么需要 Overlap?
假设原文:
text
Undo Log 用于保存历史版本。

Read View 用于判断当前事务能够看到哪些版本。

两者共同参与 MVCC 的实现。
如果刚好在:
text
Undo Log...这里切断:
text
Chunk 1
Undo Log 用于保存历史版本。

Chunk 2
Read View 用于判断...
可能会让知识上下文被拆开。
所以可以让 Chunk 之间:
text
重复一小部分内容。这就是:
Overlap【重叠区域】
例如:
text
Chunk 1
A B C D E F

Chunk 2
        E F G H I J
        ↑
      overlap
十一、写一个最简单的 Chunker
创建:
text
chunker.py代码:
python
def split_text(
    text,
    chunk_size=1000,
    overlap=150
):
    chunks = []

    start = 0

    while start < len(text):

        end = start + chunk_size

        chunk = text[start:end]

        chunks.append(chunk)

        start = end - overlap

    return chunks
然后测试:
python
text = """
这里是一篇非常长的技术文章。
"""

chunks = split_text(text)

for i, chunk in enumerate(chunks):

    print("Chunk:", i)

    print(chunk)

    print("----------------")
现在:
text
Markdown
   ↓
10000字
   ↓
Chunker
   ↓
1000字
1000字
1000字
...
十二、但这里有一个很重要的现实问题
机械按照字符切割:
python
text[start:end]当然不是最优方案。
例如:
text
### G1 的 Remembered Set

Remembered Set 是...
如果刚好切在:
text
Remembered Set 是中间:
text
Chunk 1
Remembered Set 是

Chunk 2
一种...
语义就被拆开了。
所以真正生产级 RAG 一般会更加重视:
text
Markdown 标题
段落
代码块
列表
语义边界
十三、为什么我的知识库特别适合 Markdown Chunking?
因为我的知识本身就是:
text
Markdown而 Markdown 已经帮我提供了大量结构:
markdown
# JVM

## JVM 内存结构

### 堆

### 栈

## 垃圾回收

### GC Roots

### G1
所以未来可以设计成:
text
Markdown
   ↓
识别标题
   ↓
识别段落
   ↓
保留标题上下文
   ↓
生成 Chunk
例如:
text
Chunk:

主题:JVM → 垃圾回收 → G1

G1 是一种面向服务端应用的垃圾收集器......
相比单纯:
text
1000字符这种方式更适合我的技术知识库。
十四、接下来要做一个非常重要的事情:Metadata
现在我们保存:
text
vector
text
source
但是以后我希望知道更多信息。
例如:
text
这段知识来自:

MySQL/MVCC.md

属于:

MySQL

主题:

MVCC

第几个 Chunk:

3
所以可以保存:
text
metadata例如:
json
{
  "source": "MySQL/MVCC.md",
  "category": "MySQL",
  "title": "MVCC",
  "chunk_index": 3
}
这样以后检索的时候就可以做:
text
只搜索 MySQL或者:
text
只搜索 JVM甚至:
text
只搜索面试知识这会成为以后 RAG 优化的重要基础。
十五、现在重新设计我的 Milvus 数据
之前:
text
id
vector
text
source
现在我希望:
text
id
vector
text
source
title
category
chunk_index
也就是说:
text
┌───────────────────────────┐
│ Chunk                      │
├───────────────────────────┤
│ id                         │
│ vector                     │
│ text                       │
│ source                     │
│ title                      │
│ category                   │
│ chunk_index                │
└───────────────────────────┘
这样以后知识库才会越来越完整。
十六、现在开始把整个流程连接起来
终于到了这一篇最核心的部分。
我们现在拥有:
text
① Obsidian 扫描
② Markdown 读取
③ Chunk 分块
④ Embedding
⑤ Milvus
把它们连接:
text
                    Obsidian
                       │
                       ▼
                扫描所有 .md
                       │
                       ▼
                 读取 Markdown
                       │
                       ▼
                    Chunk
                       │
                       ▼
              Qwen3-Embedding
                       │
                       ▼
                  Vector
                       │
                       ▼
                    Milvus
这就是:
Indexing Pipeline【索引构建流程】
十七、什么叫 Indexing?
这个词以后会经常出现。
Index:
索引
Indexing:
建立索引。
我们做的事情就是:
text
我的 Markdown
       ↓
处理
       ↓
Embedding
       ↓
Vector
       ↓
Milvus
其实就是:
把原始知识转换成方便未来检索的索引数据。
所以:
text
Indexing解决的是:
"知识怎么进入知识库?"
而:
text
Retrieval解决的是:
"用户提问时,怎么找到知识?"
这是两个不同的阶段。
十八、整个 RAG 可以分成两条流水线
到这里,一个非常重要的架构开始出现:
text
                 RAG
                  │
        ┌─────────┴─────────┐
        │                   │
        ▼                   ▼
   Indexing Pipeline   Retrieval Pipeline
      建立索引              检索
        │                   │
        ▼                   ▼
   Markdown             用户问题
        │                   │
        ▼                   ▼
      Chunk              Embedding
        │                   │
        ▼                   ▼
    Embedding             Milvus
        │                   │
        ▼                   ▼
     Milvus              Top-K
                            │
                            ▼
                         Context
                            │
                            ▼
                         LLM
这张图非常值得记住。
因为以后面试官问:
"你们 RAG 的整体流程是什么?"
就可以从这两条 Pipeline 来回答。
十九、把所有 Markdown 自动处理
现在可以写一个简化版:
python
from pathlib import Path
import requests


VAULT_PATH = Path("./obsidian")

EMBEDDING_URL = "http://localhost:11434/api/embed"

EMBEDDING_MODEL = "qwen3-embedding:0.6b"


def split_text(
    text,
    chunk_size=1000,
    overlap=150
):
    chunks = []

    start = 0

    while start < len(text):

        end = start + chunk_size

        chunk = text[start:end]

        chunks.append(chunk)

        start = end - overlap

    return chunks


def embedding(text):

    response = requests.post(
        EMBEDDING_URL,
        json={
            "model": EMBEDDING_MODEL,
            "input": text
        }
    )

    response.raise_for_status()

    return response.json()["embeddings"][0]


markdown_files = VAULT_PATH.rglob("*.md")


for file_path in markdown_files:

    print()
    print("处理文件:", file_path)

    text = file_path.read_text(
        encoding="utf-8"
    )

    chunks = split_text(text)

    print(
        "Chunk 数量:",
        len(chunks)
    )

    for index, chunk in enumerate(chunks):

        vector = embedding(chunk)

        print(
            f"Chunk {index}:",
            len(vector)
        )
现在运行:
bash
python indexer.py程序就会:
text
找到文件
 ↓
读取
 ↓
切 Chunk
 ↓
Embedding
二十、不过这里有一个巨大的性能问题
假设:
text
1000 篇 Markdown每篇:
text
10 个 Chunk那么:
text
1000 × 10
=
10000 个 Chunk
意味着:
text
10000 次 Embedding如果每次都:
text
HTTP 请求
 ↓
Ollama
 ↓
Embedding
速度就会非常慢。
所以真正的知识库还需要进一步优化:
批量 Embedding
也就是:
text
Chunk 1
Chunk 2
Chunk 3
Chunk 4
      ↓
一次请求
      ↓
Embedding
      ↓
Vector 1
Vector 2
Vector 3
Vector 4
而不是:
text
Chunk 1 → 请求
Chunk 2 → 请求
Chunk 3 → 请求
Chunk 4 → 请求
后面优化索引器的时候,我们会处理这个问题。
二十一、还需要解决"重复索引"
现在如果我运行:
bash
python indexer.py一次。
数据库:
text
100 个 Chunk然后第二天又运行:
bash
python indexer.py如果程序没有判断:
这个文件以前是不是已经处理过?
那么就会变成:
text
第一次
100 chunks

第二次
200 chunks

第三次
300 chunks
出现大量重复数据。
所以真正的知识库还需要:
增量索引
也就是:
text
文件没变化
   ↓
跳过

文件发生变化
   ↓
重新 Embedding

新增文件
   ↓
建立索引

删除文件
   ↓
删除对应向量
这才是真正可以长期运行的知识库。
二十二、我开始意识到:RAG 不是一个简单的 Demo
到这里,我原来以为:
text
RAG
=
Embedding + Vector DB + LLM
现在发现远远不止。
一个真正可用的 RAG 至少涉及:
text
数据源
 ↓
文档加载
 ↓
文本清洗
 ↓
Chunk
 ↓
Embedding
 ↓
Vector DB
 ↓
Retrieval
 ↓
Rerank
 ↓
Context
 ↓
Prompt
 ↓
LLM
 ↓
Answer
甚至还包括:
text
Metadata
权限
增量索引
删除同步
缓存
评估
引用
监控
所以:
RAG 的难点其实并不只是"调用大模型"。
真正困难的是:
怎么把知识可靠地送到大模型面前。
二十三、这一篇之后,我的项目发生了一个变化
以前:
text
test.md
   ↓
Embedding
   ↓
Milvus
现在:
text
Obsidian Vault
      ↓
自动扫描
      ↓
Markdown
      ↓
Chunk
      ↓
Embedding
      ↓
Milvus
这意味着以后我只需要把知识写进:
text
Obsidian而不需要再考虑:
text
怎么导入?
怎么 Embedding?
怎么保存?
这些工作逐渐可以交给程序。
二十四、我的本地 AI 知识库开始成型
现在整个项目可以理解成:
text
                 我的知识
                    │
                    ▼
                Obsidian
                    │
                    ▼
              Markdown Vault
                    │
                    ▼
              自动索引器
                    │
          ┌─────────┴─────────┐
          │                   │
          ▼                   ▼
        Chunk             Metadata
          │                   │
          └─────────┬─────────┘
                    ▼
               Embedding
                    │
                    ▼
                 Milvus
                    │
                    ▼
                Vector DB
                    │
                    ▼
                  RAG
                    │
                    ▼
                Qwen3.5
                    │
                    ▼
                 AI回答
这已经越来越像一个真正的:
Personal AI Knowledge Base【个人 AI 知识库】
了。
二十五、下一步最值得做什么?
现在不要急着上 Agent,也不要急着上 MCP。
因为目前还有一个非常明显的问题:
我的 Chunk 还很粗糙。
所以接下来我要解决:
text
Markdown
   ↓
智能 Chunk
而不是简单:
text
每 1000 字硬切一次下一篇就进入:
《RAG 为什么总是"搜不到"?从 Chunk 到语义分块,我终于搞懂检索效果的关键》
我们会开始研究:
text
Chunk Size
Overlap
Markdown 标题
代码块
段落
Metadata
Top-K
相似度阈值
并且会做一个非常有意思的实验:
text
同一个问题
       ↓
不同 Chunk 策略
       ↓
分别检索
       ↓
比较结果
这样我就能真正理解:
为什么有时候 Embedding 明明做对了,RAG 还是回答不好。
而这一步,也会开始进入真正的: