复合索引最左前缀原则:PostgreSQL 的 WHERE 为什么必须命中第一列
标签:#PostgreSQL #索引 #性能优化
一、前言
你是否遇到过:明明建了复合索引,EXPLAIN 却显示 Seq Scan(全表扫描),或者 Bitmap Index Scan 把整棵索引树扫了个遍?
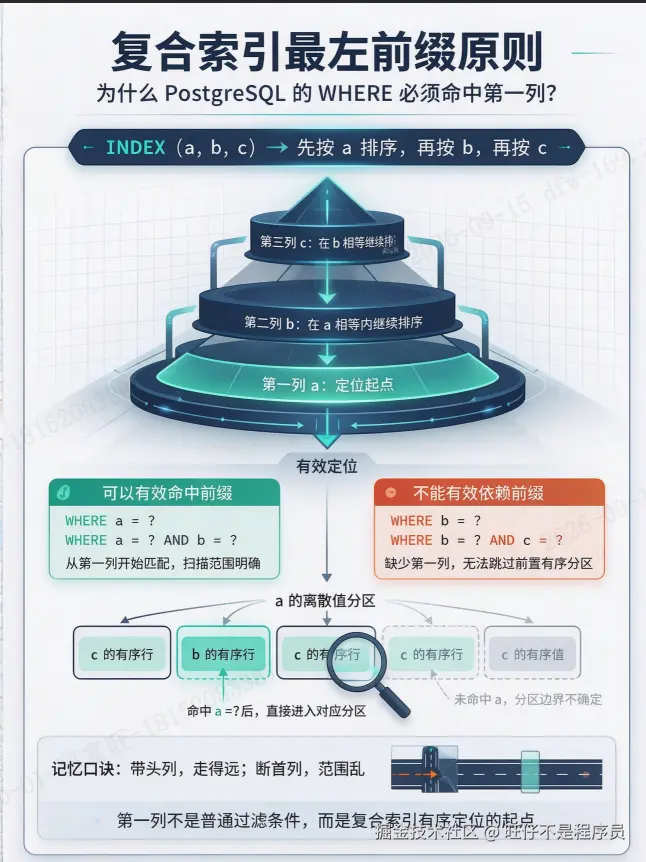
很多开发者以为"建了复合索引就万事大吉"。结果 WHERE 条件没带第一列,PostgreSQL 优化器要么全表扫描,要么扫描完整棵索引,查询直接退化成 O(N)。复合索引用得好不好,第一列是关键中的关键。
二、核心开发规范
- 复合索引 (a, b, c) 的查询条件必须包含最左列 a:只有从最左列开始连续匹配,才能逐步缩小索引扫描范围;
- 复合列数推荐不超过 3 个:第 3 列之后,存储与写入成本持续上升,区分度收益趋近于 0,性价比断崖式下跌;
- 别用"多塞几列"做覆盖索引 :PostgreSQL 提供了
INCLUDE子句,覆盖列应放进INCLUDE,而不是塞进键列。
三、底层原理通俗讲解
- B-tree 多列索引 :键是
(a, b, c)元组,按字典序整体排序------先按a,a相同按b,b相同按c。类比电话簿:"姓 → 名",只有知道姓氏才能快速翻到那一页; - 最左前缀 :只有从最左列开始的连续前缀,才能缩小索引扫描范围 。没有
a,B-tree 无法定位起点,只能从头扫; - PostgreSQL 与 MySQL 的关键差异 :MySQL 缺最左列 → 索引完全失效,全表扫描;PostgreSQL 缺最左列 → 索引仍可能被使用 (右侧列作为 Filter 在索引内检查),但不会缩小扫描范围 ,扫完整棵索引的效率约等于全表扫描。官方文档原话:最左列上的等值约束(加上第一个非等值约束列的不等值约束)总会用于限制扫描范围;右侧列的约束只是在索引中检查,减少回表,但不减少扫描范围。
四、实战错误案例&优化方案
场景1:WHERE 缺最左列(最高频错误)
表设计:orders 表,复合索引 idx_orders_user_status (user_id, status, create_time)
❌ 错误写法(WHERE 不带第一列 user_id,索引无法缩小范围)
sql
SELECT * FROM orders WHERE status = 1;
-- 执行计划:Bitmap Index Scan 扫完整棵索引 + Filter(status=1),或直接 Seq Scan
✅ 正确优化写法(带最左列 user_id,索引精准定位)
sql
SELECT * FROM orders WHERE user_id = 10086 AND status = 1;补充:如果业务就是高频按 status 单列查询,单独建 idx_orders_status 才是正解。
关键结论:复合索引不是"建了三列就三列都能单查";谁的单列查询频次高,就给谁单独建索引。
场景2:跳列------WHERE 用了第 1 列和第 3 列
❌ 错误写法(跳过 status,create_time 无法缩小范围,只能作为索引内 Filter)
sql
SELECT * FROM orders
WHERE user_id = 10086 AND create_time >= '2026-09-01 00:00:00';
✅ 方案A:补齐中间列(如果 status 确实有等值条件)
sql
SELECT * FROM orders
WHERE user_id = 10086 AND status = 1 AND create_time >= '2026-09-01 00:00:00';
✅ 方案B:调整索引列序(如果 create_time 范围查询更常用)
sql
CREATE INDEX idx_orders_user_time ON orders (user_id, create_time);关键结论:跳列 = 右侧列白建;索引列序必须对着真实查询组合来排。
场景3:范围条件截断
❌ 错误写法(status 是不等值,create_time 无法缩小范围)
sql
SELECT * FROM orders
WHERE user_id = 10086 AND status > 1 AND create_time >= '2026-09-01';
✅ 正确写法(等值列前置,范围列放最后)
sql
SELECT * FROM orders
WHERE user_id = 10086 AND status = 1 AND create_time >= '2026-09-01';
关键结论 :等值条件列放前面,范围条件列放最后;范围条件会截断其后所有列。
场景4:覆盖索引的正确姿势------INCLUDE(PostgreSQL 特色)
❌ 错误写法(为了覆盖查询把列全塞进键列,索引膨胀、B-tree 去重失效)
sql
CREATE INDEX idx_orders_cover ON orders
  (user_id, status, create_time, amount, product_id);
✅ 正确写法(键列只放 WHERE / 排序用到的列,覆盖列放 INCLUDE,PG 11+)
sql
CREATE INDEX idx_orders_cover ON orders
  (user_id, status) INCLUDE (create_time, amount);

SELECT create_time, amount FROM orders
WHERE user_id = 10086 AND status = 1;
-- 执行计划:Index Only Scan,无需回表
关键结论 :INCLUDE 列不参与排序和搜索、不增加 B-tree 层级复杂度,是"给索引加列"的唯一正确姿势;但它会膨胀索引且禁用 B-tree 去重,宽列要慎用(官方文档明确提示)。
五、绝对禁止的写法汇总
- 查复合索引却不带最左列 :
WHERE b = 1/WHERE c = 1; - 跳列使用 :
WHERE a = 1 AND c = 1; - 范围条件放等值条件前面 :
WHERE a > 1 AND b = 1(b 白建); - 为了覆盖查询无脑加键列 (应该用
INCLUDE); - 对索引列做函数 / 运算:
WHERE date(create_time) = '2026-09-01'。
六、最终评审口诀(记住不踩坑)
最左前缀第一条,WHERE 必须带首列;
键列不过三,覆盖请用 INCLUDE。
七、总结
- 使用规则:复合索引查询必须从第一列开始连续匹配,缺首列或跳列都等于白建;
- 数量规则 :复合列数推荐 2~3 个,第 3 列后存储/写入成本涨、区分度收益趋零;
- 列序规则:等值列在前、高区分度在前、范围列最后;
- PostgreSQL 特有 :覆盖查询用
INCLUDE,别往键列里塞;索引最多 32 列只是硬上限,不是设计目标; - 验证手段 :建索引后用
EXPLAIN ANALYZE对比Index Cond(真正缩小范围的列)与Filter(只是索引内过滤的列),确认索引真实生效。
标签:PostgreSQL 数据库 索引
参考来源
- PostgreSQL 官方文档 11.3 Multicolumn Indexes(最左前缀精确规则)------ www.postgresql.org/docs/18/ind...
- PostgreSQL 官方文档 CREATE INDEX(32 列上限、INCLUDE 语义与注意事项)------ www.postgresql.org/docs/curren...