2026 年 8 月 26 日,智谱(Z.ai)发布并开源了 GLM-5.3-Flash ------GLM-5 系列的首个原生多模态模型,权重当天以 MIT 协议放出。它是一个 320B 总参数 / 18B 激活的 MoE 模型,在 Artificial Analysis 综合智能指数(v4.1.1)上拿到 57 分,与 Claude Opus 4.8 持平,而 API 定价只有 GLM-5.3 的 1/10。
我们来看一下官方给出的关键规格:
| 属性 | 数值 |
|---|---|
| 架构 | MoE(混合专家) |
| 总参数量 | 3200 亿 |
| 激活参数量 | 180 亿 |
| 层数 | 45(GLM-4.5 为 92 层) |
| 专家数量 | 288 个路由专家 + 1 个共享专家,top-8 激活 |
| 注意力 | 稀疏注意力 + 线性注意力混合架构,支持 MTP |
| 上下文长度 | 1,048,576(1M),最大输出 128K |
| 输入模态 | 文本 / 图像 / 视频(448px 视觉编码器) |
| 权重精度 | 原生 FP8(约 306 GiB),另有 BF16 变体 |
| 开源协议 | MIT |
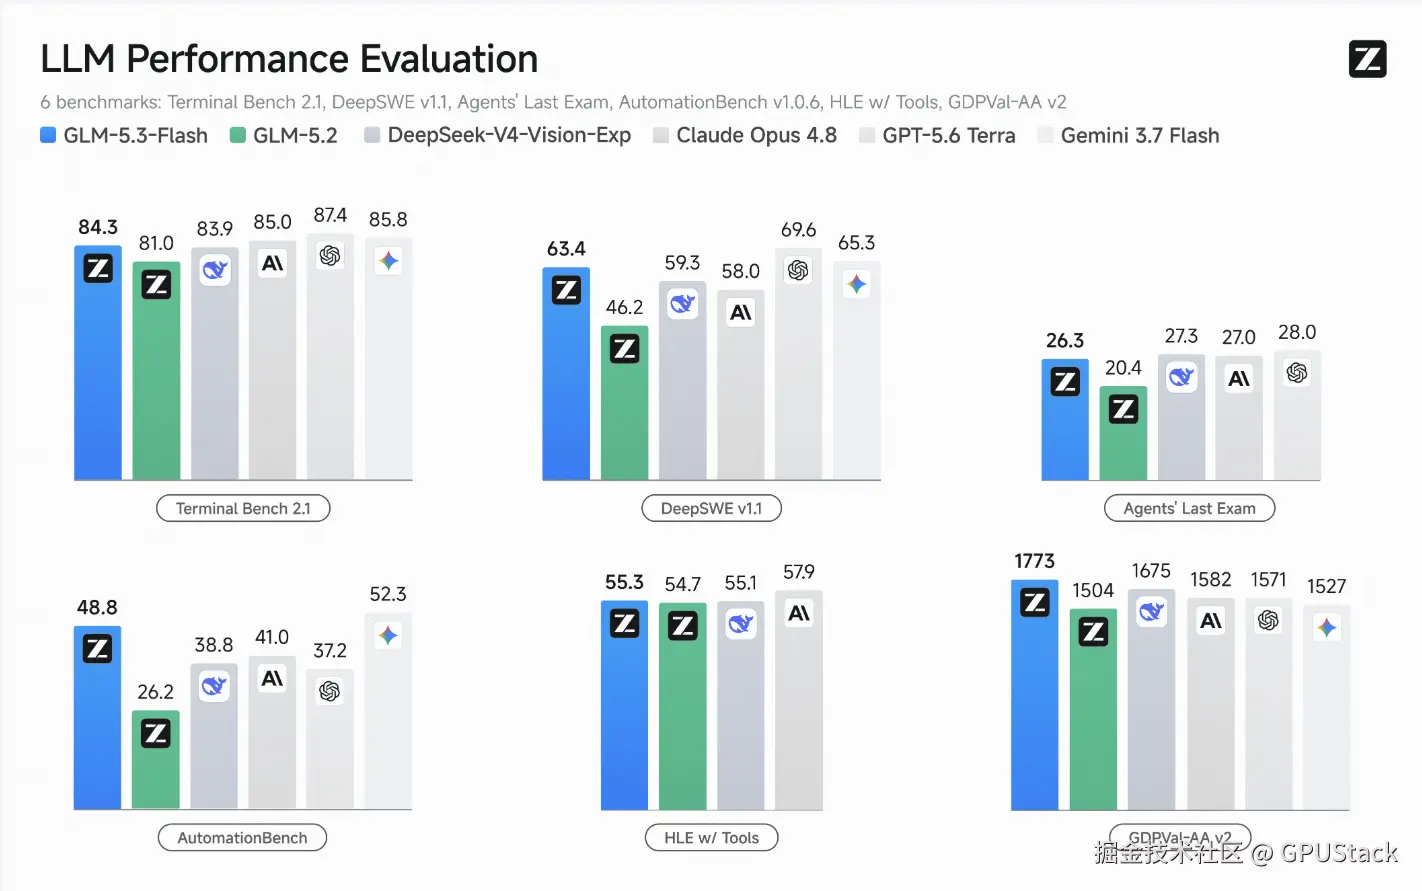
官方口径里,GLM-5.3-Flash 在六项编码与 Agent 基准上全面超越参数量高出一倍的 GLM-5.2:Terminal-Bench 2.1(81.0 → 84.3)、DeepSWE v1.1(46.2 → 63.4)、Agents' Last Exam(20.4 → 26.3)、AutomationBench(26.2 → 48.8)、HLE with tools(54.7 → 55.3)、GDPval-AA v2 Elo(1504 → 1773)。其中 GDPval-AA v2 由 Artificial Analysis 独立跑分,1773 分是榜单最高。
一、在 GPUStack 上部署 GLM-5.3-Flash
GLM-5.3-Flash 是 8 月底才开源的新模型,采用了稀疏 + 线性混合注意力、mHC(流形约束超连接)等一整套新结构,普通 vLLM 版本跑不起来------模型代码目前只在 vLLM 主干和官方专用镜像 vllm/vllm-openai:glm53-flash 里,尚未进入任何一个正式版本。
好在这件事在 GPUStack 里只需要在「推理后端」加一个版本,剩下的部署流程仍然是 Web 界面几步完成。
实测环境:8 张 H20-96G 显卡,Driver Version 570.172.08,CUDA Version 12.8。
① 进入「推理后端」,先为 vLLM 添加 glm53-flash 版本
关键顺序 :必须先在「推理后端」里加好这个镜像版本,部署页面的「后端版本」下拉框才能选到它。
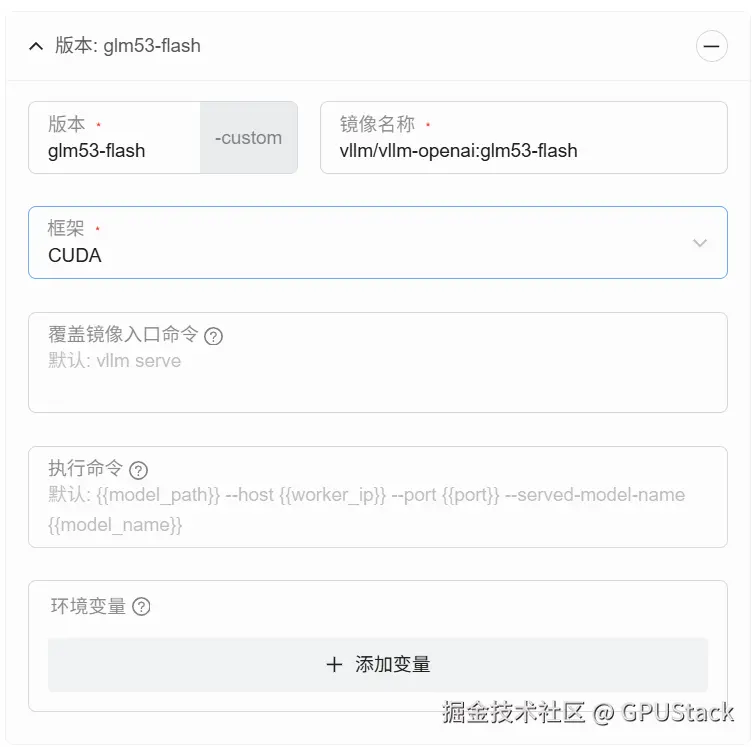
左侧菜单进入 推理后端 ,找到 vLLM 卡片点「编辑」,在「版本配置」里点「添加版本」。
- 版本号:填
glm53-flash(与镜像 tag 对应,便于识别) - 镜像名称:填写
vllm/vllm-openai:glm53-flash(GLM-5.3-Flash 专用 Day-0 版本) - 框架选择 CUDA
保存后即得到一个可选的 glm53-flash 版本。
该镜像只支持 NVIDIA Hopper 及更新架构 (H100 / H200 / H20),以及 AMD Instinct gfx950(ROCm)。它对 FlashInfer ≥ 0.6.18 有硬依赖(NoPE 稀疏 MLA 初始化需要),官方镜像已内置,不要换成通用 vLLM 镜像。
② 新建部署,选模型与后端
回到 部署 页面,点右上角「部署模型」,按下图填写基本信息:
- 来源 选择 ModelScope (国内下载更稳定),仓库 ID 填
ZhipuAI/GLM-5.3-Flash - 后端 选 vLLM
- 后端版本 选刚才添加的
glm53-flash版本
③ 配置后端参数
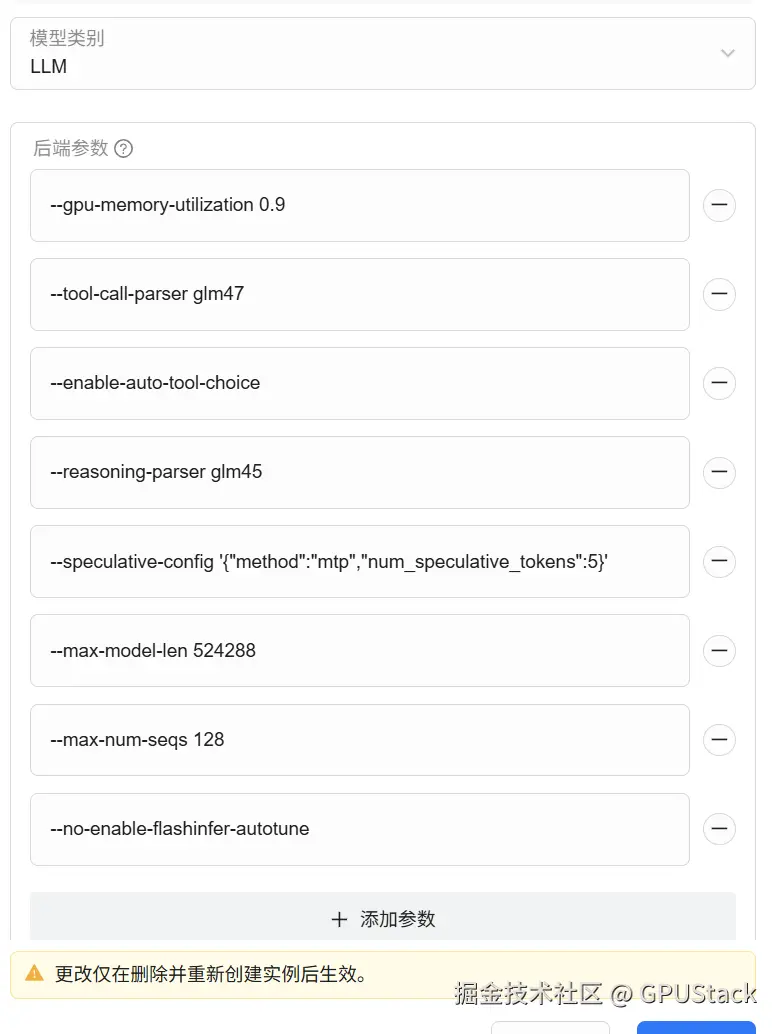
在「高级」里逐项填入后端参数:
text
--gpu-memory-utilization 0.9
--tool-call-parser glm47
--enable-auto-tool-choice
--reasoning-parser glm45
--speculative-config '{"method":"mtp","num_speculative_tokens":5}'
--max-model-len 524288
--max-num-seqs 128
--no-enable-flashinfer-autotune
关键点说明:
--tool-call-parser glm47+--enable-auto-tool-choice+--reasoning-parser glm45:打开 GLM-5.3-Flash 的工具调用 与思考链解析 ,是它 Agent 能力的核心开关。注意这里两个解析器的名字不一致(工具调用glm47、推理glm45),照抄即可,别手滑写成同一个。--gpu-memory-utilization 0.9+--max-num-seqs 128:尽量把剩余显存让给 KV 缓存,同时限制并发序列数,避免长上下文场景下 OOM。--no-enable-flashinfer-autotune:跳过 FlashInfer 的自动调优。模型权重加载 + 编译本身就要十几分钟,再叠加 autotune 会让首次启动慢到难以接受,关掉它启动更快且吞吐基本无损。
⚠️ 一个容易踩的坑 :本文没有 加
--kv-cache-dtype fp8。在 Hopper 架构上该模型的 FP8 KV 缓存尚不被支持,强行指定会报错。好在 GLM-5.3-Flash 的混合注意力本身已经把 KV 缓存压到 GLM-5.3 的 1/4.4(注意力计算量降 3.0 倍),靠 IndexPool(把 4 个索引器键向量加权池化压缩成 1 个)就能拿到不错的长上下文经济性,不必额外做 KV 量化。
提交后实例进入 Running 即部署完成。
二、验证与调用
1. 试验场交互
直接在 GPUStack 试验场里对话,观察右下角实时输出吞吐。
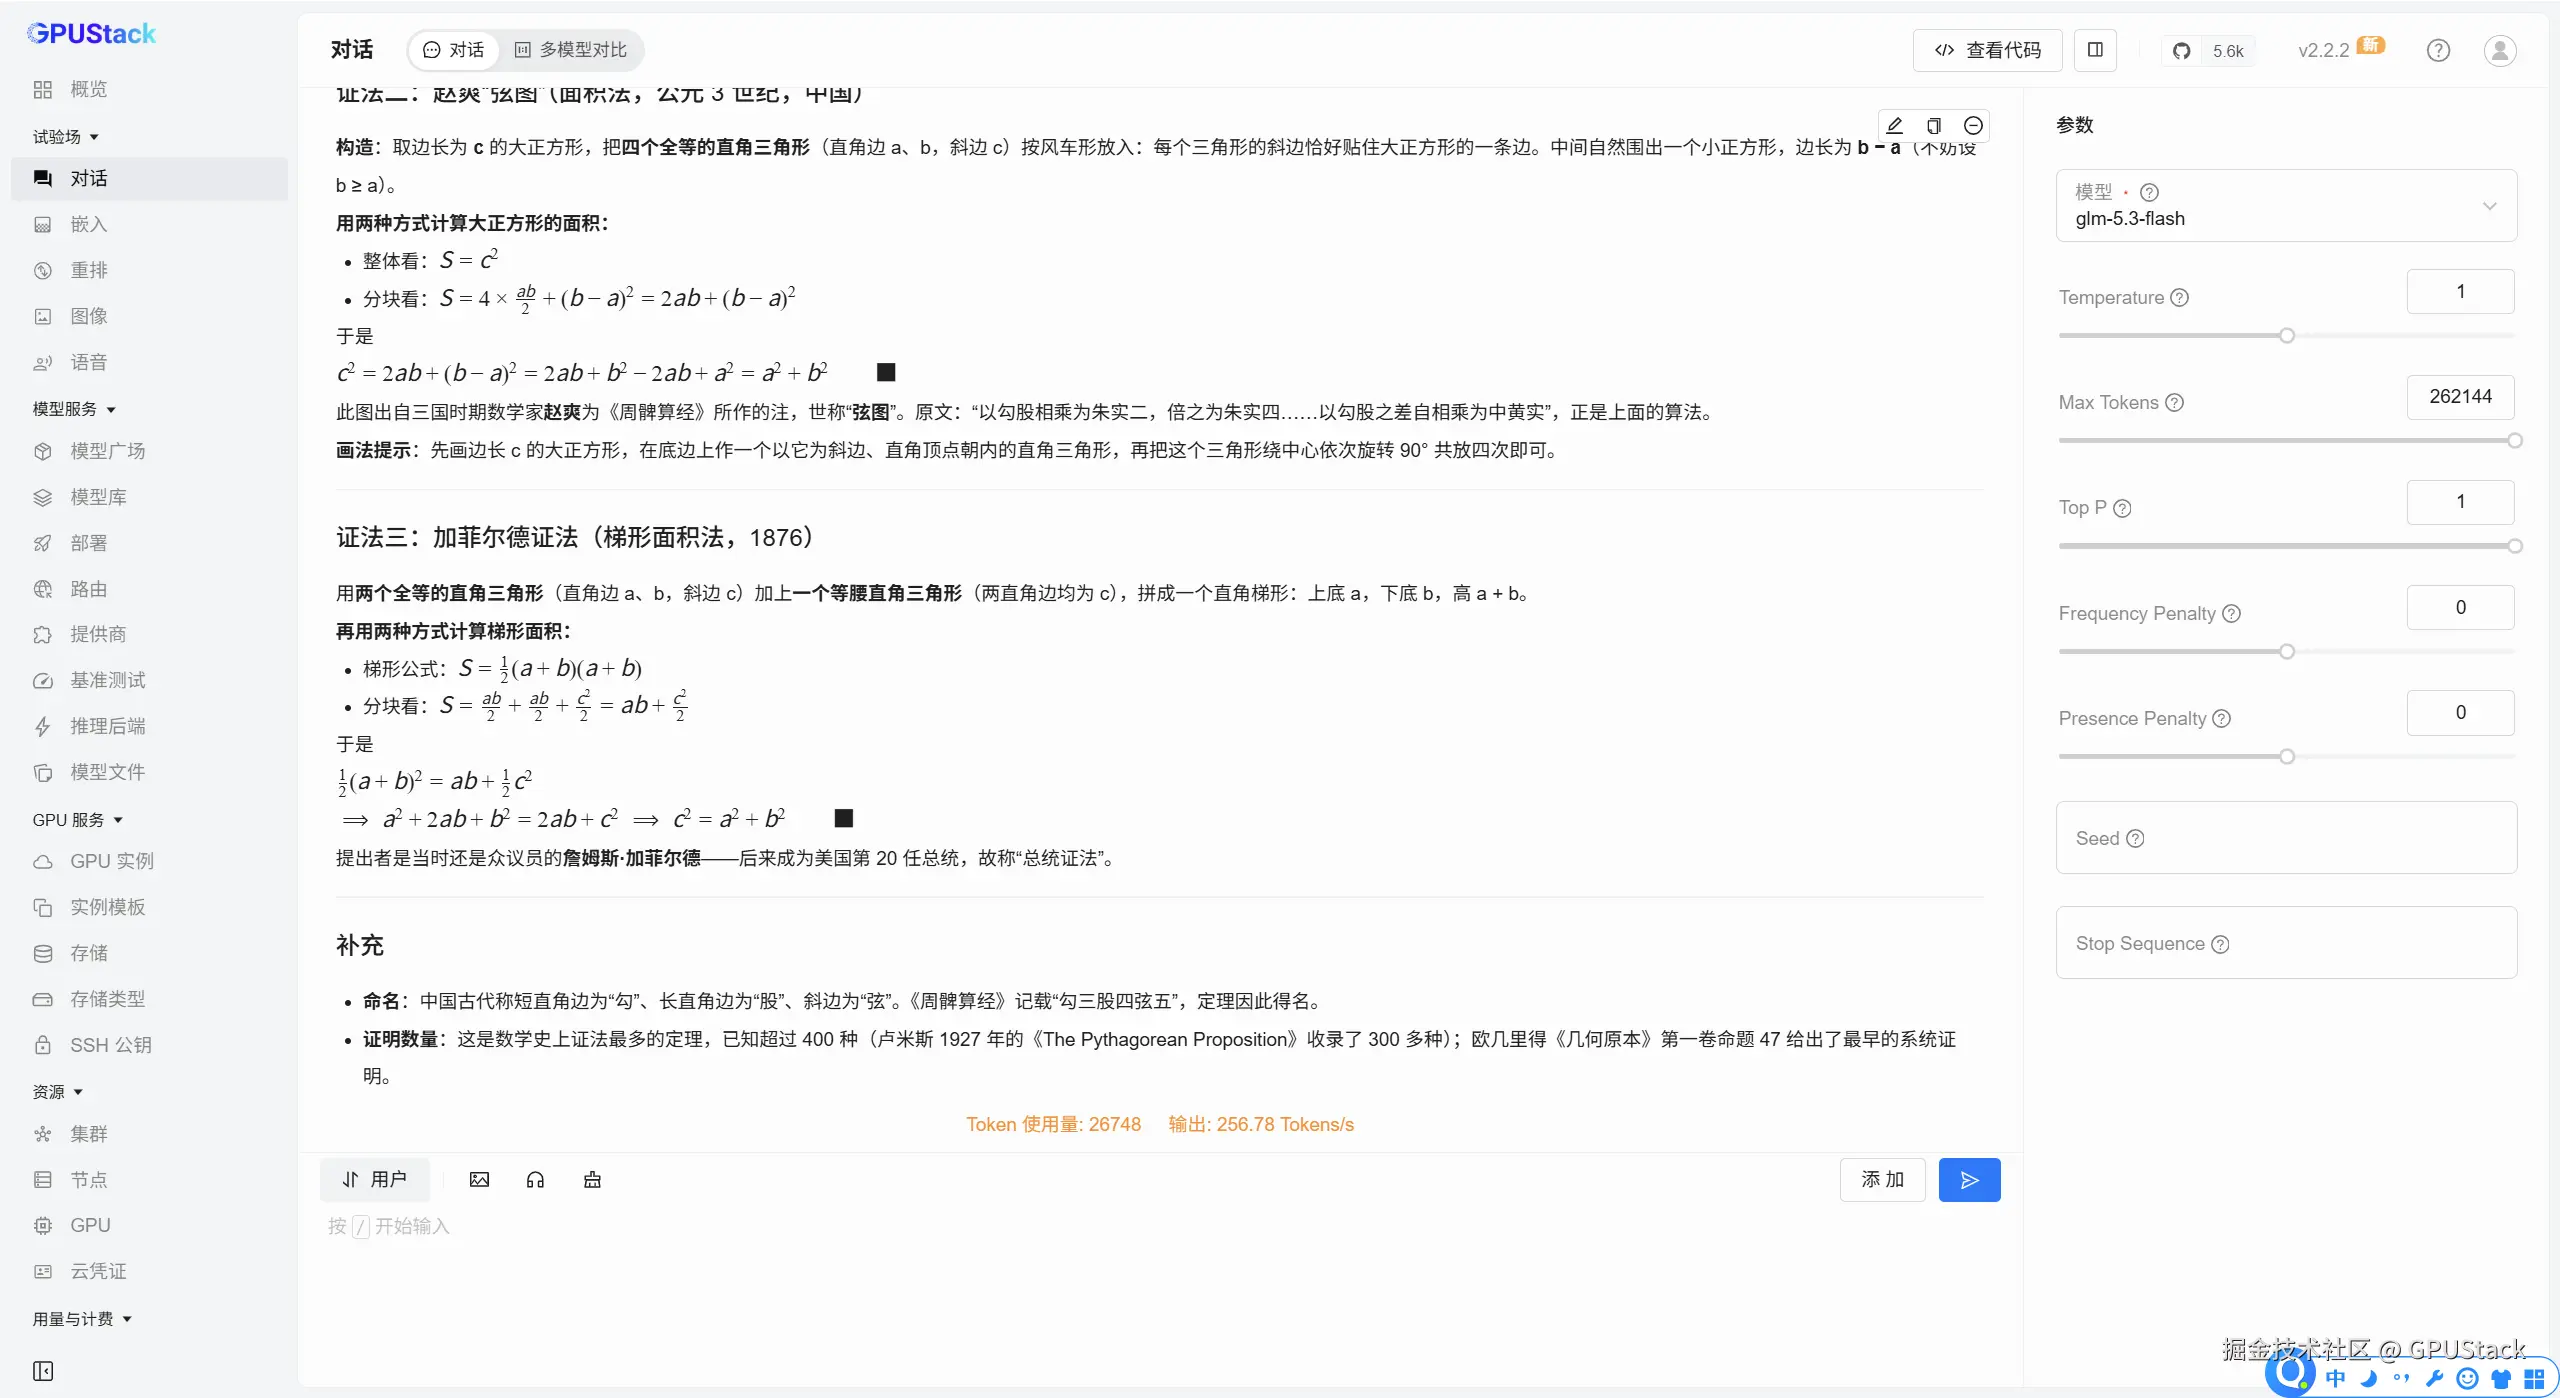
需要注意的是,GLM-5.3-Flash 的思考模式不可关闭,接口会把 reasoning_content 与正文分开返回,客户端拿到的是干净的回复文本------接自动化链路时记得按 reasoning 字段单独处理。
2. 多模态实测:让模型"看图干活"
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型,我们直接在 GPUStack 试验场里丢一张图试试。
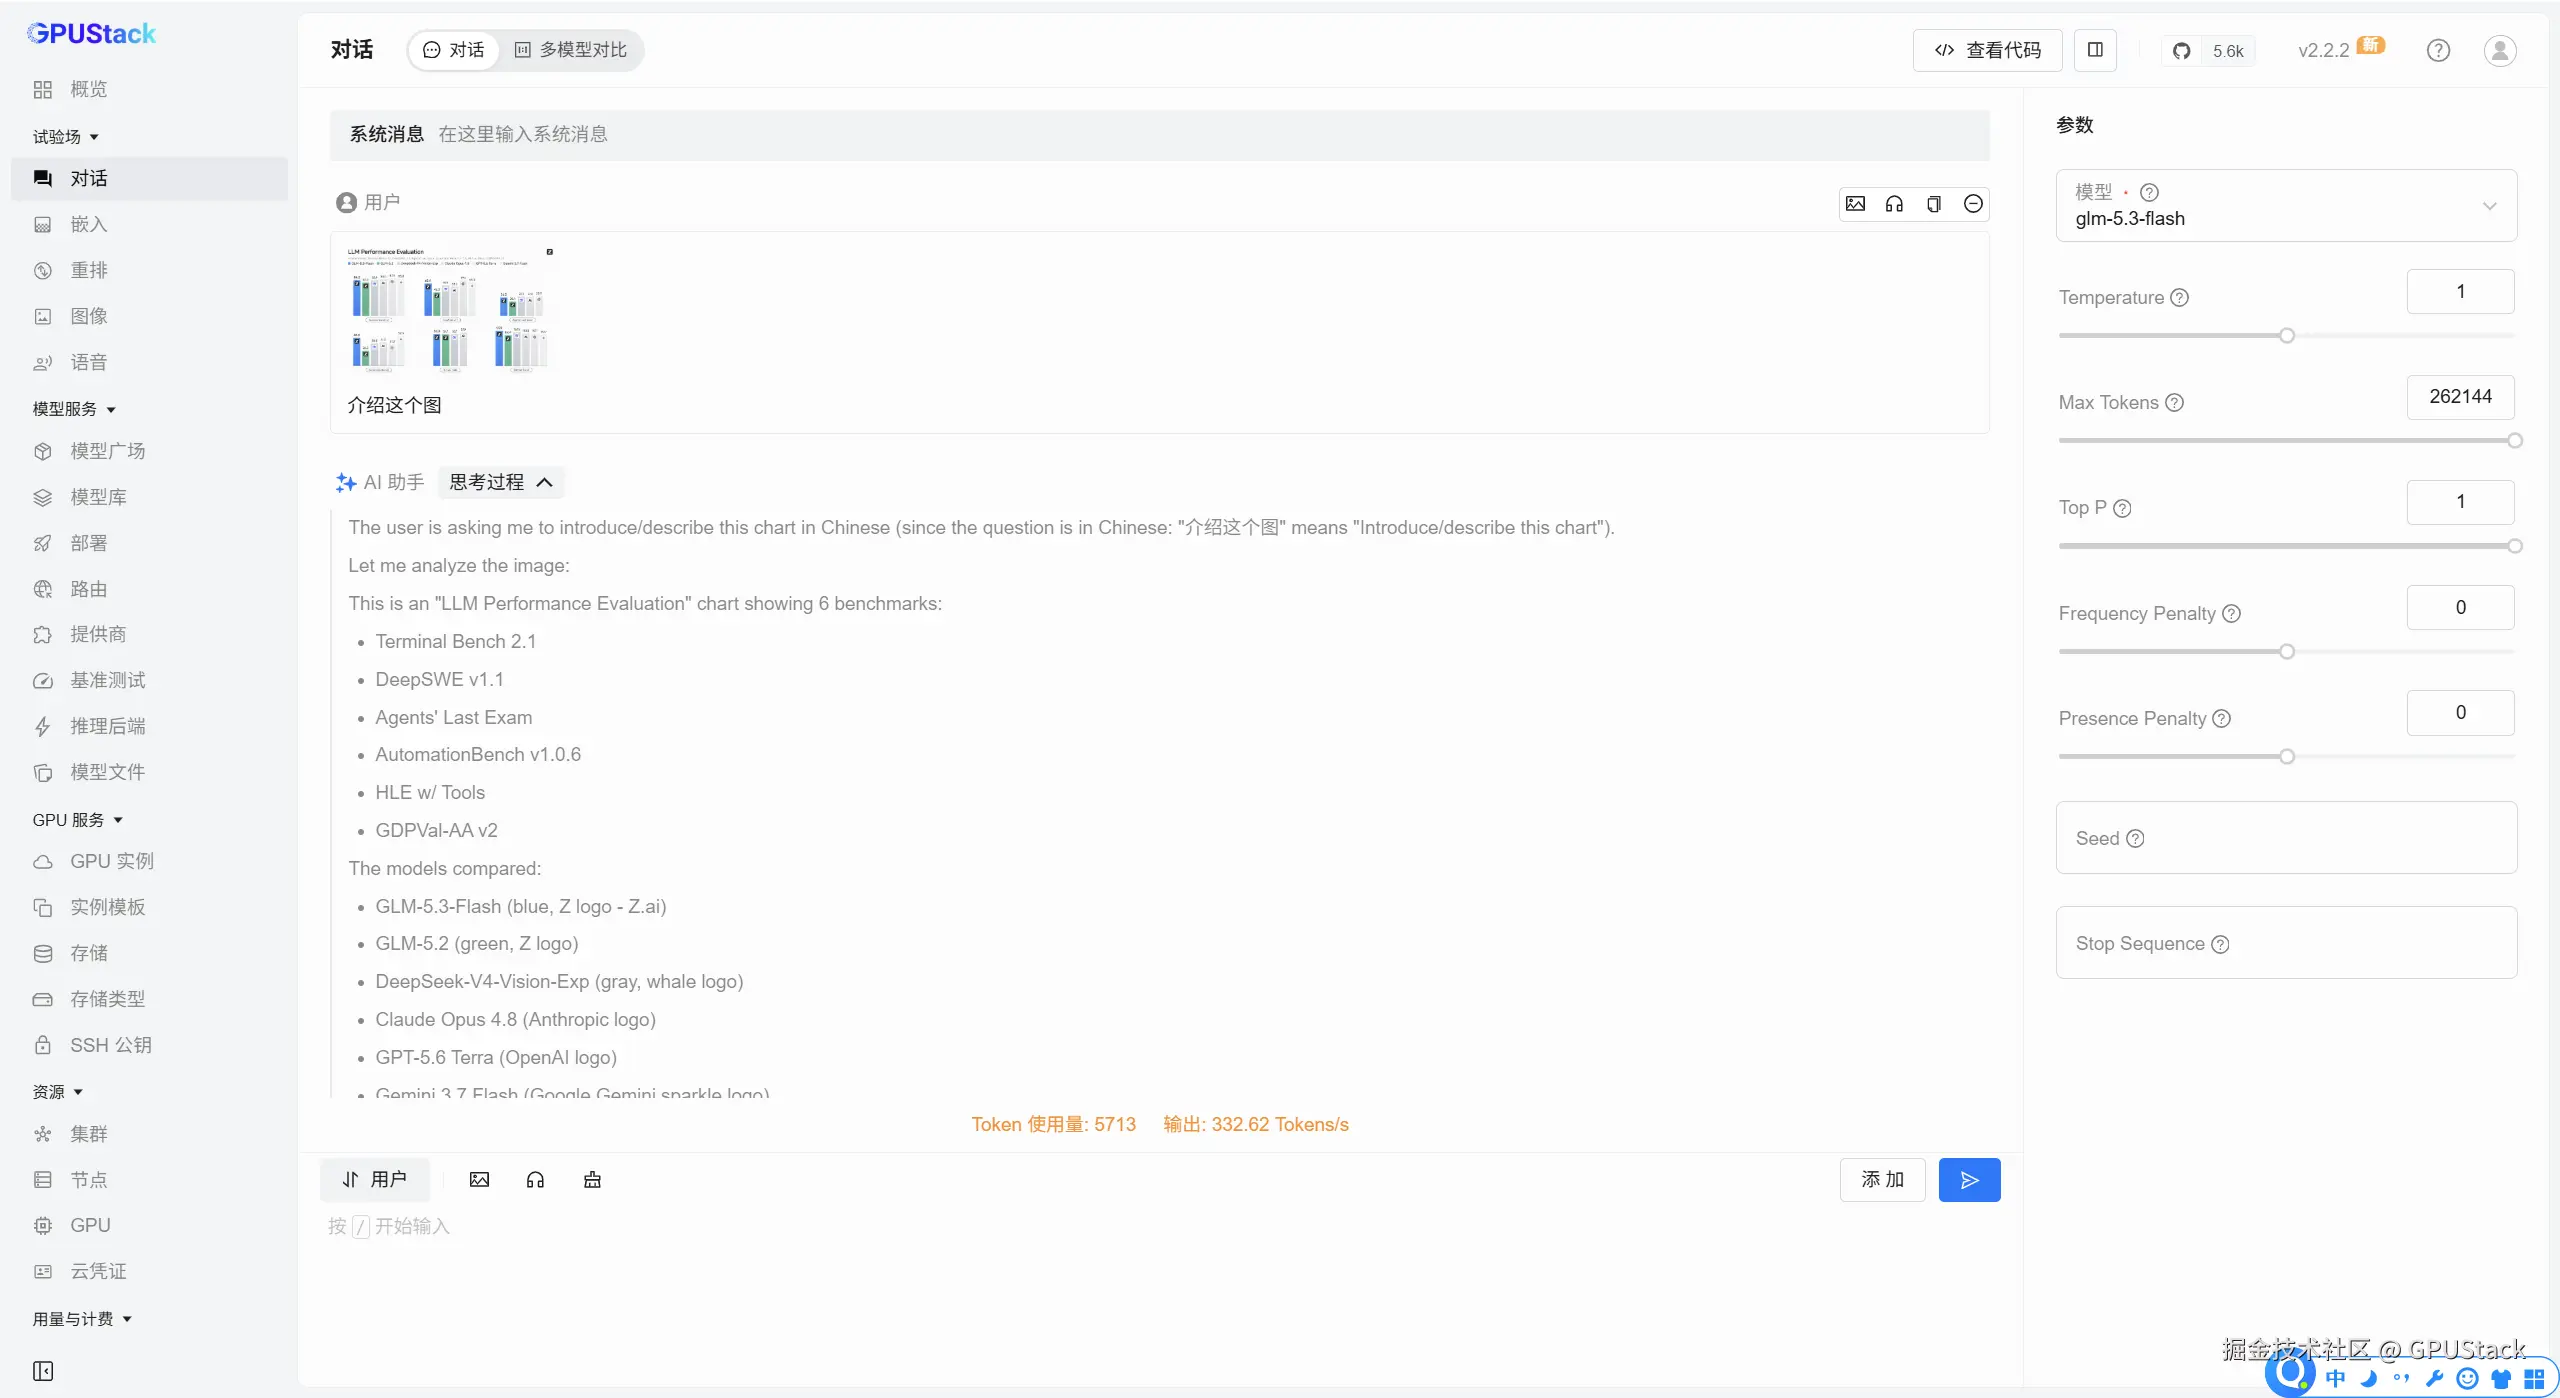
可以看到这个时候 GLM-5.3-Flash 就支持了识图。除了编码场景,这套视觉能力还能用于解读文档、电子表格、演示文稿、仪表盘等异构视觉信息,并直接基于视觉上下文评估自身输出的质量与美观度。
3. 基准测试
部署进入 Running 后,进入 GPUStack 基准测试 ,选中 GLM-5.3-Flash 模型,对模型的吞吐能力进行测试。
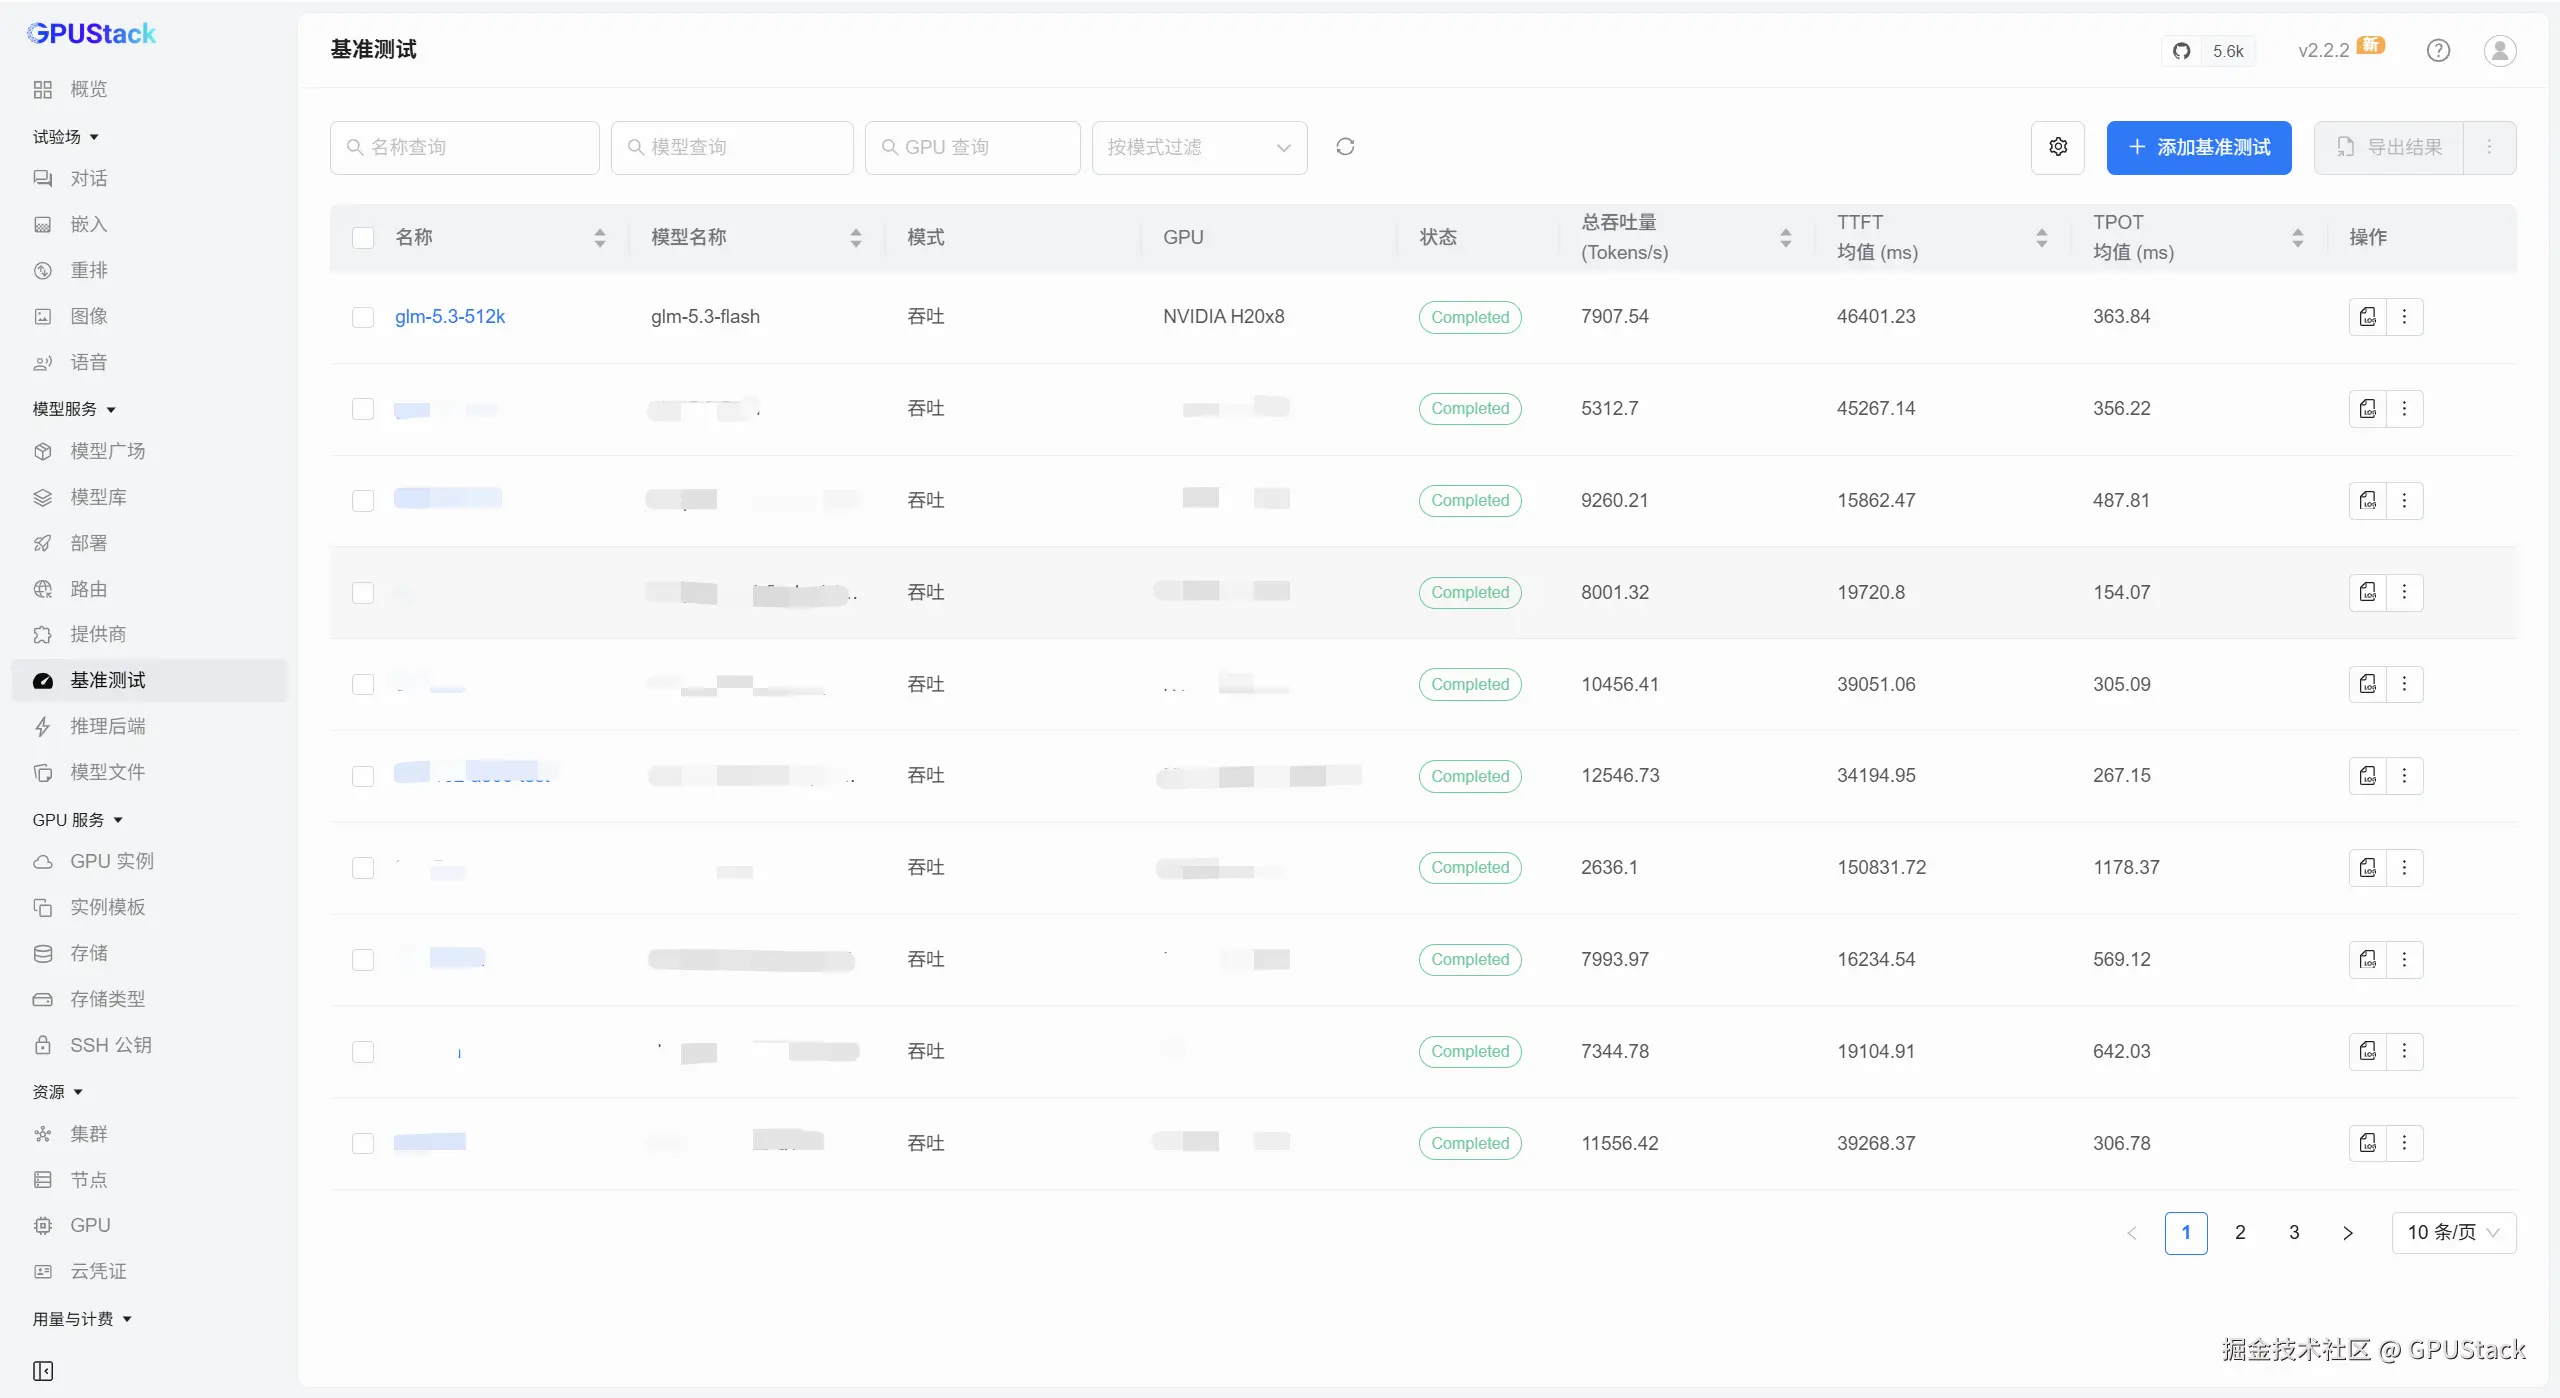
| 测试项 | 结果 |
|---|---|
| 测试环境 | 8 × NVIDIA H20-96G |
| 测试任务 | glm-5.3-512k |
| 总吞吐量 | 7907.54 Tokens/s |
| 平均首 Token 延迟(TTFT) | 46,401.23 ms(约 46.40 s) |
| 平均每 Token 延迟(TPOT) | 363.84 ms |
在名为 glm-5.3-512k 的测试中,8 张 H20 的总吞吐量达到 7907.54 Tokens/s 。由于测试面向超长上下文,平均 TTFT 约为 46.40 秒 ,TPOT 为 363.84 毫秒。这组数据可用于评估本文配置下的长上下文承载能力;不同的输入长度、输出长度和并发数会显著影响结果,因此不建议与其他测试直接横向对比。
总结
GLM-5.3-Flash 把「前沿智能」和「前沿价格」解绑了:320B 总参数只激活 18B,45 层的浅堆叠 + 稀疏/线性混合注意力,让它在 8 张卡上就能跑起来,却拿到了与 Claude Opus 4.8 持平的 AA 综合智能指数 57 分。加上 MIT 协议------商用、私有化、微调都没有障碍,还是原生多模态(文本 / 图像 / 视频)。
借助 GPUStack 可插拔的 vLLM 后端,这件事被压缩成了三步:添加一个官方专用镜像版本 → 选 ModelScope 仓库 → 填后端参数 。把 glm47 工具调用解析器、glm45 推理解析器打开之后,一个支持图文视频混合输入、带工具调用的 Agent 服务就跑起来了,试验场和 OpenAI 兼容接口都能直接用。
对做企业内部 MaaS 平台的团队来说,这是个很值得 Day 0 就拉起来做评测的模型------尤其是那些「要读截图、读图表、读 UI 才能完成任务」的场景,以及本身 token 量很大、对单价敏感的长程 Agent 任务。
实测参考环境:8 卡 H20-96G | Driver Version: 570.172.08 | CUDA Version: 12.8 | GPUStack v2.2.2 | vLLM 镜像
vllm/vllm-openai:glm53-flash注意:GLM-5.3-Flash 的模型代码尚未进入 vLLM numbered release,务必使用官方专用镜像;Hopper 架构上暂不支持 FP8 KV 缓存。