文本经过清洗、分片和向量化之后,还需要解决两个问题:用什么表示判断内容相关,以及怎样在大量资料中快速找到这些内容;整段语义、精确词项和 token 之间的细粒度关系,是不同的匹配信号;向量数据库与索引则决定这些信号如何被保存和检索
从 Dense、Sparse、BM25 到 ColBERT,再到近似最近邻和结构化索引,核心都是在信息保留、查询成本与知识组织之间取舍
一、Embedding 的多路输出
部分模型能够从同一段文本中产生多种表示;例如 bge-m3 同时支持稠密向量、稀疏词项权重与 ColBERT 式多向量输出,各路保留的信息并不相同
| 输出 | 表示形式 | 主要用途 |
|---|---|---|
| Dense | 每段文本一个固定维度向量;bge-m3 的稠密向量为 1024 维 | 匹配整体语义 |
| Sparse | 以词表位置为维度,只记录非零词项及权重 | 提供词项匹配信号 |
| ColBERT 式多向量 | 每个有效 token 保留一个向量 | 比较细粒度语义关系 |
稀疏表示的非零项数量随文本而变,50---200 项可以是一种文本规模下的示例,不能当成固定输出长度;多向量的维度也要以模型配置为准,不能把所有 ColBERT 模型都写成 1024 维;相关输出见 bge-m3 模型说明
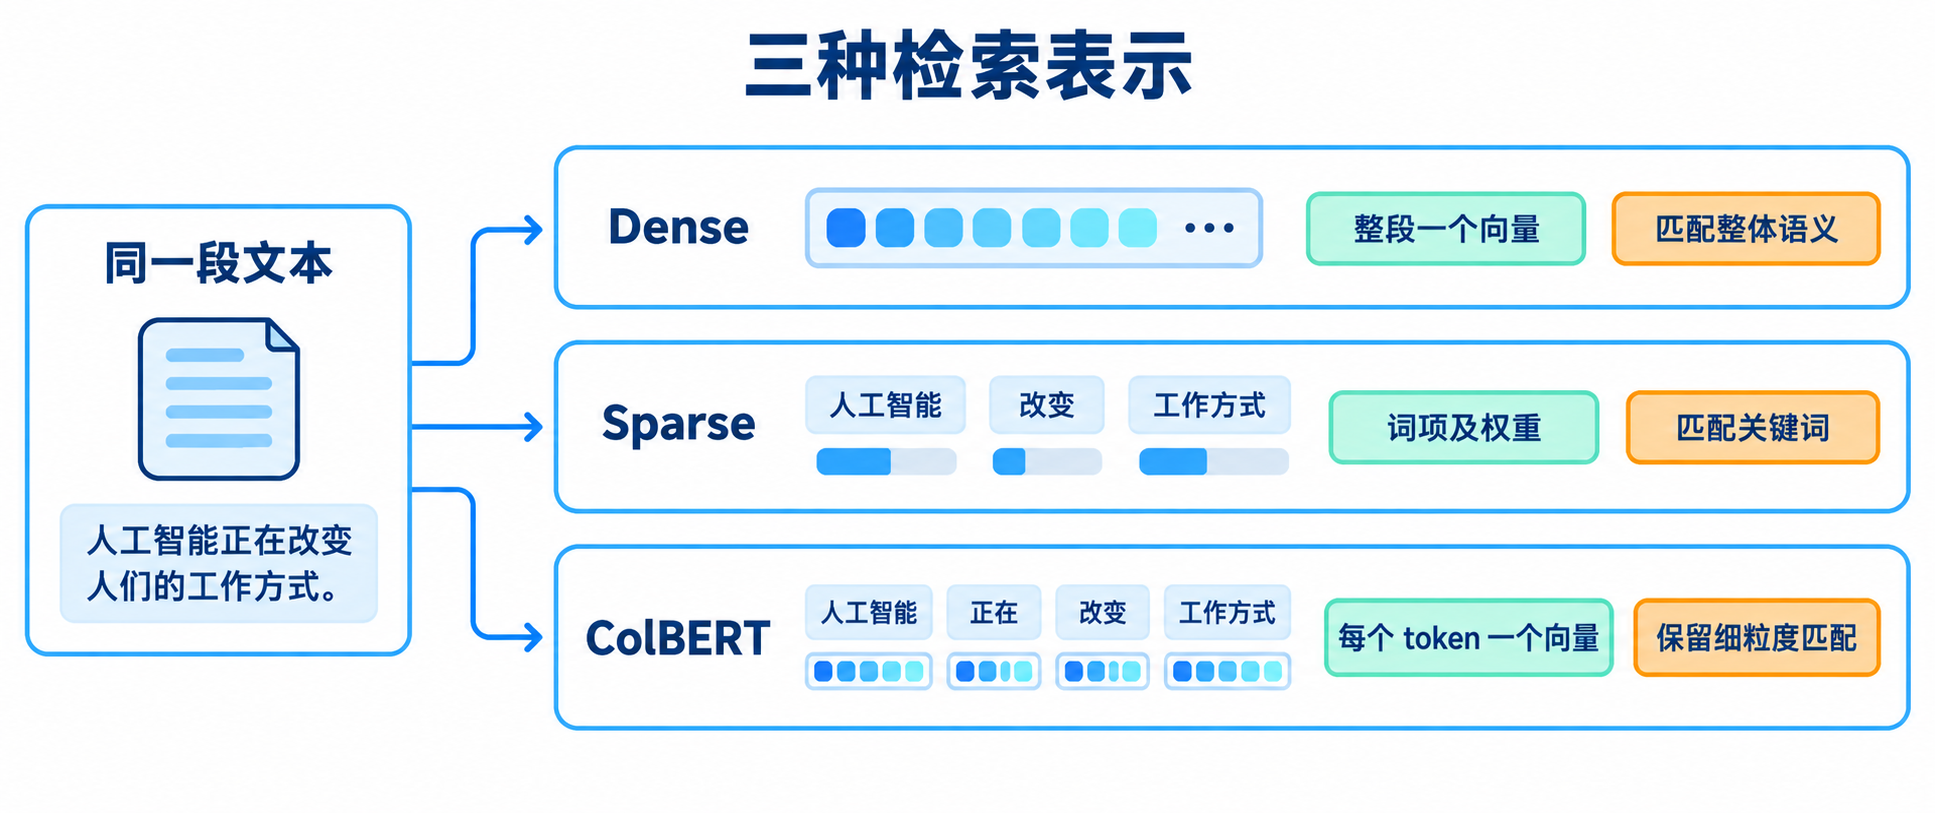
图中的词组与向量条用于示意,不代表某个 tokenizer 的实际切分或真实模型输出
Dense:把整段文本压缩成一个向量
从文本到向量:池化做了什么
Transformer 编码器通常先输出一个形状为 seq_len × hidden_dim 的矩阵;seq_len 是 tokenizer 实际产生的序列长度,hidden_dim 是每个 token 的表示维度;例如,序列有 512 个 token、隐藏维度为 1024,输出便是 512 × 1024
"如何部署 RAG 系统" 可以用四个词组来说明处理过程,但真实 token 数要由模型的 tokenizer 计算;中文词、英文缩写和空格都可能影响切分,不能直接把四个词组当成四个真实 token
要得到整段文本的单一向量,还需要池化:
- CLS 池化 :取特定起始位置的向量作为整段表示;它是否能有效汇聚语义,取决于模型的训练方式,而非只要存在
[CLS]就自动成立 - 平均池化:对有效 token 的表示求平均,通常需要排除 padding;它是另一种汇聚方式,不能笼统认为一定更稳定或完全不受位置影响
如果一段文本有 128 个 token,每个 token 为 1024 维,那么池化前有 128 × 1024 = 131072 个数值,池化后剩下 1024 个;这里的 128∶1 是表示元素数量之比,不是严格的信息量度量;它说明了 Dense 的取舍:整段表示便于检索,但 token 级匹配细节不再单独保存
例如,"如何部署系统" 可能匹配到没有相同措辞的 "安装步骤如下",因为两者语义接近;但查询 processPayment 函数 时,单靠整体语义可能把 "支付处理模块设计" 排在前面,却没有准确找出包含函数标识符的代码块
从向量到召回:相似度怎样计算
余弦相似度关注向量方向;欧氏距离同时受到方向与模长影响,二者适合哪一种场景,应依据模型训练时使用的度量判断;不能把向量模长直接解释为文本长度,也不能断言欧氏距离必然给出错误排序
先看点积;对于两个三维向量:
A = [0.12, -0.34, 0.56]
B = [0.10, -0.31, 0.52]

A · B = 0.12 × 0.10 + (-0.34) × (-0.31) + 0.56 × 0.52
      = 0.012 + 0.1054 + 0.2912
      = 0.4086
高维向量的算法相同,都是对应元素相乘后求和;余弦相似度再除以两个向量的模长乘积:
cos(A, B) = (A · B) / (|A| × |B|)

|A| = √(0.12² + (-0.34)² + 0.56²)
    = √0.4436 ≈ 0.6660

|B| = √(0.10² + (-0.31)² + 0.52²)
    = √0.3765 ≈ 0.6136

cos(A, B) ≈ 0.9998
cosine distance = 1 - cosine similarity ≈ 0.0002
模长是向量的几何长度,不是元素数量;余弦相似度的范围为 [-1, 1],1 表示方向一致,0 表示正交,-1 表示方向相反;相应的余弦距离 1 - cosine similarity 范围为 [0, 2],越小表示方向越接近;这些是几何含义,不能把 -1 直接等同于自然语言中的 "语义对立"
这里使用完整的三维示例计算结果;如果展示的是带省略号的高维向量,就不能仅用已展示的三个元素验证整条向量的相似度
使用 normalize_embeddings=True 等配置进行 L2 归一化后,非零向量的模长变为 1:
归一化后的余弦相似度 = 点积
归一化后的余弦距离 = 1 - 点积
这样可以直接使用点积比较方向,避免未归一化点积中模长对得分的影响;代价是丢弃模长所携带的信号,因此是否归一化应遵循模型的使用方式;对于单位向量,欧氏距离与余弦相似度也具有对应关系,可以产生相同的近邻排序
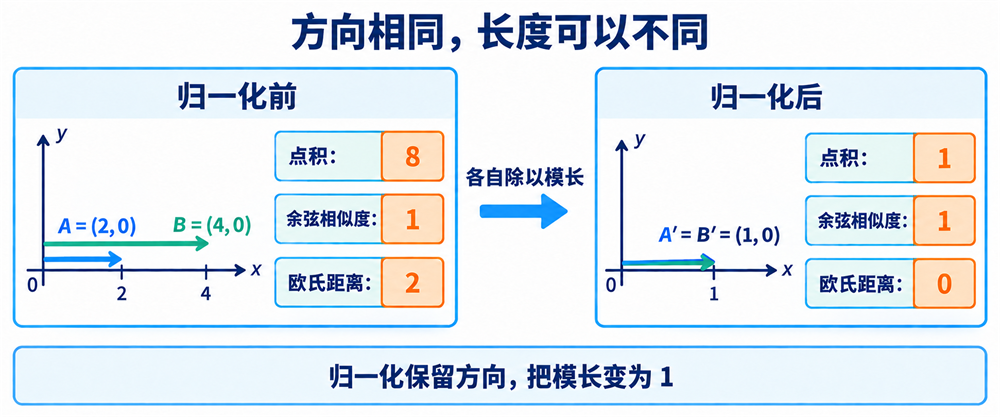
检索时,把问题编码为向量,与知识库向量比较,按距离从小到大取前 K 个,就是 Top-K 召回
| 方面 | Dense 的特点 |
|---|---|
| 语义匹配 | 能利用训练得到的语义关系,匹配 "部署" 和 "安装" 等不同表达 |
| 精确匹配 | 函数名、型号等精确标识符可能需要词项检索补充 |
| 可解释性 | 很难直接指出某一个词对最终相似度贡献多少 |
| 预计算 | 文档向量可以提前生成;查询时主要编码问题 |
| 查询成本 | 单次向量比较简单,但全库检索耗时还取决于数量、维度和索引 |
Sparse:为词项保留可检索的权重
Sparse 表示可以理解为一个很长、但绝大多数位置为零的向量;维度对应词表中的固定位置,只有部分词项携带权重;实际存储时可以保存 "词项 ID---权重" 对,而不必写出所有零
仍以 "如何部署 RAG 系统" 为例,用简化词项展示:
输入文本 → Tokenizer → 上下文编码 → 词项权重

词项       示例词表位置       示例权重
如何          1234             0.35
系统          2345             0.28
部署          5678             0.82
RAG           8901             0.91

稀疏表示:{1234: 0.35, 2345: 0.28, 5678: 0.82, 8901: 0.91}
这些位置和权重只是示意,不是实际词表记录或推理结果;对于约 25 万规模的词表,即使只保留少量非零项,仍然可以按词项位置进行比较
以 bge-m3 的词项权重思路看,编码器先得到每个 token 的上下文向量,再经线性映射和非负激活获得标量权重;重复词项还需要聚合;映射参数通过训练学习,因此同一个词在不同上下文中可能获得不同权重
例如,"部署" 比 "系统" 更能区分当前问题,"RAG" 也可能比 "如何" 更有用;Sparse 不必固定遵守这个排序,而是由模型根据上下文给出权重
需要区分 "词项权重包含上下文" 与" 不同词项可以直接匹配";bge-m3 的稀疏路以词项重合为基础,仅仅提高 "部署" 的权重,并不会自动让它和不同词表位置的 "安装" 产生点积;同样,多语言模型不意味着纯稀疏匹配自动获得任意跨语言对齐能力
BM25 与中文分词器:
神经词项权重与统计词项权重:
稀疏检索还有一条传统路径:BM25;它不需要通过神经网络生成词项权重,而是利用词频、文档频率和文档长度计算相关性
TF-IDF 的直觉是:一个词在当前文档中越常见、在整个语料库中越少见,就越能代表这篇文档;使用原始词频的简单版本会受到词频线性增长和文档长度的影响;BM25 则在稀有词加权之外,引入词频饱和与长度校正;不同 TF-IDF 实现也可能使用对数词频和归一化,不能把这些局限概括为所有 TF-IDF 的必然行为
| 比较项 | Sparse embedding | BM25 |
|---|---|---|
| 权重来源 | 模型学习到的上下文权重 | 语料统计与评分公式 |
| 查询端 | 需要模型编码;与 Dense 同时使用时可能共享编码器计算 | 分词与查索引,不需要神经模型推理 |
| 可解释性 | 能查看词项权重,但权重来源仍依赖模型 | 可以分解 IDF、词频和长度项 |
| 索引维护 | 同步更新词项记录及对应文档 | 同步更新倒排记录、文档频率、长度等统计 |
| 精确匹配 | 受词表切分和词项重合影响 | 受分析器和分词结果影响 |
| 多语言 | 依赖模型词表与训练,不保证跨词项匹配 | 需要适合语言的分词或分析策略 |
例如,神经稀疏表示可以给出 {部署: 0.82, 系统: 0.28},BM25 则依据对应词的 IDF、出现次数和文档长度计算贡献;二者的数值来源不同,不能直接比较大小
BM25 公式与参数:
一种常见的 BM25 形式为:
BM25(q, d) = Σ_i IDF(q_i) ×
             [f(q_i, d) × (k1 + 1)] /
             [f(q_i, d) + k1 × (1 - b + b × |d| / avgdl)]
其中 f(q_i, d) 是查询词在文档中的出现次数,|d| 是文档长度,avgdl 是语料中的平均文档长度
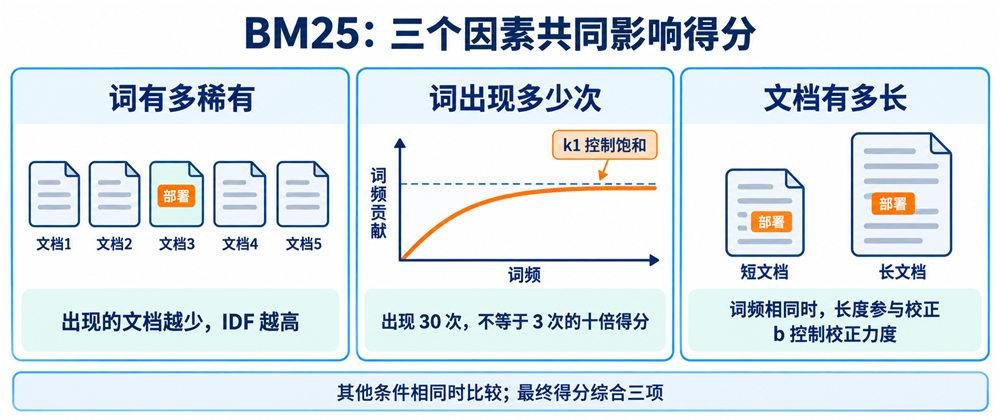
IDF 控制词的区分度 ;设总文档数为 N,包含该词的文档数为 df,经典形式之一是:
IDF(q_i) = ln[(N - df(q_i) + 0.5) / (df(q_i) + 0.5)]这个版本在 df > N/2 时会出现负值,因此不能据此说 "所有文档都包含某词时,IDF 接近零";Lucene 使用带 1 + 的非负形式,高频词在这一形式下才会获得接近零的权重:
IDF(q_i) = ln[1 + (N - df(q_i) + 0.5) / (df(q_i) + 0.5)]k1 控制词频饱和 ;某词出现 3 次可能说明相关,出现 30 次却不意味着相关性变为十倍;k1=0 时,命中词不再因重复出现而继续增加词频得分;取 1.2 或 2.0 会形成不同的饱和曲线,较大的值允许词频继续发挥更大作用
b 控制文档长度校正 ;b=0 忽略长度,b=1 完全使用公式中的长度比校正;Lucene 的默认值为 k1=1.2、b=0.75;当 chunk 长度都接近 512 token 时,长度差异较小,b 的影响可能减弱;公式与默认值见 Lucene BM25Similarity 文档
停用词与中文分词:
"的、了、在、是" 等高频词可以通过停用词表处理;中文停用词集合 收录了多个来源的词表,包括常被称作哈工大、百度停用词表的版本;使用时仍要检查过滤规则是否伤害实际查询
低频词同样需要结合业务判断;不能统一过滤 df < 2 的词,因为只出现一次的函数名、产品型号或错误码,可能恰好是最关键的检索线索
中文词语之间没有天然空格;如果文档侧把一个术语切成两部分,查询侧却保留成一个词,倒排索引就可能无法按预期命中
| 分词器 | 特点与适用方向 | 安装命令 |
|---|---|---|
| jieba | 精确、全模式与搜索模式;支持关键词提取和词性标注,适合通用项目 | pip install jieba |
| pkuseg | 支持不同领域分词模型,可用于专业资料对照评估 | pip install pkuseg |
| thulac | 中文分词与词性标注,可用于相关研究与应用 | pip install thulac |
| HanLP | 分词之外还提供命名实体识别、依存分析等 NLP 能力 | pip install hanlp |
| LAC | 提供词法分析能力,可评估其领域适应性与运行成本 | pip install lac |
可以先用 jieba 建立基线,再观察专有名词、复合词和领域术语是否被正确切分;当分词误差已经影响召回时,再比较其他分词器;"准确率提高 5%---10%" 或 "某工具一定更慢" 都必须对应具体语料与运行环境
ColBERT:在 token 层面进行延迟交互
Dense 把文本汇聚为单一向量;Cross-encoder 则把问题和文档放在一起编码,直接计算两者的交互关系;ColBERT 采用另一种折中:分别编码问题与文档,保留 token 级向量,在评分时才进行交互
文档 token 向量可以提前计算;查询到来后,对查询中的每个 token,寻找文档中与它最相似的 token,再汇总这些最佳匹配,这就是 MaxSim:
Score(q, d) = Σ_i max_j (q_i · d_j)用 "如何/部署/系统" 作为查询词项,"安装/步骤/如下/配置/环境" 作为文档词项,可以得到下面这组示例相似度:
| 查询词项 | 安装 | 步骤 | 如下 | 配置 | 环境 | 最大值 |
|---|---|---|---|---|---|---|
| 如何 | 0.21 | 0.15 | 0.18 | 0.12 | 0.09 | 0.21 |
| 部署 | 0.85 | 0.42 | 0.31 | 0.78 | 0.65 | 0.85 |
| 系统 | 0.33 | 0.28 | 0.45 | 0.51 | 0.37 | 0.51 |
第一行选择 0.21,第二行选择 0.85,第三行选择 0.51,总分为 0.21 + 0.85 + 0.51 = 1.57;每个查询 token 都有机会找到自己的最佳匹配,不必依赖整段池化后的单一表示;这些数字用于解释计算过程,并非模型实测结果
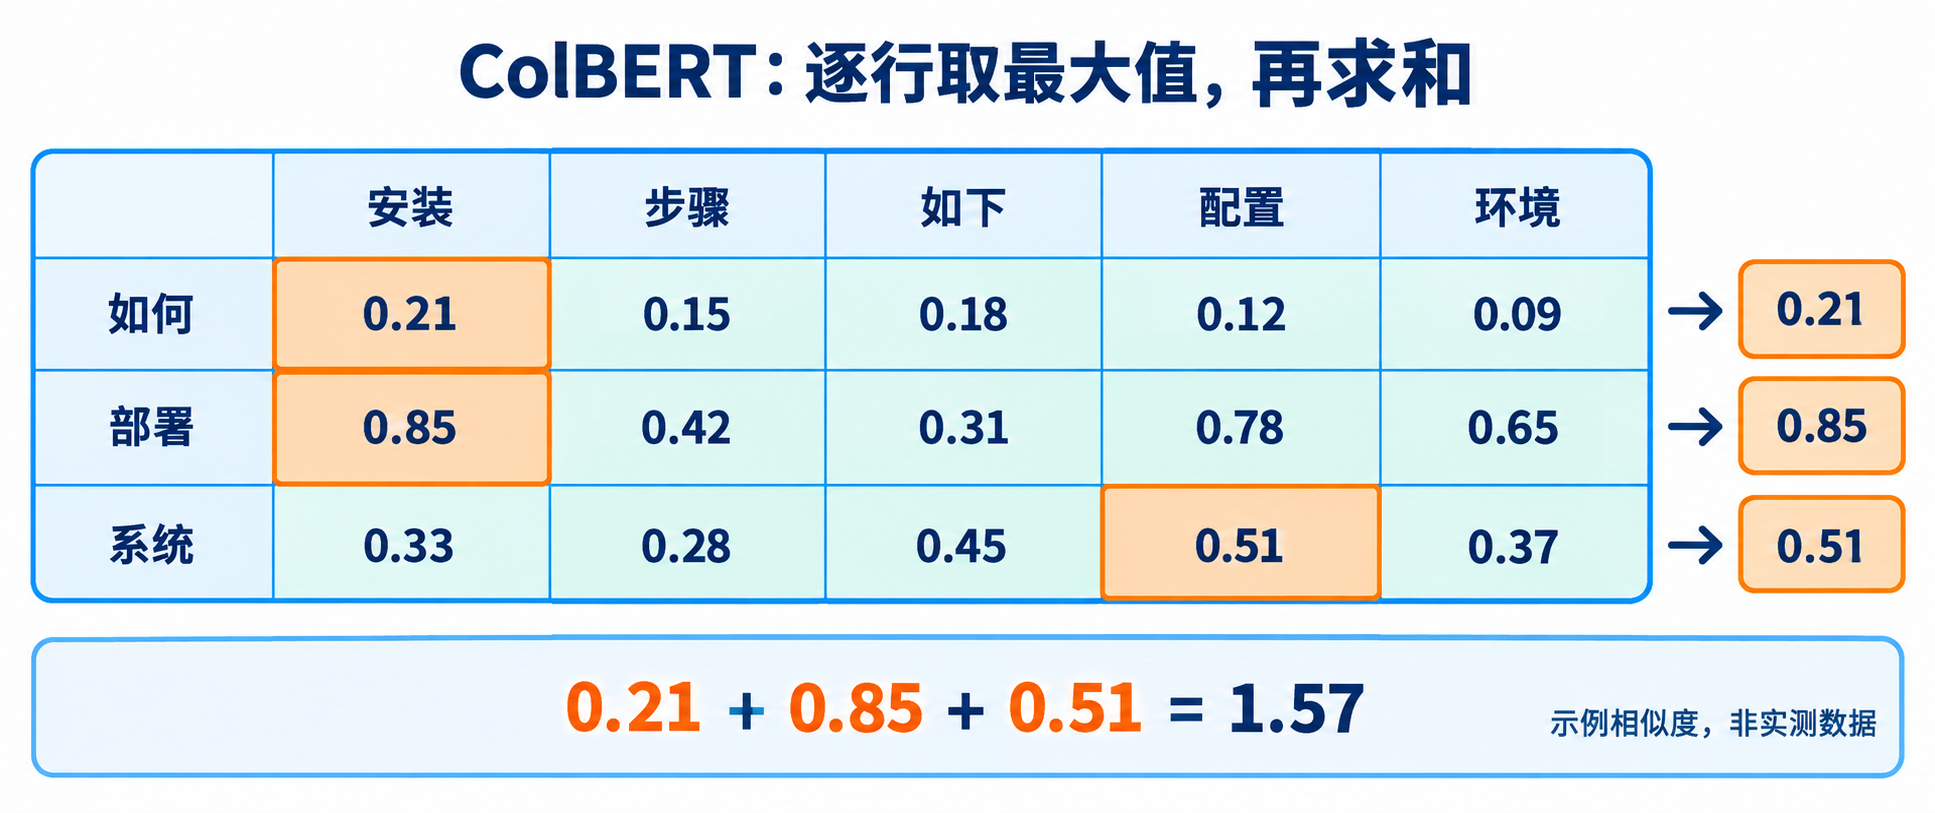
不同实现可能对 MaxSim 求和或做长度归一化;例如,FlagEmbedding 的 colbert_score 对逐行最大值求和后,还会除以查询向量数;按上面的三个查询向量计算,对应为 1.57 / 3 ≈ 0.5233,因此不能默认接口返回值与求和示例一致;参见 FlagEmbedding 评分实现
多向量的成本也更高;假设每个向量为 1024 维 FP32,一个向量约 4 KiB,128 个向量便约 512 KiB,原始向量存储比单向量多 128 倍;实际索引还受投影维度、压缩与结构开销影响,因此不能把 "10---50 倍" 视为固定比例
| 方面 | Dense | ColBERT 式多向量 |
|---|---|---|
| 表示 | 每段一个向量 | 每段多个 token 向量 |
| 文档预计算 | 可以 | 可以 |
| 评分 | 比较整段表示 | 聚合 token 之间的最佳匹配 |
| 主要资源压力 | 向量总量和近邻搜索 | 更多向量的存储、读取与交互计算 |
| 使用方向 | 大规模语义召回的基础方案 | 细粒度检索或候选重评分 |
不能把 Cross-encoder、ColBERT、Sparse、Dense 排成固定的质量与速度排行榜;尤其不能把 "一对向量的点积时间" 与 "一次完整模型编码时间" 直接比较;是否值得引入多向量检索,要用相同硬件、语料、候选规模和评估口径判断
三路表示如何组合:
可以先建立 Dense + Sparse,或 Dense + BM25 的混合召回;Dense 负责 "如何部署" 与 "安装步骤" 之间的语义匹配,词项路补充 processPayment 等标识符的匹配信号,再通过 RRF 等方法融合结果
BM25 的查询端不需要神经模型编码;神经稀疏权重需要模型计算,但若与 Dense 共享一次编码器前向过程,不能把它简单算作再完整运行一次模型;额外成本要区分共享编码、输出头和索引查询
ColBERT 可以按需引入;语料较小、细粒度错误突出、资源较充足时,可以用它做对照实验;"少于 1 万个 chunk" 只是方便起步的规模示例,不是算法的适用上限;另一条常用路径是混合召回后再使用 Cross-encoder 精排,以候选筛选控制交互计算量
二、写入向量库:存储架构与数据库选型
向量数据库的作用与分类:
当向量从几百个增加到百万甚至更大规模,逐个比较的成本会不断增加;普通结构化索引擅长 WHERE age = 25 这类条件,却不能直接解决高维空间中的近邻查找
向量数据库除了保存向量,还需要管理文本标识、元数据与查询能力;HNSW、IVF 等索引让系统能够减少搜索范围,用近似结果换取效率;它们不意味着任何规模和过滤条件下都能保证毫秒级响应
常见索引思路包括:
- 树结构:例如 Annoy,通过空间划分缩小候选范围
- 哈希:例如 LSH,把相近对象尽量放入相同的桶
- 邻近图:例如 HNSW,沿图中的连接寻找更接近查询的节点
- 聚类与量化:IVF 先划分搜索区域,PQ 则压缩向量表示;两者可以组合,但并非同一个操作
主流向量存储方案:
| 方案 | 主要特点 | 适合考察的场景 |
|---|---|---|
| Pinecone | 托管向量服务 | 希望减少自建运维的应用 |
| Milvus | 开源分布式向量系统,提供多种索引选择 | 大规模向量管理与检索 |
| Qdrant | Rust 实现,提供过滤与量化相关能力 | 需要向量检索与元数据过滤的应用 |
| Weaviate | 向量数据库与检索集成能力 | 需要多种检索和模型集成的项目 |
| Chroma | 便于从本地开发起步 | 原型、实验与小型应用 |
| FAISS | 相似性搜索算法库,不是完整数据库 | 本地实验、自行构建检索服务 |
| pgvector | PostgreSQL 的向量扩展 | 希望结合 SQL、事务与现有业务数据 |
原型可以从 Chroma 或 FAISS 开始;需要分布式管理和更高并发时,再评估专用服务;已经使用 PostgreSQL 的项目,可以先评估 pgvector,让向量与业务记录共享事务和 SQL 过滤能力
10 万、百万或千万向量都可以作为压测规模,但不能作为切换产品的固定门槛;同样,SLA、低于 100 ms 的延迟或每秒 4000 次请求,需要对应具体服务条款或测试条件;选择时应同时比较查询负载、过滤需求、运维成本与事务一致性
ANN 索引:HNSW、IVF 与 Annoy
为什么需要近似最近邻
暴力搜索会计算查询与全部文档向量的距离,再取 Top-K;它可以作为精确检索基线,但耗时随数据量与维度增加,还受到硬件和批处理方式影响;"10 万条约 100 ms、百万条约 1 秒" 只能是特定环境的示例
ANN,即近似最近邻,用索引限制需要访问的候选,允许一定的近邻召回损失以换取速度;这里的召回率通常是相对精确近邻结果而言,不能直接等同于业务问题的答案召回率
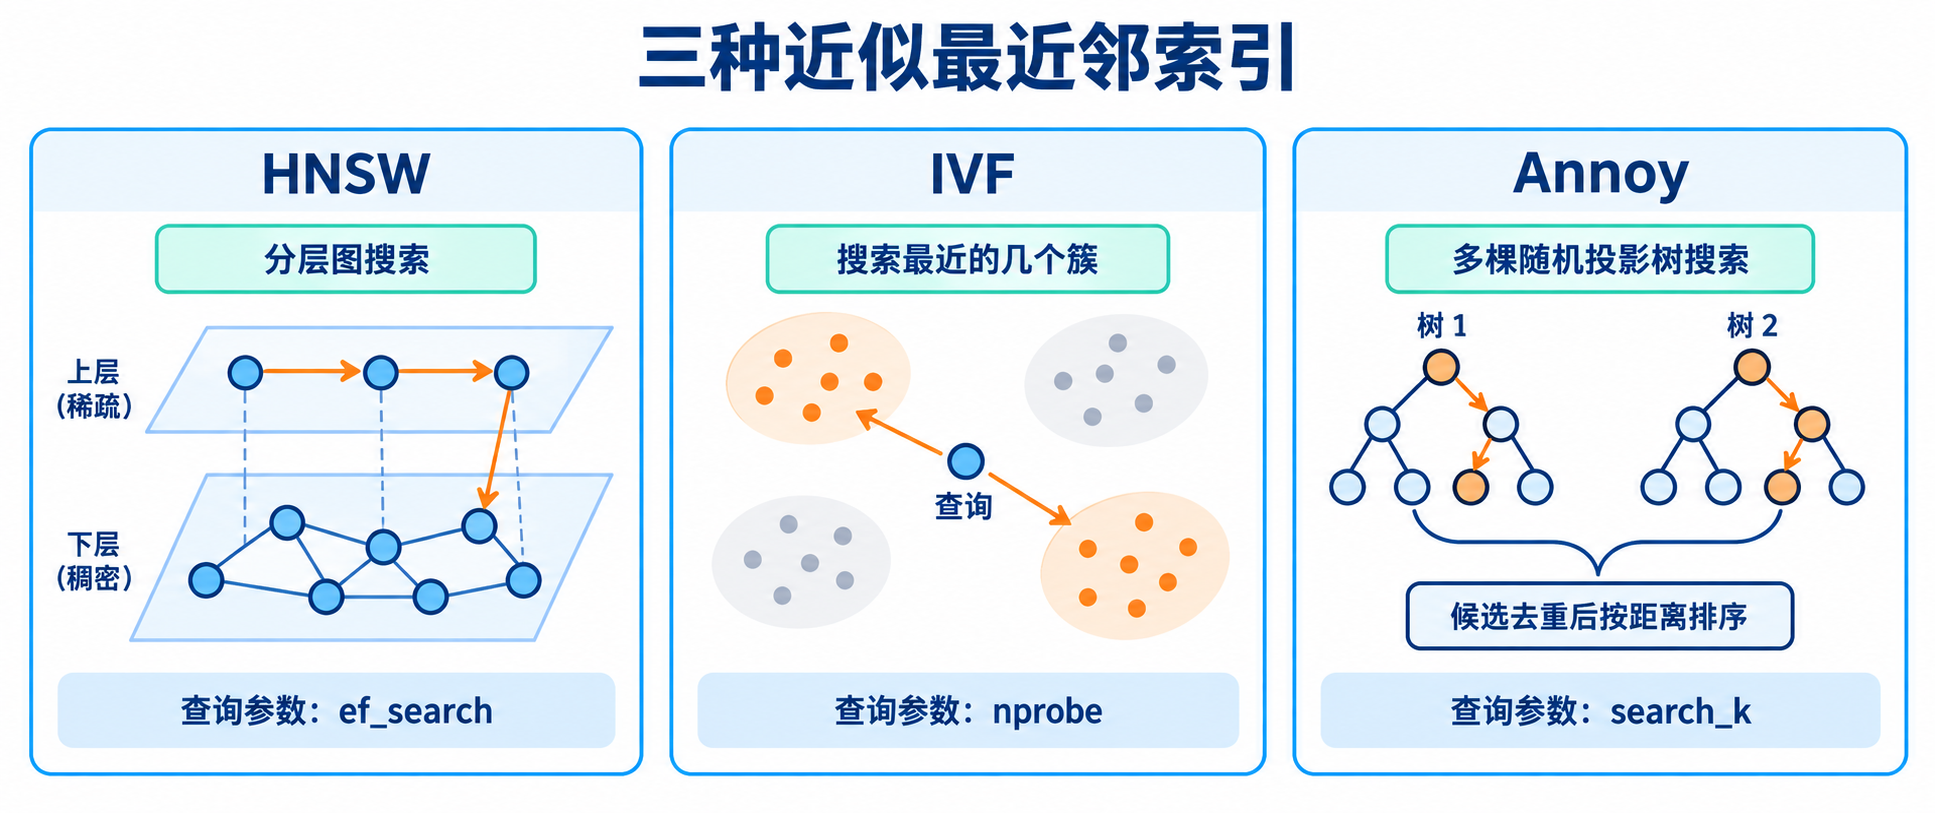
HNSW:沿分层邻近图逐步搜索
HNSW 构建多层邻近图,上层节点少,底层包含全部节点;查询从上层入口开始,寻找更接近查询的邻居,再逐层下降;可以把它想象成先看全国地图定位区域,再看城市与街道地图缩小范围
插入新向量时,系统先确定它参与的层级,从高层搜索入口,在相关层寻找候选邻居,选择连接并修剪邻接列表;邻居选择并不只是机械保留最近的 m 个点,还可能使用启发式策略维持图的可导航性
三个关键参数分别控制连接密度、建图搜索和查询搜索:
| 参数 | 作用 | 调大后的主要代价 |
|---|---|---|
m 或 M |
控制图连接数量 | 更多边带来存储与构建开销 |
ef_construction |
控制建图时的候选搜索宽度 | 构建时间增加 |
ef_search,部分库称 ef |
控制查询时的候选搜索宽度 | 查询耗时增加 |
可以用 m=16 开始对照,也可以比较 8、32 等配置;具体层的最大邻居数由实现决定,不能保证所有层都恰好受 m 条边限制;调整 m 和建图策略通常需要重建索引,而查询搜索宽度一般可以运行时调整
ef_construction 可比较 48---200 等范围,但 "64 是默认值" 必须指明使用哪个数据库;查询侧可比较 40、100、200,观察召回和延迟是否值得交换;没有通用的 "增加不到 2 ms" 保证,也不能预设这些配置必然对应 88%、95%、97% 的召回率
尤其要注意,不存在 ef_search ≤ ef_construction 的通用约束 ;hnswlib 的查询 ef 至少应覆盖请求的邻居数 k,可以大于构建时的搜索宽度;参数说明见 hnswlib 文档
IVF:先分簇,再搜索附近的簇
IVF 通过聚类把向量分配到多个列表;查询时先选择最近的几个簇,再在这些簇内搜索,从而避免遍历全部向量
例如有四个簇,查询位于簇 1 与簇 2 附近;当 nprobe=2 时,只搜索这两个簇,暂不访问簇 3、簇 4;如果真正的近邻被分到未访问的簇,就可能漏掉,因此搜索更多簇通常能够提高近邻召回
- nlist:簇或倒排列表的数量;修改它通常需要重新训练和构建索引
- nprobe:查询时访问多少个簇;通常可以运行时调整,值越大,计算范围越广
√N 或 N/100 可以作为某些实现讨论簇数的经验量级,但不构成通用上下界;IVF 完成训练后也可以添加向量,只有分布变化较大时才需要评估重新训练;在 FAISS 中还可以结合 PQ 压缩向量,具体结构见 FAISS 索引说明
Annoy:多棵随机投影树寻找候选
Annoy 使用随机投影树逐步划分空间;查询从树根根据划分进入相应区域,直到得到较小的候选集合;单棵树可能把近邻分到不同区域,因此通过多棵树扩大找到候选的机会
例如,一棵树把查询定位到包含 A、B 的区域,另一棵树可能再提供 C;系统合并并去重候选,最后按距离选择近邻;最终排序不是按候选在多棵树中出现的次数投票
它的两个主要参数是 n_trees 和 search_k;前者影响树的数量与索引构建成本,可以比较 50---100 等配置;后者控制查询时检查的节点数量,在速度与召回之间取舍;search_k=-1 表示采用默认预算,通常为 n_trees × 请求近邻数,并不表示遍历所有叶子
Annoy 的一个特点是只读索引文件可以通过 mmap 映射,多进程共享同一份索引;因此适合更新较少、读取较多的场景;构建完成后不能直接继续添加数据,新数据需要重建并发布新的索引版本;这些行为见 Annoy 文档
三种索引如何取舍:
| 方面 | HNSW | IVF | Annoy |
|---|---|---|---|
| 核心结构 | 多层邻近图 | 聚类与倒排列表 | 多棵空间划分树 |
| 查询预算 | ef_search |
nprobe |
search_k |
| 主要额外开销 | 图的连接信息 | 聚类训练与列表管理 | 多棵树的构建和存储 |
| 数据更新 | 通常支持增量插入 | 训练后可追加,分布变化需关注 | 构建后只读,更新需重建 |
| 典型考虑 | 增量更新与较高近邻召回 | 大规模分区检索,可结合压缩 | 静态索引、多进程文件共享 |
频繁更新的知识库可以优先评估 HNSW;大规模数据与压缩需求可以考察 IVF;按周或按月更新、需要共享静态索引时,可以考察 Annoy;实际内存和速度还取决于具体实现,mmap 也不代表索引无需物理内存
HNSW 与 WHERE 过滤:为什么结果可能不足
实际业务往往只搜索指定目录、租户或未归档资料;如果先在全量图中搜索,再过滤候选,原本找到的近邻可能大部分被排除,最终返回数少于 LIMIT
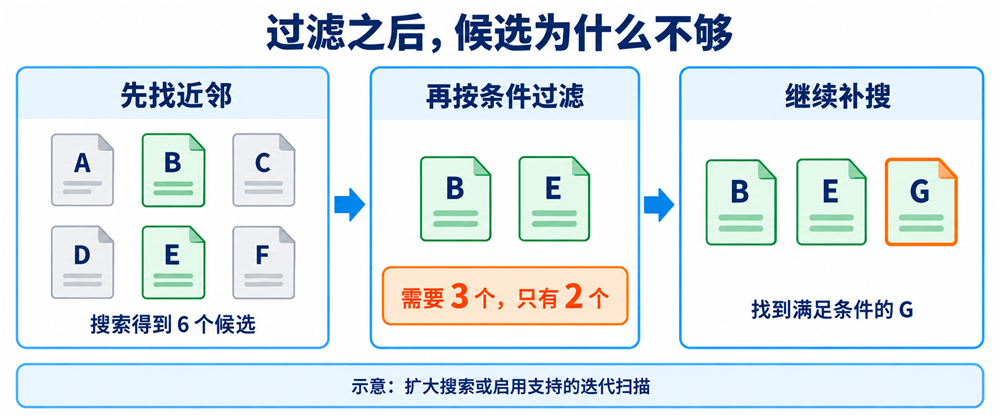
过滤后只剩几十个候选时,直接计算这些候选的距离可能比走 ANN 更合适;但是否会自动选择这种计划,取决于数据库优化器,而不是所有向量系统共有的行为
遇到结果不足时,可以检查:
- 查询搜索宽度是否太小,过滤后可用候选是否不足
- 是否支持迭代扫描或补搜,以继续寻找满足条件的结果
- 统计信息是否过期,导致优化器错误估计过滤后的规模
在 PostgreSQL 中可以通过 EXPLAIN ANALYZE 查看实际执行计划;pgvector 提供迭代扫描等相关配置,使用前要确认版本和扫描预算;小结果集走顺序扫描并不一定有问题;参见 pgvector 过滤与迭代扫描说明
三、结构化索引:组织知识本身
ANN 解决的是 "怎样快速找到附近的向量";结构化索引则追问 "文本块之间的关系怎样保存";只把片段当成独立记录,可能难以回答统计、跨文档综合和关系链问题
为什么扁平片段有时不够:
统计问题需要完整范围;假设有 100 个案例,其中 90 个是黑猫、10 个是白猫;如果 Top-K 只取 20 个案例,模型可能只看到 15 个黑猫和 3 个白猫,无法据此推算全库比例;把 K 调大也不保证得到完整集合
如果已经基于全量资料核验并保存 "共有 100 只猫,其中黑猫 90%、白猫 10%",检索这条汇总即可回答;关键是统计覆盖了完整数据,而不是模型对少数片段做了猜测
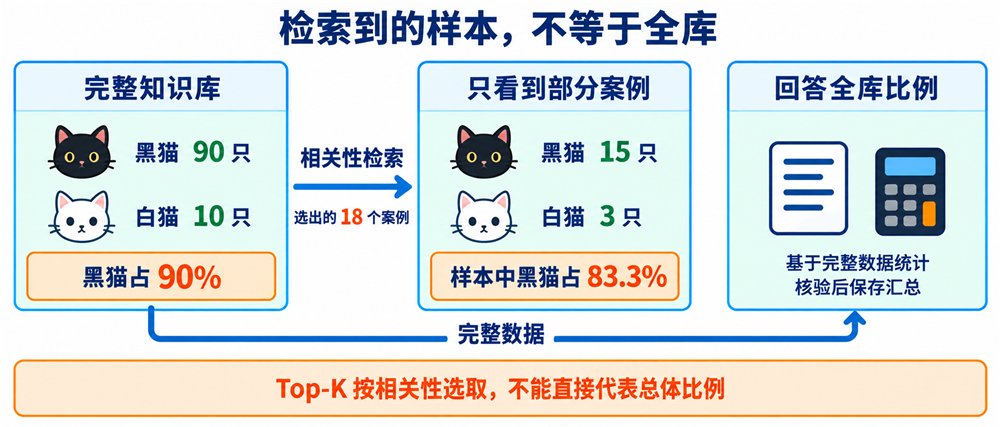
相似案例不能替代适用规则;退伍军人 John 获得优惠,医生 Sarah 获得折扣,教师 Mike 不符合条件;护士提问时,检索可能因职业语义接近而优先召回 Sarah,进而错误泛化
如果有权威规则明确写着 "优惠仅适用于退伍军人和医生",就应把完整规则纳入索引;仅凭三个案例还不足以推出 "所有其他职业都不符合条件",知识提炼也不能凭空把案例扩展成规则
这些例子说明,需要跨文档统计或规则判断时,索引阶段可能需要额外整理汇总、规则及关系;模型可以执行一定的总结与推理,但无法凭空恢复没有检索到的证据
RAPTOR:从细节向上生成层次摘要
RAPTOR 先把文本块作为叶子节点,按语义关联聚类,再为每组内容生成摘要;摘要可以继续聚类和概括,形成从具体片段到较高层主题的结构
例如,多段关于 SSE 指令集的内容可以汇聚为 "x86 SIMD 指令集的各代演进";具体片段说明某一代的功能,父级摘要描述它们之间的演进关系;涉及指令细节时,仍要回到对应资料,不能用抽象摘要替代具体依据
这种组织方式允许在多个抽象层次检索;查询 "请解释 SSE 指令集" 时,可以从较高层概览获得方向,再找到底层细节;实现也可以把多个层级放在一起检索,并不一定每次都严格从根沿树向下走;参见 RAPTOR 论文
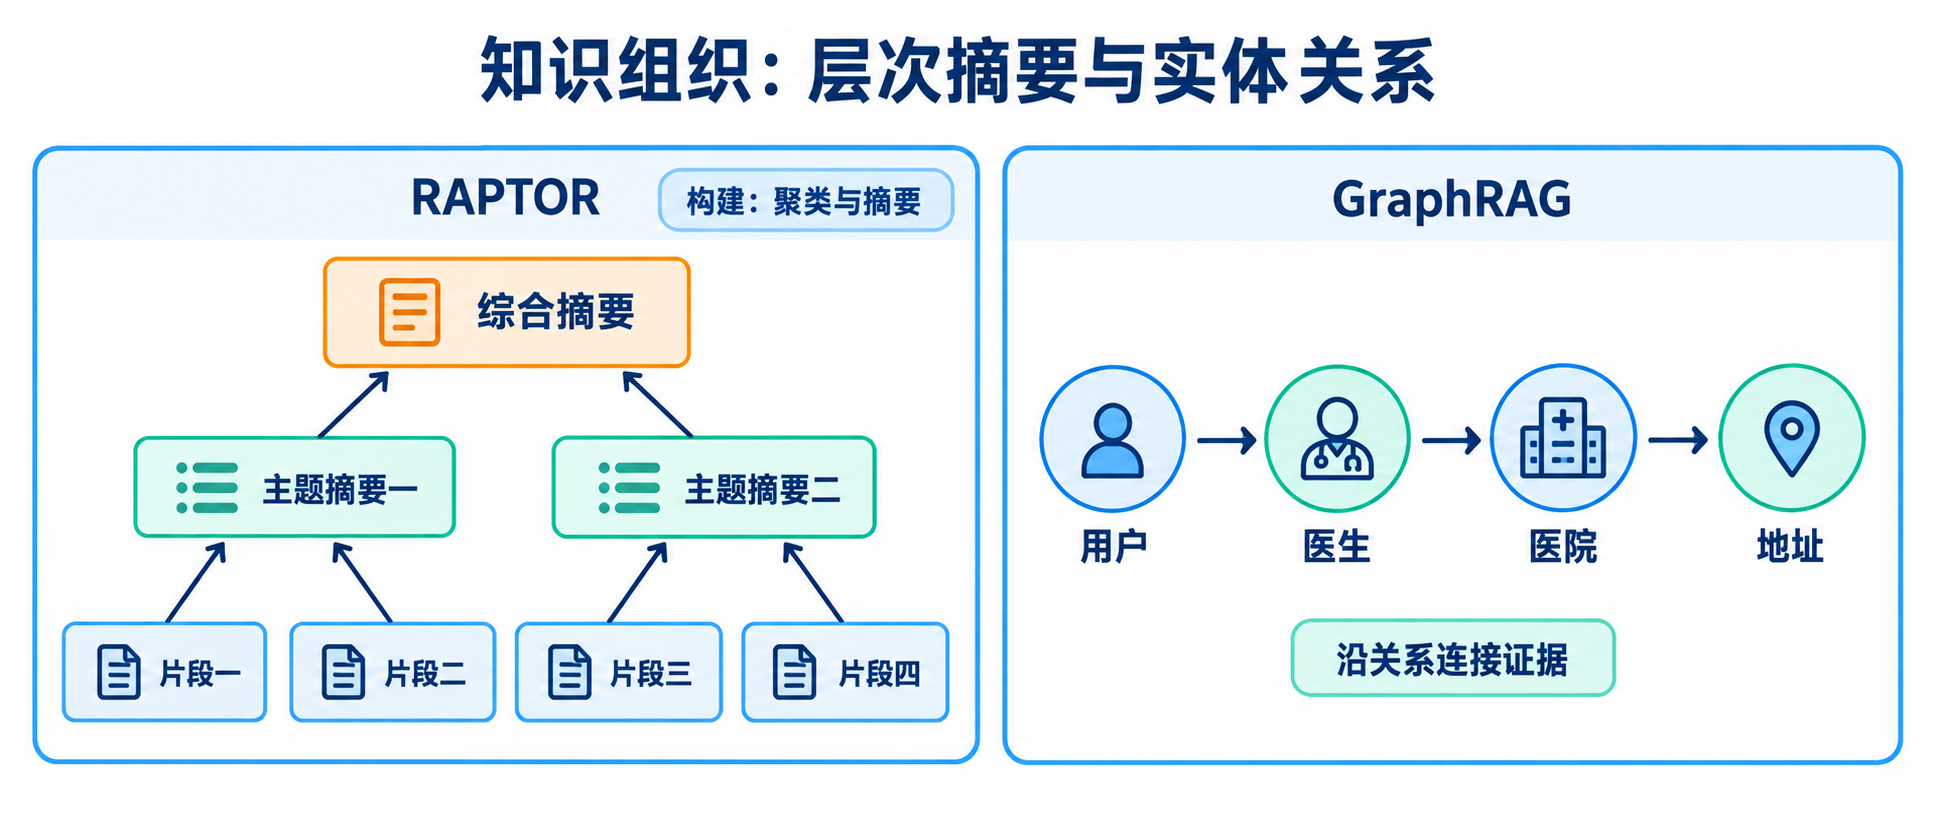
GraphRAG:通过实体关系连接证据
知识图谱用实体和关系组织信息;三元组可以写成 "北京---是首都---中国" 或 "张三---就职于---腾讯",多个三元组连接成网络
当问题是 "我的医生所在医院的地址",系统需要连接 "用户→医生→医院→地址";图结构能够保存这条关系链,帮助检索相关证据;但回答是否可靠,仍取决于关系是否正确、是否完整以及是否过期
实体消歧与词义消歧也不同;判断 bank 指银行还是河岸,是结合语境判断词义;区分同名的两个 "张医生",则需要建立不同实体标识,例如 "张医生-A---科室---牙科" 和 "张医生-B---科室---心脏科";图谱可以保存消歧后的结果,但前面的实体识别与对齐仍需可靠完成
Microsoft GraphRAG 会从文本提取实体与关系,构建图结构,并通过社区发现组织相关实体,生成社区摘要,支持局部与整体问题的检索;它不只是简单地把向量库替换成图数据库;参见 GraphRAG 官方说明
结构化提取也有局限;"如果下周还下雨,我就取消去海边,改去博物馆" 包含条件和时间;若只保存几条孤立的 "去海边" "去博物馆" 关系,就可能破坏原意;条件并非原则上无法建模,但过于简单的三元组提取容易漏掉这些限定,因此需要保留原始文本作为依据
什么时候值得引入结构化索引:
如果主要问题是 "退款政策是什么",准确召回相应片段通常就能解决;如果经常需要比较 "SSE 与 AVX 的架构差异",或从整体架构逐步深入具体指令,多层摘要与关系组织才更值得投入
结构化索引需要额外提取、聚类、摘要与更新维护,部分查询还会增加模型调用;一种互补方式是保留完整自然语言资料,使用元数据、摘要和关系辅助检索;在需要多跳关系或精确实体定位的场景中,再把图谱作为专项能力,而不是替代全部原文
四、上下文感知检索:先补背景,再建立索引
结构化索引处理知识组织关系,而上下文感知检索关注每个片段是否脱离语境;例如 "该公司第二季度的收入增长了 3%",单独出现时无法说明公司是谁、年份是什么,也可能缺少相关业务范围
Anthropic 的 Contextual Retrieval 在索引前使用模型为片段生成简短背景,再与原片段拼接;例如前缀可以说明 "本段来自 ACME 公司 2025 年第二季度财务报告",随后保留收入增长 3% 的原句;前缀必须来自文档中真实存在的上下文,不能补写没有依据的信息
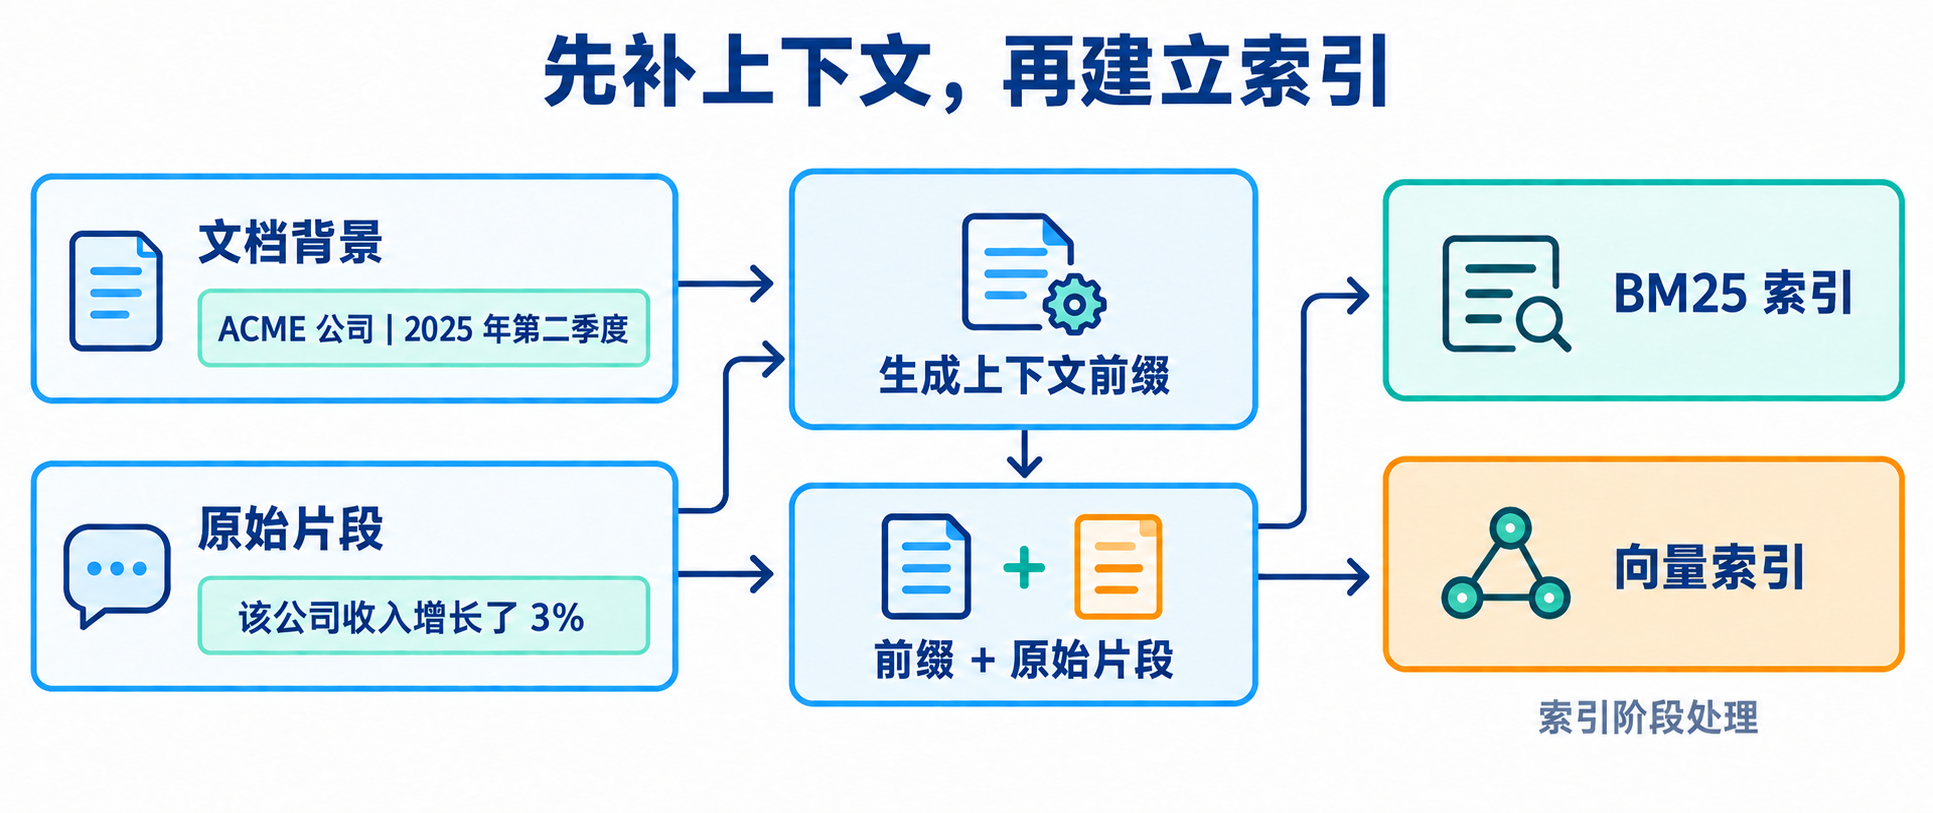
拼接后的内容可以同时用于两条路径:
- BM25:增加 ACME、年份、季度等可匹配词项,让原本缺少关键词的片段有机会命中
- Dense:补足语义背景,让向量更准确地表示这段内容谈论的对象
这个过程发生在索引阶段,处理的是知识库片段;它与运行时压缩会话历史不同,前者为片段补背景,后者围绕当前任务整理上下文窗口
代价主要是额外的上下文生成调用;对于反复共享的完整文档前缀,可以利用提示缓存降低成本,但具体费用取决于模型、缓存计费和片段数量;Anthropic 发布该方法时给出的每百万文档 token 约 1.02 美元,是其指定假设下的历史估算,不是固定报价
在其报告的评估设置中,Contextual Embeddings 与 Contextual BM25 将 top-20 检索失败率从 5.7% 降到 2.9%,相对下降约 49%;再结合重排序器,报告的相对降幅为 67%;这是特定数据和配置下的结果,不是所有知识库都能获得的收益;实验与成本假设见 Anthropic Contextual Retrieval
多路表示决定系统依据什么信号匹配,ANN 决定怎样缩小搜索范围,结构化索引与上下文前缀则帮助资料保留关系和语境;把这些选择与实际问题对应起来,知识库才能兼顾查询效率与证据完整性