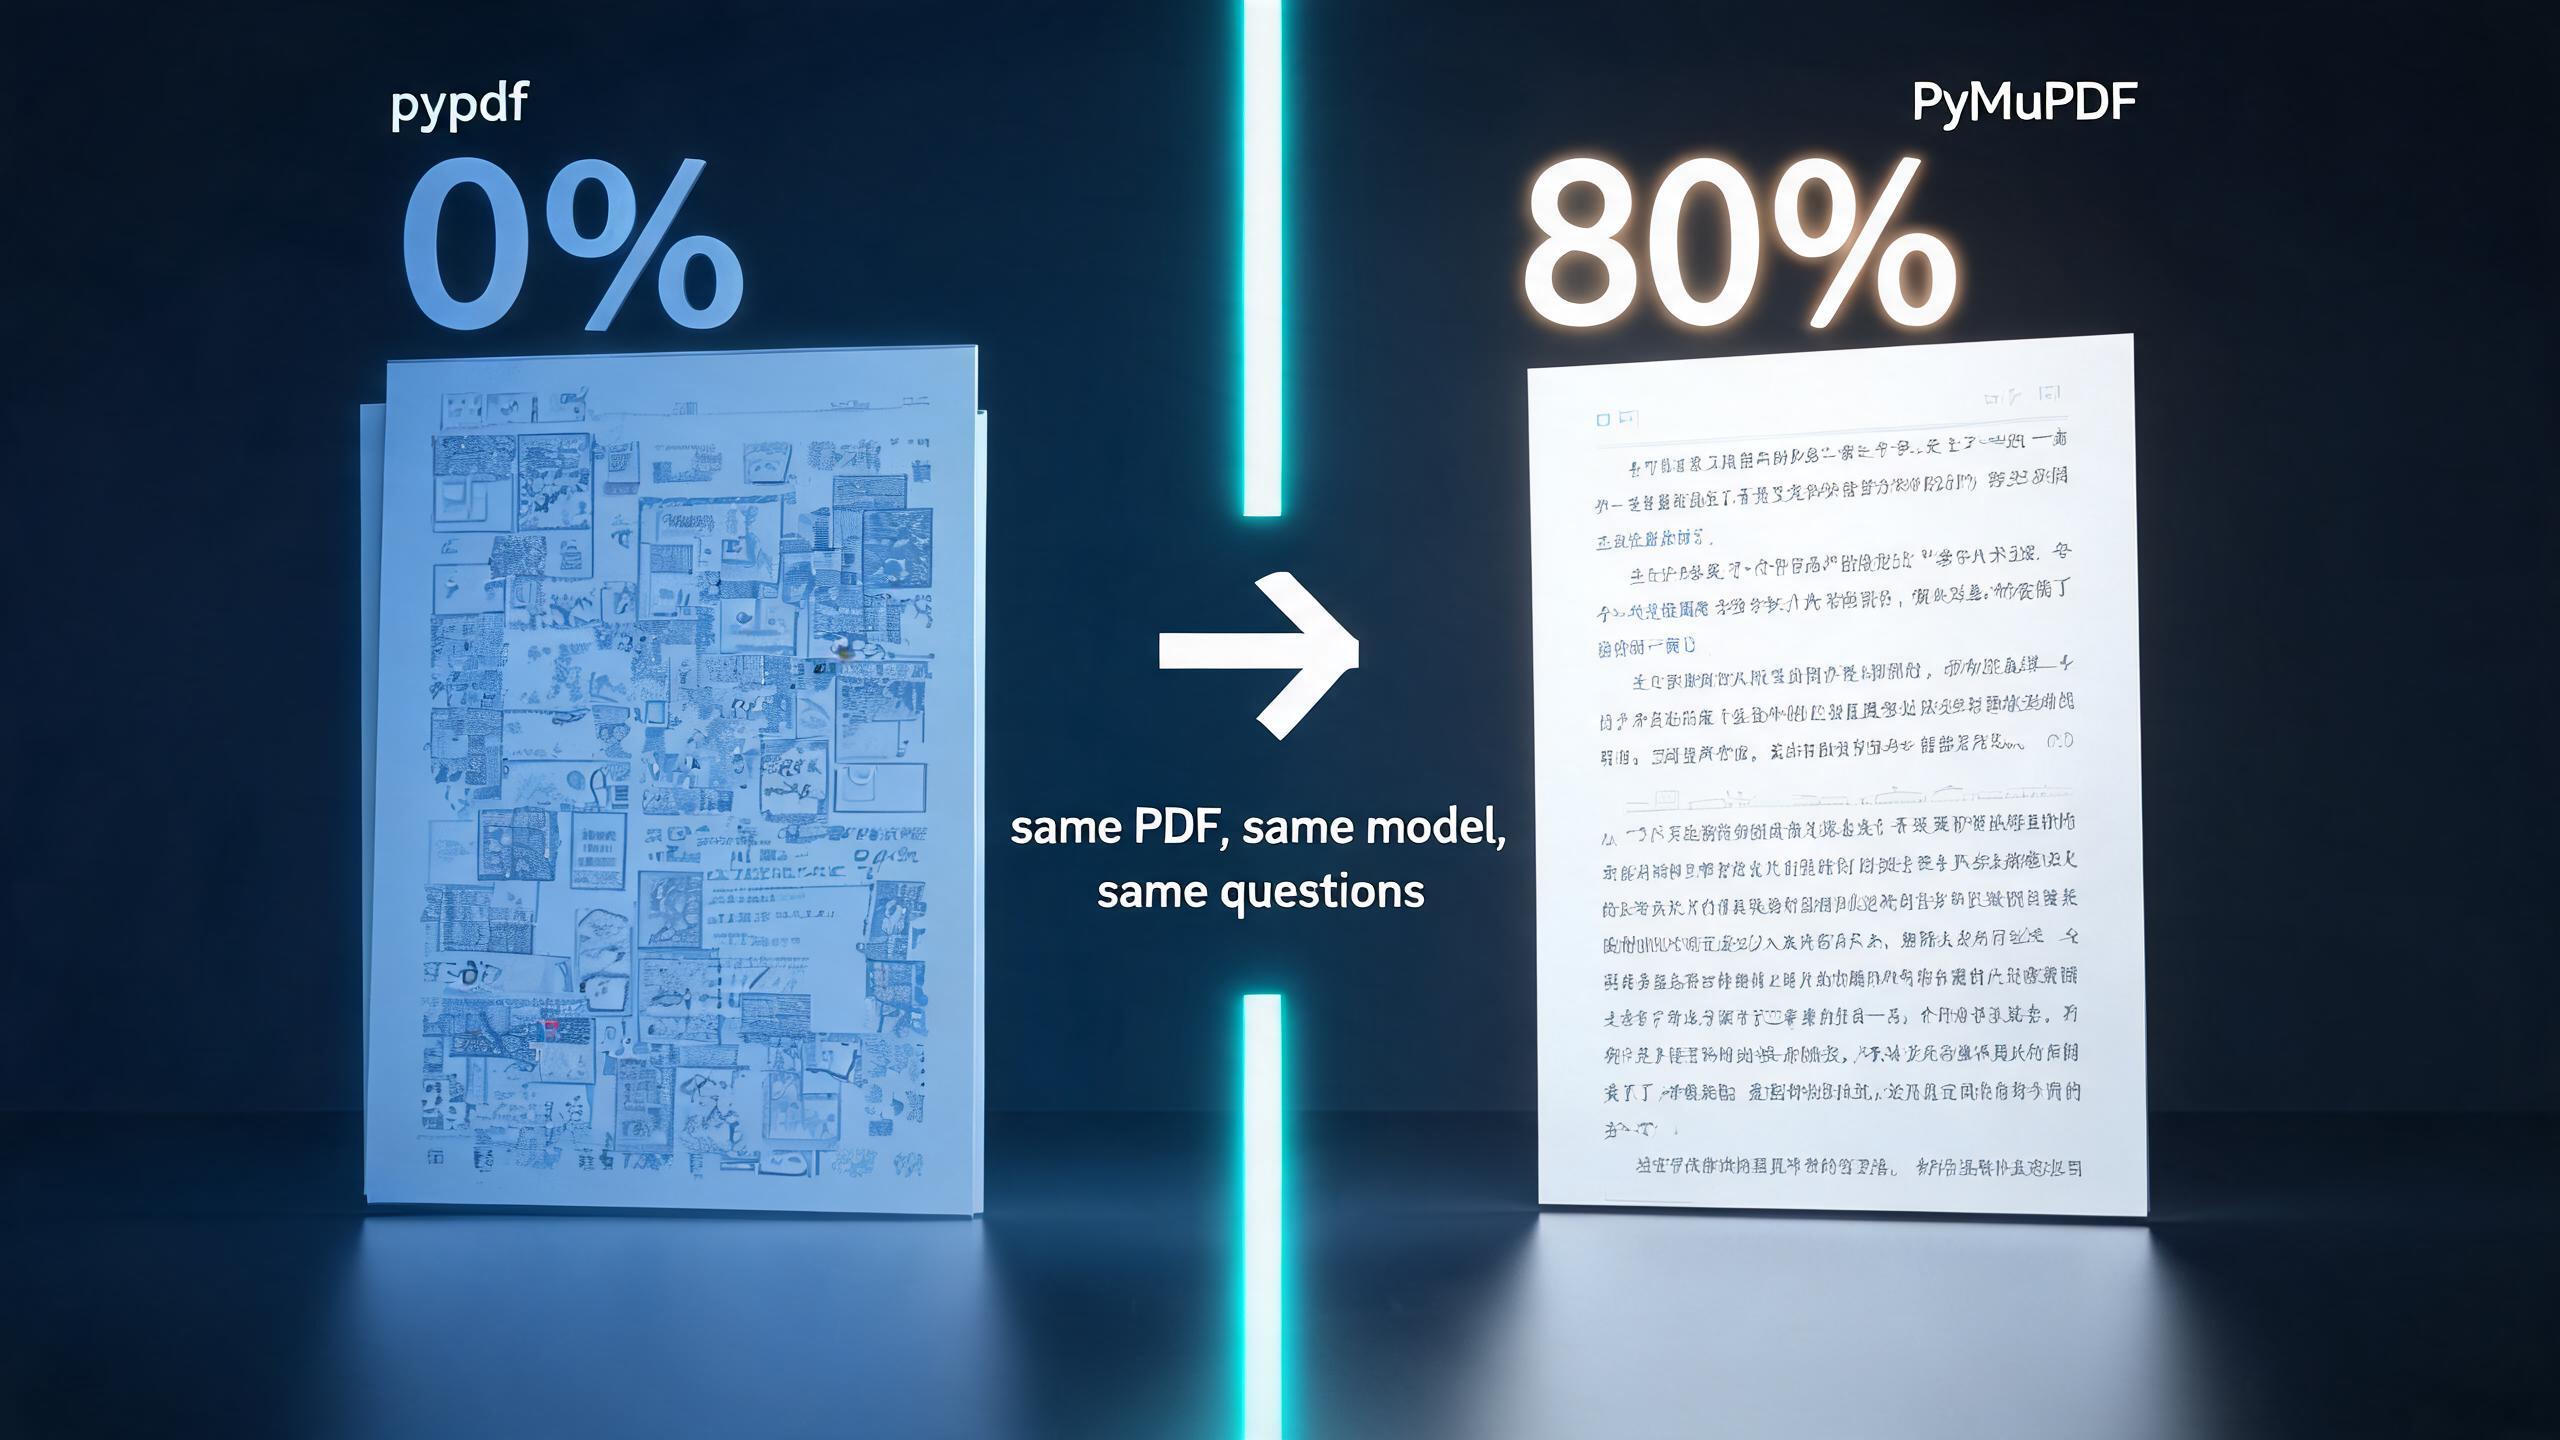
测试日期:2026-10-02
测试环境:Docker+PageIndex Cloud SDK+FAISS+PyMuPDF+硅基流动API
测试文档:腾讯控股2024年度年报(274页,繁体PDF)
这篇原本要写"PageIndex在国产模型环境下翻车了"。
写到一半我回头核对产出数据,发现翻车的不是它,是我自己。我在评测过程中踩了三个坑,一个比一个基础,也一个比一个难堪:解析器一个汉字都没抽出来、我自己写的标准答案错了九道、以及把限流当成了兼容性问题。
一、PageIndex是什么
1.1 它做的事:把"翻目录"这件事交给模型
PageIndex是Vectify AI在2026年9月开源的项目,主打无向量RAG(vectorless RAG)。它不做embedding,也不算相似度,流程是这样的:
- 建索引 :把整篇文档读一遍,让LLM生成一棵树状目录(类似书籍的章节结构),每个节点带一段摘要
- 查询:问题进来后,模型先读这棵树,判断答案大概落在哪个分支
- 下钻:沿着分支走到叶子节点,再调工具把对应页码的原文整页读出来
- 回答:基于原文给出答案
这套动作在实测里能直接看到------它对外暴露的工具主要就是两个:
get_document_structure    # 拿整篇文档的树结构
get_page_content          # 按页码取原文
后面第七节会把真实的调用记录整段贴出来。
1.2 和普通RAG的区别在哪
| 环节 | 向量RAG | PageIndex |
|---|---|---|
| 索引产物 | 一堆chunk的向量 | 一棵带摘要的目录树 |
| 找答案的方式 | 算语义相似度,取top-k | 模型沿树推理,选分支 |
| 读原文 | 只给命中的k个片段 | 定位到具体页,整页读 |
| 效果取决于 | embedding对语义的区分度 | LLM的推理能力+文档结构是否清晰 |
| 像什么 | 拿着问题跟每一段话比相似度 | 像人翻目录找章节,再翻到那页细读 |
差别的核心就一句话:**相似不等于相关。**向量检索优化的是"语义距离最近",而文档问答要的是"事实正确"。问"总收入",语义上最近的很可能是"增值服务收入"或者"毛利"------它们长得像,但不是答案。
PageIndex想用LLM的推理能力替代这一步相似度计算。这个方向本身成立,也正是我想验证的。
二、为什么值得动手测
三个理由,最后一个是国内团队最该关心的:
- **官方数据太漂亮。**PageIndex公布在FinanceBench基准上的准确率是98.7%,传统向量RAG大约50%。差距大到我需要自己看一眼------顺带说明,这是厂商自测数字,我没能复现也没能证伪(第十节会再说一次)
- **它瞄准的正是向量RAG最挣扎的场景。**财报、合同、技术手册这类长文档,恰恰是我这几轮实测里基础向量RAG表现最差的地方
- **我想加一个国内开发者更关心的变量:国产模型能不能跑。**生产环境里数据安全、成本、合规往往比"效果最好"更重要。如果它只能用GPT系列,对国内团队的价值就得打折
三、怎么测的:方案与环境
理由够了,动手。
3.1 测试文档
腾讯控股2024年度年报,PDF格式,274页,繁体。选它的理由很简单:结构完整(财务摘要、业务回顾、管理层讨论、公司治理都有)、数据密集(表格多、数字多、脚注多)、公开披露没有版权问题。
3.2 题目与评判标准
15道题,三个难度等级:简单5道(原文明确给出的单个数字或事实)、中等7道(需定位正确章节,可能涉及计算或对比)、困难3道(需跨章节综合或归纳)。
评判标准:
- 完全正确:核心事实和数字准确,单位、范围、条件都对
- 部分正确:答到部分要点,但有遗漏、单位不明确或数字有偏差
- 错误:答非所问,或声称无法回答但答案其实在文档里
方法说明:这是15题小样本探索性实测,单人人工评判,可能有主观偏差。金标准逐条回溯到年报页码(第4、8、28、123页等),每道题都标了出处。
3.3 三组方案
| 方案 | 配置 | 作用 |
|---|---|---|
| A 基础向量RAG | PyMuPDF解析、chunk_size=500、overlap=50、bge-m3、FAISS、top_k=3 | 对照组,测"裸奔版"下限 |
| B PageIndex Cloud | 官方OCR+树索引,问答用DeepSeek-V3(硅基流动) | 实验组 |
| C 调优向量RAG | A+BM25混合检索(RRF融合),召回5篇 | 补齐"调优后上限"的对照 |
方案C是立项时就定下的:官方对比的往往是"最差的向量RAG",这对向量检索不公平,真正有意义的对比应该跟调优后的版本比。
3.4 运行环境
Docker容器(python:3.10-slim),装pageindex、langchain系列、faiss-cpu、pymupdf。模型走硅基流动的OpenAI兼容接口。完整配置和可复现的脚本见第十一节。
方案定了,开始跑。后面几节讲的,都是跑的过程中发生了什么。
四、第一个坑:274页的中文PDF,抽出了0个汉字
这一节是整篇里最有价值的部分,因为它跟PageIndex、跟向量检索、跟大模型全都无关。
4.1 现象
对照组一开始用的就是标准写法:
python
from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader(pdf_path)
documents = loader.load()          # LangChain 默认后端是 pypdf
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = text_splitter.split_documents(documents)
跑得很顺,274页切成333个块,5.3秒建完索引。15道题答下来,13道回答"根据文档内容无法回答",剩下2道给了数字但答非所问。我当时给这个结果的解释是:bge-m3对"总收入"和"增值服务收入"的语义区分度不够。
这个解释是错的。
我把vector_result.json里每题检索到的chunk内容打出来看一眼,满屏是这样的:
ʮ̡ 262 ൗ ܓ 48 ྼ ϓͭήᓃʿ ʊ೯БŊྼϗٙ
Τ၈ሯ༉ઋ ᛆूˢԷ (%) ุਕʿᐄή这是典型的CID/ToUnicode CMap映射缺失------中文字形没有正确映射回Unicode,被解成了希腊字母、西里尔字母、马来亚拉姆字母的大杂烩。
4.2 量化证据
我写了个脚本把两个解析器拉到同一个文档上对比:
python
import fitz, re

def stats(text):
    total = len(text)
    cjk = len(re.findall(r"[\u4e00-\u9fff]", text))
    weird = len(re.findall(r"[\u0370-\u03ff\u0400-\u04ff\u0d00-\u0d7f]", text))
return total, cjk, weird / total * 100| 解析器 | 抽取字符数 | 中文字数 | 乱码字符占比 |
|---|---|---|---|
| pypdf(LangChain默认) | 90,558 | 0 | 6.0% |
| PyMuPDF | 191,402 | 128,008 | 0.0% |
**0个汉字。**一份274页的中文年报,喂给embedding模型的上下文里一个中文都没有。
这个数字解释了一切:
- 为什么13道题都答"无法回答"------问题里的中文关键词,在全是符号碎片的知识库里没有任何可匹配的东西
- 为什么剩下2道题还能吐出数字------**数字和拉丁字符的编码没坏,只有中文坏了。**纯靠数字形状还能蒙对,一旦涉及语义就全线崩
我当时把"13道无法回答"解释成"语义相似度不等于事实相关性",把一个解析层事故包装成了范式缺陷。这条归因链条错得离谱。
4.3 修复
一条命令的事:
bash
pip install pymupdf
python
import fitz
from langchain_core.documents import Document

doc = fitz.open(pdf_path)
pages = [
    Document(page_content=page.get_text() or "", metadata={"page": i})
    for i, page in enumerate(doc)
    if page.get_text().strip()
]
切块策略、bge-m3、FAISS、DeepSeek-V3一个都没动,只换了解析器,改完之后:
[basic] pages=272 chars=191402 chunks=529
[basic] index_time=35.11s
[basic] q1 ok 2.93s :: 腾讯控股2024年的总收入为人民币6,603亿元。
[basic] q2 ok 3.17s :: 腾讯2024年净利润为人民币1,940.73亿元(国际财务报告准则)和人民币2,227.03亿元(非国际财务报告准则)。
[basic] q12 ok 3.17s :: 2024年腾讯回购了307,238,500股股份,回购总金额为1,120亿港元。
索引时间从5.3秒涨到35.11秒,因为文本量翻了一倍多。这笔开销值。
五、第二个坑:9道标准答案是我自己写错的
如果说第一个坑是技术问题,第二个坑更难受------它说明我一开始就没有资格评判模型的答案。
修好解析之后,我把15道题的答案对着年报原文逐条核了一遍。核对的基础是三处公开数据:第123页《综合收益表》、第8页《管理层讨论及分析》的分部收入表、第4页主席报告里的经营数据表。
| 题 | 我原来的标准答案 | 年报真值 | 出处 |
|---|---|---|---|
| q1总收入 | 约7262亿元 | 6,602.57亿元,同比+8% | p123综合收益表 |
| q2净利润 | 约2145亿元 | IFRS归母1,940.73亿元(+68%) ;Non-IFRS2,227.03亿元(+41%) | p4/p123 |
| q3增值服务 | 约3224亿元 | 3,192亿元,同比+7% | p8 |
| q4微信月活 | 13.9亿,+2.5% | 1,385百万(13.85亿),同比+3% | p4经营数据表 |
| q6网络广告 | 1126亿元,+24% | 营销服务1,213.74亿元,同比+20%(2024年起由"网络广告"更名) | p8/p123 |
| q7金融科技及企业服务 | 2277亿元,+13% | 2,119.56亿元,同比+4% | p8/p123 |
| q10视频付费会员 | 1.05亿 | 1.13亿 | p5 |
| q12回购 | 约1350亿港元 | 约1,120亿港元,共307,238,500股并注销 | p28 |
| q13音乐付费会员 | 1.1亿 | 1.21亿 | p5 |
15道题里9道对不上,偏差都不小:q1差了659亿元,q6的同比差了4个百分点,q12差了230亿港元。
5.1 最打脸的一题
旧版对照组的q4输出是这样的:
微信及WeChat月活1,385(单位未明确),同比增长3%
我当时判"部分正确",理由是"单位不明确,数字有偏差"。翻到第4页经营数据表:
微信及WeChat 的合併月活躍賬戶數
1,385    1,343    3%
(百万计,另有指明者除外)
年报自己的单位就是百万。模型答的1,385、增长3%,两个数字全对,还忠实反映了原文的百万口径。
这题是全对,被我判成了部分对。
同一份结果里还有q13,模型答255,792,我判"数字对但答非所问"。回头看,那是在一堆乱码chunk里捡到的某个会计科目数字。两条记录指向的是同一个结论:上下文没有中文,模型只能靠数字碰运气。
5.2 教训
评测集的金标准必须能逐条回溯到原文页码。我后来给自己立的规矩是:每题除了expected_answer,还要填expected_pages和note(口径说明)。没有出处页的答案,本质上只是另一个猜测。
六、重做之后:0%到80%
两个坑都填上了,重跑基础版对照组。先放新旧两版的整体对照:
| 维度 | 旧版(pypdf抽取) | 新版(PyMuPDF抽取) |
|---|---|---|
| 抽取字符数 | 90,558 | 191,402 |
| 抽出的中文字数 | 0 | 128,008 |
| 乱码字符占比 | 6.0% | 0.0% |
| 切块数(500/50) | 333 | 529 |
| 向量RAG完全正确率 | 0%(0/15) | 80%(12/15) |
| 平均查询耗时 | 2.61秒 | 4.04秒 |
配置完全没有优化,就是最朴素的那套:chunk_size=500、overlap=50、bge-m3、FAISS、top_k=3、DeepSeek-V3、temperature=0。
说明:这组数字来自两次独立运行,索引耗时实测在3541秒、平均查询在4.04.8秒之间波动,同一脚本的正常抖动,不影响准确率结论。
| 题号 | 难度 | 答案 | 判定 |
|---|---|---|---|
| q1 | 简单 | 6,603亿元 | 正确 |
| q2 | 简单 | IFRS 1,940.73亿+Non-IFRS 2,227.03亿 | 正确 |
| q3 | 中等 | 增值服务3,191.68亿;占比称未披露 | 部分正确 |
| q4 | 简单 | 13.85亿,同比3% | 正确 |
| q5 | 中等 | 混元、元宝、AI融入搜一搜与广告平台 | 正确 |
| q6 | 中等 | 营销服务1,213.74亿,+20%(注明更名) | 正确 |
| q7 | 中等 | 给出毛利997亿,未给收入2,119.56亿 | 部分正确 |
| q8 | 中等 | 无法回答 | 错误 |
| q9 | 困难 | ESG工作组、可持续社会价值创新、未成年人保护等 | 正确 |
| q10 | 简单 | 1.13亿 | 正确 |
| q11 | 困难 | 三个方向:AI、产业互联网、内容与平台生态 | 正确 |
| q12 | 中等 | 307,238,500股,1,120亿港元 | 正确 |
| q13 | 简单 | 1.21亿 | 正确 |
| q14 | 困难 | 《帝国时代》手游、《流亡黯道2》、Supercell | 正确 |
| q15 | 中等 | 分部收入2,119.56亿+4%,并声明未披露云单列数据 | 正确 |
完全正确12/15,部分正确2/15,错误1/15。
我还补记了一个指标:召回率hit@3------正确答案所在页有没有出现在检索结果里。
| 组别 | hit@3 | 完全正确率 |
|---|---|---|
| 基础组(向量top-3) | 14/15(93%) | 12/15(80%) |
| 调优组(BM25+向量混合,top-5) | 13/15(87%) | 更低(q6、q15答错) |
顺带修正一处:q9的期望页我一开始标成了指向ESG报告的引用页,实际答案内容在第106至107页,把这两页补进标注后两组才算命中。
召回率高于准确率,这个对比值得单独说一句:它意味着检索层基本是命中的,剩下丢的分主要不在"找没找到",而在"拿到之后怎么答":
- q8检索命中了(p5),但模型选择拒绝回答
- q3检索命中,但游戏收入占比要到附注里凑,模型说未披露
- q7两组都没检索到收入分部表(p8),都答成了毛利
也就是说,解析层修好之后,这套朴素配置的瓶颈落在生成层------检索层该找的基本都找到了。这跟我这个系列第3篇生成层实测的方向能对上。
而调优组在q6上偏偏丢了命中------它检索到的是分部毛利表(p9)而不是收入表(p8),所以把毛利672.32亿当成了收入。混合检索多召回的那几篇文档,把真正的收入页挤掉了------这是它比基础组差的直接原因,不再是推测。
再按题型分层看一眼(开放题的判定弹性大,分开算更稳):
| 类别 | 题数 | 完全正确 | 正确率 |
|---|---|---|---|
| 事实/数值题(q1、q2、q3、q4、q6、q7、q10、q12、q13) | 9 | 7 | 78% |
| 开放题(q5、q8、q9、q11、q14、q15) | 6 | 5 | 83% |
两类接近,说明80%不是靠开放题放水撑起来的。反过来,如果把开放题一律从严改判为部分正确,完全正确率会降到7/15(47%)------这是同一组数据在最保守口径下的下限,两个数字放在一起看才有意义。
唯一答错的q8(研发投入总额)情有可原:年报没有单独列示"研发开支"总额,只在开支附注里体现,模型拒绝回答反而是对的------这是我在出题时没核实清楚口径,属于第三版要补的内容。
6.1 顺手做了一组调优对照
立项文档里我写过:"官方对比的是最差的向量RAG,这不公平,真正有意义的对比是PageIndex vs调优后的向量RAG。"上一版因为对照组全崩,这组没做成。这次补上了------BM25加向量混合检索(RRF融合),召回从3篇扩到5篇:
python
class Ensemble:
    """BM25 + 向量混合(标准 RRF 融合)"""

    def invoke(self, q):
        ra = self.a.invoke(q)      # BM25 top-8
        rb = self.b.invoke(q)      # 向量 top-8
        scores, seen = {}, {}
        # 注意:两路必须分别计算排名,不能拼接后统一 enumerate
        for rank, d in enumerate(ra):
            scores[d.page_content] = scores.get(d.page_content, 0.0) + 1.0 / (60 + rank)
            seen.setdefault(d.page_content, d)
        for rank, d in enumerate(rb):
            scores[d.page_content] = scores.get(d.page_content, 0.0) + 1.0 / (60 + rank)
            seen.setdefault(d.page_content, d)
        ordered = sorted(scores.items(), key=lambda x: -x[1])
        return [seen[c] for c, _ in ordered[:5]]
结果并不好看:
| 题 | 基础组 | 调优组(BM25+向量) |
|---|---|---|
| q6营销服务收入 | 1,213.74亿元,+20%(正确) | 672.32亿元,+31%(错误) |
| q15腾讯云 | 分部收入2,119.56亿,并说明未披露 | 无法回答 |
| q2净利润 | 两个口径都给出 | 只给了IFRS一个 |
| 平均查询耗时 | 4.04秒 | 4.06秒 |
调优组在q6上把分部毛利表里的营销服务毛利(67,232百万元=672.32亿元)当成了收入。多召回的文档带来的只有同名不同口径的干扰------毛利表混进来之后,收入就被顶掉了。
这不意外,和这个系列第1篇分块策略实测的结论是同一个方向------那篇跑了9组配置、900次检索,Hit@1全挤在0.81~0.83。检索策略的边际收益,远小于"你的文本到底有没有被读出来"这件事的基础收益。
七、PageIndex:它没翻在兼容性上
回到这次的主角。上一版我写它"工具调用不兼容,国产模型大多只做到第二层兼容性"。这个结论我没有数据支撑------我有的只是它失败了,然后我挑了一个自己最熟悉的原因往上套。
7.1 它成功的两次
把pageindex_cloud_deepseek.json完整打开,q1的answer字段是这样的:
[tool_call] get_document_structure {"doc_name": "tencent-2024-annual-report.pdf"}
[tool_result] get_document_structure: {"success": true, "structure": [{"title": "Preface",
  "node_id": "0000", "start_index": 1, "end_index": 1, "summary": "Tencent 腾讯..."}]}

[tool_call] get_page_content {"doc_name": "tencent-2024-annual-report.pdf", "pages": "124"}
[tool_result] get_page_content: {"success": true, "total_pages": 274,
  "requested_pages": "124", "content": [{"page": 124, "text": "# 綜合收益表"}]}

腾讯控股2024年的总收入为6,602.57亿元人民币。具体数据如下:
- 增值服务收入:3,191.68亿元
- 营销服务收入:1,213.74亿元
- 金融科技及企业服务收入:2,119.56亿元
- 其他收入:77.59亿元
数据来源:《腾讯控股2024年年度报告》综合收益表(第124页)。
把四个分部加起来:3191.68+1213.74+2119.56+77.59= 6602.57,和我对照第123页综合收益表的结果完全一致。
这段输出包含三个关键动作:
- DeepSeek-V3发起了结构化的
tool_calls - PageIndex接住并执行了工具,把第124页的真实内容回传
- 模型读到内容后给出正确答案,还用对了"营销服务"这个2024年新口径
**多轮工具调用的Agent循环,在国产模型上是能跑通的。**我上一版给它打的两个不兼容判断,全部撤回。
至于[tool_call]这段为什么会混进答案里------调用本身是成功的,流式输出把工具调用轨迹也当成内容块吐了出来,而我的脚本无脑累加了全部chunk:
python
for chunk in client.chat(q["question"], doc_id=doc_id, stream=True):
    if isinstance(chunk, str):
        answer += chunk        # tool trace 也被拼进了 answer
这是调用方的日志处理问题,跟框架兼容性无关。
7.2 它失败的十三次
同一份JSON里,q3到q15的错误一模一样,一共13条:
The model backend failed: litellm.RateLimitError:
RateLimitError: OpenAIException - Request was rejected due to rate limiting.
Details: TPM limit reached.
TPM是每分钟token数的速率上限。注意它跟余额是两回事------测完之后我的账户里还剩5.35元,限流照样发生,因为TPM上限跟着账户档位走,跟余额还剩多少无关。PageIndex每次问答是多轮Agent循环,一轮输入就要八千多token,瞬时消耗远超低档位的TPM。
为了确认这不是巧合,我用同一个doc_id、同一份代码、同一个模型,把请求间隔拉到4秒重跑了5道题:
[PI] doc_id=pi-cmuq5jrky001e09mbxj0na2b9 model=openai/deepseek-ai/DeepSeek-V3 n=5 sleep=4s
[PI] q1 FAIL ...Request was rejected due to rate limiting
[PI] q2 FAIL ...Request was rejected due to rate limiting
[PI] q3 FAIL ...Request was rejected due to rate limiting
[PI] q4 FAIL ...Request was rejected due to rate limiting
[PI] q5 FAIL ...Request was rejected due to rate limiting
[PI] success=0/5两次实验合起来看:q1、q2先成功,从q3开始全部失败------这个形状符合滑动窗口限流的特征。一轮Agent循环的消耗把一分钟窗口填满之后,后续请求无论怎么重试都会被拒,而窗口一重置,下一题一进来又立刻把它打满。代码一行没改,变的只是每次请求落在窗口的哪个位置。
7.3 上一版那个"四层兼容性"框架怎么改
上一版我提了个四层模型,说国产模型"大多只做到第二层(单轮tool calling)",PageIndex需要第四层。
现在看,至少DeepSeek-V3完成了第四层要求的完整动作。真正卡住它的是中间的OpenAI兼容层------这里是硅基流动,在多轮Agent调用下,速率上限(TPM)会比模型能力更早成为瓶颈。
**这个锅怎么定位到硅基流动而不是PageIndex?**三个判据:
- 报错是
litellm.RateLimitError包着OpenAIException ... rate limiting ... TPM limit reached------litellm只是客户端库,它转述的是上游OpenAI兼容接口返回的429。PageIndex自己的额度不足,不会用"TPM"这个措辞 - Cloud索引走的是官方额度,170秒跑完,全程没报过任何配额错误
- 报错全部集中在问答阶段,而问答用的是我自己的硅基流动key,token从我的账户扣
这个区别很重要:归因给模型,开发者的选项只剩"换模型或等厂商改";归因给限速,选项立刻变成"升TPM档位、降并发、错峰跑、自己实现Agent层控制token",后者今天就能动手。
7.4 索引侧:这一条结论没变
Cloud模式建274页索引耗时170秒,自带OCR,不消耗自有token,这一条和上一版一致:
| 项目 | PageIndex Cloud | 自跑向量RAG(PyMuPDF) |
|---|---|---|
| 建274页索引 | 170秒 | 35.11秒 |
| 是否消耗自有token | 否 | 是(191,402字符embedding) |
| 自带OCR | 是 | 否 |
| 单次成功问答耗时 | 18.3秒/30.5秒(两次样本) | 4.04秒(15题平均) |
PageIndex慢得多,但它慢的那部分工作(理解文档结构)正是向量索引不做的。
八、国产环境的真实门槛排序
测完这一轮,如果有人问我"国产环境下做一套文档问答,先解决什么",我的答案变了:
| 优先级 | 环节 | 这次踩到的坑 | 后果 |
|---|---|---|---|
| 1 | 解析层 | pypdf抽0个汉字 | 准确率0%,而且看不出原因是解析 |
| 2 | 评测金标准 | 15题错9题 | 模型答对也判错,方向彻底走反 |
| 3 | 速率限制(TPM)与并发 | 13/15请求被TPM限流(来自硅基流动侧) | Agent类框架直接不可用 |
| 4 | 检索策略调优 | BM25混合反而串了毛利与收入 | 边际收益小于预期 |
| 5 | 模型/框架兼容性 | 本轮没遇到实质问题 | 之前被错误归因成了主因 |
前两项加起来工作量不到半天,但它们决定了后面所有数据的可信度。
九、成本与延迟:口径这次对了
上一版的成本估算有个明显的口径错误,这里一并更正。
向量RAG(修好解析后)
| 环节 | 用量 | 单价 | 成本 |
|---|---|---|---|
| Embedding(529 chunk,191,402字符) | 约13万token | 0.1元/百万token | 约0.013元 |
| 15次问答(DeepSeek-V3) | 约5万输入+0.8万输出token | 1元/百万输入,5元/百万输出 | 约0.09元 |
| 合计 | --- | --- | 约0.1元 |
数字和上一版接近,但这次的191,402字符是真实抽出来的文本,不是乱码。
PageIndex Cloud
Cloud索引走官方额度,问答token自付。按成功样本粗估:单轮多轮循环约8000输入+500输出token,约0.01元/次。这个数字只有参考价值,因为总共只跑成功2次,样本不足以做统计。
上一版那张"准确率50%/70%/90%三档"的敏感性分析表已经整段删掉------分母错位(拿基础组的"部分正确率13%"当"准确率"),算出来的结论没有意义。
十、验证边界
这篇结论的适用范围,我自己先标清楚:
- **样本15题、1份文档、单人评判。**精度有限,不能推广到"所有中文财报"
- **PageIndex的准确率没有统计意义。**全程只跑成功2次,我给不出任何准确率数字,只能说"在这两次上答对了"。要给出数字,需要把TPM档位升上去再跑一轮------通常靠充值提升账户等级,或者直连模型厂商的官方API------在那之前,关于它准确率的一切说法都是推测,官方那个98.7%同样是厂商自测,我没能复现也没能证伪
- **Qwen2.5-72B的上下文问题我上一版说错了。**硅基流动同时提供
Qwen/Qwen2.5-72B-Instruct(32K)和Qwen/Qwen2.5-72B-Instruct-128K两个入口,我当初只试了前者就下了"Qwen只有32K"的结论 - **没有跑rerank组。**平台上有
BAAI/bge-reranker-v2-m3可用,这次没做,它在我上面那张优先级表里排第4位。所以这篇回答不了"精排到底能提多少"这个问题,只能留到下一轮 - **研发支出那道题口径没锁死。**q8的错更多出在出题口径,与模型无关
十一、如果你想自己跑一遍
这次的脚本都在docker/scripts/下,容器pageindex-test可以直接跑:
bash
# 解析质量自检,这一步一定要先跑
docker exec pageindex-test python scripts/_parse_check.py

# 对照组(基础版 / BM25 混合版)
docker exec pageindex-test python scripts/test_vector_rag_v2.py \
  docs/tencent-2024-annual-report.pdf scripts/questions_v2.json \
  output/vector_basic_v3.json basic
最重要的一条经验:**任何RAG评测开始前,先打印几个chunk用眼睛看一遍。**这个动作30秒,能省掉后面几天的错误归因。
RAG链路实测系列
系列说明:前5篇是经典向量RAG链路四件套加查询路由番外,本篇(第6篇)开始探索下一代架构------无向量、推理型、Agent化检索。
| # | 篇目 | 状态 |
|---|---|---|
| 1 | 分块策略实测(9组配置900次检索,Hit@1全挤在0.81~0.83) | 已发布 |
| 2 | 重排序实测(500条真实查询,精排Hit@1 0.364→0.486) | 已发布 |
| 3 | 生成层实测(答案递到嘴边,7B还是漏掉一半) | 已发布 |
| 4 | 6,208条答案打分实测(判对率94%,逐字正确率6%) | 已发布 |
| 5 | 查询路由实测(路由准确率要98.2%才不亏,而我测出来最高97.1%) | 已发布 |
| 6 | PageIndex没翻车,翻车的是我的解析器(本篇) | 本篇 |
顺带推荐一篇工程向总结:RAG六层架构实践指南(哪些层值得做,哪些层我实测没跑出差别)。
相关链接:
- 测试脚本与结果数据:
docker/scripts/与docker/output/ - 测试文档:腾讯控股2024年年度报告(公开披露文件)
- PageIndex官方文档:docs.pageindex.ai
下一步我打算补两件事:给向量RAG加bge-reranker-v2-m3精排,看第4位优先级到底值多少;以及把TPM档位升上去重跑PageIndex,把它的准确率从"2次成功"变成一个有统计意义的数字。
在那之前,如果你正准备给公司做一套文档问答,建议的顺序是:先用_parse_check.py这类脚本把你的PDF按解析器过一遍,看到中文字数,再来谈选型。这个顺序反过来,你会得到一个很干净的数字,和一个完全错误的结论。