LangChain4j AiServices:用接口声明式串起 Tool、Memory 与按需 RAG
写 LLM 应用时,最容易膨胀的是「手写消息列表 + 自己拼 tool call + 自己管会话」。LangChain4j 的 AiServices 换了个思路:先声明一个 Java 接口,再用 builder 把 ChatModel、记忆、工具、检索插进去,调用侧只剩一次方法调用。下面按官方 AiServices 教程与入门页落地四件事:接口与 builder、多用户 Memory、@Tool、以及把 RAG 做成按需 Tool。版本以文档示例的 langchain4j / langchain4j-open-ai / langchain4j-bom = 1.21.0 为准;bom 下不少模块仍可能是 1.21.0-beta31 一类,升级时要当潜在 breaking 看待。这里不涉及 Agentic 的 @Agent / sequence。
一、接口 + AiServices:声明式入口
JDK 要求 ≥ 17 。最小形态是:定义助手接口,用 AiServices.create 或 AiServices.builder 绑定模型。教程里最简单的接口甚至可以只有一个 String chat(String userMessage);需要模板变量或与 @MemoryId 并存时,再给参数加上 @UserMessage(否则构建 AiServices 时会抛 IllegalConfigurationException,1.21.0 实测)。
java
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.model.openai.OpenAiChatModel;
import dev.langchain4j.service.AiServices;

public class AiServicesBasics {

    interface Assistant {
        String chat(String userMessage);
    }

    public static void main(String[] args) {
        ChatModel model = OpenAiChatModel.builder()
                .apiKey(System.getenv("OPENAI_API_KEY"))
                .modelName("gpt-4o-mini")
                .build();

        Assistant assistant = AiServices.create(Assistant.class, model);
        System.out.println(assistant.chat("用一句话解释何为声明式 AI 服务"));
    }
}
OpenAiChatModel.builder().apiKey(...).modelName("gpt-4o-mini").build() 与入门文档一致。需要同时挂记忆、工具、检索时,改用 builder 更清晰:
java
import dev.langchain4j.memory.chat.MessageWindowChatMemory;
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.service.AiServices;

public class AiServicesWithMemory {

    interface Assistant {
        String chat(String userMessage);
    }

    static Assistant create(ChatModel model) {
        return AiServices.builder(Assistant.class)
                .chatModel(model)
                .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
                .build();
    }
}
声明式的好处是边界清楚:接口是「对业务暴露的能力」,builder 是「运行时拼装」。模型供应商、窗口大小、工具集合都可以在不动接口签名的前提下替换。文档还提醒:Quarkus / Spring Boot 扩展可以自动装配助手 Bean,那时甚至不必手写 AiServices.create,但核心心智模型不变,仍然是「接口 + 低层组件」。
Chains 在文档里已标 legacy (目前主要是 ConversationalChain / ConversationalRetrievalChain),新项目不要再把 ConversationalChain 当默认方案。需要编排多个助手时,用普通 Java 把多个 AiServices 串起来即可,别回到旧 Chain API。
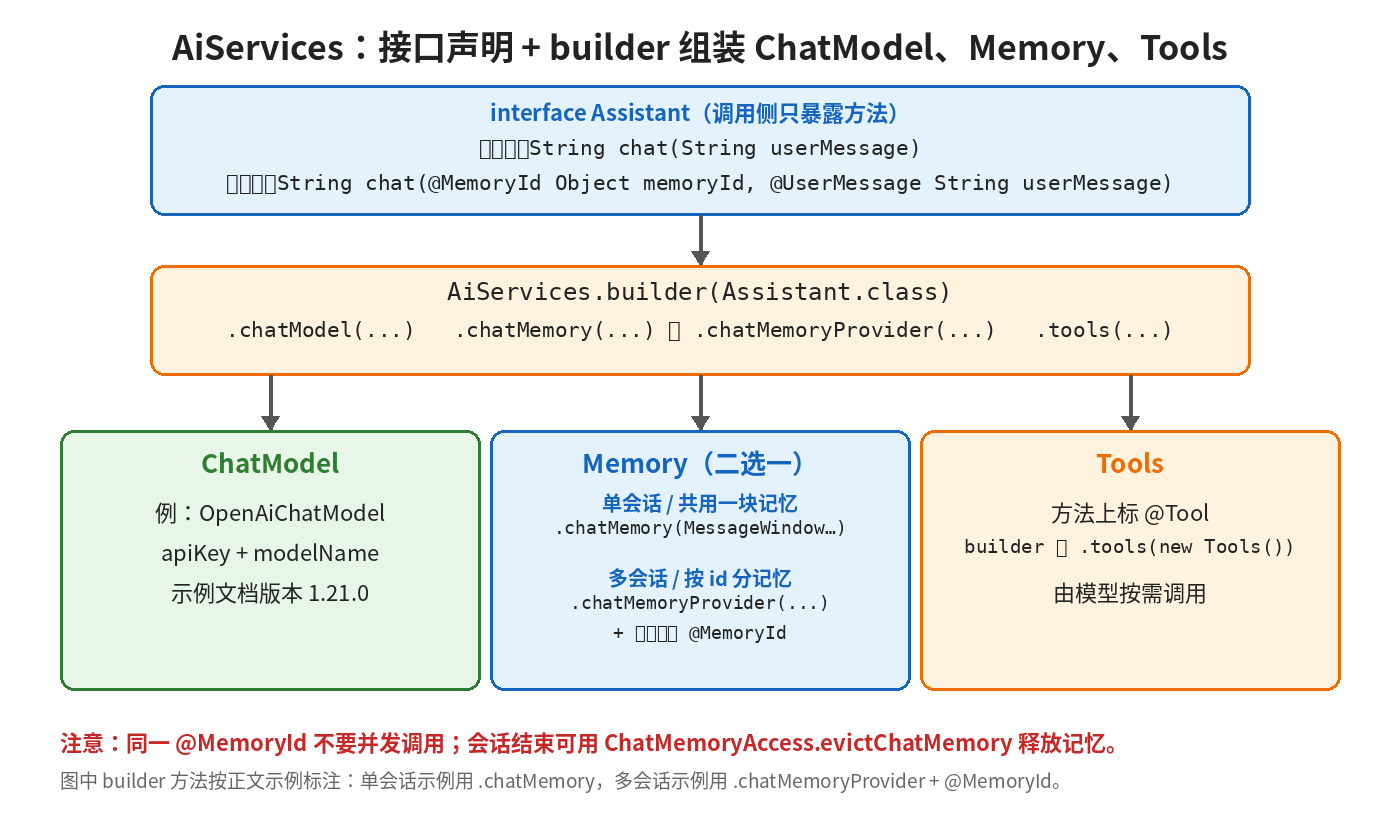
上线前建议把「接口方法签名」和「builder 里挂了什么」分成两份清单:前者进 API 评审,后者进运维/成本评审(模型、窗口、是否每次检索)。两边分开,改 prompt 或换模型时才不会误伤调用方。
二、ChatMemory:单窗、多用户与驱逐
单会话可以直接 .chatMemory(MessageWindowChatMemory.withMaxMessages(10)),所有调用共享同一块记忆,适合演示或单人后台任务。多用户 / 多会话要用 chatMemoryProvider + @MemoryId:
java
import dev.langchain4j.memory.chat.MessageWindowChatMemory;
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.service.AiServices;
import dev.langchain4j.service.MemoryId;
import dev.langchain4j.service.UserMessage;

public class MultiUserMemoryDemo {

    interface Assistant {
        String chat(@MemoryId String memoryId, @UserMessage String userMessage);
    }

    public static Assistant create(ChatModel model) {
        return AiServices.builder(Assistant.class)
                .chatModel(model)
                .chatMemoryProvider(memoryId ->
                        MessageWindowChatMemory.withMaxMessages(10))
                .build();
    }
}
文档写明两条硬约束,生产里值得写进评审清单:
- 同一
@MemoryId不要并发调用 ,会损坏 ChatMemory;目前没有内置防并发。需要的话在业务侧对 memoryId 加串行(锁、队列、单线程执行器),不要指望框架替你挡。 - 方法上没有
@MemoryId时,provider 收到的 memoryId 默认是字符串"default"。所有「忘了传会话号」的调用会挤进同一个窗口,排查时很迷惑。
会话结束或用户注销时,让助手接口 继承 ChatMemoryAccess ,即可使用 getChatMemory / evictChatMemory,避免进程内记忆无限涨:
java
import dev.langchain4j.service.MemoryId;
import dev.langchain4j.service.UserMessage;
import dev.langchain4j.service.memory.ChatMemoryAccess;

public class EvictMemoryDemo {

    interface Assistant extends ChatMemoryAccess {
        String chat(@MemoryId String memoryId, @UserMessage String userMessage);
    }

    static void endSession(Assistant assistant, String memoryId) {
        assistant.evictChatMemory(memoryId);
    }
}记忆窗口大小没有万能值:withMaxMessages(10) 是教程常用示例。MessageWindowChatMemory 是按条数的滑动窗口,超出上限时先挤掉最旧的消息,SystemMessage 一旦加入就会保留(1.21.0 实测:上限 3,先放 SystemMessage 再放 4 条用户消息,最后剩 system, u3, u4)。它和 evictChatMemory 不是一回事:前者在窗口里淘汰旧消息,后者是把整段会话的记忆删掉。短客服会话可以更小,长文档讨论可能要更大,但别指望单靠加大窗口替代检索,那是下一节 RAG 的职责。窗口过大时,每次请求都会把历史消息再送给模型,延迟和费用一起涨;窗口过小则「用户刚说过的偏好」转眼忘掉。结合产品会话长度做压测,比拍脑袋抄 10 更靠谱。
还有一个实操细节:@MemoryId 的类型可以是 int、String 等;关键是 业务侧保证同一会话始终用同一个 id ,并且结束时 evict。把 HTTP 会话、用户 id、工单号直接当 memoryId 都可以,但要防止「未登录共享 default」和「登出后 id 复用却未 evict」两类串话。
三、@Tool:把可执行能力交给模型
工具就是普通类上的 @Tool 方法,再通过 .tools(...) 注册。教程示例很直白:加减乘除一类纯函数,模型会在需要时发起调用,AiServices 负责执行并回填。
java
import dev.langchain4j.agent.tool.Tool;
import dev.langchain4j.memory.chat.MessageWindowChatMemory;
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.service.AiServices;

public class ToolDemo {

    static class Tools {
        @Tool
        int add(int a, int b) {
            return a + b;
        }

        @Tool
        int multiply(int a, int b) {
            return a * b;
        }
    }

    interface Assistant {
        String chat(String userMessage);
    }

    public static Assistant create(ChatModel model) {
        return AiServices.builder(Assistant.class)
                .chatModel(model)
                .chatMemory(MessageWindowChatMemory.withMaxMessages(10))
                .tools(new Tools())
                .build();
    }
}
工具描述(注解文案或方法名语义)写清楚「做什么、参数含义」,比堆很多模糊工具更不容易误调。工具内部若有副作用(下单、改库),务必在业务层做鉴权与幂等,框架不会替你审计。多工具时保持每个 @Tool 单一职责;把「查天气」和「改配置」塞进同一个巨型方法,既难测也难让模型选对。
成本视角上,每一次暴露给模型的工具都会占用 prompt 配额。文档在「Chaining multiple AI Services」(串联多个 AiServices)一节也强调:用户只是打招呼时,不必把几十个工具一并塞进上下文。能拆成「轻助手 / 重助手」就拆,比一个上帝助手挂满工具更安全,也更省钱。
四、RAG:每次都搜,还是做成 Tool 按需搜
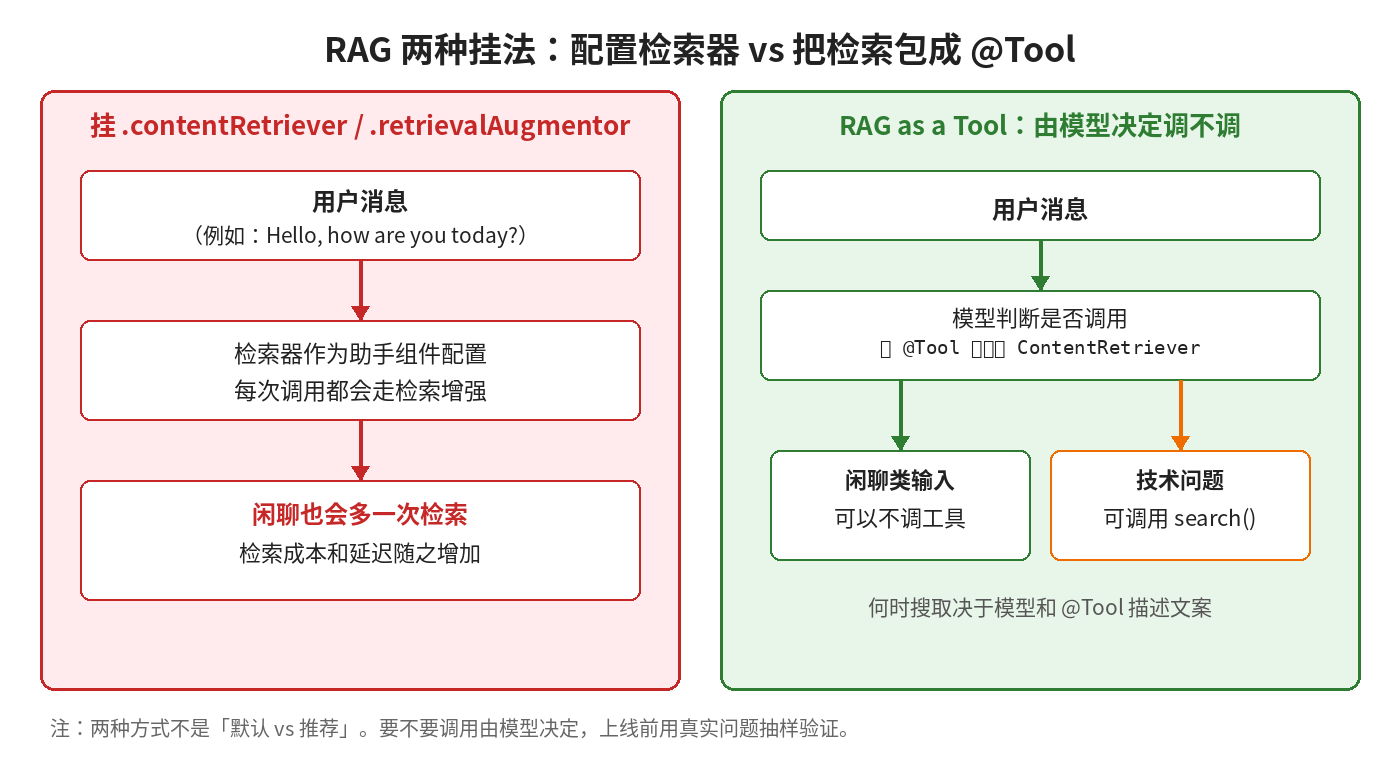
AiServices 支持 .contentRetriever(...) 或 .retrievalAugmentor(...)。默认行为是:每次对话都会走检索。对「知识库问答」很合适;对「你好」「谢谢」这类招呼,则白白多打一轮向量库 / 搜索。
java
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.rag.content.retriever.ContentRetriever;
import dev.langchain4j.service.AiServices;

public class AlwaysRagDemo {

    interface Assistant {
        String chat(String userMessage);
    }

    static Assistant create(ChatModel model, ContentRetriever retriever) {
        return AiServices.builder(Assistant.class)
                .chatModel(model)
                .contentRetriever(retriever)
                .build();
    }
}
需要查询改写、重排等高级能力时,换成 .retrievalAugmentor(...)(例如文档中的 DefaultRetrievalAugmentor)会更灵活;这里的焦点仍是「挂不挂、何时挂」,不展开改写链路的每个子组件。
文档给出的另一条路叫 RAG as a Tool :把 ContentRetriever 包进一个 @Tool,注册进 .tools(...),由模型决定要不要检索。问候可以不搜,真正的知识问题再搜。官方示例的核心写法如下(ContentRetriever 实例由你的嵌入存储提供):
java
import dev.langchain4j.agent.tool.Tool;
import dev.langchain4j.model.chat.ChatModel;
import dev.langchain4j.rag.content.retriever.ContentRetriever;
import dev.langchain4j.rag.query.Query;
import dev.langchain4j.service.AiServices;

import java.util.stream.Collectors;

public class RagAsToolDemo {

    static class SearchTool {
        private final ContentRetriever contentRetriever;

        SearchTool(ContentRetriever contentRetriever) {
            this.contentRetriever = contentRetriever;
        }

        @Tool("Search for technical information about LangChain4j and RAG configurations")
        public String search(String query) {
            return contentRetriever.retrieve(new Query(query)).stream()
                    .map(content -> content.textSegment().text())
                    .collect(Collectors.joining("\n\n"));
        }
    }

    interface Assistant {
        String chat(String userMessage);
    }

    public static Assistant create(ChatModel model, ContentRetriever retriever) {
        return AiServices.builder(Assistant.class)
                .chatModel(model)
                .tools(new SearchTool(retriever))
                .build();
    }
}
文档描述的预期行为也很直观:输入「Hello, how are you today?」时,模型可不调工具;输入「How do I configure a ContentRetriever?」这类技术问题时,再触发 search()。工具上的描述文案会影响「何时搜」,值得认真写,别随手写个 search。
选型可以记成:
| 策略 | 挂法 | 适合 |
|---|---|---|
| 总是 RAG | .contentRetriever / .retrievalAugmentor |
几乎句句都要查库 |
| RAG as Tool | @Tool + .tools |
招呼与闲聊多、知识问答少 |
不要同时「每次检索」又「同库再挂一个搜索 Tool」却不加说明。每多一次检索,上下文变长、响应变慢、费用变高(官方在 Chaining multiple AI Services 一节谈到 RAG 的成本);两层检索会不会互相重复,文档没有专门讨论,这是经验判断,上线前用真实问题抽样看一下。选定一种主路径,在系统提示里写清「何时应调用搜索工具」,比叠两层检索更干净。
五、版本与依赖注意点
入门文档示例版本:
langchain4jlangchain4j-open-ailangchain4j-bom
均为 1.21.0 。用 bom 统一管理时,许多模块仍可能是 1.21.0-beta31 一类 ,API 可能 breaking。升级前看发行说明,别默认「同主版本就二进制兼容」。例如文档 Streaming 一节里的 langchain4j-reactor 就示例为 1.21.0-beta31。
xml
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>dev.langchain4j</groupId>
      <artifactId>langchain4j-bom</artifactId>
      <version>1.21.0</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>

<dependencies>
  <dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j</artifactId>
  </dependency>
  <dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-open-ai</artifactId>
  </dependency>
</dependencies>
示例里的类名、注解均来自官方教程。Agentic 的 @Agent / sequence 不在上面这些依赖结论的范围内。你若已经在用 Agentic 编排,那是工作流层;AiServices 仍适合作为「单助手 + Tool + Memory」的声明式内核,两者不必互相取代。
依赖冲突排查时,优先看 bom 导入是否唯一、是否有旧版 langchain4j 被传递依赖拉进来。锁定 1.21.0 核心工件后,再单独评估仍带 beta 后缀的模块是否本迭代必需。注意 beta 不只出现在你显式声明的模块里:实测 langchain4j-open-ai:1.21.0 自己就传递依赖 langchain4j-reactive-streaming:1.21.0-beta31。
六、小结与评审清单
若你把 AiServices 接到 HTTP 层,建议在过滤器里生成或解析会话 id,再传入 @MemoryId,别让控制器随手拼字符串。超时、熔断、限流仍按普通下游依赖治理:模型调用是 I/O,工具调用可能是更重的 I/O,两者超时要分开配置。联调时先关掉 RAG、只留一个无副作用工具,确认记忆与并发约束无误,再打开检索;分层打开,问题更好定位。
AiServices 把「怎么调模型」收成接口,把「用什么模型、什么记忆、什么工具、是否检索」留给 builder。落地时优先记住:
- 多用户用
chatMemoryProvider+@MemoryId;同 ID 不要并发; - 接口继承
ChatMemoryAccess,用evictChatMemory收尾,防泄漏; @Tool描述写清楚,副作用自己鉴权;工具过多就拆成多个助手;- RAG 默认每次检索;招呼多就改成 RAG-as-Tool(
ContentRetriever包进@Tool); - 版本与 beta 模块的注意事项见第五节,升级前先看发行说明。
按这五条过一遍 PR,比先纠结 prompt 措辞更能减少会话错乱和无效检索。声明式接口稳定之后,再迭代系统提示与检索质量,节奏会顺很多。把「记忆是否会串 / 是否会漏 evict」和「检索是每次还是按需」写成验收项,比只看 Demo 能否跑通更接近生产。
相关阅读:《LangChain4j用Agent拼工作流》。AiServices 是 Tool、Memory、RAG 这一层的声明式接口;那篇讲的是单独发版、带 beta 后缀的 langchain4j-agentic 模块(版本形如 1.20.2-beta30,官方标注为实验性),用来做工作流和 Agent 编排。
封面建议:白底示意图,上方是一块写着 interface Assistant 的面板,下方并排三块,分别是 ChatModel、Memory 加 @MemoryId、@Tool 与 RAG as a Tool,整体以绿色作强调,右下角有「LangChain4j 1.21.0」的小字。