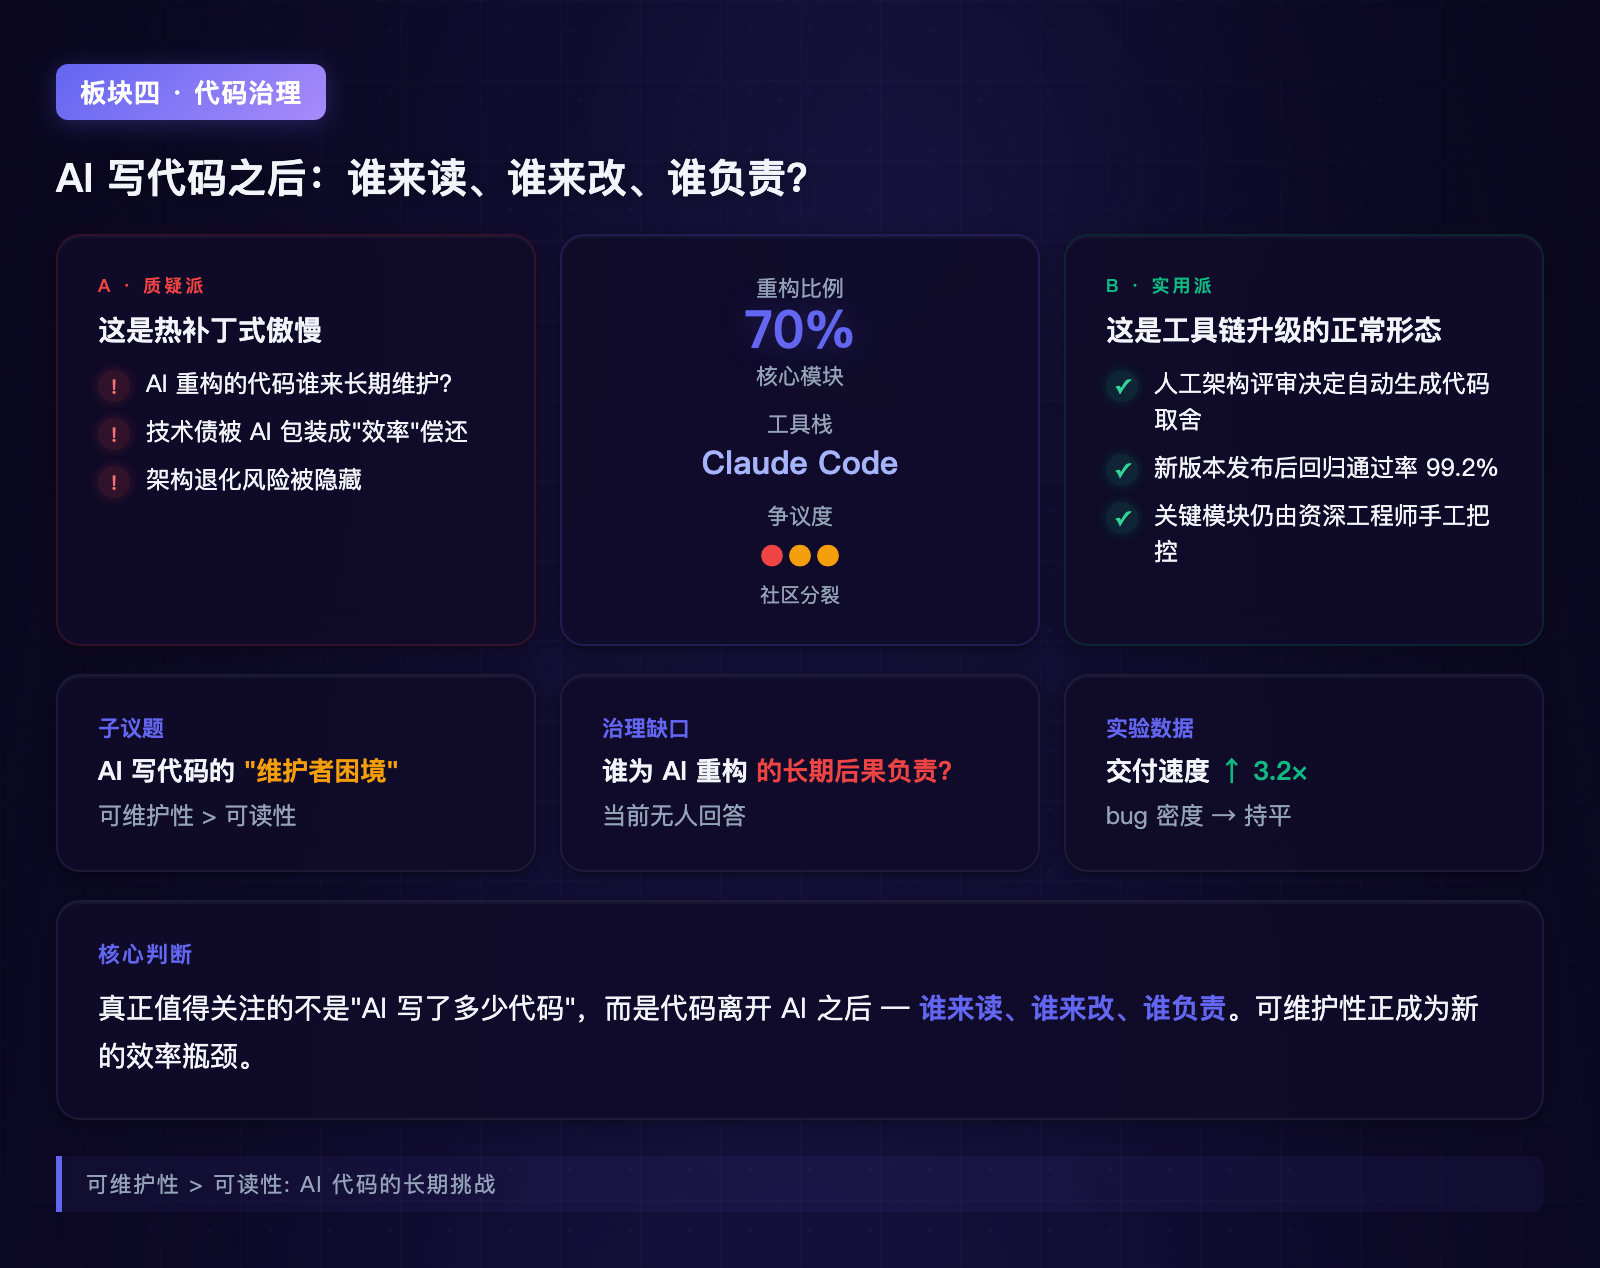
AI 前沿日报 · 2026-09-14
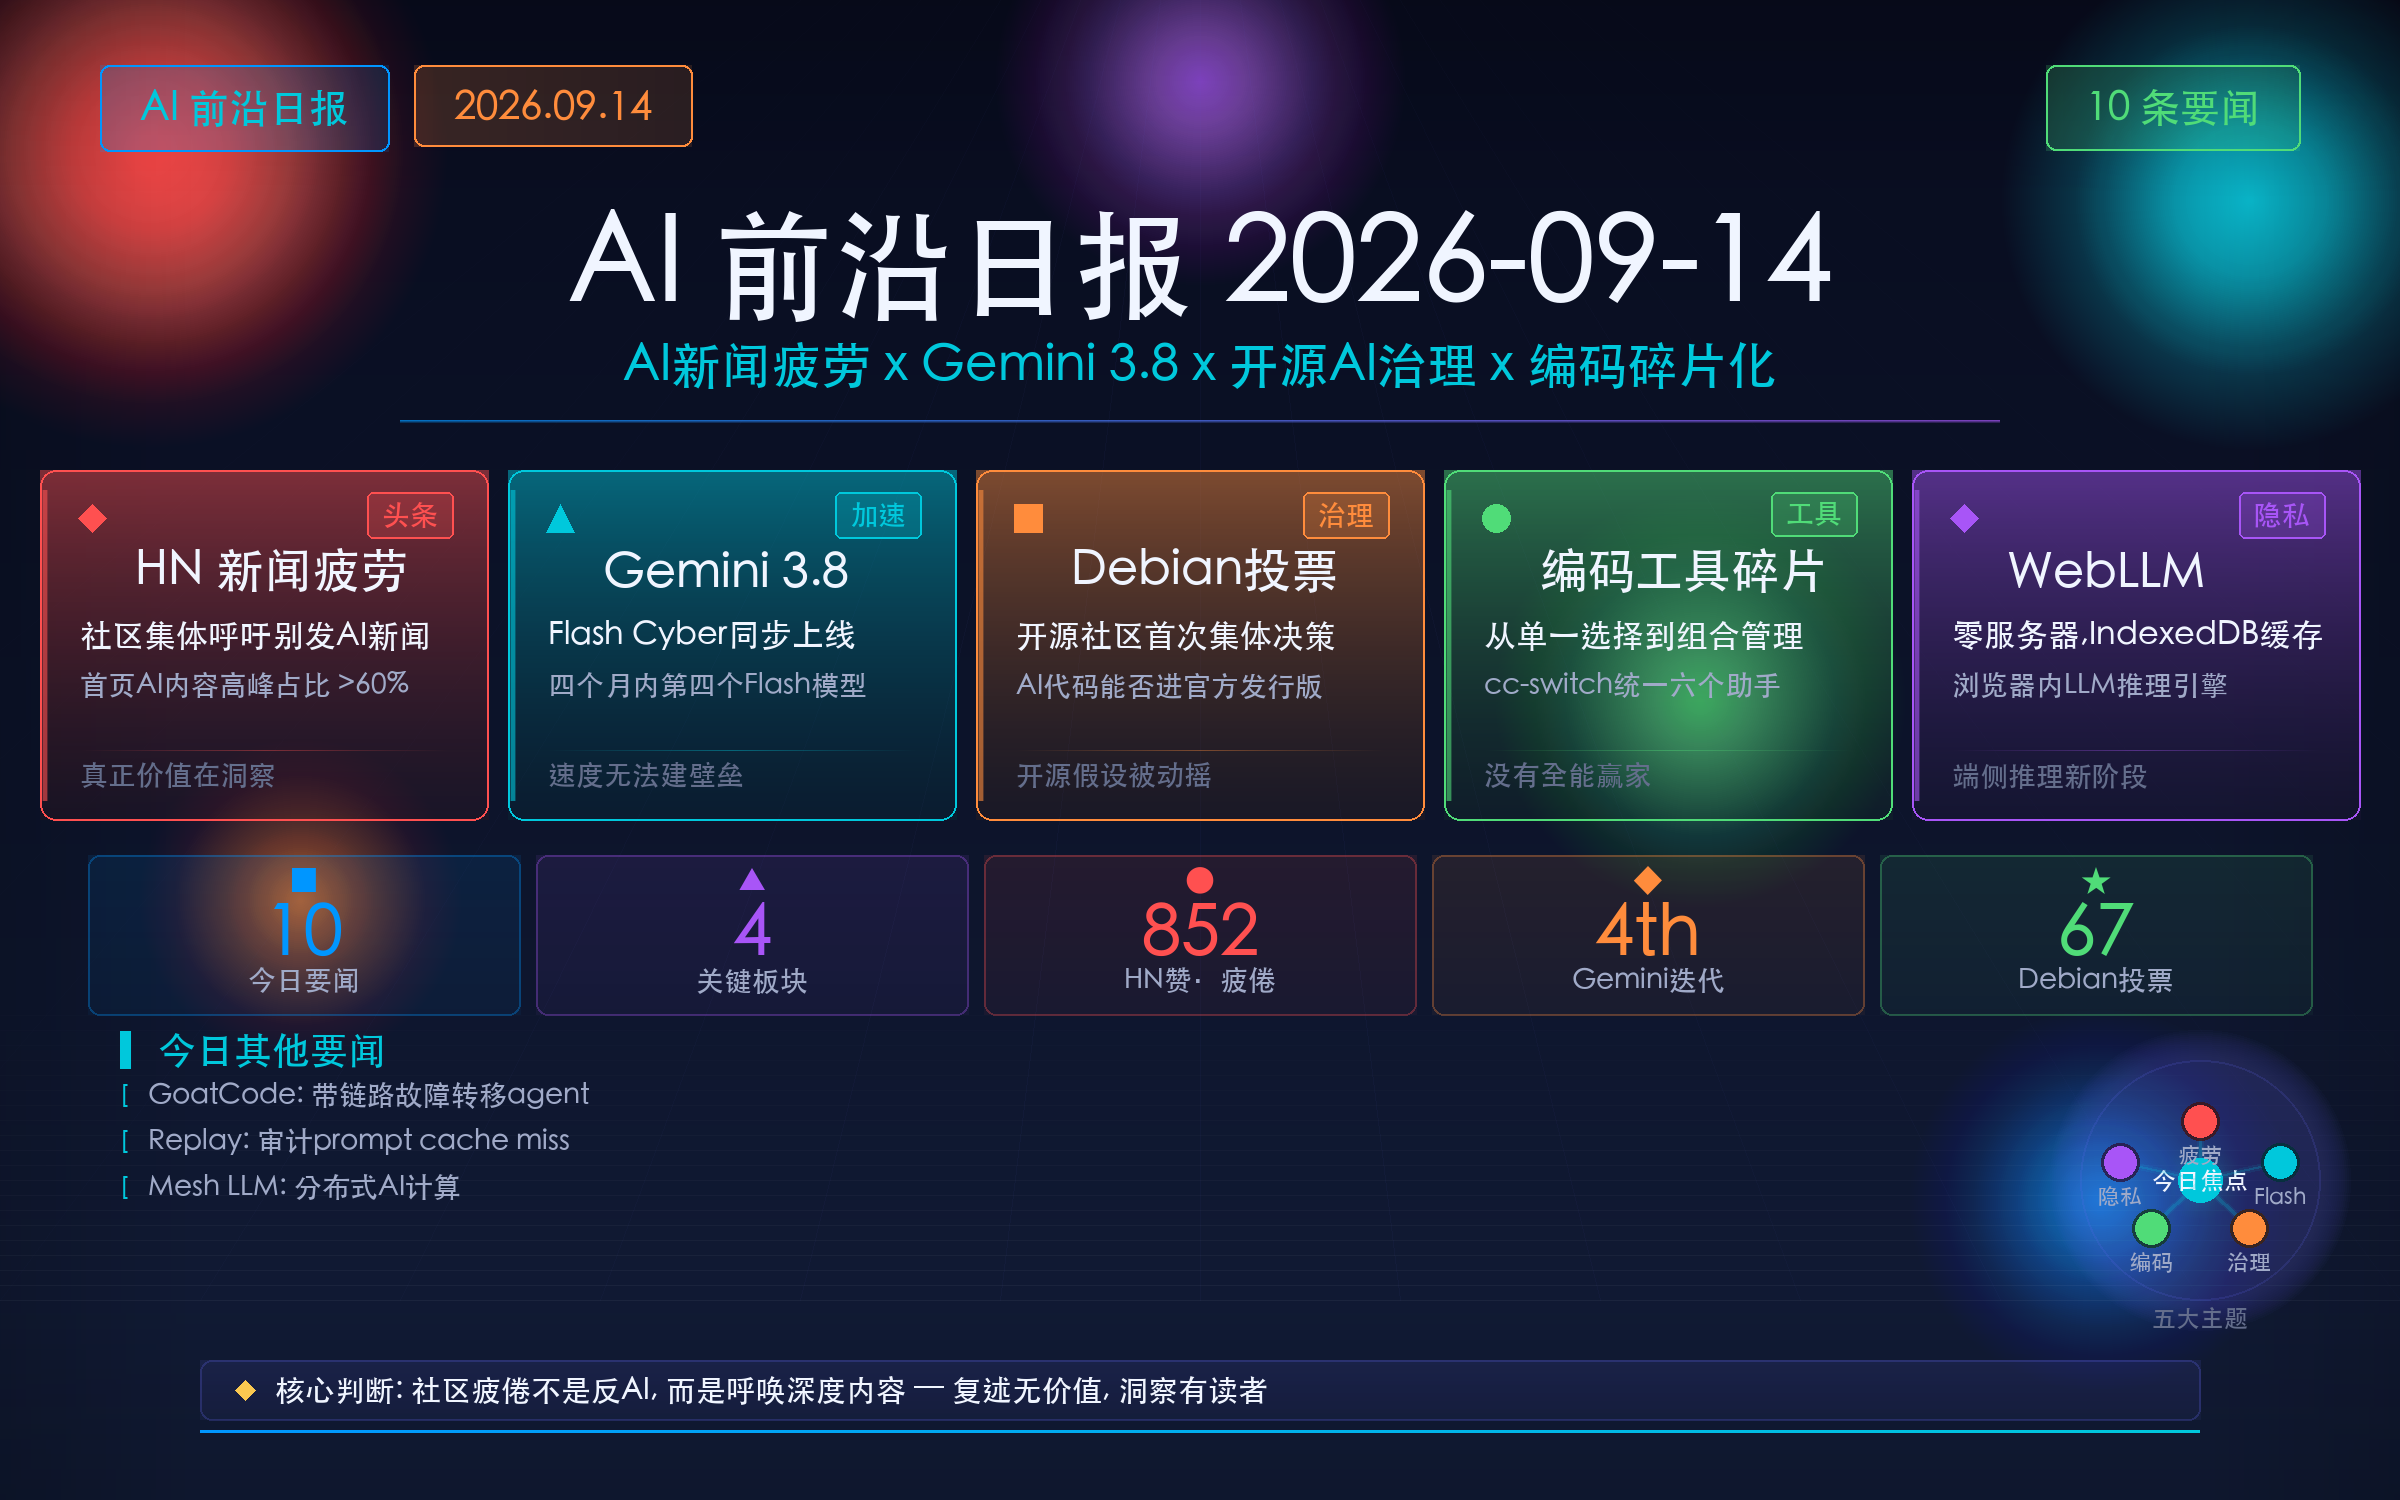
今日主题:当社区开始疲倦,当模型加速迭代,当开放生态被迫做出选择------AI 已进入"不只是新闻多,而是值得读的新闻少"的阶段。
头条:Google 发布 Gemini 3.8 Flash 与 Flash Cyber --- 四个月内第四个 Flash 模型,用户端推理竞赛正在加速
一、模型的代价与反思
1. HN 社区的精神内耗:"能不能别再有 AI 新闻了?"
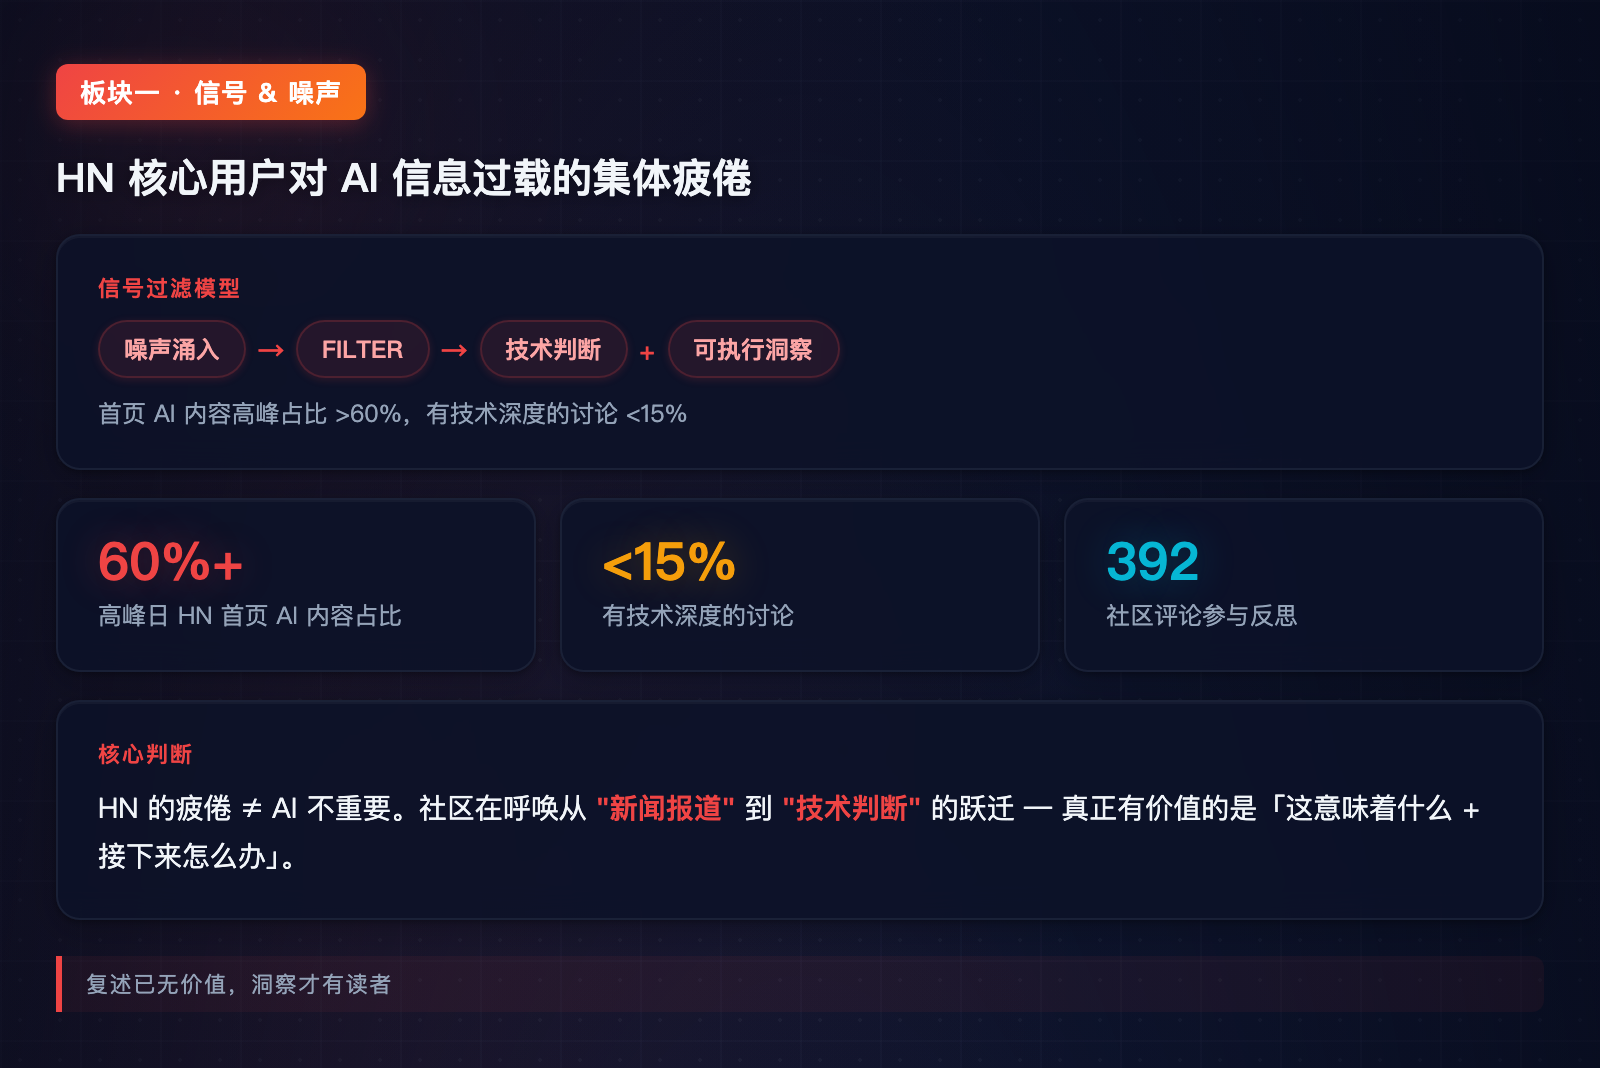
48 小时内,一条"Ask HN"帖子冲上 852 赞、392 条评论,标题只有一句话:"Can we please limit the AI news flood?" 这并非反技术情绪,而是 HN 核心用户群(工程师、CTO、系统设计师)对当前 AI 内容密度的集体不适。
帖子核心问题被反复讨论:
- 信号与噪声的比例失衡:用户反馈 HN 首页 AI 相关内容在高峰日占比超过 60%,其中真正有技术深度的讨论不到 15%,大量内容重复、浅层、或基于同一新闻报道的复述。
- 讨论同质化严重:同一个模型发布,会出现多条标题类似、内容重叠的帖子占据首页,挤压了其他技术话题的生存空间。
- "标题党焦虑":标题用"威胁"、"颠覆"、"末日"等高情绪词制造紧迫感,但正文往往缺乏可执行的技术洞察。
多条高赞评论指向同一个判断:真正有价值的内容不是"AI 做了什么",而是"这意味着什么"和"接下来怎么办"。
核心判断:HN 社区的疲倦不代表 AI 不重要,而是在呼唤一种更深度的内容形态------从"新闻报道"转向"技术判断"。这对内容创作者是一个清晰的信号:复述已无价值,洞察才有读者。
2. Google Gemini 3.8 Flash 发布:四个月内第四个 Flash,加速信号显著
Google 在 Gemini 模型家族中推出 3.8 Flash 与 3.8 Flash Cyber,这是自 2026 年 5 月起算的第四次 Flash 迭代------平均不到两个月一个新版本。Flash 系列原本定位"快速、低成本的用户端推理",但迭代节奏从年度赛跑进入季度竞赛。
关键信息:
- 模型卡片公开:Google 同步公布了详细的模型卡文档(Model Card PDF),涵盖能力边界、安全评估、使用约束------在头部模型厂商中属于为数不多公开细节的案例。
- Cyber 变体同步上线:Flash Cyber 是针对网络安全工作流优化的变体,意味着 Flash 不再只是"便宜快",开始在垂类寻找存在感。
- 社区比较声音:部分开发者指出 Kimi K3 与 GLM-5.3 在特定评测上的表现已超过 Gemini 3.8 Flash,国产模型在用户端推理赛道已不再落后。
核心判断:Flash 的迭代加速,是"用户端 AI 竞赛"的缩影。Google 在用快速迭代防守用户注意力和 API 调用量,但单靠速度无法建立技术壁垒------真正的黏性来自生态锁定与垂直场景的不可替代性。
3. WebLLM:浏览器内的高性能 LLM 推理引擎
一条来自 9 月初的讨论近期收到更多关注:WebLLM 把 LLM 推理直接搬进浏览器,利用 WebGPU + WebAssembly 在本地运行量化后的开放模型(Llama 3、Gemma 2、Phi-3 等),达到可交互的推理速度。
项目亮点:
- 零服务器依赖:推理全程在客户端浏览器中完成,模型权重通过 IndexedDB 缓存,后续访问无需重复下载。
- WebGPU 加速:使用 WebGPU 作为底层计算后端,在支持 WebGPU 的浏览器中(Chrome 113+、Edge、部分 Nightly)可启用 GPU 加速。
- 与 LangChain 集成:项目团队已集成 LangChain.js,允许在浏览器中构建完整的 RAG pipeline。
这不是一次"技术玩具"------它意味着用户端隐私推理正式进入工程阶段:敏感数据永远不需要离开浏览器,这是对"一切上云"逻辑的一次结构性反拨。
核心判断:WebLLM 不是一次技术突破,而是一个临界点:浏览器作为推理运行环境的可行性已被证明,下一步将是"什么时候它能日常可用"。
二、开源社区的技术治理
4. Debian 发起历史性投票:AI 生成的代码,能不能进入官方发行版?
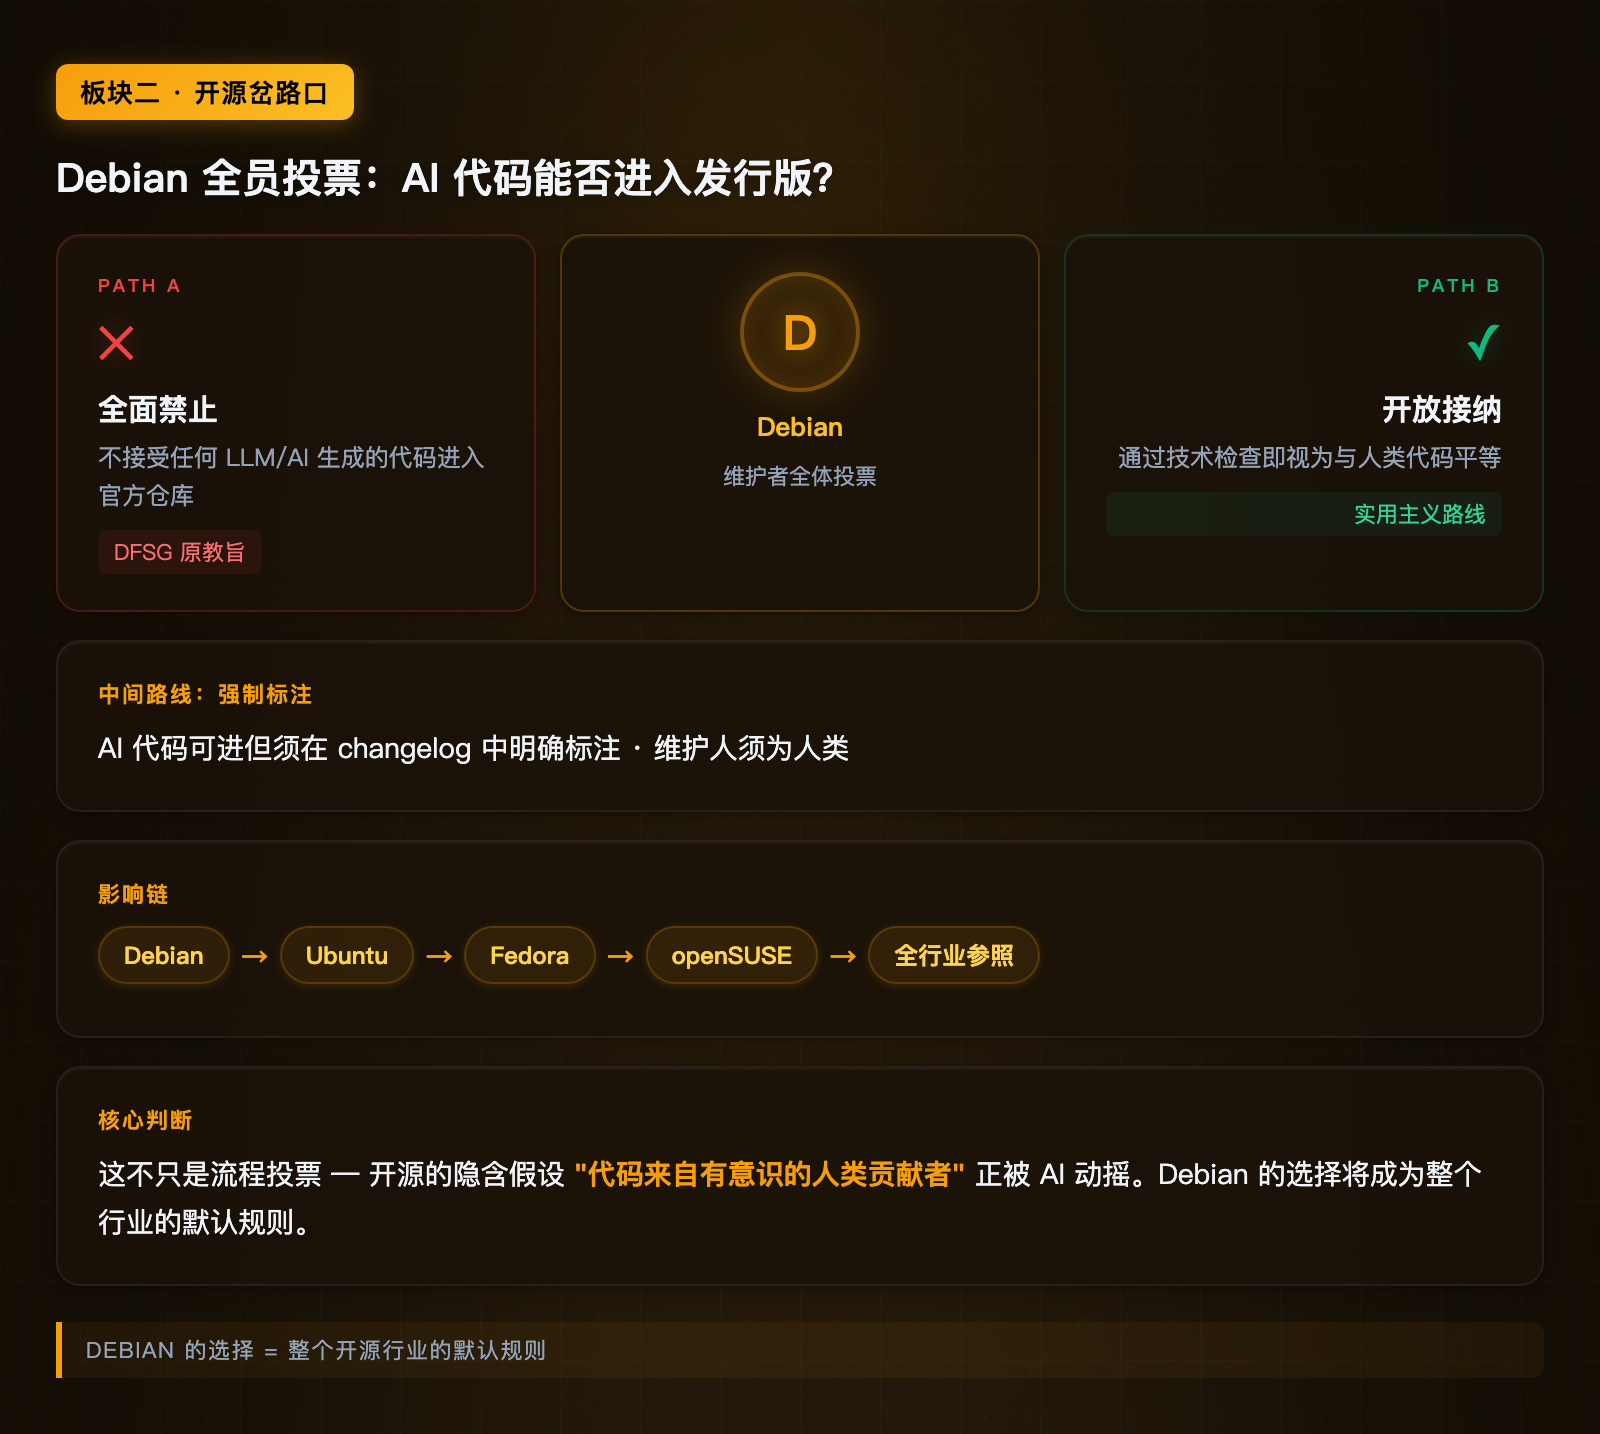
Debian 开发者邮件列表(debian-devel-announce)于 8 月中旬发布了一份关于 AI/LLM 生成代码在 Debian 项目中地位 的正式投票提案,这很可能是主流开源社区首次就"AI 代码进入发行版"做出集体决策。
提案的核心问题被高度压缩成几个可投票的选项:
- 完全禁止:Debian 官方仓库不接受任何由 LLM/AI 工具生成的代码。
- 强制标注:允许接受 AI 生成的代码,但必须在 copyright 文件和 changelog 中清晰标注 AI 贡献部分、工具名称与版本。
- 同等对待:只要代码通过技术评审(符合 DFSG、可维护、符合代码规范),视为与人类贡献平等,不额外标注。
- 禁止维护者角色:AI 代码可进入,但维护人必须是人类,且对代码故障负全责。
该投票的背景非常现实:多名 Debian 维护者已在 patch 提交中发现 LLM 风格的代码痕迹------典型的"教科书注释"、"冗余类型说明"、"对不存在的边界情况的过度防御";更棘手的是版权层面:LLM 训练数据包含大量 GPL 代码片段,AI 生成的代码是否存在"潜意识侵权"风险,目前法律尚无定论。
核心判断:Debian 的投票不只是流程治理,更是开源哲学面对 AI 冲击时的集体身份确认------开源不只是"代码公开",还有一个隐含假设"代码来自有意识的人类贡献者",这个假设正在被 AI 动摇。
5. 从 WebLLM 到 Mesh LLM:分布式 AI 计算的蓝图已在纸上
另外一条引起注意的项目是 Mesh LLM ,基于 iroh(一个 P2P 网络库)实现跨设备的分布式 AI 推理------你可以把家里的旧笔记本、树莓派、甚至备用手机组网,协作完成单个大模型的推理。
这不是"多台机器装同一个模型"的简单堆叠,而是真正的计算任务分割:
- 不同层或不同 token 批被分配给不同设备。
- 设备间通过 QUIC 协议交换中间张量。
- 网络拓扑自动适配------有线设备承担计算重担,无线设备处理轻量层。
当前限制也很诚实:需要同构设备(相同 GPU 架构)才能稳定运行,且通信开销在低带宽环境下会反噬效率。但思路打开了另一扇门:"算力"不一定来自云,也可以来自身边的闲置设备。
三、AI 编码工具碎片化
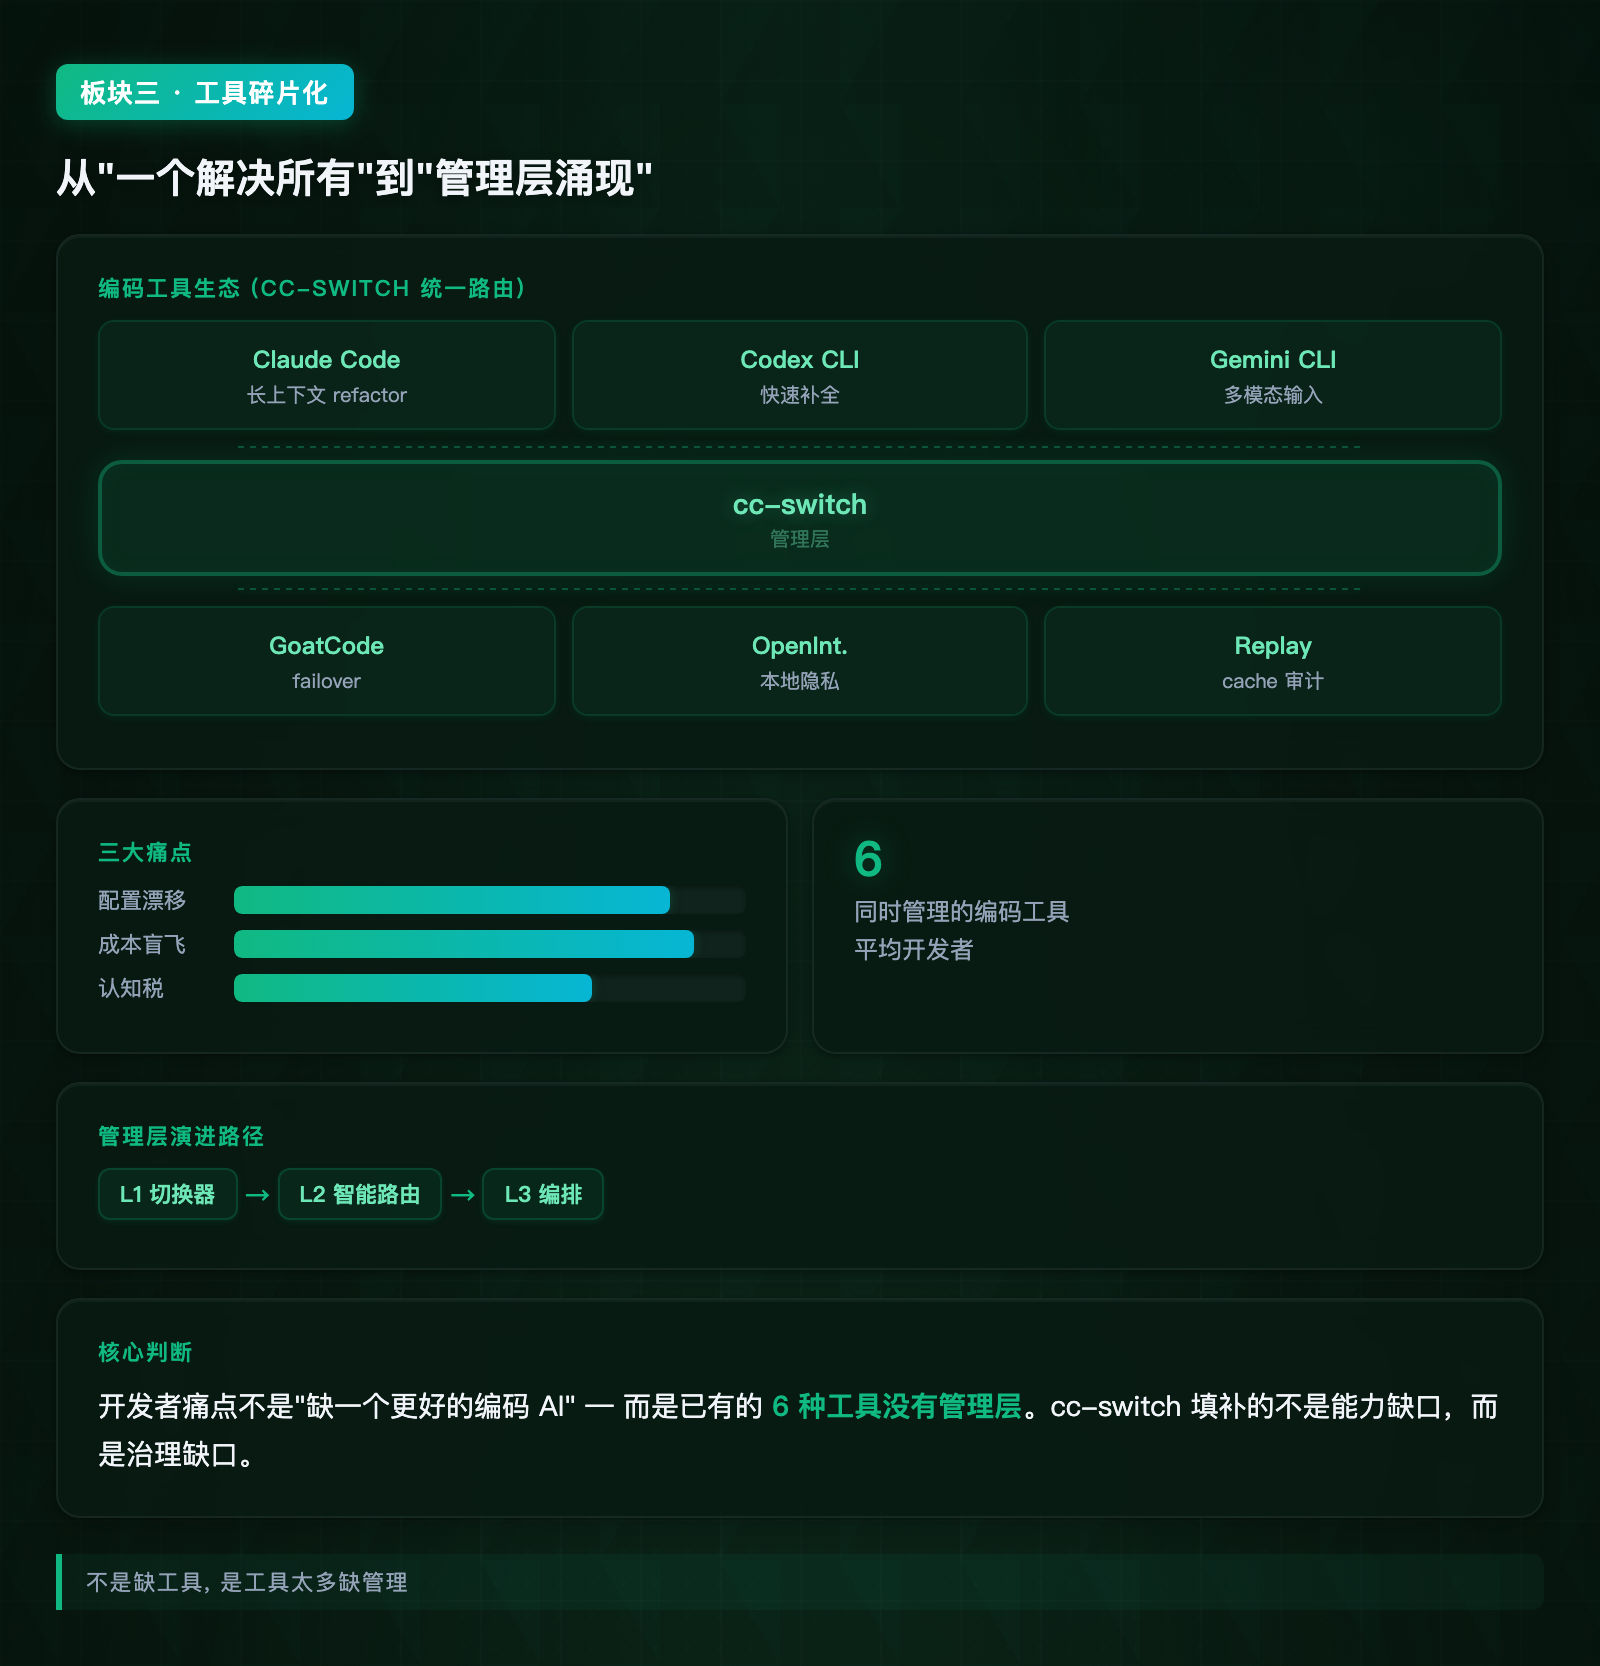
6. cc-switch:一个工具,统一六个 AI 编码助手
如果你同时使用 Claude Code、OpenAI Codex、Gemini CLI、GoatCode、Open Copilot 等多个编码 AI 工具,cc-switch 正是为你而来------它是一个跨平台的桌面管理器,让你一键切换"当前激活的 AI 编码后端"。
核心功能:
- 配置集中管理:不同 AI 工具的 API Key、模型版本、使用限额、端点 URI,可以在同一个面板里配置。
- 使用量追踪:实时显示每个后端的 token 消耗量与费用估算------在多个定价模型并行使用时,这个信息几乎是刚需。
- 快速切换:通过快捷键或托盘图标在 Codex / Gemini / Claude / 自定义工具之间切换。
这个工具的存在本身就是一个信号:AI 编码工具栈正在从"单一选择"走向"组合管理"------没有一家模型在所有任务上都最优,开发者开始像"基金经理管理资产组合"一样管理自己的 AI 工具。
核心判断:cc-switch 不是"又一个编码助手",而是"编码助手的管理层"。它解决了当前开发者真正面对的痛点------不是缺工具,是太多了。
7. GoatCode:带链路故障转移的开源 terminal AI agent
9 月刚上新的 GoatCode 定位为开源 terminal AI agent,但其差异化功能是 provider failover------当一个 AI 后端宕机、限流或响应慢时,任务自动切换到下一个可用提供商。
这个设计思路对比当前生态:
- 大多数 coding agent(无论 Claude Code 还是 Codex CLI)都是单点:后端挂了就只能等。
- GoatCode 的 failover 分两层:请求级重试 (同一后端,指数退避)和 提供商级切换(主用失败切备用)。
- 失败记录会在会话内缓存,避免"反复把同一任务发给已挂掉的提供商"。
这不是技术难点上的突破,而是工程韧性层面的设计思路成熟------当 AI 不再是 demo 而是生产工具,"后端不可用时就只能等"成了不可接受的脆弱性。
8. Replay:审计 AI agent 对话中"静默的 prompt cache miss"
9 月刚发布的 Replay 是一个开发者工具,定位极为具体:审计 AI agent 对话回放中的 prompt cache miss(缓存未命中)------ 也就是那些"模型以为已知、实则丢失了上下文"的隐藏问题。
问题本质:
- 在长对话场景下(agent 会话动辄数十万 token),prompt caching 能显著降低成本和延迟。
- 但缓存一旦 miss(例如输入变化了 1 个 token 导致整个后缀不在缓存中),成本与延迟瞬间暴涨。
- 大多数开发者对此"毫无感知"------因为模型仍然能正确推理,只是钱包在默默燃烧。
Replay 把 miss 高亮成可视化的时间轴,让开发者可以:
- 定位是哪一段对话稳定命中、哪一段频繁 miss。
- 量化每一次 miss 在 token 和美元上的真实代价。
核心判断:当 AI 推理成本开始由"模型定价"主导转向"缓存效率"主导,这种"cache 可观测性"工具会成为 AI 应用开发的必备基础设施。
四、工程实践与代理测试
9. "人类语法为何把 LLM 搞崩":一份技术解剖
一条近期热度上升的技术分享**《Why Human Syntax Breaks LLMs (And How to Fix Agentic Coding)》**提出了一个违反直觉的观察:在一些编码任务中,给 LLM 的 prompt 使用自然英语语法(完整句子、从句结构、被动语态)反而比使用"类代码结构"的伪语言更容易出错。
核心论点:
- LLM 的 transformer 注意力机制在处理结构化短序列(如 JSON、函数签名、注释标签)时定位更准确。
- 自然英语的长距离依赖(从句套从句、代词指代)在百万 token 级别会产生"注意力稀释"------模型在解码关键调用时,有效注意力反而被分散到无关修饰词。
- 实践建议:在 prompt 工程中以"结构化标记+关键词"替代完整叙述,例如用
[INPUT] file.py | [GOAL] add retry | [CONST] max=3替代"Please add a retry mechanism to file.py, maximum three attempts."
这看似是写作风格的问题,实则是对 transformer 注意力机制运作方式的一次实操验证。
10. 开源语音 Agent 测试基础设施:给 AI 打电话
9 月发布的 "simulation testing infrastructure for voice agents" 是一个专为语音 AI Agent 设计的开源测试框架。框架允许开发者:
- 生成多种噪声环境(街道噪声、回声、多人通话、方言口音)。
- 注入"对话干扰"(打断、反问、沉默、话题跳转)。
- 自动化评估 agent 的语义准确率、响应延迟、任务完成度。
在 GPT-4o 等模型大力推广语音交互、各厂商纷纷上线"语音助手 + 工具调用"的当下,这个框架填补了关键技术缺口------语音 Agent 的测试曾是"手动打电话"。
核心判断:语音 Agent 的工程成熟度落后于文本 Agent 大约 12-18 个月。这个测试框架是语音 Agent 从 demo 进入生产的关键基础设施之一。