【核心主旨】:本文深入对比 Agentic RAG 领域最经典的三种架构演进形态:基础检索自纠错(本地循环重搜)、标准 CRAG(双阈值打分 + 联网兜底 + 句子级去噪)与带回环的 Self-RAG(前置门控 + 本地/网络两段式 + 质检回环)。全方位拆解其业务痛点、完整状态流转逻辑、核心实现代码与生产环境工程避坑指南。
一、 架构横向全景对比
在进入具体代码与流程之前,先通过下表建立三种架构的全局认知坐标系:
| 评估维度 | 方案一:基础检索自纠错 | 方案二:标准 CRAG | 方案三:带回环的 Self-RAG |
|---|---|---|---|
| 设计核心理念 | 本地改写死磕:搜不准就换关键词重新搜本地库 | 置信度分流 + 降噪:按分值定策略,引入外援并句子级脱水 | 严谨把关 + 闭环:前置省调用,后置联网结果必须二次安检 |
| 前置检索决策 | 简单判断(检索还是直答) | 不判断,默认必须检索本地库 | 深思熟虑(LLM 评估是否为通识常识题,非必要不查库) |
| 文档评估方式 | 粗粒度二元判定(Good / Bad) | 细粒度三档打分(>0.7 正确 / <0.3 错误 / 中间模糊) | 逐篇文档打标(遍历判断每一篇是否提供有效信息) |
| 检索失败应对 | 改写 Query,回流继续搜本地向量库 | 改写 Query,调用外部搜索引擎(Tavily)拉取新知识 | 改写 Query,调用外部搜索引擎(Tavily)拉取新知识 |
| 知识降噪精炼 | 无(原始文档切片直接塞给上下文) | 句子级粉碎过滤(切碎为单句,LLM 逐句踢出废话) | 简单字符串拼接与过滤后合并 |
| 外部数据信任度 | 不涉及外部数据 | 默认信任(搜索结果直接参与句子精炼) | 绝不轻信(搜回来的网页必须强制回流二次安检) |
| 图拓扑结构 | 单循环有向图(本地重试环) | 单向确定性无环图(DAG) | 双重回环有向图(循环安检环) |
| 死循环风险 | 极高(本地无此知识时会无限死循环) | 零风险(单向流水线,耗时与步数严格可控) | 高(若网络数据持续不相关,无最大轮数限制会卡死) |
| 典型端到端耗时 | 3 ~ 6 秒(受本地重搜轮数影响) | 2 ~ 4 秒(单向并行流水线,稳定) | 5 ~ 12 秒(多次 LLM 串行调用与网络搜索延迟叠加) |
| 适用生产场景 | 涉密不可联网、纯内网本地资料库 | 通用技术支持、企业知识问答主力架构(性价比最高) | 医疗、法律、严谨金融合规审核(对准确度要求极高、不惧延迟) |
二、 方案一:基础检索自纠错(图片流程)
1. 一句话结论
【一句话结论】:针对用户提问不规范导致的检索落空,通过"查完先质检、不合格就换个词重新搜本地"的朴素循环纠正语义偏差。
2. 为什么需要它?(传统单向 RAG 的致命痛点)
传统 RAG 是单向直线管道(Prompt ➡️ 向量检索 ➡️ 拼上下文 ➡️ 生成)。如果用户提问口语化严重、带有错别字或漏掉了核心关键词,向量库可能第一步就召回了一堆风马牛不相及的噪音碎片。传统 RAG 只能硬着头皮把垃圾输入喂给大模型,最终导致大模型一本正经地胡说八道。
3. 底层机制与流向拆解
text
用户提问 (User Query)
       │
       ▼
[智能体决策节点 (AGENT)] ──(无需检索)──► [直接生成答案]
       │ (需要检索)
       ▼
 [本地检索 (RETRIEVE)]
       │
       ▼
 [质量评估 (EVALUATE)]
       │
       ▼
[决策关卡 (Are results good?)]
       ├─────── If Good (合格) ───────► [最终生成 (GENERATE)] ──► 结束
       │
       └─────── If Bad (不合格) ──────► [改写查询 (RE-QUERY)]
                                                │
                                                └───► (箭头回流,重新进入 RETRIEVE)
4. 核心执行逻辑
- 决策分流:Agent 接收用户问题,判断是直接根据常识回答,还是需要进入知识库检索。
- 本地检索:调用向量检索器在私有文档库中提取 Top-K 个分块。
- 质量评估:引入评估节点,让模型充当裁判,裁决召回内容是否足以支撑该问题。
- 纠错回环 :
- 合格(Good):放行进入生成节点,输出最终答复;
- 不合格(Bad) :触发
RE-QUERY节点,将原始问题改写提炼出新的关键词,闭环重新执行检索。
5. 【核心细节与避坑指南】
- 避坑 1(本地盲区引发无限死循环) : 该方案最大的设计缺陷在于只在本地知识库里打转。如果知识库里压根没有收录该领域的任何文档,无论改写大模型多么卖力地变换 100 种搜索词,检索出来的依然是 Bad,系统将直接陷入死循环,直到上下文溢出或超时崩溃。
- 避坑 2(缺乏多维数据源补救手段): 没有接入外部工具(如搜索引擎或结构化数据库),自愈能力单一,只适用于问答范围极其封闭且题库完备的局域网知识库。
三、 方案二:标准 CRAG
1. 一句话结论
【一句话结论】:引入双阈值三档裁决分流,本地知识不足立刻呼叫网络搜索救场,并在生成前用"句子级手术刀"将所有文本粉碎剔除废话,实现绝对可控的单向流水线。
2. 为什么需要它?(解决知识盲区与长文档噪音)
在方案一中,开发者经常面临两大折磨:第一是本地库知识有限,查不到就只能干瞪眼;第二是检索出来的文档动辄几百字,其中只有一两句有用,剩下全是废话,大模型读了很容易产生幻觉。CRAG(Corrective RAG)通过**"外援兜底"与"句子级降噪"**一次性解决了这两个顽疾。
3. 底层机制与流向拆解
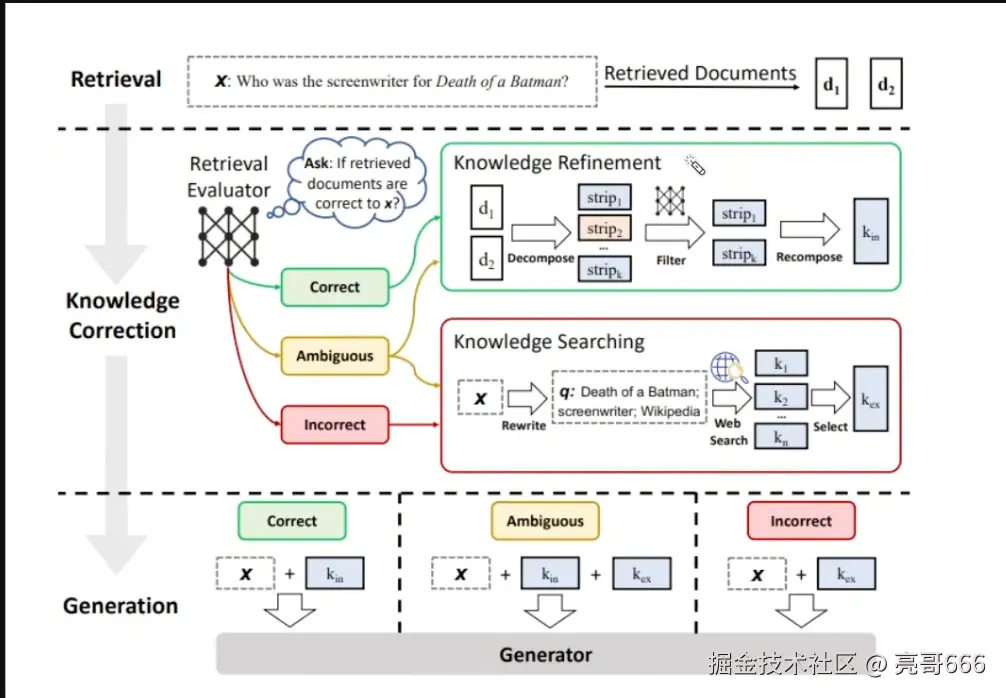
text
START
  │
  ▼
[retrieve (本地检索)]
  │
  ▼
[eval_each_doc (双阈值评分与三档裁决)]
  │
  ├─► [VERDICT: CORRECT (高分合格)] ──────────────────────────────┐
  │                                                                 │
  └─► [VERDICT: INCORRECT / AMBIGUOUS (零分或模糊)]                 │
            │                                                       │
            ▼                                                       ▼
      [rewrite_query (改写为搜索引擎关键词)]                 [refine (知识精炼与降噪)]
            │                                                       ▲
            ▼                                                       │
      [web_search (调用 Tavily 搜索网页)] ──────────────────────────┘
                                                                    │
                                                                    ▼
                                                            [generate (严格基于上下文生成)]
                                                                    │
                                                                    ▼
                                                                   END
4. 核心数据结构与状态机代码实现
(1)全局状态设计(State)
python
class State(TypedDict):
    question: str
    docs: List[Document]         # 本地初筛召回文档
    good_docs: List[Document]    # 本地合格文档
    verdict: str                 # 裁决结果: CORRECT / INCORRECT / AMBIGUOUS
    reason: str                  # 评估打分理由
    strips: List[str]            # 切分出的单句列表
    kept_strips: List[str]       # 过滤后保留的高价值句子
    refined_context: str         # 最终拼接送给模型的无噪音上下文
    web_query: str               # 针对搜索引擎改写的关键词
    web_docs: List[Document]     # 网络搜索召回文档
    answer: str                  # 最终输出文本
(2)双阈值三档评估裁决机制(eval_each_doc_node)
python
UPPER_TH = 0.7   # 高置信度阈值
LOWER_TH = 0.3   # 低置信度阈值

class DocEvalScore(BaseModel):
    score: float  # [0.0, 1.0] 打分
    reason: str

def eval_each_doc_node(state: State) -> State:
    q = state["question"]
    scores: List[float] = []
    good: List[Document] = []

    for d in state["docs"]:
        out = doc_eval_chain.invoke({"question": q, "chunk": d.page_content})
        scores.append(out.score)
        if out.score > LOWER_TH:
            good.append(d)

    # 1. 至少有一篇文档得分超过高阈值:本地完全覆盖
    if any(s > UPPER_TH for s in scores):
        return {"good_docs": good, "verdict": "CORRECT", "reason": f"有分块得分 > {UPPER_TH}"}

    # 2. 所有文档得分均低于低阈值:本地完全不匹配或知识库没有
    if len(scores) > 0 and all(s < LOWER_TH for s in scores):
        return {"good_docs": [], "verdict": "INCORRECT", "reason": f"所有分块均 < {LOWER_TH}"}

    # 3. 介于二者之间:模糊存疑,需要结合本地与外部补充
    return {"good_docs": good, "verdict": "AMBIGUOUS", "reason": "无优质分块但存在弱相关分块"}
【代码解析】:不搞主观的合格/不合格判断,而是通过
0.7和0.3建立明确的数字水位线。大于 0.7 坚信本地;小于 0.3 全面启用网络;在 0.3 到 0.7 之间则实行本地加网络混合。
(3)句子级粉碎去噪(refine 节点)
python
def decompose_to_sentences(text: str) -> List[str]:
    # 正则按标点切分为独立句子,过滤掉过短碎片
    text = re.sub(r"\s+", " ", text).strip()
    sentences = re.split(r"(?<=[.!?。!?])\s+", text)
    return [s.strip() for s in sentences if len(s.strip()) > 20]

def refine(state: State) -> State:
    q = state["question"]
    # 根据裁决决定使用哪个来源
    if state.get("verdict") == "CORRECT":
        docs_to_use = state["good_docs"]
    elif state.get("verdict") == "INCORRECT":
        docs_to_use = state["web_docs"]
    else:  # AMBIGUOUS: 本地弱相关与网络强相关混合补充
        docs_to_use = state["good_docs"] + state["web_docs"]

    context = "\n\n".join(d.page_content for d in docs_to_use).strip()
    strips = decompose_to_sentences(context)

    # 逐句通过 LLM 过滤器检验
    kept: List[str] = []
    for s in strips:
        if filter_chain.invoke({"question": q, "sentence": s}).keep:
            kept.append(s)

    refined_context = "\n".join(kept).strip()
    return {"strips": strips, "kept_strips": kept, "refined_context": refined_context}
【代码解析】:这是 CRAG 的精髓所在。无论本地还是网络搜出的材料,先全部粉碎成单句,由专门的小模型判断每一句是否直接贡献于答案。不相关废话直接扔掉,最后拼出的上下文极度纯净,直接阻断大模型的幻觉诱因。
5. 【核心细节与避坑指南】
- 细节 1(为什么没有回环也能保证质量?) : CRAG 放弃了反复重试的回环,改用单向拓扑流。因为引入了搜索引擎作为兜底,再加上三档分流,绝大多数盲区已被覆盖。单向无环的特性让它在工业界极受青睐,因为它的最大耗时和成本是绝对可预期的,永远不会卡死在某个循环里。
- 细节 2(句子级过滤的模型选择) :
filter_chain需要对每一个句子调一次模型。如果文档较长切出 20 个句子,串行调用会拖慢系统。在生产环境中,必须对句子过滤器采用并发调用(Thread/Async),且必须使用尺寸极小的极速模型(如 gpt-4o-mini 或本地量化小模型)。
四、 方案三:带回环的 Self-RAG(self_rag_web.ipynb)
1. 一句话结论与极简速记看板
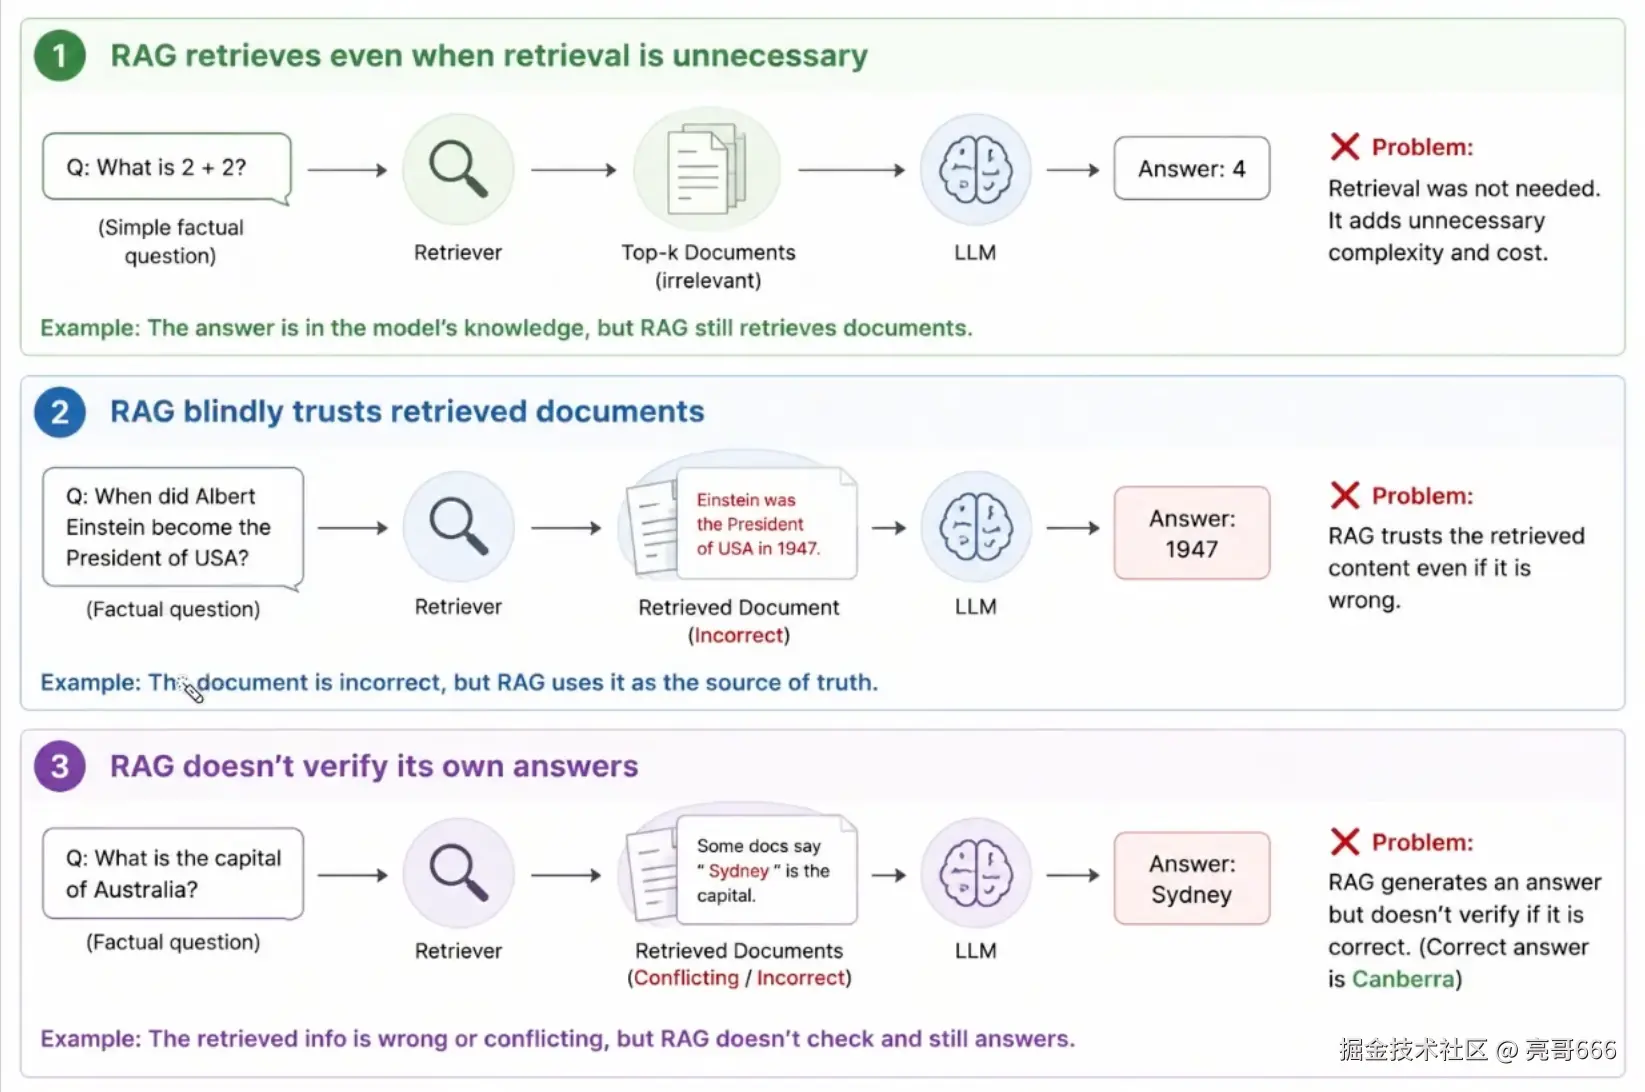
【一句话结论】:前置设卡省调用,后置联网搜出的数据必须打回原形重新安检,打造滴水不漏的双向反思闭环。
💡 【极简速记看板:搞懂 Self-RAG 的"3+1"层安检灵魂】
Self-RAG 流程节点看似复杂,本质上其实只做了 4 道防线把关(3 道主线 + 1 道材料安检)。只要记住这四句大白话拷问,整个复杂逻辑立刻清晰:
text
【查前审问】                【材料安检】                   【产后核据】                  【切题检验】
第 1 层:该不该查? ──► 第 1.5 层:材料相关吗? ──► 第 2 层:答案有证据吗? ──► 第 3 层:回答用户问题了吗?
(解决盲目查/滥用算力) (剔除噪音/纯净上下文) (杜绝胡编/事实抗幻觉) (拒绝避重就轻/防跑题)| 关卡层次 | 把关维度 | 通俗大白话拷问 | 解决的核心顽疾 | 工业落地点 / 节点映射 |
|---|---|---|---|---|
| 第 1 层 | 动作把关 (查前审问) | 到底需不需要查知识库? "常识和简单计算大模型自己就会,何必大费周章查库?" | 解决盲目查库、滥用算力 (节省 1~2s 检索延迟与检索 Token) | decide_retrieval 论文 [Retrieve] 标记 |
| 第 1.5 层 | 材料把关 (材料安检) | 查出来的文档自身到底相不相关? "向量库召回 3 篇文档,2 篇是噪音,废话扔掉只留有用那篇" | 剔除噪音干扰、提纯上下文 (防止脏数据投毒带偏大模型) | is_relevant 论文 [ISREL] 标记 |
| 第 2 层 | 事实把关 (产后核据) | 生成的答案能不能从依据推导出来? "检查初稿每句话,文档没写的内容严禁自作聪明瞎编" | 解决事实幻觉、杜绝胡编捏造 (无证据直接判定打回重写) | is_sup (Groundness) 论文 [ISSUP] 标记 |
| 第 3 层 | 意图把关 (切题检验) | 用户真正问的这个点,你到底回答了没有? "问的是首都却答成了地理面积,哪怕全是真话也是不及格" | 解决避重就轻、答非所问 (跑题立刻触发重写 Query 重查) | is_use (Utility) 论文 [ISUSE] 标记 |
2. 为什么需要它?(诞生背景:官方论文指出的传统 RAG 三大致命硬伤)
Self-RAG(自我反思检索增强)的提出,正是为了彻底根治传统 RAG 在实际落地中的三大经典硬伤:
-
硬伤 1:不该查也硬查(盲目检索,增加延迟与成本)
- 经典反例 :用户问
2 + 2 = ?。大模型内部参数能秒答,传统 RAG 依然机械去向量库搜一堆无关数学文档拼成长上下文。 - 解法 :前置门禁节点
decide_retrieval,常识题直接答,从源头省下检索开销。
- 经典反例 :用户问
-
硬伤 2:盲目轻信检索文档(给啥信啥,被脏数据带偏)
- 经典反例 :用户问
爱因斯坦哪年当选美国总统?。向量库碰巧召回恶搞文章"1947年当选",传统 RAG 照单全收答出1947。 - 解法 :文档质检节点
is_relevant,检索后先派裁判逐篇打标审查,剔除噪音废话,合格才放行。
- 经典反例 :用户问
-
硬伤 3:答完从不检查(管生不管验,答错答偏不自知)
- 经典反例 :用户问
澳大利亚首都是哪里?。检索文档互相冲突,模型误答"悉尼"(应为堪培拉),答完就直接输出给用户。 - 解法 :产后核查(
is_sup+is_use),对照材料自查事实依据并检查是否切题,未通过立刻触发纠错回路。
- 经典反例 :用户问
3. 工程落地杀手锏:产后双验合一与双层纠错闭环
(1)产后双验合二为一(第 2 层与第 3 层合并)
学术论文为了理论严格拆分,把"产后核据(is_sup)"与"切题检验(is_use)"拆成两次 LLM 调用。但生产环境下拆成两次会导致响应变慢 1~2 秒,且输入 Token 浪费一倍。
工业级标准解法:使用 Pydantic 结构化输出,一次调用同时完成事实性与切题度检验!
python
class AnswerAudit(BaseModel):
    is_grounded: bool = Field(..., description="生成的答案是否完全由检索文档支持?严禁胡编")
    is_useful: bool = Field(..., description="生成的答案是否真正切题回答了用户的问题?")
    reason: str = Field(..., description="裁决理由")

# 一次性调用裁判大模型,传一次上下文搞定两项检验
audit_result: AnswerAudit = audit_llm.invoke({
    "question": question,
    "context": context,
    "answer": generated_answer
})

# 极简分支路由:
if audit_result.is_grounded and audit_result.is_useful:
    return "END"                 # 两项全过:完美放行给用户
elif not audit_result.is_useful:
    return "rewrite_question"    # 答非所问(大病):材料不对路,重写问题回流重搜!
elif not audit_result.is_grounded:
return "revise_answer" # 局部微小幻觉(小病):材料对路,原地改词润色!- 工程收益 :
- 首字延迟立省 1~2 秒:直接减少一轮模型网络往返时间;
- 输入 Token 消耗减半:无需把长篇文档与问答上传两次进行重复评审。
(2)微观小闭环 vs 宏观大闭环
通过产后双验,系统实现了两套粒度完全不同的自纠错回路:
- 【小闭环:微观防幻觉原地润色】(
is_sup 🔁 revise_answer) : 材料完全相关,仅答案有小瑕疵或个别断言无依据。直接在内存中让 LLM 原地修改错句,改完后再次复验,无需重新检索,成本极低。 - 【大闭环:宏观答非所问回流重搜】(
is_use ➡️ rewrite_question ➡️ retrieve): 答案没有假话,但根本没切中用户要害(避重就轻)。说明检索召回的材料方向错了,触发改写问题并向上回流重射回检索器,重新发起全局知识检索。
【核心口诀】:
Think ➡️ Judge ➡️ Answer Better(查前审问省算力,材料安检除噪音,产后双验合一防幻觉与跑题,微观原地润色、宏观回流重搜!)
4. 底层机制与流向拆解
(1)实战代码拓扑流(self_rag_web.ipynb 联网回环模式)
text
START
  │
  ▼
[decide_retrieval (前置门禁: 要不要查?)]
  │
  ├─► should_retrieve = False ──► [generate_direct (模型常识直答)] ──► END
  │
  └─► should_retrieve = True
            │
            ▼
      [retrieve (本地知识库检索)]
            │
            ▼
    ┌─► [is_relevant (文档相关性质检关卡)]
    │       │
    │       ├─► 存在相关文档 ────────► [generate_from_context] ──► END
    │       │
    │       └─► 完全不相关 / 查无结果
    │                 │
    │                 ▼
    │           [rewrite_query (重写关键词)]
    │                 │
    │                 ▼
    │           [web_search (联网搜索)]
    │                 │
    │                 └───► (强制回流 Circle Back 重新进入 is_relevant 安检!)
(2)理论完全体状态机拓扑流(LangGraph 四大关卡 + 双层闭环架构)
text
               [_start_]
                  │
                  ▼
        [decide_retrieval] (关卡 1: 该不该查?)
          /              \
 (无需查) /                \ (需要查)
        ▼                  ▼
[generate_direct]     [retrieve] (执行向量库检索)
        │                  │
        │                  ▼
        │            [is_relevant] (关卡 2: 资料相关吗?)
        │             /          \
        │     (不相关)/            \ (相关)
        │           ▼              ▼
        │   [no_answer_found]  [generate_from_context] (生成初稿)
        │           │              │
        │           │              ▼
        │           │         [is_sup] (关卡 3: 答案有事实依据吗? 防幻觉)
        │           │          /    ▲
        │           │ (有幻觉)/      │ (修改完再验)
        │           │        ▼      │
        │           │    [revise_answer] ───【小闭环: 原地微调改词,不重搜】
        │           │        │
        │           │ (有依据) accept_answer
        │           │        ▼
        │           │     [is_use] (关卡 4: 真正解答用户问题了吗? 切题度)
        │           │     /      \
        │           │(切题)        \(答非所问)
        │           │ /            ▼
        │           │/      [rewrite_question]
        │           │              │
        │           │              └───► 向上回流射回 [retrieve]! ───【大闭环: 宏观重写重搜】
        ▼           ▼
      └─────► [_end_]
5. 核心数据结构与状态机代码实现
(1)全局状态设计(State,与代码 1:1 对应)
python
class State(TypedDict):
    question: str
    need_retrieval: bool         # 是否需要检索的布尔标记
    docs: List[Document]         # 待质检的文档池 (本地检索或网络搜索都会覆写此字段)
    relevant_docs: List[Document] # 经质检确认有用的文档列表
    context: str                 # 拼装后的上下文内容
    answer: str                  # 最终回答
    web_query: str               # 改写后的网络搜索 Query
(2)前置门控判断(decide_retrieval)
python
class RetrieveDecision(BaseModel):
    should_retrieve: bool = Field(
        ...,
        description="如果需要外部文档/特定事实才能回答则为 True,通用定义或常识解释为 False"
    )

def decide_retrieval(state: State):
    decision: RetrieveDecision = should_retrieve_llm.invoke(
        decide_retrieval_prompt.format_messages(question=state["question"])
    )
    return {"need_retrieval": decision.should_retrieve}
【代码解析】:第一道大门。面对"什么是冒泡排序"、"写一首诗"等通识性问题,直接返回
False走模型自身内部常识直接回答,不碰向量库,省下 100% 检索耗时。
(3)多文档质检打标(is_relevant)
python
class RelevanceDecision(BaseModel):
    is_relevant: bool = Field(..., description="文档是否对回答该问题有帮助")

def is_relevant(state: State):
    relevant_docs: List[Document] = []
    # 逐篇扫描(无论是本地文档还是联网拿回来的文档)
    for doc in state["docs"]:
        decision: RelevanceDecision = relevance_llm.invoke(
            is_relevant_prompt.format_messages(
                question=state["question"], document=doc.page_content
            )
        )
        if decision.is_relevant:
            relevant_docs.append(doc)
    # 过滤出真正合格的文献池
    return {"relevant_docs": relevant_docs}
(4)网络搜索与数据覆写(web_search_node,回环衔接点)
python
def web_search_node(state: State):
    q = state.get("web_query") or state["question"]
    results = tavily.invoke({"query": q})

    docs = []
    for r in results or []:
        text = f"TITLE: {r.get('title', '')}\nURL: {r.get('url', '')}\nCONTENT:\n{r.get('content', '')}"
        docs.append(Document(page_content=text, metadata={"source": "web"}))

    # 关键机制:将网络结果覆写进 state["docs"],让后续回环节点能够无缝复用 is_relevant
    return {"docs": docs}
(5)核心状态图构建与回流回环(Circle Back)
python
# 构建 LangGraph 图拓扑
g = StateGraph(State)

g.add_node("decide_retrieval", decide_retrieval)
g.add_node("generate_direct", generate_direct)
g.add_node("retrieve", retrieve)
g.add_node("is_relevant", is_relevant)
g.add_node("generate_from_context", generate_from_context)
g.add_node("rewrite_query", rewrite_query_node)
g.add_node("web_search", web_search_node)

# 1. 前置条件路由
g.add_edge(START, "decide_retrieval")
g.add_conditional_edges(
    "decide_retrieval",
    route_after_decide,
    {
        "generate_direct": "generate_direct",
        "retrieve": "retrieve",
    },
)
g.add_edge("generate_direct", END)

# 2. 检索流向质检
g.add_edge("retrieve", "is_relevant")

# 3. 质检分流:有合格文档就生成,没有就去重写联网
g.add_conditional_edges(
    "is_relevant",
    route_after_relevance,
    {
        "generate_from_context": "generate_from_context",
        "rewrite_query": "rewrite_query",
    },
)

# 4. 关键回环机制:网络搜完后,绝不直接生成,而是强制打回重新质检!
g.add_edge("rewrite_query", "web_search")
g.add_edge("web_search", "is_relevant")  # 回环重检 (Circle back)

g.add_edge("generate_from_context", END)
【代码解析】:重点看倒数第二行
g.add_edge("web_search", "is_relevant")。这是该架构的灵魂所在!网络搜索返回的docs被原样塞入质检节点,必须再接受一次is_relevant的残酷审问,只有被证实确实相关的网页片段,才准许流向generate_from_context。
6. 【核心细节与避坑指南】
- 避坑 1(死循环熔断器缺失 ------ 致命隐患) : 在原版
self_rag_web.ipynb中,如果网络搜索出来的结果依然被判定为is_relevant=False,路由会再次流向rewrite_query再次搜索,导致图陷入无限死循环!- 【正确改法】 :生产环境中必须在
State中加入重试计数器loop_count: int。在route_after_relevance中做硬性限制:若loop_count >= 2,强制终止循环并流向兜底提示,严禁裸跑无界循环。
- 【正确改法】 :生产环境中必须在
- 避坑 2(多轮 LLM 串行延迟累加): 如果本地有 4 篇文档,网络又搜出 5 篇文档,逐篇质检相当于调用了 9 次大模型。如果不采用异步批处理,首字延迟会直接突破 10 秒。
五、 真实业务架构选型落地指南
在工程研发中,架构并不是越复杂越好。选择哪种方案,取决于业务对**"响应速度"、 "API 预算成本"与"准确率底线"**的平衡:
text
                                  【业务需求决策树】
                                          │
                  ┌───────────────────────┴───────────────────────┐
                  ▼                                               ▼
         [内部封闭场景 / 绝不联网]                         [开放场景 / 允许网络补充]
                  │                                               │
      ┌───────────┴───────────┐                       ┌───────────┴───────────┐
      ▼                       ▼                       ▼                       ▼
【简单垂直手册】         【用户提问口语化】              【追求高并发极速响应】     【严肃专业严谨合规】
  (标准固定FAQ)           (问不准、常少词)               (客服/企业助手/查账)       (医疗/法律/深度研报)
      │                       │                       │                       │
      ▼                       ▼                       ▼                       ▼
 [传统基础 RAG]         [方案一: 检索自纠错]             [方案二: 标准 CRAG]       [方案三: 回环 Self-RAG]
 (单向0思考,秒回)       (本地 Re-Query 循环)            (双阈值+句子降噪,性价比高)  (强制二次安检,防外部污染)
1. 优先推荐:将"方案二(CRAG)"作为企业主力架构
在企业真实落地中,方案二(CRAG)是性价比和稳定性最好的平衡点。它具备单向流水线的可预测性(永远不会死锁),自带双阈值安全降级,同时具备句子级去噪和外部搜索能力,是开发商业问答系统最不容易翻车的基石。
2. 混合实战:引入轻量路由的"快慢双车道"
如果想兼顾方案三的省钱优势,最佳工程组合拳是:
- 在外层挂一个 轻量意图分类器 (类似方案三的
decide_retrieval):把打招呼和常识过滤掉; - 内层需要检索的复杂任务,走 方案二(CRAG 的单向管道);
- 只有当系统被明确用于法律合同审计、医疗文献对齐时,才开启 方案三的带计数器质检回环(Circle Back)。
六、 终局演进:多意图拆解与动态路由统一架构(工业级完全体)
1. 一句话结论
【一句话结论】:针对用户复合多问场景,先由拆解器化整为零,再通过意图路由器并发派发到各专业通道,最后由聚合器汇总合体,彻底解决单选路由器的死穴。
2. 统一架构流程图(无 Emoji 规范版)
3. 架构三大阶段运转说明
- 阶段 1:化整为零(拆解器 Decomposer) :
- 用户输入复合问题(例如:"北京今天天气如何?查下上月销售冠军是谁,以及公司的年假政策")。
- 模型将其拆解为 3 个独立子任务对象,包含各自独立的查询词与预估意图。若仅有单一意图则直接透传,跳过拆解耗时。
- 阶段 2:各司其职(并发多路路由 Fan-out) :
- 子任务 1 走天气 API 工具通道;
- 子任务 2 走 Text-to-SQL 通道,经由语法树审计后连接只读从库计算;
- 子任务 3 走 Self-RAG 通道进行向量比对与反思校验。
- 各通道在后台完全并行异步执行,总耗时仅取决于耗时最长的单个通道。
- 阶段 3:聚沙成塔(聚合器 Synthesizer) :
- 汇总各通道局部事实,消除矛盾点,组织为格式工整、条理清晰的自然语言完整答复。
4. LangGraph 并发扇出核心代码模式(Fan-out / Send)
python
from langgraph.constants import Send
from pydantic import BaseModel
from typing import Literal, List

class SubTask(BaseModel):
    sub_query: str
    intent: Literal["direct", "simple_rag", "self_rag", "text_to_sql", "external_api"]

class DecomposeResult(BaseModel):
    tasks: List[SubTask]

def route_subtasks(state: OverallState):
    # 核心分发逻辑:拆出多少个子任务,瞬间并发派发给对应管道节点
    return [Send(task.intent, {"query": task.sub_query}) for task in state["tasks"]]

# 在工作流中绑定条件并发边
workflow.add_conditional_edges("decomposer_node", route_subtasks)
【代码解析】:无需构建多个相互开会聊天的独立智能体(Multi-Agent),直接利用 LangGraph 原生的
Send机制实现状态图级别的轻量并发扇出,兼具极高的性能与最低的 Token 消耗。