【简介】在LM Studio上测得Qwen3.8-Flash-Next速度为37 tokens/s,这个速度一个人勉强,多人用就不够了,那有没有办法加快速度呢?
 模型平台
上一篇文章,虽然测得Qwen3.8-Flash-Next性能基本能满足要求,但是在长时间测试的时候Mac系统重启了一次。这不得不让我有再重新找过大模型的想法了。
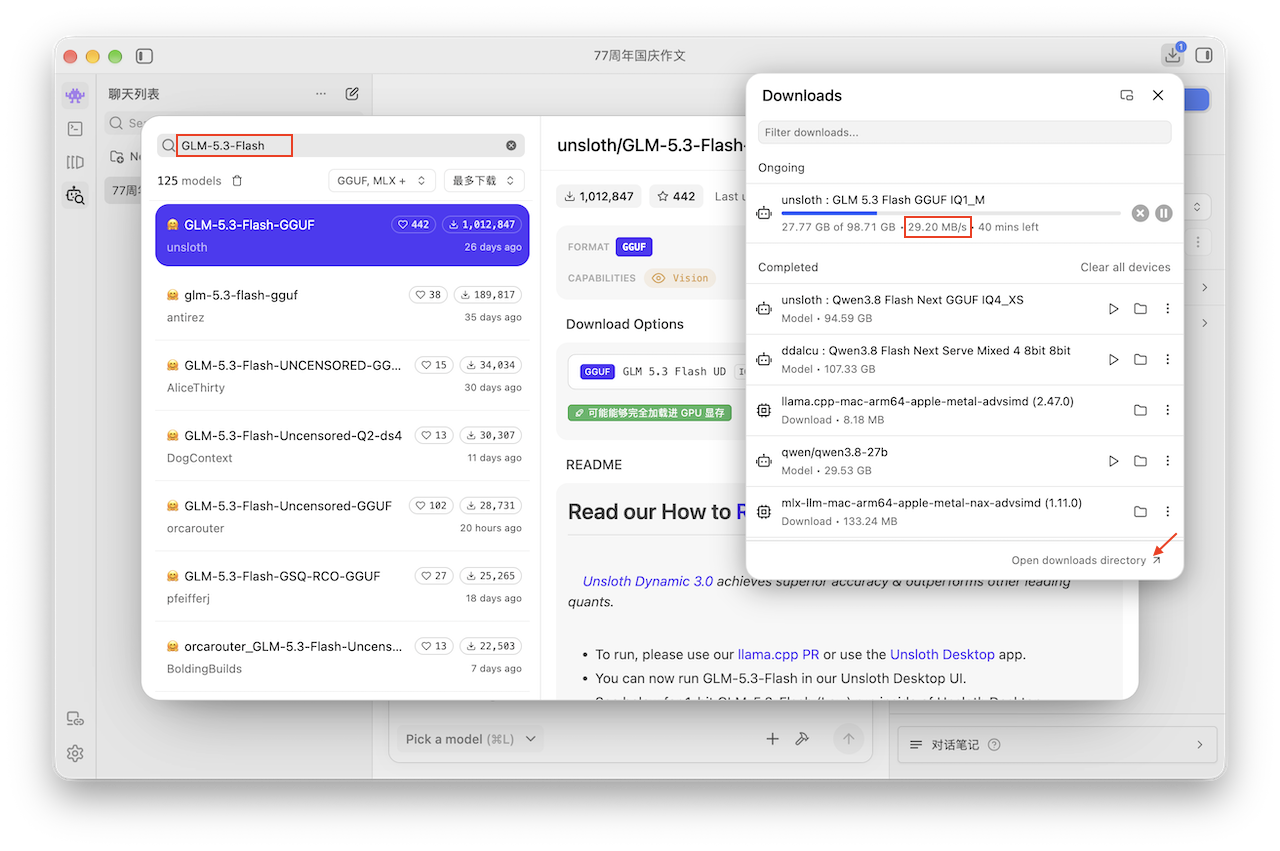
① 再次让ChatGPT推荐大模型,选择了GLM-5.3-Flash,下载的是98.71GB的版本,这里发现一个诀窍,就是早上下载时的速度最快。无意中看见在下载界面可以进入到下载目录,点击【Open downloads directory】。
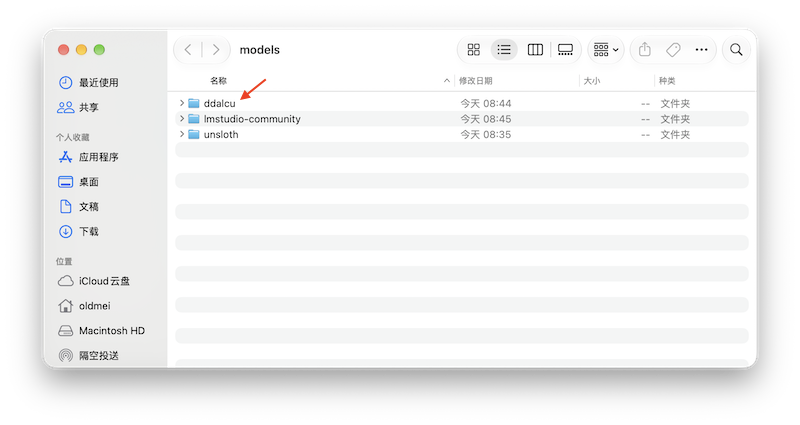
② 原来LM Studio并不是将所有模型放在同一目录下,可以根据模型类别分别存放,我们点击【ddalcu】。
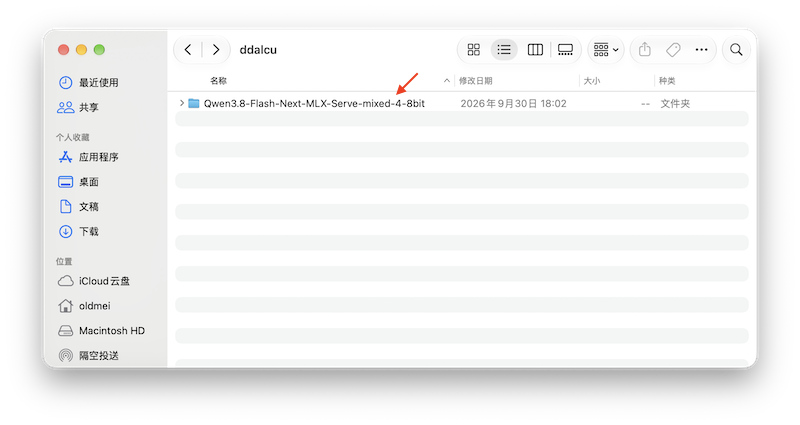
③ 这里存放的是前面下载的Qwen3.8-Flash- Next-MLX-Server-mixed-4-8bit模型,由于体积太大(107GB),无法在LM Studio下使用,可以在Max-Serve下使用。
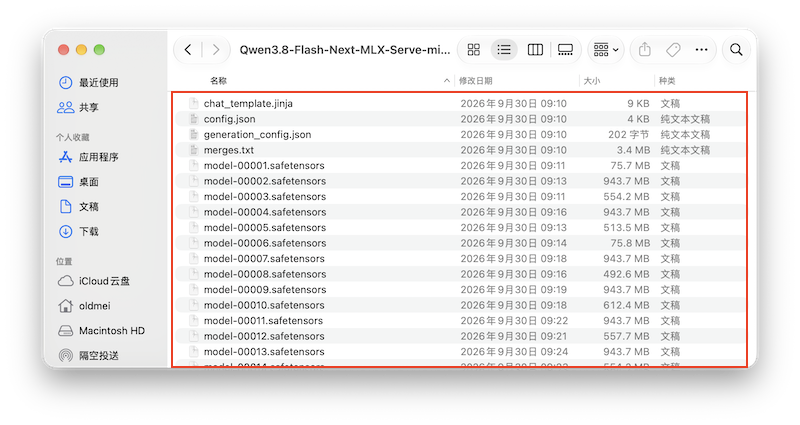
④ 该模型由许多小文件组成。那么什么是ddalcu?
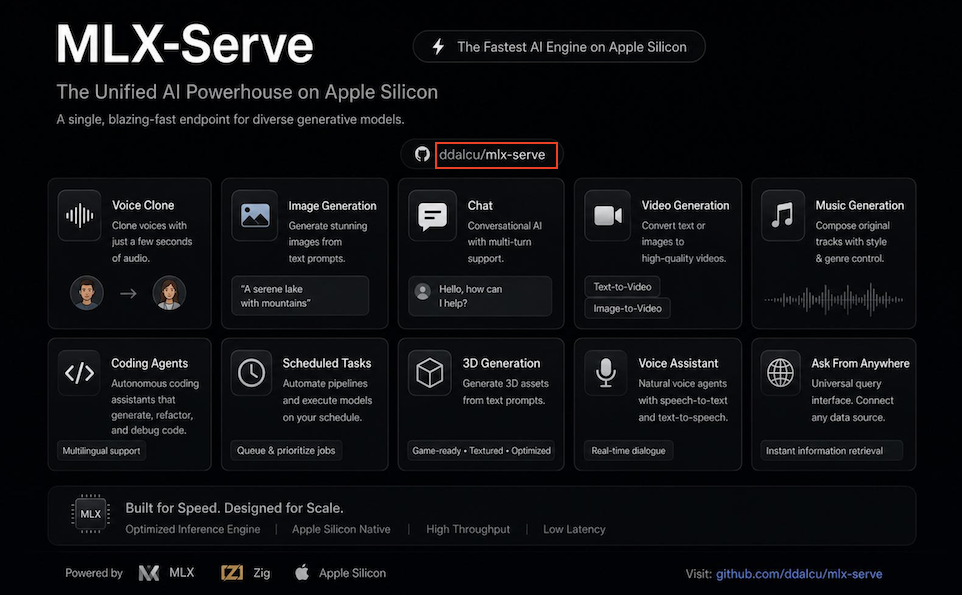
⑤ ddalcu其实是GitHub用户名,在本地模型圈子里能看到它,基本都是指ddalcu/mls-serve这个项目。mlx-serve是专门给Apple Silicon(M系列Mac)做的原生本地大模型推理服务。表示这个大模型在mlx-serve下使用。
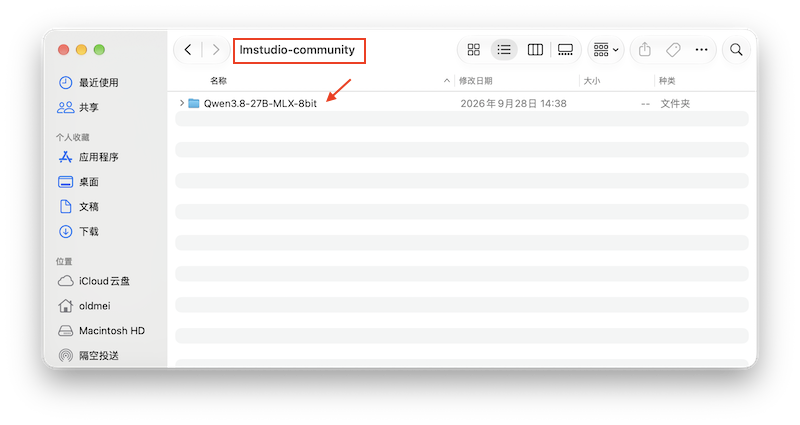
⑥ 再看看lmstudio-community目录,里面是我们第一个下载的Qwen3.8-27B-MLX-8bit模型。
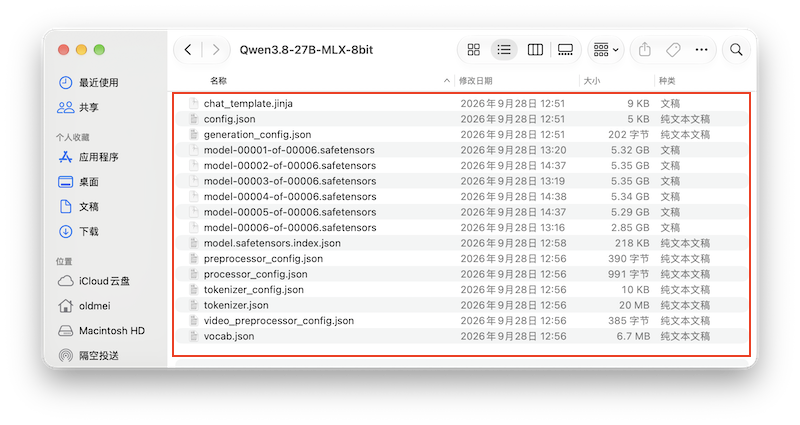
⑦ 这个模型是我们运行的第一个本地大模型,只有30多G,也是有很多小文件组成。那lmstudio-community又是什么呢?
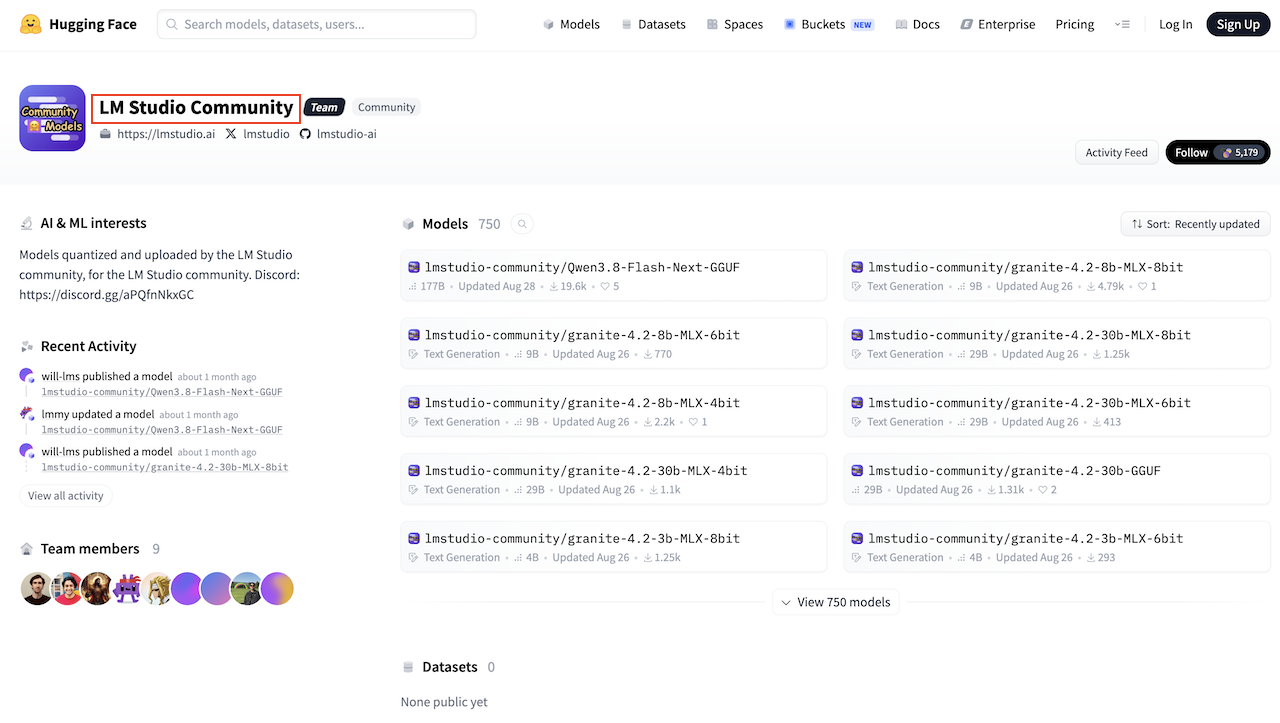
⑧ lmstudio-community是Hugging Face上的一个组织帐号,专门存放社区量化好、直接适配LM Studio的模型。它是由社区爱好者、贡献者把原版开源大模型做量化(GGUF/MLX格式),上传到这个组织下,目标就是开箱即用,直接在LM Studio里面搜索下载,不用自己本地量化模型。
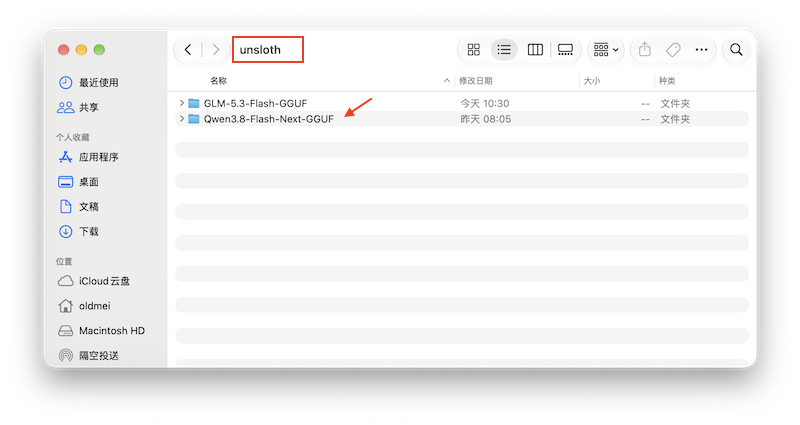
⑨ 最后看看unsloth目录,有两个大模型,一个是昨天测试OK的Qwen3.8-Flash-Next-GGUF,另一个就是刚下载的模型,我们先看看Qwen3.8目前里有啥。
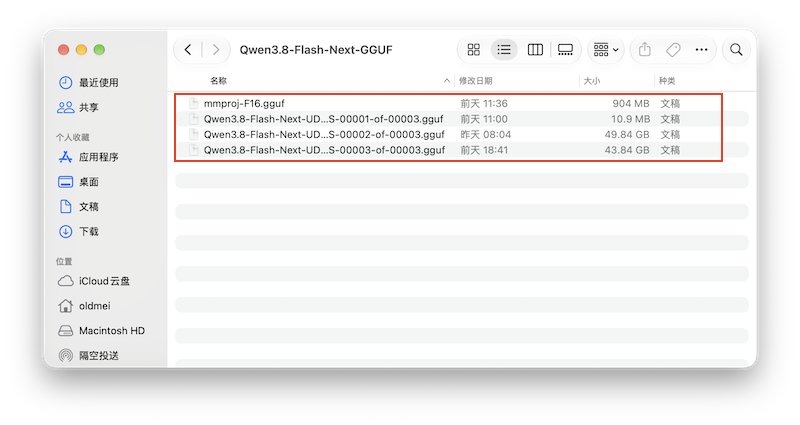
⑩ 这里面就比较简单了,除了将近100GB的模型拆成3个主模型文件,还有一个专门处理图片的文件。
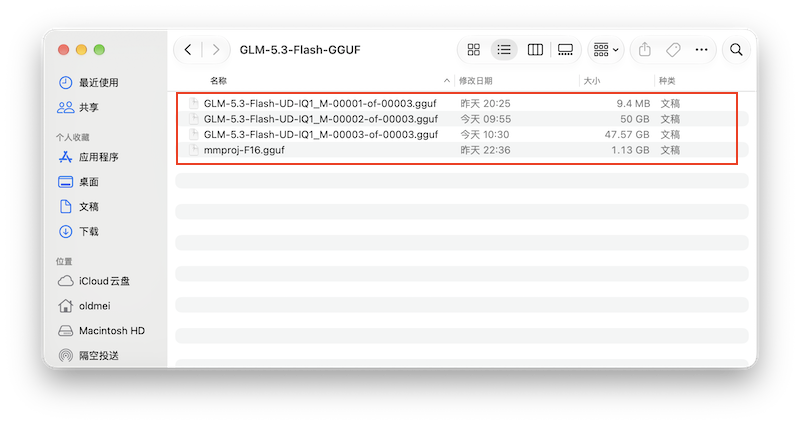
⑪ 另一个刚刚下载,还没来得及测试的GLM 5.3大模型,里面的文件结构也是一样的。那么unsloth又是什么呢?
⑫ Unsolth是本地大模型圈非常火的开源项目,两件核心东西:Python微调库+Unsloth Desktop(桌面GUI),HuggingFace上也有unsloth模型组织帐号。最早出名是微调(Fine-tune),同样的硬件、微调显示存少约60%,速度快2倍,适合做模型二次调教、做私有Agent、知识库定制。
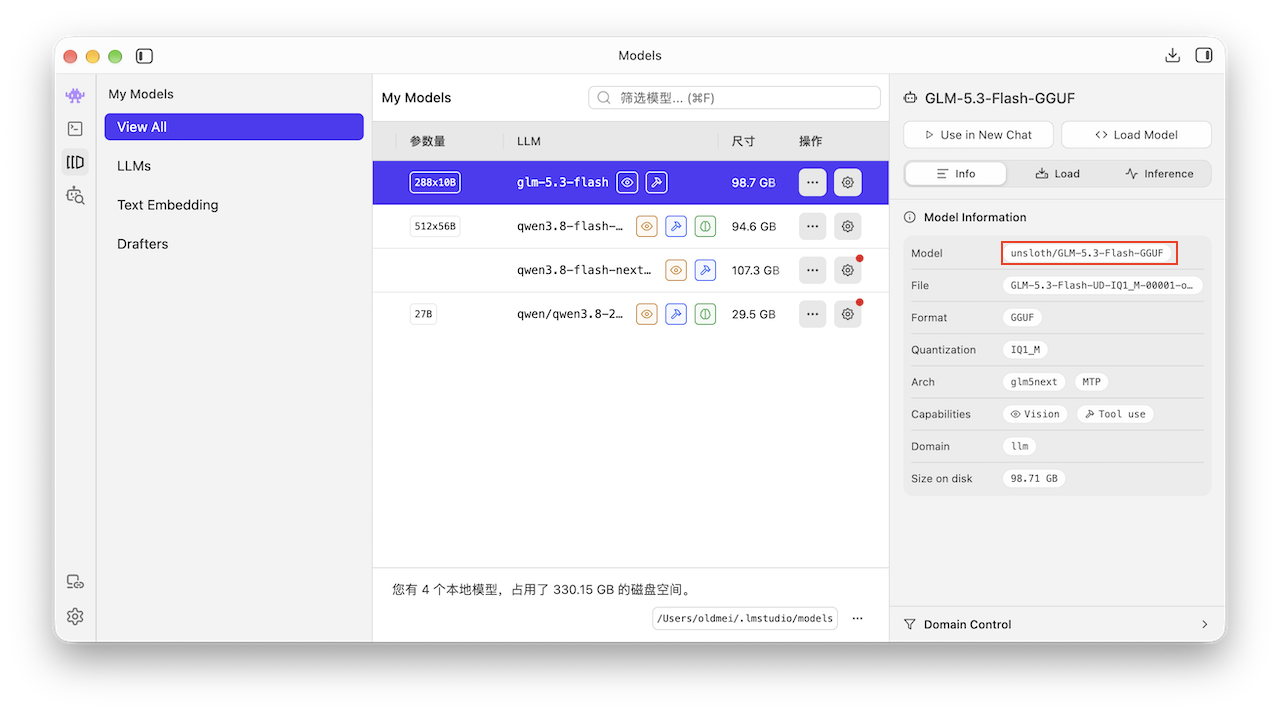
⑬ unsloth/前缀的模型,在Unsloth团队自己量化打包的GGUF模型,这些GGUF模型LM Studio、mlx-seve、llama.cpp、Ollama全都可以加载,这就是为什么上一篇文章可以在LM Studio使用Qwen3.8-Flash-Next模型的原因了。
【总结】
现有工具对比:
● mlx-serve: 主打Apple Silicon原生MLX推理,Zig写,侧重高性能推理服务
● LM Studio: 跨平台GUI,GGUF/MLX双引擎,模型商店友好
● Unsloth Desktop: 即能跑推理,又能直接在本机做模型微调,自带UD系列高质量GGUF,也支持图像/视频生成
 Unsloth 下载与安装
即然Unsolth Desktop这么厉害,那么我们来试试。
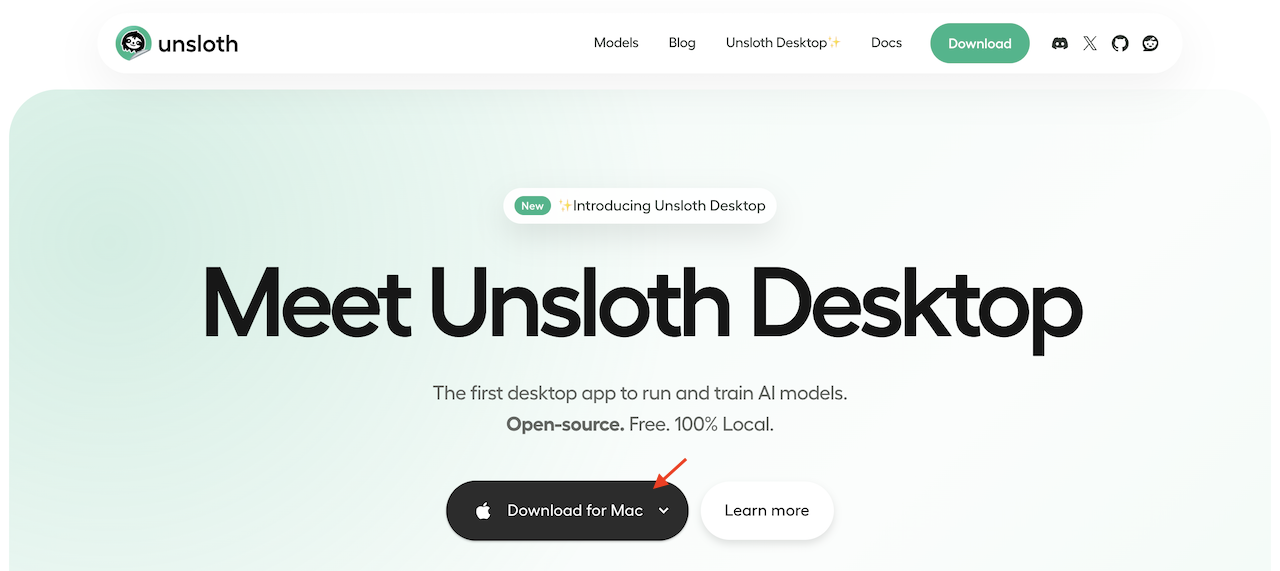
① unsloth(unsloth.ai)首页点击【Download for Mac】。
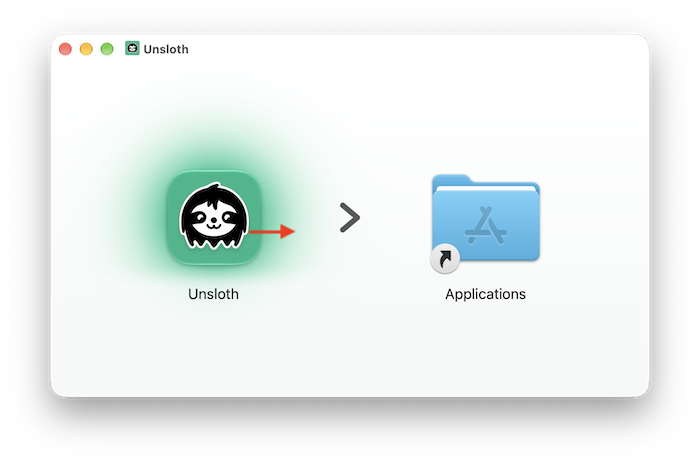
② 双击下载后的安装文件,弹出窗口,拖动Unsloth到Applications。
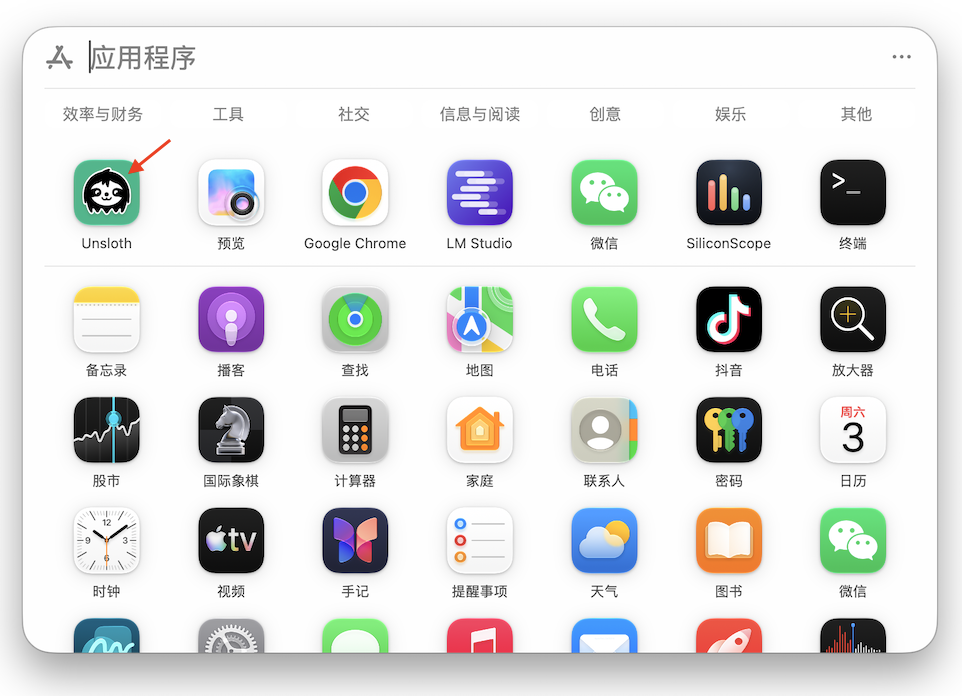
③ 打开Launchpad(启动台),点击Unsloth图标。
④ 出现unsloth安装提示,点击【Get Started】。
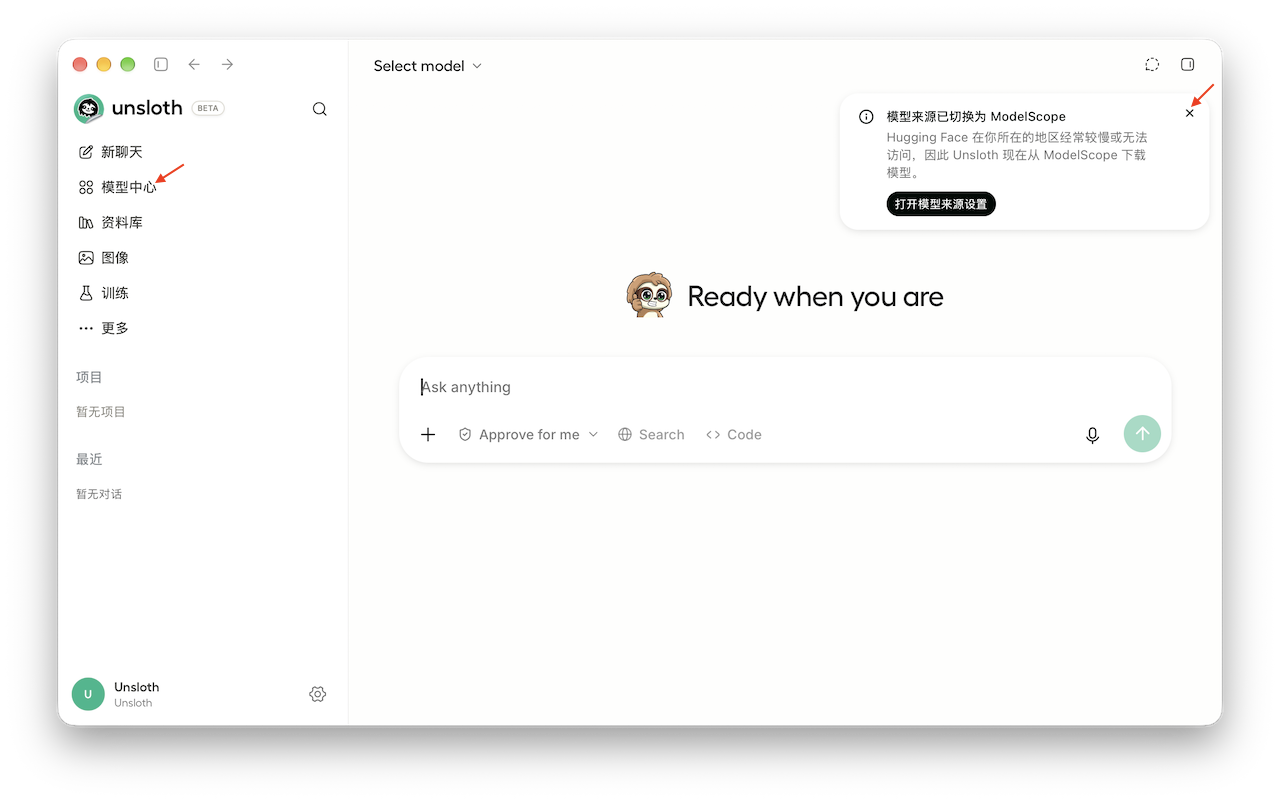
⑤ 经过几分钟耐心的等待,unsloth安装完成进入主介面。提示模型来源切换成ModelScope,这里关闭提示,点击菜单【模型中心】。
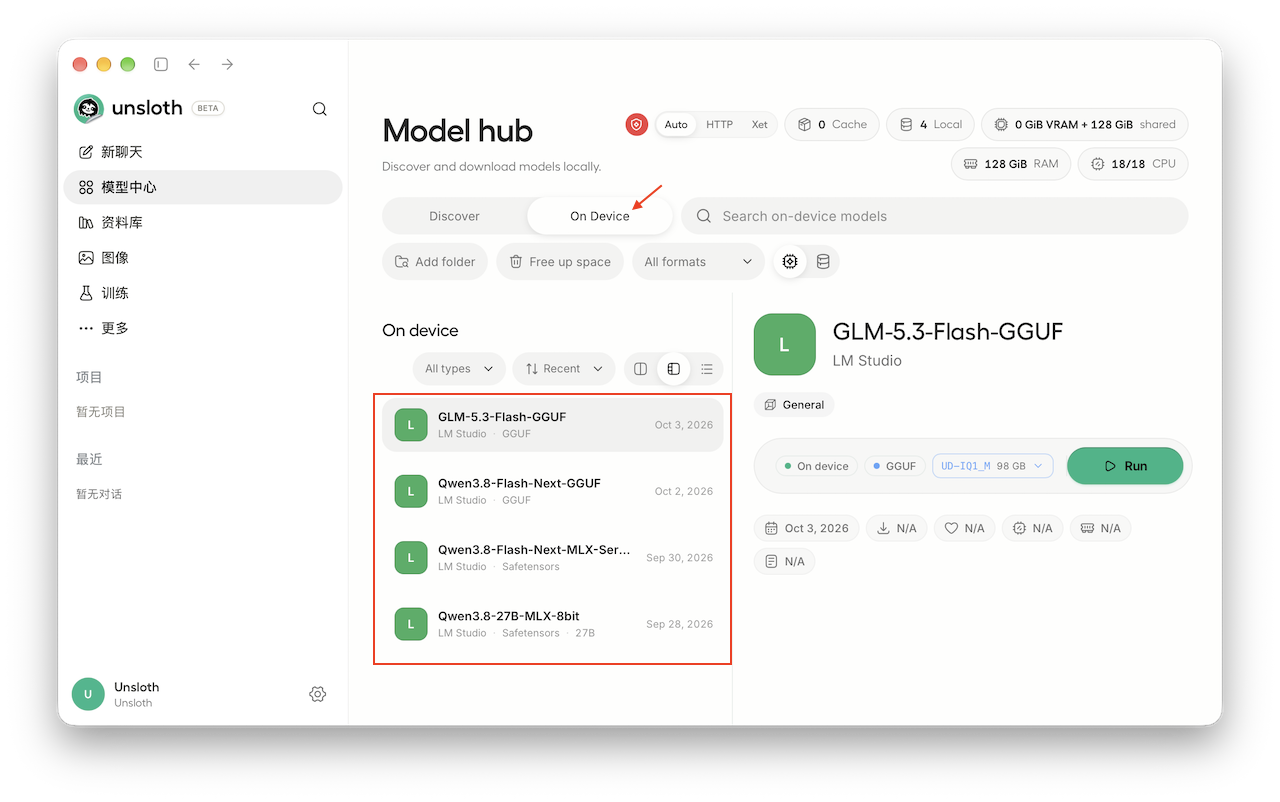
⑥ 点击【On Device】,惊奇的发现竟然已经找到LM Studio下载的四个模型文件,这个非常友好,得加分。
 Unsloth 模型装载与测试
为了能装下近100GB的模型,我们需要空出内存来。
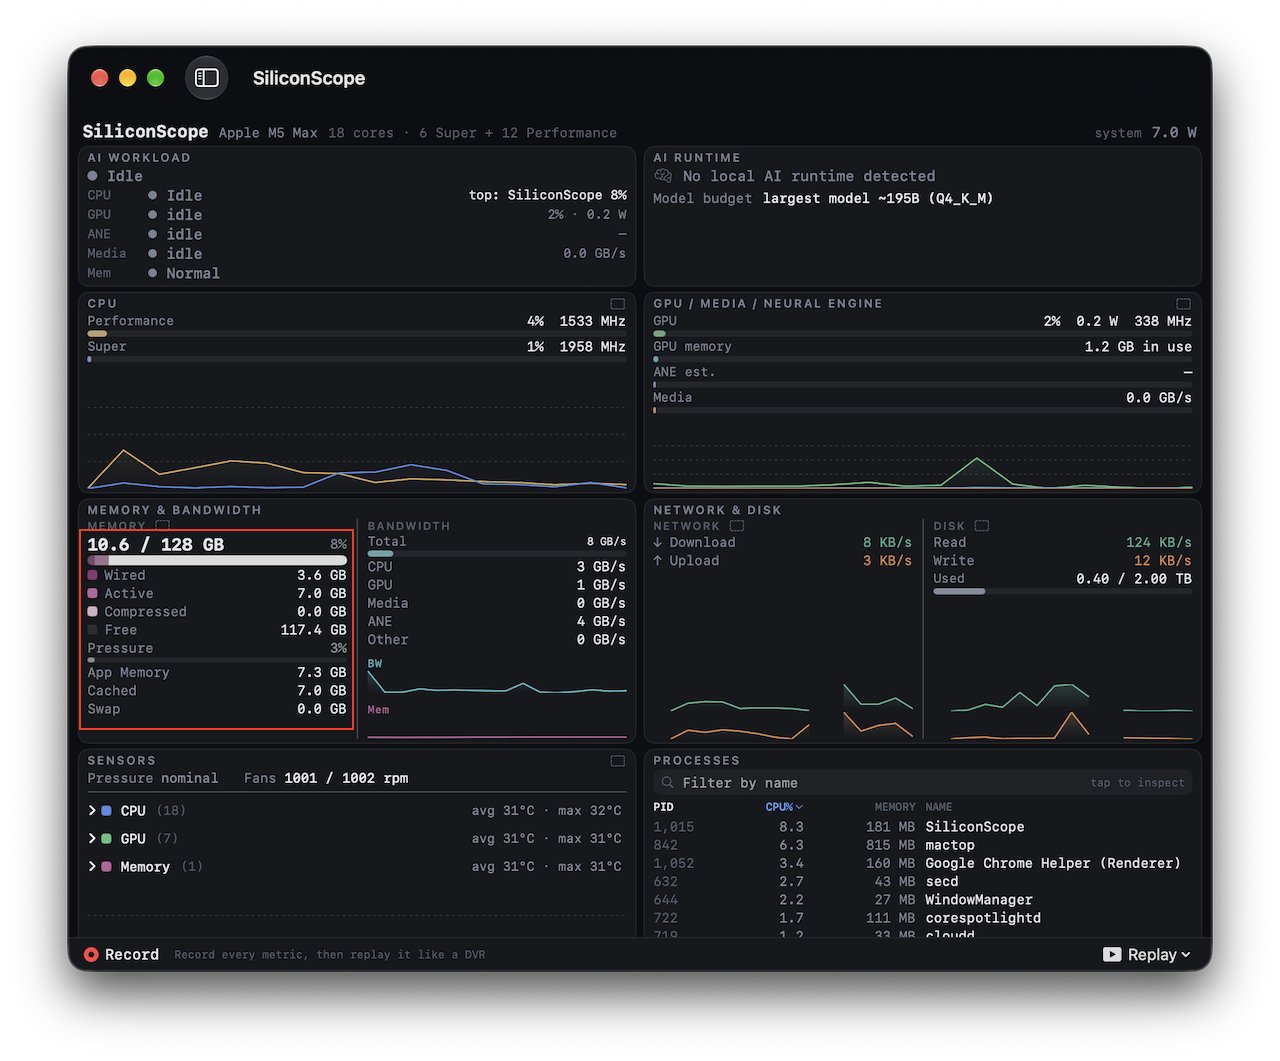
① 重启Mac,只启动SiliconScope和浏览器,目前只占用10.6GB内存。
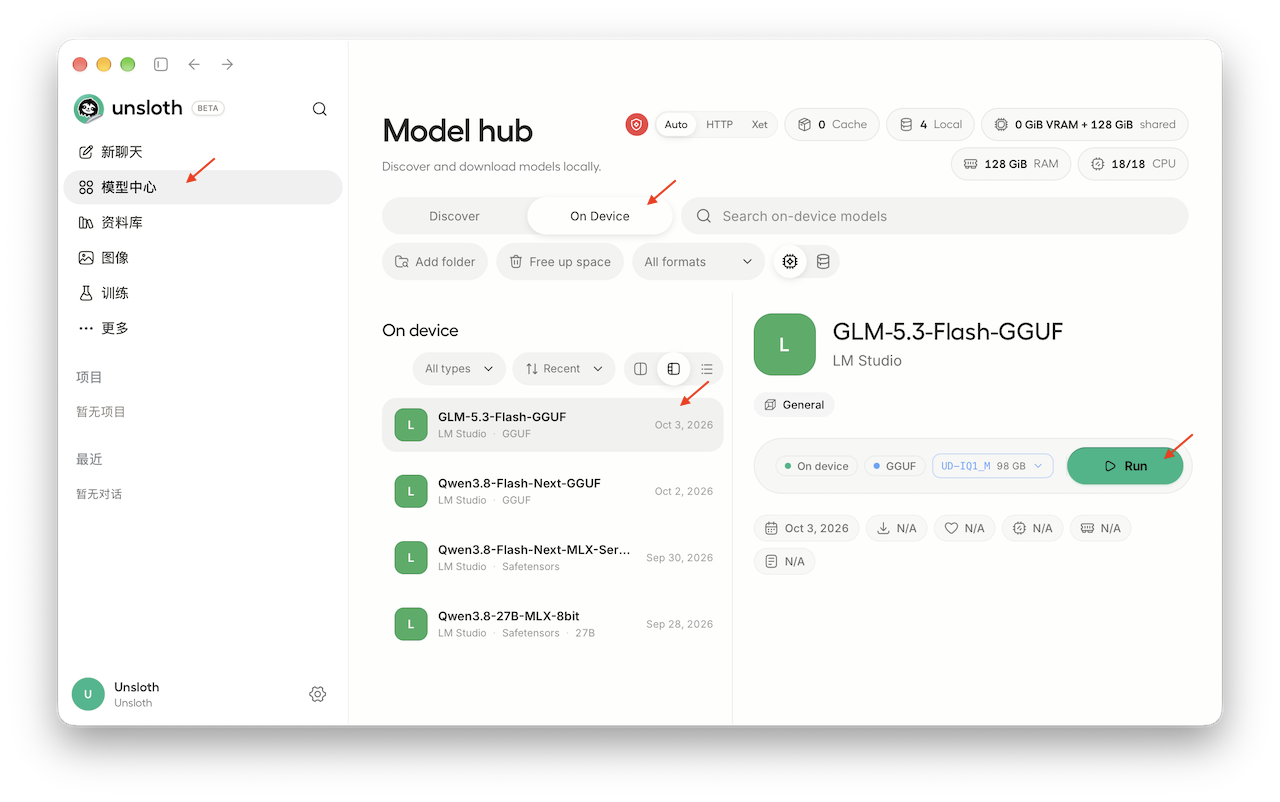
② 打开unsloth,选择菜单【模型心中】,选择【On Device】,选择模型【GLM-5.3-Flash-GGUF】,点击【Run】。
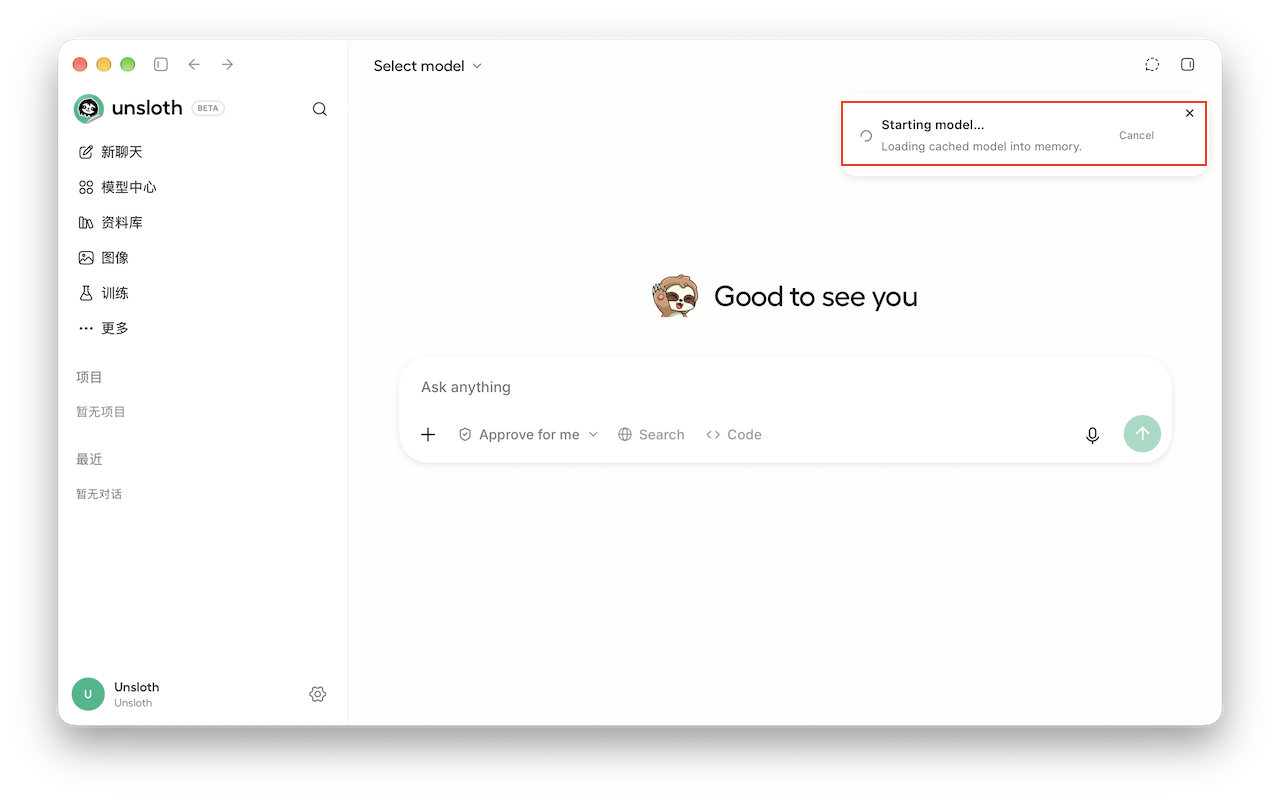
③ 提示正在将模型装入内存。
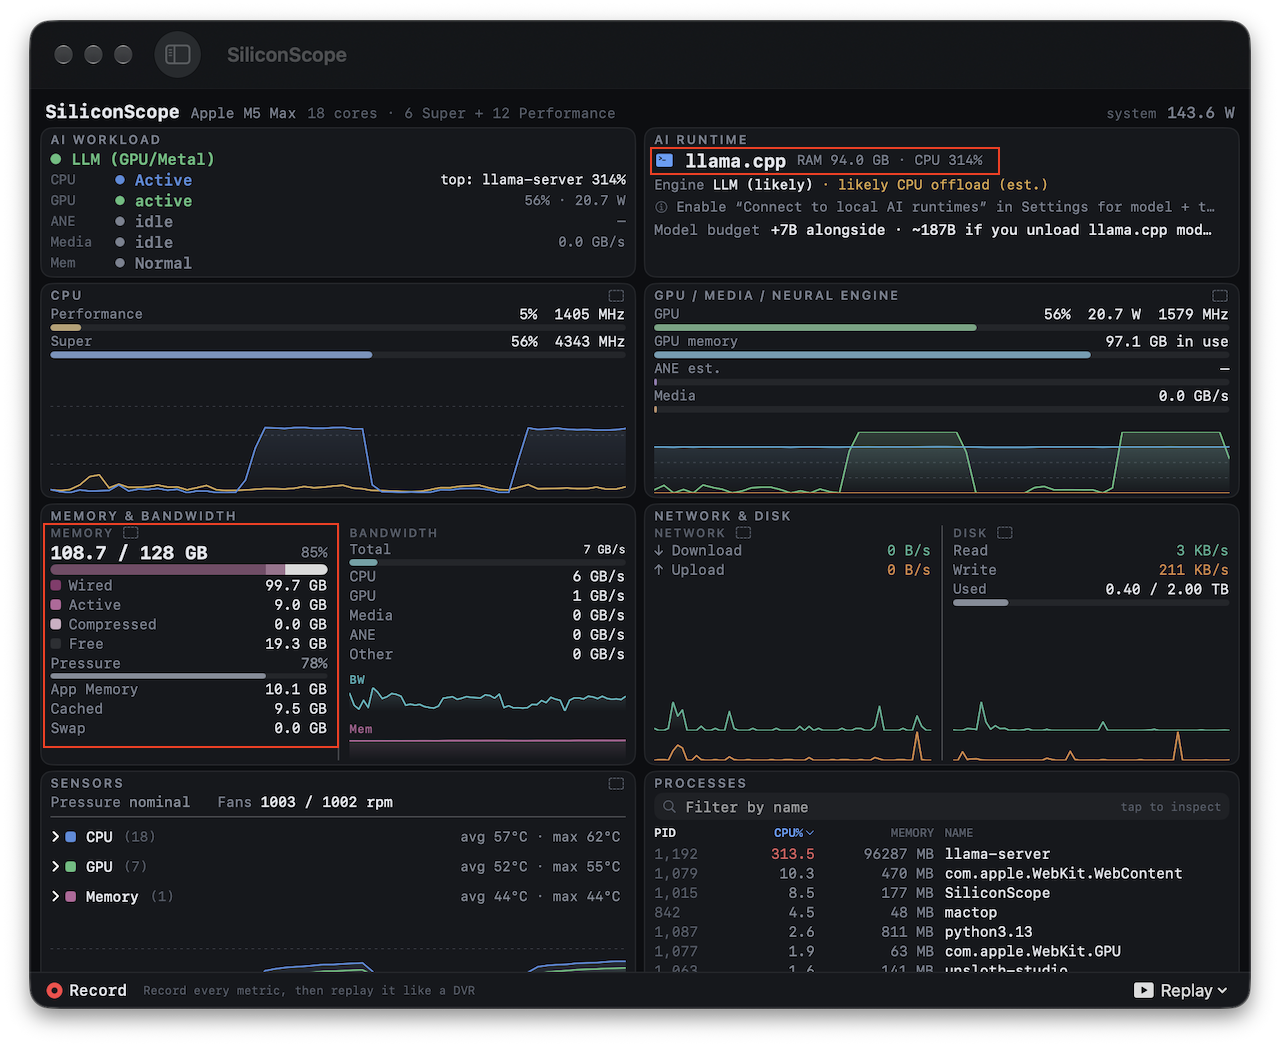
④ 模装装载完成后,再看SiliconScope,发现AI RUNTIME 是 llama.cpp,占108.7GB内存,减去10.6G基础占用,这个大模型占内存102G,说明整个模型文件都装载到内存中了。
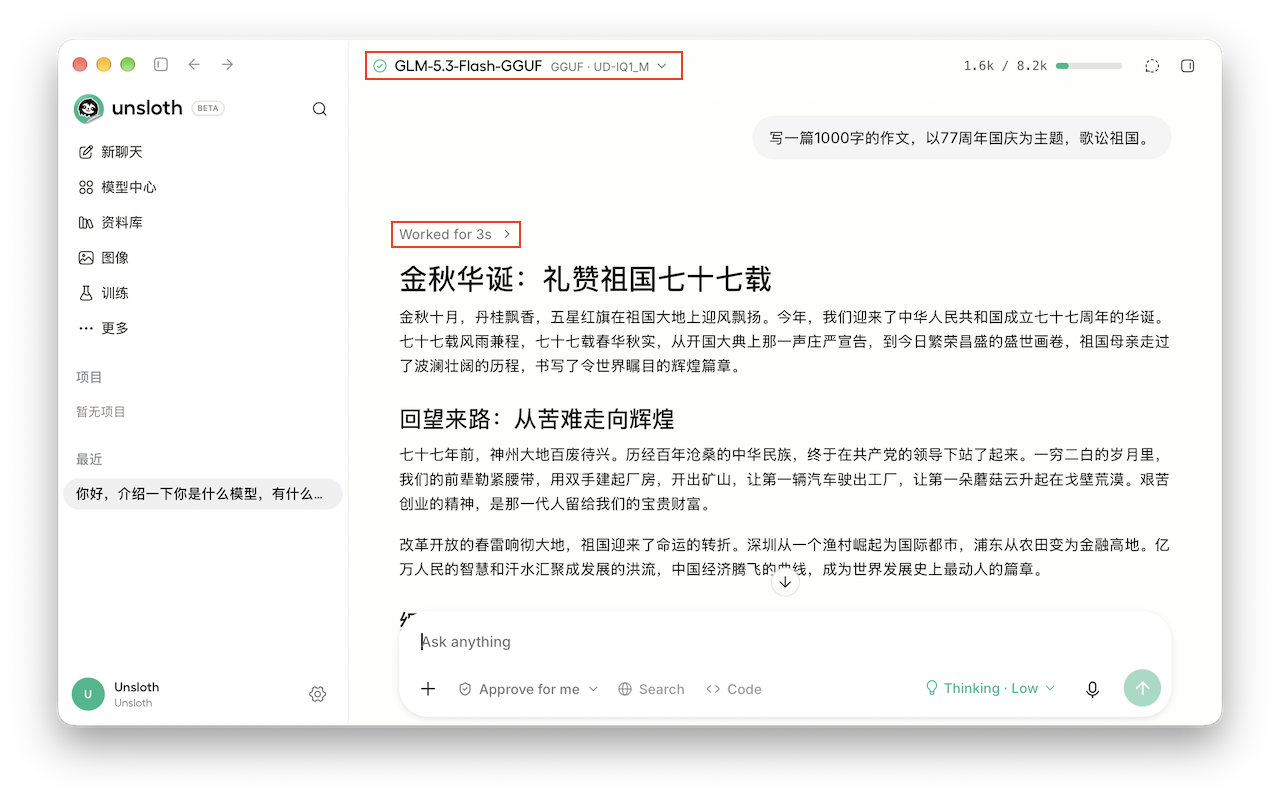
⑤ 用同样的问题,让unsloth下的GLM-5.3写一篇1000字的文章,思考时间用了3秒钟,而上一篇文章中,LM Studio下的Qwen3.8,同样问题,思考时间是3.46秒。
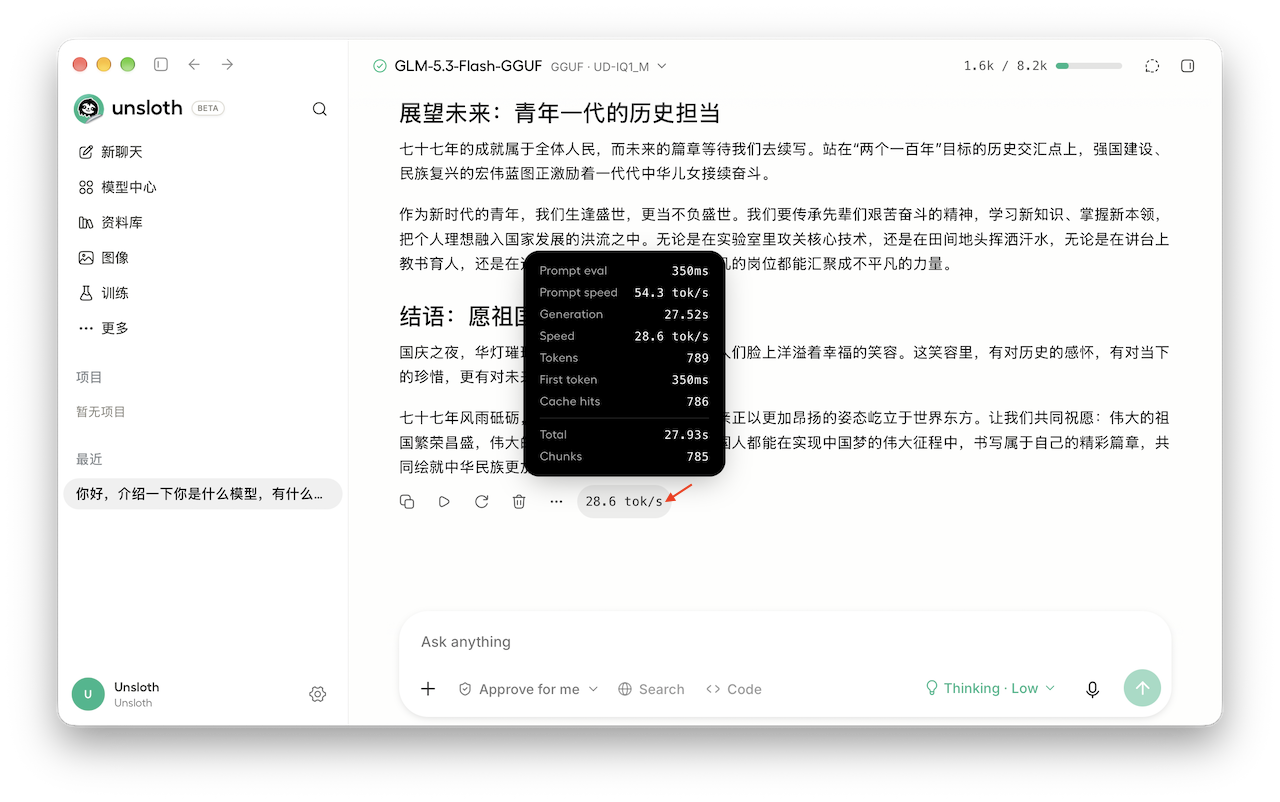
⑥ 鼠标移动到问题最后的28.6 tok/s上,弹出菜单显示更多的内容。LM Studio下的Qwen3.8,显示的是38.28 token/s,由于是不同模型,不同平台,这个只做一个简单参考,谁好谁差,还要深入研究才能知道答案。
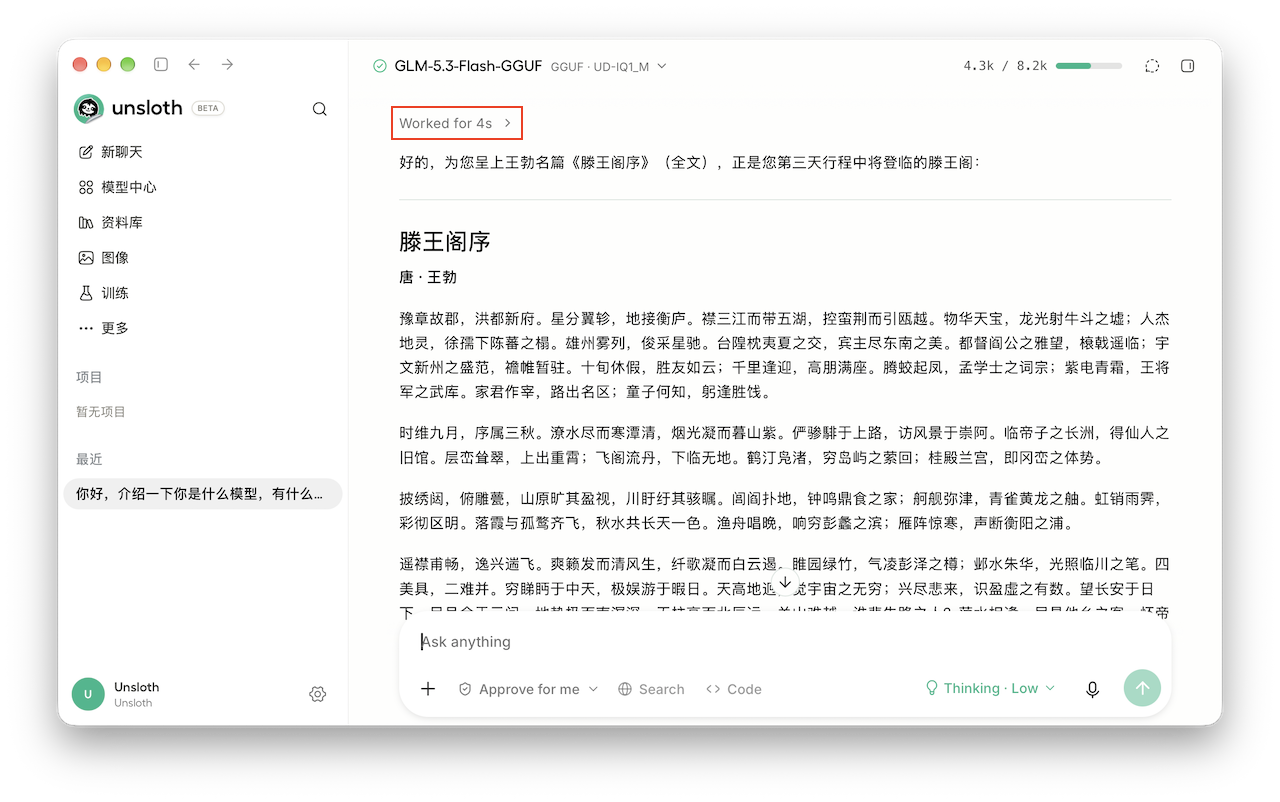
⑦ 同样在断网的情况下背讼滕王阁序,unsloth加GLM5.3的反应时间只有4秒钟,而LM Studio加Qwen3.8是1分钟,到低是模型太强,还是unsloth比LM Studio更快呢?你们想不想知道?
