文章目录
-
- [1. 先说结论](#1. 先说结论)
- [2. 两份 feed 与取数代码](#2. 两份 feed 与取数代码)
- [3. 发现一:中英两版是两套编号,`guid` 零重合](#3. 发现一:中英两版是两套编号,
guid零重合) - [4. 发现二:`lastBuildDate` 停在 2016 年](#4. 发现二:
lastBuildDate停在 2016 年) - [5. 发现三:100 条是硬上限,窗口按发布量滚动](#5. 发现三:100 条是硬上限,窗口按发布量滚动)
- [6. 发现四:9% 的条目是「(只有中文)」](#6. 发现四:9% 的条目是「(只有中文)」)
- [7. 双快照:同一脚本拍两张](#7. 双快照:同一脚本拍两张)
- [8. 踩坑清单与结论](#8. 踩坑清单与结论)
- [9. 参考链接](#9. 参考链接)
1. 先说结论
香港特区政府新闻公报提供两份 RSS:一份中文、一份英文,各 100 条。我把两份都拉下来做了一次对照,跑出三个不太符合直觉的结论:
| 问题 | 实测结果 |
|---|---|
同一则公报中英两版,能用 guid 或 link 配对吗? |
不能 :两个 feed 的 guid 交集是 0 ,因为中英两版是两个不同编号的文件 |
channel.lastBuildDate 能当"最近更新时间"吗? |
不能 :中文和英文两份 feed 的这个字段都停在 2016-07-12,十年没变 |
| 100 条是"最近 N 天"吗? | 不是 :100 条是硬上限 ,窗口按发布量滚动------本次实测覆盖 4.03 天 |
一句话:这份 feed 里最像"标准字段"的两个字段,恰好都不能直接用。
下面把取数代码、跨语言配对的正确口径、滚动窗口的周转估算,以及两次快照的差异完整拆开。
2. 两份 feed 与取数代码
| 语言 | 地址 | channel 标题 |
|---|---|---|
| 中文 | www.info.gov.hk/gia/rss/general_zh.xml |
香港特區政府新聞公報 |
| 英文 | www.info.gov.hk/gia/rss/general_en.xml |
HKSAR Government Press Releases |
两份都零鉴权。解析用标准库的 xml.etree + email.utils 就够------pubDate 是 RFC 822 格式,别自己写正则去切:
python
import re, html, email.utils, xml.etree.ElementTree as ET

FEEDS = {
    "zh": "https://www.info.gov.hk/gia/rss/general_zh.xml",
    "en": "https://www.info.gov.hk/gia/rss/general_en.xml",
}
FIELDS = ("title", "guid", "link", "pubDate", "description")

def load_feed(path):
    """解析一份 RSS:时间转成带时区的 datetime,正文去掉 HTML 标签。"""
    ch = ET.parse(path).getroot().find("channel")
    items = []
    for it in ch.findall("item"):
        row = {k: (it.findtext(k) or "").strip() for k in FIELDS}
        row["dt"] = email.utils.parsedate_to_datetime(row["pubDate"])
        # description 里带 <br /> 之类的标签,需要去标签 + 实体解码
        row["text"] = html.unescape(re.sub(r"<[^>]+>", " ", row["description"]))
        row["text"] = re.sub(r"\s+", " ", row["text"]).strip()
        items.append(row)
    return {
        "title": (ch.findtext("title") or "").strip(),
        "pubDate": (ch.findtext("pubDate") or "").strip(),
        "lastBuildDate": (ch.findtext("lastBuildDate") or "").strip(),
        "n_items": len(items),
        "items": items,
}这段解析代码可以直接拿走用,建议收藏备用------任何 RSS 2.0 的 feed 都适用,只要字段名对得上。环境:Python 3.13.12(macOS),仅标准库。
3. 发现一:中英两版是两套编号,guid 零重合
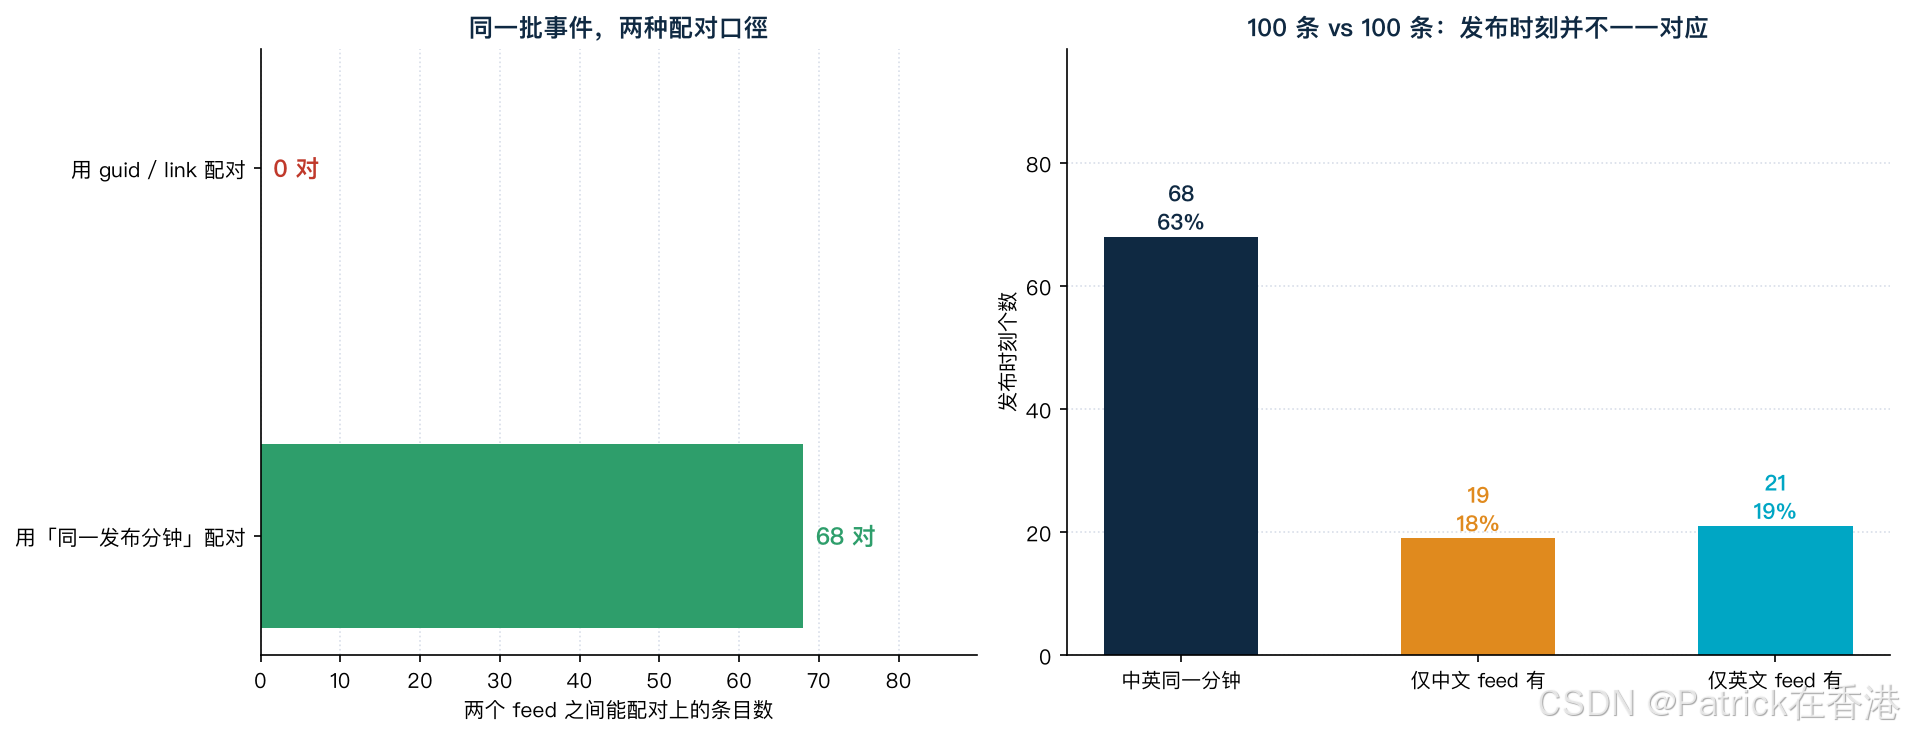
第一眼看上去,两个 feed 很像:各 100 条,时间窗口也几乎重合(中文 09-10 12:00 ~ 09-14 12:48,英文 09-10 11:00 ~ 09-14 12:00)。
那我当然想用 guid 把同一则公报的中英两版配起来。跑出来的结果是这样:
zh guid 数量   : 100
en guid 数量   : 100
guid 交集      : 0      ← 一个都对不上
link 交集      : 0
零重合。 如果只看这个数字,很容易得出"两份 feed 内容完全不同"的结论------但这是错的。随便挑三则同一事件:
| 发布时刻 | 中文 | 英文 |
|---|---|---|
| 09-14 10:20 | P2026091400238 數個泳灘懸掛紅旗 |
P2026091400239 Red flags hoisted at some beaches |
| 09-14 11:30 | P2026091400192 教育局提醒家長遞交小一入學申請表 |
P2026091400191 Parents reminded to submit application form |
| 09-14 12:00 | P2026091400281 社署邀請合資格人士或機構申請資訊科技計劃協助殘疾人士 |
P2026091400282 SWD invites applications for IT schemes |
是同一件事,但文件编号相邻而不同 (0238 / 0239,0192 / 0191,0281 / 0282)。也就是说:中文版和英文版在源站是两份独立文件,各有各的编号 。用 guid 或 link 做跨语言配对,正确结果就是 0 个------这个 0 不是"没有共同内容",而是"这个键根本不适用于跨语言"。
可行的配对键是发布时间 。实测把 pubDate 截到分钟后比对:
python
import collections

def pair_by_time(zh, en):
    """跨语言配对:guid 不能当键(中英编号不同),只能用「同一发布分钟」。

    注意 pubDate 的秒位是随机的(实测有 06--23 秒不等),
    所以必须先把秒位归零,否则同一分钟的两条永远配不上。
    """
    z = collections.defaultdict(list)
    e = collections.defaultdict(list)
    for i in zh["items"]:
        z[i["dt"].replace(second=0)].append(i)
    for i in en["items"]:
        e[i["dt"].replace(second=0)].append(i)
    both = sorted(set(z) & set(e))
    return {
        "guid_overlap": len({i["guid"] for i in zh["items"]}
                            & {i["guid"] for i in en["items"]}),
        "same_minute_pairs": len(both),
        "zh_only_minutes": len(set(z) - set(e)),
        "en_only_minutes": len(set(e) - set(z)),
}跑出来:同一分钟可配 68 对,另有 19 个时刻只有中文、21 个时刻只有英文。
那个"秒位随机"的细节值得单独说一句:pubDate 长这样 Mon, 14 Sep 2026 12:48:16 +0800------秒位不是 0 。如果直接拿完整时间戳当键,能配上的对会从 68 掉到 58,凭空少 10 对。跨源配对前,先确认时间字段的精度到哪一位。
4. 发现二:lastBuildDate 停在 2016 年
同一份 feed 里还有一个字段,看起来正好能回答"这份 feed 什么时候更新过":
zh.lastBuildDate = Tue, 12 Jul 2016 11:00:00 GMT
en.lastBuildDate = Tue, 12 Jul 2016 11:00:00 GMT
zh.pubDate       = Mon, 14 Sep 2026 13:06:32 GMT
lastBuildDate 是 RSS 2.0 规范里的标准字段,语义就是"内容最后构建的时间"。而这里它停在 2016 年 7 月 12 日 ------同一份 feed 里的 pubDate(feed 自身的发布时间)却是今天 13:06。
两个字段都在描述"这份 feed 的时间",相差十年。 结论很直接:
- 要判断 feed 有没有更新 → 看最新一条
item的pubDate,或者 feed 级的pubDate; lastBuildDate在这份 feed 上是一个从不维护的历史遗留字段,用它做"多久没更新"的告警,会得到"十年没动过"的结论。
这不是孤例的怪癖------解析任何 feed 之前,先把时间字段逐个和真实数据对一遍,比事后发现告警一直误报便宜得多。
5. 发现三:100 条是硬上限,窗口按发布量滚动
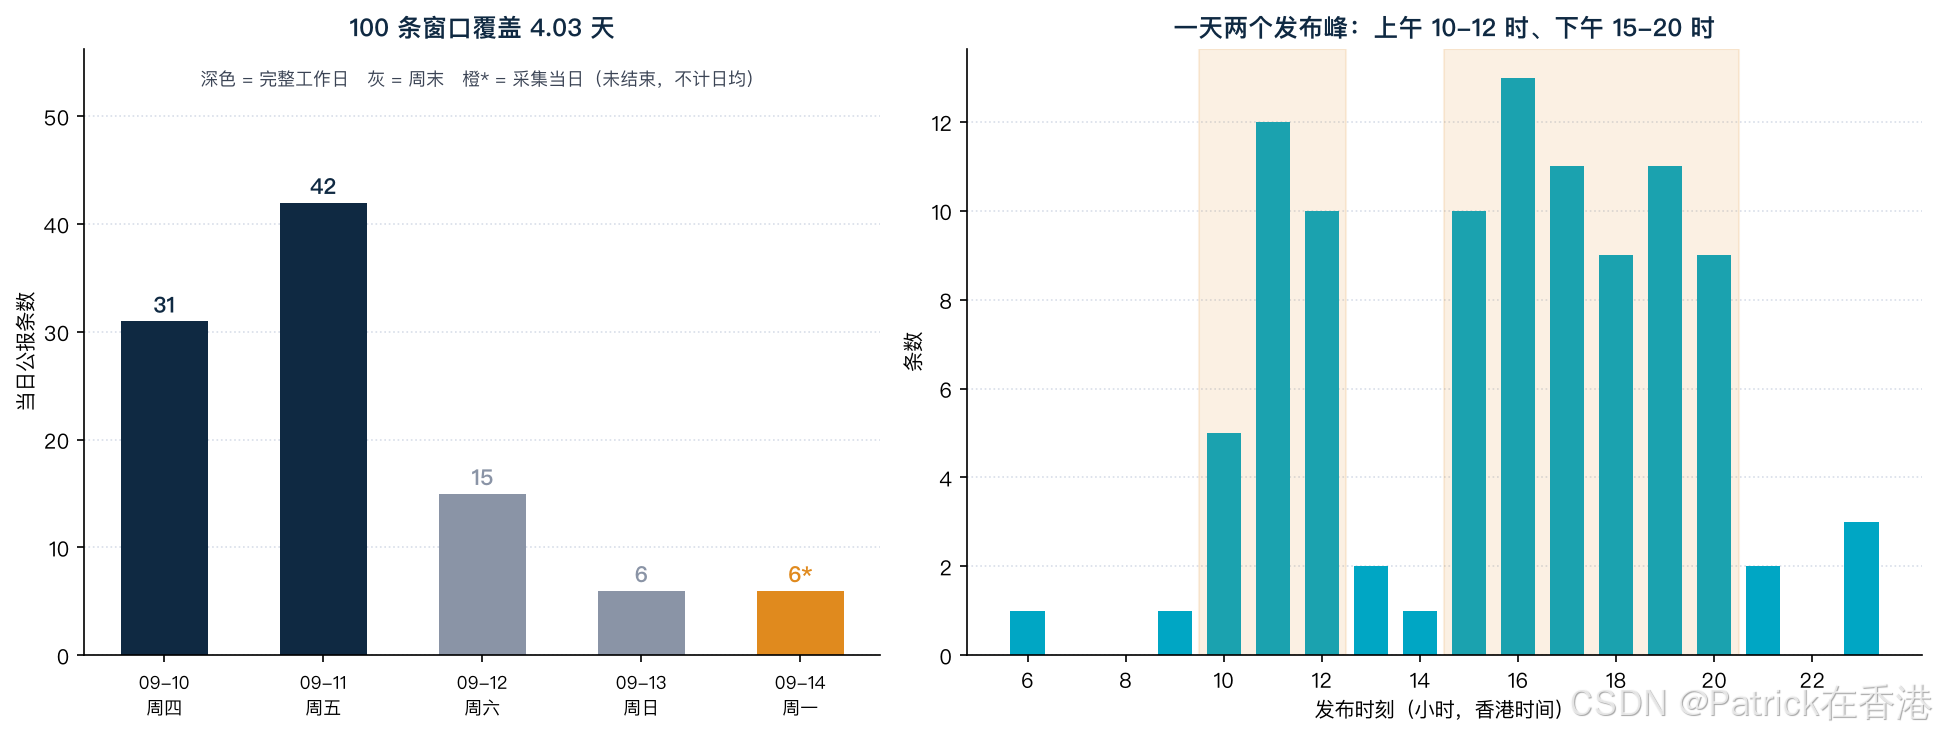
我一开始以为 100 条对应"最近若干天"。实测中文 feed 的 100 条覆盖 2026-09-10 12:00 ~ 2026-09-14 12:48,等于 4.03 天。逐日条数:
09-10 周四  31 条
09-11 周五  42 条
09-12 周六  15 条
09-13 周日   6 条
09-14 周一   6 条   ← 采集时刻才 13:11,当天还没发完
周末和工作日的密度差一个数量级 :完整工作日 31--42 条/天,周六 15 条、周日 6 条。所以"100 条覆盖多少天"不是一个固定值------按工作日速率算,100 条约等于 2.4--3.2 个工作日,而按本次实测(含周末)是 4.03 个自然日。
这带来一个容易被忽略的后果:超过窗口的旧公报会被挤出去,而且没有任何提示。 如果你用这份 feed 做"政府公告归档",周一抓一次、周五再抓一次,中间几天发布的公报很可能已经不在 feed 里了。要归档就得定时拉、自己落库,不能指望 feed 帮你保存历史。
发布时段的分布也很清楚------一天两个峰:上午 10--12 时、下午 15--20 时,21 时之后骤降。做轮询的话,按这个形状设置抓取频率比"每 10 分钟一次"省得多。
窗口的计算逻辑:
python
import collections, datetime as dt

def window(lang):
    """滚动窗口:条目数、时间跨度、按工作日速率估算的周转天数。"""
    d = [i["dt"] for i in lang["items"]]
    span = max(d) - min(d)
    per_day = collections.Counter(x.date() for x in d)
    newest = max(per_day)
    # 采集当日还在发布中,不能计入日均,否则速率会被算低
    complete = [k for k in sorted(per_day) if k < newest]
    weekdays = [per_day[k] for k in complete if k.weekday() < 5]
    return {
        "n": len(d),
        "span_days": round(span.total_seconds() / 86400, 2),
        "per_day": {k.isoformat(): v for k, v in sorted(per_day.items())},
        "partial_day": newest.isoformat(),
        "turnover_days_min": round(len(d) / max(weekdays), 2),
        "turnover_days_max": round(len(d) / min(weekdays), 2),
}这套窗口估算建议收藏,换成任何"有上限的列表接口"都能直接套。
6. 发现四:9% 的条目是「(只有中文)」
中文 feed 的标题里,有 **9 条(9.0%)**带一个显式标记:
⋯⋯局長出席⋯⋯論壇致辭(只有中文)
⋯⋯局長出席⋯⋯論壇致辭(只有中文)(附圖/短片)
⋯⋯服務獎頒獎典禮致辭(只有中文)(附圖/短片)
这类条目在英文 feed 里没有对应版本------它们大多是官员致辞,官方只发布中文稿。这就是第 3 节里"仅中文的 19 个发布时刻"的主要来源之一。
对做双语内容聚合的人来说,这意味着英文 feed 不是中文 feed 的子集,也不是超集 :中文独有 19 个时刻,英文独有 21 个时刻。要"全量",两个都得抓。
7. 双快照:同一脚本拍两张
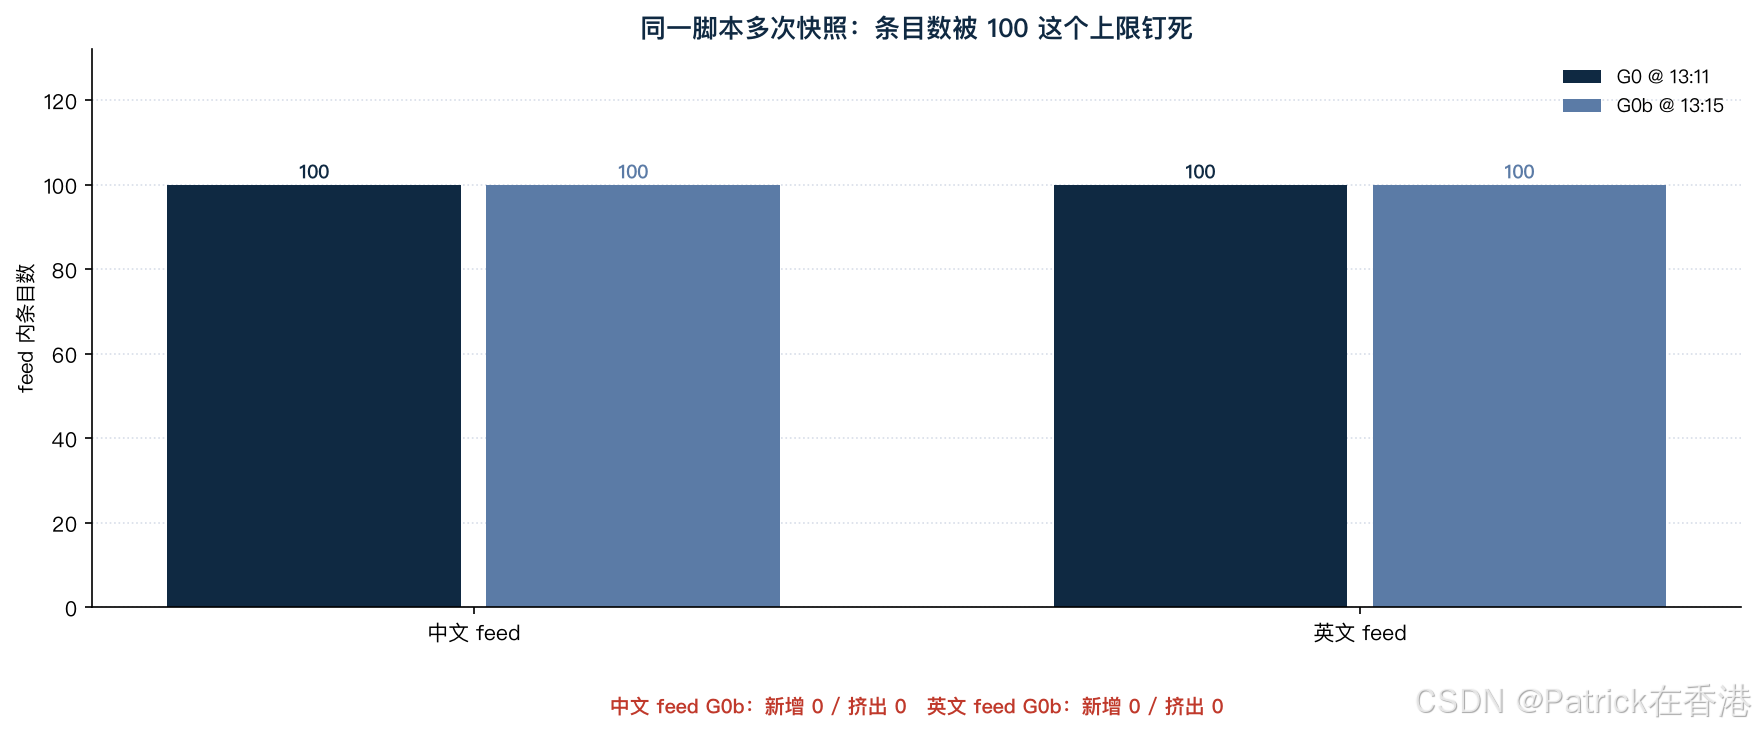
用同一份脚本、同一套参数,在 13:11:41 和 13:15:33 各拍了一次(间隔 3 分 52 秒):
快照 G0  (13:11:41)  中文 100 条 | 英文 100 条
快照 G0b (13:15:33)  中文 100 条 | 英文 100 条
                     新增 0 条   | 挤出 0 条
两个 feed 都纹丝不动 :条目数 100 → 100,guid 集合的增删都是 0。
这次"什么都没发生",恰好把第 5 节那个性质补完整了:数量这个指标在两个方向上都失效。
- 窗口满时,新增一条就挤掉一条 → 数量永远显示 100,看不出内容在换;
- 确实没发布时 → 数量同样显示 100,看不出内容真的没动。
两个场景读数完全相同。 要判断有没有变化,只有一条路:比对 guid 集合的增删,别比对条数。
那"多久拍一次才可能看到变化"?用发布时刻分布可以直接算------把 100 条按整点归并、除以窗口天数,得到每个整点的期望发布量,再取倒数:
| 整点 | 期望发布量 | 期望看到 1 条新增所需间隔 |
|---|---|---|
| 16 时 | 3.23 条/小时 | 约 19 分钟 |
| 11 时 | 2.98 条/小时 | 约 20 分钟 |
| 13 时 | 0.50 条/小时 | 约 121 分钟 |
| 09 时、14 时 | 0.25 条/小时 | 约 242 分钟 |
同一份 feed,"多久能看到变化"在 19 分钟到 242 分钟之间摆动,差 12.7 倍。 固定间隔轮询要么在高峰时段白花请求,要么在低谷时段漏掉变化;按这个分布去分配抓取频率才划算。
8. 踩坑清单与结论
| 坑 | 现象 | 处理 |
|---|---|---|
用 guid 做跨语言配对 |
交集恒为 0,看起来像"两边没有共同内容" | 中英两版是两套编号;跨语言只能用发布时刻 + 语义配对 |
| 直接拿完整时间戳配对 | 少配 10 对 | pubDate 秒位随机,配对前先归零到分钟 |
用 lastBuildDate 判新鲜度 |
该字段停在 2016-07-12 | 看最新一条 item.pubDate 或 feed 级 pubDate |
| 以为 100 条 = 最近 N 天 | 实际覆盖 4.03 天,工作日密度不同还会缩 | 100 是硬上限,窗口按发布量滚动 |
| 用条目数做变更检测 | 两次快照条数都是 100,看不出变化 | 比对 guid 集合的增删 |
| 指望 feed 保存历史 | 超出窗口的条目静默消失 | 定时拉取、自己落库 |
把 description 直接入库 |
里面混着 <br /> 之类的标签 |
先剥标签再做实体解码 |
值得记住的三条:
- 标准字段 ≠ 可靠字段。
guid和lastBuildDate都是 RSS 2.0 规范里的字段,规范也写明了语义;但在这份 feed 上,一个不适用于跨语言、一个十年没更新。字段名相同,不代表语义可用。 - 配对键要先验证再使用。 用
guid直接配对得到 0、用完整时间戳配对得到 58、把秒位归零到分钟后得到 68------同一件事三种键三个答案,先各跑一遍再决定用哪个,比事后解释"数据怎么少了"便宜。 - 有界窗口的数据源,不要用"数量"做监控。 数量恒定是有界队列的固有属性;能反映变化的只有集合的增删。
可复用的三块:RSS 解析 load_feed() (时区解析 + 正文去标签)、跨语言配对 pair_by_time() 、滚动窗口估算 window() 。如果这篇对你有用,收藏 + 点赞------下次接任何 RSS 或"有界窗口"式接口,可以按这三块先过一遍。
香港公开数据的实测会继续更新,关注不迷路。
9. 参考链接
- https://www.info.gov.hk/gia/rss/general_zh.xml
- https://www.info.gov.hk/gia/rss/general_en.xml
- https://www.info.gov.hk/gia/general/today.htm
原创声明:本文为原创技术实践。两份 feed 与两次快照均为 2026-09-14 的真实采集(快照 G0 于 13:11:41、G0b 于 13:15:33)。feed 的条目上限、字段维护状态与发布节奏可能随官方调整而变化,请以自测数据为准。